Le flux de saisie de données AP :
cinq étapes du PDF au grand livre
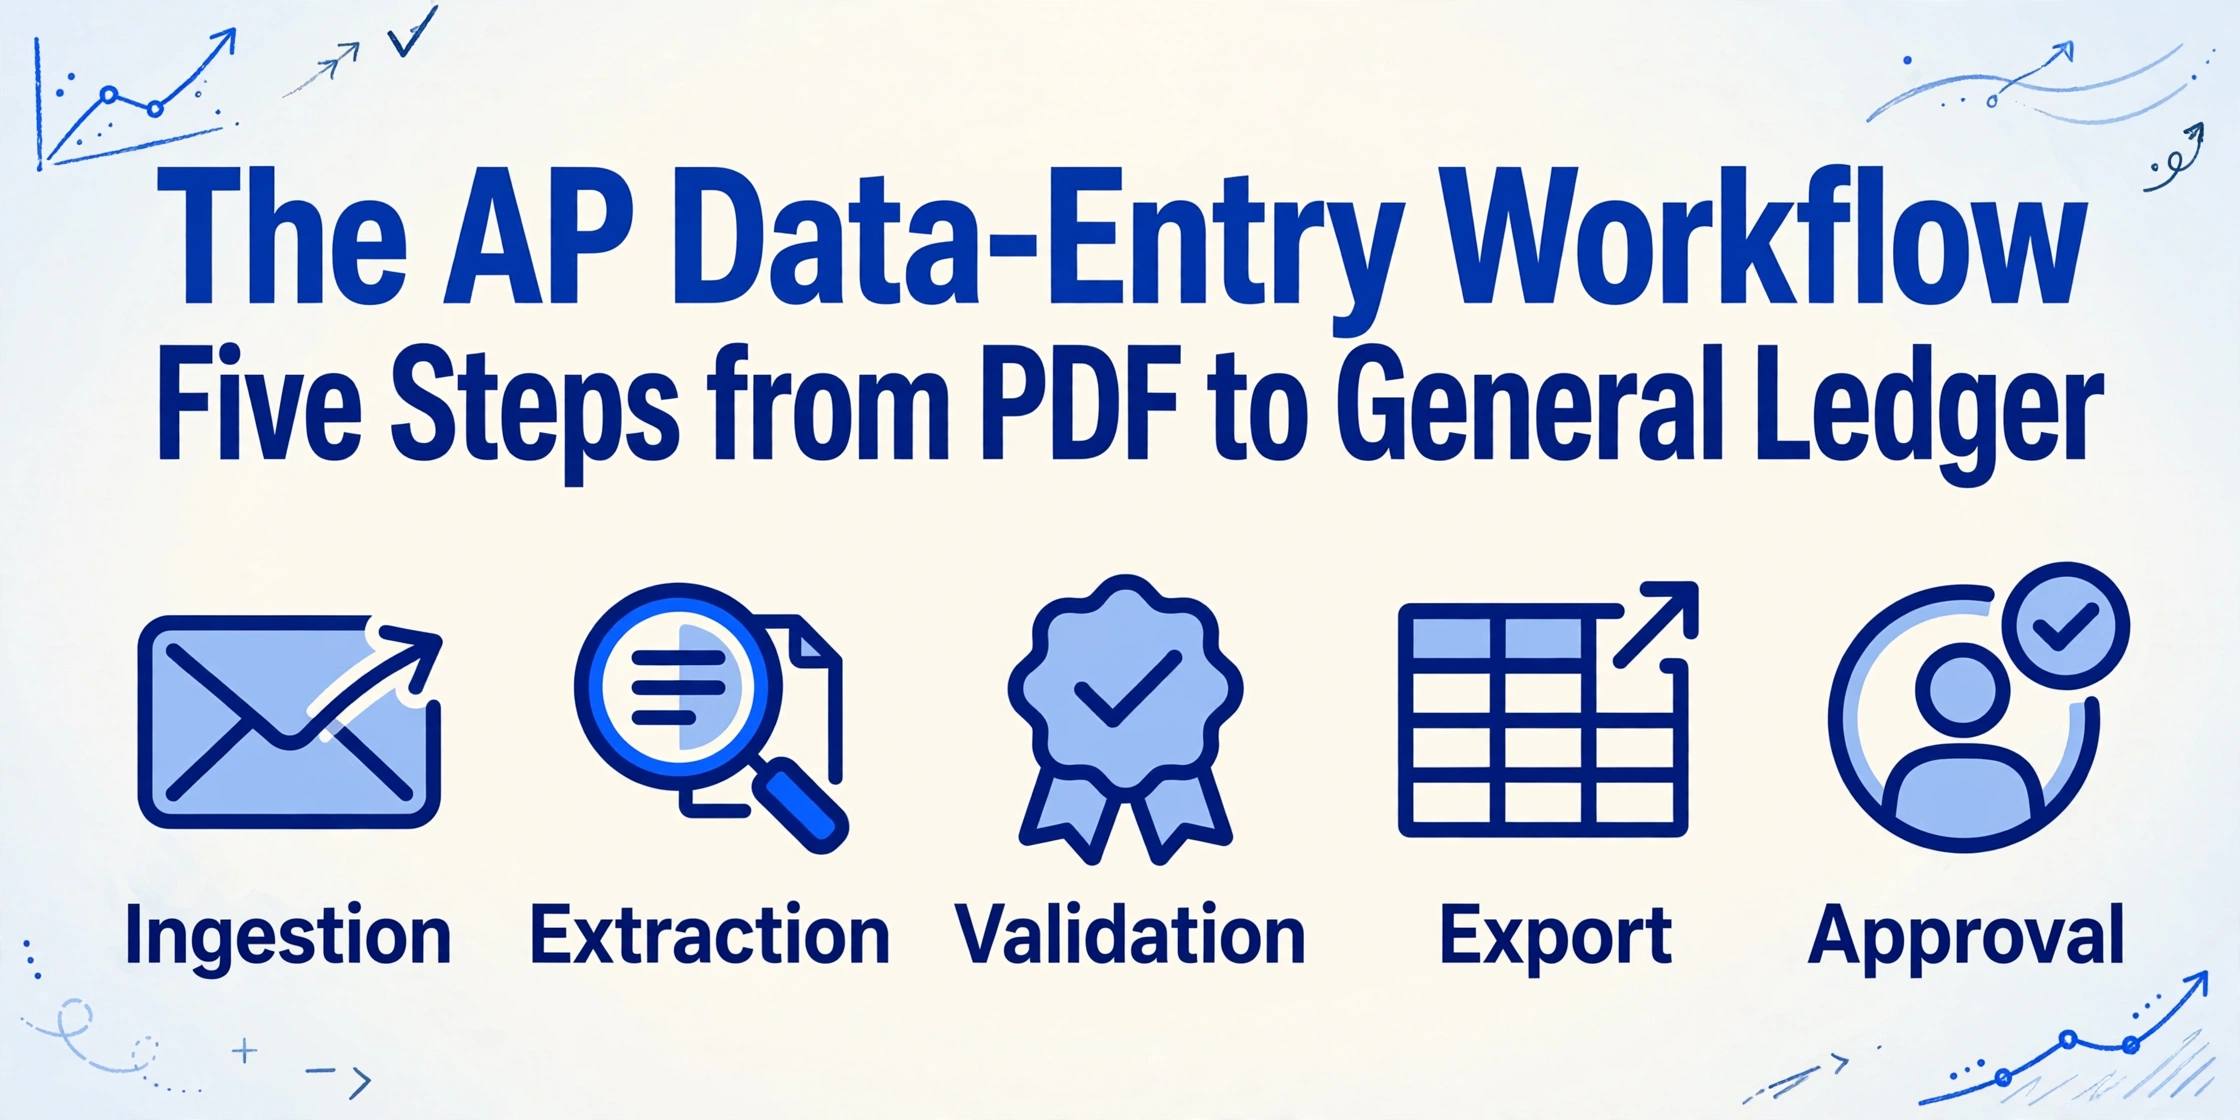
L'automatisation AP n'est pas un grand interrupteur. Ce sont cinq étapes distinctes, chacune avec ses propres outils, ses propres modes de défaillance et son propre plafond d'automatisation. La plupart des outils vendus comme « automatisation AP » couvrent au plus deux de ces étapes. Les trois autres sont celles où les factures stagnent, où les doublons passent à travers, et où le personnel vérifie manuellement les PDF contre les écrans ERP. Couvrir toute la chaîne, pas seulement l'étape d'extraction, est ce qui distingue une automatisation qui tient quand chaque fournisseur formate les factures différemment d'une automatisation qui ne fonctionne que sur l'échantillon.
Points clés à retenir
- Ce que la plupart des outils appellent automatisation AP automatise exactement une étape — lire les champs d'une page — sur les cinq étapes qu'une facture parcourt de la boîte de réception au grand livre.
- L'écart de coût de 70 % entre la moyenne (9,40 $) et les meilleurs de leur catégorie (2,78 $) par facture ne vient pas d'une meilleure extraction — il vient de l'automatisation des étapes entre l'extraction et la comptabilisation.
- Le test du pipeline : si votre outil AP ne peut pas exporter un lot de 50 factures vers votre système comptable en une seule opération, vous n'avez pas automatisé l'AP — vous avez seulement déplacé le goulot d'étranglement de l'extraction vers la ressaisie.
Les cinq points de transfert dans le pipeline de saisie de données AP
La saisie de données des comptes fournisseurs n'est pas une seule tâche. C'est un pipeline : une séquence d'étapes distinctes, chacune passant le relais à la suivante. Chaque point de transfert est à la fois un point de défaillance et une opportunité d'automatisation. Les cinq étapes sont :
La plupart des outils d'automatisation AP se concentrent entièrement sur l'étape 2. Quelques-uns s'étendent aux étapes 1 et 3. Presque aucun ne touche aux étapes 4 et 5. Et c'est pourquoi, en pratique, « nous avons automatisé l'AP » signifie souvent « nous avons automatisé l'extraction des données de factures et rien d'autre n'a changé ». Le débit global du pipeline reste gouverné par son point de transfert le plus lent.
Selon le rapport AP Metrics That Matter 2025 d'Ardent Partners, l'organisation moyenne dépense 9,40 $ pour traiter une seule facture, tandis que les équipes les plus performantes — les 20 % supérieurs — ont réduit ce chiffre à 2,78 $ grâce à une automatisation de bout en bout.¹ Cet écart de coût de 70 % ne vient pas uniquement d'une meilleure extraction. Il provient de l'automatisation des points de transfert entre l'extraction et la comptabilisation — les étapes où les données attendent qu'un humain les fasse avancer.
Ingestion : centraliser les factures au même endroit
Le premier goulot d'étranglement dans la plupart des flux de travail AP n'a rien à voir avec la lecture des données des factures. Il s'agit d'acheminer la facture dans le système. Les factures arrivent par pièces jointes e-mail, portails fournisseurs (Coupa, Ariba), courrier papier, lecteurs réseau partagés et, de plus en plus, flux EDI. Un commis AP d'une entreprise manufacturière de taille moyenne peut devoir récupérer des factures sur sept canaux différents avant même de pouvoir commencer la saisie des données. Un analyseur d'e-mails pour la pile de pièces jointes ne supprime qu'un seul de ces canaux, mais c'est souvent celui qui coûte le plus de temps.
L'étude IOFM 2024 AP Benchmarking a révélé que le traitement manuel des factures prend en moyenne 12,5 minutes par facture, et que les 1,5 premières minutes de ce temps sont consacrées à localiser et ouvrir le fichier.² Avant même qu'un seul champ ne soit lu, le pipeline consomme déjà du temps de travail facturable.
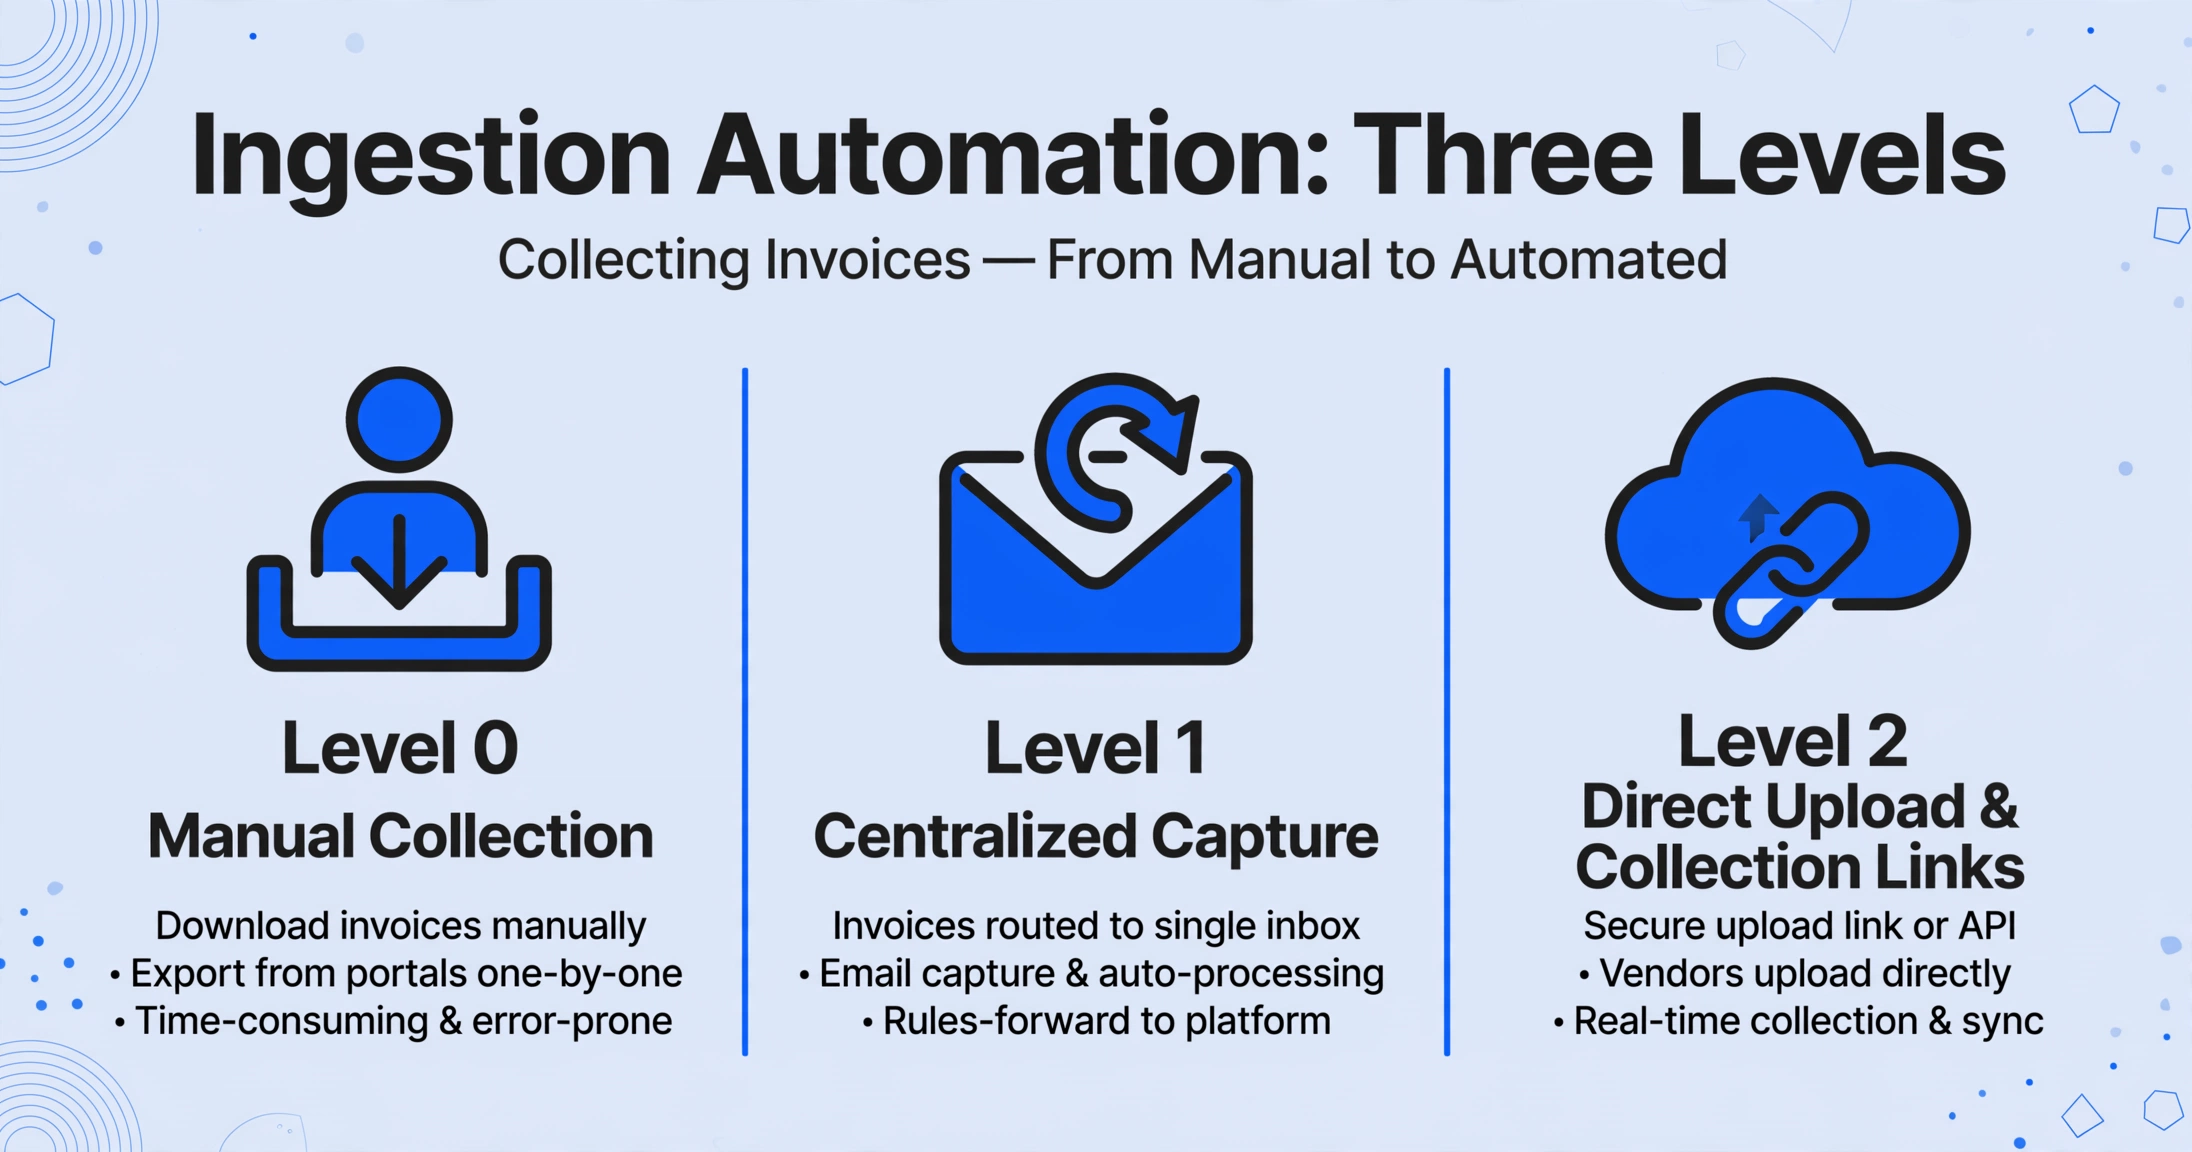
L'automatisation de l'ingestion se décline en trois niveaux :
- Niveau 0 — Collecte manuelle. Quelqu'un télécharge les pièces jointes des e-mails, imprime les factures papier pour les numériser, se connecte séparément à chaque portail fournisseur. C'est là que la plupart des petites et moyennes équipes AP opèrent encore.
- Niveau 1 — Capture centralisée. Un analyseur d'e-mails ou une boîte de réception dédiée achemine automatiquement les pièces jointes vers une file de traitement. Les factures papier sont numérisées en lot vers un dossier surveillé. Cela élimine la chasse multi-canaux mais ne résout pas le problème de format.
- Niveau 2 — Téléversement direct et Lien de collecte. Au lieu de courir après les factures, vous donnez aux fournisseurs et aux parties prenantes internes un lien où ils téléversent directement. La fonctionnalité Lien de collecte d'ImageToTable.ai fait exactement cela : vous générez une URL partageable (aucune inscription requise pour l'expéditeur), l'expéditeur dépose les fichiers, et ils atterrissent dans votre file de traitement. L'étape d'ingestion passe de « trouver et télécharger » à « ouvrir la file ».
Sur r/Accounting de Reddit, un utilisateur a décrit sa réalité d'ingestion avec 1 500 à 2 000 factures fournisseurs mensuelles : « les factures arrivent dans une boîte de réception partagée sous forme de pièces jointes PDF, quelqu'un ouvre chacune d'elles, saisit les informations d'en-tête dans NetSuite, fait la correspondance avec le PO manuellement, achemine pour approbation par e-mail, relance les approbateurs qui ignorent la demande. »³ L'étape d'ingestion dans ce flux de travail — ouvrir les pièces jointes et les acheminer à la bonne personne — est entièrement manuelle et répétée des milliers de fois par mois.
Ce qui change avec l'automatisation : Les factures passent d'une dispersion entre boîtes de réception et lecteurs à un point d'entrée structuré unique. L'étape de capture passe de quelques minutes à quelques secondes par facture.
Ce qui ne change pas : Quelqu'un doit toujours décider quelles factures traiter, gérer les demandes des fournisseurs concernant les factures manquantes et maintenir les canaux d'entrée.
Extraction : là où se produit le plus grand changement
C'est à cette étape que la technologie a fait le bond le plus spectaculaire — et c'est là que la différence entre l'ancienne approche et la nouvelle approche génère les plus grandes économies de temps dans l'ensemble du processus. L'extraction consiste à lire des champs individuels d'un document : numéro de facture, date d'émission, date d'échéance, nom du fournisseur, descriptions des lignes, quantités, prix unitaires, montants de taxes et total de la facture. Réussir ou échouer à cette étape a des répercussions sur chaque transfert en aval.
L'ancienne méthode : l'OCR basé sur un modèle
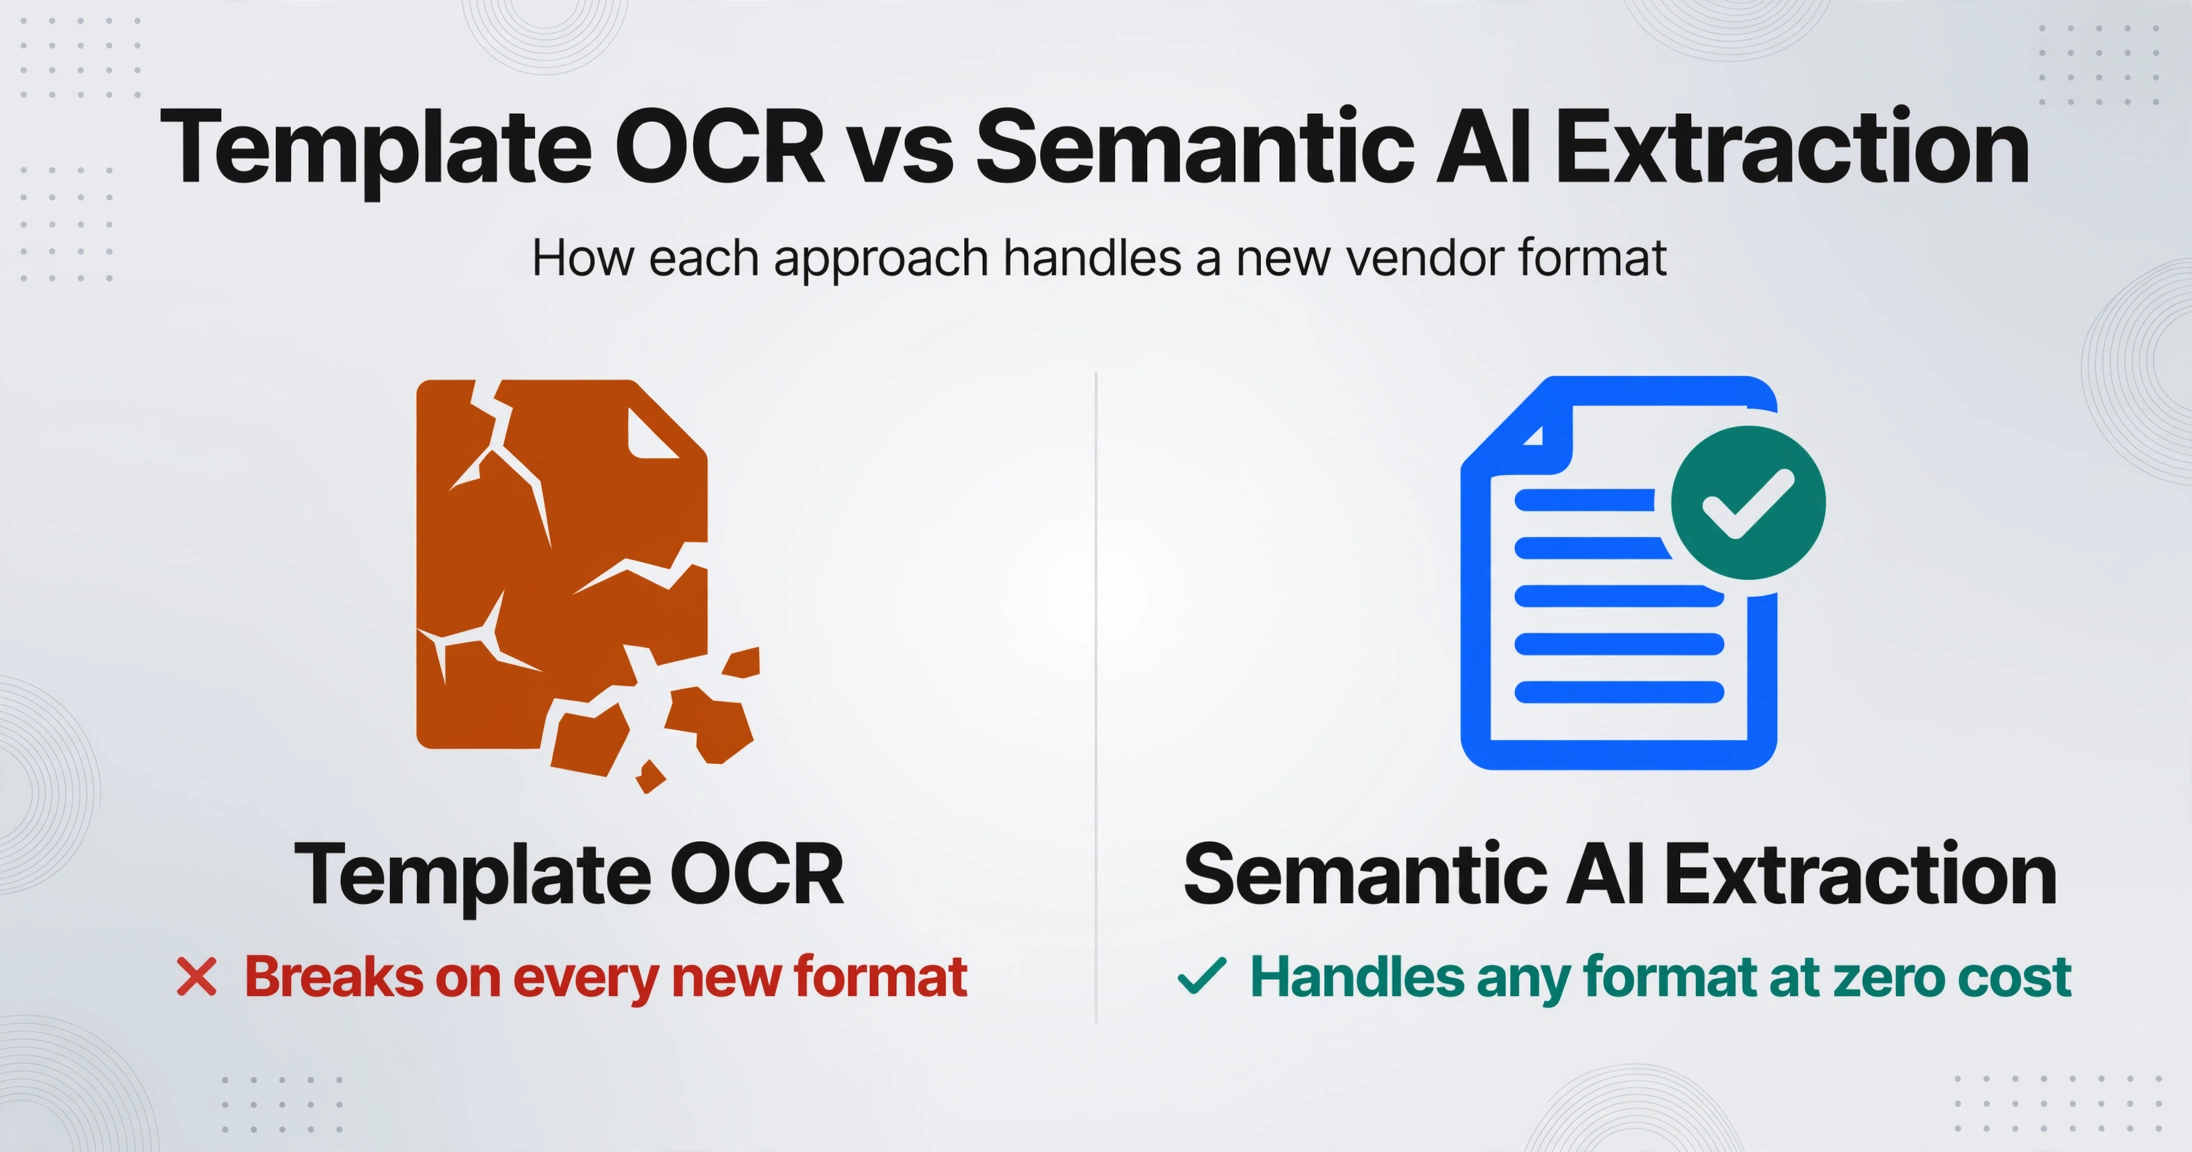
Les outils traditionnels d'automatisation de la comptabilité fournisseurs (AP) s'appuient sur la reconnaissance optique de caractères (OCR) associée à des modèles ou à un mappage de zones. Pour chaque fournisseur, vous définissez où se trouve chaque champ sur la page — « Le numéro de facture se trouve dans le coin supérieur droit, à 3 pouces du bas, à 2 pouces de la marge droite. » L'OCR lit les caractères dans cette zone. Si le fournisseur modifie la mise en page de ses factures — et il le fera — le modèle échoue. Vous créez un nouveau modèle. Multipliez cela par 200 fournisseurs, chacun avec son propre format et des changements de mise en page périodiques, et la maintenance des modèles devient un travail à part entière.
Cet utilisateur de Reddit qui traite 1 500 à 2 000 factures a indiqué avoir essayé l'OCR intégré à son ERP : « il échoue sur la moitié de nos factures parce que chaque atelier d'usinage et chaque fournisseur de matières premières formate les leurs différemment. »³ C'est le problème du modèle en une phrase. Si votre outil dépend de la connaissance de l'emplacement où se trouvent les données, il échoue dès qu'un nouveau format apparaît.
La nouvelle approche : l'extraction sémantique par IA
L'extraction par IA fonctionne différemment. Au lieu de programmer des modèles pour chaque format, vous indiquez au système ce que vous voulez — les noms de champs — et un modèle de vision par langage lit le document pour trouver chaque champ en comprenant sa signification, et non son emplacement. Un champ intitulé « Invoice Number » est localisé qu'il se trouve dans le coin supérieur droit, dans l'en-tête central ou enfoui dans un bloc de texte. C'est l'Extraction de colonnes personnalisées : vous saisissez les noms de colonnes souhaités dans votre tableau de sortie (par exemple « Invoice # », « Supplier », « Net Amount », « Tax », « Gross Total »), et l'IA analyse chaque document pour trouver ces valeurs, quel que soit le format.
Cette approche indépendante du format vous permet de traiter par lots des factures provenant de 50 fournisseurs différents — chacun avec sa propre conception de facture — et d'obtenir une feuille de calcul unifiée en sortie. L'étape d'extraction, qui représentait la plus grande part du temps de traitement manuel, passe de 4 minutes par facture (saisie manuelle) à moins de 10 secondes par page.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
La différence se cumule avec le volume. Une facture traitée manuellement prend environ 4 minutes rien que pour la saisie des données. Traiter 100 factures représente près de 7 heures de saisie. Avec l'extraction sémantique, ces 100 factures sont traitées en environ 17 minutes — et la sortie est déjà structurée en feuille de calcul, prête pour la validation.
Au-delà de l'extraction directe des champs, l'IA peut également effectuer des colonnes calculées pendant l'extraction — par exemple, vérifier que la somme des montants des lignes correspond au total de la facture, ou calculer la différence entre le montant du bon de commande et le montant facturé. Cela déplace le travail de validation en amont, dans l'étape d'extraction, en détectant les écarts avant qu'ils n'atteignent la file d'approbation.
Validation : détecter les erreurs avant qu'elles n'atteignent le grand livre
L'extraction produit des données. La validation décide si ces données sont correctes. C'est le point de passage où la plupart des pipelines perdent en productivité — et où le plafond de l'automatisation est plus bas que ne le suggèrent la plupart des argumentaires marketing des fournisseurs.
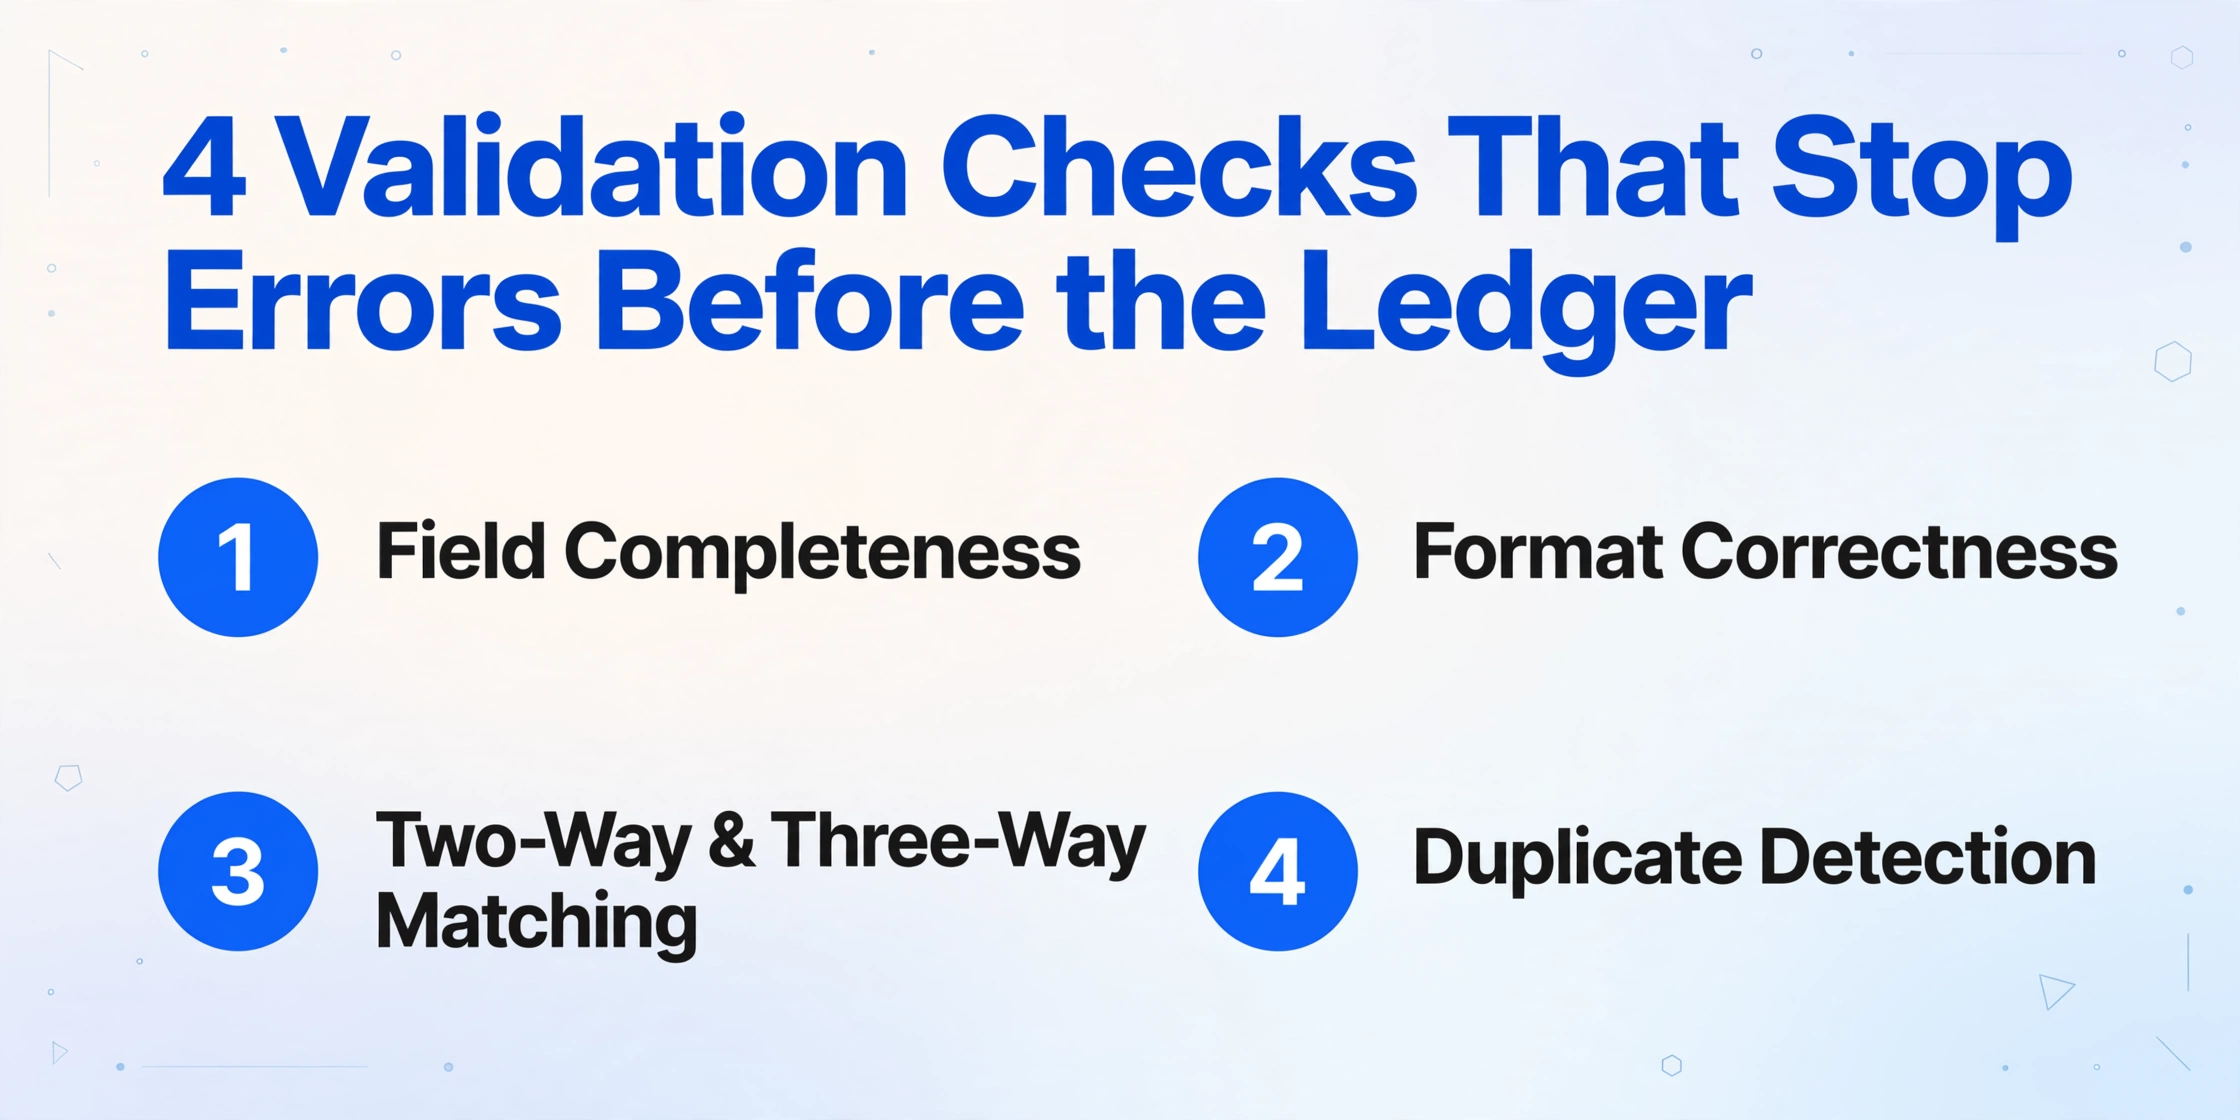
La validation en AP couvre plusieurs contrôles distincts :
- Exhaustivité des champs. Tous les champs obligatoires sont-ils présents ? Une date de facture manquante, un numéro d'identification fiscale du fournisseur manquant ou un total vide doivent arrêter la facture avant qu'elle n'atteigne l'ERP.
- Exactitude du format. Les dates sont-elles au format attendu ? Les montants en devises sont-ils analysés correctement chez les fournisseurs internationaux (qui peuvent utiliser des virgules comme séparateurs décimaux) ? L'IA a-t-elle correctement distingué la date de facture de la date d'échéance ?
- Rapprochement à deux et trois voies. Le montant de la facture correspond-il au bon de commande ? Les quantités correspondent-elles au bon de réception ? Le rapprochement à trois voies — bon de commande vs. réception vs. facture — est la référence absolue en matière de contrôle AP et une exigence de conformité SOX essentielle pour les sociétés cotées.
- Détection des doublons. Cette facture a-t-elle déjà été traitée ? Un doublon est rarement une copie à l'identique, donc un simple coup d'œil ne suffit pas à le repérer : la même facture arrive par deux canaux, ou est saisie deux fois sous un numéro qui diffère par un préfixe. Pour la détecter, il faut vérifier l'ensemble du lot contre lui-même, ce que la détection des factures en double automatise.
Le rapport Ardent Partners 2025 a révélé que 53 % des professionnels de l'AP citent les exceptions de facturation comme leur plus grand défi, avec un taux d'exception moyen de 14 %.⁴ Les équipes les plus performantes ont ramené ce taux à 9 %, mais cela signifie encore qu'environ 1 facture sur 10 nécessite une intervention manuelle.
Les exceptions qui subsistent nécessitent toujours une personne, mais les examiner ne doit pas signifier relire la facture. L'écran de révision d'ImageToTable.ai relie chaque cellule extraite à sa source : survolez la cellule « Montant net » et la région correspondante se met en surbrillance sur le scan original ; cliquez sur une région et elle vous ramène à la cellule qu'elle a remplie. Une vérification ponctuelle devient une affaire de quelques secondes au lieu d'une relecture complète, et l'auto-annotation peut générer les surlignages avant même que quiconque n'ouvre le fichier.
Ce qui change avec l'automatisation : Normalisation automatisée des formats, signalement des doublons et rapprochement de base avec les bons de commande. L'IA peut vérifier l'arithmétique (les totaux correspondent aux sommes des lignes), signaler les champs obligatoires manquants et normaliser les formats de date et de devise avant que la facture n'atteigne un humain.
Ce qui ne change pas : Le rapprochement à trois voies avec des données de réception incomplètes, la résolution des litiges fournisseurs concernant les prix, et le jugement de savoir si la description d'une ligne correspond au périmètre du bon de commande. Ces éléments nécessitent un contexte qui se trouve dans les fils de discussion, les contrats et la mémoire humaine — pas sur la page de la facture.
Export et comptabilisation : le pont vers votre logiciel comptable
C'est la transmission qui distingue un outil d'extraction utile d'un outil qui boucle réellement le cycle AP. Vous avez extrait et validé les données des factures. Elles doivent maintenant atterrir dans votre système comptable — QuickBooks, Xero, NetSuite, SAP, ou tout autre ERP utilisé par votre équipe financière. L'étape d'export est celle où la compatibilité des formats, la gestion des lots et la profondeur d'intégration déterminent si vous faites encore de la double saisie.
Le scénario idéal pour l'export est l'intégration directe : les données extraites circulent automatiquement vers votre logiciel comptable, créant une facture fournisseur avec les lignes, les codes fiscaux et les dates d'échéance. En pratique, la plupart des équipes AP de petites et moyennes tailles se situent quelque part entre :
- Saisie manuelle. Extraire vers Excel, puis saisir manuellement les mêmes données dans QuickBooks. Cela va à l'encontre du but de l'automatisation — vous avez gagné du temps sur l'extraction mais vous le dépensez en ressaisie.
- Import CSV/Excel. Exporter depuis l'outil d'extraction, formater la feuille de calcul pour qu'elle corresponde au modèle d'import de votre ERP, téléverser. Une amélioration, mais toujours une transmission manuelle avec des frictions de formatage.
- Écriture directe dans la feuille de calcul. Si votre flux de travail vit dans des feuilles de calcul, la sortie de l'extraction s'écrit directement dans Google Sheets ou Excel — sans étape intermédiaire d'export-import. Le module complémentaire Google Sheets d'ImageToTable.ai et l'export Excel sont conçus pour ce modèle : les données extraites s'ajoutent directement à votre feuille de travail.
La transmission d'export est l'endroit où la conception du pipeline compte le plus. Si votre outil d'extraction produit une sortie propre et structurée mais ne peut pas se connecter à votre système comptable, vous n'avez pas automatisé le pipeline — vous n'avez automatisé qu'une étape et créé une nouvelle tâche manuelle à la transmission suivante. Les données d'IOFM montrent que l'étape de saisie des données (extraction) consomme environ 4 minutes par facture manuellement, mais la comptabilisation et le rapprochement en aval ajoutent encore 3 à 4 minutes. Un outil qui automatise l'extraction mais force la comptabilisation manuelle ne résout que la moitié du problème.
Batch Export est essentiel ici. Traiter les factures individuellement — extraire une, exporter une, comptabiliser une — ne passe pas à l'échelle. Une conception Batch-First Processing signifie que vous téléversez 50 factures à la fois, extrayez les 50 en parallèle, validez le lot dans son ensemble et exportez une seule feuille de calcul ou un seul CSV avec les 50 lignes. Le passage de « les 50 extraites » à « les 50 comptabilisées » doit être une seule opération, pas 50. La forme pratique de cette opération, une ligne par facture dans un journal prêt au paiement plutôt que 50 exports séparés, est la création d'un journal des comptes fournisseurs à partir d'un téléversement par lot.
Les étapes humaines que l'automatisation ne remplace pas
Toutes les étapes du pipeline AP ne doivent pas être automatisées. Certaines exigent un jugement que l'IA actuelle ne fournit pas de manière fiable — et surtout, certaines comportent une responsabilité de conformité ou fiduciaire que les organisations ne devraient pas déléguer à un modèle.
L'étape d'approbation en est l'exemple le plus clair. Un responsable AP qui examine une facture d'équipement de 45 000 $ ne vérifie pas seulement que les chiffres s'additionnent. Il vérifie que l'équipement a bien été reçu, que le prix correspond au contrat négocié, que le budget dispose d'une marge et que l'achat a été dûment autorisé. Ce sont des décisions de gouvernance, pas des décisions de saisie de données. L'automatisation peut router la facture vers le bon approbateur et afficher le contexte pertinent (détails du PO, statut de réception, budget restant), mais elle ne devrait pas approuver le paiement. C'est pourquoi les données d'Ardent Partners montrent que le taux de traitement sans intervention des meilleurs de leur catégorie est de 49,2 %, et non de 100 % — les 50,8 % de factures qui reçoivent encore une intervention humaine incluent les approbations, la résolution des exceptions et les validations complexes qui bénéficient d'une supervision humaine.
Le codage GL et l'affectation des centres de coûts se situent dans une zone grise. L'IA peut suggérer un compte GL en fonction du fournisseur et de la description — et elle voit souvent juste pour les fournisseurs récurrents — mais les décisions de jugement concernant la capitalisation par rapport aux charges, ou la répartition d'une facture unique entre plusieurs centres de coûts, exigent toujours une personne des finances qui comprend le contexte commercial.
Le principe clé : automatiser les étapes mécaniques où les humains sont lents et sujets aux erreurs (lecture des champs, saisie des données, vérification des formats), et préserver les étapes de jugement où les humains apportent de la valeur (approbation, résolution des litiges, répartition stratégique). Le pipeline s'accélère non pas parce que les humains sont supprimés, mais parce qu'ils sont libérés des tâches pour lesquelles ils n'ont jamais été doués.
Où le pipeline se brise : fragmentation des formats et lacunes d'intégration
La plupart des échecs d'automatisation AP partagent une cause racine : le pipeline n'est aussi solide que son maillon le plus faible. Un outil qui extrait parfaitement les données des factures mais ne peut pas les exporter vers votre ERP est un pipeline cassé. Un flux de travail qui automatise l'ingestion et l'extraction mais laisse la validation entièrement manuelle crée toujours un goulot d'étranglement. Comprendre où les pipelines se brisent vous aide à évaluer les outils par rapport à votre flux de travail réel — et non par rapport à une démo qui ne montre que l'étape 2.
Les deux points de défaillance les plus courants :
Fragmentation des formats à l'étape d'extraction. C'est ce que l'utilisateur Reddit a décrit : une OCR qui fonctionne sur certains formats de fournisseurs mais échoue sur d'autres. L'OCR traditionnelle basée sur des modèles échoue ici car chaque nouveau format de fournisseur exige un nouveau modèle — et les fournisseurs industriels, les prestataires de services et les fournisseurs internationaux formatent tous leurs factures différemment. C'est précisément là que l'extraction par IA sémantique est transformatrice : en localisant les champs en fonction du sens plutôt que de la position, elle gère la variation de format à un coût marginal nul. Vous ne maintenez pas 200 modèles. Vous maintenez un ensemble de noms de colonnes.
Lacunes d'intégration à l'étape d'exportation. Les données sont extraites et propres, mais les intégrer dans l'ERP exige un reformatage, un mappage CSV manuel ou — dans le pire des cas — une ressaisie. La transition d'exportation est l'endroit où le traitement par lots devient essentiel : traiter 50 factures via l'extraction puis exporter les 50 en une seule opération élimine 49 répétitions du même flux d'exportation. Pour les équipes qui utilisent Google Sheets comme principal outil de suivi AP, l'approche par module complémentaire (les données extraites sont écrites directement dans la feuille) supprime entièrement la transition d'exportation.
Le test du pipeline. Lorsque vous évaluez un outil d'automatisation AP — qu'il s'agisse d'une plateforme d'entreprise comme Coupa ou Medius, ou d'un outil d'extraction léger — confrontez-le aux cinq étapes de transfert de votre flux de travail réel : ingestion, extraction, validation, export et approbation. Un outil qui obtient 10/10 en extraction mais 0/10 en export crée un nouveau goulot d'étranglement là où un ancien a été supprimé. La vitesse totale du pipeline reste limitée par l'étape la plus lente.
FAQ
ImageToTable.ai s'intègre-t-il directement avec QuickBooks ou NetSuite ?
ImageToTable.ai ne propose pas d'intégrations ERP natives. Les données extraites sont exportées en Excel (XLSX), CSV, ou directement dans Google Sheets via l'extension. Pour les utilisateurs de QuickBooks et Xero, cela signifie que vous exportez le lot vers Excel et utilisez la fonction d'import de votre logiciel comptable — une étape de 30 secondes en général. Pour les utilisateurs de NetSuite et SAP, le format CSV correspond aux modèles d'import standard. Si votre ERP nécessite une intégration au niveau API, vous aurez besoin d'une étape middleware ou d'un outil conçu pour ce transfert spécifique.
Combien de factures puis-je traiter en un seul lot ?
L'offre gratuite permet de traiter un nombre limité de fichiers, et les formules payantes évoluent à partir de là : Basic ($9/mois) convient aux équipes à volume modéré, Pro ($19/mois) gère un débit plus élevé, et Max ($59/mois) est conçu pour le traitement intensif de lots avec l'allocation de crédits la plus élevée. Chaque formule payante fixe également un plafond par lot — 100 fichiers sur Basic, 200 sur Pro et 300 sur Max — et chaque fichier d'un lot consomme un crédit. Un lot de 50 factures consomme 50 crédits et reste largement dans les limites de chaque formule payante. Le traitement lui-même est parallélisé : les factures d'un lot sont extraites simultanément, donc 50 factures sont traitées à peu près dans le même temps réel que 5.
Peut-il traiter des factures manuscrites ou des scans papier ?
Oui. Le modèle de vision linguistique qui alimente l'extraction lit l'écriture manuscrite, le texte imprimé, les tableaux et les cases à cocher. Pour les factures papier, vous devrez d'abord les scanner ou les photographier — le téléversement accepte les formats JPG, PNG, PDF et WebP. La précision de l'écriture manuscrite dépend de la lisibilité : une écriture claire en caractères d'imprimerie est extraite de manière fiable ; une écriture cursive rapide avec de nombreux barrés sera moins précise et pourra nécessiter une vérification manuelle lors de la validation.
Que se passe-t-il avec les factures multi-devises — peut-il mélanger les montants ?
L'IA lit le symbole ou le code de devise directement sur la facture (USD, EUR, GBP, JPY, etc.) et l'inclut dans le résultat extrait. Elle distingue la devise de la facture des montants de taxe indiqués en devise locale. Pour le post-traitement, vous pouvez utiliser des colonnes calculées pour appliquer un taux de conversion si nécessaire — par exemple, en définissant une colonne qui multiplie le montant extrait par un taux de change fixe. L'outil ne convertit pas automatiquement les devises, ce qui est le comportement le plus sûr : la conversion de devises doit être une étape explicite, pas une décision prise silencieusement par l'IA.
Dois-je configurer des modèles pour chaque fournisseur ?
Non. C'est la différence fondamentale entre l'OCR basé sur des modèles et l'extraction pilotée par l'IA. Avec ImageToTable.ai, vous définissez les noms de colonnes que vous souhaitez extraire — « Numéro de facture », « Fournisseur », « Numéro de bon de commande », « Montant net », « Taxes », « Total » — et l'IA trouve ces champs sur chaque facture, quel que soit le format du fournisseur. Vous pouvez enregistrer des configurations de colonnes comme modèles réutilisables dans l'outil, mais ces modèles définissent ce qu'il faut extraire, pas où. Un nouveau fournisseur avec un format de facture totalement inconnu ne nécessite aucune configuration préalable, au-delà du simple téléchargement du fichier.
Comment faire pour que les fournisseurs envoient des factures dans un format que l'outil peut lire ?
Vous n'avez pas besoin de changer la façon dont les fournisseurs envoient leurs factures. L'outil accepte les PDF, les images et les captures d'écran — des formats que presque tous les fournisseurs utilisent déjà. Si vous souhaitez simplifier davantage l'étape d'ingestion, utilisez la fonction Lien de collecte : générez une URL partageable, envoyez-la à vos fournisseurs, et ils téléversent les factures directement dans votre file de traitement. Aucune inscription ni connexion requise de leur côté. Cela élimine entièrement l'étape de recherche de pièces jointes dans les e-mails de votre flux de travail.
Quelle précision puis-je attendre, et quand dois-je vérifier les résultats ?
Les données de factures imprimées atteignent jusqu'à 99 % de précision pour les champs courants (dates, montants, noms de fournisseurs). L'écriture manuscrite et les documents mal numérisés seront moins précis. En règle pratique : pour les fournisseurs récurrents avec des factures PDF propres, vérifiez une facture sur dix lors de la validation. Pour les nouveaux fournisseurs, les factures manuscrites ou les factures avec des tableaux de lignes complexes, examinez l'extraction complète avant de la comptabiliser. L'étape de validation existe pour une raison — l'extraction automatisée réduit la charge de vérification de « lire chaque champ de chaque facture » à « vérifier les cas particuliers », mais elle n'élimine pas entièrement le besoin d'une relecture humaine.
Le pipeline de saisie des données AP comporte cinq étapes de transfert. En automatiser deux est un début. En automatiser quatre — en réservant la cinquième au jugement humain — c'est là que se situe la différence de coût mesurable entre 9,40 $ et 2,78 $ par facture.
Testez l'étape d'extraction sur vos propres factures — voyez à quel point elle modifie réellement le pipeline.
Traitez vos factures gratuitementAucune carte de crédit requise. Les 50 premières pages de factures sont gratuites.