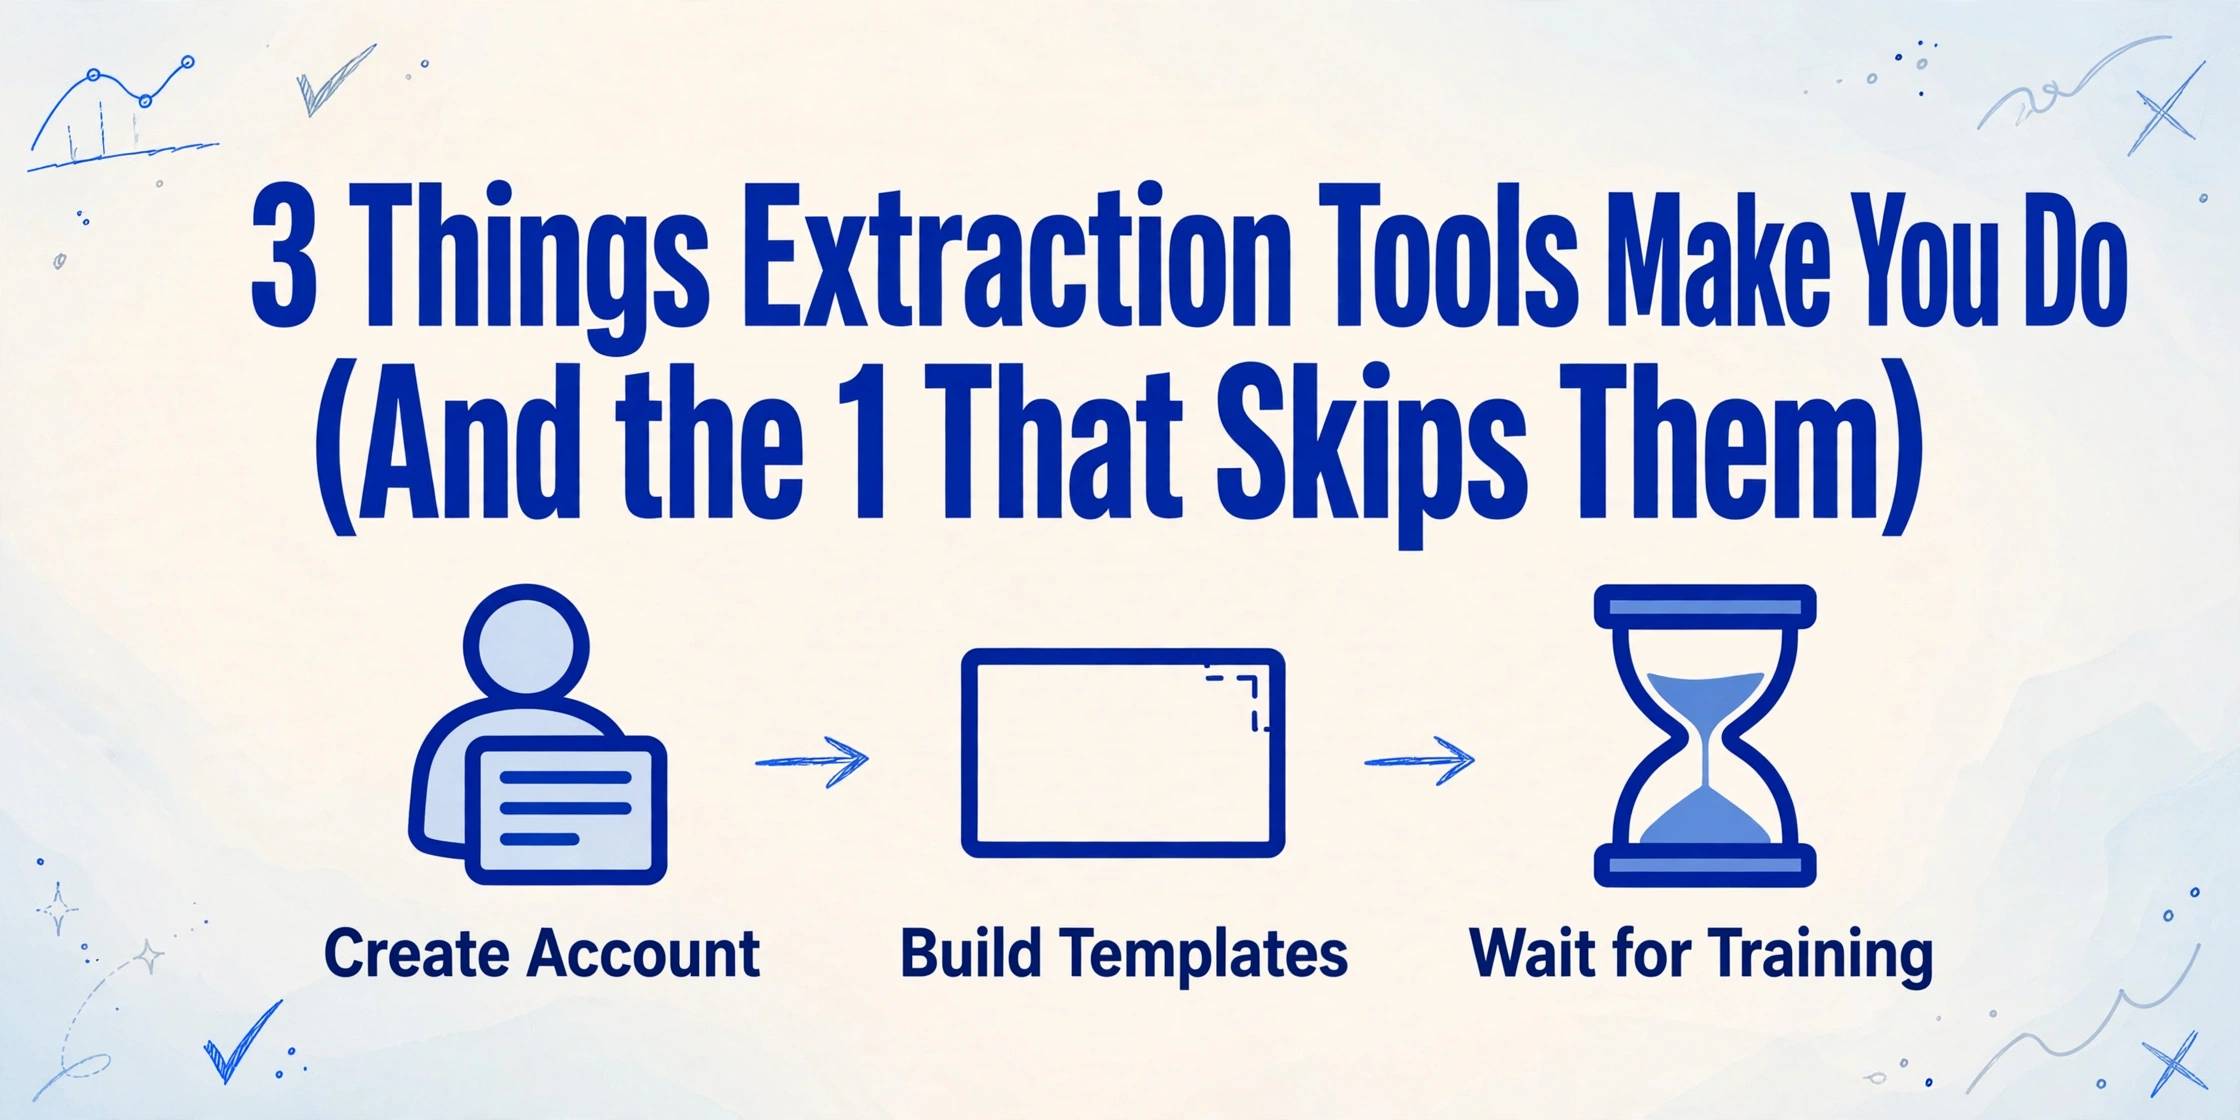
抽出ツールがあなたに強いる3つの作業
そしてそれをスキップする1つのツール
ほとんどのドキュメント抽出ツールには暗黙の前提があります。それは、価値を得る前に設定作業を行う意思があるということです。数分の設定ではなく、数時間、場合によっては数日かかります。ここでは、市場のほぼすべての抽出ツールが1行のデータを生成する前に要求する3つのこと、それぞれに実際にかかる時間、そしてそれらすべてをスキップできるように設計された1つのツールをご紹介します。
重要なポイント
- 抽出が始まる前に、ほとんどのツールは3つの設定ステップを要求します。アカウント登録、ベンダーごとのテンプレート作成、モデルのトレーニング完了までの数時間の待機です。
- 200のベンダーを抱える場合、テンプレートのメンテナンスに半週間かかり、ベンダーのフォーマット変更のたびに抽出パイプラインが静かに壊れます。
- 3つすべてをスキップできます。ブラウザを開き、任意の請求書をアップロードし、列に名前を付けるだけで、登録もテンプレートもトレーニングもなしに構造化データが得られます。
ステップ1: テスト前にアカウントを作成する
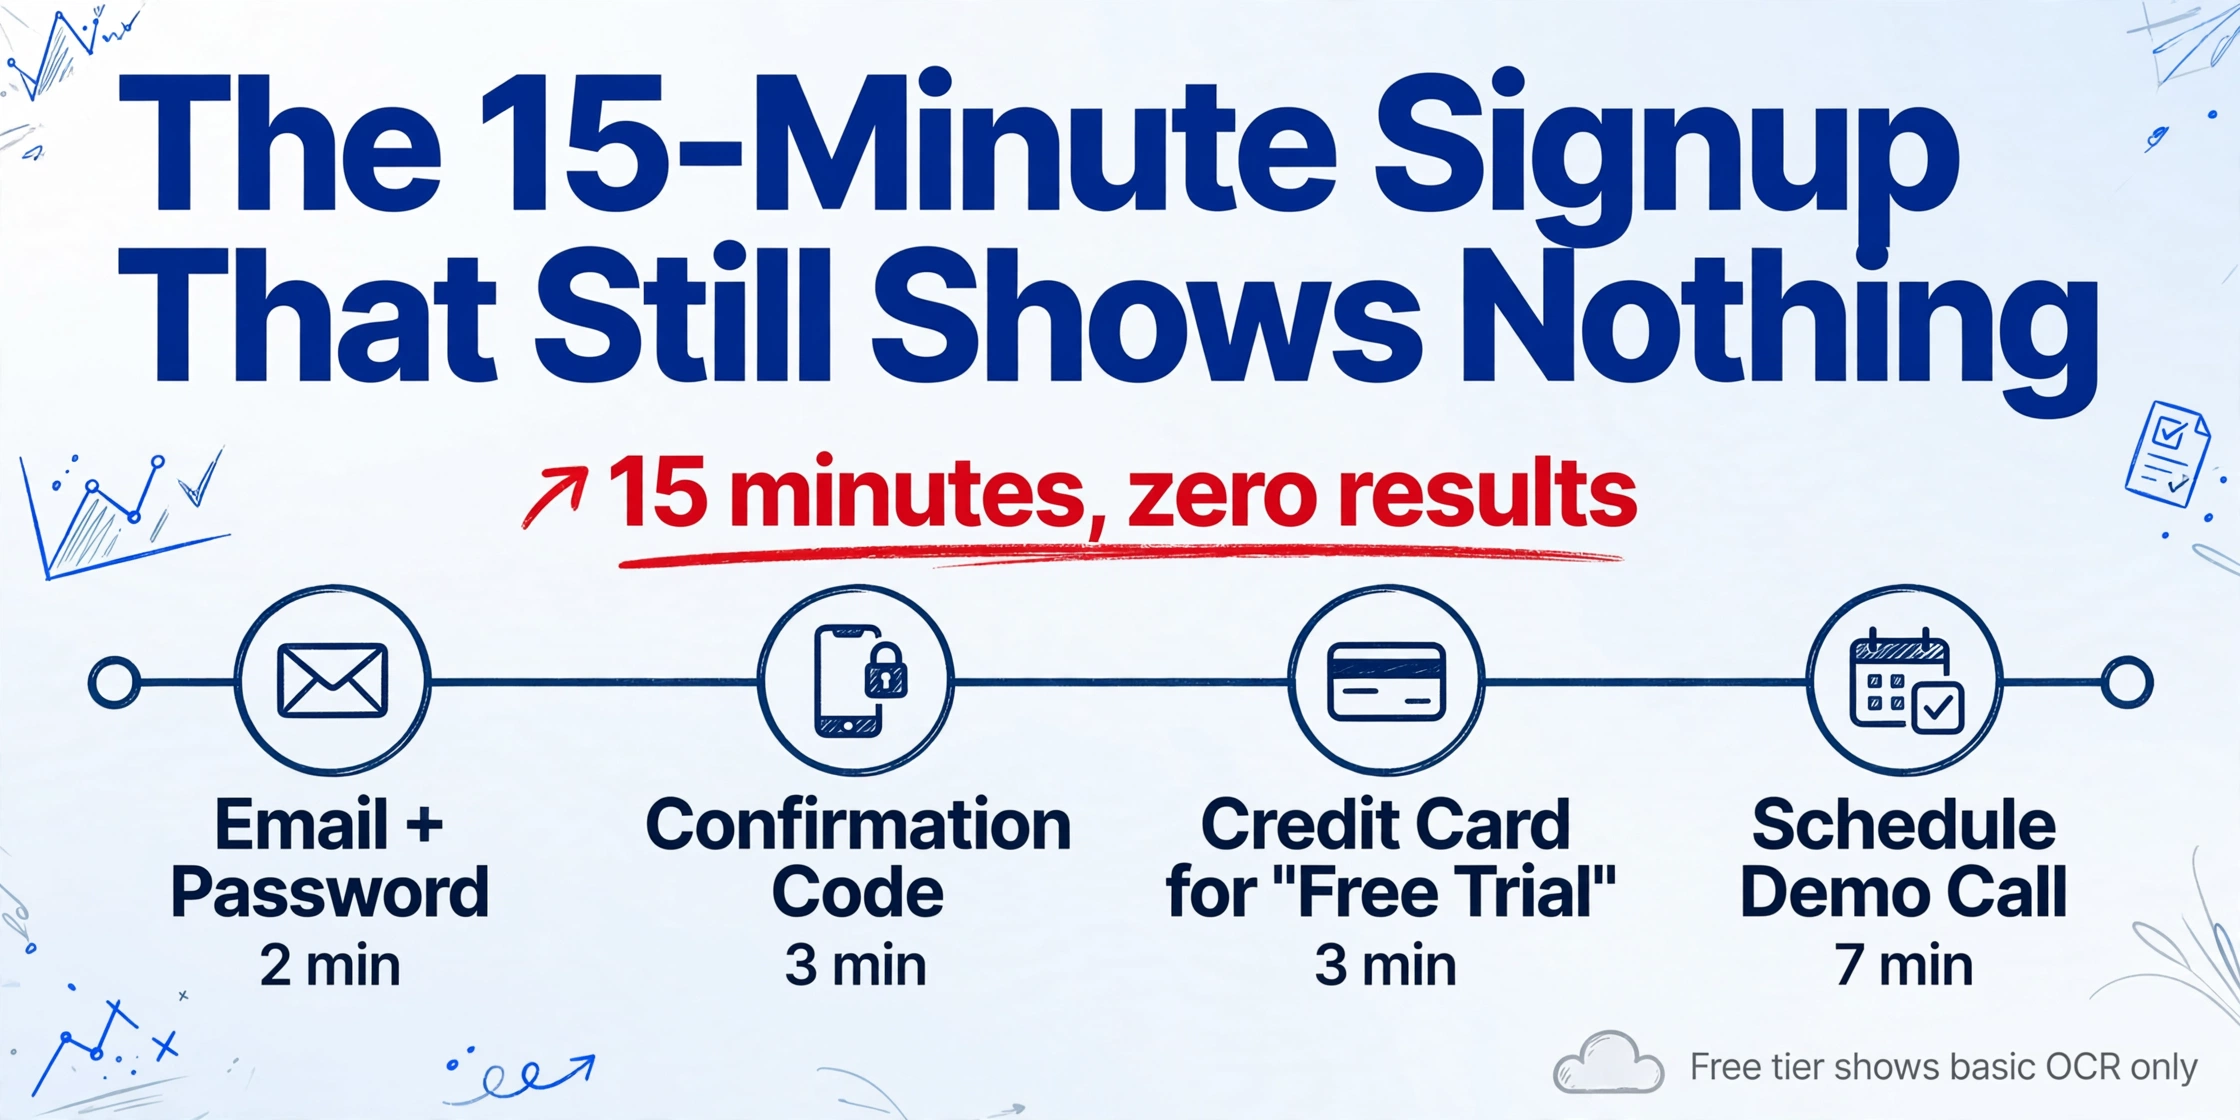
ほとんどの抽出ツールが最初に求めるのはドキュメントではなく、メールアドレスです。そしてパスワード、確認コード。時には「無料トライアル」のためのクレジットカードまで求められます。
登録は3つのステップの中で最も短く、おそらく5分程度ですが、それは設計思想を表しています。ツールは価値を証明する前に、あなたをリードとして獲得したいのです。ファイルを1つもアップロードせず、実際のドキュメントで抽出がどう機能するかも確認しないうちに、コミットさせられるのです。
さらに悪いことに、摩擦は登録で終わりません。多くのツールは抽出品質を有料プランの背後に置いているため、無料ティアでは基本的なOCRしか見られず、本当のAI抽出はサブスクリプションの壁の向こうにあります。アカウント設定を完了しても、目的の機能をテストできないことに気づくだけです。
Redditのr/Accountingで、ツールを評価中の簿記係がそのフラストレーションを要約しています。「何かにコミットする前に、自分の請求書で機能するかどうか確認したいだけなんだ。」それは言うほど簡単ではありません。ほとんどのツールは「コミット前にお試し」のステップをプロセス全体で最も長い部分にしているからです。
登録自体は5分です。しかし隠れたコストはコンテキストスイッチングです。ツールのサインアップページを開き、メールに切り替えて確認し、また戻って組織情報を入力し、場合によってはデモ通話を予約する。最初のドキュメントをアップロードする頃には15分が経過し、まだ結果は1つも見えていません。
ステップ2:ドキュメントを送ってくるすべてのベンダー向けにテンプレートを作成する
テンプレートベースのツール(サンプル文書の各フィールドに矩形を描画するタイプ)は、抽出のオンボーディングプロセスにおいて最大の時間の無駄となります。
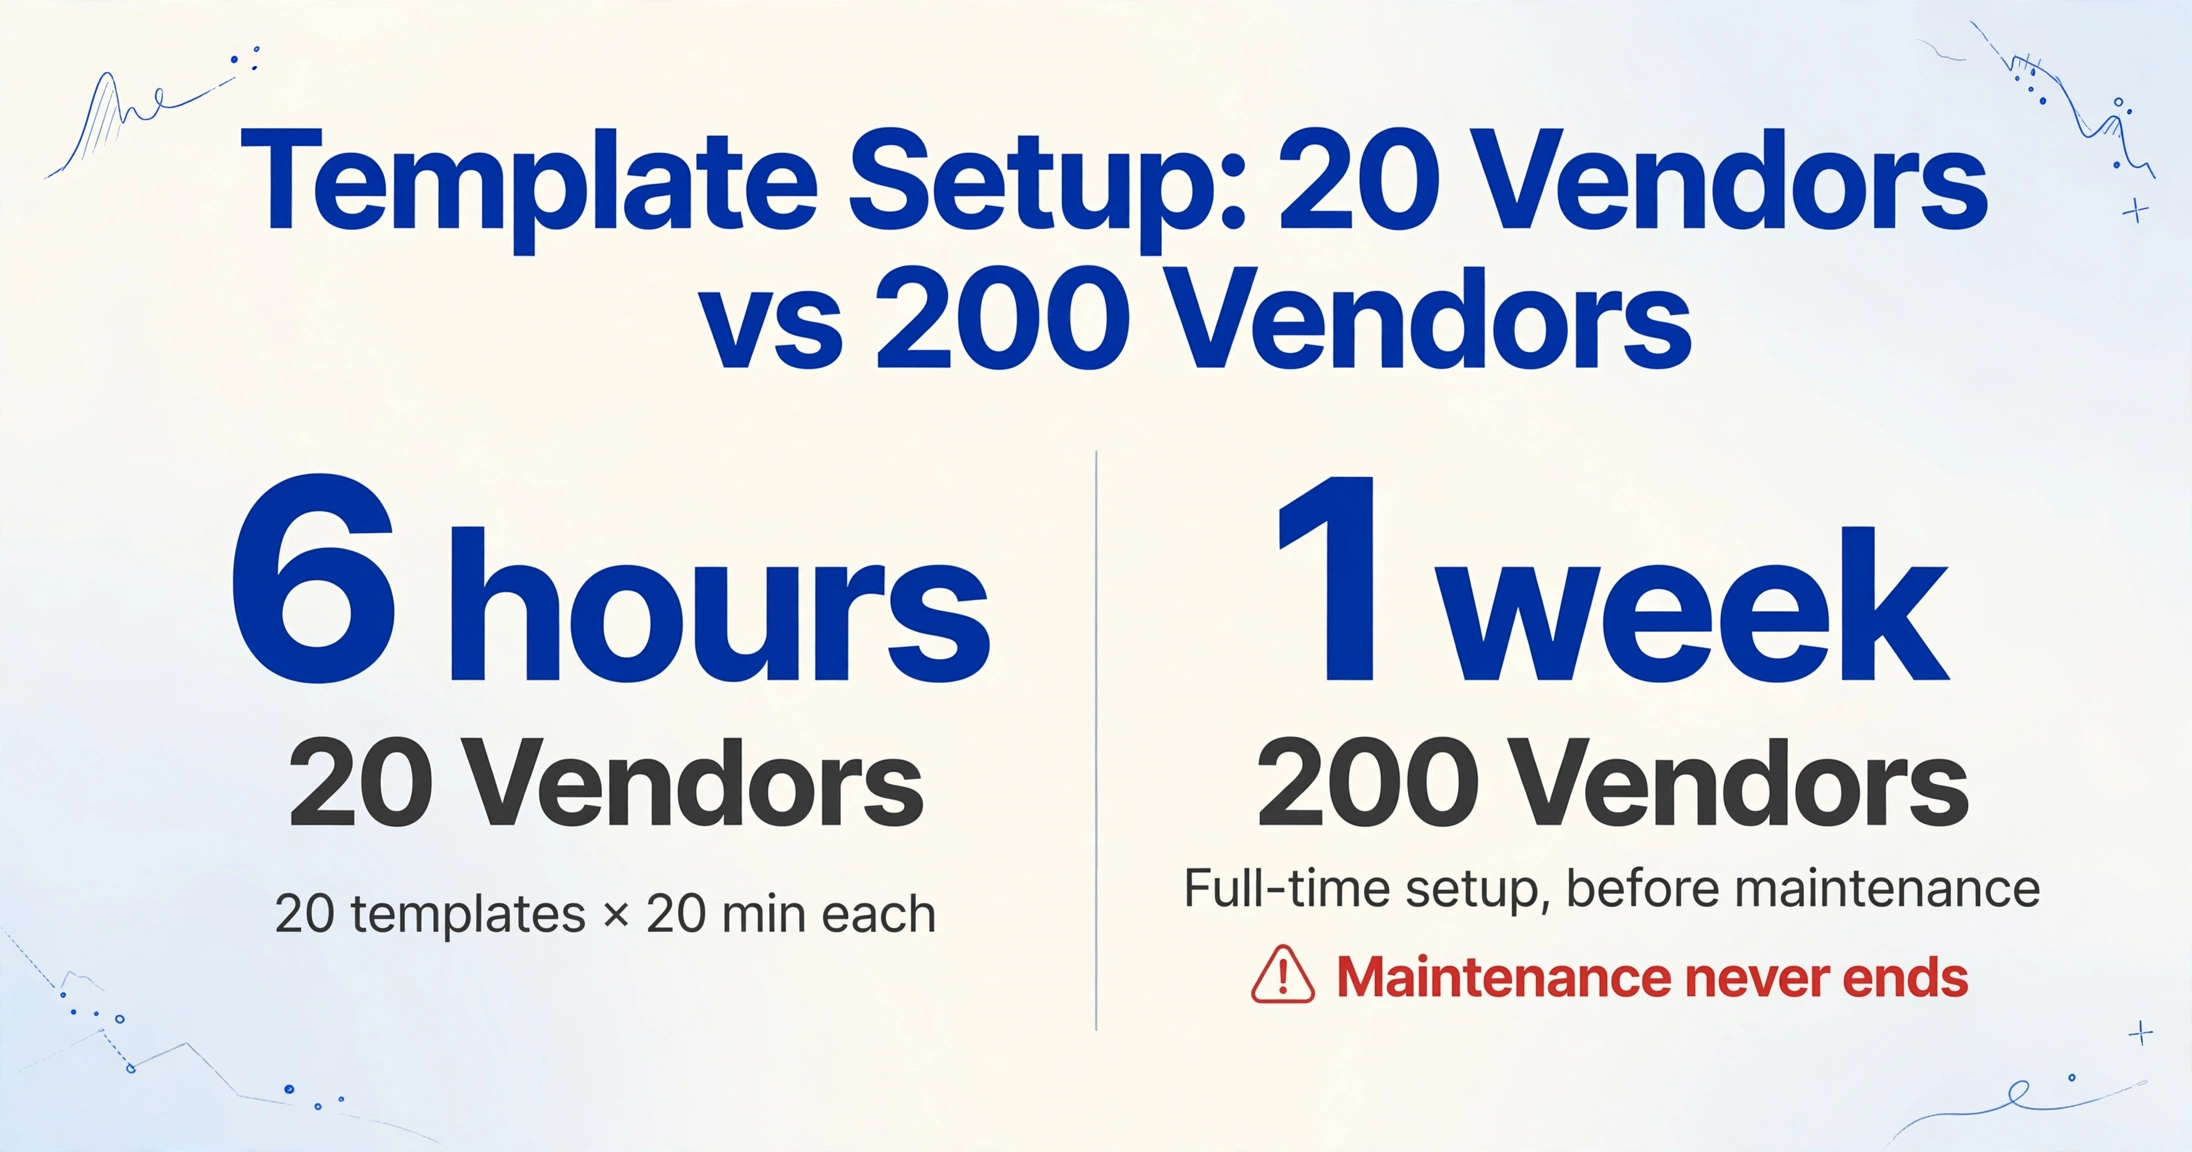
計算してみましょう。1つのテンプレートの設定には15〜30分かかります。サンプル文書をアップロードし、請求書番号の領域を描画し、日付の領域を描画し、ベンダーの領域を描画し、合計金額の領域を描画し、そのベンダーの最近の請求書数件でテストし、不一致を修正し、繰り返す。ベンダー1社あたり約20分です。
それを掛け算してみましょう。取引先が20社の小規模企業は、20件のテンプレート設定が必要です。システムが本番稼働するまでに、矩形を描画するだけで約6時間かかります。取引先が200社の中堅企業なら?初期設定だけで丸1週間分の工数です。しかもメンテナンスは終わりません。
ベンダーが請求書をリニューアルした場合(新しいERPシステム、ブランド変更したテンプレート、コンプライアンス項目の追加など)、座標ベースのテンプレートは壊れます。エラーは発生しません。古いピクセル位置に存在するテキストを黙って抽出するだけです。配送先住所が日付列に入り、小計が税額の代わりに入る。照合で不一致が検出されるまで、結果はもっともらしく見えますが、それは数日後かもしれません。
Docsumoの業界調査を引用した独立系分析によると、テンプレートベースの文書処理を利用する組織は、新しい文書形式ごとに抽出ルールの設定、テスト、検証に平均6〜8週間を費やしています。定期的に形式が変更される大規模なベンダーベースでは、継続的なメンテナンスコストが初期導入コストに匹敵します。
あるユーザーはr/automationで、異なる請求書レイアウト用のOCRテンプレートを1年間メンテナンスした経験についてこう語っています。「ベンダーがフォーマットを変更するとすぐに、メンテナンスが完全に悪夢になりました」。別のコメント投稿者はr/Accountingでより率直に述べています。避けるべき主なものは「ベンダーごとにテンプレートを設定する必要があるもの — 異なる形式を送ってくる複数のクライアントがいると、節約できる時間よりも多くの時間を消費します」。
ステップ3:モデルのトレーニング完了を待つ
テンプレートを超えて、機械学習ベースの抽出(データから学習すると主張する「最新」のツール)に移行した場合、待ち時間の種類が変わるだけです。
これらのプラットフォームでは、矩形を描く必要はありません。代わりに、ラベル付けされたトレーニングデータ(どの値がどのフィールドに対応するかを手動でマークした、50〜200件のサンプルドキュメント)を求められます。サンプルが多いほど、新しいドキュメント上のフィールド位置を予測するモデルの精度が向上します。ラベル付け自体に10〜20時間の集中的な作業が必要です。その後、モデルのトレーニング中は待機します(ボリュームにもよりますが、数時間から1日以上)。
その魅力は明らかです。一度トレーニングすれば、モデルはそのドキュメントタイプを自動的に処理します。しかし、ほとんどのチームにとって現実は、トレーニングは一度きりのイベントではないということです。レイアウトが大幅に異なる新しいベンダーが現れるたびに、追加のサンプルが必要になります。ベンダーのフォーマット変更のたびに再トレーニングが必要です。フォーマットが変わるとモデルの予測は静かに劣化し、下流で誰かがエラーに気付くまでわかりません。
これが第2世代アプローチの中心的な皮肉です。テンプレートを排除するはずのツールが、モデルメンテナンスに置き換えたのです。ゾーンを描く必要はなくなりましたが、サンプルの収集、フィールドのラベル付け、フォーマット変更への再トレーニング、精度ドリフトの監視が必要になります。作業は「ドキュメント単位」から「トレーニングサイクル単位」に移行しましたが、なくなりはしませんでした。
一部のツールがなぜトレーニングデータを必要とし、他のツールが不要なのかを詳しく知りたい方は、テンプレート不要の抽出に関する解説をご覧ください。ピクセル位置でドキュメントを読むツールと、意味で読むツールのアーキテクチャ上の違いを説明しています。
請求書の「合計金額」を見つけるために50件のラベル付きサンプルを必要とするドキュメント抽出ツールは、ドキュメントを読んでいるのではありません。その値がページ上のどこに配置される傾向があるかについての確率分布を学習し、次の請求書がほぼ同じ場所に配置されることを期待しているのです。
代替案:3つのステップをすべて省略するとどうなるか
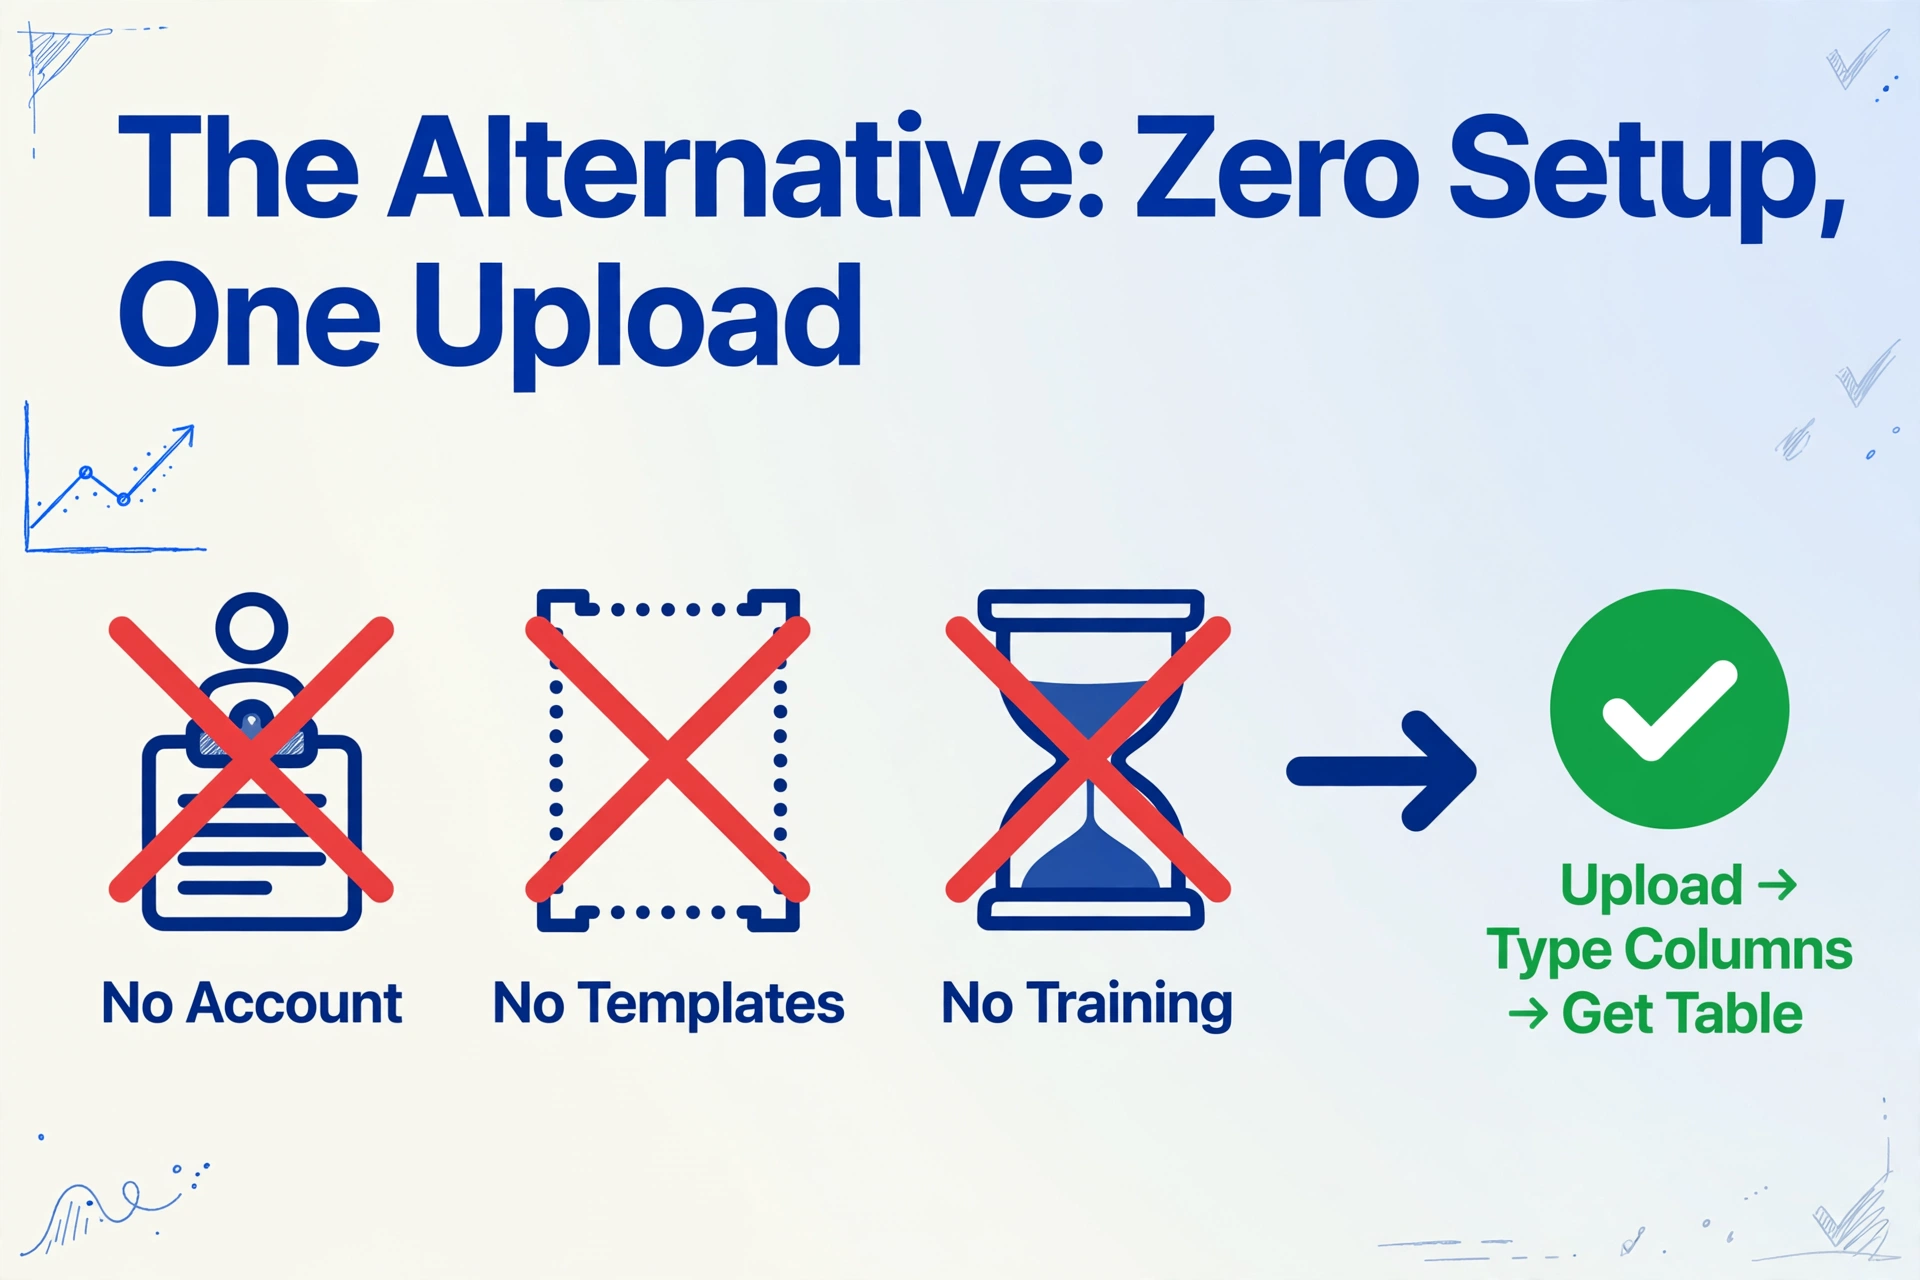
同じワークフローを、別の前提で作られたツールで試してみましょう。その前提とは、ユーザーが設定のために来ているのではなく、抽出のために来ている、というものです。
アカウントは作成しません。ページを開き、ドキュメントをアップロードして、必要な列名を入力するだけです。「請求書番号」「日付」「ベンダー」「小計」「税額」「合計」のように。AIはドキュメントを読み取りますが、ピクセル座標ではなく、各フィールドが文脈で何を意味するかを理解して、それらの列を埋めていきます。それだけです。登録ゲートなし。描くべきテンプレートなし。ラベル付けする学習サンプルなし。モデルが学習するのを待つ必要もありません。
このアプローチ — AIデータ入力をビジュアル大規模言語モデルで実現する方法 — は、抽出をパターンマッチングの問題ではなく、意味推論の問題として扱います。モデルは、請求書がどのようなものか、日付が通常どこに表示されるか、合計がどのようにフォーマットされるか、ベンダー名フィールドが文脈でどのように読まれるかをすでに知った状態で提供されます。あなたの仕事はモデルに教えることではなく、フォーマットに関係なくすべてのドキュメントに対して、あなたが望むものを一度だけ伝えることです。
以下でお試しください。任意の請求書をアップロードし、列名を入力すれば、3つのステップを一切踏むことなく、抽出がリアルタイムで行われるのを確認できます。
ファイルは安全に処理され、保存されません。
処理は標準的なビジネスドキュメントの場合、1ページあたり5〜10秒かかり、画質の良い印刷テキストでは最大99%の精度を実現します。バッチモードでは、複数のドキュメントを1つのスプレッドシートに統合します。20の異なるベンダーから20件の請求書をアップロードすると、ベンダーごとの設定なしで、すべてを含む1つのテーブルが得られます。
初日以降も重要な理由
3ステップの税は、単なる初期費用ではありません。毎回発生するコストです。新しいベンダーがパイプラインに加わるたび、既存のベンダーが文書形式を更新するたび、まだ設定していない文書タイプを抽出する必要があるたびに、再び支払うことになります。
200のアクティブベンダーを抱える企業では、テンプレートのメンテナンスだけでパートタイムの役割になります。2,000ベンダーでは専任ポジションとなり、抽出データを実際に活用するのではなく、テンプレートを維持するだけの仕事になります。手作業を排除するはずのツールが、新たな手作業を生み出したのです。
代替案であるテンプレート不要、トレーニング不要、アカウント不要の抽出は、初日だけでなく、メンテナンス負債を蓄積せずにスケールします。20ベンダーでも200ベンダーでも、ワークフローは同じです。文書をアップロードし、列名を指定し、表を取得するだけ。形式が変わっても抽出は壊れません。AIが座標に固定されたり、古くなる統計パターンに依存したりしないからです。
既存のツールを置き換える必要はありません。今すぐ1バッチの文書で試せます。セットアップに1週間かけることなく、1ワークフローサイクルで違いを実感できます。
よくある質問
これら3つのステップをすべてスキップできるツールはありますか?
はい、ただし抽出市場ではまだ少数派です。2023年以前に構築されたほとんどのツールは、テンプレートまたはモデルトレーニングに依存しています。その基盤アーキテクチャがゼロショット文書理解をサポートしていないからです。ImageToTable.aiは、ClaudeやGPT-4Vと同じクラスのビジュアルLLMを基に初日から構築されました。つまり、ピクセル座標や統計パターンではなく、意味理解によって文書を読み取ります。トレードオフは1ページあたりのコストです。LLM推論は従来のOCRやオンプレミスの統計モデルより高価です。しかし、月に数百から数千の文書を処理するほとんどのチームにとって、排除されたセットアップとメンテナンスの時間が、ページあたりのコスト差を上回ります。
テンプレートやトレーニングなしでの抽出精度は?
標準的なビジネス文書(請求書、領収書、注文書、銀行取引明細書)の印刷テキストで、画質が良好な場合、最大99%の精度です。精度は主に、画像品質(照明、焦点、解像度)、文書の複雑さ(密集したマルチカラム表、混在フォント)、およびフィールドの明確さ(明確なラベル vs. 暗黙的またはラベルなし)に依存します。手書きコンテンツや低品質スキャンでは精度が低下します。重要な財務書類については、新しい文書タイプからの最初の数回の抽出をスポットチェックすることをお勧めします。これは、トレーニングの有無にかかわらず、あらゆる抽出ツールで行うべき慣行です。
ゲストモードは機密性の高い財務データを含む文書に対して安全ですか?
ImageToTable.aiは、抽出のためにメモリ上で文書を処理し、アップロードされたファイルを保存しません。各処理セッションは独立しており、ファイルは保持、インデックス化、またはAIのトレーニングに使用されることはありません。履歴の永続化、バッチ管理、テンプレートプリセットが必要なチームは、無料アカウントを作成することで、抽出ワークフローを変更せずにこれらの機能を追加できます。ゲストモードとアカウントモードは同じ抽出エンジンと同じセキュリティアーキテクチャを使用しており、唯一の違いは処理履歴がアカウントに保存されるかどうかです。