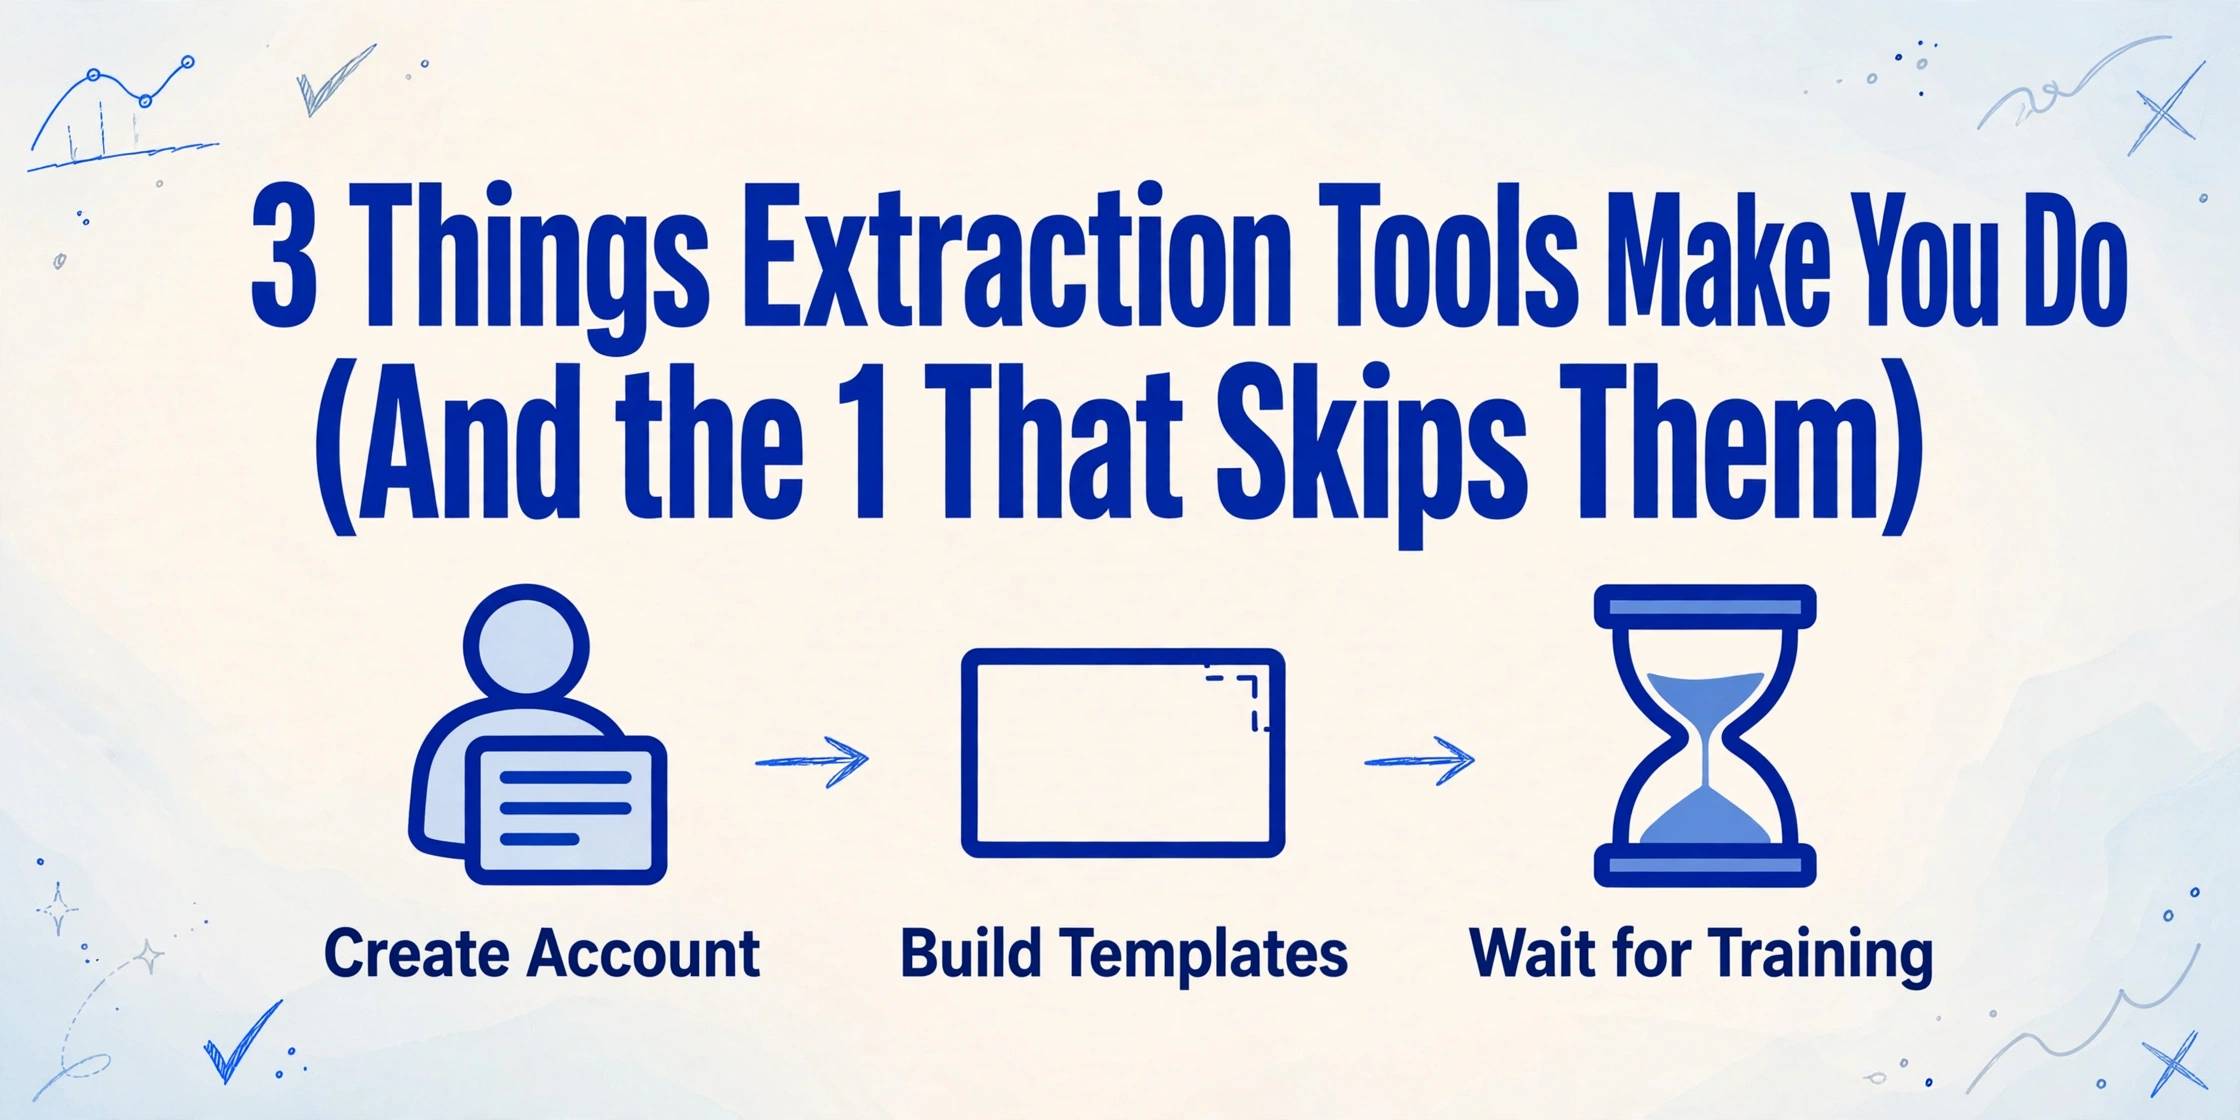
3 choses que les outils d'extraction vous imposent
Et celui qui les évite
La plupart des outils d'extraction de documents partagent une hypothèse tacite : que vous êtes prêt à faire un travail de configuration avant d'obtenir la moindre valeur. Pas quelques minutes de configuration — des heures, parfois des jours. Voici les trois choses que presque tous les outils d'extraction du marché vous demandent avant de produire la moindre ligne de données, ce que chacune coûte en temps réel, et l'outil conçu pour les éviter toutes.
Points clés
- Avant même que l'extraction ne commence, la plupart des outils exigent trois étapes de configuration — créer un compte, créer des modèles par fournisseur et attendre des heures la fin de l'entraînement du modèle.
- Avec 200 fournisseurs, la maintenance des modèles consomme une demi-semaine de travail et chaque changement de format d'un fournisseur casse silencieusement votre pipeline d'extraction.
- Évitez les trois — ouvrez un navigateur, importez n'importe quelle facture, nommez vos colonnes et obtenez des données structurées sans inscription, modèles ni entraînement.
Étape 1 : Créez un compte avant de pouvoir tester quoi que ce soit
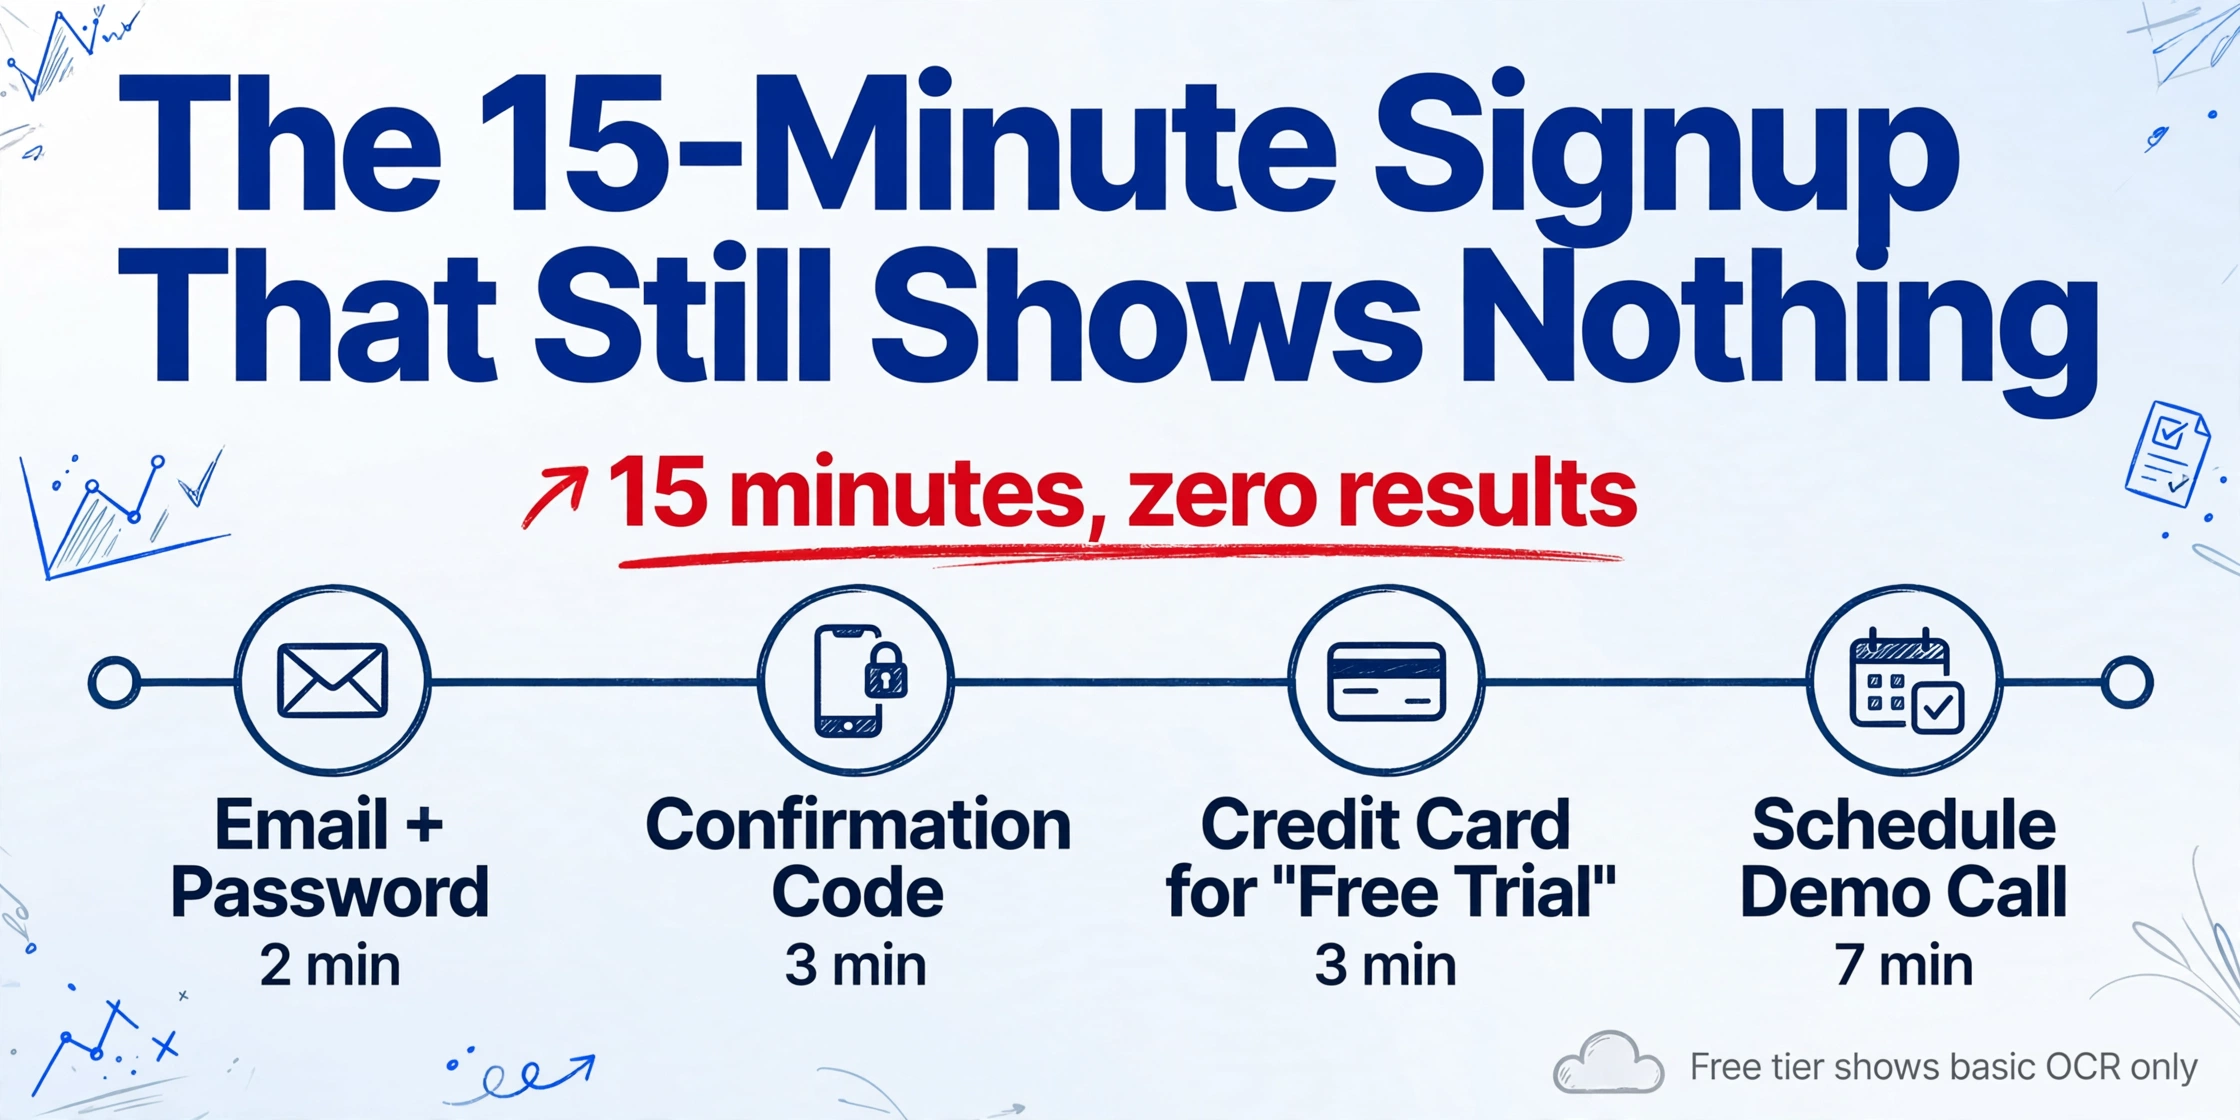
La première chose que la plupart des outils d'extraction demandent n'est pas un document, mais une adresse e-mail. Et un mot de passe. Et un code de confirmation. Parfois une carte bancaire pour l'« essai gratuit ».
L'inscription est la plus petite des trois étapes — environ 5 minutes — mais elle traduit une philosophie de conception : l'outil veut vous capturer comme prospect avant de prouver sa valeur. Vous vous engagez avant même d'avoir téléversé un seul fichier ou vu comment l'extraction traite vos documents réels.
Pire, la friction ne s'arrête pas à l'inscription. De nombreux outils réservent leur qualité d'extraction aux offres payantes : l'offre gratuite vous montre un OCR basique, tandis que la véritable extraction par IA reste derrière un mur d'abonnement. Vous terminez la création de compte pour réaliser que vous ne pouvez toujours pas tester la fonctionnalité qui vous intéressait.
Sur r/Accounting, un comptable évaluant des outils a résumé la frustration : « Je veux juste voir si ça fonctionne sur mes factures avant de m'engager. » C'est plus difficile qu'il n'y paraît — la plupart des outils font de l'étape « essayer avant de s'engager » la plus longue du processus.
L'inscription en elle-même prend 5 minutes. Mais le coût caché, c'est le changement de contexte : vous ouvrez la page d'inscription de l'outil, passez à votre e-mail pour confirmer, revenez, remplissez les détails de votre organisation, planifiez peut-être un appel de démo. Le temps de téléverser votre premier document, 15 minutes se sont écoulées et vous n'avez toujours pas vu de résultat.
Étape 2 : Créez un modèle pour chaque fournisseur qui vous envoie des documents
Les outils basés sur des modèles — ceux où vous dessinez des rectangles autour de chaque champ sur un document d'exemple — représentent le plus grand gouffre de temps dans le processus d'intégration de l'extraction.
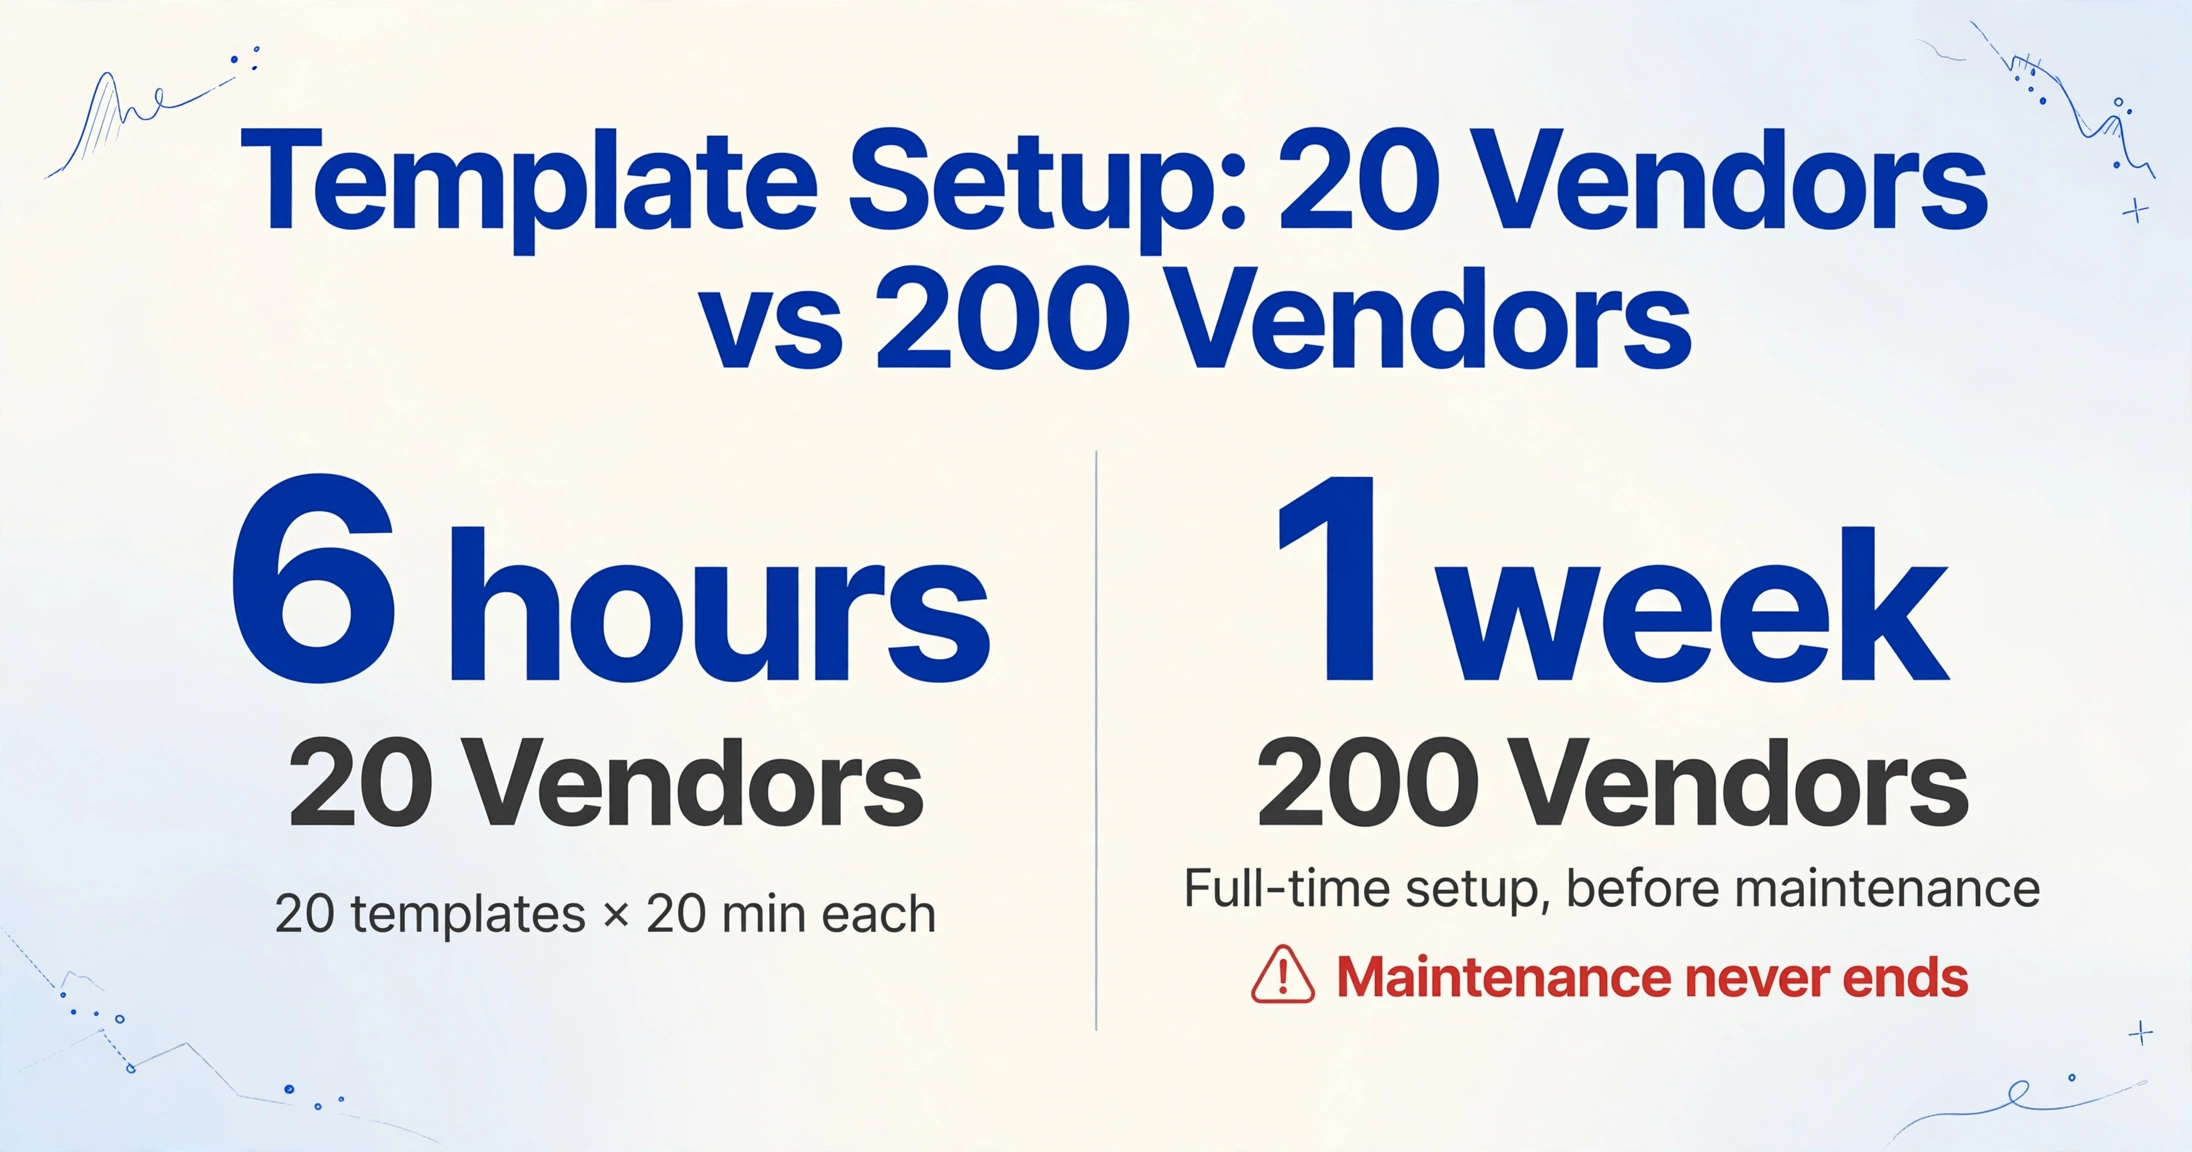
Voici le calcul. Configurer un modèle prend 15 à 30 minutes : téléverser un document d'exemple, dessiner la zone du numéro de facture, en dessiner une autre pour la date, une autre pour le fournisseur, une autre pour le total, tester sur quelques factures récentes de ce fournisseur, corriger les écarts, recommencer. Vingt minutes, à peu de chose près, par fournisseur.
Maintenant, multipliez. Une petite entreprise avec 20 fournisseurs réguliers fait face à 20 configurations de modèles — environ 6 heures à dessiner des rectangles avant que le système soit prêt pour la production. Une entreprise de taille intermédiaire avec 200 fournisseurs ? C'est une semaine entière du temps de quelqu'un, rien que pour la configuration initiale. Et la maintenance ne s'arrête jamais.
Quand un fournisseur remanie sa facture — nouveau système ERP, modèle remanié, champs de conformité ajoutés — le modèle basé sur les coordonnées casse. Il ne renvoie pas d'erreur. Il extrait silencieusement le texte qui occupe désormais les anciennes positions en pixels. Une adresse de livraison atterrit dans votre colonne de date. Un sous-total remplace votre montant de taxe. Le résultat semble plausible jusqu'à ce que le rapprochement détecte l'écart, ce qui peut arriver des jours plus tard.
Selon une analyse indépendante citant les recherches sectorielles de Docsumo, les organisations qui utilisent un traitement documentaire basé sur des modèles consacrent en moyenne 6 à 8 semaines par nouveau format de document à configurer, tester et valider les règles d'extraction. Sur une base de fournisseurs importante avec un renouvellement régulier des formats, le coût de maintenance continu rivalise avec celui de la mise en œuvre initiale.
Comme l'a dit un utilisateur sur r/automation, après avoir passé un an à maintenir des modèles OCR pour différentes mises en page de factures : « C'était un vrai cauchemar à maintenir dès qu'un fournisseur changeait son formatage. » Un autre commentateur sur r/Accounting l'a formulé plus crûment : ce qu'il faut surtout éviter, c'est « tout ce qui vous oblige à configurer des modèles par fournisseur — avec plusieurs clients qui envoient des formats différents, cela prendra plus de temps que cela n'en fait gagner. »
Étape 3 : Attendez la fin de l'entraînement du modèle
Si vous avez dépassé les modèles pour passer à l'extraction basée sur l'apprentissage automatique — les outils « modernes » qui prétendent apprendre de vos données — vous avez échangé un type d'attente contre un autre.
Ces plateformes ne vous obligent pas à dessiner des rectangles. À la place, elles demandent des données d'entraînement étiquetées : 50 à 200 documents d'exemple où vous avez marqué manuellement quelle valeur correspond à quel champ. Plus il y a d'échantillons, mieux le modèle prédit la position des champs sur de nouveaux documents. L'étiquetage lui-même prend 10 à 20 heures de travail concentré. Ensuite, vous attendez pendant que le modèle s'entraîne — de quelques heures à plus d'une journée, selon le volume.
La promesse est séduisante : une fois entraîné, le modèle traite automatiquement ce type de document. La réalité pour la plupart des équipes, c'est que l'entraînement n'est pas un événement unique. Chaque nouveau fournisseur avec une mise en page très différente nécessite des échantillons supplémentaires. Chaque changement de format d'un fournisseur exige un réentraînement. Les prédictions du modèle se dégradent silencieusement lorsque les formats changent, et vous ne le saurez pas avant que quelqu'un ne détecte l'erreur en aval.
C'est l'ironie centrale de l'approche de deuxième génération : les outils censés éliminer les modèles les ont remplacés par la maintenance du modèle. Vous ne dessinez plus de zones, mais vous collectez des échantillons, étiquetez des champs, réentraînez à chaque changement de format et surveillez la dérive de précision. Le travail est passé de « par document » à « par cycle d'entraînement », mais il n'a pas disparu.
Pour un examen plus approfondi des raisons pour lesquelles certains outils nécessitent encore des données d'entraînement et d'autres non, consultez notre analyse de l'extraction sans aucun modèle — elle explique la différence architecturale entre les outils qui lisent les documents par position de pixel et ceux qui les lisent par sens sémantique.
Un outil d'extraction de documents qui a besoin de 50 échantillons étiquetés pour trouver « Total Amount » sur une facture ne lit pas le document. Il apprend une distribution de probabilité sur l'endroit où cette valeur tend à se situer sur une page — et espère que la prochaine facture la placera à peu près au même endroit.
L'alternative : ce qui se passe lorsque vous sautez les trois étapes
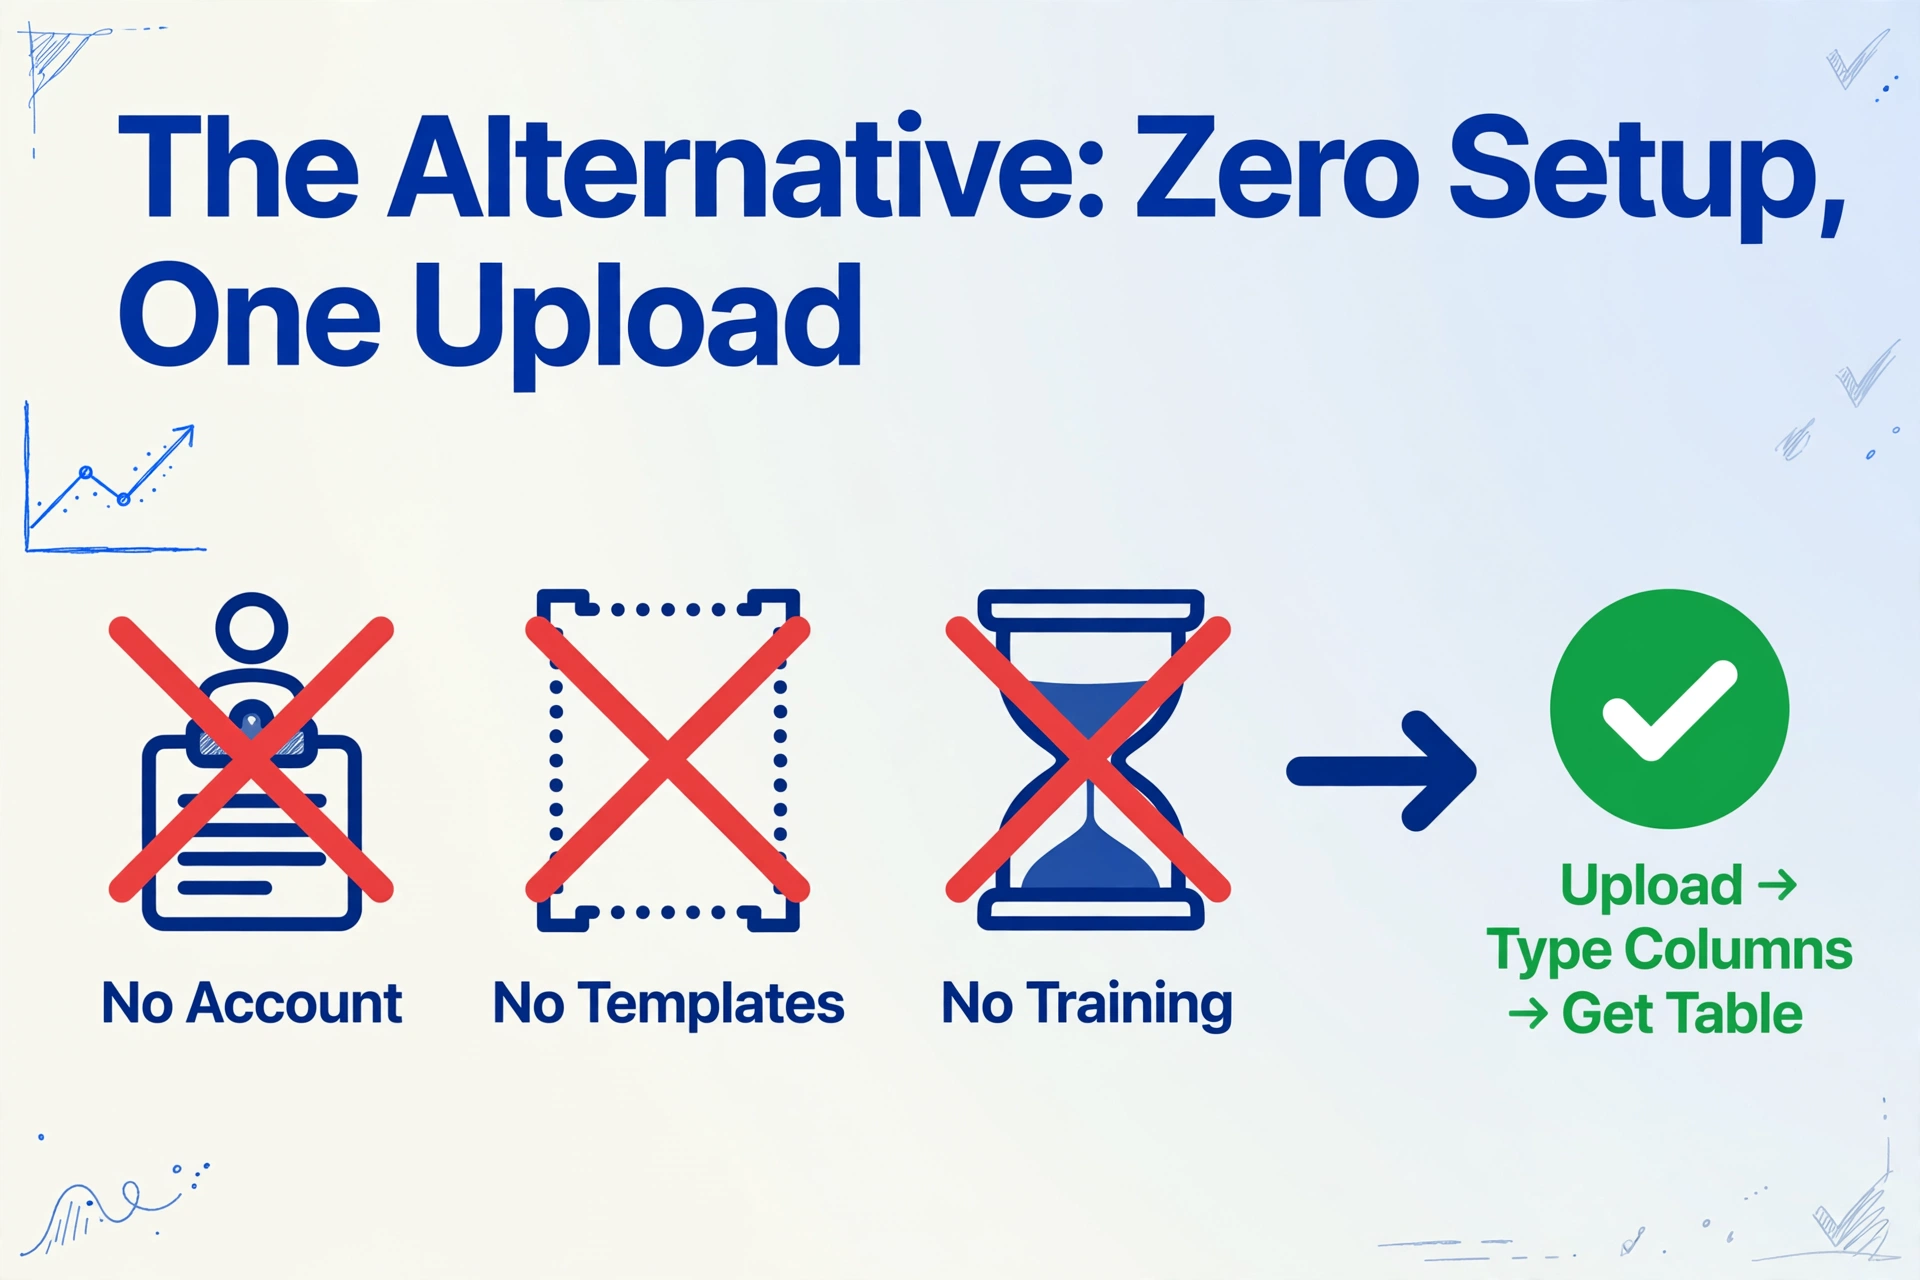
Voici à quoi ressemble le même flux de travail sur un outil conçu autour d'une hypothèse différente — celle que vous êtes venu pour l'extraction, pas pour la configuration.
Vous ne créez pas de compte. Vous ouvrez la page, téléversez un document et saisissez les noms de colonnes souhaités : « Invoice Number », « Date », « Vendor », « Subtotal », « Tax », « Total ». L'IA lit le document — non pas par coordonnées de pixels, mais en comprenant ce que chaque champ signifie dans son contexte — et remplit ces colonnes. C'est tout. Pas de barrière d'inscription. Pas de modèles à dessiner. Pas d'échantillons d'entraînement à étiqueter. Pas d'attente qu'un modèle apprenne.
Cette approche — la saisie de données par IA propulsée par des grands modèles de langage visuels — traite l'extraction comme un problème de raisonnement sémantique, et non de correspondance de motifs. Le modèle est arrivé en sachant déjà à quoi ressemble une facture, où les dates apparaissent généralement, comment les totaux sont formatés et à quoi ressemble un champ de nom de fournisseur dans son contexte. Votre rôle n'est pas de lui apprendre — c'est de lui dire ce que vous voulez, une seule fois, pour tous vos documents quel que soit le format.
Essayez ci-dessous. Téléversez n'importe quelle facture, saisissez vos noms de colonnes et voyez l'extraction se faire en temps réel — sans aucune des trois étapes :
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Le traitement prend 5 à 10 secondes par page sur des documents professionnels standards, avec une précision allant jusqu'à 99 % sur du texte imprimé de bonne qualité d'image. Le mode batch fusionne plusieurs documents en une seule feuille de calcul — téléversez 20 factures de 20 fournisseurs différents et obtenez un seul tableau les regroupant toutes, sans configuration par fournisseur.
Pourquoi cela compte au-delà du premier jour
La taxe en trois étapes n'est pas qu'un coût d'intégration — c'est un coût récurrent. Chaque fois qu'un nouveau fournisseur entre dans votre pipeline, chaque fois qu'un fournisseur existant met à jour le format de ses documents, chaque fois que vous devez extraire un type de document que vous n'avez pas encore configuré, vous la payez à nouveau.
Pour une entreprise comptant 200 fournisseurs actifs, la maintenance des modèles devient à elle seule un rôle à temps partiel. À 2 000 fournisseurs, c'est un poste à part entière — quelqu'un dont le travail consiste à maintenir les modèles d'extraction en vie, et non à utiliser réellement les données extraites. L'outil censé éliminer le travail manuel a créé une nouvelle catégorie de travail manuel.
L'alternative — extraction sans modèle, sans entraînement, sans compte obligatoire — n'est pas seulement plus rapide le premier jour. Elle passe à l'échelle sans accumuler de dette de maintenance. Vingt fournisseurs ou deux cents, le flux de travail est identique : importez vos documents, nommez vos colonnes, obtenez votre tableau. Les changements de format ne cassent pas l'extraction, car l'IA n'est pas ancrée à des coordonnées ni entraînée sur des motifs statistiques qui deviennent obsolètes.
Vous n'avez pas besoin de remplacer vos outils existants pour tester cela. Vous pouvez l'essayer dès maintenant sur un seul lot de documents et constater la différence en un cycle de travail — pas après une semaine de configuration.
FAQ
Existe-t-il des outils qui sautent réellement ces trois étapes ?
Oui, mais ils restent minoritaires sur le marché de l'extraction. La plupart des outils conçus avant 2023 reposent soit sur des modèles, soit sur l'entraînement de modèles, car leur architecture sous-jacente ne prend pas en charge la compréhension de documents sans exemple. ImageToTable.ai a été conçu dès le premier jour sur des LLM visuels — la même classe de modèles que Claude et GPT-4V — ce qui signifie qu'il lit les documents par compréhension sémantique plutôt que par coordonnées de pixels ou motifs statistiques. Le compromis est le coût par page : l'inférence LLM est plus coûteuse que l'OCR traditionnel ou les modèles statistiques sur site. Mais pour la plupart des équipes traitant des centaines à des milliers de documents par mois, le temps de configuration et de maintenance éliminé l'emporte sur la différence de coût par page.
Quelle est la précision de l'extraction sans modèle ni entraînement ?
Jusqu'à 99 % sur du texte imprimé issu de documents professionnels standard — factures, reçus, bons de commande, relevés bancaires — avec une bonne qualité d'image. La précision dépend principalement de la qualité de l'image (éclairage, netteté, résolution), de la complexité du document (tableaux denses à plusieurs colonnes, polices mixtes) et de la clarté des champs (clairement étiquetés ou implicites/non étiquetés). Le contenu manuscrit et les scans de mauvaise qualité réduisent la précision. Pour les documents financiers critiques, il est recommandé de vérifier par échantillonnage les premières extractions d'un nouveau type de document — la même pratique que vous suivriez avec n'importe quel outil d'extraction, entraîné ou non.
Le mode invité est-il sécurisé pour les documents contenant des données financières sensibles ?
ImageToTable.ai traite les documents en mémoire pour l'extraction et ne stocke pas les fichiers téléversés. Chaque session de traitement est indépendante — les fichiers ne sont ni conservés, ni indexés, ni utilisés pour entraîner l'IA. Pour les équipes qui ont besoin d'un historique persistant, d'une gestion par lots et de préréglages de modèles, la création d'un compte gratuit ajoute ces fonctionnalités sans modifier le flux d'extraction. Le mode invité et le mode compte utilisent le même moteur d'extraction et la même architecture de sécurité — la seule différence est de savoir si votre historique de traitement est enregistré dans votre compte.