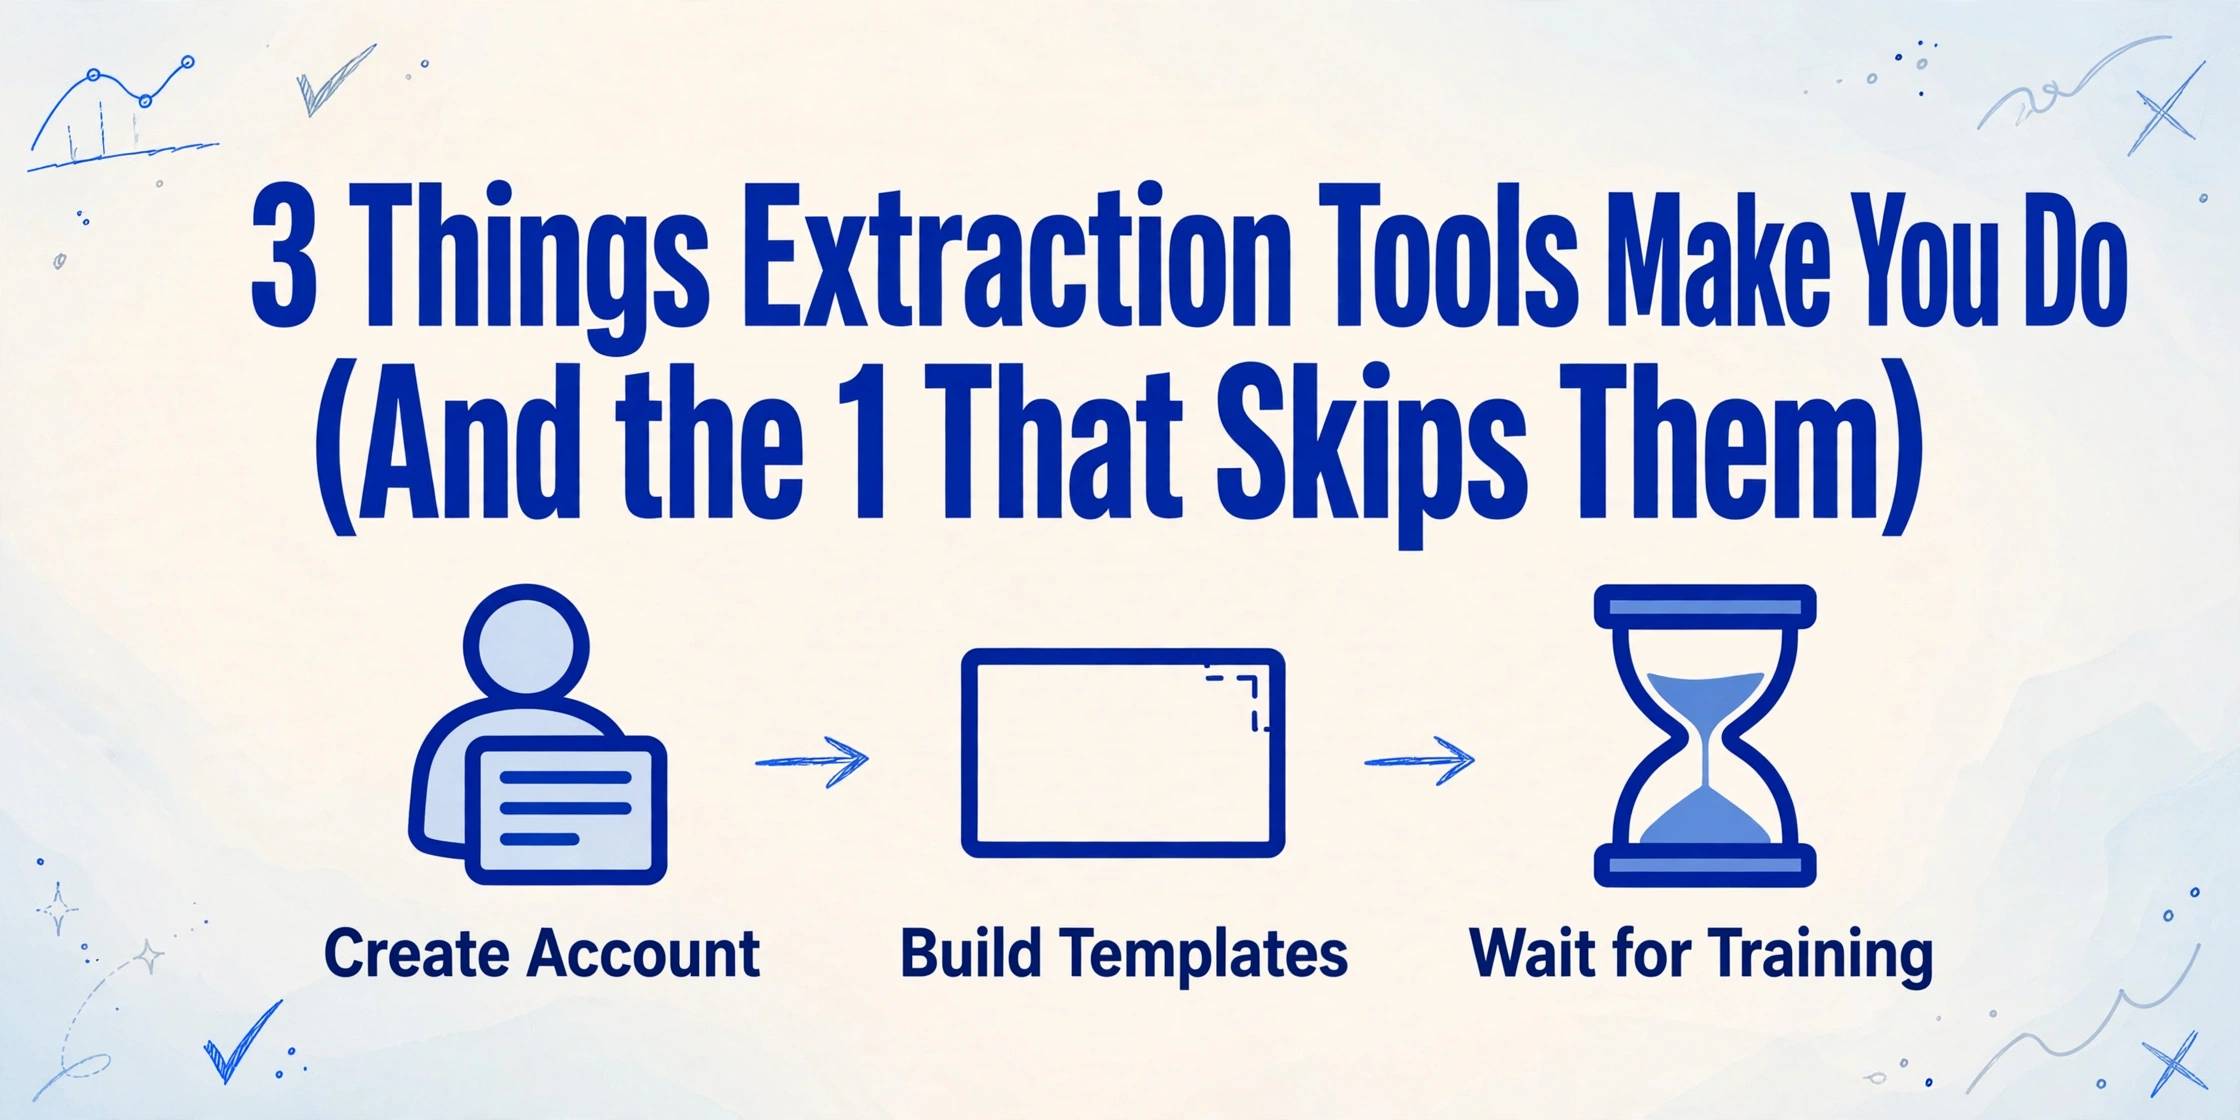
3 Coisas Que Ferramentas de Extração Fazem Você Fazer
E a 1 Que Pula Todas
A maioria das ferramentas de extração de documentos compartilha uma suposição implícita: que você está disposto a fazer trabalho de configuração antes de obter qualquer valor de volta. Não são minutos de configuração — são horas, às vezes dias. Aqui estão as três coisas que quase toda ferramenta de extração do mercado exige de você antes de produzir uma única linha de dados, o que cada uma custa em tempo real, e a única ferramenta criada para pular todas elas.
Principais Conclusões
- Antes que a extração comece, a maioria das ferramentas exige três etapas de configuração — registrar uma conta, criar templates por fornecedor e aguardar horas para o treinamento do modelo terminar.
- Com 200 fornecedores, a manutenção de templates consome metade de uma semana de trabalho, e cada mudança de formato do fornecedor quebra silenciosamente seu pipeline de extração.
- Pule todas as três — abra um navegador, envie qualquer fatura, nomeie suas colunas e obtenha dados estruturados sem registro, templates ou treinamento.
Etapa 1: Crie uma conta antes de testar qualquer coisa
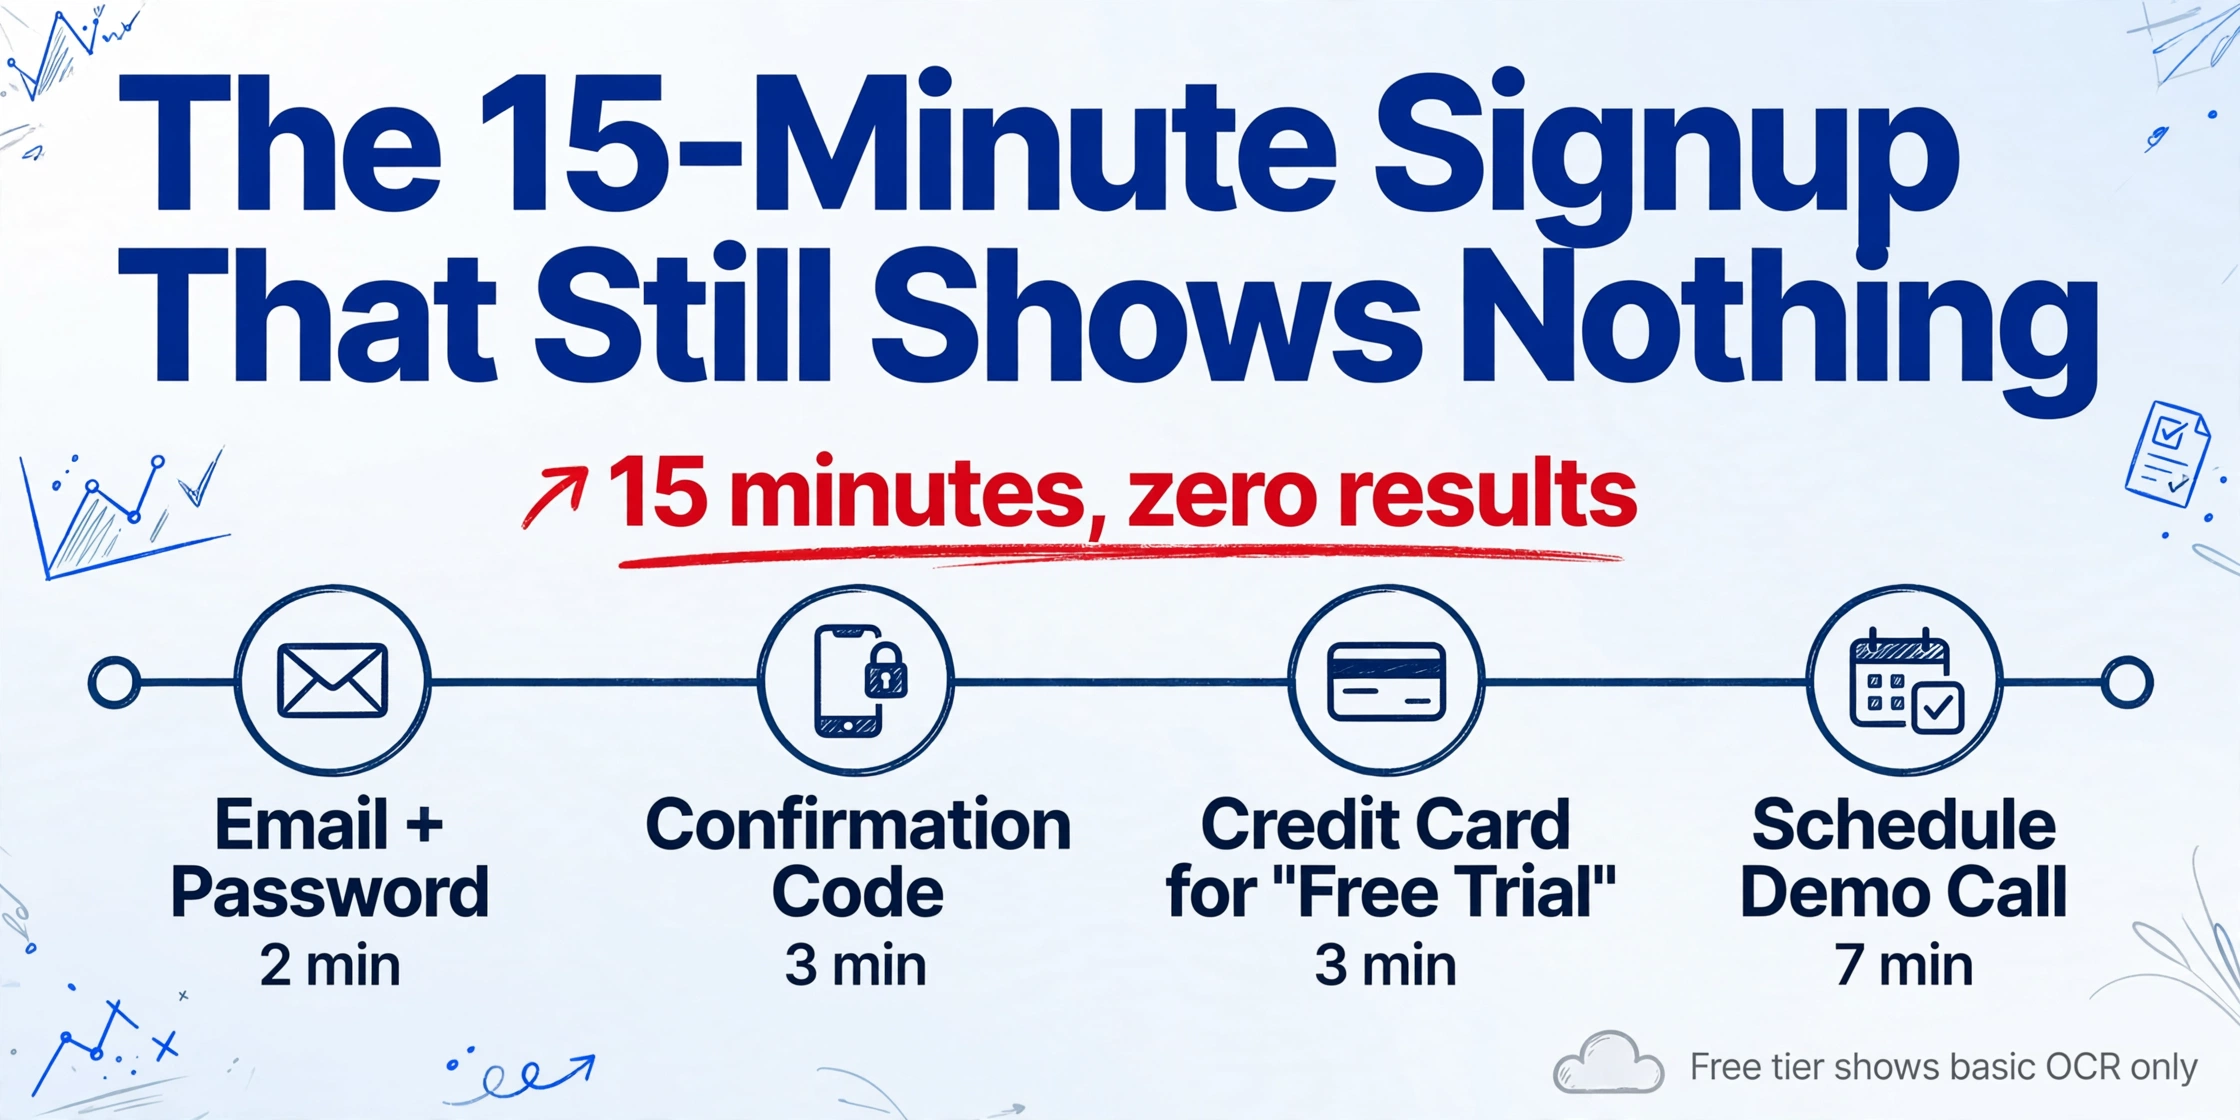
A primeira coisa que a maioria das ferramentas de extração pede não é um documento — é um endereço de e-mail. E uma senha. E um código de confirmação. Às vezes, um cartão de crédito para o "teste grátis".
O registro é a menor das três etapas — talvez 5 minutos — mas representa uma filosofia de design: a ferramenta quer capturar você como lead antes de provar seu valor. Você está se comprometendo antes de enviar um único arquivo ou ver como a extração lida com seus documentos reais.
Pior, o atrito não para no registro. Muitas ferramentas limitam a qualidade da extração atrás de planos pagos, então o nível gratuito mostra OCR básico enquanto a extração real por IA fica atrás de uma assinatura. Você conclui a configuração da conta apenas para perceber que ainda não consegue testar o recurso pelo qual veio.
No r/Accounting do Reddit, um contador avaliando ferramentas resumiu a frustração: "Só quero ver se funciona nas minhas faturas antes de me comprometer com qualquer coisa." Isso é mais difícil do que parece — a maioria das ferramentas torna a etapa "testar antes de se comprometer" a parte mais longa do processo.
O registro em si leva 5 minutos. Mas o custo oculto é a troca de contexto: você abre a página de cadastro da ferramenta, alterna para seu e-mail para confirmar, volta, preenche os dados da sua organização, talvez agende uma chamada de demonstração. Quando você envia seu primeiro documento, 15 minutos se passaram e você ainda não viu um resultado.
Etapa 2: Crie um modelo para cada fornecedor que envia documentos a você
Ferramentas baseadas em modelo — o tipo em que você desenha retângulos ao redor de cada campo em um documento de amostra — representam o maior consumo de tempo no processo de integração de extração.
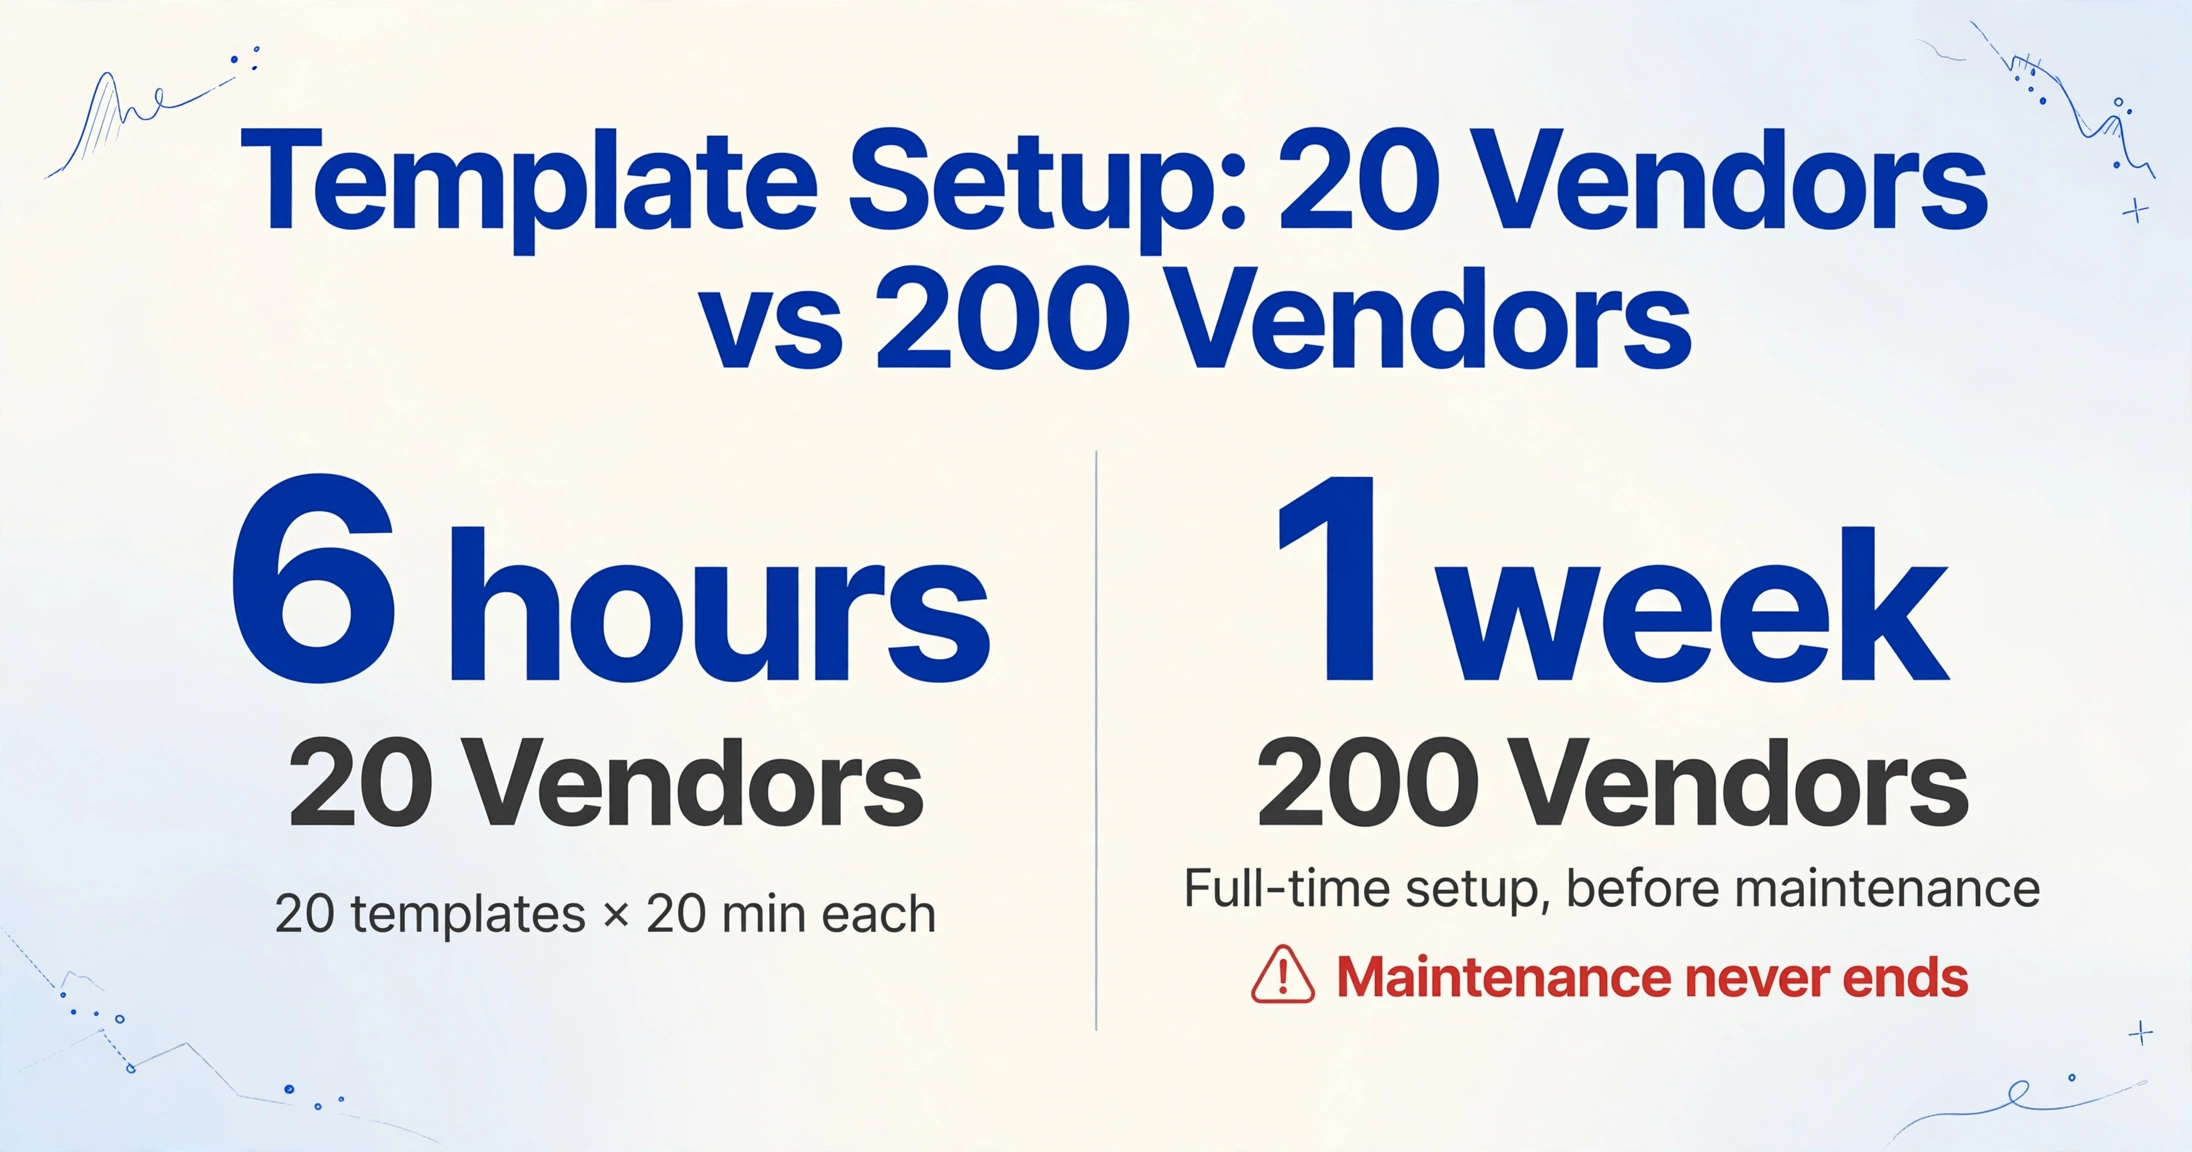
Veja a matemática. Configurar um modelo leva de 15 a 30 minutos: envie um documento de amostra, desenhe a zona para o Número da Fatura, desenhe outra para a Data, outra para o Fornecedor, outra para o Total, teste com algumas faturas recentes desse fornecedor, corrija divergências, repita. Vinte minutos, mais ou menos, por fornecedor.
Agora multiplique. Uma pequena empresa com 20 fornecedores regulares enfrenta 20 configurações de modelo — cerca de 6 horas desenhando retângulos antes de o sistema estar pronto para produção. Uma empresa de médio porte com 200 fornecedores? Isso é uma semana inteira do tempo de alguém, apenas na configuração inicial. E a manutenção nunca termina.
Quando um fornecedor reformula sua fatura — novo sistema de ERP, modelo reformulado, campos de conformidade adicionados — o modelo baseado em coordenadas quebra. Ele não gera erro. Ele silenciosamente extrai qualquer texto que agora ocupe as antigas posições de pixel. Um endereço de entrega cai na sua coluna de data. Um subtotal substitui o valor do imposto. O resultado parece plausível até a conciliação detectar a divergência, o que pode levar dias.
De acordo com uma análise independente que cita a pesquisa do setor da Docsumo, organizações que usam processamento de documentos baseado em modelo gastam em média de 6 a 8 semanas por novo formato de documento para configurar, testar e validar regras de extração. Em uma base ampla de fornecedores com mudanças frequentes de formato, o custo contínuo de manutenção rivaliza com a implementação original.
Como um usuário disse no r/automation, depois de passar um ano mantendo modelos de OCR para diferentes layouts de fatura: "Foi um pesadelo total de manter assim que um fornecedor mudou a formatação." Outro comentarista no r/Accounting foi mais direto: a principal coisa a evitar é "qualquer coisa que exija configurar modelos por fornecedor — com vários clientes enviando formatos diferentes, isso vai consumir mais tempo do que economizar."
Etapa 3: Aguarde a Conclusão do Treinamento do Modelo
Se você passou dos templates para a extração baseada em machine learning — as ferramentas "modernas" que afirmam aprender com seus dados — você trocou um tipo de espera por outro.
Essas plataformas não fazem você desenhar retângulos. Em vez disso, elas pedem dados de treinamento rotulados: de 50 a 200 documentos de amostra onde você marcou manualmente qual valor corresponde a qual campo. Quanto mais amostras, melhor o modelo fica em prever as posições dos campos em novos documentos. A rotulagem em si leva de 10 a 20 horas de trabalho focado. Depois, você espera enquanto o modelo treina — de horas a um dia ou mais, dependendo do volume.
A promessa é atraente: uma vez treinado, o modelo lida com aquele tipo de documento automaticamente. A realidade para a maioria das equipes é que o treinamento não é um evento único. Cada novo fornecedor com um layout significativamente diferente precisa de amostras adicionais. Cada mudança de formato do fornecedor exige retreinamento. As previsões do modelo degradam silenciosamente quando os formatos mudam, e você só vai descobrir quando alguém perceber o erro mais adiante.
Esta é a ironia central da abordagem de segunda geração: as ferramentas que deveriam eliminar os templates os substituíram pela manutenção do modelo. Você não está mais desenhando zonas, mas está coletando amostras, rotulando campos, retreinando em mudanças de formato e monitorando a deriva de precisão. O trabalho mudou de "por documento" para "por ciclo de treinamento", mas não desapareceu.
Para uma análise mais aprofundada de por que algumas ferramentas ainda exigem dados de treinamento enquanto outras não, veja nossa análise sobre extração sem nenhum template — ela explica a diferença arquitetônica entre ferramentas que leem documentos por posição de pixel e ferramentas que os leem por significado semântico.
Uma ferramenta de extração de documentos que precisa de 50 amostras rotuladas para encontrar o "Valor Total" em uma fatura não está lendo o documento. Ela está aprendendo uma distribuição de probabilidade sobre onde esse valor tende a ficar em uma página — e esperando que a próxima fatura o coloque aproximadamente no mesmo lugar.
A alternativa: o que acontece quando você omite todas as três etapas
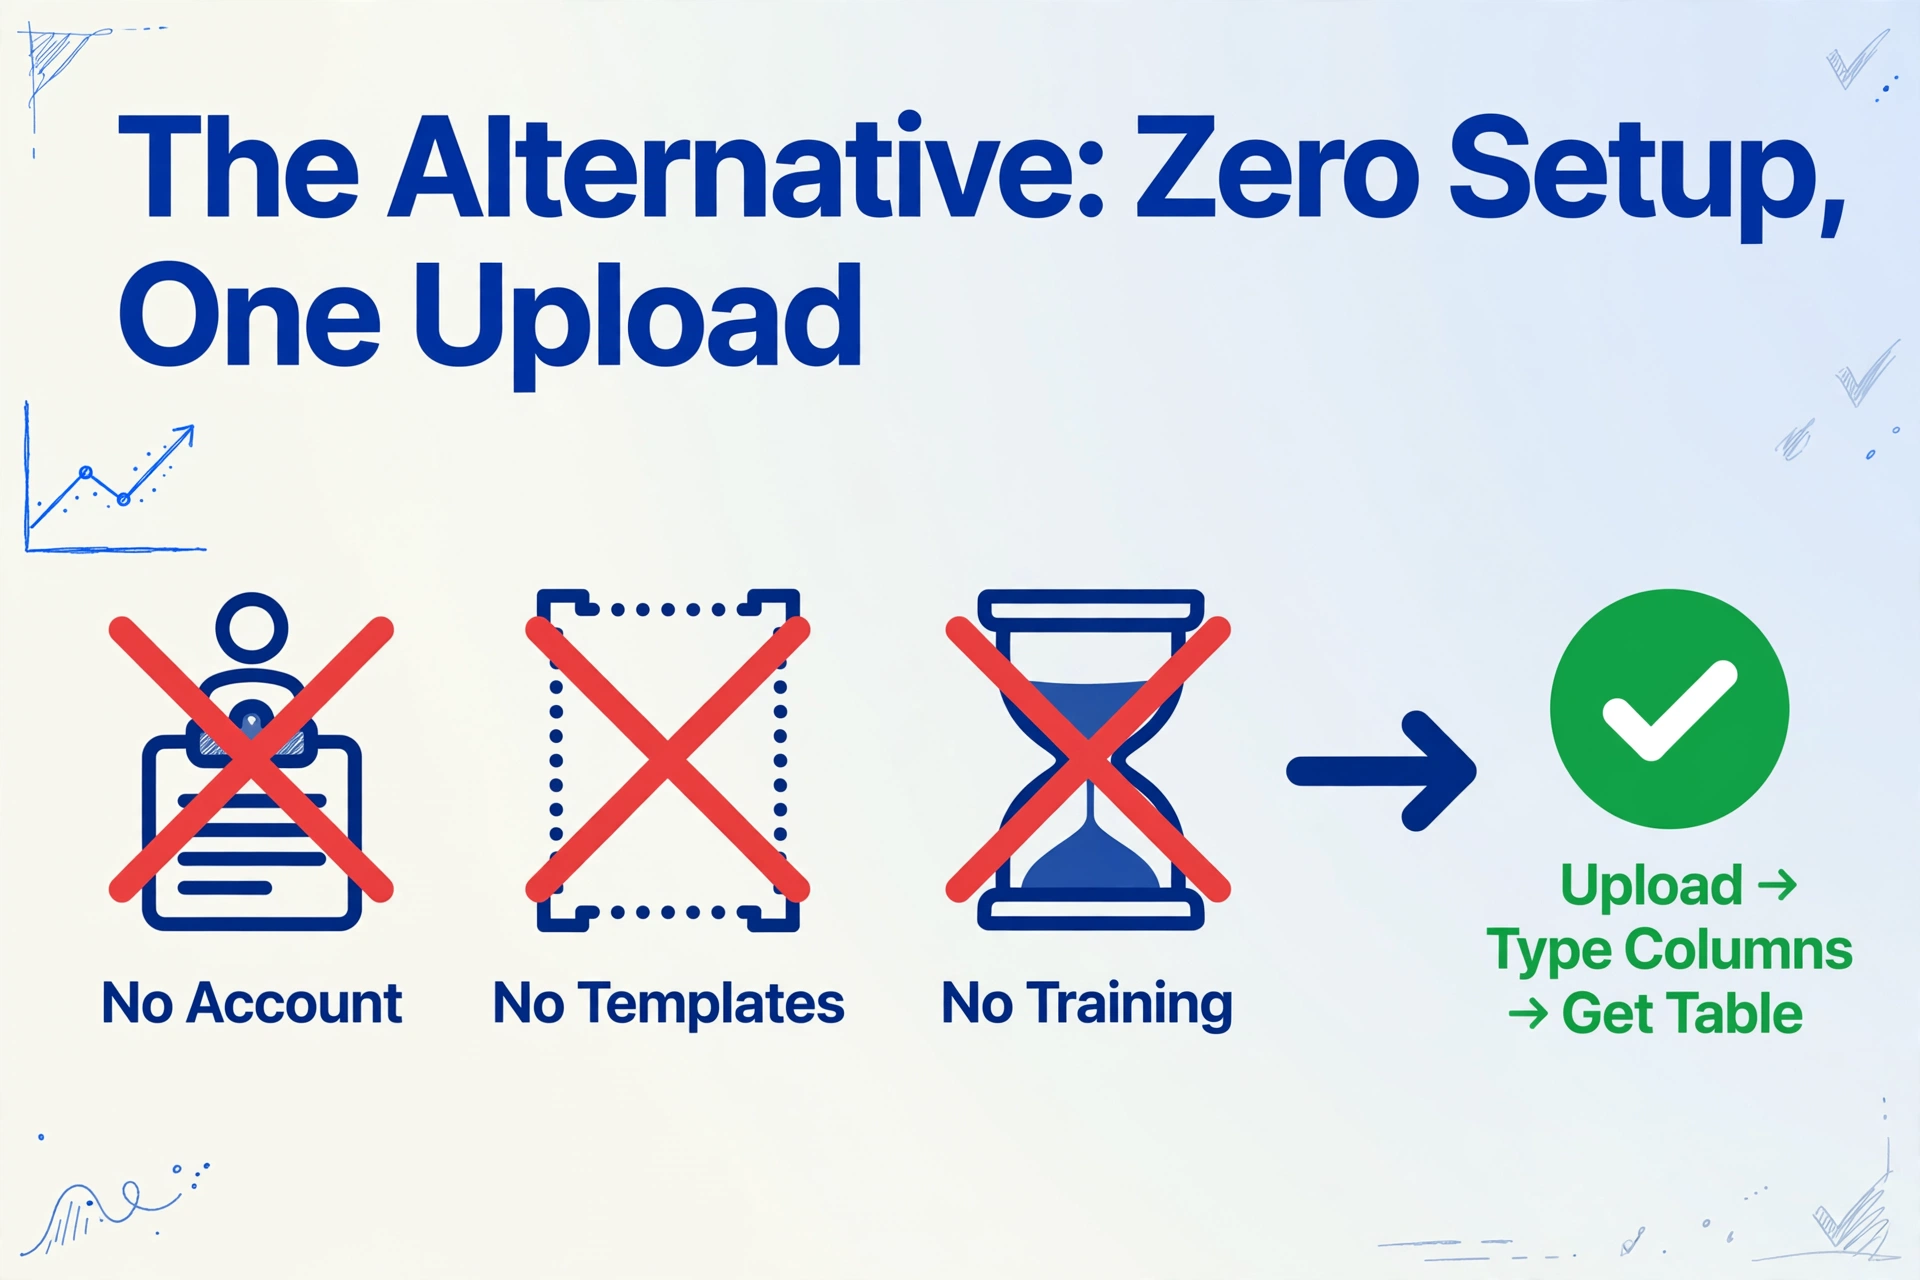
Veja como é o mesmo fluxo de trabalho em uma ferramenta construída em torno de uma suposição diferente — que você veio para extrair, não para configurar.
Você não cria uma conta. Você abre a página, carrega um documento e digita os nomes das colunas que deseja: "Número de Fatura", "Data", "Fornecedor", "Subtotal", "Imposto", "Total". A IA lê o documento — não por coordenadas de pixels, mas entendendo o que cada campo significa no contexto — e preenche essas colunas. Isso é tudo. Sem portão de registro. Sem modelos para desenhar. Sem samples de treinamento para rotular. Sem esperar que um modelo aprenda.
Essa abordagem — entrada de dados por IA alimentada por modelos de linguagem visual grandes — trata a extração como um problema de raciocinio semântico, não de correspondência de padrões. O modelo já chegou sabendo como é uma fatura, onde as datas normalmente aparecem, como os totais são formatados e como é um campo de nome de fornecedor no contexto. Sua tarefa não é ensiná-lo — é dizer o que você quer, exatamente uma vez, para todos seus documentos, independentemente do formato.
Experimente abaixo. Carregue qualquer fatura, digite os nomes das colunas e veja a extração acontecer em tempo real — sem nenhuna das três etapas:
Os arquivos são processados de forma segura e não são armazenados.
O processamento leva de 5 a 10 segundos por página em documentos comerciais padrão, com até 99% de precisão em texto impresso com boa qualidade de imagem. O modo batch mescla vários documentos em uma única planilha — cargue 20 faturas de 20 fornecedores diferentes e obtenha uma tabela com todas elas, sem configuração por fornecedor.
Por que isso importa além do primeiro dia
O imposto de três etapas não é apenas um custo de integração — é recorrente. Toda vez que um novo fornecedor entra no seu pipeline, toda vez que um fornecedor existente atualiza o formato do documento, toda vez que você precisa extrair um tipo de documento que ainda não configurou, você paga novamente.
Para uma empresa com 200 fornecedores ativos, a manutenção de modelos vira um trabalho de meio período. Com 2.000 fornecedores, é uma posição dedicada — alguém cujo trabalho é manter os modelos de extração funcionando, não usar os dados extraídos. A ferramenta que deveria eliminar o trabalho manual criou uma nova categoria de trabalho manual.
A alternativa — extração sem modelos, sem treinamento e sem conta obrigatória — não é apenas mais rápida no primeiro dia. Ela escala sem acumular dívida de manutenção. Vinte fornecedores ou duzentos, o fluxo de trabalho é idêntico: envie documentos, nomeie suas colunas, obtenha sua tabela. Mudanças de formato não quebram a extração porque a IA não está ancorada em coordenadas ou treinada em padrões estatísticos que ficam obsoletos.
Você não precisa substituir suas ferramentas atuais para testar isso. Pode experimentar com um único lote de documentos agora mesmo e ver a diferença em um ciclo de fluxo de trabalho — não depois de uma semana de configuração.
Perguntas Frequentes
Existem ferramentas que realmente pulam todas essas três etapas?
Sim, mas ainda são minoria no mercado de extração. A maioria das ferramentas criadas antes de 2023 depende de modelos ou treinamento porque sua arquitetura subjacente não suporta compreensão zero-shot de documentos. O ImageToTable.ai foi construído desde o primeiro dia com LLMs visuais — a mesma classe de modelos por trás do Claude e GPT-4V — o que significa que ele lê documentos por compreensão semântica, não por coordenadas de pixels ou padrões estatísticos. A contrapartida é o custo por página: a inferência de LLM é mais cara que OCR tradicional ou modelos estatísticos locais. Mas para a maioria das equipes que processam centenas a milhares de documentos por mês, o tempo eliminado de configuração e manutenção supera a diferença de custo por página.
Qual a precisão da extração sem modelos ou treinamento?
Até 99% em texto impresso de documentos comerciais padrão — faturas, recibos, ordens de compra, extratos bancários — com boa qualidade de imagem. A precisão depende principalmente da qualidade da imagem (iluminação, foco, resolução), da complexidade do documento (tabelas densas com várias colunas, fontes mistas) e da clareza dos campos (claramente rotulados vs. implícitos ou não rotulados). Conteúdo manuscrito e digitalizações de baixa qualidade reduzem a precisão. Para documentos financeiros críticos, recomenda-se verificar as primeiras extrações de um novo tipo de documento — a mesma prática que você seguiria com qualquer ferramenta de extração, treinada ou não.
O modo convidado é seguro para documentos com dados financeiros confidenciais?
O ImageToTable.ai processa documentos na memória para extração e não armazena arquivos enviados. Cada sessão de processamento é independente — os arquivos não são retidos, indexados ou usados para treinar a IA. Para equipes que precisam de histórico persistente, gerenciamento em lote e predefinições de modelos, criar uma conta gratuita adiciona esses recursos sem alterar o fluxo de trabalho de extração. O modo convidado e o modo de conta usam o mesmo mecanismo de extração e a mesma arquitetura de segurança — a única diferença é se o seu histórico de processamento é salvo na sua conta.