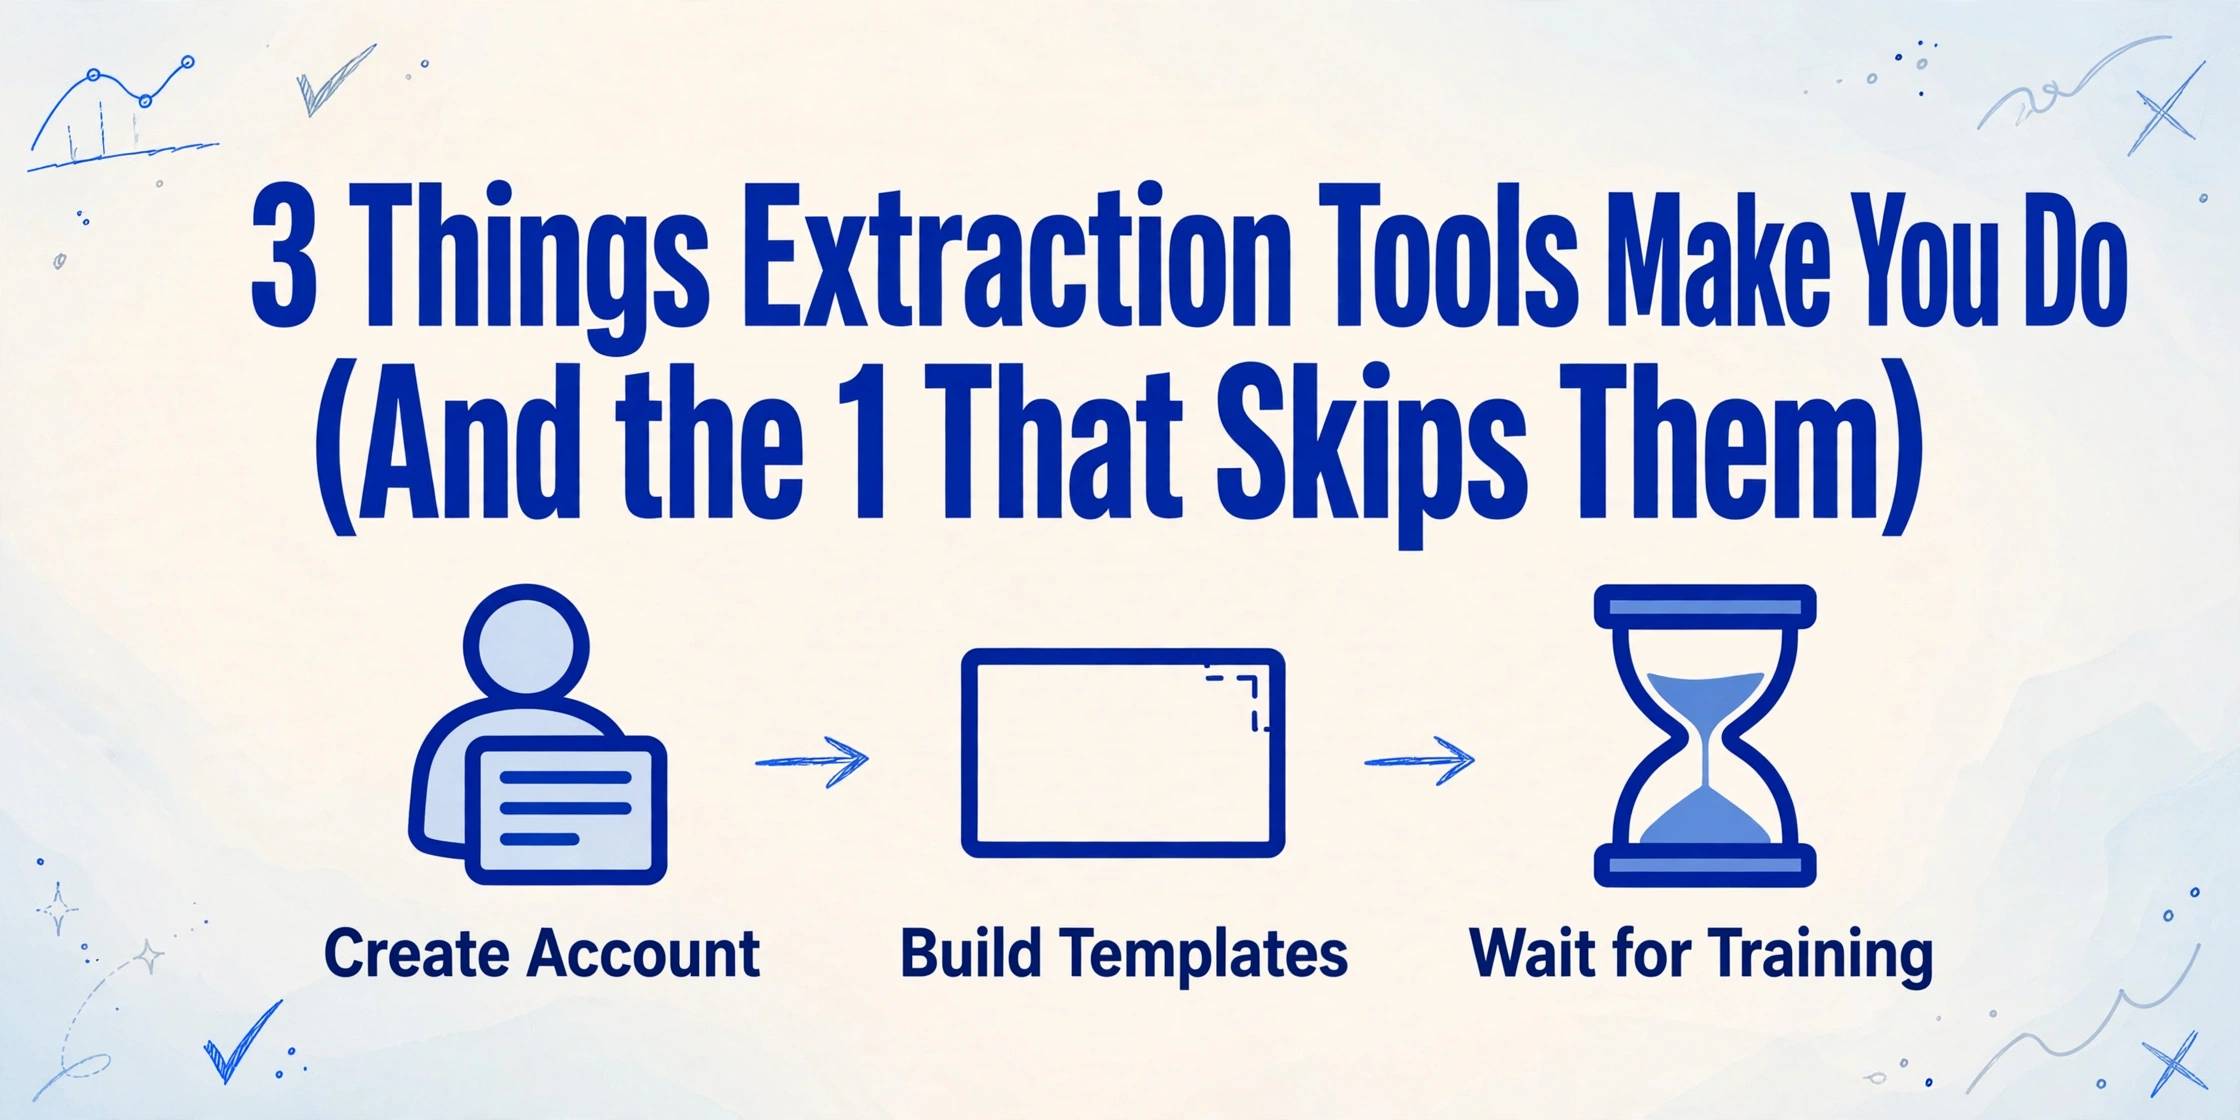
3 Dinge, die Extraktionstools von Ihnen verlangen
Und das 1, das sie überspringt
Die meisten Dokumentextraktionstools teilen eine unausgesprochene Annahme: dass Sie bereit sind, Konfigurationsarbeit zu leisten, bevor Sie einen Mehrwert erhalten. Nicht Minuten der Konfiguration – sondern Stunden, manchmal Tage. Hier sind die drei Dinge, die fast jedes Extraktionstool auf dem Markt von Ihnen verlangt, bevor es eine einzige Datenzeile produziert, was jede davon an realer Zeit kostet – und das eine Tool, das gebaut wurde, um alle zu überspringen.
Wichtigste Erkenntnisse
- Bevor die Extraktion überhaupt beginnt, verlangen die meisten Tools drei Konfigurationsschritte – ein Konto registrieren, pro Lieferant Vorlagen erstellen und stundenlang auf den Abschluss des Modelltrainings warten.
- Mit 200 Lieferanten verschlingt die Vorlagenpflege eine halbe Arbeitswoche, und jede Formatänderung eines Lieferanten bricht Ihre Extraktionspipeline stillschweigend.
- Überspringen Sie alle drei – öffnen Sie einen Browser, laden Sie eine beliebige Rechnung hoch, benennen Sie Ihre Spalten und erhalten Sie strukturierte Daten ohne Registrierung, Vorlagen oder Training.
Schritt 1: Erstellen Sie ein Konto, bevor Sie etwas testen können
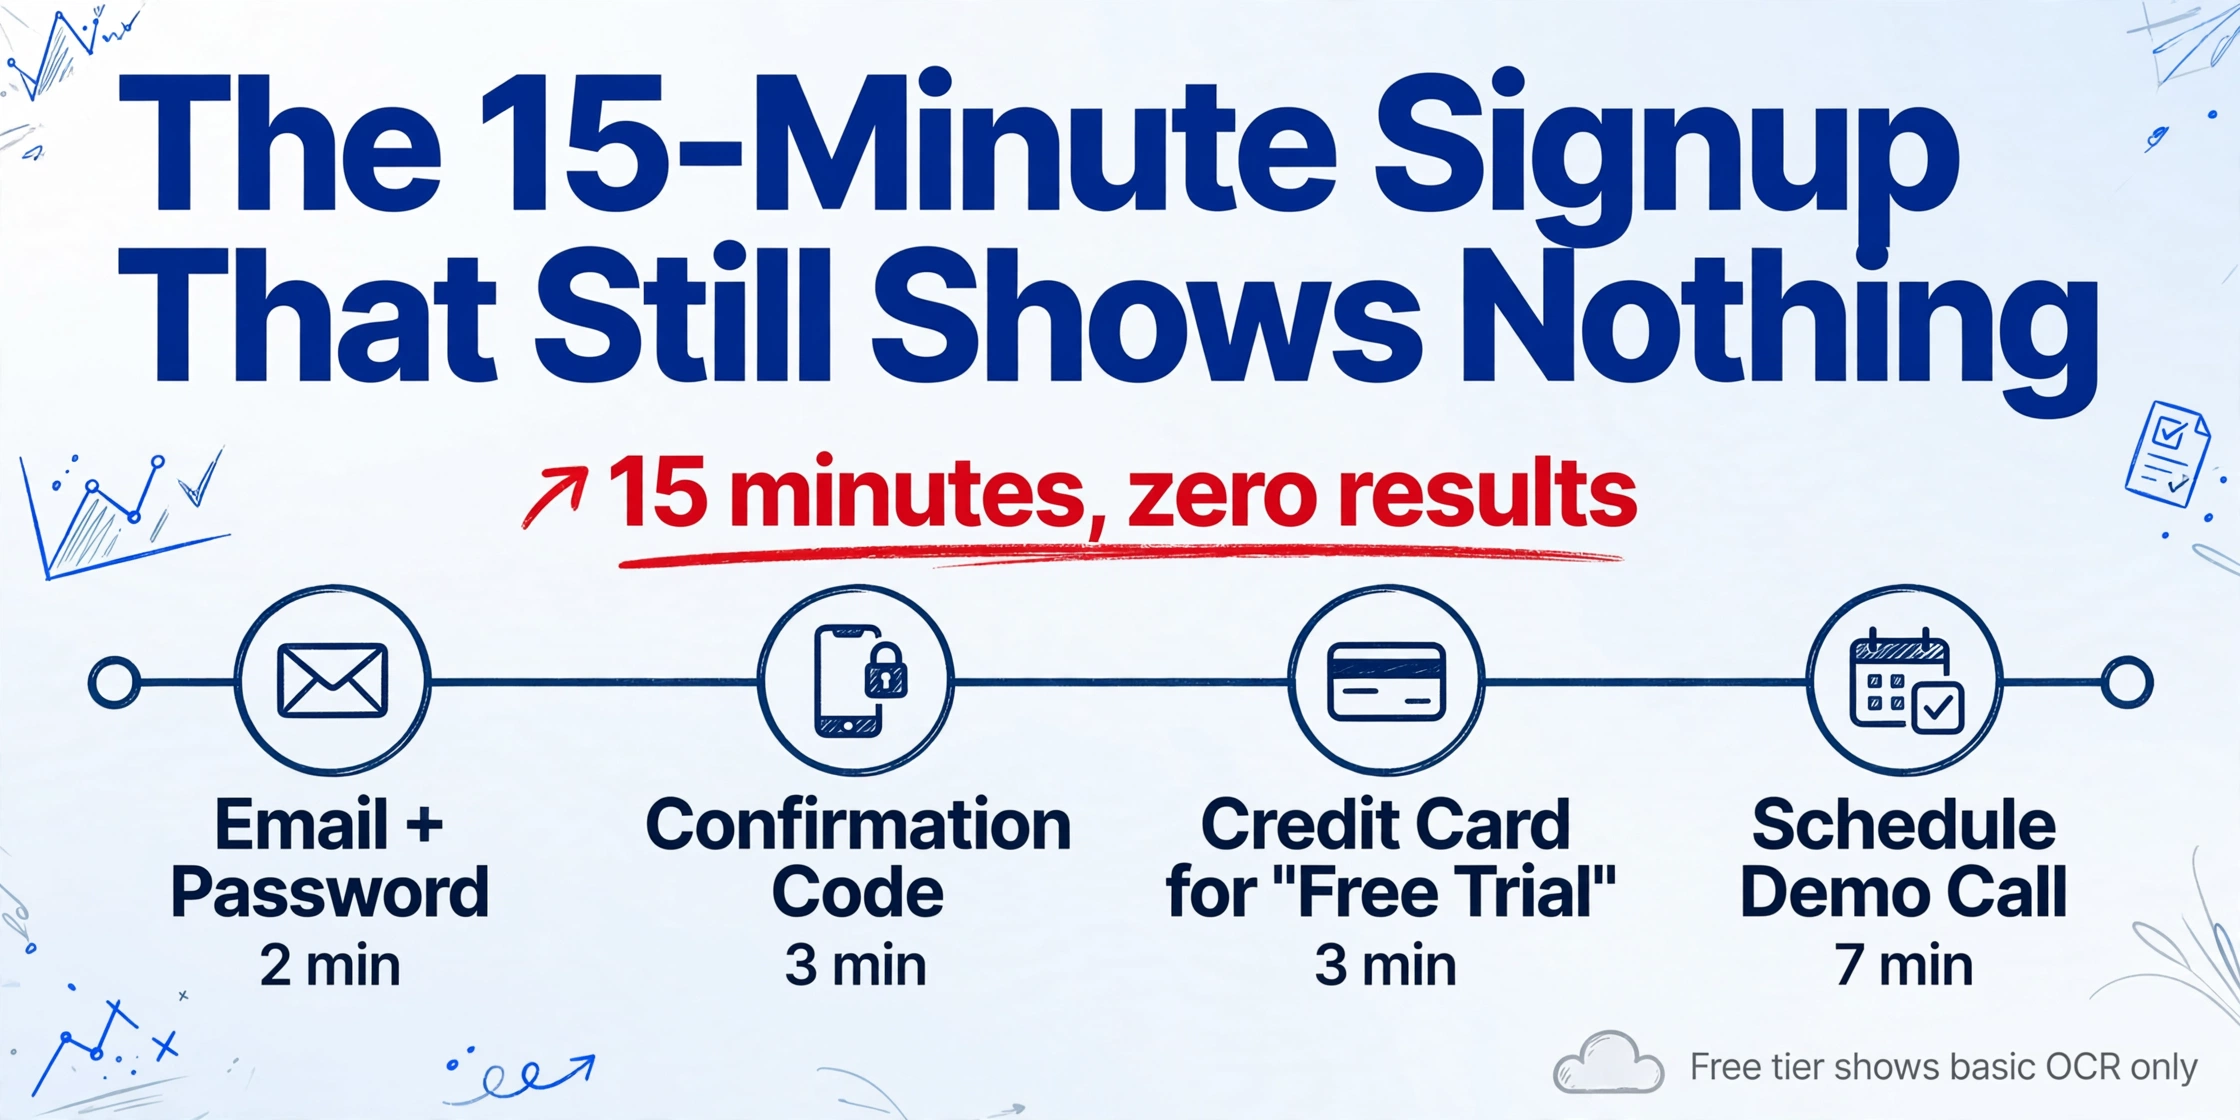
Das Erste, worum die meisten Extraktionstools bitten, ist kein Dokument – sondern eine E-Mail-Adresse. Und ein Passwort. Und einen Bestätigungscode. Manchmal eine Kreditkarte für die „kostenlose Testversion".
Die Registrierung ist der kleinste der drei Schritte – vielleicht 5 Minuten – aber sie steht für eine Designphilosophie: Das Tool möchte Sie als Lead erfassen, bevor es seinen Wert beweist. Sie verpflichten sich, bevor Sie eine einzige Datei hochgeladen oder gesehen haben, wie die Extraktion mit Ihren tatsächlichen Dokumenten umgeht.
Schlimmer noch: Die Hürden enden nicht bei der Registrierung. Viele Tools sperren ihre Extraktionsqualität hinter kostenpflichtigen Tarifen, sodass die kostenlose Stufe nur grundlegende OCR zeigt, während die echte KI-Extraktion hinter einer Abonnement-Wand liegt. Sie schließen die Kontoeinrichtung ab, nur um festzustellen, dass Sie die Funktion, wegen der Sie gekommen sind, immer noch nicht testen können.
Auf Reddits r/Accounting fasste ein Buchhalter, der Tools evaluierte, den Frust zusammen: „Ich möchte einfach sehen, ob es mit meinen Rechnungen funktioniert, bevor ich mich auf etwas festlege." Das ist schwerer, als es klingt – die meisten Tools machen den Schritt „Erst testen, dann festlegen" zum längsten Teil des Prozesses.
Die Registrierung selbst dauert 5 Minuten. Aber die versteckten Kosten entstehen durch den Kontextwechsel: Sie öffnen die Anmeldeseite des Tools, wechseln zu Ihrer E-Mail zur Bestätigung, wechseln zurück, füllen Ihre Organisationsdaten aus, planen vielleicht einen Demo-Anruf. Bis Sie Ihr erstes Dokument hochladen, sind 15 Minuten vergangen und Sie haben immer noch kein Ergebnis gesehen.
Schritt 2: Erstellen Sie eine Vorlage für jeden Lieferanten, der Ihnen Dokumente sendet
Vorlagenbasierte Tools – die Art, bei der Sie auf einem Musterdokument Rechtecke um jedes Feld zeichnen – stellen den größten einzelnen Zeitfresser im Onboarding-Prozess der Extraktion dar.
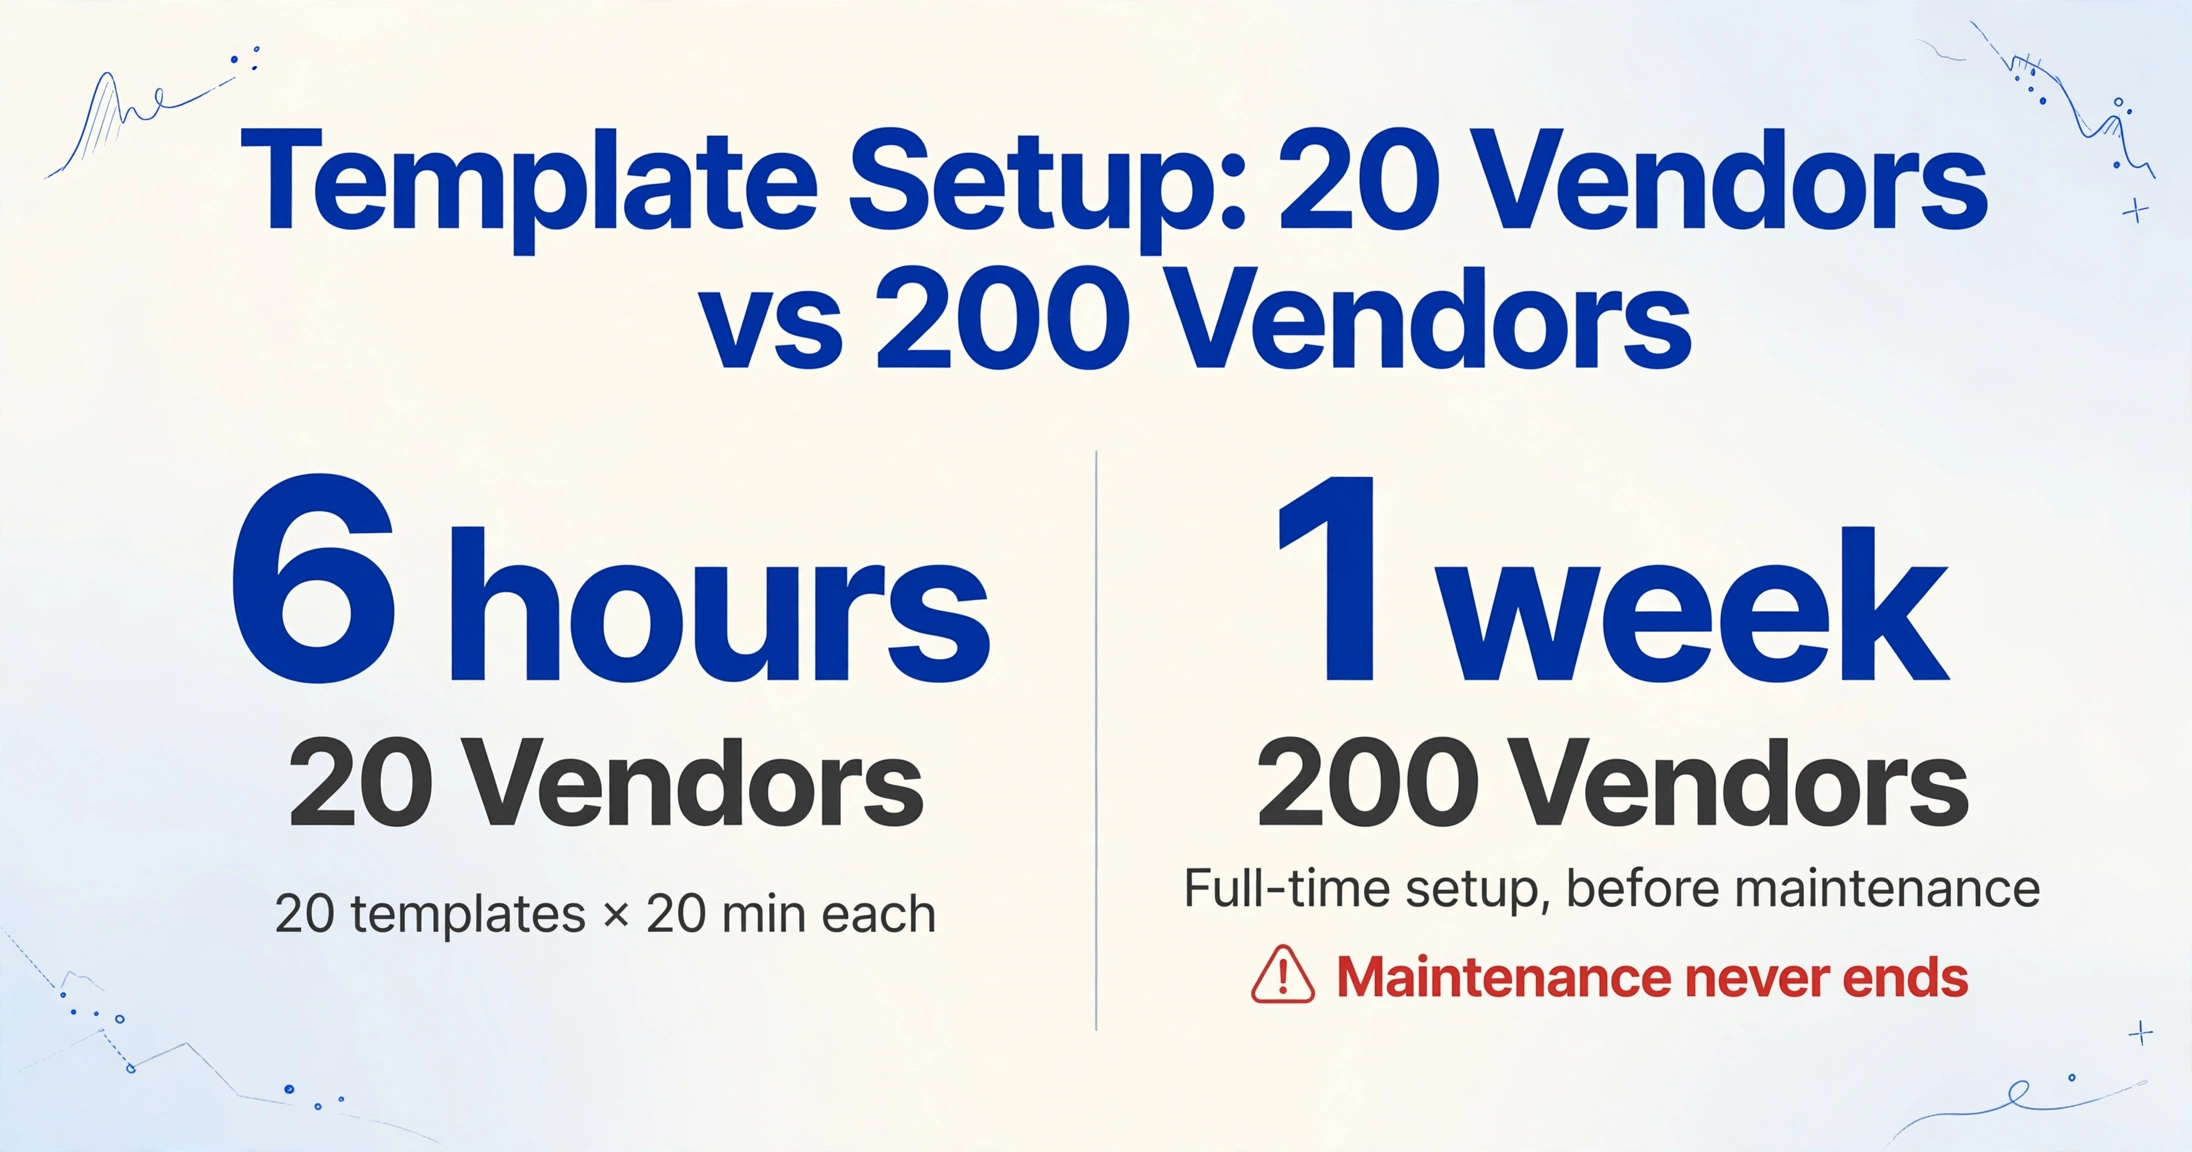
Hier ist die Rechnung. Die Konfiguration einer Vorlage dauert 15 bis 30 Minuten: Musterdokument hochladen, die Zone für Rechnungsnummer zeichnen, eine weitere für Datum, eine für Lieferant, eine für Summe, gegen ein paar aktuelle Rechnungen dieses Lieferanten testen, Abweichungen korrigieren, wiederholen. Zwanzig Minuten, mehr oder weniger, pro Lieferant.
Jetzt multiplizieren Sie. Ein kleines Unternehmen mit 20 regulären Lieferanten steht vor 20 Vorlagenkonfigurationen – rund 6 Stunden Rechtecke zeichnen, bevor das System produktionsbereit ist. Ein mittelständisches Unternehmen mit 200 Lieferanten? Das ist eine volle Arbeitswoche, nur für die Ersteinrichtung. Und die Wartung endet nie.
Wenn ein Lieferant seine Rechnung neu gestaltet – neues ERP-System, neu gestaltete Vorlage, zusätzliche Compliance-Felder – bricht die koordinatenbasierte Vorlage. Sie wirft keinen Fehler aus. Sie extrahiert stillschweigend den Text, der jetzt die alten Pixelpositionen belegt. Eine Lieferadresse landet in Ihrer Datumsspalte. Ein Zwischensumme ersetzt Ihren Steuerbetrag. Das Ergebnis sieht plausibel aus, bis der Abgleich die Abweichung bemerkt – möglicherweise Tage später.
Laut einer unabhängigen Analyse, die Docsumos Branchenforschung zitiert, verbringen Organisationen, die vorlagenbasierte Dokumentenverarbeitung nutzen, durchschnittlich 6 bis 8 Wochen pro neuem Dokumentformat für Konfiguration, Tests und Validierung der Extraktionsregeln. Bei einer großen Lieferantenbasis mit regelmäßigem Formatwechsel übersteigen die laufenden Wartungskosten die ursprüngliche Implementierung.
Wie ein Nutzer es auf r/automation ausdrückte, nachdem er ein Jahr lang OCR-Vorlagen für verschiedene Rechnungslayouts gepflegt hatte: „Es war ein totaler Albtraum, sobald ein Lieferant sein Format geändert hat." Ein anderer Kommentator auf r/Accounting formulierte es deutlicher: Die Hauptsache, die es zu vermeiden gilt, ist „alles, was Sie dazu zwingt, Vorlagen pro Lieferant einzurichten – mit mehreren Kunden, die unterschiedliche Formate senden, wird das mehr Zeit fressen, als es spart."
Schritt 3: Warten, bis das Modelltraining abgeschlossen ist
Wenn Sie über Vorlagen hinaus zu maschinenlernbasierten Extraktionen übergegangen sind – den „modernen" Tools, die behaupten, aus Ihren Daten zu lernen –, haben Sie eine Art des Wartens gegen eine andere eingetauscht.
Diese Plattformen zwingen Sie nicht dazu, Rechtecke zu zeichnen. Stattdessen verlangen sie gekennzeichnete Trainingsdaten: 50 bis 200 Beispieldokumente, in denen Sie manuell markiert haben, welcher Wert zu welchem Feld gehört. Je mehr Beispiele, desto besser kann das Modell Feldpositionen in neuen Dokumenten vorhersagen. Die Kennzeichnung selbst nimmt 10 bis 20 Stunden konzentrierter Arbeit in Anspruch. Dann warten Sie, während das Modell trainiert – Stunden bis zu einem Tag oder mehr, je nach Umfang.
Das Versprechen klingt verlockend: Einmal trainiert, verarbeitet das Modell diesen Dokumenttyp automatisch. Die Realität für die meisten Teams ist jedoch, dass Training kein einmaliges Ereignis ist. Jeder neue Lieferant mit einem deutlich anderen Layout benötigt zusätzliche Beispiele. Jede Formatänderung des Lieferanten erfordert ein erneutes Training. Die Vorhersagen des Modells verschlechtern sich still, wenn sich Formate ändern, und Sie merken es erst, wenn jemand den Fehler nachgelagert entdeckt.
Das ist die zentrale Ironie des Ansatzes der zweiten Generation: Die Tools, die Vorlagen überflüssig machen sollten, haben sie durch Modellpflege ersetzt. Sie zeichnen keine Zonen mehr, aber Sie sammeln Beispiele, kennzeichnen Felder, trainieren bei Formatänderungen neu und überwachen die Genauigkeitsdrift. Die Arbeit hat sich von „pro Dokument" zu „pro Trainingszyklus" verlagert, aber sie ist nicht verschwunden.
Für einen tieferen Einblick, warum einige Tools weiterhin Trainingsdaten benötigen und andere nicht, lesen Sie unsere Übersicht zu Extraktion ohne Vorlagen – sie erklärt den architektonischen Unterschied zwischen Tools, die Dokumente anhand der Pixelposition lesen, und Tools, die sie anhand der semantischen Bedeutung lesen.
Ein Dokumentextraktionstool, das 50 gekennzeichnete Beispiele benötigt, um den „Gesamtbetrag" auf einer Rechnung zu finden, liest das Dokument nicht. Es lernt eine Wahrscheinlichkeitsverteilung darüber, wo dieser Wert auf einer Seite tendenziell steht – und hofft, dass die nächste Rechnung ihn ungefähr an derselben Stelle platziert.
Die Alternative: Was passiert, wenn Sie alle drei Schritte überspringen
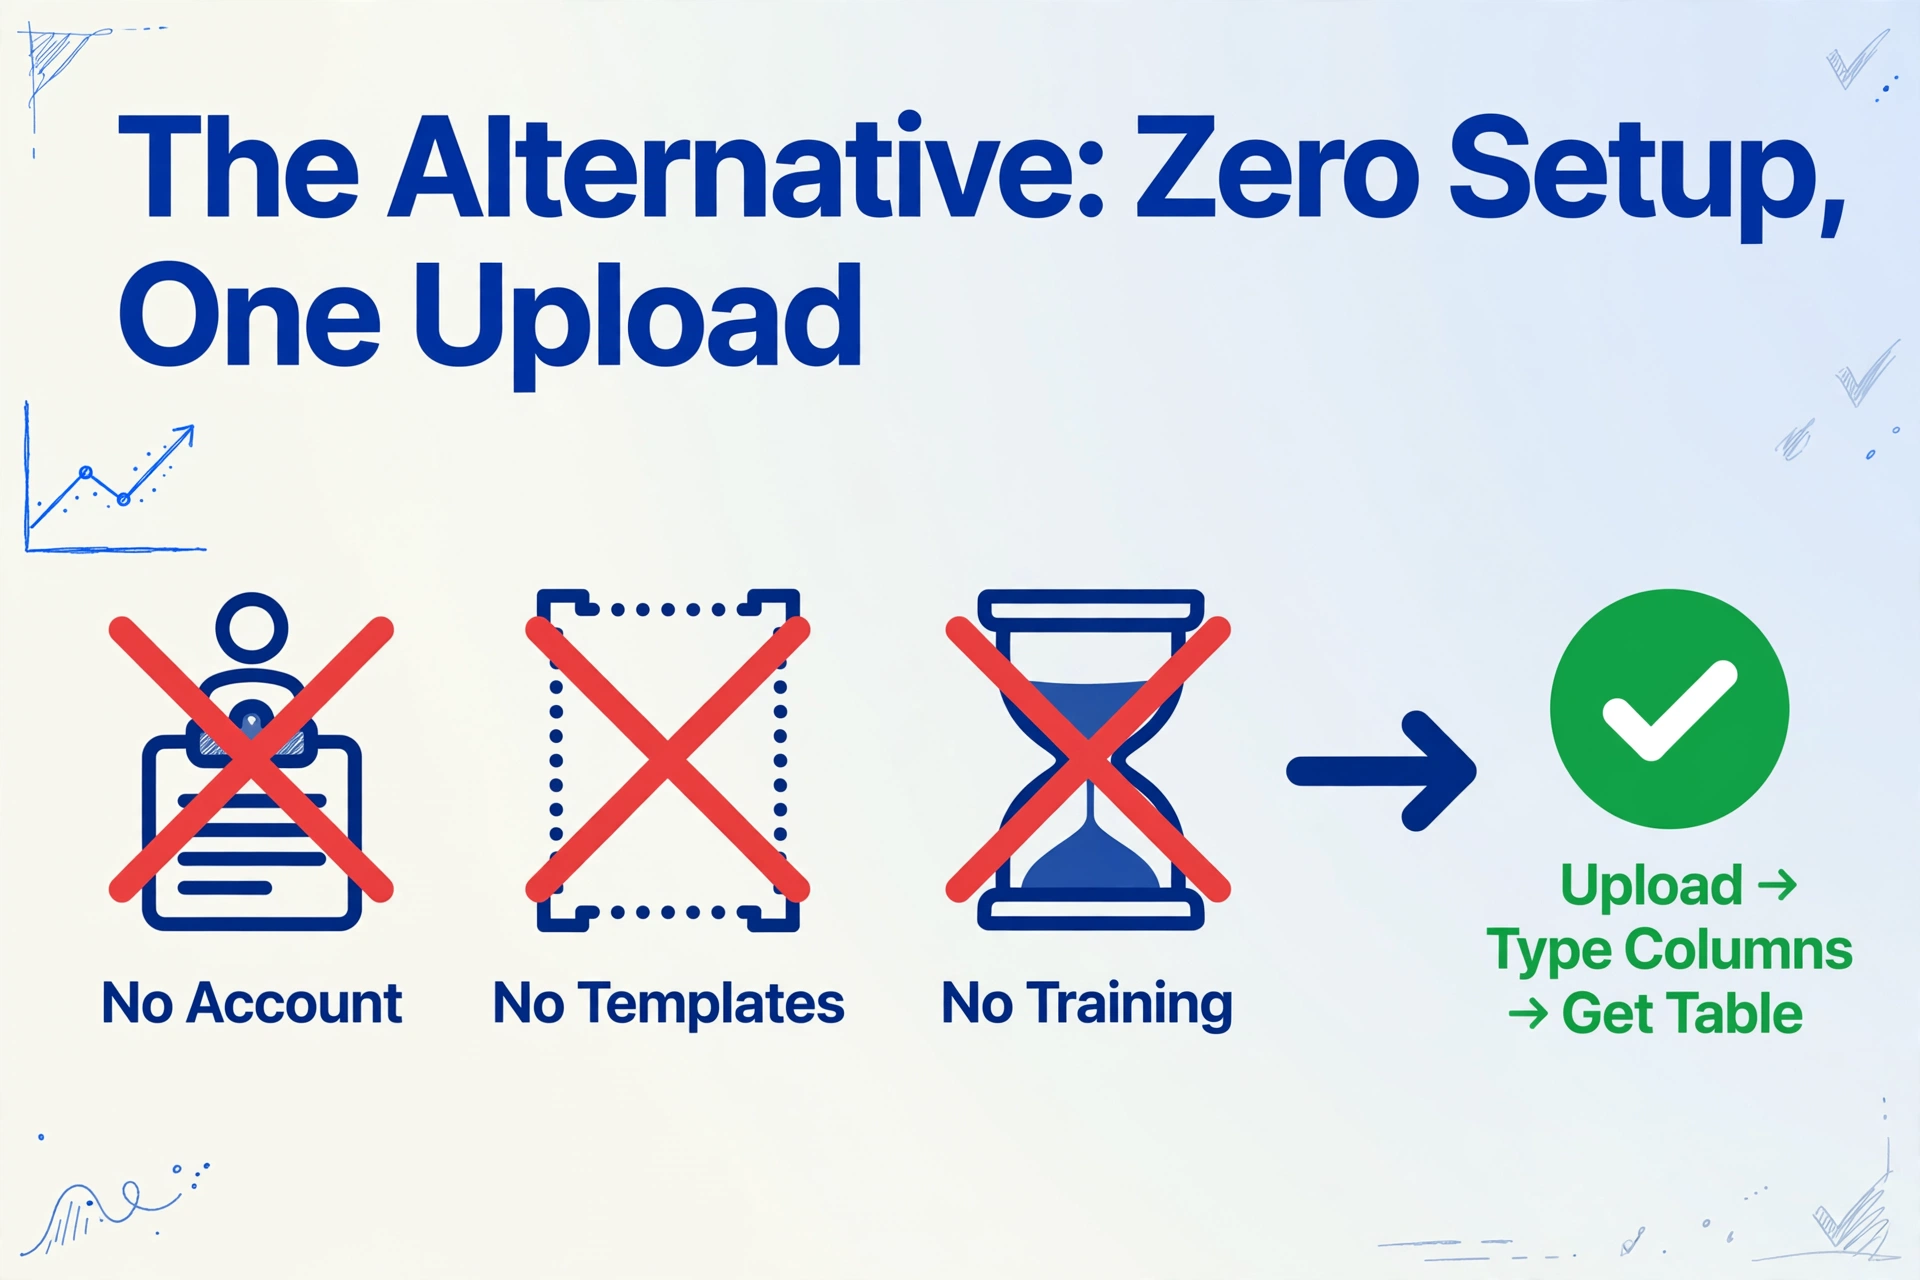
So sieht derselbe Workflow mit einem Tool aus, das auf einer anderen Annahme aufgebaut ist – dass Sie zur Extraktion gekommen sind, nicht zur Konfiguration.
Sie erstellen kein Konto. Sie öffnen die Seite, laden ein Dokument hoch und geben die gewünschten Spaltennamen ein: „Rechnungsnummer", „Datum", „Lieferant", „Zwischensumme", „Steuer", „Gesamtbetrag". Die KI liest das Dokument – nicht über Pixelkoordinaten, sondern indem sie versteht, was jedes Feld im Kontext bedeutet – und füllt diese Spalten. Das war's. Keine Registrierungshürde. Keine Vorlagen zum Zeichnen. Keine Trainingsbeispiele zum Beschriften. Kein Warten darauf, dass ein Modell lernt.
Dieser Ansatz – KI-Dateneingabe auf Basis visueller großer Sprachmodelle – behandelt Extraktion als semantisches Denkproblem, nicht als Mustererkennung. Das Modell wusste bereits, wie eine Rechnung aussieht, wo Daten typischerweise erscheinen, wie Summen formatiert sind und wie ein Lieferantenname-Feld im Kontext aussieht. Ihre Aufgabe ist nicht, es zu lehren – sondern ihm genau einmal zu sagen, was Sie wollen, für alle Ihre Dokumente, unabhängig vom Format.
Probieren Sie es unten aus. Laden Sie eine beliebige Rechnung hoch, geben Sie Ihre Spaltennamen ein und sehen Sie die Extraktion in Echtzeit – ohne einen der drei Schritte:
Dateien werden sicher verarbeitet und nicht gespeichert.
Die Verarbeitung dauert 5 bis 10 Sekunden pro Seite bei Standard-Geschäftsdokumenten, mit bis zu 99 % Genauigkeit bei gedrucktem Text mit guter Bildqualität. Der Batch-Modus führt mehrere Dokumente in einer Tabelle zusammen – laden Sie 20 Rechnungen von 20 verschiedenen Lieferanten hoch und erhalten Sie eine Tabelle mit allen, ohne Einrichtung pro Lieferant.
Warum das über den ersten Tag hinaus wichtig ist
Die Dreistufensteuer ist nicht nur eine Einführungskosten – sie ist wiederkehrend. Jedes Mal, wenn ein neuer Lieferant in Ihre Pipeline aufgenommen wird, jedes Mal, wenn ein bestehender Lieferant sein Dokumentenformat aktualisiert, jedes Mal, wenn Sie einen Dokumenttyp extrahieren müssen, den Sie noch nicht konfiguriert haben, zahlen Sie erneut.
Für ein Unternehmen mit 200 aktiven Lieferanten wird die Vorlagenwartung allein zu einer Teilzeitaufgabe. Bei 2.000 Lieferanten ist es eine Vollzeitstelle – jemand, dessen Aufgabe es ist, Extraktionsvorlagen am Leben zu erhalten, anstatt die extrahierten Daten tatsächlich zu nutzen. Das Werkzeug, das manuelle Arbeit überflüssig machen sollte, hat eine neue Kategorie manueller Arbeit geschaffen.
Die Alternative – vorlagenfreie, trainingsfreie, kontenoptionale Extraktion – ist nicht nur am ersten Tag schneller. Sie skaliert, ohne Wartungsschulden anzuhäufen. Zwanzig Lieferanten oder zweihundert, der Arbeitsablauf ist identisch: Dokumente hochladen, Spalten benennen, Tabelle erhalten. Formatänderungen unterbrechen die Extraktion nicht, weil die KI nicht an Koordinaten verankert oder auf statistische Muster trainiert ist, die veralten.
Sie müssen Ihre vorhandenen Werkzeuge nicht ersetzen, um dies zu testen. Sie können es jetzt mit einem einzelnen Stapel von Dokumenten ausprobieren und den Unterschied in einem Arbeitsablaufzyklus sehen – nicht nach einer Woche Einrichtung.
FAQ
Gibt es Werkzeuge, die tatsächlich alle drei Schritte überspringen?
Ja, aber sie sind immer noch die Minderheit auf dem Extraktionsmarkt. Die meisten vor 2023 gebauten Werkzeuge basieren entweder auf Vorlagen oder Modelltraining, weil ihre zugrunde liegende Architektur kein Zero-Shot-Dokumentenverständnis unterstützt. ImageToTable.ai wurde von Anfang an auf visuellen LLMs aufgebaut – derselben Modellklasse wie Claude und GPT-4V – was bedeutet, dass es Dokumente durch semantisches Verständnis liest, anstatt durch Pixelkoordinaten oder statistische Muster. Der Kompromiss sind die Kosten pro Seite: LLM-Inferenz ist teurer als traditionelle OCR oder lokale statistische Modelle. Aber für die meisten Teams, die Hunderte bis Tausende von Dokumenten pro Monat verarbeiten, überwiegt die eingesparte Einrichtungs- und Wartungszeit den Kostenunterschied pro Seite.
Wie genau ist die Extraktion ohne Vorlagen oder Training?
Bis zu 99 % bei gedrucktem Text aus Standard-Geschäftsdokumenten — Rechnungen, Quittungen, Bestellungen, Kontoauszüge — bei guter Bildqualität. Die Genauigkeit hängt hauptsächlich von der Bildqualität (Beleuchtung, Schärfe, Auflösung), der Dokumentenkomplexität (dichte mehrspaltige Tabellen, gemischte Schriftarten) und der Feldklarheit (klar beschriftet vs. implizit oder unbeschriftet) ab. Handschriftlicher Inhalt und Scans schlechter Qualität verringern die Genauigkeit. Bei kritischen Finanzdokumenten wird empfohlen, die ersten Extraktionen eines neuen Dokumenttyps stichprobenartig zu prüfen — dieselbe Vorgehensweise wie bei jedem anderen Extraktionstool, trainiert oder nicht.
Ist der Gastmodus für Dokumente mit sensiblen Finanzdaten sicher?
ImageToTable.ai verarbeitet Dokumente zur Extraktion im Arbeitsspeicher und speichert keine hochgeladenen Dateien. Jede Verarbeitungssitzung ist unabhängig — Dateien werden nicht aufbewahrt, indiziert oder zum Trainieren der KI verwendet. Für Teams, die einen dauerhaften Verlauf, Batch-Verwaltung und Vorlageneinstellungen benötigen, bietet ein kostenloses Konto diese Funktionen, ohne den Extraktionsablauf zu ändern. Der Gastmodus und der Kontomodus verwenden dieselbe Extraktions-Engine und dieselbe Sicherheitsarchitektur — der einzige Unterschied ist, ob Ihr Verarbeitungsverlauf in Ihrem Konto gespeichert wird.