3 cosas que las herramientas de extracción te obligan a hacer
Y la 1 que las omite
La mayoría de las herramientas de extracción de documentos comparten una suposición tácita: que estás dispuesto a hacer trabajo de configuración antes de obtener valor alguno. No minutos de configuración, sino horas, a veces días. Estas son las tres cosas que casi todas las herramientas de extracción del mercado te piden antes de producir una sola fila de datos, cuánto cuesta cada una en tiempo real y la única herramienta diseñada para omitirlas todas.
Conclusiones clave
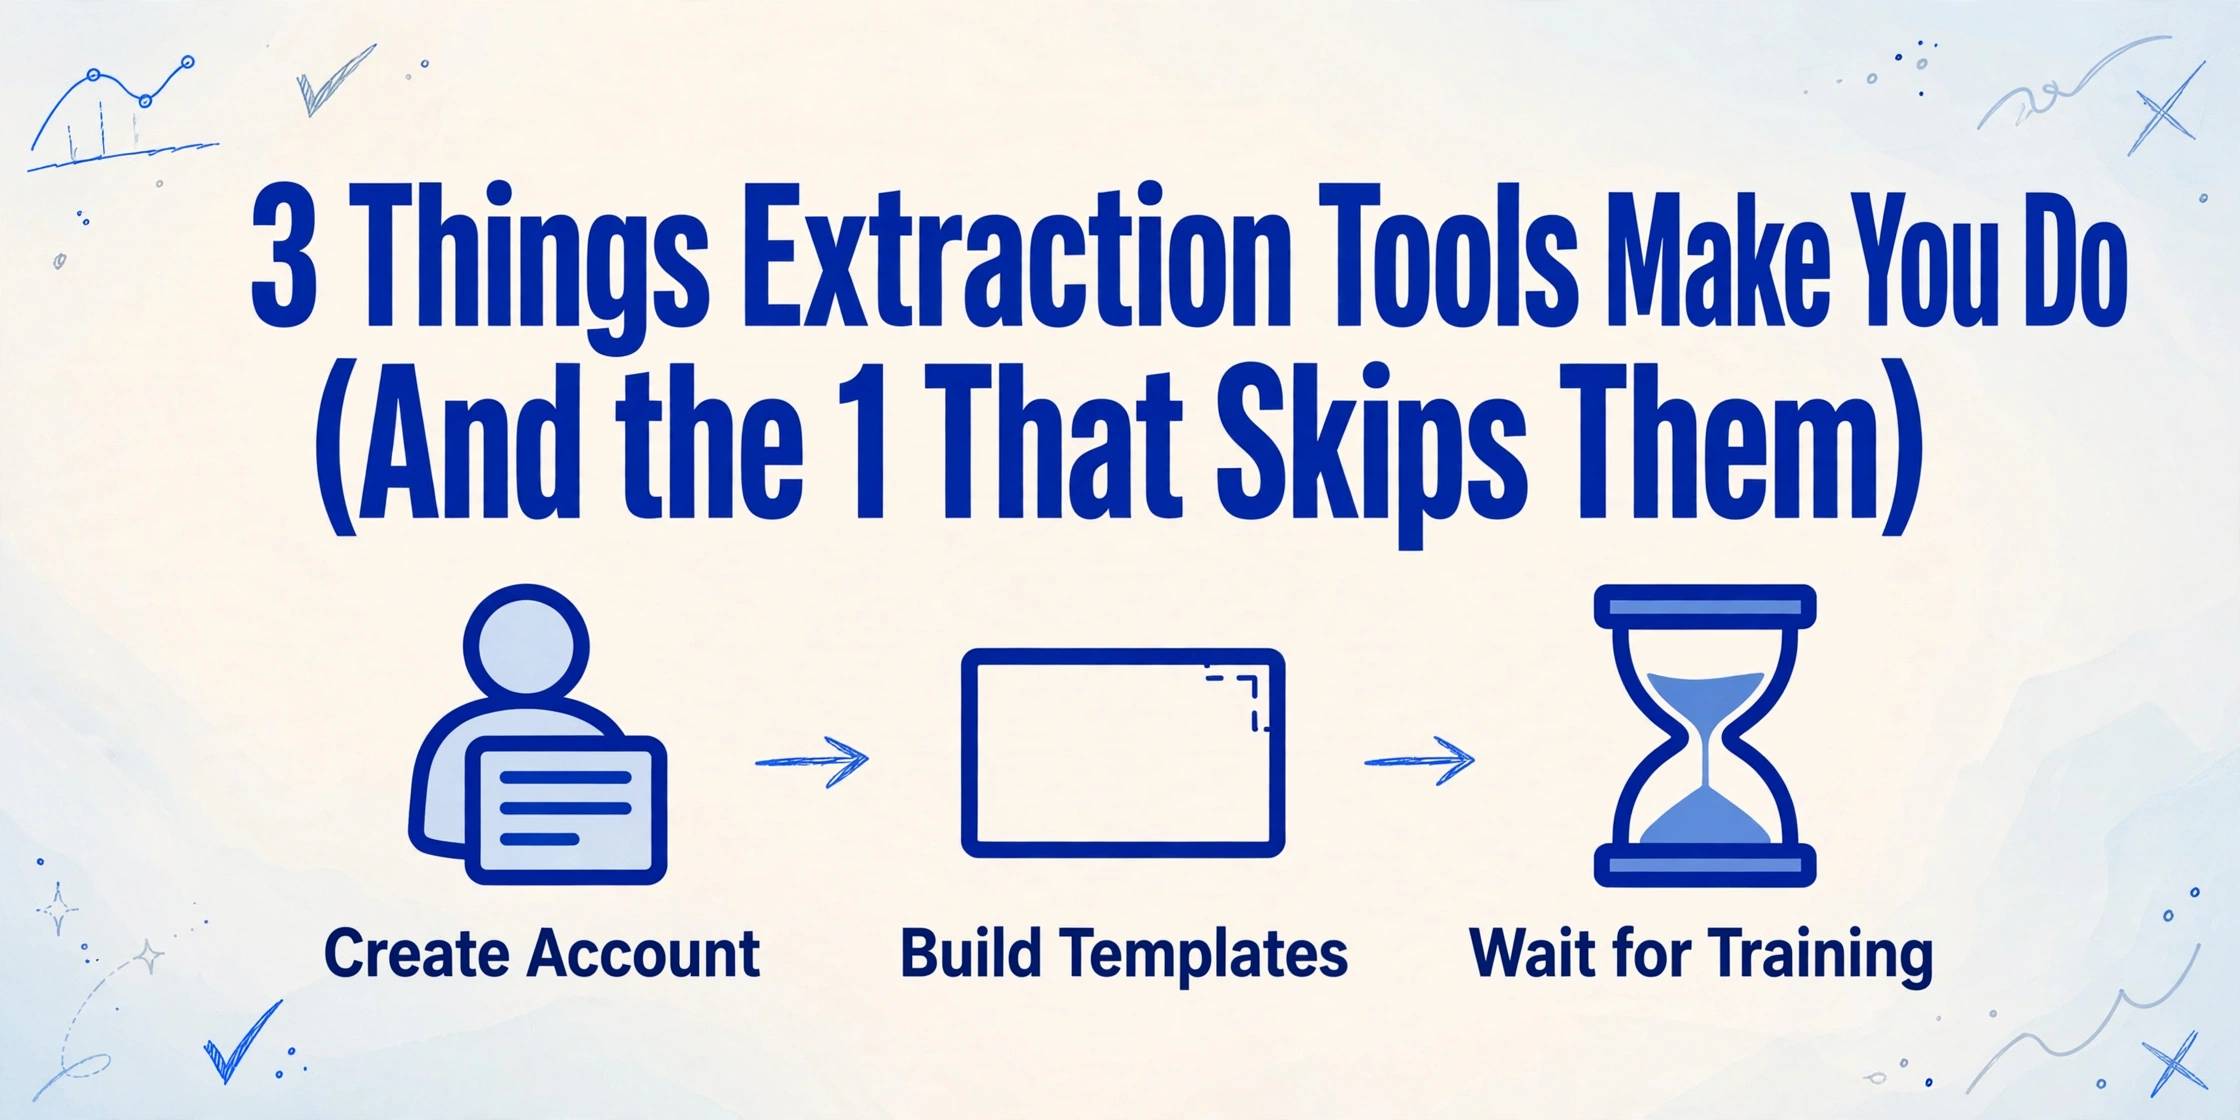
- Antes de que la extracción siquiera comience, la mayoría de las herramientas requieren tres pasos de configuración: registrar una cuenta, crear plantillas por proveedor y esperar horas a que termine el entrenamiento del modelo.
- Con 200 proveedores, el mantenimiento de plantillas consume media semana laboral y cada cambio de formato del proveedor rompe silenciosamente tu pipeline de extracción.
- Omite los tres pasos: abre un navegador, sube cualquier factura, nombra tus columnas y obtén datos estructurados sin registro, plantillas ni entrenamiento.
Paso 1: Cree una cuenta antes de poder probar nada
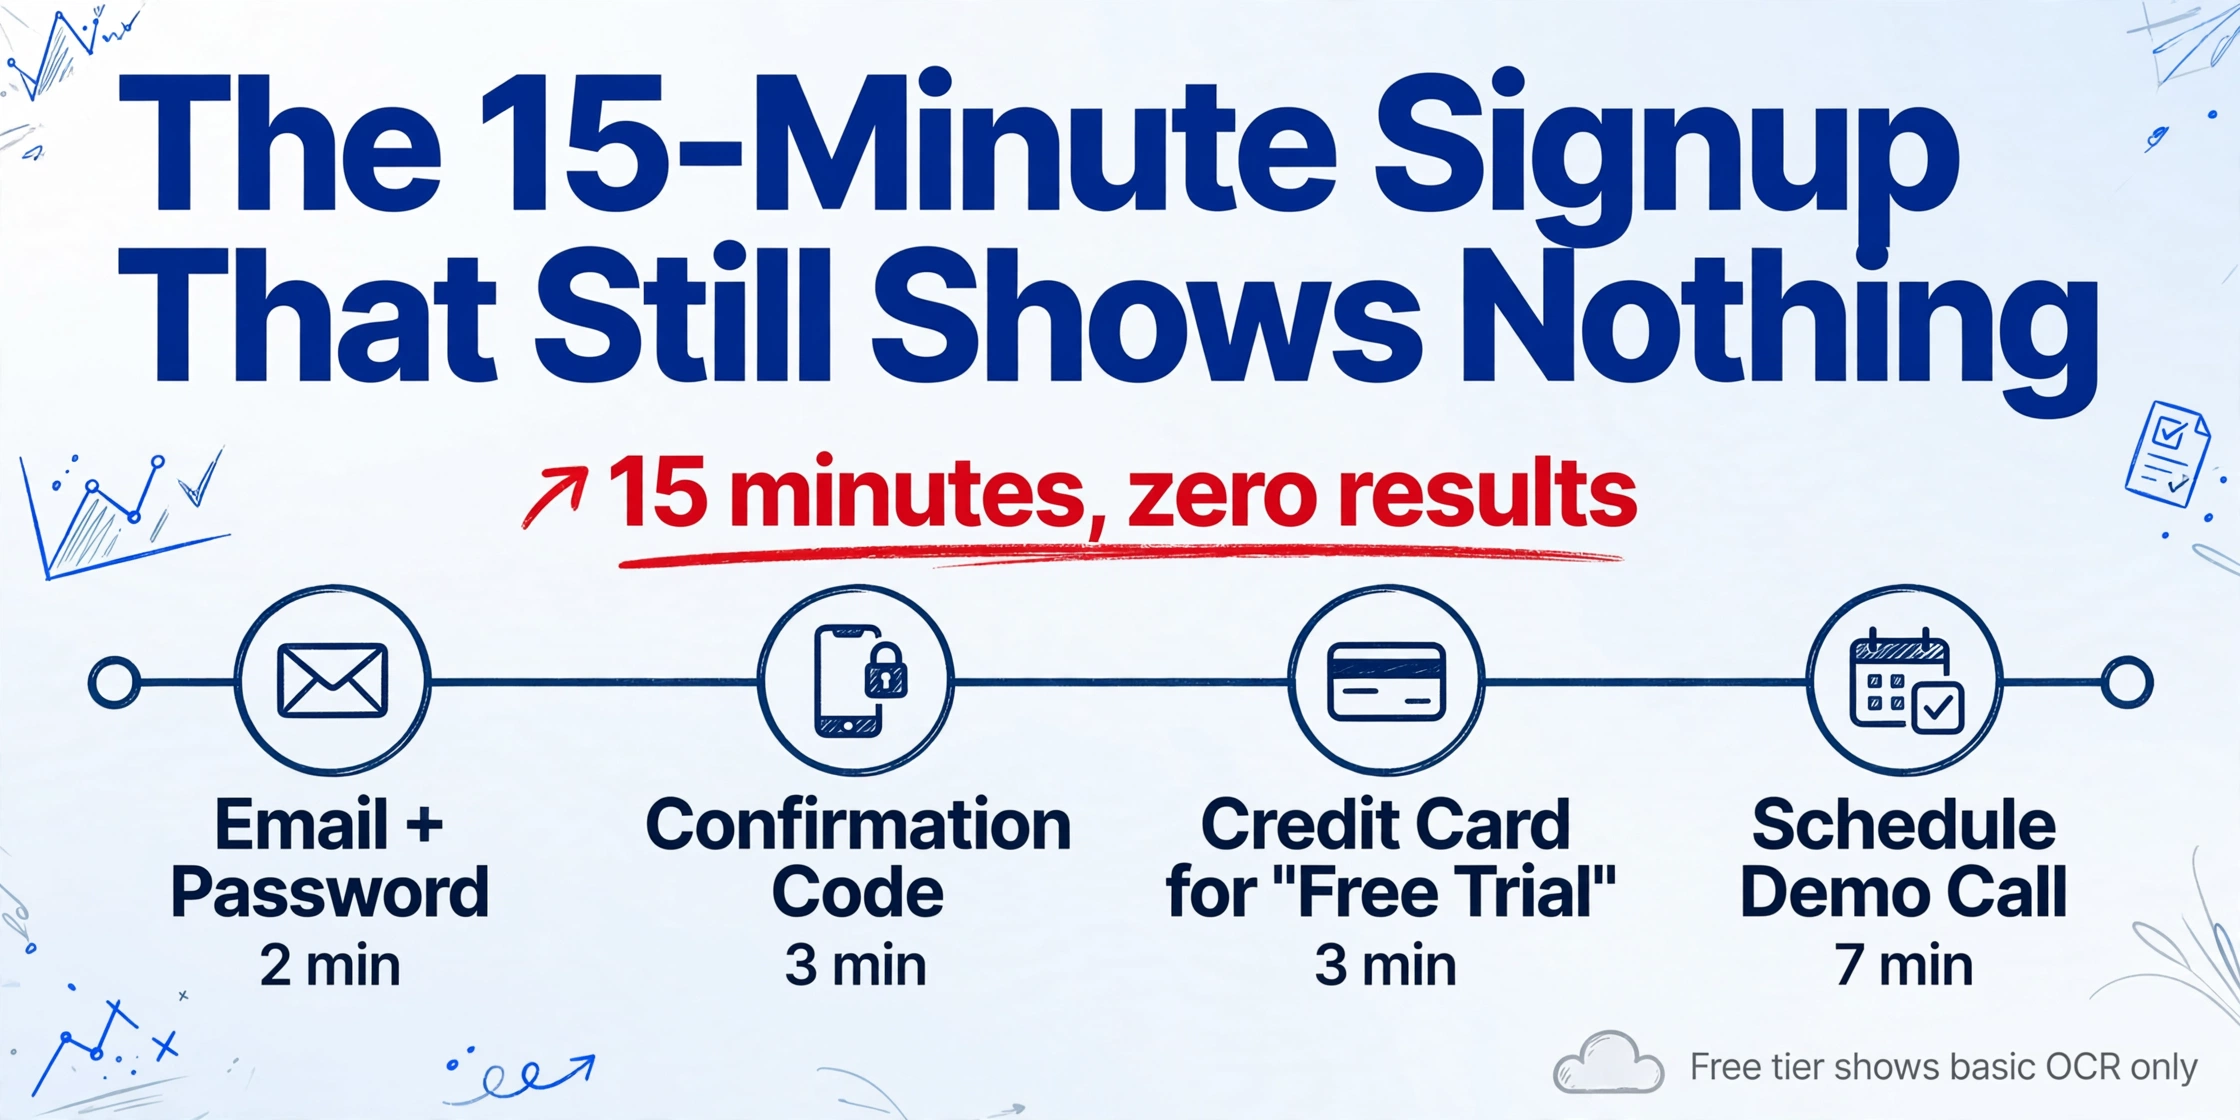
Lo primero que la mayoría de las herramientas de extracción solicitan no es un documento, sino una dirección de correo electrónico. Y una contraseña. Y un código de confirmación. A veces, una tarjeta de crédito para la "prueba gratuita".
El registro es el más pequeño de los tres pasos — quizás 5 minutos — pero representa una filosofía de diseño: la herramienta quiere capturarlo como cliente potencial antes de demostrar su valor. Usted se compromete antes de haber subido un solo archivo o de haber visto cómo la extracción maneja sus documentos reales.
Peor aún, la fricción no termina con el registro. Muchas herramientas restringen la calidad de su extracción detrás de planes de pago, por lo que el nivel gratuito le muestra OCR básico mientras que la extracción real con IA está detrás de un muro de suscripción. Usted completa la configuración de la cuenta solo para darse cuenta de que aún no puede probar la función para la que vino.
En r/Accounting de Reddit, un tenedor de libros que evaluaba herramientas resumió la frustración: "Solo quiero ver si funciona con mis facturas antes de comprometerme con algo". Eso es más difícil de lo que parece: la mayoría de las herramientas hacen que el paso de "probar antes de comprometerse" sea la parte más larga del proceso.
El registro en sí toma 5 minutos. Pero el costo oculto es el cambio de contexto: usted abre la página de registro de la herramienta, cambia a su correo electrónico para confirmar, vuelve a cambiar, completa los datos de su organización, quizás programa una llamada de demostración. Para cuando sube su primer documento, han pasado 15 minutos y aún no ha visto un resultado.
Paso 2: Cree una plantilla para cada proveedor que le envíe documentos
Las herramientas basadas en plantillas — aquellas en las que dibuja rectángulos alrededor de cada campo en un documento de muestra — representan la mayor pérdida de tiempo en el proceso de incorporación de extracción.
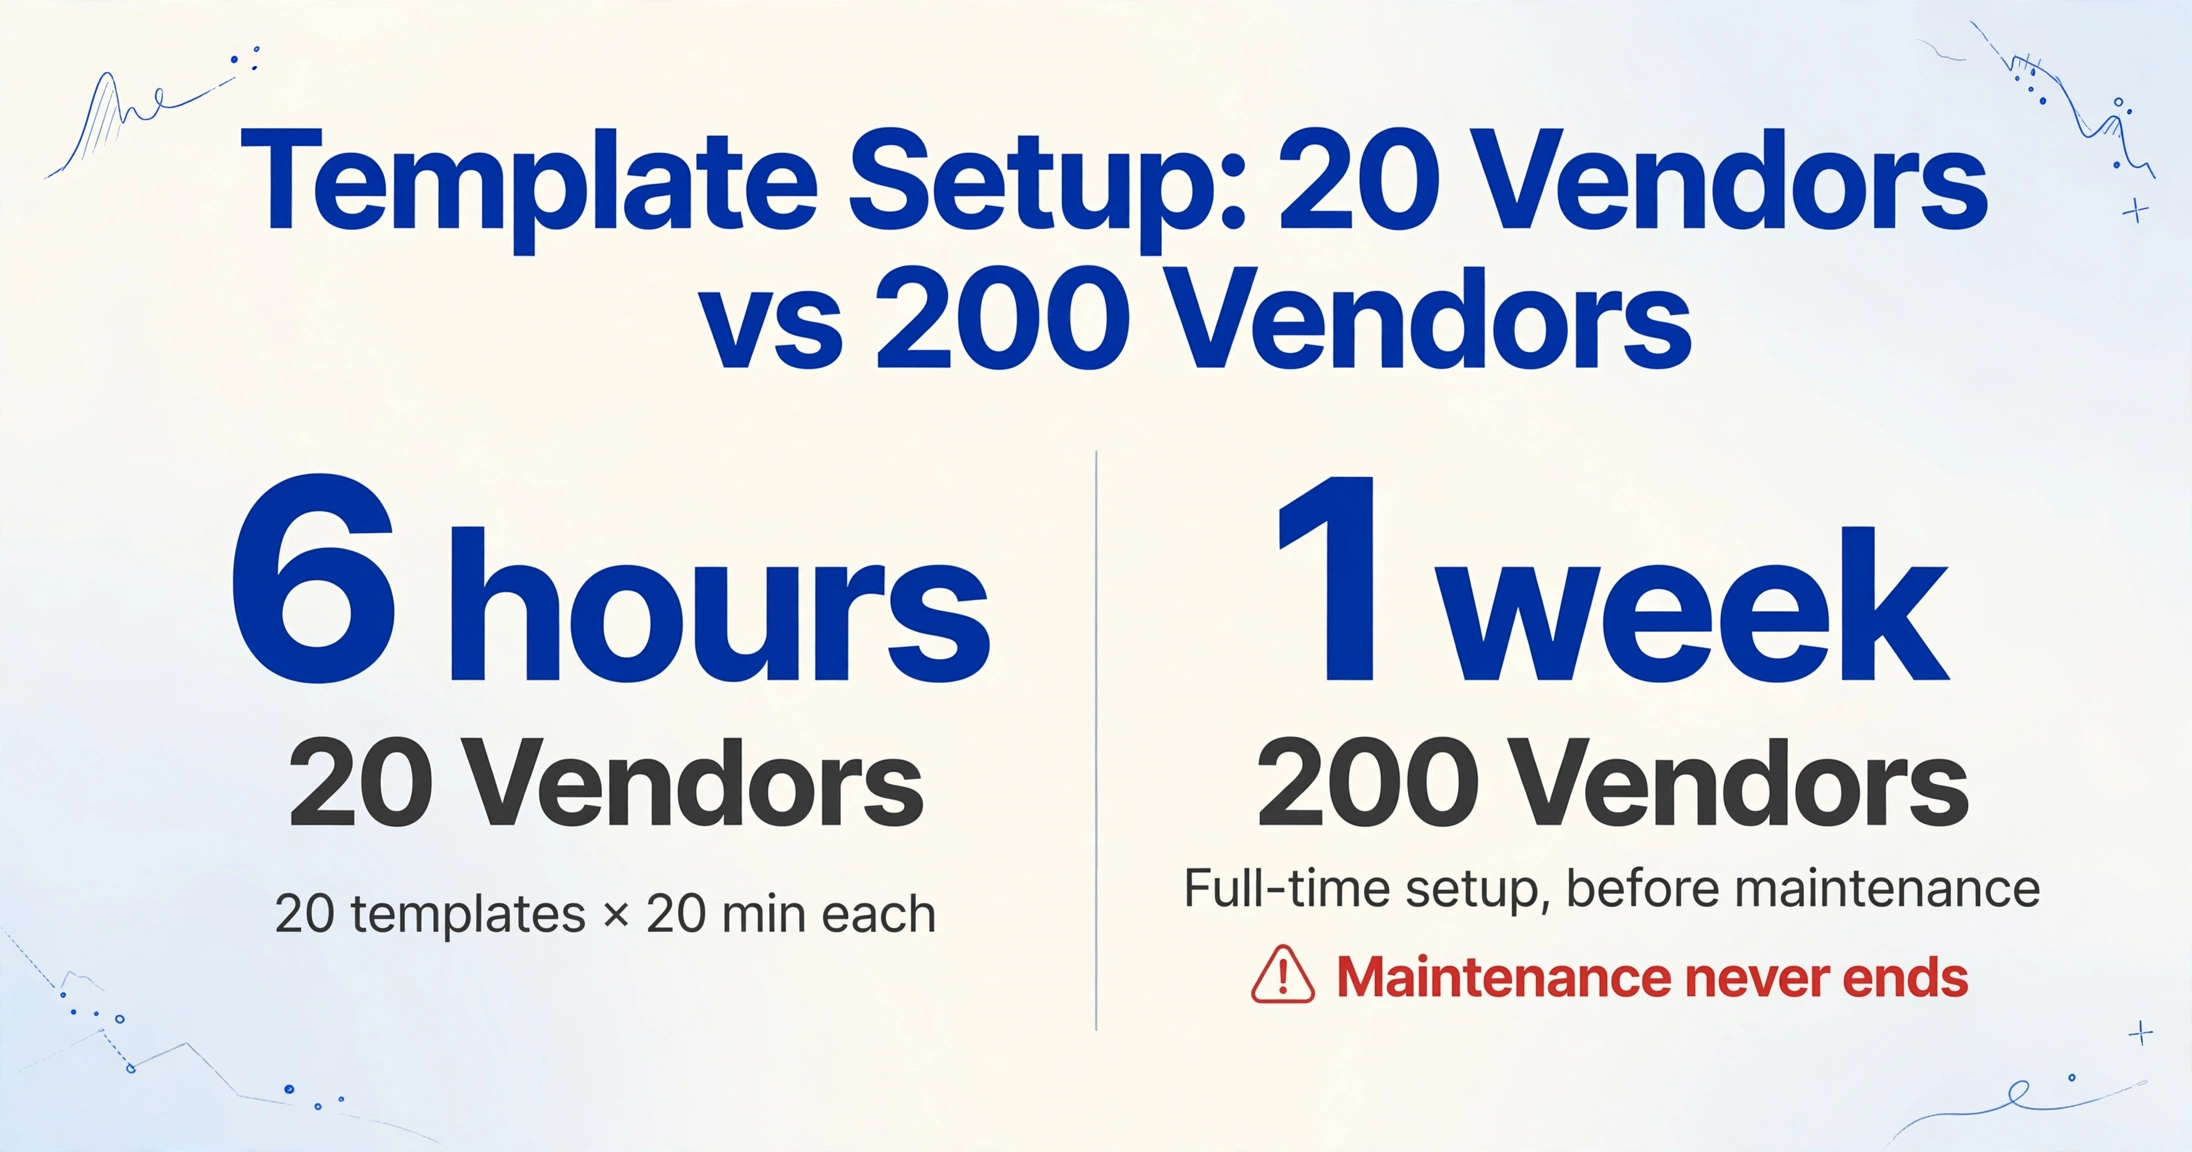
Aquí están los números. Configurar una plantilla toma de 15 a 30 minutos: suba un documento de muestra, dibuje la zona para el Número de Factura, dibuje otra para la Fecha, otra para el Proveedor, otra para el Total, pruebe con algunas facturas recientes de ese proveedor, corrija los desajustes, repita. Veinte minutos, más o menos, por proveedor.
Ahora multiplique. Una pequeña empresa con 20 proveedores habituales enfrenta 20 configuraciones de plantillas — aproximadamente 6 horas dibujando rectángulos antes de que el sistema esté listo para producción. ¿Una empresa de tamaño mediano con 200 proveedores? Eso es una semana completa del tiempo de alguien, solo en la configuración inicial. Y el mantenimiento nunca termina.
Cuando un proveedor rediseña su factura — nuevo sistema ERP, plantilla renombrada, campos de cumplimiento añadidos — la plantilla basada en coordenadas se rompe. No lanza un error. Extrae silenciosamente cualquier texto que ahora ocupe las antiguas posiciones de píxeles. Una dirección de envío termina en su columna de fecha. Un subtotal reemplaza su monto de impuestos. El resultado parece plausible hasta que la conciliación detecta el desajuste, lo que podría ocurrir días después.
Según un análisis independiente que cita la investigación de la industria de Docsumo, las organizaciones que utilizan procesamiento de documentos basado en plantillas gastan un promedio de 6 a 8 semanas por cada nuevo formato de documento para configurar, probar y validar las reglas de extracción. Con una base amplia de proveedores y cambios frecuentes de formato, el costo de mantenimiento continuo rivaliza con la implementación original.
Como dijo un usuario en r/automation, después de pasar un año manteniendo plantillas de OCR para diferentes diseños de facturas: "Fue una pesadilla total de mantener en cuanto un proveedor cambiaba su formato." Otro comentarista en r/Accounting lo expresó de manera más directa: lo principal a evitar es "cualquier cosa que requiera configurar plantillas por proveedor — con múltiples clientes enviando formatos diferentes, eso consumirá más tiempo del que ahorra."
Paso 3: Espere a que finalice el entrenamiento del modelo
Si ha dejado atrás las plantillas y ha pasado a la extracción basada en aprendizaje automático —las herramientas "modernas" que dicen aprender de sus datos—, ha cambiado un tipo de espera por otro.
Estas plataformas no le hacen dibujar rectángulos. En su lugar, le piden datos de entrenamiento etiquetados: de 50 a 200 documentos de muestra en los que usted ha marcado manualmente qué valor corresponde a cada campo. Cuantas más muestras, mejor predice el modelo la posición de los campos en documentos nuevos. El etiquetado en sí toma de 10 a 20 horas de trabajo concentrado. Luego espera mientras el modelo se entrena —de horas a un día o más, según el volumen.
La promesa es atractiva: una vez entrenado, el modelo gestiona ese tipo de documento automáticamente. La realidad para la mayoría de los equipos es que el entrenamiento no es un evento único. Cada nuevo proveedor con un diseño significativamente distinto requiere muestras adicionales. Cada cambio de formato del proveedor exige reentrenar. Las predicciones del modelo se degradan silenciosamente cuando los formatos cambian, y usted no lo sabrá hasta que alguien detecte el error más adelante.
Esta es la ironía central del enfoque de segunda generación: las herramientas que debían eliminar las plantillas las reemplazaron por mantenimiento del modelo. Ya no dibuja zonas, pero recolecta muestras, etiqueta campos, reentrena ante cambios de formato y supervisa la deriva de precisión. El trabajo pasó de "por documento" a "por ciclo de entrenamiento", pero no desapareció.
Para un análisis más profundo de por qué algunas herramientas aún requieren datos de entrenamiento y otras no, consulte nuestro desglose sobre extracción sin plantillas —explica la diferencia arquitectónica entre las herramientas que leen documentos por posición de píxel y las que los leen por significado semántico.
Una herramienta de extracción de documentos que necesita 50 muestras etiquetadas para encontrar el "Importe Total" en una factura no está leyendo el documento. Está aprendiendo una distribución de probabilidad sobre dónde tiende a ubicarse ese valor en una página —y esperando que la próxima factura lo coloque aproximadamente en el mismo lugar.
La alternativa: qué sucede cuando omite los tres pasos
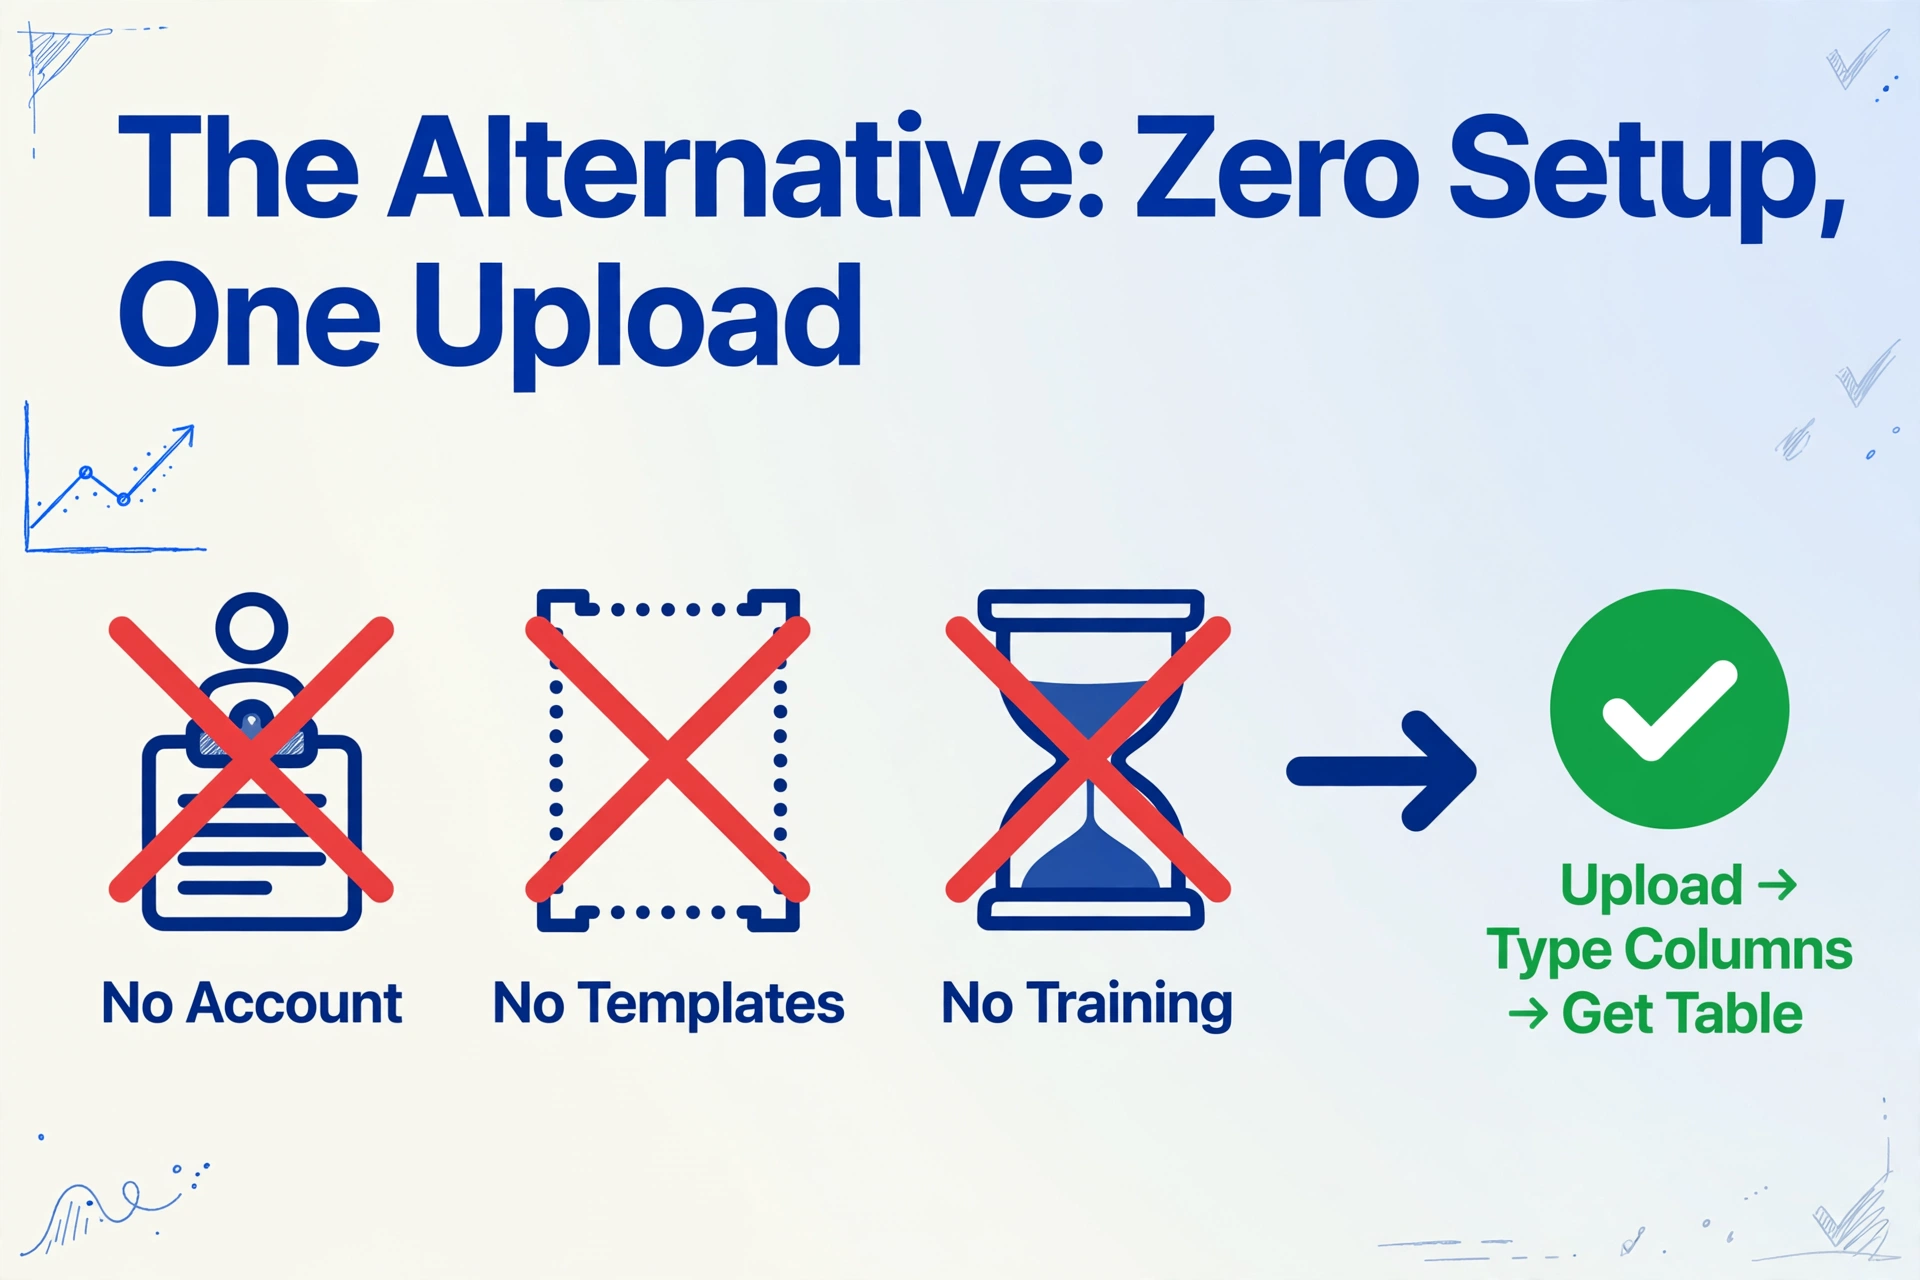
Así es como se ve el mismo flujo de trabajo en una herramienta construida sobre una premisa diferente: que usted vino a extraer, no a configurar.
No crea una cuenta. Abre la página, sube un documento y escribe los nombres de las columnas que desea: "Número de factura", "Fecha", "Proveedor", "Subtotal", "Impuesto", "Total". La IA lee el documento — no por coordenadas de píxeles, sino comprendiendo qué significa cada campo en su contexto — y completa esas columnas. Eso es todo. Sin registro obligatorio. Sin plantillas que dibujar. Sin muestras de entrenamiento que etiquetar. Sin esperar a que un modelo aprenda.
Este enfoque — entrada de datos con IA impulsada por modelos visuales de lenguaje de gran escala — trata la extracción como un problema de razonamiento semántico, no de coincidencia de patrones. El modelo ya sabe cómo es una factura, dónde suelen aparecer las fechas, cómo se formatean los totales y cómo se lee un campo de nombre de proveedor en contexto. Su trabajo no es enseñarle — es decirle qué quiere, una sola vez, para todos sus documentos, independientemente del formato.
Pruébelo a continuación. Suba cualquier factura, escriba los nombres de sus columnas y vea la extracción en tiempo real — sin ninguno de los tres pasos:
Los archivos se procesan de forma segura y no se almacenan.
El procesamiento toma de 5 a 10 segundos por página en documentos comerciales estándar, con hasta un 99% de precisión en texto impreso con buena calidad de imagen. El modo batch fusiona varios documentos en una sola hoja de cálculo: suba 20 facturas de 20 proveedores diferentes y obtenga una tabla con todas ellas, sin configuración por proveedor.
Por qué esto importa más allá del primer día
El impuesto de tres pasos no es solo un costo de incorporación, sino recurrente. Cada vez que un nuevo proveedor entra en tu flujo, cada vez que uno existente actualiza el formato de sus documentos, cada vez que necesitas extraer un tipo de documento que aún no has configurado, lo pagas de nuevo.
Para una empresa con 200 proveedores activos, solo el mantenimiento de plantillas se convierte en un trabajo de medio tiempo. Con 2,000 proveedores, es un puesto dedicado: alguien cuyo trabajo es mantener vivas las plantillas de extracción, no usar los datos extraídos. La herramienta que debía eliminar el trabajo manual creó una nueva categoría de trabajo manual.
La alternativa — extracción sin plantillas, sin entrenamiento, sin cuenta — no solo es más rápida el primer día. Escala sin acumular deuda de mantenimiento. Veinte proveedores o doscientos, el flujo de trabajo es idéntico: sube documentos, nombra tus columnas, obtén tu tabla. Los cambios de formato no rompen la extracción porque la IA no está anclada a coordenadas ni entrenada en patrones estadísticos que caducan.
No tienes que reemplazar tus herramientas actuales para probarlo. Puedes intentarlo con un solo lote de documentos ahora mismo y ver la diferencia en un ciclo de trabajo, no después de una semana de configuración.
Preguntas frecuentes
¿Existen herramientas que realmente omitan estos tres pasos?
Sí, pero siguen siendo minoría en el mercado de extracción. La mayoría de las herramientas creadas antes de 2023 dependen de plantillas o entrenamiento de modelos porque su arquitectura subyacente no admite la comprensión de documentos sin ejemplos previos. ImageToTable.ai se construyó desde el primer día con LLM visuales — la misma clase de modelos detrás de Claude y GPT-4V — lo que significa que lee documentos mediante comprensión semántica, no coordenadas de píxeles ni patrones estadísticos. La desventaja es el costo por página: la inferencia de LLM es más cara que el OCR tradicional o los modelos estadísticos locales. Pero para la mayoría de los equipos que procesan cientos o miles de documentos al mes, el tiempo de configuración y mantenimiento eliminado supera la diferencia de costo por página.
¿Qué precisión tiene la extracción sin plantillas ni entrenamiento?
Hasta un 99% en texto impreso de documentos comerciales estándar — facturas, recibos, órdenes de compra, estados bancarios — con buena calidad de imagen. La precisión depende principalmente de la calidad de la imagen (iluminación, enfoque, resolución), la complejidad del documento (tablas densas de varias columnas, fuentes mixtas) y la claridad de los campos (etiquetados claramente vs. implícitos o sin etiquetar). El contenido manuscrito y los escaneos de baja calidad reducen la precisión. Para documentos financieros críticos, se recomienda verificar las primeras extracciones de un nuevo tipo de documento — la misma práctica que seguiría con cualquier herramienta de extracción, entrenada o no.
¿Es seguro el modo invitado para documentos con datos financieros sensibles?
ImageToTable.ai procesa los documentos en memoria para la extracción y no almacena los archivos subidos. Cada sesión de procesamiento es independiente: los archivos no se retienen, indexan ni se usan para entrenar la IA. Para equipos que necesitan historial persistente, gestión por lotes y plantillas predefinidas, crear una cuenta gratuita añade esas funciones sin cambiar el flujo de extracción. El modo invitado y el modo con cuenta usan el mismo motor de extracción y la misma arquitectura de seguridad; la única diferencia es si su historial de procesamiento se guarda en su cuenta.