Vos employés envoient des captures d'écran de notes de frais.
La finance passe 20 minutes à saisir chacune.
Il est lundi, 9 h 17. La boîte de réception de la finance contient 37 messages non lus — tous des soumissions de notes de frais. Douze sont des captures d'écran d'applications de paiement : confirmations de transaction Alipay, reçus WeChat Pay, captures de l'application bancaire Chase affichant « Pending - $47.19 ». Neuf sont des photos de reçus physiques prises à bout de bras sous l'éclairage fluorescent du bureau — une est à l'envers. Huit sont des pièces jointes transférées par e-mail : confirmations de réservation d'hôtel, récapitulatifs de trajets VTC, accusés de réception de commandes en ligne. Les huit restantes sont un mélange : une capture d'écran d'un tableur qu'un employé utilisait comme son propre suivi de frais, deux factures PDF de fournisseurs et trois fils de SMS transférés sous forme de captures d'écran. Chacune contient des données que quelqu'un à la finance passera la journée à lire puis à ressaisir dans le tableur de notes de frais de l'entreprise. Selon le repère de la GBTA Foundation de 20 minutes par note de frais, ces 37 soumissions représentent environ 12 heures de saisie manuelle — un jour et demi de la semaine de travail de quelqu'un passé à regarder des images et à taper des chiffres déjà visibles à l'écran. Les données sont là. Elles ne sont simplement pas là où le tableur en a besoin.
Pourquoi les captures d'écran de notes de frais sont plus difficiles à traiter que les reçus papier
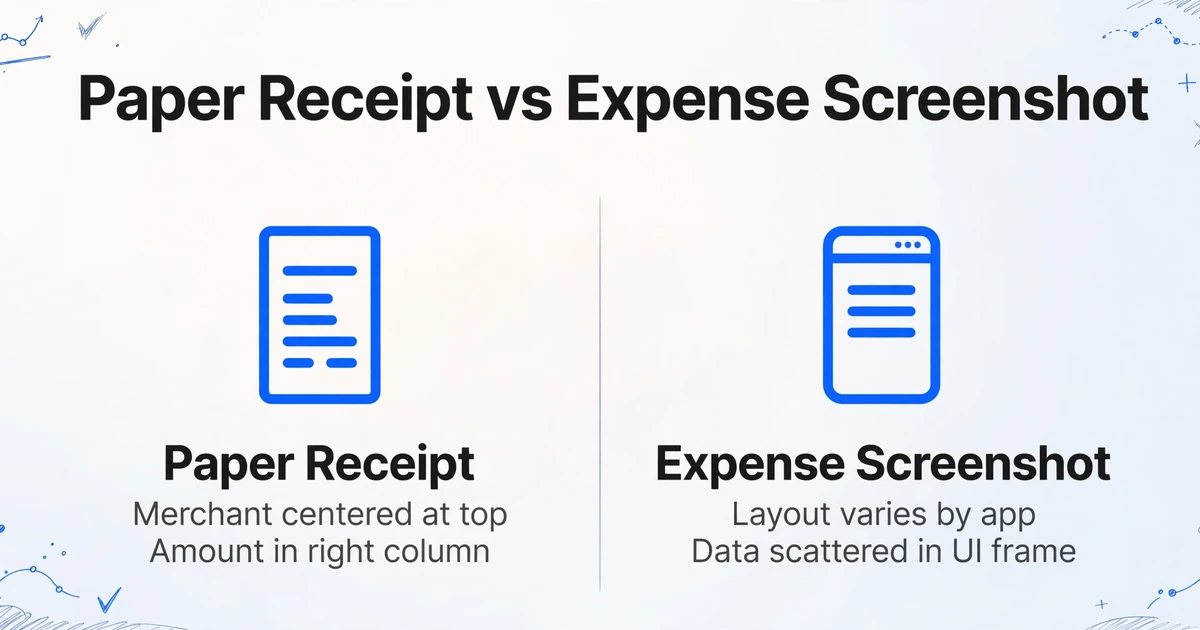
Un reçu papier a une structure prévisible. Le nom du commerçant est centré en haut. La date, l'heure et l'identifiant de transaction apparaissent dans un bloc compact juste en dessous. Les lignes d'articles, le sous-total, la taxe et le total forment une colonne verticale sur le côté droit du ticket. Cette disposition est restée quasiment inchangée pendant trente ans — tous les systèmes de point de vente en Amérique du Nord impriment des reçus qui suivent à peu près le même modèle.
Une capture d'écran d'une transaction de note de frais prise sur un téléphone n'a rien de cette prévisibilité. Une confirmation de paiement Alipay place le nom du commerçant en gras en haut au centre, le montant en gros chiffres colorés en dessous, le moyen de paiement dans une étiquette bleue, et l'heure de la transaction en petits caractères gris en bas — le tout dans une interface d'application de marque avec des barres de navigation, des icônes de barre d'état et une couleur d'arrière-plan. Une capture d'écran de l'application bancaire Chase place le nom du commerçant dans la colonne de gauche d'une liste de transactions, le montant à droite, et la date au-dessus dans une police différente — dans une mise en page d'interface totalement différente. Une confirmation par e-mail transférée sous forme de capture d'écran contient les détails de réservation intégrés au corps du texte, mêlés à des en-têtes de réponse et des blocs de signature.
Les mêmes données de note de frais — date, commerçant, montant, catégorie, moyen de paiement — disposées selon trois mises en page visuelles totalement différentes issues de trois sources de captures d'écran. C'est ce qui rend l'extraction depuis une capture d'écran fondamentalement plus difficile que la numérisation de reçus : les données ne sont pas simplement à des positions différentes sur le même modèle. Elles sont intégrées dans différentes architectures d'information — une interface de confirmation de transaction n'est pas une interface de relevé bancaire, qui n'est pas un corps d'e-mail. Un lecteur humain s'y retrouve sans effort parce qu'il comprend que « $47.19 » à côté d'une icône de café dans une application de paiement signifie la même chose que « 47.19 » dans la colonne « Amount » d'une liste de transactions bancaires. L'OCR traditionnel ne le comprend pas. Il lit les caractères en séquence, de haut en bas, de gauche à droite — et sur une capture d'écran, cette séquence n'a souvent aucun sens sémantique.
Une confirmation d'application de paiement, une liste de transactions d'application bancaire et une confirmation de réservation par e-mail sont trois architectures d'information différentes qui décrivent la même note de frais. L'OCR traditionnel lit chacune comme un flux plat de caractères. L'extraction visuelle par IA lit chacune comme une source de données structurée — comprenant que le grand nombre au centre d'une interface de confirmation de paiement est le montant de la transaction, quelle que soit l'application qui a généré la capture d'écran.
Le coût réel de la saisie manuelle des données à partir de captures d'écran : 58 $ par note de frais, le plancher
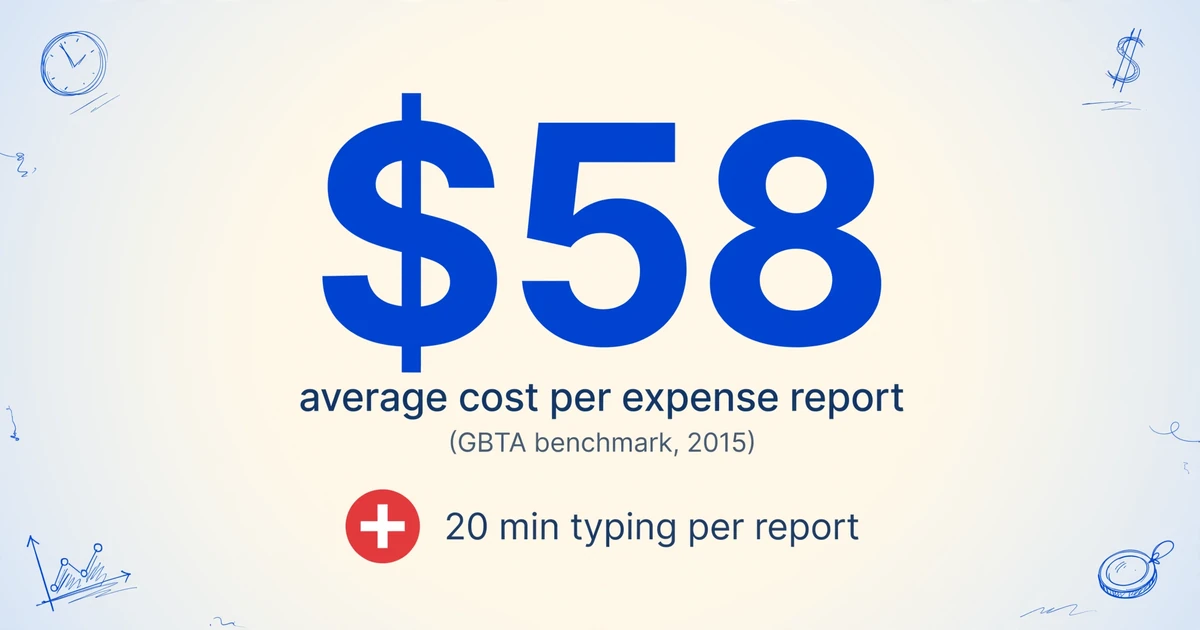
Le benchmark de la Global Business Travel Association — 58 $ par note de frais, 20 minutes de traitement par note de frais — a été mesuré en 2015 et reste le chiffre sectoriel le plus largement cité. SAP Concur le cite. Ramp le cite. Tous les fournisseurs de gestion des notes de frais l'utilisent comme référence. Mais l'étude GBTA mesurait un flux de travail global de notes de frais — de la soumission par l'employé à l'approbation par le manager, puis à la revue financière et au remboursement. Lorsque la preuve de dépense arrive sous forme de capture d'écran ou de photo, le coût se concentre sur une seule étape : la saisie manuelle des données visibles dans le tableur.
La ventilation issue de la même étude GBTA, réanalysée par points de friction : 54 % des acheteurs de voyages dans les entreprises sans logiciel de notes de frais tiers ont identifié « la saisie des données » comme un point de friction majeur. 55 % ont identifié « la jointure des reçus ». La création des notes de frais (49 %) était le point suivant le plus cité. Ces trois étapes — le début du processus de notes de frais — représentent la majorité des 20 minutes. L'étape « saisie des données » à elle seule, lorsque la preuve est une capture d'écran sans données lisibles par machine intégrées, consomme environ 12 à 15 de ces 20 minutes par note de frais.
Le taux d'erreur aggrave la situation. L'étude GBTA a constaté que 19 % des notes de frais contiennent des erreurs, et chaque correction coûte 52 $ et 18 minutes supplémentaires. La saisie manuelle à partir de captures d'écran est particulièrement sujette aux erreurs : une confirmation d'application de paiement de 47,19 $ devient 47,91 $ lorsque l'œil du gestionnaire financier saute entre la capture d'écran sur un écran et le tableur sur un autre. Le nom du commerçant « Guangzhou Hengtong Logistics Co. » devient « Guangzhou Hengtong Logist » dans un champ tronqué. La date « 06/15/2026 » devient « 05/15/2026 » parce que l'horodatage de l'interface de la capture d'écran utilise un format que le lecteur a analysé trop rapidement.
L'Aberdeen Group a publié une analyse distincte évaluant le traitement manuel des notes de frais à 35,02 $ par note de frais pour les petites entreprises — un chiffre qui tient compte de taux de salaire plus bas et de chaînes d'approbation plus simples. Combiné aux données GBTA, la fourchette est de 35 à 58 $ par note de frais pour le traitement manuel, et le flux de travail basé uniquement sur des captures d'écran se situe dans le haut de la fourchette car aucune donnée lisible par machine n'existe nulle part dans le processus. Chaque chiffre doit être saisi à partir d'une image.
Pour une entreprise de 30 employés soumettant en moyenne 1,2 entrée de frais par mois (un mélange de voyageurs fréquents et de soumissionnaires occasionnels), cela représente 36 soumissions par mois. À 58 $ par note de frais, le coût mensuel de saisie manuelle est de 2 088 $. Annualisé : 25 056 $ dépensés pour une tâche qu'un modèle d'IA visuelle peut accomplir en quelques secondes par capture d'écran — et le chiffre de 58 $ date de 2015. Ajusté à l'inflation salariale, l'équivalent actuel se situe plutôt autour de 70 $ par note de frais.
Ce que l'OCR traditionnel et les applications de notes de frais ne voient pas dans les captures d'écran
L'industrie des logiciels de gestion des notes de frais a passé vingt ans à optimiser ce qui se passe après l'entrée des données de frais dans le système. Le routage des approbations est automatisé. Les violations de politique sont signalées. Le remboursement est traité par lots. Le goulot d'étranglement qui subsiste est le moment qui précède toute intervention de ces logiciels sur les données — lorsque la preuve de la dépense existe sous forme de capture d'écran sur le téléphone d'un employé et que les données qu'elle contient n'ont aucune représentation lisible par machine.
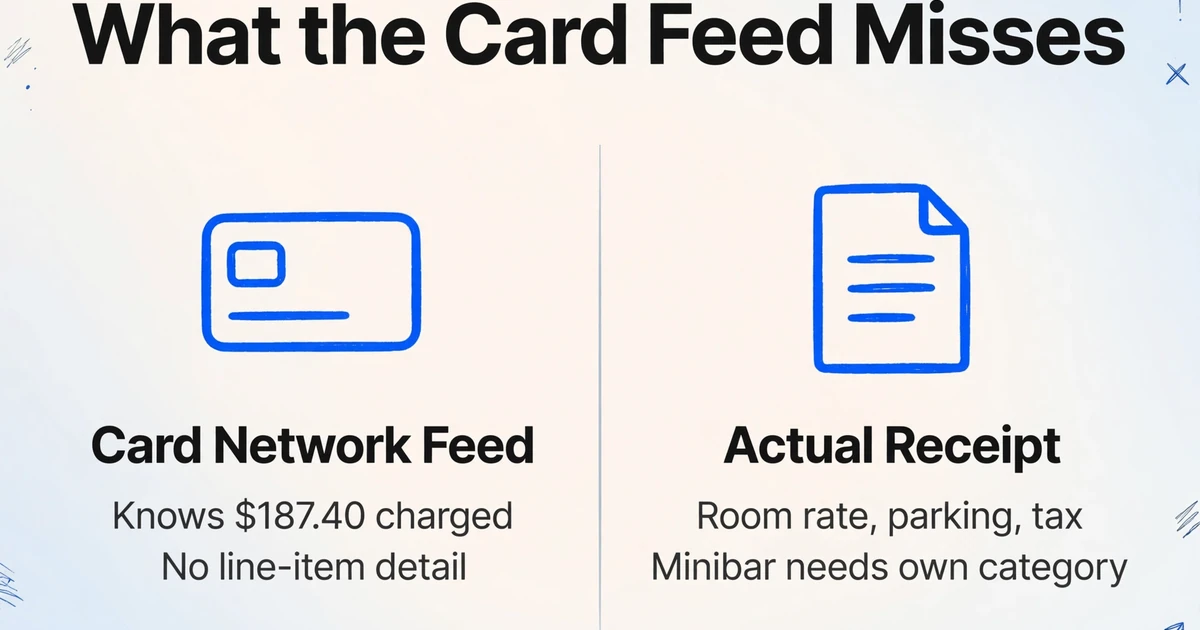
Les programmes de cartes d'entreprise résolvent une partie du problème en alimentant automatiquement le nom du commerçant, la date et le montant depuis le flux du réseau de cartes. Mais ils créent leur propre lacune : le flux de carte capture la transaction, pas le détail du reçu. Une ligne de note de restaurant incluant des repas partagés, un folio d'hôtel avec tarif de chambre plus taxes plus parking plus frais de minibar, un paiement fournisseur réparti sur plusieurs codes comptables — tout cela exige le détail ligne par ligne que seul le document réel contient. Le réseau de cartes sait que $187.40 a été débité. Il ne sait pas que $120 correspondait au tarif de la chambre, $18 au parking, $11.40 à la taxe et $38 aux frais de minibar qui nécessitent leur propre catégorie de dépense.
Les applications mobiles de numérisation de reçus — la fonction « prenez une photo de votre reçu » dans Expensify, Concur et autres — sont conçues pour les reçus papier. Un reçu papier a une forme physique constante : un ticket de papier thermique, généralement large de 3-4 pouces, avec du texte imprimé sur une ou deux colonnes. Le moteur de numérisation attend ce format. Donnez-lui une capture d'écran d'une confirmation d'application de paiement — un rectangle au rapport d'aspect 9×19,5 avec une barre de navigation en haut, une bannière colorée au milieu et un bouton de partage en bas — et le moteur ne sait pas quoi faire des éléments d'interface. Il tente d'analyser le texte mais attribue mal le commerçant, le montant et la date, car il cherche des motifs de reçu dans une mise en page d'interface.
C'est là l'inadéquation fondamentale. L'OCR traditionnel et les scanners mobiles de reçus sont conçus pour des mises en page de documents. Les captures d'écran de notes de frais sont des mises en page d'interfaces d'application. Elles contiennent les mêmes données — une transaction a eu lieu chez ce commerçant à cette date pour ce montant — mais la grammaire visuelle est entièrement différente. Ce qui rend un modèle d'IA visuelle capable de lire les deux est la même capacité qui permet aux humains de lire les deux : comprendre ce que chaque donnée signifie plutôt que de faire correspondre sa position sur un modèle appris.
Comment l'IA visuelle lit une capture d'écran différemment de l'OCR
L'OCR traditionnel traite une image en détectant des blocs contigus de motifs de pixels similaires — « cela ressemble à du texte » — et exécute une reconnaissance de caractères sur chaque bloc. Le résultat est un flux plat de segments de texte avec des coordonnées de cadre englobant : (x:120, y:45) : « Starbucks », (x:300, y:87) : « 12,45 $ », (x:120, y:120) : « 15/03/2026 ». Ce qui manque, c'est la relation entre ces morceaux de texte. L'OCR ne sait pas que « 12,45 $ » aux coordonnées (300, 87) est le montant de la transaction, que « Starbucks » à (120, 45) est le marchand, ou que les deux appartiennent au même événement de transaction.
Un modèle d'IA visuelle — le type utilisé dans Extraction de colonnes personnalisées — lit la capture d'écran comme le ferait une personne. Lorsque vous définissez les noms de colonnes « Date », « Marchand », « Montant », « Catégorie » et « Mode de paiement », l'IA ne recherche pas de coordonnées de pixels. Elle lit l'image entière de manière holistique — barres de navigation, bannières colorées, icônes d'état, blocs de texte, lignes de séparation, espaces blancs — et construit une compréhension sémantique : il s'agit d'un écran de confirmation de paiement d'Alipay. Le grand nombre avec un symbole monétaire dans la carte centrale est le montant de la transaction. Le texte en gras au-dessus est le marchand. L'horodatage en bas est la date. L'étiquette bleue à côté du montant indique « Carte de crédit » — c'est le mode de paiement.
C'est le changement de paradigme décrit dans la présentation du produit — de l'extraction basée sur la position à l'extraction basée sur la sémantique. L'OCR traditionnel et les outils basés sur des modèles demandent : « où se trouvent les données sur cette page ? » Ils vous obligent à dessiner une zone autour du champ du montant, une autre autour du champ de la date, une troisième autour du champ du marchand — un modèle par application. L'IA visuelle demande : « que signifient les données sur cette page ? » Elle identifie le montant en reconnaissant ce à quoi ressemble un montant en contexte — un nombre proéminent avec un indicateur de devise dans la section des détails de paiement d'un écran — quel que soit l'application, la mise en page ou la taille d'écran spécifique.
1 Vous définissez les colonnes une seule fois
Ouvrez l'outil, saisissez les noms de colonnes : Date, Marchand, Montant, Catégorie, Mode de paiement. Ce sont les champs que vous souhaitez dans votre feuille de calcul de sortie. Les noms de colonnes sont votre spécification — l'IA lit chaque capture d'écran pour trouver les données qui correspondent à ces descriptions sémantiques.
2 Téléversez les captures d'écran en un seul lot
Faites glisser les 37 captures d'écran et photos de reçus dans la zone de téléversement en une seule fois. Confirmations Alipay, captures mobiles Chase, captures d'écran d'e-mails transférés, photos de reçus de restaurant — formats mixtes, mises en page mixtes, ratios d'aspect différents, conventions d'interface d'application différentes. L'outil les traite comme un seul lot.
3 L'IA extrait les données par le sens, pas par la position
Pour chaque capture d'écran, l'IA visuelle lit l'image, comprend l'architecture de l'information — s'agit-il d'une confirmation de paiement ? d'une liste de transactions bancaires ? d'une photo de reçu ? d'un e-mail transféré ? — et localise les valeurs qui correspondent à vos noms de colonnes. Une « Date » sur un écran Alipay est un horodatage en bas en petit texte ; sur une capture d'écran de relevé bancaire, c'est un en-tête de colonne dans la liste des transactions ; sur une photo de reçu, c'est un texte imprimé près du haut. L'IA les trouve tous parce qu'elle comprend à quoi ressemble un champ de date dans chaque contexte.
4 Un seul fichier Excel, chaque capture d'écran en ligne
Le résultat est une feuille de calcul Excel unique. Chaque ligne correspond aux données de dépenses extraites d'une capture d'écran — colonne Date, colonne Marchand, colonne Montant, colonne Catégorie, colonne Mode de paiement. Le nom de fichier d'origine est inclus comme colonne de référence, afin que chaque ligne du tableur puisse être reliée à sa capture d'écran source à des fins d'audit. Exportez, ouvrez dans Excel, et les données réparties sur 37 mises en page d'applications différentes se retrouvent désormais dans un tableau triable et filtrable.
La compression du temps à cette étape est la mesure centrale. Ce qui prenait 12 à 15 minutes par capture d'écran — ouvrir l'image, lire les champs, les saisir dans la ligne du tableur, vérifier les chiffres, passer à l'image suivante — prend désormais 5 à 10 secondes par capture d'écran de temps de traitement IA, plus quelques minutes pour téléverser le lot. Pour 37 soumissions, cela représente environ quatre minutes d'interaction avec l'outil au lieu de douze heures de saisie manuelle. La référence de 20 minutes du GBTA s'effondre non pas parce qu'une partie du processus de dépenses a changé, mais parce que l'étape de saisie manuelle — qui consommait la majorité de ces 20 minutes — a été automatisée hors d'existence.
Conformité IRS : les captures d'écran satisfont-elles aux exigences de justification des dépenses ?
La réponse courte : oui — à condition qu'elles contiennent les éléments de données requis. En vertu de la publication 463 de l'IRS et de l'article §274(d) de l'Internal Revenue Code, les déductions de dépenses professionnelles doivent être justifiées par des registres adéquats ou des preuves suffisantes. Pour chaque dépense, la documentation doit établir le montant, la date, le lieu et l'objet professionnel. Pour les repas et divertissements, la relation professionnelle des personnes impliquées doit également être documentée.
Une capture d'écran numérique d'une confirmation de paiement satisfait à ces exigences exactement comme le ferait un reçu papier — l'IRS accepte les registres numériques, y compris les images électroniques et les captures d'écran, depuis la Revenue Ruling 2003-106, qui a explicitement approuvé les reçus électroniques et les notes de frais pour les dispositifs de remboursement sur justificatifs. La règle du reçu de 75 $ (IRC §274(d)) stipule que pour les dépenses inférieures à 75 $, un reçu n'est pas requis — mais le montant, la date, le lieu et l'objet professionnel doivent tout de même être enregistrés. Pour les dépenses de 75 $ ou plus, un reçu ou une preuve documentaire équivalente est obligatoire.
Ce que cela signifie pour votre flux de travail : une capture d'écran d'un repas à 47,19 $ n'exige pas légalement la conservation du reçu papier original, mais vous devez tout de même enregistrer la date, le marchand, le montant et l'objet professionnel dans un endroit accessible. Une capture d'écran d'une facture d'hôtel de 312 $ exige quant à elle la conservation — et une capture d'écran de la confirmation de paiement de l'hôtel, plus une capture d'écran du détail des lignes de la facture, satisfait à l'exigence de preuve documentaire tant que les données sont lisibles et complètes.
La valeur pratique de la conformité liée à l'extraction de données de captures d'écran dans un tableur structuré va au-delà de la satisfaction de l'IRS. Lorsque chaque ligne de dépense de votre tableur fait référence au nom de fichier d'origine — alipay_starbucks_mars15.png, chase_hotel_marriott_mars17.png — le lien entre les données et la preuve survit à toute vérification future ou revue interne. Une personne ouvrant le tableur trois ans plus tard (la période de conservation recommandée par l'IRS pour les notes de frais) peut localiser la capture d'écran source par le seul nom de fichier, sans avoir à relire chaque image. C'est ce à quoi ressemble l'intégrité de la piste d'audit lorsque vos preuves de dépenses sont entièrement numériques.
À quoi ressemble réellement un traitement par lots de fin de mois
Prenons un scénario concret : un cabinet de conseil de 40 personnes, sans programme de carte d'entreprise ni logiciel de gestion des dépenses. Les employés soumettent leurs preuves de dépenses via trois canaux : un canal Slack d'entreprise (#expenses), des pièces jointes par e-mail et — pour les consultants terrain — des messages WeChat directement au responsable financier. À la fin du mois de mars, le responsable financier télécharge tout dans un dossier.
Le dossier contient : 14 captures d'écran de confirmations de paiement Alipay/WeChat Pay ; 9 photos de reçus papier prises avec des téléphones ; 6 confirmations par e-mail de réservations aériennes et hôtelières, transférées sous forme de captures d'écran ; 4 captures d'écran de listes de transactions d'applications bancaires ; 3 factures PDF de fournisseurs ; et 2 photos de journaux de kilométrage manuscrits. Cela fait 38 fichiers, au moins cinq formats visuels distincts, contenant les mêmes données essentielles — date, commerçant/fournisseur, montant, catégorie, mode de paiement — disposées selon cinq mises en page complètement différentes.
Traiter ce lot par saisie manuelle : le responsable financier ouvre chaque fichier, lit les champs, les saisit dans le tableur principal. Le changement de format est la taxe cachée. Lire une confirmation Alipay — nom du commerçant en gras en haut au centre, montant en grand texte coloré — entraîne l'œil à analyser une certaine mise en page. Puis le fichier suivant est une liste de transactions bancaires avec les montants dans une colonne, les commerçants dans une autre, les dates au-dessus — un schéma d'analyse complètement différent. L'œil doit se réadapter. Au fichier 20, les erreurs augmentent. Au fichier 30, le responsable financier commet des erreurs qu'il ne ferait pas au fichier 5. Le taux d'erreur de 19 % du GBTA n'est pas réparti uniformément — il se concentre dans la seconde moitié d'une session de traitement par lots, alimenté par la fatigue due aux changements de format.
Traiter ce même lot avec l'extraction par IA : téléchargez les 38 fichiers en une seule fois. Définissez les colonnes — Date, Commerçant, Montant, Catégorie, Mode de paiement, Objet professionnel. L'IA lit chaque fichier en comprenant ce que signifient les données, trouve les valeurs correspondantes dans cinq mises en page visuelles différentes et génère un tableur avec 38 lignes. La tâche restante du responsable financier est la vérification et l'approbation — des tâches qui exigent du jugement et une connaissance des politiques — plutôt que la saisie manuelle, qui n'exige ni l'un ni l'autre.
La différence de coût à cette échelle : 38 captures d'écran × 20 minutes de saisie manuelle = 760 minutes (12,7 heures). Au taux horaire chargé d'environ 30 $ du responsable financier, cela représente 381 $ de travail de saisie pour un mois. Annualisé sur 12 mois : 4 572 $ consacrés à une tâche qu'un outil d'IA réalise en moins de cinq minutes d'interaction active par mois.
Trois erreurs de saisie manuelle qui ne surviennent qu'avec les captures d'écran
Toutes les erreurs de note de frais ne se valent pas. La saisie manuelle de captures d'écran introduit trois modes de défaillance spécifiques que les reçus papier et les flux de cartes d'entreprise ne produisent pas :
1. Contamination par les éléments d'interface
Une capture d'écran d'application de paiement contient les données de transaction — mais aussi la barre de navigation de l'application (« Retour », « Partager », « Détails »), une barre de statut avec l'heure et le pourcentage de batterie, parfois une animation « Succès » flottante, et le panneau de notifications du téléphone si la capture a été prise rapidement. L'OCR traditionnel lit tout cela comme du texte. Une étiquette de bouton « Retour » est extraite comme un champ. Le pourcentage de batterie « 73 % » est lu comme un montant en dollars. L'heure dans la barre de statut — « 14:31 » — est mal identifiée comme une heure de transaction.
L'IA visuelle fait la distinction entre l'habillage de l'application et le contenu de l'application parce qu'elle comprend la grammaire visuelle d'un écran : les barres de navigation sont en haut et en bas avec un style cohérent, les icônes de statut sont dans un coin spécifique, les données de transaction sont dans la zone de contenu centrale avec une typographie et un espacement différents. La distinction évidente pour un humain — « ceci fait partie de l'application, voici les données que je veux » — fait partie de ce que le modèle d'IA apprend à séparer.
2. Ambiguïté des symboles et formats de devise
Les entreprises mondiales reçoivent des captures d'écran de notes de frais dans plusieurs devises. Un employé coréen soumet une capture d'écran KakaoPay avec « ₩47 000 » — 47 000 ₩ KRW, pas 47 000 $ USD (environ 32 $). Un employé japonais soumet une capture d'écran PayPay avec « ¥1 280 » — 1 280 ¥ JPY, environ 8 $. Un employé allemand soumet une capture d'écran bancaire où « 1 280,50 € » utilise la notation européenne des milliers/décimales — potentiellement mal interprétée comme 1,28 $ par un moteur OCR américain qui utilise par défaut le format américain.
Lorsque l'IA visuelle extrait ces champs, la compréhension contextuelle de l'application — KakaoPay est une application de paiement coréenne, PayPay est japonaise, une application bancaire allemande Sparkasse utilise la locale allemande — éclaire l'interprétation. L'IA extrait « 1280 » comme valeur numérique et préserve le contexte de devise, permettant à la feuille de calcul de sortie de normaliser entre les devises lors d'une étape de post-traitement. L'OCR traditionnel produit « 1 280,50 » ou « ¥1 280 » comme chaînes de texte brutes que quelqu'un doit ensuite normaliser manuellement — une étape manuelle elle-même sujette aux erreurs.
3. Classification des catégories comme étape manuelle distincte
Une note de frais nécessite plus que les simples données de transaction — elle nécessite la catégorie de dépense : Repas & Divertissements, Déplacements, Fournitures de bureau, Services professionnels, ou les codes GL spécifiques de l'entreprise. Avec la saisie manuelle, c'est une décision que la personne chargée des finances prend pour chaque ligne. « Starbucks — c'est Repas. Office Depot — Fournitures. Uber — Déplacements. » Cela ajoute 5 à 10 secondes de charge cognitive par ligne et introduit des incohérences lorsque différents validateurs classent le même marchand différemment.
L'extraction par IA peut gérer cela dans le même passage grâce à un mécanisme appelé colonne inférée. Lorsque vous définissez une colonne comme Catégorie (options : Repas/Transport/Bureau/Autre), l'IA lit le nom du marchand, le contexte de la transaction et le type de document, puis déduit la catégorie la plus probable parmi les options que vous avez fournies — sans nécessiter d'étape de classification distincte. L'inférence repose sur des règles que vous définissez (limitées à l'ensemble d'options que vous spécifiez), de sorte que le résultat est cohérent sur l'ensemble du lot. La même capacité sous-jacente peut déduire le mode de paiement, le code GL, le département ou toute classification spécifique à l'entreprise en fonction du contenu du document.
Liens de collecte : arrêtez de recevoir des captures d'écran par e-mail et sur Slack
Le problème structurel plus profond n'est pas la saisie manuelle — c'est le canal de soumission. Lorsque les employés soumettent des captures d'écran de notes de frais par e-mail, Slack, WeChat et SMS, le travail de l'équipe financière commence par une phase de téléchargement et de tri qui n'a rien à voir avec la comptabilité : collecter les fichiers depuis quatre plateformes différentes, les renommer pour la traçabilité, les regrouper par employé, identifier les soumissions complètes et celles incomplètes.
Un Lien de collecte résout ce problème en fournissant un point de soumission unique. Le responsable financier génère un lien — une URL unique — et l'envoie aux employés. Lorsqu'un employé ouvre le lien dans le navigateur de son téléphone, il saisit un court code de vérification et téléverse ses captures d'écran de notes de frais directement via le navigateur. Les fichiers arrivent dans la file de traitement du compte du responsable financier, étiquetés par heure de téléversement et nom de fichier, organisés dans une vue unique. Aucune pièce jointe à télécharger. Aucun fil Slack à parcourir. Aucune capture d'écran de chaînes de SMS transférée.
Pour les équipes terrain et les prestataires externes qui n'ont pas de compte e-mail d'entreprise, cela élimine le mode d'échec de soumission le plus courant : « Je l'ai envoyé, l'avez-vous reçu ? » Le lien de collecte est une destination fixe. Le téléversement est confirmé à l'écran. Le responsable financier peut voir exactement quels employés ont soumis et lesquels ne l'ont pas fait, avant même le début du traitement.
Extension Google Sheets : extraction directe dans votre feuille de notes de frais
Pour les équipes financières qui vivent dans Google Sheets — et selon le schéma de traitement des notes de frais le plus courant que nous observons chez les petites et moyennes entreprises, cela décrit une part substantielle des équipes traitant moins de 200 rapports par mois — l'extension Google Sheets élimine entièrement l'étape d'exportation et d'importation. L'extension s'ouvre sous forme de panneau latéral dans n'importe quelle feuille Google. Importez directement les captures d'écran de notes de frais dans le panneau, définissez vos colonnes, traitez le lot, et les données extraites s'ajoutent directement à la feuille active — aucun téléchargement de fichier, aucune conversion Excel vers Sheets, aucun copier-coller entre les fenêtres.
L'extension fonctionne en mode compte lorsqu'elle est connectée à une clé API : les modèles, les règles de correspondance et l'historique de traitement se synchronisent avec l'application web. Les membres de l'équipe ayant un accès en modification à la feuille de calcul peuvent importer et traiter dans le cadre de leurs quotas de plan individuels. Le résultat est une feuille de calcul unique — partagée au sein de l'équipe financière — où les données de notes de frais arrivent à partir de captures d'écran et de photos de reçus sans que personne ne saisisse un seul champ.
Essayez avec de vraies captures d'écran de notes de frais
La meilleure façon d'évaluer si l'extraction par IA fonctionne sur votre combinaison spécifique de captures d'écran de notes de frais est de la tester avec des fichiers réels. La démo ci-dessous fonctionne avec le préréglage expense-report — des colonnes préconfigurées pour Date, Commerçant, Montant et Catégorie — mais vous pouvez ajouter, supprimer ou renommer n'importe quelle colonne pour correspondre à votre propre feuille de notes de frais. Aucune inscription requise. Aucune carte de crédit. Les fichiers sont traités en quelques secondes et ne sont pas conservés au-delà de la session.
Combien ça coûte
ImageToTable.ai propose quatre plans. Le plan Free comprend 50 crédits par mois — suffisant pour qu'une petite équipe traite quelques captures d'écran de notes de frais et évalue si la qualité d'extraction répond à ses besoins. Le plan Basic à 9 $/mois couvre 500 crédits mensuels, adapté à une équipe traitant 100 à 200 soumissions de notes de frais par mois. Le plan Pro à 19 $/mois fournit 2 000 crédits, couvrant le traitement par lots à des volumes plus élevés, y compris les folios d'hôtel PDF multipages et les factures fournisseurs qui nécessitent plus de crédits par document. Le plan Max à 59 $/mois fournit 10 000 crédits pour les équipes financières à volume élevé et inclut un traitement prioritaire. Tous les plans payants incluent l'accès à l'extension Google Sheets, la gestion des modèles et l'exportation par lots.
Comparé au coût de traitement manuel de 35 $ à 58 $ par rapport, l'abonnement est rentabilisé dès les cinq à dix premières soumissions de notes de frais du mois. Un plan Pro à 19 $/mois traite le même volume de données de notes de frais qui coûterait à une équipe financière environ 1 260 $ en saisie manuelle au tarif des petites entreprises d'Aberdeen. Le calcul ne nécessite pas de feuille de calcul — vous pouvez le faire de tête.
Questions fréquentes
L'extraction par IA peut-elle lire des captures d'écran en chinois, japonais, coréen ou dans d'autres langues non anglaises ?
Oui. Le modèle d'IA visuelle traite le texte dans toutes les langues principales, notamment le chinois (simplifié et traditionnel), le japonais, le coréen, l'arabe, le thaï, le vietnamien et toutes les langues européennes. Les captures d'écran d'applications de paiement comme Alipay, WeChat Pay, KakaoPay, PayPay et autres applications régionales similaires sont prises en charge. Le modèle extrait les données dans la langue source et peut conserver le texte d'origine — ainsi, un nom de marchand chinois sur une capture d'écran Alipay apparaît en chinois dans le tableau de sortie, et non sous forme de translittération.
Quelle est la différence avec la fonctionnalité « Obtenir des données à partir d'une image » de Microsoft Excel ?
La fonctionnalité « Obtenir des données à partir d'une image » d'Excel extrait tout le texte visible d'une image dans une grille non structurée — elle capture tout ce que le moteur OCR peut lire et le place dans des cellules selon un agencement spatial approximativement identique à celui de l'image d'origine. Elle ne fait pas la distinction entre « c'est le montant qui m'intéresse » et « c'est le texte de la barre de navigation ». Pour une capture d'écran contenant 15 éléments de texte visibles, vous obtenez 15 cellules. Vous devez ensuite trouver, extraire et réorganiser les points de données spécifiques dont vous avez besoin. L'extraction par IA avec colonnes personnalisées n'extrait que les champs que vous spécifiez — Date, Montant, Marchand, Catégorie — et les organise directement dans la structure de colonnes que vous avez définie, prête à l'emploi.
Fonctionne-t-elle sur des captures d'écran de mauvaise qualité — des images compressées transférées via des applications de messagerie ?
Les artefacts de compression des applications de messagerie (WeChat, WhatsApp, Slack recompressent tous les images) réduisent la qualité de l'image, et à des niveaux de compression sévères, les petits textes peuvent devenir illisibles. Le modèle d'IA donne les meilleurs résultats avec des captures d'écran claires en résolution d'origine — la qualité obtenue lorsqu'un employé prend une capture d'écran directement sur son téléphone et la télécharge sans la transférer via une application de chat. Si le texte est lisible à l'œil humain sur l'image compressée, l'IA peut généralement l'extraire. Si la compression a transformé le texte en blobs de pixels illisibles, la qualité de l'extraction se dégradera.
Puis-je utiliser le même outil pour traiter les reçus papier en plus des captures d'écran ?
Oui. L'outil traite les captures d'écran, les photos de reçus, les relevés PDF et les documents scannés dans le même lot — vous n'avez pas besoin d'outils séparés pour différents types d'entrées. Téléversez la capture d'écran Alipay, la photo du reçu papier et le relevé d'hôtel PDF ensemble. Définissez vos colonnes une seule fois — Date, Commerçant, Montant, Catégorie — et chaque ligne du tableur de sortie représente un document traité, que la source soit une capture d'écran numérique, une photo de reçu ou un PDF.
Comment cela s'intègre-t-il avec QuickBooks, Xero ou notre ERP ?
L'outil génère des formats Excel (XLSX) et CSV, importables par tous les principaux systèmes comptables. QuickBooks Online et Xero acceptent tous deux les importations CSV et Excel pour les transactions de dépenses. Pour les systèmes ERP avec des formats d'importation personnalisés, les données extraites peuvent servir de source structurée et nettoyée qui alimente votre pipeline d'importation existant. L'outil se place avant votre système comptable dans le flux de travail — il produit des données structurées à partir de captures d'écran non structurées, et ces données structurées transitent par votre processus normal d'importation et de rapprochement.
Qu'advient-il des fichiers de capture d'écran après le traitement ?
Les fichiers téléversés sont traités en mémoire et ne sont pas stockés sur le serveur au-delà de la session de traitement active. Vous pouvez supprimer les tâches traitées à tout moment depuis votre tableau de bord, ce qui supprime à la fois les données extraites et les fichiers sources du serveur. Pour une conformité continue, nous recommandons de conserver les captures d'écran sources dans votre propre stockage — un dossier Google Drive, une bibliothèque de documents SharePoint ou votre serveur de fichiers — avec la colonne de référence de nom de fichier du tableur de sortie fournissant le lien de piste d'audit vers chaque fichier source.
En résumé
Les captures d'écran de notes de frais ne vont pas disparaître. Les employés continueront de soumettre leurs justificatifs de dépenses de la manière que leur téléphone produit naturellement — confirmations d'applications de paiement, captures d'écran de transactions bancaires, photos de reçus, e-mails transférés. Chacune de ces captures d'écran contient des données que quelqu'un de votre équipe financière lit actuellement puis saisit dans un tableur, à un coût d'environ 35 à 58 $ par note de frais. Le coût n'est pas visible car il est intégré au salaire — quelqu'un fait ce travail, le travail est fait, et le coût est absorbé dans la masse salariale de l'équipe financière. Mais le coût est réel, et le montant annuel même pour une petite équipe atteint cinq chiffres.
L'extraction par IA visuelle ne change pas le flux de travail de déclaration de dépenses. Elle change l'étape interne qui consommait 60 à 70 % du temps : la saisie manuelle des données visibles d'une image vers une ligne dans un tableur. Lorsque cette étape passe de 15 minutes à 10 secondes, la référence évolue. Et l'équipe financière qui passait 12 heures par mois à lire des captures d'écran commence à consacrer ce temps à des tâches qui exigent réellement un jugement financier.