Seus funcionários enviam capturas de tela de despesas.
O financeiro gasta 20 minutos digitando cada uma.
É segunda-feira, 9h17. A caixa de entrada do financeiro tem 37 mensagens não lidas — todas envios de despesas. Doze são capturas de tela de aplicativos de pagamento: confirmações de transação do Alipay, recibos do WeChat Pay, capturas do aplicativo bancário do Chase mostrando "Pending - $47.19". Nove são fotos de recibos físicos tiradas com o braço esticado sob a luz fluorescente do escritório — uma está de cabeça para baixo. Oito são anexos encaminhados por e-mail: confirmações de reserva de hotel, resumos de viagens de aplicativos de transporte, confirmações de pedidos online. As oito restantes são uma mistura: uma captura de tela de uma planilha que algum funcionário usou como seu próprio controle de despesas, duas faturas de fornecedores em PDF e três conversas por mensagem de texto encaminhadas como capturas de tela. Cada uma contém dados que alguém do financeiro vai passar o dia lendo e depois digitando na planilha de despesas da empresa. No benchmark da GBTA Foundation de 20 minutos por relatório, esses 37 envios representam cerca de 12 horas de digitação manual — um dia e meio da semana de trabalho de alguém gasto olhando imagens e digitando números que já estão visíveis na tela. Os dados estão lá. Só não estão onde a planilha precisa que estejam.
Por que capturas de tela de despesas são mais difíceis do que recibos em papel
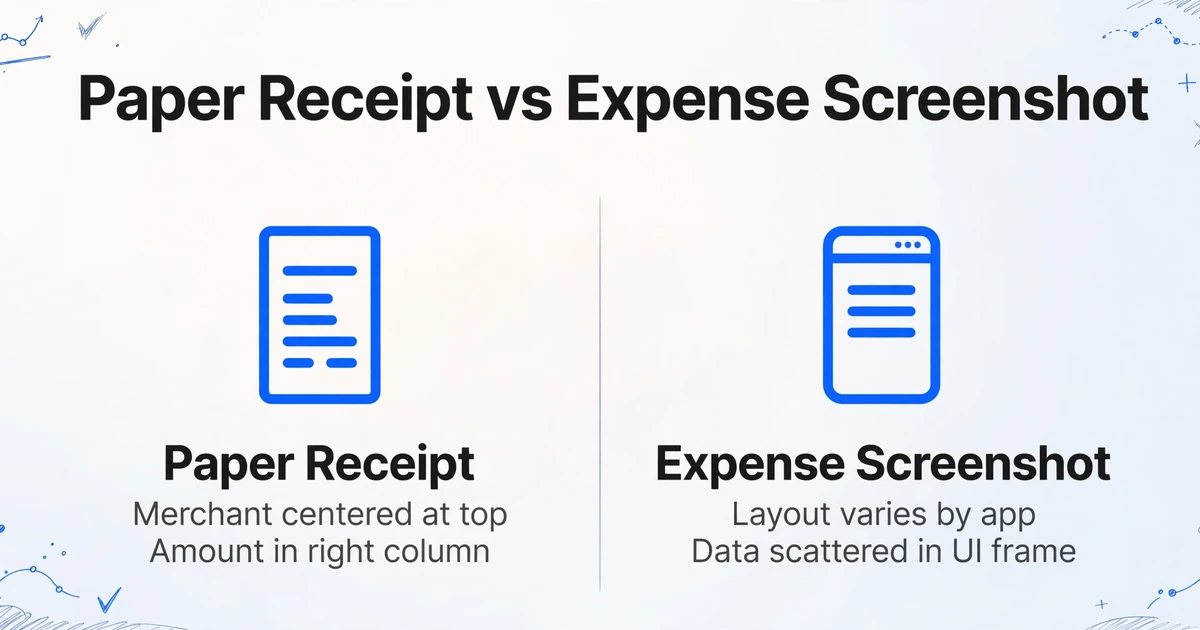
Um recibo em papel tem uma estrutura previsível. O nome do estabelecimento fica centralizado no topo. A data, a hora e o ID da transação aparecem em um bloco compacto logo abaixo. Os itens, o subtotal, o imposto e o total formam uma coluna vertical no lado direito do comprovante. Esse layout permanece praticamente inalterado há trinta anos — todo sistema de PDV na América do Norte imprime recibos que seguem mais ou menos o mesmo modelo.
Uma captura de tela de uma transação de despesa feita no celular não tem nada dessa previsibilidade. Uma confirmação de pagamento do Alipay coloca o nome do estabelecimento em negrito no topo central, o valor em um número grande e colorido logo abaixo, o método de pagamento em uma etiqueta azul e o horário da transação em texto cinza pequeno na parte inferior — tudo dentro de um quadro de aplicativo com marca, barras de navegação, ícones da barra de status e uma cor de fundo. Uma captura de tela do aplicativo bancário Chase coloca o nome do estabelecimento na coluna esquerda de uma lista de transações, o valor à direita e a data acima, em uma fonte diferente — dentro de um layout de interface completamente diferente. Uma confirmação por e-mail encaminhada como captura de tela tem os detalhes da reserva incorporados no corpo do texto, com cabeçalhos de resposta e blocos de assinatura misturados.
Os mesmos dados de despesa — data, estabelecimento, valor, categoria, método de pagamento — organizados em três layouts visuais completamente diferentes em três fontes de captura de tela. É isso que torna a extração de capturas de tela fundamentalmente mais difícil do que a leitura de recibos: os dados não estão apenas em posições diferentes no mesmo modelo. Eles estão incorporados em arquiteturas de informação diferentes — uma interface de confirmação de transação não é uma interface de extrato bancário, que não é um corpo de e-mail. Um leitor humano navega por isso sem esforço porque entende que "$47.19" ao lado de um ícone de café em um aplicativo de pagamento significa a mesma coisa que "47.19" na coluna "Amount" de uma lista de transações bancárias. O OCR tradicional não entende isso. Ele lê caracteres em sequência, de cima para baixo, da esquerda para a direita — e, em uma captura de tela, a sequência muitas vezes não faz sentido semântico.
Uma confirmação de aplicativo de pagamento, uma lista de transações de aplicativo bancário e uma confirmação de reserva por e-mail são três arquiteturas de informação diferentes que descrevem a mesma despesa. O OCR tradicional lê cada uma como um fluxo plano de caracteres. A extração visual com IA lê cada uma como uma fonte de dados estruturada — entendendo que o número grande no centro de uma interface de confirmação de pagamento é o valor da transação, independentemente de qual aplicativo gerou a captura de tela.
O Custo Real de Digitar Dados de Capturas de Tela: $58 por Relatório É o Piso
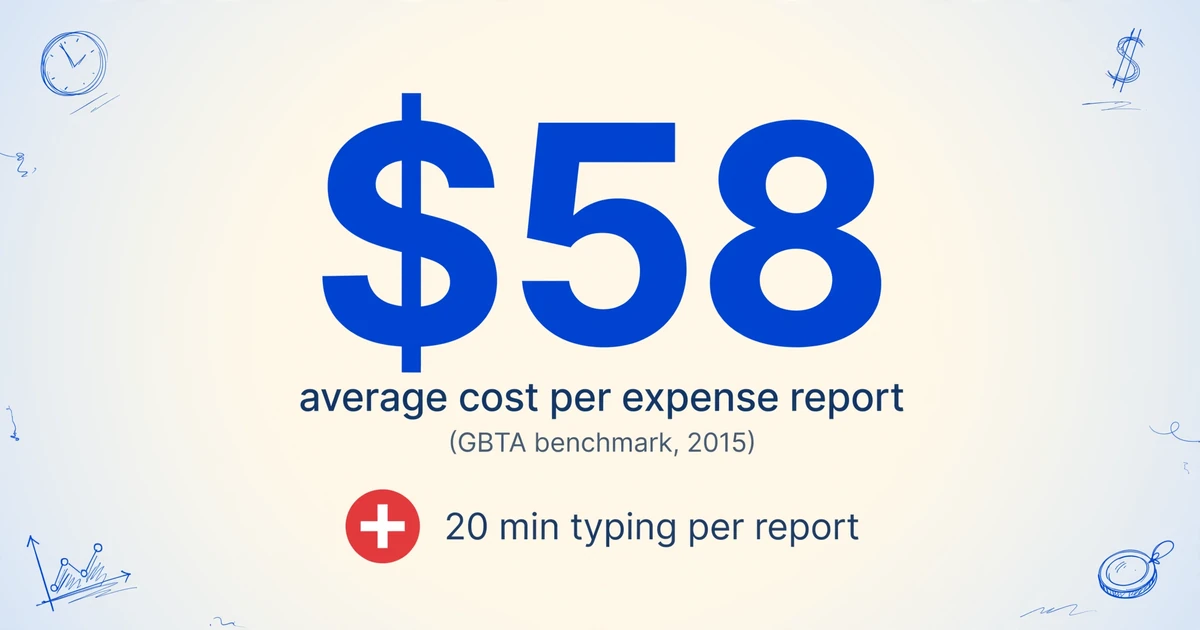
O benchmark da Global Business Travel Association — $58 por relatório de despesas, 20 minutos de tempo de processamento por relatório — foi medido em 2015 e continua sendo o número do setor mais amplamente citado. A SAP Concur cita. A Ramp cita. Todo fornecedor de gestão de despesas o usa como referência. Mas o estudo da GBTA mediu um fluxo amplo de relatórios de despesas — do envio pelo funcionário à aprovação do gestor, passando pela revisão financeira e reembolso. Quando a evidência da despesa chega como captura de tela ou foto, o custo se concentra em uma etapa: a digitação manual dos dados visíveis na planilha.
O detalhamento do mesmo estudo da GBTA, reanalisado por pontos de dor: 54% dos compradores de viagens em empresas sem software de despesas de terceiros identificaram "inserir os dados" como um ponto de dor importante. 55% identificaram "anexar recibos". Configurar relatórios de despesas (49%) foi o próximo mais citado. Essas três etapas — a ponta inicial do processo de relatórios de despesas — respondem pela maior parte dos 20 minutos. A etapa de "inserir os dados" sozinha, quando a evidência é uma captura de tela sem dados legíveis por máquina embutidos, consome cerca de 12 a 15 desses 20 minutos por relatório.
A taxa de erros agrava isso. O estudo da GBTA descobriu que 19% dos relatórios de despesas contêm erros, e cada correção custa mais $52 e 18 minutos. A digitação manual de capturas de tela é especialmente propensa a erros: uma confirmação de aplicativo de pagamento de $47.19 vira $47.91 quando o olho do analista financeiro pula entre a captura de tela em uma tela e a planilha em outra. O nome do estabelecimento "Guangzhou Hengtong Logistics Co." vira "Guangzhou Hengtong Logist" em um campo truncado. A data "06/15/2026" vira "05/15/2026" porque o carimbo de data/hora da interface da captura de tela usa um formato que o leitor interpretou rápido demais.
A Aberdeen Group publicou uma análise separada que estima o processamento manual de relatórios de despesas em $35.02 por relatório para pequenas empresas — um número que considera taxas salariais mais baixas e cadeias de aprovação mais simples. Combinado com os dados da GBTA, a faixa é de $35 a $58 por relatório para processamento manual, e o fluxo baseado apenas em capturas de tela fica na ponta alta porque não há nenhum dado legível por máquina em nenhum ponto do processo. Cada dígito precisa ser digitado a partir de uma imagem.
Para uma empresa com 30 funcionários enviando em média 1,2 lançamentos de despesas por mês (uma mistura de viajantes frequentes e remetentes ocasionais), isso dá 36 envios por mês. A $58 por relatório, o custo mensal de digitação manual é de $2.088. Anualizado: $25.056 gastos em uma tarefa que um modelo de IA visual consegue realizar em segundos por captura de tela — e o número de $58 é de 2015. Ajustado pela inflação salarial, o equivalente hoje fica mais próximo de $70 por relatório.
O que o OCR tradicional e os aplicativos de despesas não captam nas capturas de tela
A indústria de software de gestão de despesas passou duas décadas otimizando o que acontece depois que os dados de despesas entram no sistema. O roteamento de aprovações é automatizado. As violações de políticas são sinalizadas. O reembolso é processado em lote. O gargalo que resta é o momento antes de qualquer um desses softwares tocar nos dados — quando a evidência da despesa existe como uma captura de tela no celular do funcionário e os dados dentro dela não têm representação legível por máquina.
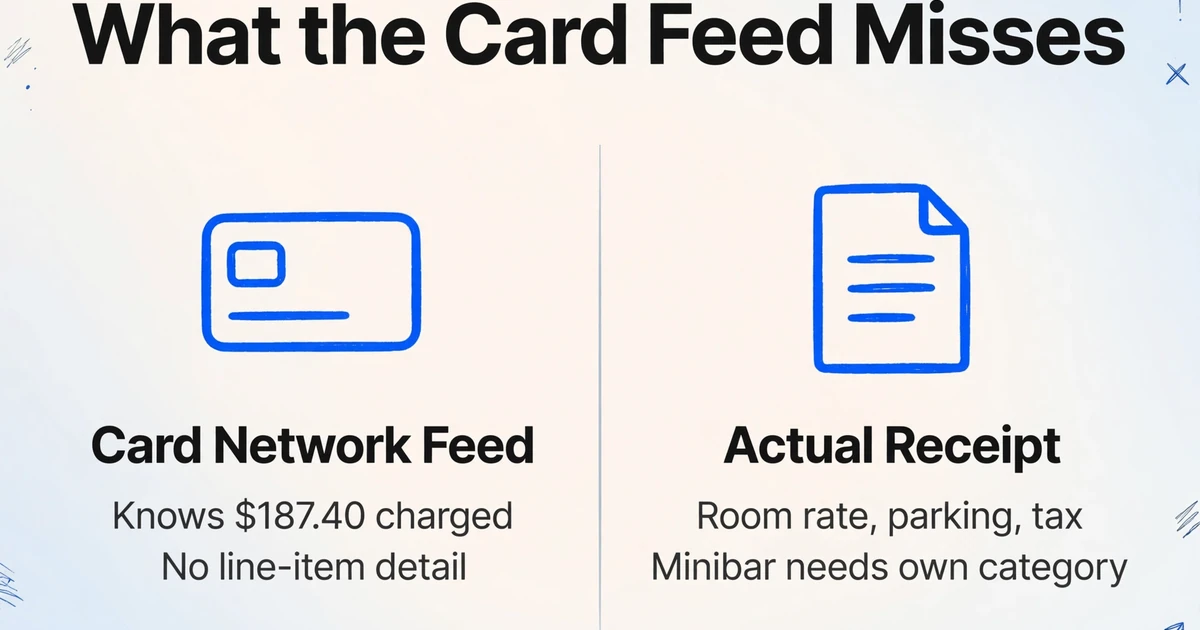
Os programas de cartão corporativo resolvem parte disso ao preencher automaticamente o nome do estabelecimento, a data e o valor a partir do extrato da rede de cartões. Mas eles introduzem sua própria lacuna: o extrato do cartão captura a transação, não o detalhe do recibo. Uma conta de restaurante que inclui refeições compartilhadas, uma fatura de hotel com diária mais impostos mais estacionamento mais cobranças de frigobar, um pagamento a fornecedor dividido entre vários códigos contábeis — tudo isso exige o detalhe de item que só o documento real contém. A rede de cartões sabe que $187.40 foi cobrado. Ela não sabe que $120 era a diária, $18 era estacionamento, $11.40 era imposto e $38 era a cobrança de frigobar que precisa de sua própria categoria de despesa.
Aplicativos móveis de digitalização de recibos — o recurso "tire uma foto do seu recibo" no Expensify, Concur e similares — são feitos para recibos em papel. Um recibo em papel tem uma forma física consistente: um pedaço de papel térmico, geralmente com 3-4 polegadas de largura, com texto impresso em uma ou duas colunas. O mecanismo de digitalização espera esse formato. Alimente-o com uma captura de tela de uma confirmação de aplicativo de pagamento — um retângulo com proporção de 9×19,5, com uma barra de navegação no topo, um banner colorido no meio e um botão de compartilhamento na parte inferior — e o mecanismo não sabe o que fazer com os elementos de interface. Ele tenta analisar o texto, mas atribui incorretamente estabelecimento, valor e data porque está procurando padrões de recibo em um layout de interface.
Essa é a incompatibilidade fundamental. O OCR tradicional e os digitalizadores móveis de recibos são feitos para layouts de documento. As capturas de tela de despesas são layouts de interface de aplicativo. Elas contêm os mesmos dados — uma transação ocorreu neste estabelecimento nesta data por este valor —, mas a gramática visual é totalmente diferente. O que torna um modelo de IA visual capaz de ler ambos é a mesma capacidade que faz os humanos lerem ambos: entender o que cada dado significa, em vez de corresponder aonde ele está em um modelo aprendido.
Como a IA Visual Lê uma Captura de Tela de Forma Diferente do OCR
O OCR tradicional processa uma imagem detectando blocos contíguos de padrões de pixels semelhantes — "isto parece texto" — e executando o reconhecimento de caracteres em cada bloco. A saída é um fluxo plano de segmentos de texto com coordenadas de caixa delimitadora: (x:120, y:45): "Starbucks", (x:300, y:87): "$12.45", (x:120, y:120): "03/15/2026". O que falta é a relação entre essas partes do texto. O OCR não sabe que "$12.45" na coordenada (300, 87) é o valor da transação, que "Starbucks" em (120, 45) é o comerciante, ou que ambos pertencem ao mesmo evento de transação.
Um modelo de IA visual — o tipo usado na Extração de Colunas Personalizadas — lê a captura de tela da forma como uma pessoa leria. Quando você define os nomes das colunas "Data", "Comerciante", "Valor", "Categoria" e "Método de Pagamento", a IA não procura coordenadas de pixels. Ela lê a imagem inteira de forma holística — barras de navegação, banners coloridos, ícones de status, blocos de texto, linhas separadoras, espaço em branco — e constrói um entendimento semântico: esta é uma tela de confirmação de pagamento do Alipay. O número grande com um símbolo de moeda no cartão central é o valor da transação. O texto em negrito acima é o comerciante. O carimbo de data/hora na parte inferior é a data. A etiqueta azul ao lado do valor diz "Cartão de Crédito" — esse é o método de pagamento.
Esta é a mudança de paradigma descrita na apresentação do produto — da extração baseada em posição para a extração baseada em semântica. O OCR tradicional e as ferramentas de modelo perguntam: "onde estão os dados nesta página?" Eles exigem que você desenhe uma caixa ao redor do campo de valor, outra ao redor do campo de data, uma terceira ao redor do campo do comerciante — um modelo por aplicativo. A IA visual pergunta: "o que os dados significam nesta página?" Ela identifica o valor reconhecendo como um valor se parece no contexto — um número proeminente com um indicador de moeda na seção de detalhes de pagamento de uma tela — independentemente do aplicativo, layout ou tamanho de tela específicos.
1 Você define as colunas uma vez
Abra a ferramenta, digite os nomes das colunas: Data, Comerciante, Valor, Categoria, Método de Pagamento. Esses são os campos que você deseja na sua planilha de saída. Os nomes das colunas são a sua especificação — a IA lê cada captura de tela para encontrar dados que correspondam a essas descrições semânticas.
2 Envie as capturas de tela em um único lote
Arraste todas as 37 capturas de tela e fotos de recibos para a área de upload de uma só vez. Confirmações do Alipay, capturas do aplicativo móvel do Chase, capturas de tela de e-mails encaminhados, fotos de recibos de restaurantes — formatos mistos, layouts mistos, proporções diferentes, convenções de interface de aplicativos diferentes. A ferramenta processa tudo como um único lote.
3 A IA extrai dados pelo significado, não pela posição
Para cada captura de tela, a IA visual lê a imagem, entende a arquitetura da informação — isto é uma confirmação de pagamento? uma lista de transações bancárias? uma foto de recibo? um e-mail encaminhado? — e localiza os valores que correspondem aos seus nomes de coluna. Uma "Data" em uma tela do Alipay é um carimbo de data/hora na parte inferior em texto pequeno; em uma captura de tela de extrato bancário é um cabeçalho de coluna na lista de transações; em uma foto de recibo é texto impresso perto do topo. A IA encontra todos eles porque entende como um campo de data se parece em cada contexto.
4 Um arquivo Excel, cada captura de tela como uma linha
A saída é uma única planilha Excel. Cada linha corresponde aos dados de despesas extraídos de uma captura de tela — coluna Data, coluna Comerciante, coluna Valor, coluna Categoria, coluna Forma de Pagamento. O nome do arquivo original é incluído como coluna de referência, para que cada linha da planilha possa ser rastreada até sua captura de tela de origem para fins de auditoria. Exporte, abra no Excel e os dados que estavam espalhados por 37 layouts diferentes de aplicativos agora estão em uma única tabela classificável e filtrável.
A compressão de tempo nesta etapa é a métrica central. O que levava 12 a 15 minutos por captura de tela — abrir a imagem, ler os campos, digitá-los na linha da planilha, conferir os números, passar para a próxima imagem — agora leva de 5 a 10 segundos por captura de tela de tempo de processamento de IA, além de alguns minutos para enviar o lote. Para 37 envios, isso dá aproximadamente quatro minutos de interação com a ferramenta, em vez de doze horas de digitação manual. O benchmark de 20 minutos da GBTA colapsa não porque qualquer parte do processo de despesas mudou, mas porque a etapa de digitação manual — que consumia a maior parte desses 20 minutos — foi automatizada até deixar de existir.
Conformidade com o IRS: Capturas de Tela Satisfazem os Requisitos de Comprovação de Despesas?
A resposta curta: sim — desde que contenham os elementos de dados exigidos. De acordo com a IRS Publication 463 e o Internal Revenue Code §274(d), as deduções de despesas empresariais devem ser comprovadas por registros adequados ou evidências suficientes. Para cada despesa, a documentação deve estabelecer o valor, a data, o local e a finalidade comercial. Para refeições e entretenimento, a relação comercial das pessoas envolvidas também deve ser documentada.
Uma captura de tela digital de uma confirmação de pagamento satisfaz esses requisitos exatamente como um recibo em papel — o IRS aceita registros digitais, incluindo imagens eletrônicas e capturas de tela, desde a Revenue Ruling 2003-106, que aprovou explicitamente recibos eletrônicos e relatórios de despesas para acordos de reembolso com planos contábeis. A regra do recibo de $75 (IRC §274(d)) estabelece que, para despesas abaixo de $75, um recibo não é obrigatório — mas o valor, a data, o local e a finalidade comercial ainda devem ser registrados. Para despesas de $75 ou mais, um recibo ou evidência documental equivalente é obrigatório.
O que isso significa para seu fluxo de trabalho: uma captura de tela de uma refeição de $47,19 não exige legalmente a retenção do recibo em papel original, mas você ainda precisa registrar a data, o comerciante, o valor e a finalidade comercial em algum lugar recuperável. Uma captura de tela de uma conta de hotel de $312 exige retenção — e uma captura de tela da confirmação de pagamento do hotel, além de uma captura de tela do detalhamento dos itens da conta, satisfaz o requisito de evidência documental, desde que os dados estejam legíveis e completos.
O valor prático de conformidade de extrair dados de capturas de tela para uma planilha estruturada vai além de satisfazer o IRS. Quando cada linha de despesas na sua planilha referencia o nome do arquivo original — alipay_starbucks_march15.png, chase_hotel_marriott_march17.png — a conexão entre os dados e a prova sobrevive a qualquer auditoria futura ou revisão interna. Alguém abrindo a planilha três anos depois (o período de retenção recomendado pelo IRS para registros de despesas) pode localizar a captura de tela original apenas pelo nome do arquivo, sem precisar reler cada imagem. É isso que a integridade da trilha de auditoria parece quando suas evidências de despesas são puramente digitais.
Como é um Lote de Fim de Mês na Prática
Considere um cenário real: uma consultoria de 40 pessoas sem programa de cartão corporativo e sem software de gestão de despesas. Os funcionários enviam evidências de despesas por três canais: um canal do Slack da empresa (#expenses), anexos de e-mail e — para consultores de campo — mensagens do WeChat diretamente para o líder financeiro. No final de março, o líder financeiro baixa tudo em uma pasta.
A pasta contém: 14 capturas de tela de confirmação de pagamento do Alipay/WeChat Pay; 9 imagens de recibos em papel fotografados com celulares; 6 confirmações por e-mail de reservas de companhias aéreas e hotéis, encaminhadas como capturas de tela; 4 capturas de tela de listas de transações de aplicativos bancários; 3 faturas em PDF de fornecedores; e 2 fotos de registros de quilometragem manuscritos. São 38 arquivos, pelo menos cinco formatos visuais distintos, contendo os mesmos dados principais — data, comerciante/fornecedor, valor, categoria, método de pagamento — organizados em cinco layouts completamente diferentes.
Processar esse lote com digitação manual: o líder financeiro abre cada arquivo, lê os campos e os digita na planilha mestre. A troca de formato é o imposto oculto. Ler uma confirmação do Alipay — nome do comerciante em negrito no topo central, valor em texto colorido grande — treina o olho para escanear um certo layout. Então o próximo arquivo é uma lista de transações bancárias com valores em uma coluna, comerciantes em outra coluna, datas acima — um padrão de escaneamento completamente diferente. O olho precisa se readaptar. No arquivo 20, os erros aumentam. No arquivo 30, o líder financeiro está cometendo erros que não cometeria no arquivo 5. A taxa de erro de 19% do GBTA não é distribuída uniformemente — ela se concentra na segunda metade de uma sessão de processamento em lote, impulsionada pela fadiga de troca de formato.
Processar o mesmo lote com extração por IA: envie todos os 38 arquivos de uma vez. Defina as colunas — Data, Comerciante, Valor, Categoria, Método de Pagamento, Finalidade do Negócio. A IA lê cada arquivo entendendo o que os dados significam, encontra os valores correspondentes em cinco layouts visuais diferentes e gera uma planilha com 38 linhas. O trabalho restante do líder financeiro é revisão e aprovação — tarefas que exigem julgamento e conhecimento de políticas — em vez de digitação manual, que não exige nenhum dos dois.
A diferença de custo nessa escala: 38 capturas de tela × 20 minutos manual = 760 minutos (12,7 horas). Com a taxa horária totalmente carregada do líder financeiro de aproximadamente $30, isso é $381 em trabalho de digitação manual por um mês. Anualizado em 12 meses: $4.572 gastos em uma tarefa que uma ferramenta de IA executa em menos de cinco minutos de interação ativa com a ferramenta por mês.
Três erros de digitação manual que só acontecem com capturas de tela
Nem todos os erros de relatório de despesas são iguais. A digitação manual de capturas de tela introduz três modos de falha específicos que recibos em papel e feeds de cartão corporativo não produzem:
1. Contaminação por Elementos de Interface
Uma captura de tela de aplicativo de pagamento contém os dados da transação — mas também a barra de navegação do aplicativo ("Voltar", "Compartilhar", "Detalhes"), uma barra de status com hora e porcentagem da bateria, às vezes uma animação flutuante de "Sucesso", e a bandeja de notificações do telefone se a captura foi tirada rapidamente. O OCR tradicional lê tudo isso como texto. Um rótulo de botão "Voltar" é extraído como um campo. A porcentagem da bateria "73%" é lida como um valor em dólares. A hora na barra de status — "14:31" — é identificada erroneamente como horário da transação.
A IA visual distingue entre a interface do aplicativo e o conteúdo do aplicativo porque entende a gramática visual de uma tela: barras de navegação ficam nas bordas superior e inferior em um estilo consistente, ícones de status ficam em um canto específico, os dados da transação ficam na área central de conteúdo com tipografia e espaçamento diferentes. A distinção que é óbvia para um humano — "isso é parte do aplicativo, isso é o dado que eu quero" — é parte do que o modelo de IA aprende a separar.
2. Ambiguidade de Símbolo de Moeda e Formato
Empresas globais recebem capturas de tela de despesas em múltiplas moedas. Um funcionário coreano envia uma captura de tela do KakaoPay com "₩47.000" — ₩47.000 KRW, não $47.000 USD (cerca de $32). Um funcionário japonês envia uma captura de tela do PayPay com "¥1.280" — ¥1.280 JPY, aproximadamente $8. Um funcionário alemão envia uma captura de tela bancária onde "1.280,50 €" usa a notação europeia de milhar/decimal — potencialmente lida erroneamente como $1,28 por um mecanismo de OCR americano que usa o formato dos EUA por padrão.
Quando a IA visual extrai esses campos, a compreensão contextual do aplicativo — KakaoPay é um aplicativo de pagamento coreano, PayPay é japonês, um aplicativo bancário alemão da Sparkasse usa o locale alemão — informa a interpretação. A IA extrai "1280" como o valor numérico e preserva o contexto da moeda, permitindo que a planilha de saída normalize entre moedas em uma etapa de pós-processamento. O OCR tradicional gera "1.280,50" ou "¥1.280" como strings de texto brutas que alguém precisa normalizar manualmente — em si uma etapa manual propensa a erros.
3. Classificação de Categoria como Etapa Manual Separada
Um relatório de despesas precisa de mais do que apenas os dados da transação — ele precisa da categoria da despesa: Refeições e Entretenimento, Viagem, Materiais de Escritório, Serviços Profissionais, ou os códigos GL específicos da empresa. Com a digitação manual, isso é uma decisão que o profissional de finanças toma para cada item. "Starbucks — isso é Refeições. Office Depot — Materiais. Uber — Viagem." Isso adiciona de 5 a 10 segundos de carga cognitiva por item e introduz inconsistência quando revisores diferentes categorizam o mesmo comerciante de maneiras diferentes.
A extração por IA pode lidar com isso como parte da mesma passagem através de um mecanismo chamado coluna inferida. Quando você define uma coluna como Categoria (opções: Refeições/Viagem/Escritório/Outro), a IA lê o nome do comerciante, o contexto da transação e o tipo de documento, e infere a categoria mais provável a partir das opções que você forneceu — sem exigir uma etapa de categorização separada. A inferência opera em regras que você define (limitadas ao conjunto de opções que você especificar), então o resultado é consistente em todo o lote. A mesma capacidade subjacente pode inferir método de pagamento, código GL, departamento ou qualquer classificação específica do negócio com base no conteúdo do documento.
Link de Coleta: Pare de Receber Capturas de Tela por Email e Slack
O problema estrutural mais profundo não é a digitação manual — é o canal de envio. Quando os funcionários enviam capturas de tela de despesas por email, Slack, WeChat e SMS, o trabalho da equipe de finanças começa com uma fase de download e organização que não tem nada a ver com contabilidade: coletar arquivos de quatro plataformas diferentes, renomeá-los para rastreabilidade, agrupá-los por funcionário, identificar quais envios estão completos e quais estão faltando.
Um Link de Coleta resolve isso fornecendo um único ponto de envio. O líder de finanças gera um link — uma URL única — e o envia aos funcionários. Quando um funcionário abre o link no navegador do celular, ele insere um código de verificação curto e envia suas capturas de tela de despesas diretamente pelo navegador. Os arquivos chegam na fila de processamento da conta do líder de finanças, identificados pelo horário de envio e nome do arquivo, organizados em uma única visualização. Sem anexos de email para baixar. Sem threads de Slack para percorrer. Sem capturas de tela encaminhadas de conversas por mensagem de texto.
Para equipes de campo e contratados externos que não têm contas de email corporativas, isso elimina o modo de falha de envio mais comum: "Enviei, você recebeu?" O link de coleta é um destino fixo. O envio é confirmado na tela. O líder de finanças pode ver exatamente quais funcionários enviaram e quais não, antes mesmo de o processamento começar.
Google Sheets Add-on: Extração Direto na Sua Planilha de Despesas
Para equipes financeiras que vivem no Google Sheets — e, de acordo com o padrão mais comum de fluxo de trabalho de despesas que vemos entre pequenas empresas e empresas de médio porte, isso descreve uma parcela substancial das equipes que processam menos de 200 relatórios por mês — o Google Sheets Add-on elimina totalmente a etapa de exportar e importar. O add-on abre como uma barra lateral dentro de qualquer planilha do Google. Envie capturas de tela de despesas diretamente na barra lateral, defina suas colunas, processe o lote, e os dados extraídos são anexados diretamente à planilha ativa — sem downloads de arquivos, sem conversão de Excel para Sheets, sem copiar e colar entre janelas.
O add-on opera em modo de conta quando conectado a uma chave de API: modelos, regras de correspondência e histórico de processamento são sincronizados com o aplicativo web. Membros da equipe com acesso de edição à planilha podem enviar e processar dentro das cotas individuais dos seus planos. O resultado é uma única planilha — compartilhada entre a equipe financeira — onde os dados de despesas chegam a partir de capturas de tela e fotos de recibos sem que ninguém digite um único campo.
Experimente com Capturas de Tela Reais de Despesas
A melhor maneira de avaliar se a extração por IA funciona com a sua combinação específica de capturas de tela de despesas é testá-la com arquivos reais. A demonstração abaixo roda no preset expense-report — colunas pré-configuradas para Data, Comerciante, Valor e Categoria — mas você pode adicionar, remover ou renomear qualquer coluna para corresponder à sua própria planilha de despesas. Sem necessidade de cadastro. Sem cartão de crédito. Os arquivos são processados em segundos e não são armazenados além da sessão.
Quanto Custa
O ImageToTable.ai oferece quatro planos. O Free plan inclui 50 créditos por mês — o suficiente para uma equipe pequena processar algumas capturas de tela de despesas e avaliar se a qualidade da extração atende às suas necessidades. O Basic plan por $9/mês cobre 500 créditos mensais, adequado para uma equipe que processa 100-200 envios de despesas por mês. O Pro plan por $19/mês oferece 2.000 créditos, cobrindo o processamento em lote em volumes maiores, incluindo contas de hotel em PDF de várias páginas e faturas de fornecedores que exigem mais créditos por documento. O Max plan por $59/mês oferece 10.000 créditos para equipes financeiras de alto volume e inclui processamento prioritário. Todos os planos pagos incluem acesso ao Google Sheets add-on, gerenciamento de modelos e exportação em lote.
Comparado ao custo de processamento manual por relatório de $35-$58, a assinatura se paga dentro dos primeiros cinco a dez envios de despesas do mês. Um Pro plan por $19/mês processa o mesmo volume de dados de despesas que custaria a uma equipe financeira cerca de $1.260 em digitação manual à taxa de pequenas empresas da Aberdeen. A conta não precisa de planilha — você pode fazer de cabeça.
Perguntas Frequentes
A extração por IA consegue ler capturas de tela em chinês, japonês, coreano ou outros idiomas que não sejam inglês?
Sim. O modelo de IA visual processa texto em todos os principais idiomas, incluindo chinês (simplificado e tradicional), japonês, coreano, árabe, tailandês, vietnamita e todos os idiomas europeus. Capturas de tela de aplicativos de pagamento como Alipay, WeChat Pay, KakaoPay, PayPay e outros aplicativos regionais são suportadas. O modelo extrai os dados no idioma de origem e pode preservar o texto original — então, um nome de comerciante chinês em uma captura de tela do Alipay aparece como texto em chinês na planilha de saída, não como uma transliteração.
Qual é a diferença entre isso e o recurso "Obter Dados da Imagem" do Microsoft Excel?
O "Obter Dados da Imagem" do Excel extrai todo o texto visível de uma imagem para uma grade não estruturada — ele captura tudo o que o mecanismo de OCR consegue ler e coloca em células aproximadamente na mesma disposição espacial da imagem original. Ele não distingue entre "este é o valor que me interessa" e "este é o texto da barra de navegação". Para uma captura de tela com 15 trechos de texto visível, você obtém 15 células. Depois, você precisa encontrar, extrair e reorganizar os pontos de dados específicos de que precisa. A extração por IA com colunas personalizadas extrai apenas os campos que você especifica — Data, Valor, Comerciante, Categoria — e os organiza diretamente na estrutura de colunas que você definiu, prontos para uso.
Funciona com capturas de tela de baixa qualidade — imagens compactadas enviadas por aplicativos de mensagens?
Os artefatos de compactação de aplicativos de mensagens (WeChat, WhatsApp, Slack recompactam imagens) reduzem a qualidade da imagem e, em níveis severos de compactação, textos pequenos podem se tornar ilegíveis. O modelo de IA tem melhor desempenho com capturas de tela nítidas e em resolução original — a qualidade que você obtém quando um funcionário faz uma captura de tela diretamente no celular e a envia sem repassar por um aplicativo de chat. Se o texto for legível a olho nu na imagem compactada, a IA geralmente consegue extraí-lo. Se a compactação transformou o texto em blocos de pixels ilegíveis, a qualidade da extração será prejudicada.
Posso usar a mesma ferramenta para processar recibos em papel junto com capturas de tela?
Sim. A ferramenta processa capturas de tela, fotos de recibos, extratos em PDF e documentos digitalizados no mesmo lote — você não precisa de ferramentas separadas para diferentes tipos de entrada. Envie a captura de tela do Alipay, a foto do recibo em papel e o folio do hotel em PDF juntos. Defina suas colunas uma vez — Data, Comerciante, Monto, Categoria — e cada linha na planilha de saída representa um documento processado, independentemente de a fonte ter sido uma captura de tela digital, uma foto de recibo ou um PDF.
Como isso se integra com QuickBooks, Xero ou nosso ERP?
A ferramenta gera formatos Excel (XLSX) e CSV, que são importáveis por todos os principais sistemas de contabilidade. QuickBooks Online e Xero aceitan importações CSV e Excel para transações de despesas. Para sistemas ERP com formatos de importação personalizados, os dados extraídos podem servir como uma fonte limpa e estruturada que alimenta seu pipeline de importação existente. A ferramenta fica antes do seu sistema de contabilidade no fluxo de trabalho — ela produz dados estruturados a partir de capturas de tela não estruturadas, e esses dados estruturados percorrem seu processo normal de importação e conciliação.
O que acontece com os arquivos de captura de tela após o processamento?
Os arquivos enviados são processados em memória e não são armazenados no servidor além da sessão de processamento ativa. Você pode excluir tarefas processadas em qualquer momento desde o painel da sua conta, o que remove tanto os dados extraídos como os arquivos de origem do servidor. Para conformidade contínua, recomendamos retener as capturas de tela de origem em seu próprio armazenamento — uma carpeta do Google Drive, uma biblioteca de documentos do SharePoint ou seu servidor de arquivos — com a columna de referência de nome de arquivo da planilha de saída fornecendo o rastro de auditoría de volta a cada arquivo de origem.
A Conclusão
As capturas de tela de despesas não vão desaparecer. Os empregados continuarán enviando evidências de despesas da maneira que seus telefones as producen naturalmente — confirmaciones de aplicativos de pagamento, capturas de tela de transações bancarias, fotos de recibos, correos electrónicos reenviados. Cada uma dessas capturas de tela contém dados que alguien en su equipo de finanzas está leyendo actualmente y luego tecleando en una hoja de cálculo, a un costo de aproximadamente $35 a $58 por informe. El costo no es visible porque está incrustado en el salario — alguien está haciendo este trabajo, el trabajo se hace, y el costo se absorbe en la nómina del equipo de finanzas. Pero el costo es real, y el número anual incluso para un equipo pequeño alcanza cinco cifras.
La extracción con IA visual no cambia el flujo de trabajo de informes de gastos. Cambia el paso dentro de él que estaba consumiendo el 60-70% del tiempo: la transcripción de datos visibles de una imagen a una fila en una hoja de cálculo. Cuando ese paso se reduce de 15 minutos a 10 segundos, el punto de referencia se mueve. Y el equipo de finanzas que pasaba 12 horas al mes leyendo capturas de pantalla comienza a dedicar ese tiempo a tareas que realmente requieren juicio financiero.