Le problème des données de déclaration en douane
que l'OCR basé sur des modèles n'a jamais résolu
Un importateur d'électronique de taille moyenne à Chicago a déposé 47 déclarations sur le formulaire 7501 du CBP en mars 2025. Une déclaration contenait un chiffre inversé dans le code HTS — 8471.30 au lieu de 8471.80. L'écart a déclenché un signalement automatique du CBP, qui a conduit à une évaluation ciblée. En septembre, les auditeurs du CBP examinaient chaque déclaration déposée par l'entreprise au cours des trois années précédentes. L'erreur initiale a pris 4 secondes à saisir. L'audit a consommé 4 mois du temps de l'équipe de conformité. C'est cela — et non la saisie lente des données — le véritable coût du traitement manuel des déclarations en douane.
Une faute de frappe de quatre secondes, un audit de quatre mois
L'Organisation mondiale du commerce recense plus de 50 000 modifications de droits de douane par an dans ses 164 États membres. Un seul code SH peut différer d'un chiffre entre une classification en franchise et un tarif de 25 % — et chaque erreur de classification entraîne une conséquence financière qui se cumule rétroactivement. Les douanes américaines peuvent contrôler les déclarations jusqu'à trois ans en arrière en vertu du 19 U.S.C. 1484. Les autorités douanières de l'UE, sous le code des douanes de l'Union (règlement (UE) 952/2013), disposent de pouvoirs rétroactifs similaires. Une erreur de saisie aujourd'hui ne coûte pas seulement des frais de correction : elle ouvre une fenêtre sur toutes vos déclarations passées.
Pourtant, la logistique pour obtenir des données exactes reste obstinément manuelle. Un importateur recevant des marchandises de cinq fournisseurs dans trois pays manipule le formulaire CBP 7501 (45+ champs répartis sur 43 blocs), le document administratif unique de l'UE (54 cases), des factures commerciales dans cinq formats différents provenant de cinq fournisseurs, des listes de colisage avec des noms de champs variables, et des connaissements qui peuvent ou non correspondre aux valeurs déclarées. Chacun de ces documents alimente la déclaration en douane — et chacun est un point potentiel d'échec de transcription.
Selon l'International Journal of Research Publication and Reviews, plus de 30 % des retards d'expédition en Asie du Sud-Est proviennent de documents douaniers incomplets ou erronés. Une étude Vizion de 2025 a révélé que 32 % des retards douaniers sont spécifiquement causés par des erreurs ou des informations manquantes sur les factures douanières. Ce ne sont pas des problèmes de vitesse de traitement. Ce sont des problèmes d'intégrité des données entre des formats de documents qui n'ont jamais été conçus pour être interopérables.
La saisie manuelle des données douanières a un taux d'erreur de 1 à 4 % par champ. Un formulaire CBP 7501 typique contient 15 à 25 valeurs transcrites indépendamment. À l'extrémité inférieure de cette fourchette, une déclaration sur quatre contient au moins un point de données erroné — n'importe lequel pouvant déclencher un contrôle de conformité qui s'étend sur des années.
Pourquoi les déclarations en douane font échouer l'OCR basé sur des modèles
L'OCR basé sur des modèles — la technologie derrière la plupart des outils d'extraction de documents du marché — fonctionne en mappant des positions fixes sur une page vers des champs de données. Vous définissez une zone pour « Importateur enregistré » sur le formulaire 7501 du CBP, et chaque formulaire suivant alimente le contenu de cette zone dans la même colonne. Le problème est que cette approche dépend d'une mise en page unique et immuable. Les déclarations en douane sont tout le contraire d'immuables.
Prenons l'exemple d'un importateur qui dépose des déclarations dans trois juridictions. Le formulaire 7501 du CBP place le numéro d'entrée dans le bloc 1, l'importateur enregistré dans le bloc 12 et le pays d'origine dans le bloc 11 — chacun étant un champ numéroté dans un formulaire gouvernemental multi-blocs. Le SAD de l'UE place le déclarant dans la case 14, le pays d'origine dans la case 16 et les codes marchandises dans la case 33, avec les unités complémentaires dans la case 41. La variante C88 du Royaume-Uni réorganise ces champs une fois de plus. La déclaration d'importation japonaise (輸入申告書) utilise une mise en page entièrement différente. Un modèle zoné pour le 7501 produit des données incohérentes lorsqu'il est pointé vers un SAD — les coordonnées ne se transfèrent pas.
Mais le point de défaillance le plus important n'est pas le formulaire douanier lui-même. Ce sont les documents justificatifs qui alimentent les données. La facture commerciale du fournisseur A à Shenzhen liste les codes HS dans la colonne 4 avec des valeurs FOB Shenzhen. Le fournisseur B à Stuttgart place les codes marchandises dans un bloc latéral et cite des prix EXW. Le fournisseur C à Monterrey envoie une facture manuscrite avec des abréviations et aucun code HS. Un courtier en douane sur le subreddit r/CustomsBroker a capturé la réalité : « Nos fichiers sont stockés sous forme papier, mais les documents sont aussi associés aux déclarations dans notre système. Nous les recevons tous par e-mail. » Les documents arrivent sous forme de PDF, de scans, de photos et de captures d'écran — puis quelqu'un saisit les données de chacun dans le système de déclaration.
C'est le problème structurel que l'OCR basé sur des modèles ne peut pas résoudre : lorsque chaque partenaire commercial formate les documents différemment, vous avez besoin d'un système qui lit par le sens, et non par la position. Un champ appelé « Code HS » sur une facture et « Classification tarifaire » sur une autre est la même entité sémantique — mais un outil basé sur des modèles les voit comme des zones sans rapport sur des documents sans rapport.
La cascade de conformité : ce que coûte réellement un seul chiffre erroné
Il est facile de considérer les erreurs douanières comme de simples désagréments administratifs — des frais de correction ici, un retard de deux jours là. La réalité est une chaîne de conséquences croissantes que la plupart des importateurs ne cartographient qu'au moment où ils la déclenchent.
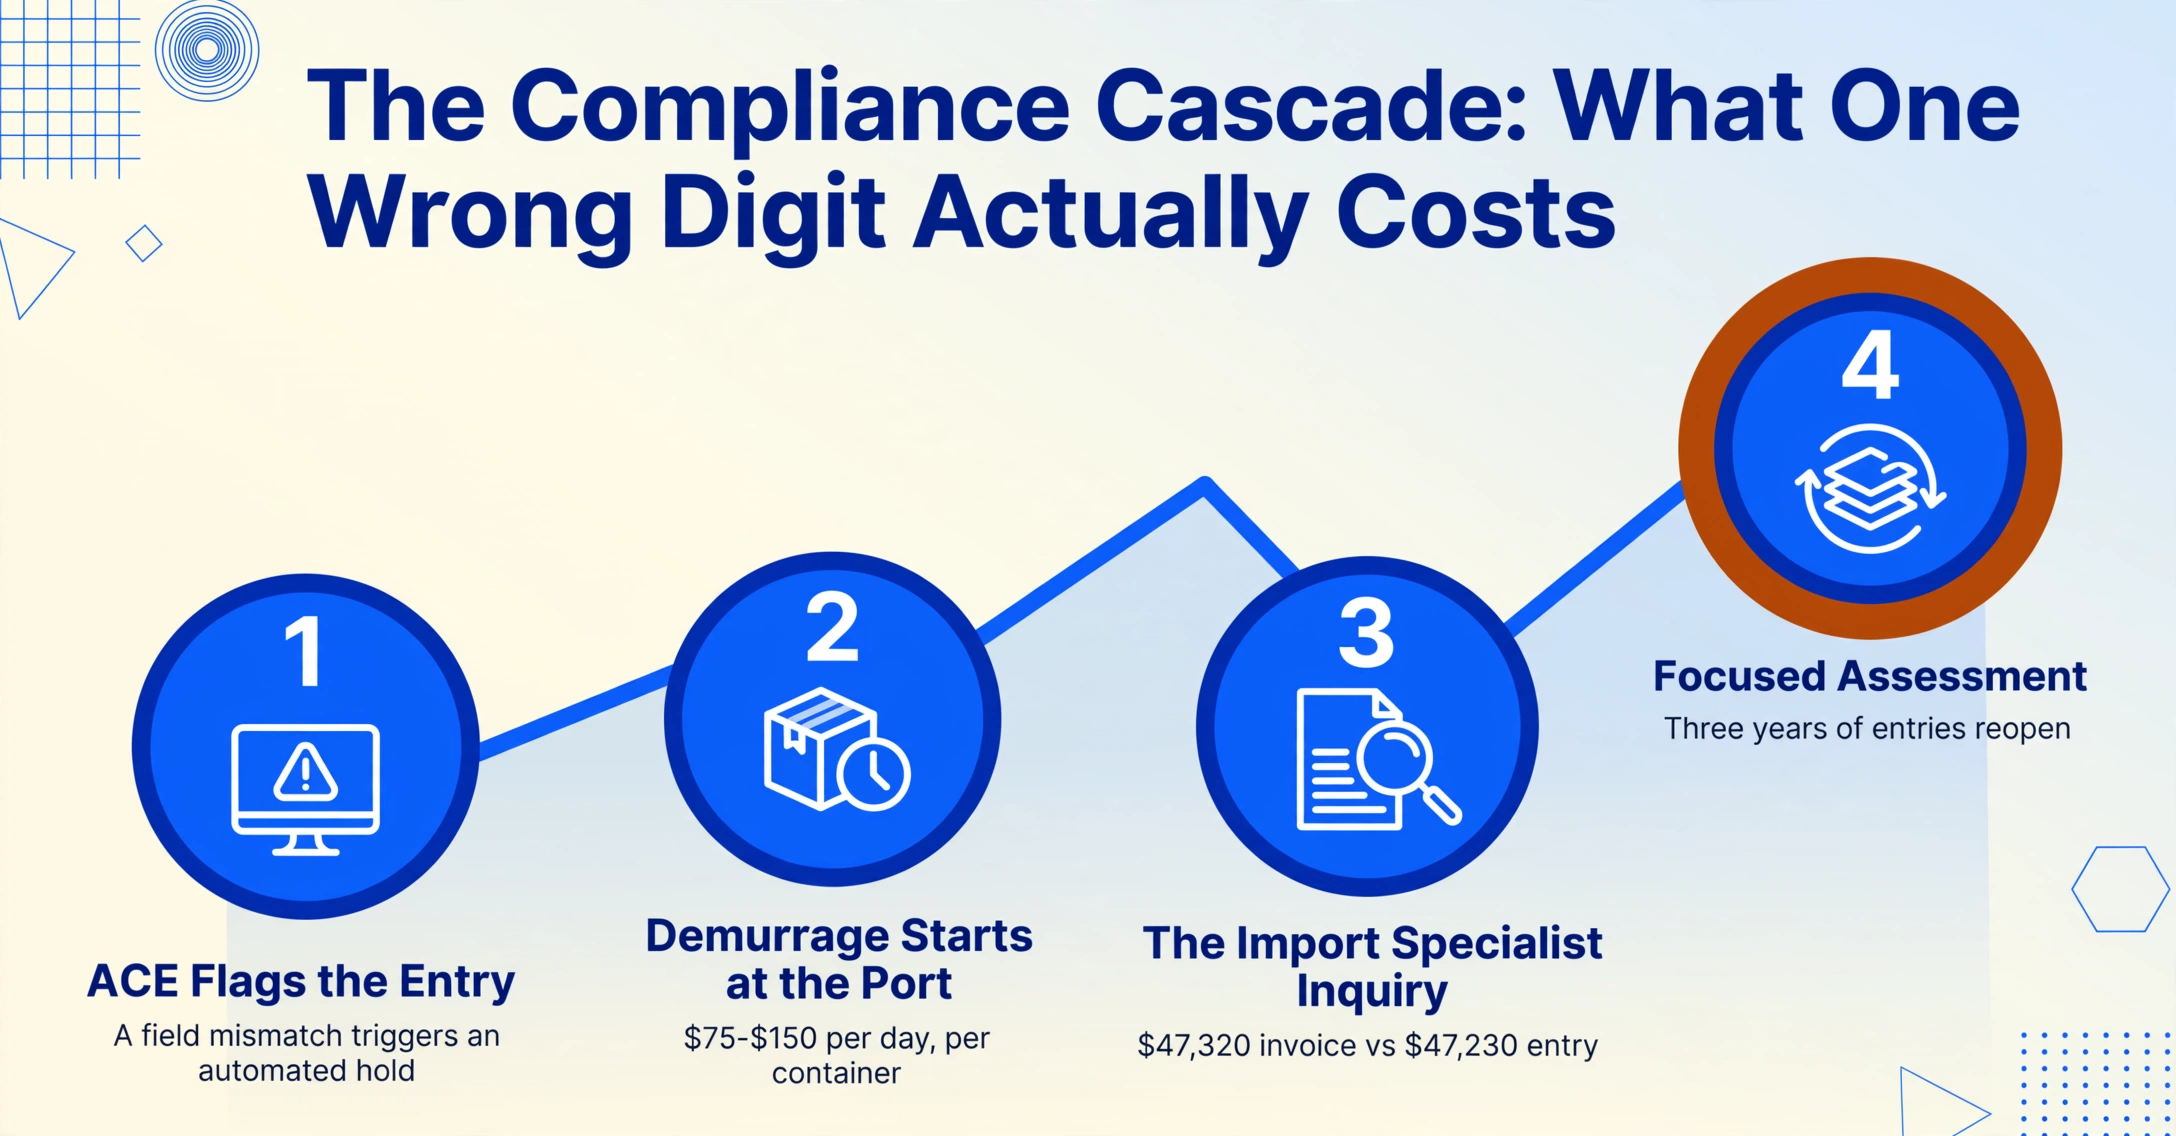
Le premier domino : le signalement automatisé. L'environnement commercial automatisé du CBP exécute des contrôles algorithmiques sur chaque déclaration électronique. Les incohérences au niveau des champs — une valeur déclarée qui s'écarte des normes statistiques pour ce code HS, un pays d'origine qui ne correspond pas à l'itinéraire typique de la chaîne d'approvisionnement pour cette marchandise — déclenchent des blocages automatisés. L'expédition cesse d'avancer. Les frais de surestarie commencent à s'accumuler au port, généralement de 75 à 150 $ par jour et par conteneur dans les ports américains selon les barèmes tarifaires des transporteurs, et les frais de détention s'ajoutent une fois le conteneur sorti du terminal.
Le deuxième domino : l'enquête. Un spécialiste des importations du CBP examine la déclaration signalée et demande des documents à l'importateur ou au courtier. C'est là que les erreurs de transcription apparaissent. Une facture commerciale indique 47 320 $ FOB, mais le formulaire 7501 a été saisi à 47 230 $. Un code HS à 10 chiffres qui devrait être 8471.80.0100 est saisi comme 8471.30.0100 — une sous-position différente avec un taux de droit différent. Le CBP ne fait pas de distinction entre une faute de frappe et une tentative de fausse déclaration. L'écart en lui-même constitue le problème de conformité.
Le troisième domino : le contrôle ciblé. Si des écarts apparaissent sur plusieurs déclarations — ou si un seul écart est suffisamment important — le CBP peut procéder à un contrôle ciblé (FA) dans le cadre de son programme d'audit réglementaire. Un FA n'est pas un simple examen documentaire. C'est un audit complet de la conformité douanière d'un importateur, couvrant le classement, l'évaluation, le pays d'origine, les demandes de programmes commerciaux préférentiels et la tenue des registres. Les auditeurs du CBP peuvent examiner les déclarations remontant à trois ans. La charge de la preuve incombe à l'importateur — le 19 CFR 162.1a exige que les importateurs « établissent l'exactitude des informations requises dans les documents de déclaration ». Si vous ne pouvez pas prouver que votre valeur déclarée était correcte parce que la facture commerciale originale était un scan PDF avec des chiffres ambigus, vous perdez.
Le quatrième domino : la pénalité. En 2024, l'application des règles commerciales américaines a atteint de nouveaux sommets. Le Bureau of Industry and Security (BIS) a engagé 26 poursuites pénales et ajouté plus de 340 entités aux listes de parties restreintes. Les pénalités administratives pour violations commerciales ont atteint un maximum de 364 992 $ par violation ou le double de la valeur de la transaction — selon le montant le plus élevé — conformément aux barèmes de pénalités mis à jour en 2024. Les pénalités pénales peuvent aller jusqu'à 20 ans d'emprisonnement et 1 million de dollars par violation. Le Department of Justice a émis environ un tiers de pénalités supplémentaires liées au FCPA et aux sanctions en 2024 par rapport à 2023, y compris une amende de 364 millions de dollars contre une entreprise aérospatiale et de défense pour violations du FCPA et des contrôles à l'exportation.
La négligence n'est pas une défense. En vertu du 19 CFR 111, les courtiers en douane doivent faire preuve de « diligence raisonnable » dans la préparation des déclarations. Si un importateur fournit des données erronées et que le courtier les dépose sans vérification, les deux parties partagent la responsabilité. La licence du courtier est en jeu. La caution de l'importateur est en jeu. L'erreur de saisie se transforme en un échec de conformité multipartite.
En 2025, la charge de conformité augmente, elle ne diminue pas. Le formulaire 7501 mis à jour par le CBP — publié le 8 juillet 2025 — a ajouté quatre nouveaux champs obligatoires pour les importations d'acier et d'aluminium au titre de l'article 232 : Pays de fusion et de coulée, Pays principal de fusion, Pays secondaire de fusion et Pays de fusion et de coulée de l'aluminium. Ces champs exigent des données de traçabilité qui ne figurent souvent pas sur une facture commerciale standard, obligeant les importateurs à solliciter des documents supplémentaires auprès des fournisseurs et à les retranscrire dans encore plus de champs de déclaration.
Parallèlement, les mises à jour 2025 du DAU de l'UE dans le cadre du mécanisme d'ajustement carbone aux frontières (MACF — Règlement (UE) 2023/956) exigent des données sur les émissions de carbone par mode de transport. La directive sur le devoir de vigilance des entreprises en matière de durabilité (CSDDD) impose des déclarations attestant de l'absence de minerais de conflit ou de travail forcé dans la production. Chaque nouveau champ réglementaire est un point de données supplémentaire qui doit être extrait d'un document fournisseur, retranscrit correctement et déposé dans les délais. La marge d'erreur de conformité s'accroît à chaque mise à jour réglementaire.
Extraction sémantique vs extraction par position : pourquoi c'est crucial pour la douane
La limitation fondamentale de l'OCR basé sur des modèles dans le traitement douanier n'est pas technique — elle est architecturale. L'extraction par position suppose une relation stable entre l'emplacement physique d'un champ sur la page et sa signification. Les déclarations en douane, par nature, violent cette hypothèse à tous les niveaux.
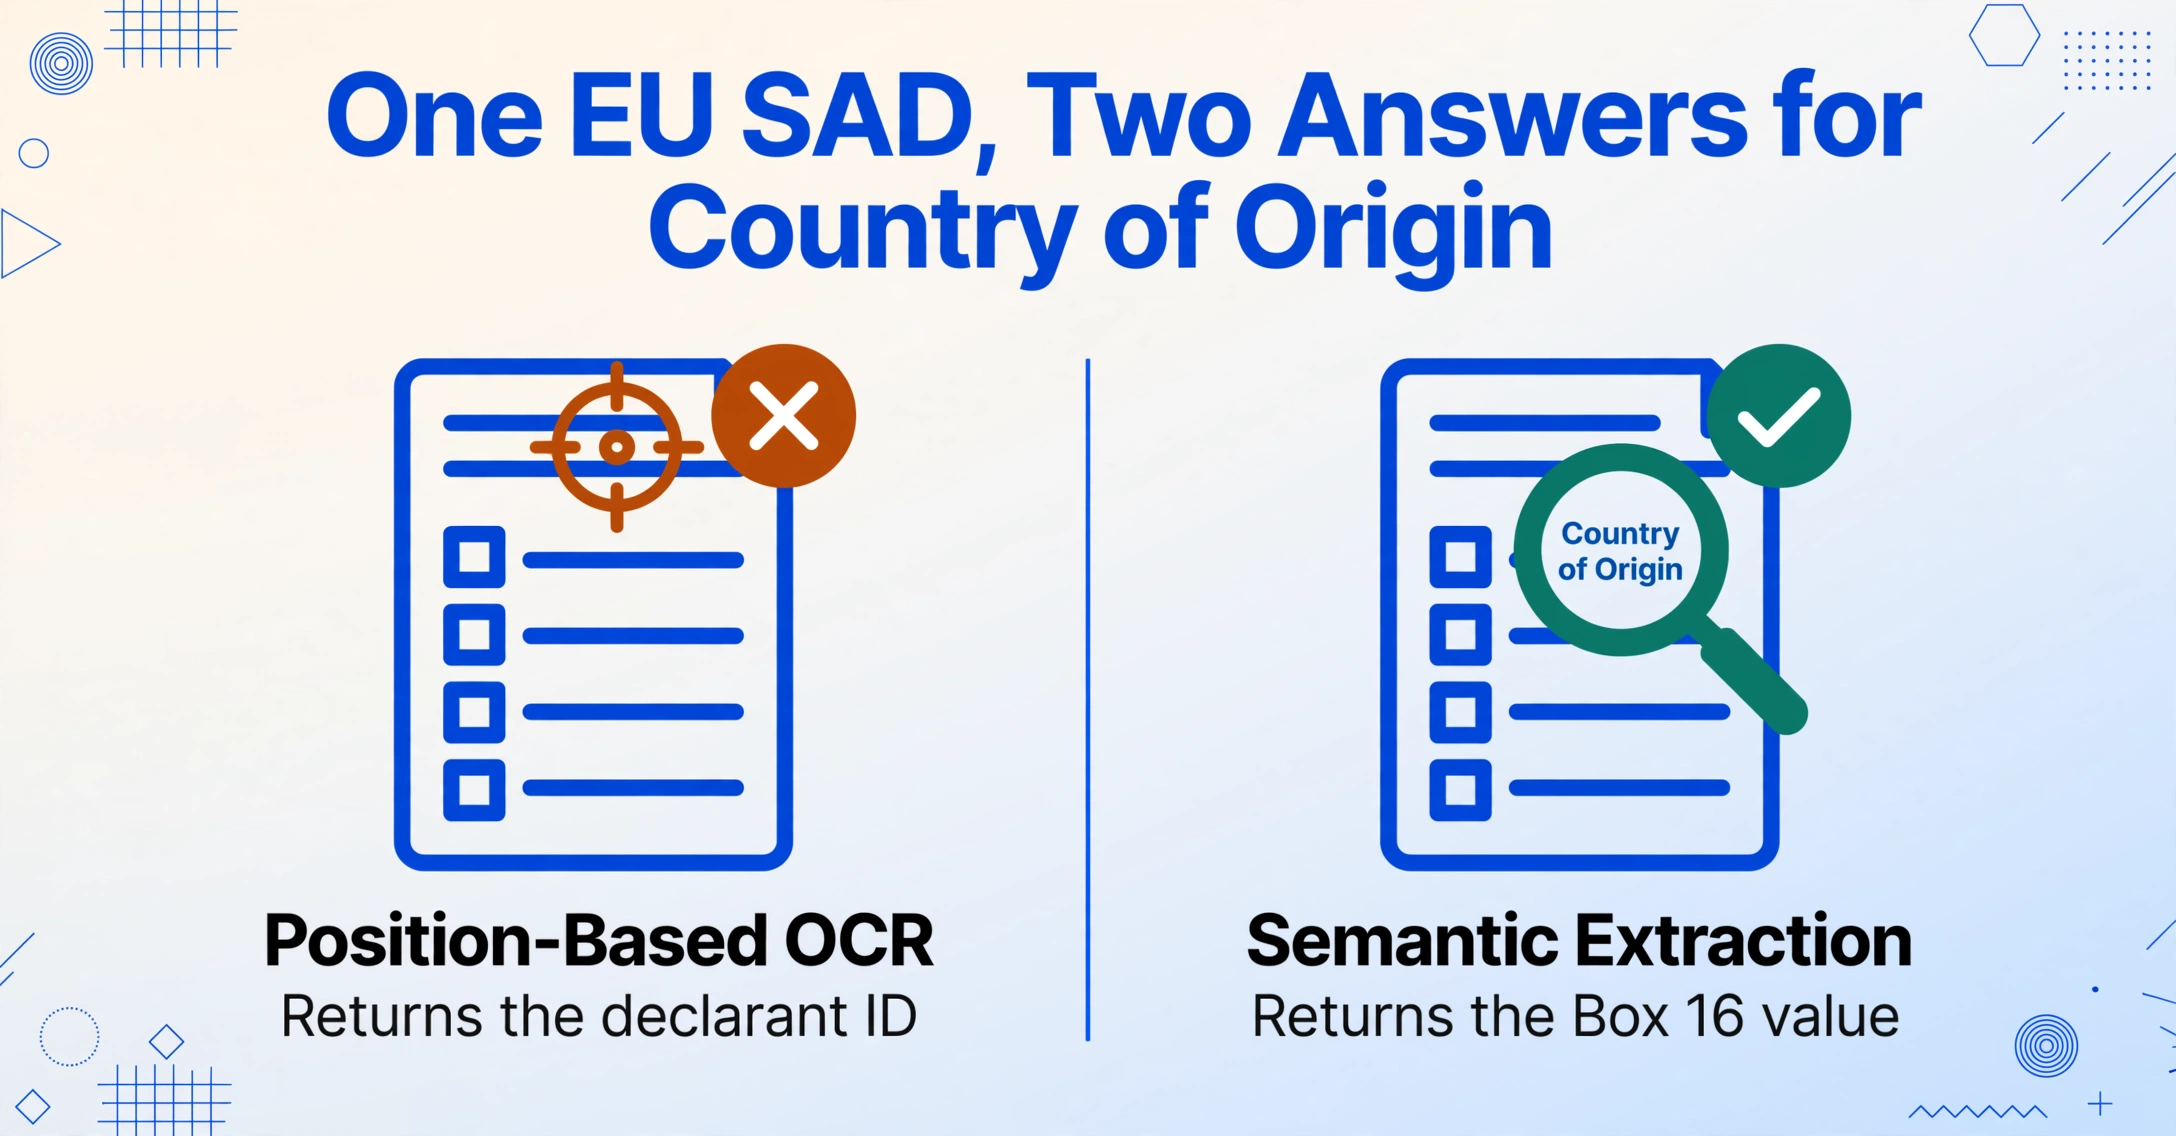
Un outil basé sur la position, entraîné sur le formulaire 7501 du CBP, apprend que le pays d'origine se trouve dans le bloc 11 — environ au tiers de la page dans la colonne de gauche. Lorsque le même outil rencontre un DAU, il cherche les données aux mêmes coordonnées et trouve le numéro d'identification du déclarant. L'extraction est erronée, et l'outil n'a aucun moyen de le savoir car il ne comprend pas ce que signifie « Pays d'origine » — il sait seulement où il se trouve habituellement.
L'extraction sémantique — parfois appelée extraction basée sur l'intention ou sans modèle — inverse cette relation. Au lieu de cartographier des positions, elle cartographie le sens. Vous indiquez au système ce que vous voulez : « Pays d'origine », « Code SH », « Valeur déclarée », « Numéro de l'importateur ». L'IA lit chaque document — qu'il s'agisse d'un CBP 7501, d'un DAU de l'UE, d'une déclaration d'importation japonaise ou d'une facture commerciale d'un fournisseur — et localise les données qui répondent à chaque définition de champ, quel que soit l'endroit où elles apparaissent sur la page ou la manière dont elles sont libellées.
C'est la différence entre programmer un outil pour lire un format de document et apprendre à un outil à comprendre à quoi ressemblent les données douanières dans tous les formats. La première approche évolue en fonction du nombre de modèles de documents que vous maintenez. La seconde approche fonctionne sur tout document contenant les informations que vous recherchez.
Pour les déclarations en douane en particulier, l'extraction sémantique gère trois défis structurels qui brisent les outils basés sur la position :
1. Variation des noms de champs entre documents. La même donnée apparaît sous différentes appellations selon les juridictions : « HTS Number » (États-Unis), « Code marchandise » (UE), « Code SH » (langue de la convention de l'OMD), « Tariff Code » (Royaume-Uni), « 統計品目番号 » (Japon). Un système sémantique reconnaît qu'il s'agit de la même entité. Un système basé sur des modèles les considère comme non liés — nécessitant un modèle distinct pour chaque convention de libellé.
2. Intégration des documents justificatifs. Les déclarations en douane ne sont pas autonomes. Elles sont assemblées à partir de données réparties entre factures commerciales, listes de colisage, connaissements, certificats d'origine et déclarations des fournisseurs. Dans un flux de travail traditionnel, une personne lit chaque document et saisit les valeurs dans le formulaire de déclaration. Avec l'extraction sémantique, vous pouvez téléverser en lot l'ensemble des documents — factures commerciales de cinq fournisseurs, listes de colisage et connaissements — et extraire tous les champs pertinents pour la déclaration dans un tableau unique. La sortie correspond directement aux champs à renseigner, quel que soit le document source ayant fourni chaque donnée.
3. Tolérance aux documents manuscrits et numérisés. Les courtiers en douane reçoivent fréquemment des factures commerciales manuscrites de petits fournisseurs étrangers, des connaissements numérisés avec tampons et annotations, et des certificats d'origine transmis par fax puis re-numérisés. L'OCR traditionnel échoue sur tout document non généré par machine. L'extraction sémantique basée sur l'IA visuelle (grands modèles multimodaux qui traitent les images en tant qu'images plutôt qu'en les convertissant d'abord en texte) lit les valeurs manuscrites, déchiffre les tampons superposés au texte et gère les artefacts de numérisations multiples — le type de documents qui arrivent chaque jour dans la boîte de réception d'un courtier.
Les fichiers sont traités de manière sécurisée et ne sont pas stockés.
Essayez de saisir les champs nécessaires à une déclaration en douane — une description de marchandise, une valeur déclarée, un pays d'origine — et observez comment l'IA localise chacun d'eux, quel que soit son emplacement sur le document. Le même mécanisme qui extrait les données de facture d'une mise en page donnée extrait les champs pertinents pour la douane de tout type de document, sans configuration par document.
Un flux de travail pratique pour l'extraction de données douanières
Passer de la saisie manuelle à l'extraction sémantique ne nécessite pas de remplacer votre système de déclaration en douane. Cela remplace l'étape de saisie des données qui l'alimente. Voici comment un importateur traitant 50 envois par mois sur trois axes commerciaux pourrait restructurer son flux de travail :
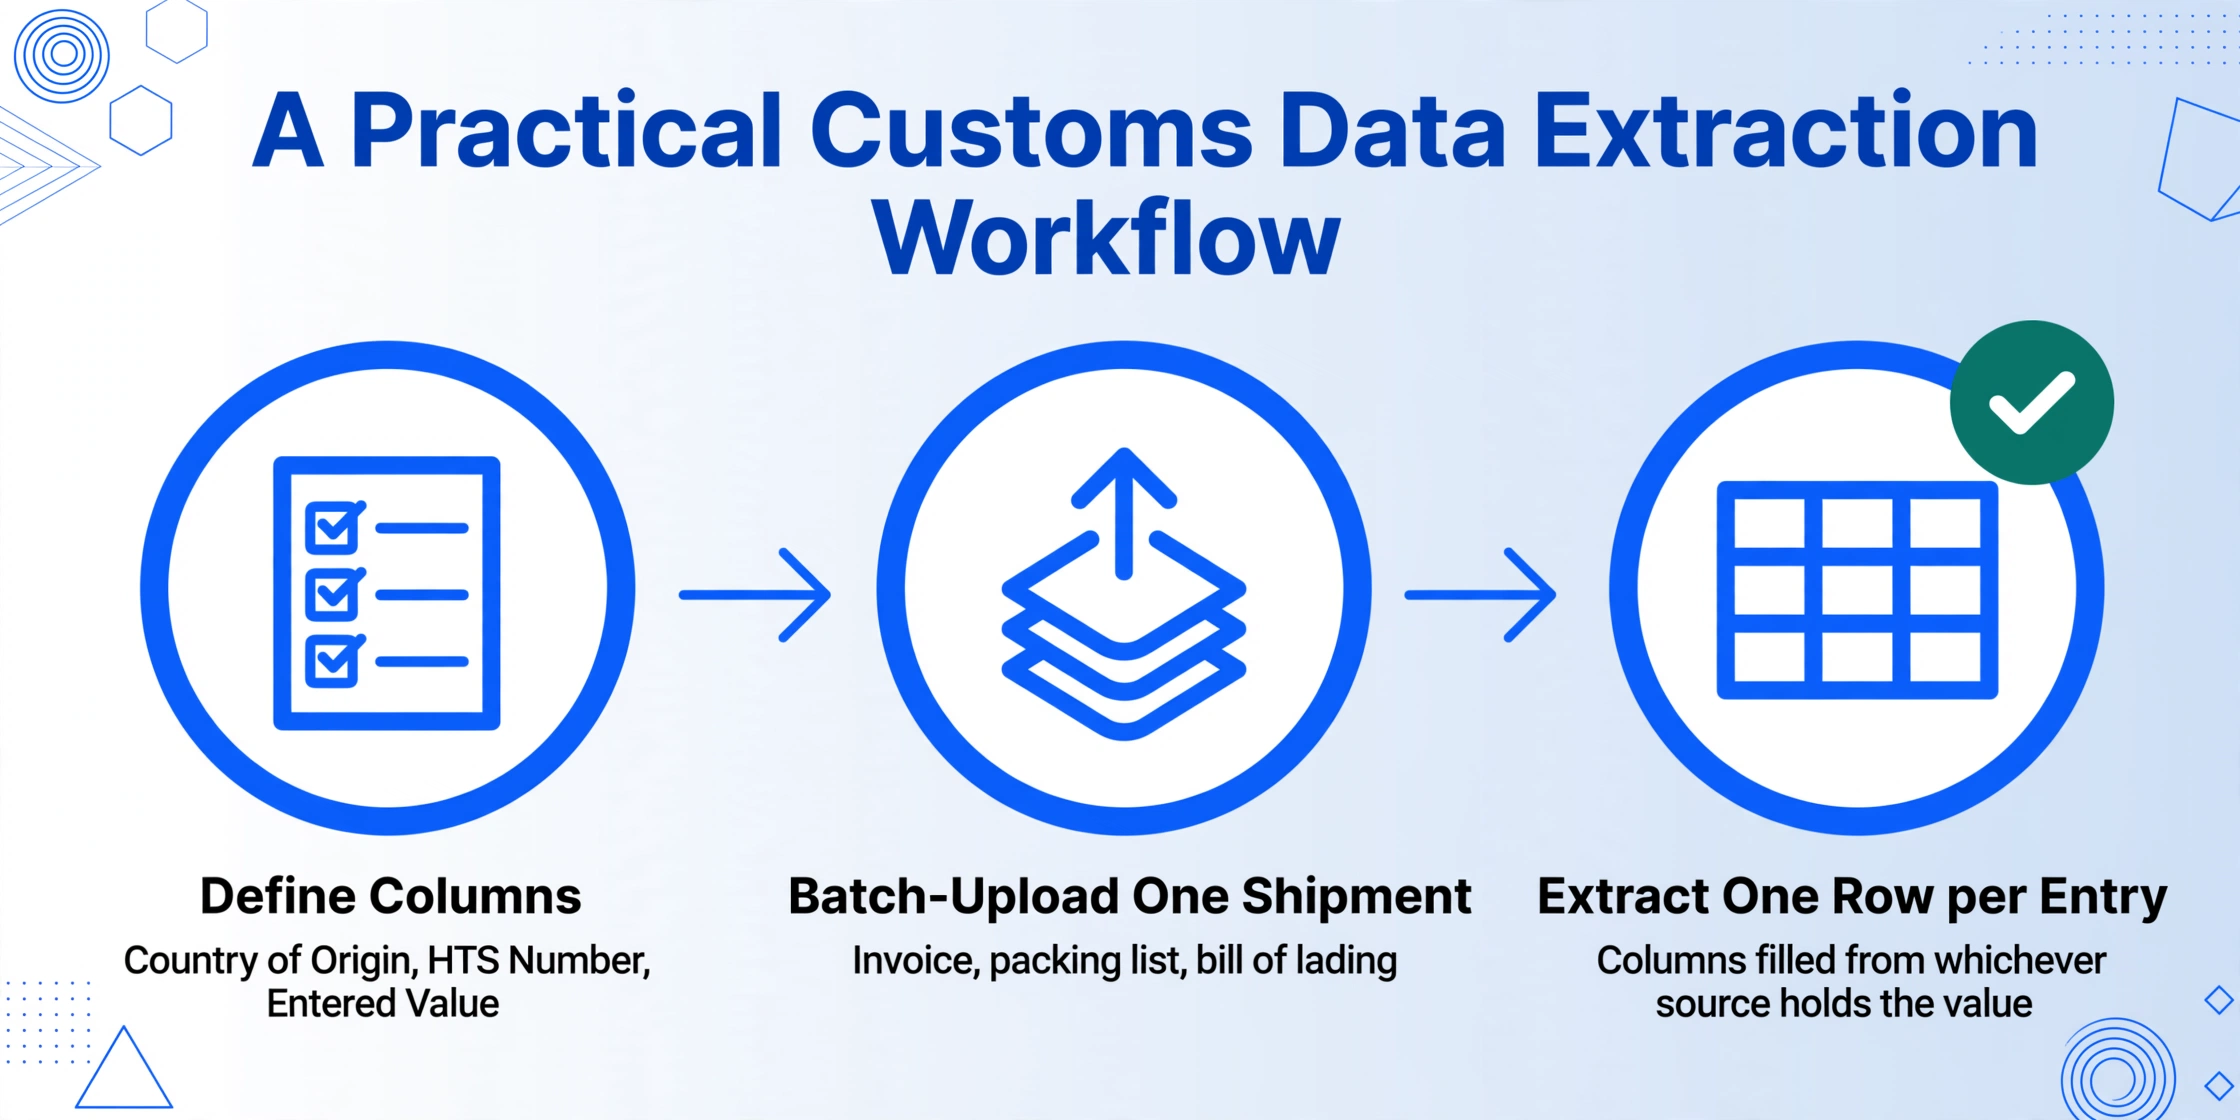
Identifiez les champs de déclaration dont vous avez besoin. Pour les entrées américaines via le formulaire 7501 du CBP, les champs extractibles essentiels incluent : numéro d'entrée, importateur de référence, pays d'origine, code HS (10 chiffres), description des marchandises, valeur déclarée, quantité, code portuaire et mode de transport. Pour les déclarants SAD de l'UE : code marchandise, pays d'origine (case 16), destinataire (case 8), valeur déclarée, masse nette et code de procédure (case 37). Définissez ces champs une fois comme vos colonnes d'extraction.
Téléversez par lot le jeu de documents justificatifs pour chaque envoi. Pour une seule entrée en douane, cela comprend généralement : la facture commerciale, la liste de colisage, le connaissement ou la lettre de transport aérien, le certificat d'origine et toute déclaration du fournisseur. Téléversez-les ensemble dans un seul lot — le moteur d'extraction les traitera comme un seul jeu de documents et remplira les champs des colonnes à partir de la source contenant chaque valeur.
Exécutez l'extraction sur le lot. L'IA lit chaque document, localise les données correspondant à vos définitions de colonnes et remplit un tableau unifié. Une ligne par entrée, avec des colonnes pour chaque champ de déclaration. Les valeurs manuscrites sur la liste de colisage, les codes HS imprimés par machine sur la facture commerciale et les déclarations d'origine tamponnées sur le certificat — tout est extrait dans la même sortie structurée.
Validez par rapport au formulaire de déclaration. Avant de déposer, comparez les données extraites à vos valeurs de déclaration prévues. Le format tableau rend les écarts visibles d'un coup d'œil — un chiffre de code HS transposé, une déclaration d'origine manquante, une divergence de valeur entre la facture et la liste de colisage. Corrigez les exceptions, pas chaque champ.
Déposez via votre système existant. Que vous utilisiez ACE (États-Unis), CDS (Royaume-Uni) ou le portail d'un courtier en douane, les données validées circulent dans le système de dépôt sans ressaisie. L'étape d'extraction gère la conversion document-données. Le dépôt se poursuit avec des données déjà recoupées par rapport aux documents sources.
Pour les courtiers ou importateurs qui déposent via Google Sheets comme intermédiaire — une pratique courante chez les petites entreprises qui préparent les données de déclaration dans des feuilles de calcul avant de les soumettre — le module complémentaire Google Sheets élimine entièrement l'étape de téléversement puis de téléchargement. Les résultats d'extraction arrivent directement dans la feuille de calcul où les données de déclaration sont compilées.
Pour les entreprises qui collectent des documents auprès de plusieurs fournisseurs ou clients, un lien de collecte permet aux parties externes de téléverser leurs factures et certificats directement dans une file de traitement — aucune connexion requise côté fournisseur, aucun e-mail avec pièce jointe à relancer. Les documents arrivent pré-organisés par source, prêts pour l'extraction par lots vers les champs de déclaration.
La trajectoire réglementaire : pourquoi cela devient plus complexe à partir d'ici
L'argument en faveur de l'automatisation de l'extraction des données douanières ne concerne pas seulement la charge de travail actuelle. Il s'agit de la direction que prend la réglementation en matière de conformité commerciale.
Le commerce mondial a atteint un record de 33 000 milliards de dollars en 2024, selon le Global Trade Update de la CNUCED — une augmentation de 3,7 % par rapport à 2023. Le volume de déclarations en douane déposées dans le monde augmente en parallèle, avec une croissance de 4 % en glissement annuel du commerce des économies en développement. Plus de commerce signifie plus de déclarations. Plus de déclarations signifie plus de données à extraire, à transcrire et à vérifier.
Parallèlement, la densité des données par déclaration augmente. Les exigences de déclaration carbone du MECAC de l'UE ajoutent des champs de données d'émissions à chaque SAD pour les marchandises couvertes. L'expansion de la section 232 des États-Unis ajoute quatre champs par entrée d'acier ou d'aluminium — des champs qui exigent des données de traçabilité souvent absentes des factures commerciales standard. Le système de contrôle des importations 2 (ICS2) de l'UE impose désormais des informations préalables sur le fret pour tous les modes de transport, pas seulement aérien et maritime. Chaque mise à jour réglementaire augmente le nombre de points de données extractibles indépendamment par déclaration — et donc le nombre de points de défaillance potentiels de transcription.
Le cadre de normes SAFE de l'Organisation mondiale des douanes continue de promouvoir les programmes d'opérateur économique agréé (OEA) qui récompensent l'historique de conformité par un dédouanement accéléré — mais augmentent aussi le contrôle sur l'exactitude des données. Un importateur certifié OEA qui dépose des déclarations cohérentes et exactes fait circuler ses marchandises plus rapidement. Un importateur avec un historique de corrections et d'amendements fait face à des files d'inspection de plus en plus longues. La piste de données de conformité s'accumule.
Les importateurs qui automatisent l'extraction des données documentaires maintenant n'économisent pas seulement des coûts de main-d'œuvre. Ils construisent une infrastructure de données de conformité qui s'accumule — chaque entrée exacte renforce le profil de conformité qui détermine la rapidité avec laquelle les expéditions futures seront dédouanées.
Questions fréquentes
L'IA peut-elle extraire des données des formulaires CBP 7501 et des déclarations SAD de l'UE ?
Oui. L'extraction sémantique par IA lit les deux types de formulaires — ainsi que leurs documents justificatifs (factures commerciales, listes de colisage, connaissements) — et remplit les champs de déclaration, quelle que soit la mise en page. La différence clé est qu'elle fonctionne en comprenant la signification d'un champ (ex. « Pays d'origine ») plutôt que son emplacement sur la page. Ainsi, la même définition de colonne fonctionne pour le bloc 11 du CBP 7501, la case 16 du SAD et toute facture fournisseur mentionnant l'origine.
Qu'en est-il des factures commerciales manuscrites de fournisseurs étrangers ?
Les modèles d'IA visuelle qui traitent directement les images de documents (plutôt que de les convertir d'abord en texte) peuvent lire les valeurs manuscrites, les tampons et les scans de plusieurs générations. La précision sur une écriture claire est comparable à celle du texte imprimé. Les documents très dégradés — multiples générations de fax, dégâts des eaux, écriture cursive extrême — auront une précision moindre. Dans ces cas, l'extraction peut signaler les champs à faible confiance pour une vérification humaine, plutôt que de renvoyer silencieusement des valeurs erronées.
Ai-je encore besoin d'un courtier en douane si j'automatise l'extraction de données ?
Oui. L'extraction de données gère l'étape de conversion document-données. Un courtier en douane agréé fournit une expertise en classification, un jugement réglementaire, une stratégie de conformité et l'autorité légale pour déposer les déclarations auprès du CBP. L'automatisation réduit la charge de travail de transcription manuelle — elle ne remplace pas le jugement professionnel nécessaire pour classer correctement les marchandises, appliquer les programmes de préférences commerciales ou gérer les actions coercitives. En vertu du 19 CFR 111, l'obligation de diligence raisonnable du courtier demeure, quel que soit l'outil utilisé pour extraire les données.
Comment cela gère-t-il la classification des codes SH/SHUSA ?
Les outils d'extraction récupèrent le code SH des documents sources — ils extraient ce qui est écrit, pas ce que devrait être la classification correcte. Si la facture d'un fournisseur indique un code SH incorrect, l'extraction rapporte fidèlement ce code. La classification — déterminer le code SHUSA à 10 chiffres correct en fonction des caractéristiques du produit, de la composition des matériaux et de l'utilisation prévue — reste une tâche de jugement professionnel. L'étape d'extraction élimine l'erreur de transcription (taper 8471.30 au lieu de 8471.80) mais ne remplace pas l'étape de classification. Certains importateurs utilisent le résultat de l'extraction comme recoupement : le code indiqué par le fournisseur versus le code classifié par le courtier, présentés côte à côte pour un examen des écarts avant le dépôt.
Qu'en est-il des documents en caractères non latins — factures fournisseurs en chinois, japonais, arabe ?
Les modèles d'IA de vision modernes sont multilingues — ils peuvent lire et extraire des données de documents en chinois, japonais, coréen, arabe et autres écritures non latines. Les valeurs extraites peuvent être translittérées ou conservées dans leur écriture d'origine selon les exigences de l'autorité douanière de destination. Pour les déclarations d'importation japonaises (輸入申告書), le système peut extraire les valeurs en kanji ainsi que les codes de marchandises et les valeurs déclarées.
Cela s'intègre-t-il avec ACE / CDS / les systèmes de déclaration en douane ?
ImageToTable.ai exporte les données extraites au format Excel (XLSX), CSV ou JSON — des formats importables dans les plateformes de déclaration en douane, les ERP ou les workflows de préparation sur tableur. Il ne dépose pas directement les déclarations auprès du CBP ou des autorités douanières de l'UE. Les données alimentent votre processus de déclaration existant. Pour les utilisateurs de Google Sheets, le module complémentaire écrit les données extraites directement dans la feuille active, sans étapes d'export/import.