O Problema dos Dados de Declaração Aduaneira
Que o OCR com Modelo Nunca Resolveu
Um importador de eletrônicos de médio porte em Chicago registrou 47 entradas no Formulário 7501 do CBP em março de 2025. Uma entrada tinha um dígito transposto no código HTS — 8471.30 em vez de 8471.80. A discrepância acionou um alerta automático da CBP, que evoluiu para uma Avaliação Focada. Em setembro, os auditores da CBP estavam revisando todas as entradas que a empresa havia registrado nos três anos anteriores. O erro original levou 4 segundos para ser digitado. A auditoria consumiu 4 meses do tempo da equipe de conformidade. Este — não a entrada lenta de dados — é o custo real do processamento manual de declarações aduaneiras.
Um Erro de Digitação de Quatro Segundos, uma Auditoria de Quatro Meses
A Organização Mundial do Comércio contabiliza mais de 50.000 alterações de alíquotas tarifárias por ano em suas 164 economias-membro. Um único código SH pode diferir em um dígito entre uma classificação isenta de imposto e uma tarifa de 25% — e cada classificação incorreta acarreta uma consequência financeira que se acumula retroativamente no tempo. A Alfândega e Proteção de Fronteiras dos EUA pode revisar declarações de importação retroativamente por até três anos, conforme o 19 U.S.C. 1484. As autoridades aduaneiras da UE, sob o Código Aduaneiro da União (Regulamento (UE) 952/2013), mantêm poderes retrospectivos semelhantes. Um erro de entrada de dados cometido hoje não custa apenas a taxa de correção — ele abre uma janela para todas as declarações que você protocolou ontem.
No entanto, a logística para obter esses dados corretos permanece teimosamente manual. Um importador que recebe mercadorias de cinco fornecedores em três países lida com o Formulário 7501 da CBP (mais de 45 campos em 43 blocos), o Documento Administrativo Único da UE (54 caixas), faturas comerciais em cinco formatos diferentes de cinco fornecedores diferentes, listas de embalagem com nomes de campos variados e conhecimentos de embarque que podem ou não estar alinhados com os valores declarados. Cada um desses documentos alimenta dados na declaração aduaneira — e cada um é um ponto potencial de falha de transcrição.
De acordo com o International Journal of Research Publication and Reviews, mais de 30% dos atrasos de embarque no Sudeste Asiático decorrem de documentação aduaneira incompleta ou incorreta. Um estudo da Vizion de 2025 descobriu que 32% dos atrasos alfandegários são causados especificamente por erros ou informações ausentes em faturas aduaneiras. Estes não são problemas de velocidade de processamento. São problemas de integridade de dados entre formatos de documentos que nunca foram projetados para interoperar.
A entrada manual de dados aduaneiros tem uma taxa de erro de 1–4% por campo. Um formulário CBP 7501 típico contém de 15 a 25 valores transcritos de forma independente. No limite inferior dessa faixa, uma em cada quatro declarações contém pelo menos um dado incorreto — qualquer um dos quais pode desencadear uma revisão de conformidade que abrange anos.
Por que as declarações aduaneiras quebram o OCR baseado em modelo
O OCR baseado em modelo — a tecnologia por trás da maioria das ferramentas de extração de documentos do mercado — funciona mapeando posições fixas em uma página para campos de dados. Você define uma zona para "Importador Registrado" no Formulário 7501 do CBP, e todo formulário subsequente alimenta o conteúdo dessa zona na mesma coluna. O problema é que essa abordagem depende de um único layout de documento imutável. Declarações aduaneiras são o oposto de imutáveis.
Considere um importador registrando entradas em três jurisdições. O Formulário 7501 do CBP coloca o Número da Entrada no Bloco 1, o Importador Registrado no Bloco 12 e o País de Origem no Bloco 11 — cada um como um campo numerado em um formulário governamental de múltiplos blocos. O DUA da UE coloca o declarante na Caixa 14, o País de Origem na Caixa 16 e os códigos de mercadoria na Caixa 33, com unidades suplementares na Caixa 41. A variante C88 do Reino Unido reorganiza esses campos novamente. A declaração de importação do Japão (輸入申告書) usa um layout totalmente diferente. Um modelo configurado para o 7501 lê dados sem sentido quando apontado para um DUA — as coordenadas não são transferíveis.
Mas o maior ponto de falha não é o formulário aduaneiro em si. São os documentos de apoio que alimentam os dados nele. A fatura comercial do Fornecedor A em Shenzhen lista códigos HS na Coluna 4 com valores FOB Shenzhen. O Fornecedor B em Stuttgart coloca os códigos de mercadoria em um bloco lateral e cotiza preços EXW. O Fornecedor C em Monterrey envia uma fatura manuscrita com abreviações e nenhum código HS. Um despachante aduaneiro no r/CustomsBroker do Reddit capturou a realidade: "Nossos arquivos são armazenados em papel, mas os documentos também são anexados à entrada em nosso sistema. Recebemos todos por e-mail." Os documentos chegam como PDFs, digitalizações, fotos e capturas de tela — e então alguém digita os dados de cada um no sistema de declaração.
Este é o problema estrutural que o OCR baseado em modelo não consegue resolver: quando cada parceiro comercial formata documentos de maneira diferente, você precisa de um sistema que leia pelo significado, não pela posição. Um campo chamado "Código HS" em uma fatura e "Classificação Tarifária" em outra é a mesma entidade semântica — mas uma ferramenta baseada em modelo as vê como zonas não relacionadas em documentos não relacionados.
A Cascada de Conformidade: O Que Um Dígito Errado Realmente Custa
É fácil tratar os erros aduaneros como meras molestias administrativas — uma taxa de correção aqui, um atraso de dois dias ali. A realidade é uma cadeia de consequências crescentes que a maioria dos importadores não mapea até que a desencadena.
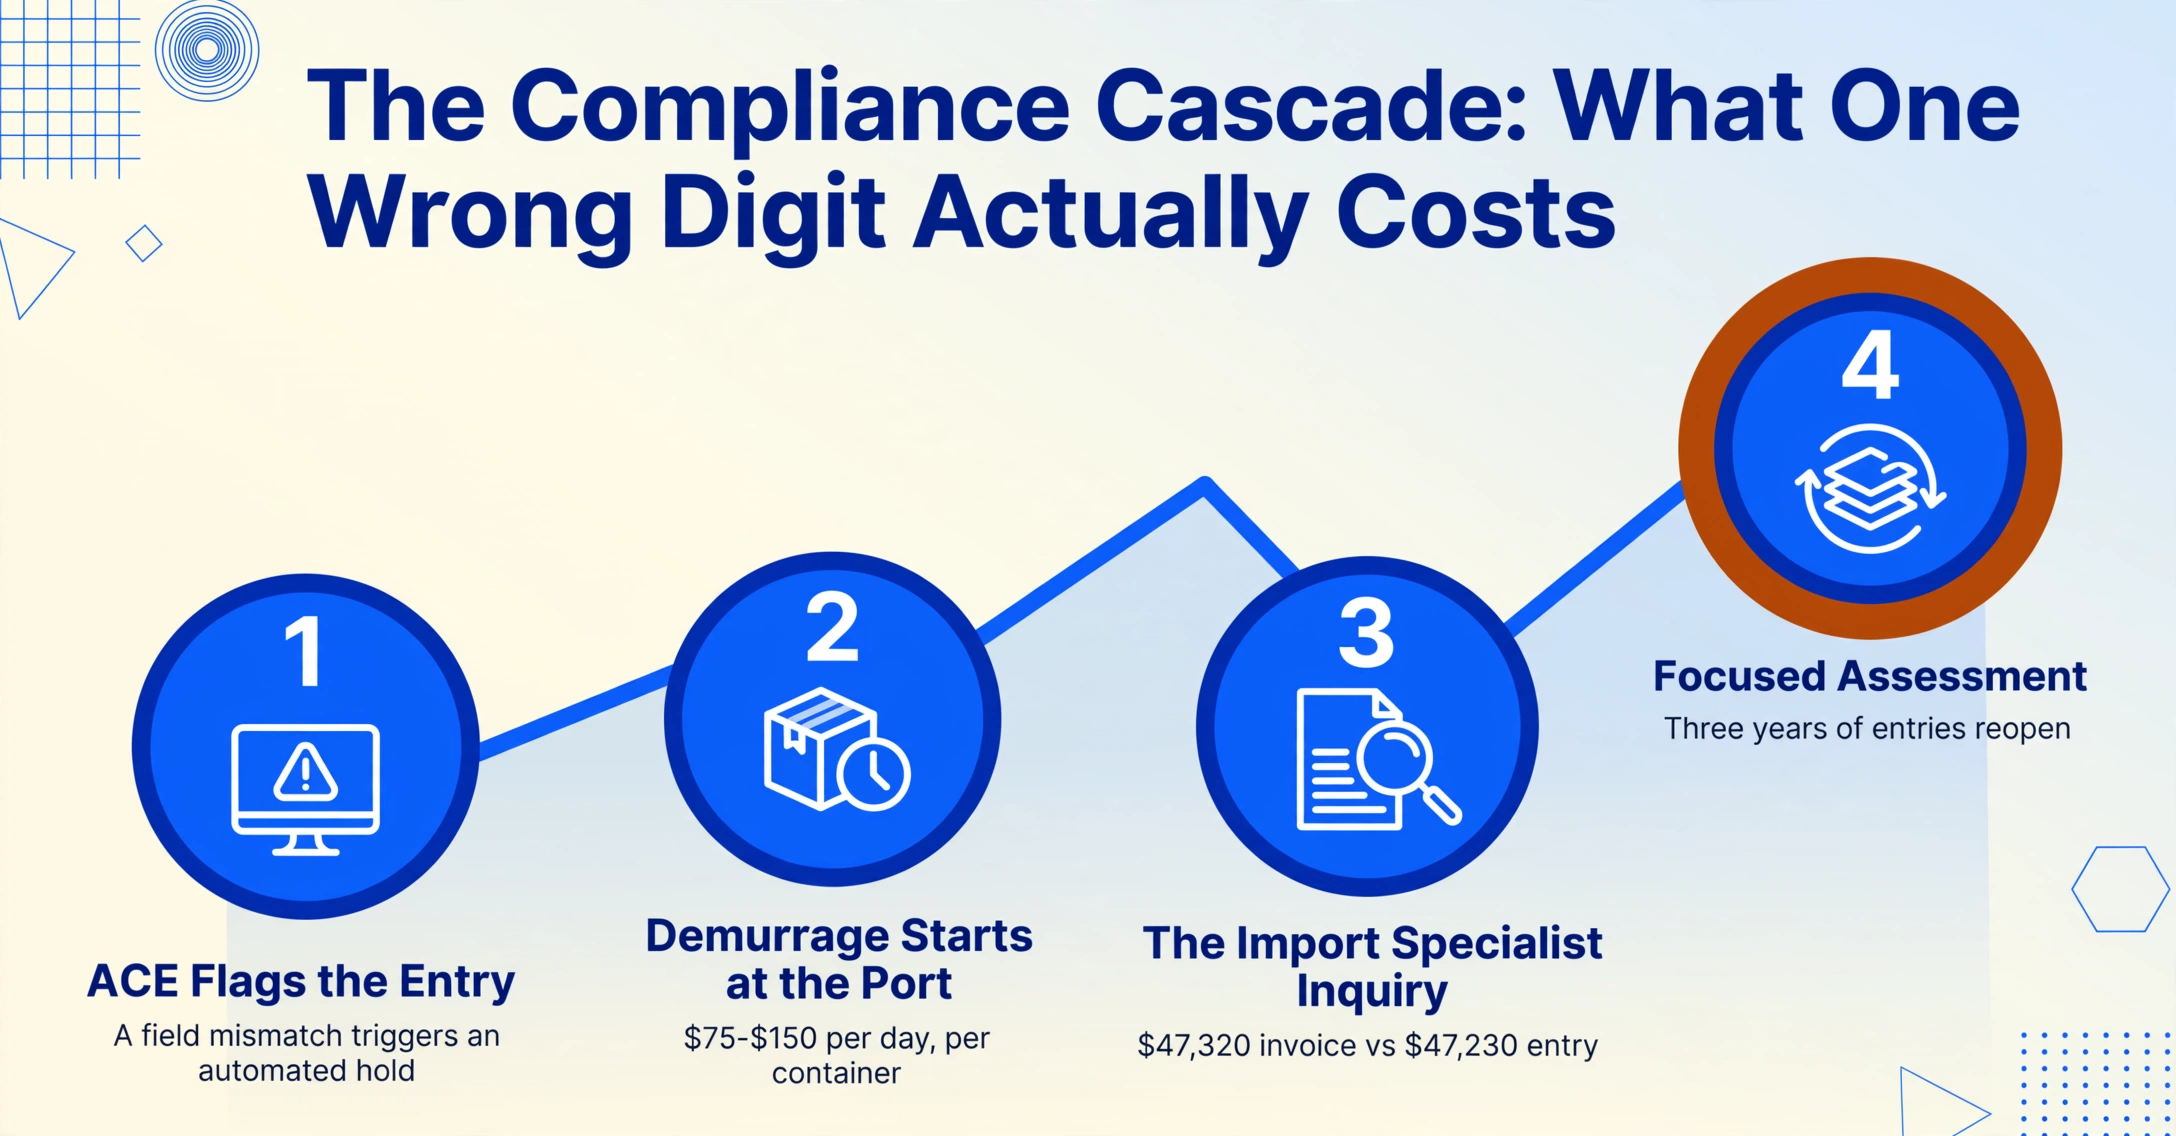
O primeiro dominó: a sinalização automatizada. O Ambiente Comercial Automatizado da CBP executa verificações algorítmicas em cada entrada eletrónica. Inconsistencias a nível de campo — um valor declarado que se desvía das normas estatísticas para esse código HTS, um país de origem que não coincide com a rota típica da cadeia de suministro para essa mercancía — desencadenan retenciones automatizadas. O envio deixa de se mover. As cargas por sobrestadía começam a se acumular no porto, tipicamente US$ 75–US$ 150 por dia por contenedor nos portos dos EUA segundo as tarifas das navieras, com a detenção adicionando outra capa de tarifas diárias uma vez que o contenedor sai do terminal.
O segundo dominó: a consulta. Um Especialista em Importações da CBP revisa a entrada sinalizada e solicita documentação ao importador ou ao agente aduanero. É aqui que os erros de transcrição afloram. Uma factura comercial mostra US$ 47.320 FOB, mas o Formulário 7501 foi digitado como US$ 47.230. Um código HTS de 10 dígitos que devería ler 8471.80.0100 lee 8471.30.0100 — uma subpartida diferente com uma taxa de direito diferente. A CBP não distingue entre um erro de digitação e uma tentativa de declarar incorretamente. A discrepância em si é o problema de conformidade.
O terceiro dominó: a Avaliação Enfocada. Se aparecen discrepâncias em múltiples entradas — ou se uma única discrepância é suficientemente material — a CBP pode escalar a uma Avaliação Enfocada (FA) sob seu programa de Auditoría Reguladora. Uma FA não é uma revisión rápida de documentos. É uma auditoría de escopo completo da conformidade aduanera do importador, que abarca classificação, valoración, país de origem, reclamaciones de programas comerciales preferenciales e mantenimiento de registros. Os auditores da CBP podem examinar entradas que remontam três anos atrás. O importador suporta a carga da prova — 19 CFR 162.1a exige que os importadores "establezcan la corrección de la información que debe mostrarse en los documentos de entrada". Se você não pode provar que seu valor declarado era correto porque a factura comercial original era uma digitalização em PDF com dígitos ambíguos, você perde.
O quarto dominó: a penalidade. Em 2024, a aplicação do comércio dos EUA alcanzó novos máximos. O Bureau of Industry and Security (BIS) apresentó 26 casos penales e agregó más de 340 entidades a las listas de partes restringidas. Las penalidades administrativas por violaciones comerciales alcanzaron un máximo de US$ 364.992 por violación o el doble del valor de la transacción — lo que sea mayor — según los programas de penalidades actualizados de 2024. Las penalidades penales se extienden a 20 años de prisión y US$ 1 millón por violación. El Departamento de Justicia emitió aproximadamente un tercio más de penalidades relacionadas con FCPA y sanciones en 2024 en comparación con 2023, incluida una multa de US$ 364 millones contra una empresa aeroespacial y de defensa por violaciones de FCPA y controles de exportación.
La negligencia no es una defensa. Bajo 19 CFR 111, los agentes aduaneros deben ejercer "diligencia debida" al preparar las declaraciones. Si un importador proporciona datos incorrectos y el agente los presenta sin verificación, ambas partes comparten la responsabilidad. La licencia del agente está en riesgo. La fianza del importador está en riesgo. El error de entrada de datos se convierte en una falla de cumplimiento de múltiples partes.
Em 2025, a carga de conformidade está crescendo, não diminuindo. O formulário 7501 atualizado da CBP — publicado em 8 de julho de 2025 — adicionou quatro novos campos obrigatórios para importações de aço e alumínio sob a Seção 232: País de Fusão e Vazamento, País Primário de Fundição, País Secundário de Fundição e País de Fusão e Fundição de Alumínio. Esses campos exigem dados de rastreabilidade que muitas vezes não constam em uma fatura comercial padrão, forçando os importadores a solicitar documentação adicional dos fornecedores e transcrevê-la em ainda mais campos de declaração.
Enquanto isso, as atualizações de 2025 do SAD da UE sob o Mecanismo de Ajuste de Carbono na Fronteira (CBAM — Regulamento (UE) 2023/956) exigem dados de emissão de carbono por modo de transporte. A Diretiva de Due Diligence de Sustentabilidade Corporativa (CSDDD) exige declarações de ausência de minerais de conflito ou trabalho forçado na produção. Cada novo campo regulatório é mais um dado que deve ser extraído de um documento do fornecedor, transcrito corretamente e arquivado dentro do prazo. A área de superfície para um erro de conformidade se expande a cada atualização regulatória.
Extração Semântica vs. Extração por Posição: Por Que Isso Importa para a Alfândega
A limitação central do OCR baseado em template no processamento aduaneiro não é técnica — é arquitetural. A extração baseada em posição assume uma relação estável entre a localização física de um campo na página e seu significado. As declarações aduaneiras, por sua natureza, violam essa premissa em todos os níveis.
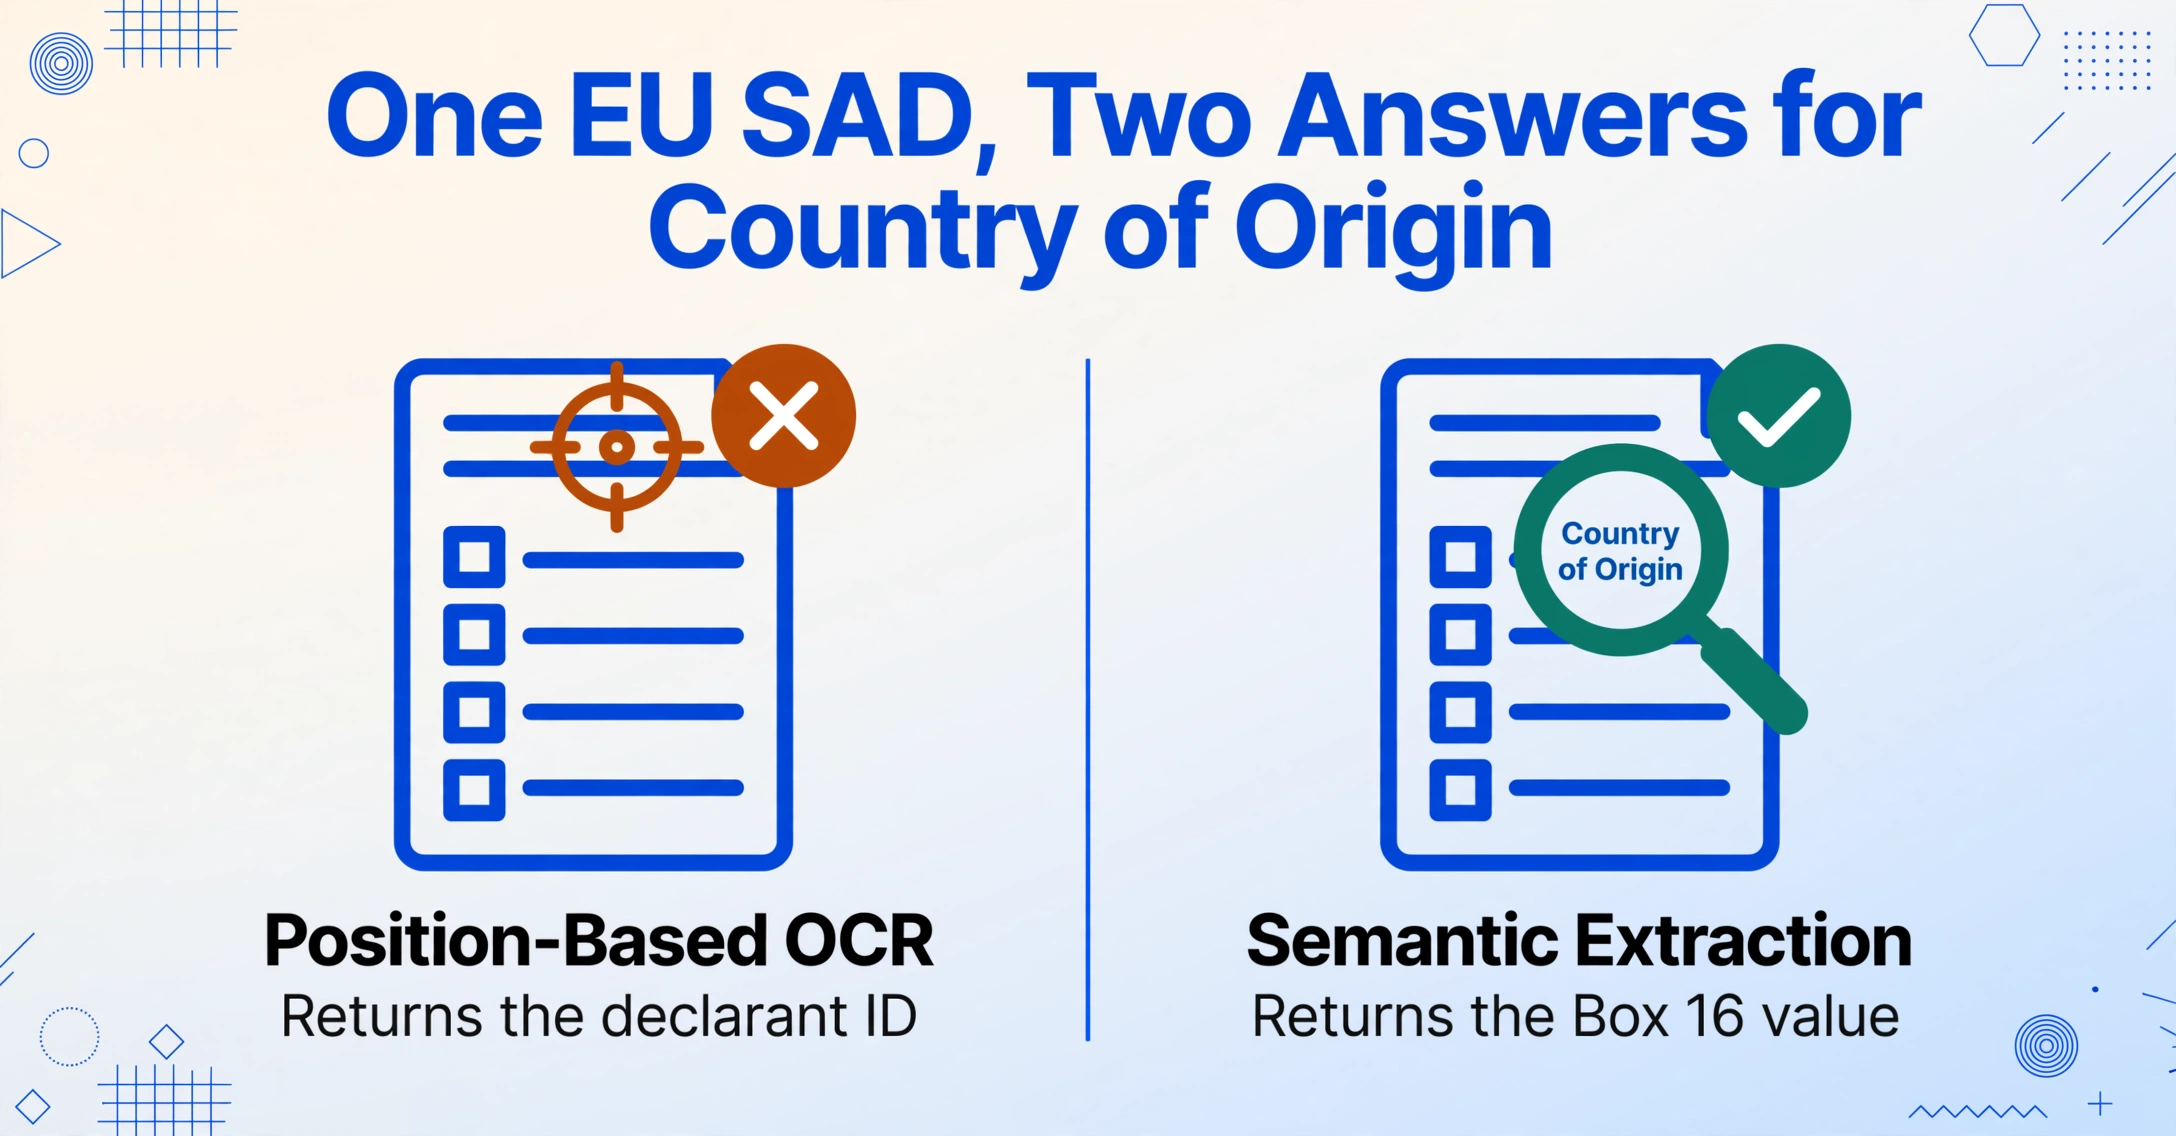
Uma ferramenta baseada em posição treinada no Formulário 7501 da CBP aprende que o País de Origem está no Bloco 11 — aproximadamente um terço abaixo da página na coluna esquerda. Quando a mesma ferramenta encontra um SAD, ela procura dados nas mesmas coordenadas e encontra o número de identificação do declarante. A extração está errada, e a ferramenta não tem mecanismo para saber que está errada porque não entende o que "País de Origem" significa — ela só sabe onde ele geralmente fica.
A extração semântica — às vezes chamada de extração baseada em intenção ou sem template — inverte essa relação. Em vez de mapear posições, ela mapeia significado. Você informa ao sistema o que deseja: "País de Origem", "Código SH", "Valor Declarado", "Número do Importador". A IA lê cada documento — seja um CBP 7501, um SAD da UE, uma declaração de importação japonesa ou uma fatura comercial de fornecedor — e localiza os dados que respondem a cada definição de campo, independentemente de onde aparecem na página ou como são rotulados.
Esta é a diferença entre programar uma ferramenta para ler um formato de documento e ensinar uma ferramenta a entender como os dados aduaneiros se parecem em todos os formatos. A primeira abordagem escala com o número de templates de documento que você mantém. A segunda abordagem funciona em qualquer documento que contenha as informações que você procura.
Para declarações aduaneiras especificamente, a extração semântica lida com três desafios estruturais que quebram as ferramentas baseadas em posição:
1. Variação de nome de campo entre documentos. O mesmo dado aparece sob rótulos diferentes entre jurisdições: "HTS Number" (EUA), "Commodity Code" (UE), "HS Code" (linguagem da Convenção da OMA), "Tariff Code" (Reino Unido), "統計品目番号" (Japão). Um sistema semântico reconhece estes como a mesma entidade. Um sistema de template os vê como não relacionados — exigindo um template separado para cada convenção de rotulagem.
2. Integração de documentos de apoio. As declarações aduaneiras não existem isoladamente. Elas são montadas a partir de dados distribuídos entre faturas comerciais, listas de embalagem, conhecimentos de embarque, certificados de origem e declarações de fornecedores. Em um fluxo de trabalho tradicional, alguém lê cada documento e digita os valores no formulário de declaração. Com a extração semântica, você pode enviar em lote o conjunto completo de documentos — faturas comerciais de cinco fornecedores, listas de embalagem e conhecimentos de embarque — e extrair todos os campos relevantes para a declaração em uma única tabela. A saída é mapeada diretamente para os campos necessários para o registro, independentemente de qual documento de origem continha cada dado.
3. Tolerância a documentos manuscritos e digitalizados. Despachantes aduaneiros recebem com frequência faturas comerciais manuscritas de fornecedores menores no exterior, conhecimentos de embarque digitalizados com carimbos e anotações, e certificados de origem que foram enviados por fax e re-digitalizados. O OCR tradicional tem dificuldade com qualquer documento que não tenha sido gerado por máquina. A extração semântica com IA de visão (modelos multimodais grandes que processam imagens como imagens, em vez de convertê-las em texto primeiro) lê valores manuscritos, decifra carimbos sobrepostos ao texto e lida com artefatos de múltiplas gerações de digitalização — o tipo de documento que chega à caixa de entrada de um despachante todos os dias.
Os arquivos são processados com segurança e não são armazenados.
Experimente inserir os campos necessários para uma declaração aduaneira — uma descrição da mercadoria, um valor declarado, um país de origem — e veja como a IA localiza cada um deles, independentemente de onde estejam no documento. O mesmo mecanismo que extrai dados de fatura de um layout extrai campos relevantes para a alfândega de qualquer tipo de documento, sem configuração por documento.
Um Fluxo de Trabalho Prático para Extração de Dados Aduaneiros
Migrar da transcrição manual para a extração semântica não exige substituir seu sistema de registro de declarações aduaneiras. Ela substitui a etapa de entrada de dados que alimenta esse sistema. Veja como um importador que processa 50 embarques por mês em três rotas comerciais poderia reestruturar o fluxo de trabalho:
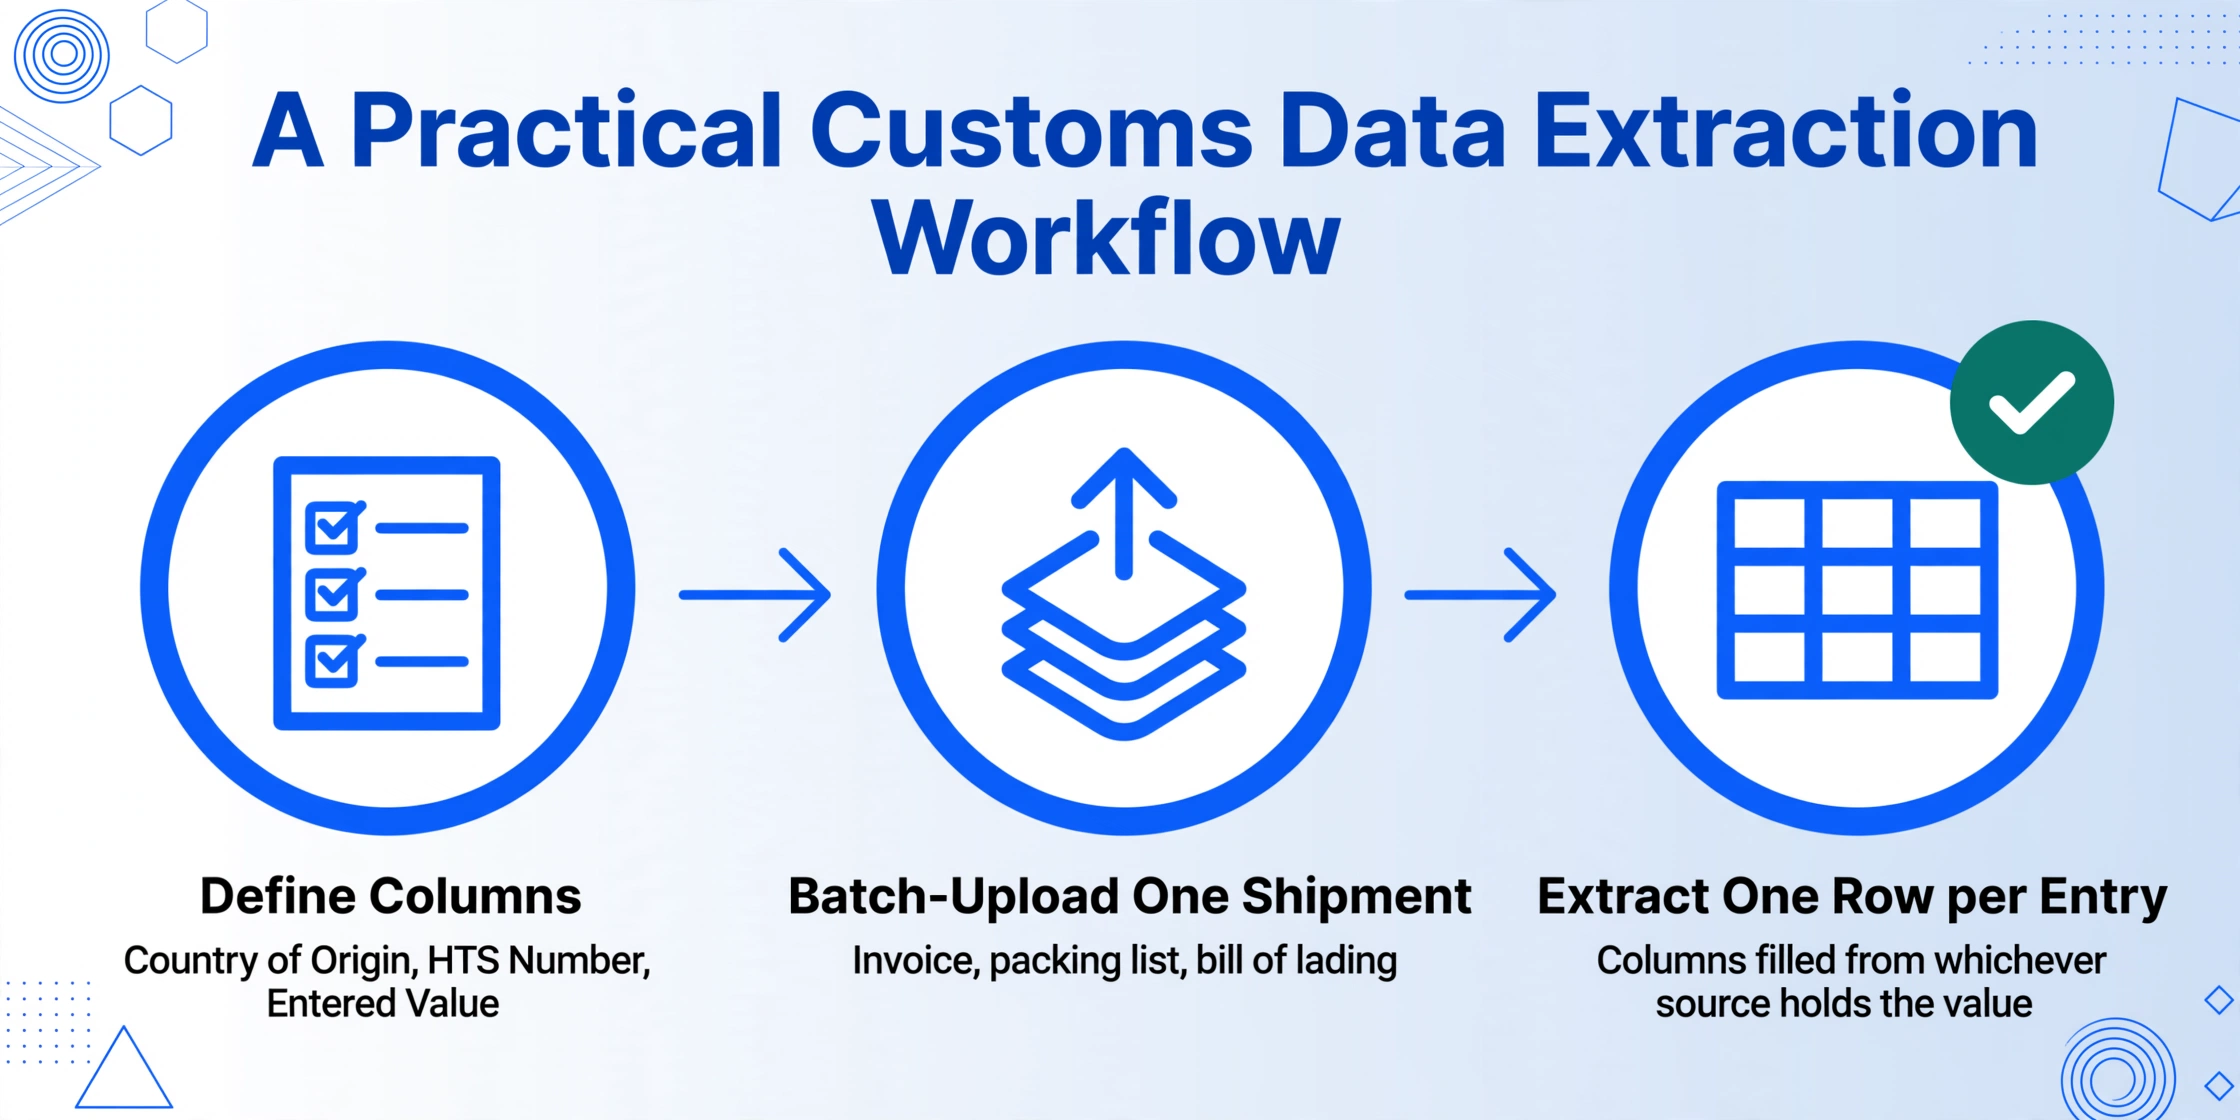
Identifique os campos da declaração que você precisa. Para entradas nos EUA via Formulário 7501 do CBP, os campos essenciais extraíveis incluem: Número da Declaração, Importador de Registro, País de Origem, código HTS (10 dígitos), Descrição da Mercadoria, Valor Declarado, Quantidade, Código do Porto e Modal de Transporte. Para declarantes da DUA na UE: Código da Mercadoria, País de Origem (Caixa 16), Consignatário (Caixa 8), Valor Declarado, Massa Líquida e Código do Procedimento (Caixa 37). Defina esses campos uma única vez como suas colunas de extração.
Envie em lote o conjunto de documentos de suporte para cada embarque. Para uma única declaração aduaneira, isso normalmente inclui: a fatura comercial, o romaneio, o conhecimento de embarque ou conhecimento aéreo, o certificado de origem e quaisquer declarações do fornecedor. Envie-os juntos em um único lote — o mecanismo de extração os tratará como um único conjunto de documentos e preencherá os campos das colunas a partir da fonte que contiver cada valor.
Execute a extração no lote. A IA lê cada documento, localiza os dados que correspondem às suas definições de coluna e preenche uma tabela unificada. Uma linha por declaração, com colunas para cada campo da declaração. Valores manuscritos no romaneio, códigos HS impressos por máquina na fatura comercial e declarações de origem carimbadas no certificado — tudo extraído para a mesma saída estruturada.
Valide os dados em relação ao formulário de declaração. Antes de registrar, compare os dados extraídos com os valores pretendidos da sua declaração. O formato de tabela torna as discrepâncias visíveis rapidamente — um dígito de código HS transposto, uma declaração de origem ausente, uma divergência de valor entre a fatura e o romaneio. Corrija as exceções, não todos os campos.
Registre por meio do seu sistema existente. Se você usa o ACE (EUA), o CDS (Reino Unido) ou o portal de um despachante aduaneiro, os dados validados fluem para o sistema de registro sem redigitação. A etapa de extração cuida da conversão de documento para dados. O registro prossegue com dados que já foram verificados em relação aos documentos de origem.
Para corretores ou importadores que usam o Google Sheets como intermediário — um padrão comum entre empresas menores que preparam dados de declaração em planilhas antes de enviar — o complemento do Google Sheets elimina totalmente a etapa de upload e download. Os resultados da extração chegam diretamente na planilha onde os dados da declaração são compilados.
Para empresas que coletam documentos de vários fornecedores ou clientes, um link de coleta permite que partes externas enviem suas faturas e certificados diretamente para uma fila de processamento — sem necessidade de login do lado do fornecedor, sem e-mails com anexos para perseguir. Os documentos chegam pré-organizados por origem, prontos para extração em lote nos campos da declaração.
A Trajetória Regulatória: Por Que Isso Fica Mais Difícil Daqui em Diante
O argumento para automatizar a extração de dados aduaneiros não é só sobre a carga de trabalho de hoje. É sobre para onde a regulamentação de conformidade comercial está caminhando.
O comércio global atingiu um recorde de US$ 33 trilhões em 2024, segundo o Global Trade Update da UNCTAD — um aumento de 3,7% em relação a 2023. O volume de declarações aduaneiras registradas globalmente está crescendo em paralelo, com o comércio das economias em desenvolvimento crescendo 4% ao ano. Mais comércio significa mais declarações. Mais declarações significam mais pontos de dados para extrair, transcrever e verificar.
Simultaneamente, a densidade de dados por declaração está aumentando. Os requisitos de relatório de carbono do Mecanismo de Ajuste de Carbono na Fronteira da UE adicionam campos de dados de emissão a cada DUA para mercadorias cobertas. A expansão da Seção 232 dos EUA adiciona quatro campos por entrada de aço ou alumínio — campos que exigem dados de rastreabilidade frequentemente ausentes das faturas comerciais padrão. O Sistema de Controle de Importações 2 (ICS2) da UE agora exige informações antecipadas de carga para todos os modos de transporte, não apenas aéreo e marítimo. Cada atualização regulatória aumenta o número de pontos de dados extraíveis de forma independente por declaração — e, portanto, o número de potenciais pontos de falha de transcrição.
O SAFE Framework of Standards da Organização Mundial das Alfândegas continua avançando em direção a programas de Operador Econômico Autorizado (OEA) que recompensam o histórico de conformidade com desembaraço acelerado — mas também aumentam o escrutínio sobre a precisão dos dados. Um importador certificado OEA que registra declarações consistentes e precisas movimenta mercadorias mais rápido. Um importador com histórico de correções e emendas enfrenta filas de inspeção progressivamente mais longas. A trilha de dados de conformidade se acumula.
Os importadores que automatizam a extração de dados de documentos agora não estão apenas economizando custo de mão de obra. Eles estão construindo uma infraestrutura de dados de conformidade que se acumula — cada entrada precisa fortalece o perfil de conformidade que determina a velocidade com que futuros embarques serão desembaraçados.
Perguntas Frequentes
A IA consegue extrair dados do formulário CBP 7501 e das declarações SAD da UE?
Sim. A extração semântica por IA lê ambos os tipos de formulário — e seus documentos de suporte (faturas comerciais, packing lists, conhecimentos de embarque) — e preenche os campos da declaração independentemente do layout do formulário. A principal diferença é que ela funciona entendendo o significado de um campo (ex.: "País de Origem") em vez de sua posição na página, então a mesma definição de coluna funciona no Bloco 11 do CBP 7501, na Caixa 16 do SAD e em qualquer fatura de fornecedor que mencione a origem.
E quanto às faturas comerciais manuscritas de fornecedores internacionais?
Modelos de IA de Visão que processam imagens de documentos diretamente (em vez de converter para texto primeiro) conseguem ler valores manuscritos, carimbos e digitalizações de múltiplas gerações. A precisão em letras legíveis é comparável à de texto impresso por máquina. Documentos muito degradados — múltiplas gerações de fax, danos por água, caligrafia extremamente cursiva — terão menor precisão. Nesses casos, a extração pode sinalizar campos de baixa confiança para revisão humana, em vez de retornar valores incorretos silenciosamente.
Ainda preciso de um despachante aduaneiro se automatizar a extração de dados?
Sim. A extração de dados cuida da etapa de conversão de documento para dados. Um despachante aduaneiro licenciado fornece expertise em classificação, julgamento regulatório, estratégia de conformidade e a autoridade legal para registrar declarações na CBP. A automação reduz a carga de trabalho de transcrição manual — ela não substitui o julgamento profissional necessário para classificar mercadorias corretamente, aplicar programas de preferência comercial ou lidar com ações de fiscalização. De acordo com o 19 CFR 111, a obrigação de diligência do despachante permanece independentemente da ferramenta que extraiu os dados.
Como isso lida com a classificação do código HS/HTS?
As ferramentas de extração obtêm o código HS dos documentos de origem — elas extraem o que está escrito, não qual deveria ser a classificação correta. Se a fatura de um fornecedor listar um código HS incorreto, a extração relata fielmente esse código. A classificação — determinar o código HTS correto de 10 dígitos com base nas características do produto, composição do material e uso pretendido — continua sendo uma tarefa de julgamento profissional. A etapa de extração elimina o erro de transcrição (digitar 8471.30 em vez de 8471.80), mas não substitui a etapa de classificação. Alguns importadores usam a saída da extração como uma verificação cruzada: o código informado pelo fornecedor versus o código classificado pelo despachante, exibidos lado a lado para revisão de discrepâncias antes do registro.
E documentos com caracteres não latinos — faturas de fornecedores em chinês, japonês, árabe?
Modelos modernos de visão por IA são multilíngues — eles leem e extraem dados de documentos em chinês, japonês, coreano, árabe e outros alfabetos não latinos. Os valores extraídos podem ser transliterados ou mantidos no idioma original, conforme exigido pela alfândega de destino. Para declarações de importação japonesas (輸入申告書), o sistema extrai valores em kanji junto com códigos de mercadorias e valores declarados.
Isso se integra com ACE / CDS / sistemas de declaração aduaneira?
O ImageToTable.ai exporta dados extraídos como Excel (XLSX), CSV ou JSON — formatos que podem ser importados para plataformas de declaração aduaneira, sistemas ERP ou planilhas de preparação. Ele não faz declarações diretamente ao CBP ou às autoridades alfandegárias da UE. A saída alimenta seu fluxo de trabalho existente. Para usuários do Google Sheets, o complemento grava os dados extraídos diretamente na planilha ativa, sem etapas de exportação/importação.