The Customs Declaration Data Problem
That Template OCR Never Solved
시카고의 중견 전자제품 수입업체는 2025년 3월에 CBP 양식 7501 47건을 제출했습니다. 한 건에서 HTS 코드의 숫자가 잘못 입력되었습니다 — 8471.80 대신 8471.30. 이 불일치로 CBP 자동 플래그가 발생했고, 이는 집중 평가(Focused Assessment)로 확대되었습니다. 9월까지 CBP 감사관은 해당 업체가 지난 3년간 제출한 모든 건을 검토하고 있었습니다. 원래 오류는 입력하는 데 4초가 걸렸습니다. 감사는 컴플라이언스 팀의 4개월을 소비했습니다. 이것이 — 느린 데이터 입력이 아니라 — 수동 세관 신고 처리의 실제 비용입니다.
4초의 오타, 4개월의 감사
세계무역기구(WTO)는 164개 회원국 경제에서 연간 5만 건 이상의 관세율 변동을 집계합니다. 하나의 HS 코드는 한 자리 차이로 무관세 분류와 25% 관세가 갈리며, 각각의 오분류는 시간을 거슬러 누적되는 재정적 결과를 초래합니다. 미국 관세국경보호청(CBP)은 19 U.S.C. 1484에 따라 최대 3년 전의 신고를 소급 검토할 수 있습니다. EU 관세 당국은 EU 관세법(규정 (EU) 952/2013)에 따라 유사한 소급 권한을 유지합니다. 오늘 발생한 한 번의 데이터 입력 오류는 단순한 수정 비용을 넘어, 과거에 제출한 모든 신고를 검토의 대상으로 만듭니다.
그러나 데이터 정확성을 확보하기 위한 물류 프로세스는 여전히 수동에 의존하고 있습니다. 3개국 5개 공급업체로부터 상품을 수입하는 업체는 CBP 양식 7501(43개 블록, 45개 이상의 필드), EU 단일 행정 문서(54개 항목), 서로 다른 5개 형식의 상업 송장, 다양한 필드명을 가진 패킹 리스트, 그리고 신고 가격과 일치하지 않을 수 있는 선하증권을 처리해야 합니다. 이 모든 문서가 관세 신고 데이터를 공급하며, 각 문서는 전사 오류의 잠재적 발생 지점입니다.
국제 연구 출판 리뷰 저널(International Journal of Research Publication and Reviews)에 따르면, 동남아시아 선적 지연의 30% 이상이 불완전하거나 오류가 있는 통관 서류에서 비롯됩니다. 2025년 Vizion 연구에 따르면 통관 지연의 32%는 특히 통관 송장의 오류 또는 정보 누락으로 인해 발생합니다. 이는 처리 속도의 문제가 아닙니다. 상호 운용되도록 설계된 적이 없는 다양한 문서 형식 간의 데이터 무결성 문제입니다.
수동 통관 데이터 입력의 필드당 오류율은 1~4%입니다. 일반적인 CBP 7501 양식에는 15~25개의 개별 전사 값이 포함됩니다. 이 범위의 하한선에서, 네 건의 신고 중 하나는 최소 하나의 잘못된 데이터 포인트를 포함하며, 이 중 어느 하나라도 수년에 걸친 규정 준수 검토를 촉발할 수 있습니다.
세관 신고서가 템플릿 OCR을 무너뜨리는 이유
템플릿 기반 OCR — 시중 대부분의 문서 추출 도구의 기반 기술 — 은 페이지의 고정 위치를 데이터 필드에 매핑하는 방식으로 작동합니다. CBP 양식 7501에서 "수입자(Importer of Record)" 영역을 정의하면 이후 모든 양식에서 해당 영역의 내용이 동일한 열로 들어갑니다. 문제는 이 접근 방식이 단일하고 불변하는 문서 레이아웃에 의존한다는 점입니다. 세관 신고서는 불변성의 정반대입니다.
세 관할 구역에 신고를 제출하는 수입업체를 생각해 보십시오. CBP 양식 7501은 신고 번호를 블록 1에, 수입자를 블록 12에, 원산지국을 블록 11에 배치합니다 — 각각 다중 블록 정부 양식의 번호가 매겨진 필드입니다. EU SAD는 신고인을 Box 14에, 원산지국을 Box 16에, 상품 코드를 Box 33에, 보조 단위를 Box 41에 배치합니다. 영국의 C88 변형은 이러한 필드를 또 다시 재배열합니다. 일본의 수입 신고서(輸入申告書)는 완전히 다른 레이아웃을 사용합니다. 7501용으로 구역을 설정한 템플릿은 SAD를 가리키면 의미 없는 내용을 읽어냅니다 — 좌표가 전환되지 않기 때문입니다.
하지만 더 큰 실패 지점은 세관 양식 자체가 아닙니다. 양식에 데이터를 공급하는 보조 문서입니다. 선전의 공급업체 A 상업 송장은 4열에 HS 코드와 FOB 선전 가격을 나열합니다. 슈투트가르트의 공급업체 B는 사이드바 블록에 상품 코드를 넣고 EXW 가격을 명시합니다. 몬테레이의 공급업체 C는 약어가 포함되고 HS 코드가 전혀 없는 수기 송장을 보냅니다. Reddit의 r/CustomsBroker에 있는 세관 중개인이 현실을 잘 포착했습니다: "우리 파일은 종이 형태로 보관되지만, 문서는 시스템의 신고 건에도 첨부됩니다. 모두 이메일로 받습니다." 문서는 PDF, 스캔, 사진, 스크린샷으로 도착합니다 — 그런 다음 누군가 각 문서의 데이터를 신고 시스템에 입력합니다.
이것이 템플릿 OCR이 해결할 수 없는 구조적 문제입니다: 모든 거래 파트너가 문서를 다르게 포맷할 때, 위치가 아닌 의미로 읽는 시스템이 필요합니다. 한 송장의 "HS 코드" 필드와 다른 송장의 "관세 분류" 필드는 동일한 의미적 개체입니다 — 그러나 템플릿 기반 도구는 이를 서로 다른 문서의 무관한 영역으로 봅니다.
규정 준수 연쇄 반응: 잘못된 숫자 하나가 실제로 초래하는 비용
통관 오류를 단순한 행정적 번거로움으로 여기기 쉽습니다. 여기서 수정 수수료, 저기서 이틀간의 지연. 그러나 현실은 대부분의 수입업자가 직접 겪기 전까지는 파악하지 못하는, 점점 확대되는 일련의 결과 사슬입니다.
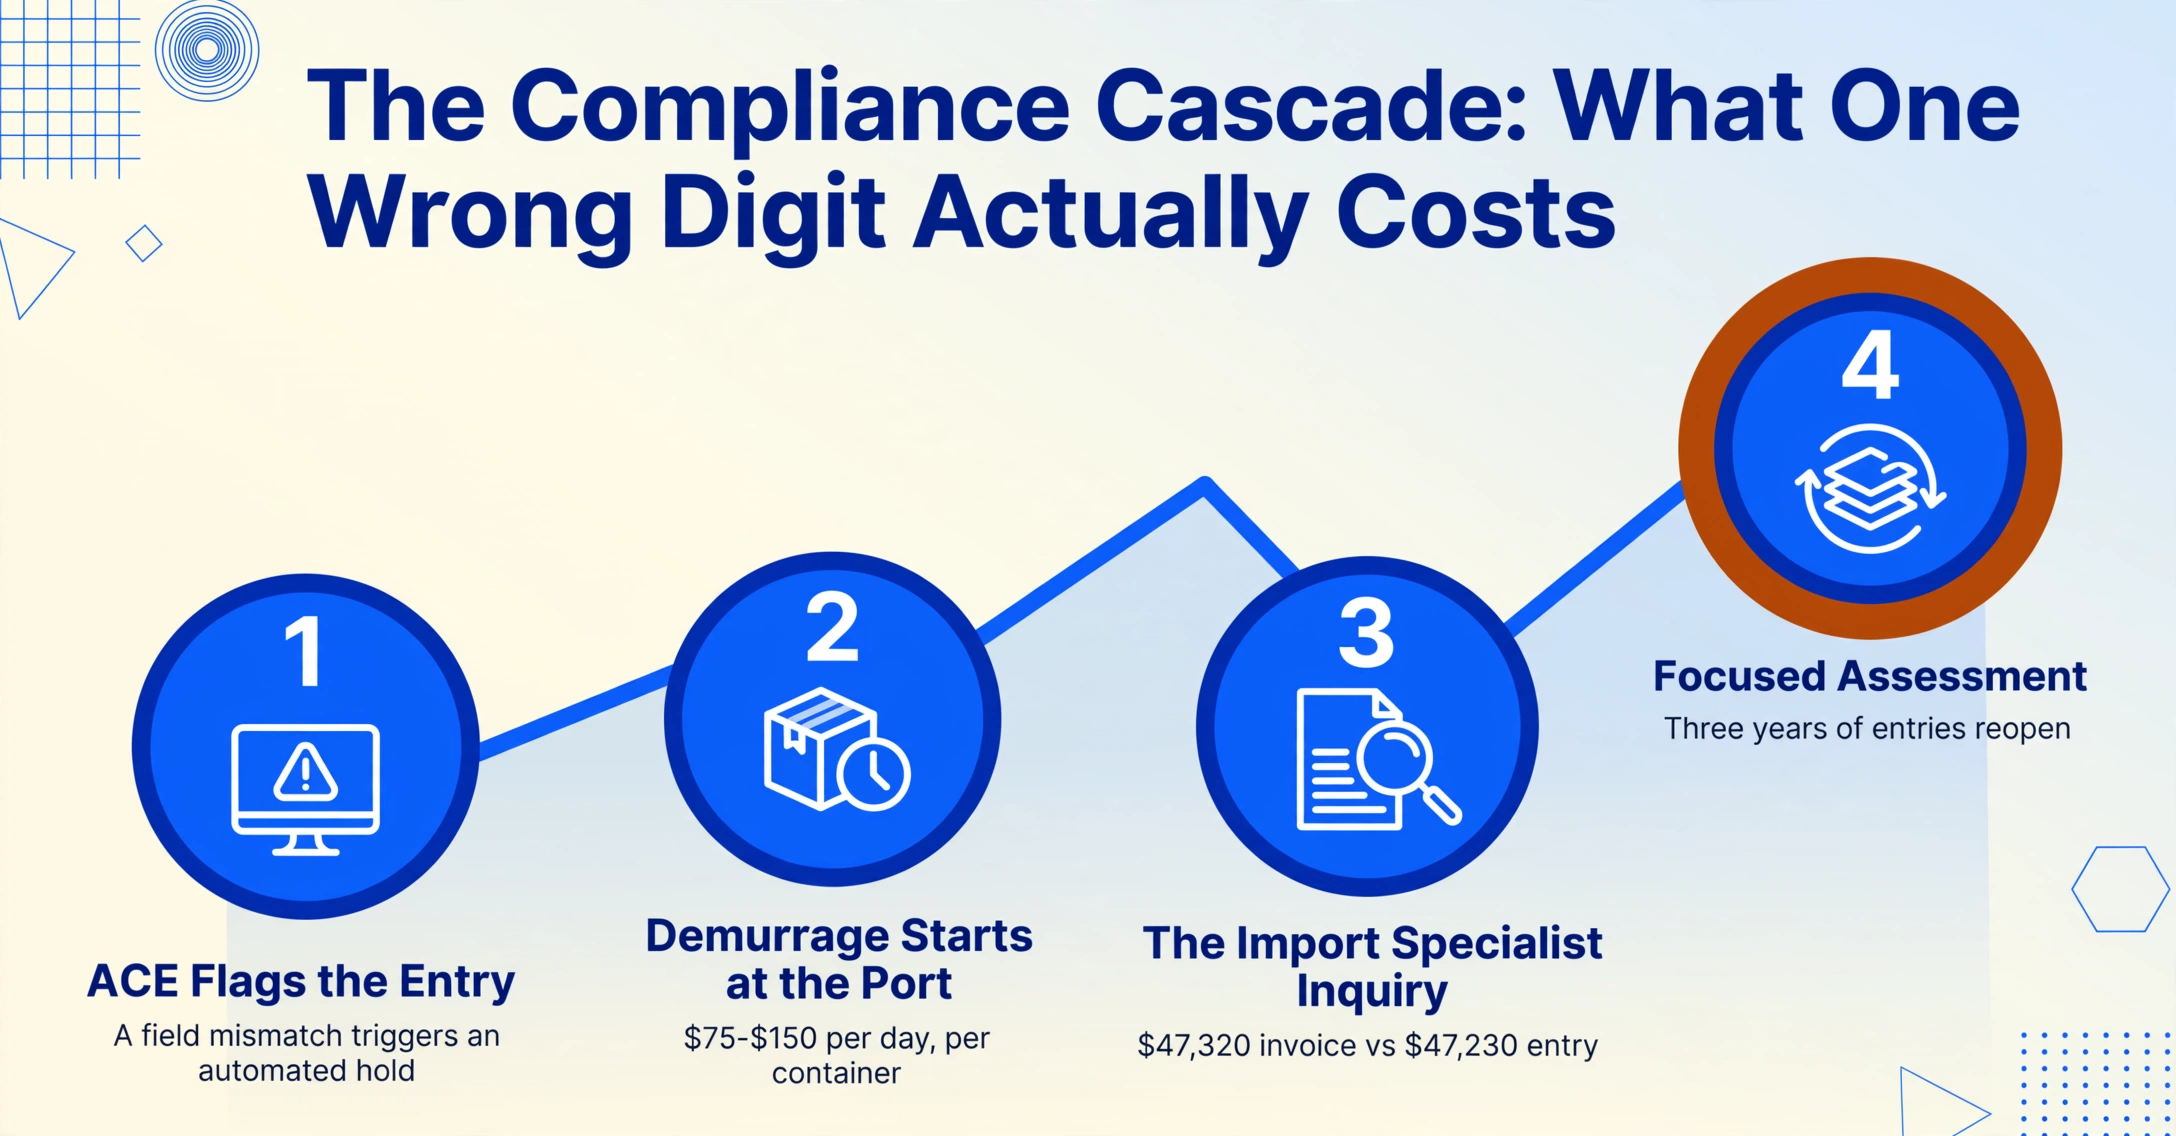
첫 번째 도미노: 자동 플래그 지정. CBP의 자동 상업 환경(ACE)은 모든 전자 신고에 대해 알고리즘 검사를 실행합니다. 필드 수준의 불일치 — 해당 HTS 코드의 통계적 표준에서 벗어난 신고 가액, 해당 상품의 일반적인 공급망 경로와 일치하지 않는 원산지 — 는 자동 보류를 촉발합니다. 화물의 이동이 중단됩니다. 선사 운임 요율표에 따르면 미국 항만에서 체화료가 컨테이너당 하루 $75~$150씩 발생하기 시작하며, 컨테이너가 터미널을 떠난 후에는 지체료가 또 다른 일일 비용을 추가합니다.
두 번째 도미노: 조회. CBP 수입 심사관은 플래그가 지정된 신고를 검토하고 수입업자 또는 통관사에게 문서를 요청합니다. 이 단계에서 전사 오류가 드러납니다. 상업 인보이스에는 $47,320 FOB로 표시되어 있는데 7501 양식에는 $47,230으로 입력된 경우. 8471.80.0100이어야 할 10자리 HTS 코드가 8471.30.0100으로 입력된 경우 — 이는 다른 세율이 적용되는 다른 세번입니다. CBP는 오타와 허위 신고 의도를 구분하지 않습니다. 불일치 자체가 규정 준수 문제입니다.
세 번째 도미노: 집중 심사(Focused Assessment). 여러 신고 건에 걸쳐 불일치가 나타나거나 — 단일 불일치가 충분히 중대한 경우 — CBP는 규제 감사 프로그램에 따라 집중 심사(FA)로 확대할 수 있습니다. FA는 빠른 문서 검토가 아닙니다. 분류, 과세 가격 평가, 원산지, 특혜 무역 프로그램 주장, 기록 보관을 포괄하는 수입업자의 통관 규정 준수에 대한 전면 감사입니다. CBP 감사관은 최대 3년 전의 신고 건을 조사할 수 있습니다. 입증 책임은 수입업자에게 있습니다 — 19 CFR 162.1a는 수입업자가 "신고 서류에 요구되는 정보의 정확성을 입증"할 것을 요구합니다. 원본 상업 인보이스가 숫자가 모호한 PDF 스캔본이어서 신고 가액의 정확성을 입증할 수 없다면, 당신의 패배입니다.
네 번째 도미노: 벌칙. 2024년, 미국 무역 집행은 새로운 최고치에 도달했습니다. 산업안보국(BIS)은 26건의 형사 사건을 제기하고 340개 이상의 업체를 제한 거래처 목록에 추가했습니다. 2024년 개정된 벌칙 기준에 따라 무역 위반에 대한 행정 벌칙은 위반 건당 최대 $364,992 또는 거래 가액의 2배 중 더 큰 금액에 달했습니다. 형사 처벌은 징역 20년 및 위반 건당 $1백만까지 확대됩니다. 법무부는 2023년 대비 2024년에 FCPA 및 제재 관련 벌칙을 약 3분의 1 더 많이 부과했으며, 항공우주 및 방산 기업에 대한 FCPA 및 수출통제 위반으로 $3억 6,400만 벌금이 포함되었습니다.
과실은 항변 사유가 아닙니다. 19 CFR 111에 따라 통관사는 신고서 작성 시 "상당한 주의"를 기울여야 합니다. 수입업자가 잘못된 데이터를 제공하고 통관사가 검증 없이 신고하면 양측 모두 책임을 공유합니다. 통관사의 면허가 위험에 처합니다. 수입업자의 보증이 위험에 처합니다. 데이터 입력 오류는 다자간 규정 준수 실패로 이어집니다.
2025년, 규정 준수 부담은 줄어들지 않고 오히려 증가하고 있습니다. 2025년 7월 8일 발표된 CBP의 업데이트된 Form 7501은 제232조에 따른 철강 및 알루미늄 수입에 대해 용해 및 주조 국가, 1차 제련 국가, 2차 제련 국가, 알루미늄 용해 및 주조 국가 등 4개의 새로운 필수 입력 필드를 추가했습니다. 이러한 필드에는 표준 상업 송장에 종종 포함되지 않는 추적 데이터가 필요하므로, 수입업자는 공급업체로부터 추가 문서를 요청하고 이를 더 많은 신고 필드에 입력해야 합니다.
한편, 탄소국경조정메커니즘(CBAM — 규정 (EU) 2023/956)에 따른 EU의 2025년 SAD 업데이트는 운송 수단별 탄소 배출 데이터를 요구합니다. 기업 지속가능성 실사 지침(CSDDD)은 생산 과정에서 분쟁 광물이나 강제 노동이 없음을 명시하도록 규정합니다. 새로운 규제 필드가 추가될 때마다 공급업체 문서에서 추출하여 정확히 기록하고 제때 제출해야 하는 데이터 포인트가 하나 더 늘어납니다. 규정 준수 오류의 표면적은 규제 업데이트가 있을 때마다 확장됩니다.
의미 기반 추출 vs. 위치 기반 추출: 통관에서 중요한 이유
통관 처리에서 템플릿 OCR의 핵심 한계는 기술적인 것이 아니라 구조적인 것입니다. 위치 기반 추출은 페이지상의 필드 물리적 위치와 그 의미 사이에 안정적인 관계가 있다고 가정합니다. 통관 신고는 본질적으로 모든 수준에서 이 가정을 위반합니다.
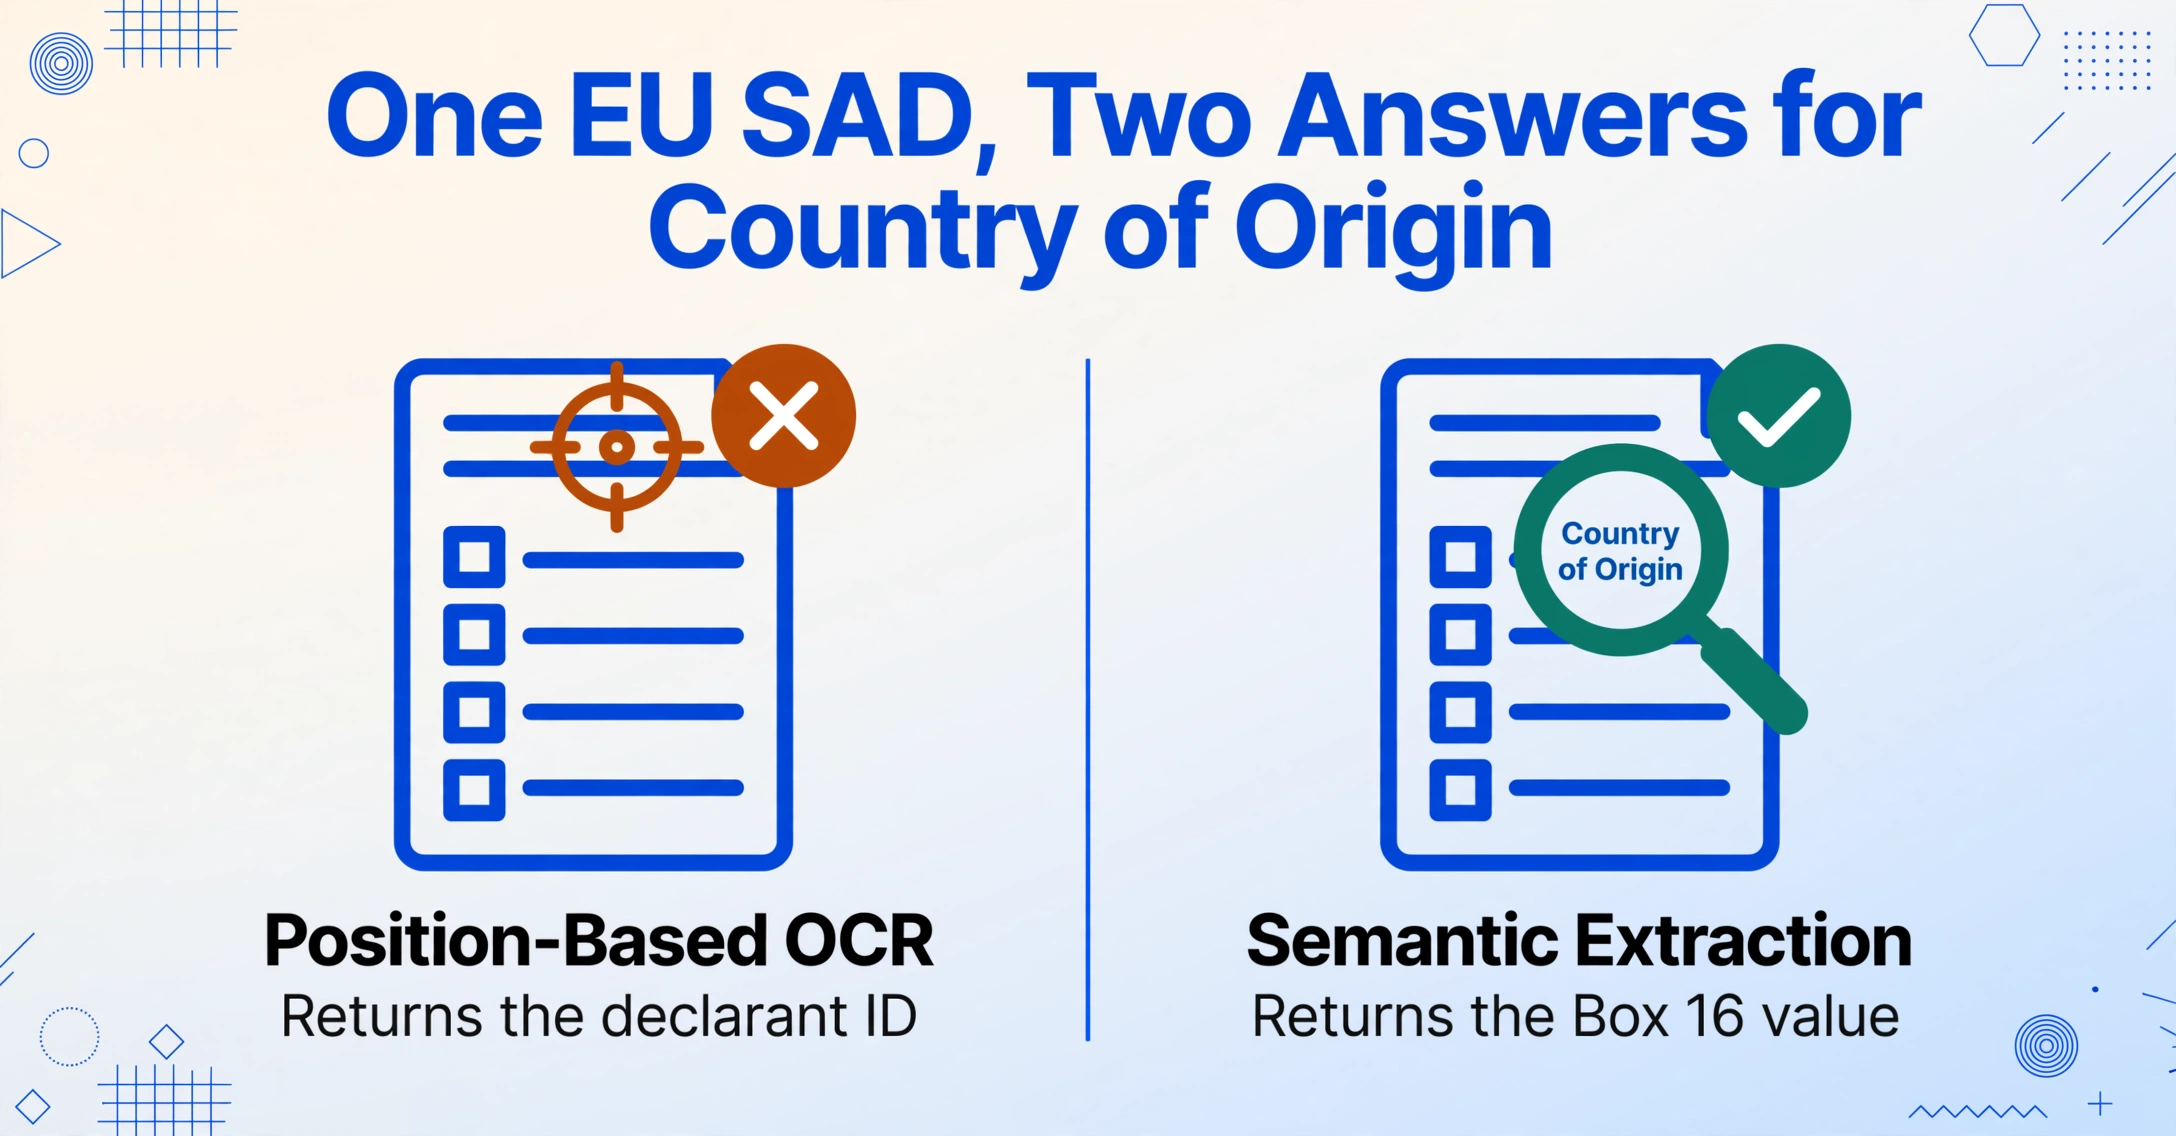
CBP Form 7501을 학습한 위치 기반 도구는 원산지 국가가 블록 11 — 페이지 왼쪽 열의 약 1/3 지점 — 에 있다고 인식합니다. 동일한 도구가 SAD를 접하면 동일한 좌표에서 데이터를 찾다가 신고인 식별 번호를 찾게 됩니다. 추출은 잘못되었지만, 도구는 "원산지 국가"가 무엇을 의미하는지 이해하지 못하기 때문에 오류를 인지할 메커니즘이 없습니다. 단지 그것이 일반적으로 어디에 위치하는지만 알 뿐입니다.
의미 기반 추출 — 의도 기반 또는 템플릿 없는 추출이라고도 함 — 은 이 관계를 반전시킵니다. 위치를 매핑하는 대신 의미를 매핑합니다. 시스템에 원하는 것을 지정합니다: "원산지 국가", "HTS 코드", "신고 가액", "수입업자 등록 번호". AI는 CBP 7501, EU SAD, 일본 수입 신고서 또는 공급업체의 상업 송장 등 각 문서를 읽고 페이지상의 위치나 레이블 방식에 관계없이 각 필드 정의에 해당하는 데이터를 찾습니다.
이것이 하나의 문서 형식을 읽도록 도구를 프로그래밍하는 것과 모든 형식에서 통관 데이터가 어떻게 보이는지 이해하도록 도구를 가르치는 것의 차이입니다. 첫 번째 접근 방식은 유지 관리하는 문서 템플릿 수에 따라 확장됩니다. 두 번째 접근 방식은 찾고 있는 정보를 포함하는 모든 문서에서 작동합니다.
특히 통관 신고의 경우, 의미 기반 추출은 위치 기반 도구를 무너뜨리는 세 가지 구조적 문제를 처리합니다:
1. 문서 간 필드명 변동. 동일한 데이터 포인트가 관할권에 따라 다른 레이블로 나타납니다: "HTS Number"(미국), "Commodity Code"(EU), "HS Code"(WCO 협약 언어), "Tariff Code"(영국), "統計品目番号"(일본). 의미 기반 시스템은 이를 동일한 항목으로 인식합니다. 템플릿 시스템은 이를 관련 없는 것으로 간주하여 각 레이블 규칙에 대해 별도의 템플릿이 필요합니다.
2. 지원 문서 통합. 세관 신고는 단독으로 이루어지지 않습니다. 상업 송장, 포장 명세서, 선하증권, 원산지 증명서, 공급업체 신고서에 분산된 데이터를 조합하여 작성됩니다. 기존 워크플로에서는 누군가 각 문서를 읽고 신고 양식에 값을 입력합니다. 의미론적 추출을 사용하면 전체 문서 세트(5개 공급업체의 상업 송장, 포장 명세서, 선하증권)를 일괄 업로드하고 모든 신고 관련 필드를 단일 테이블로 추출할 수 있습니다. 출력은 어떤 원본 문서에 어떤 데이터 포인트가 있었는지와 관계없이 제출에 필요한 필드에 직접 매핑됩니다.
3. 필기 및 스캔 문서 허용. 세관 중개인은 소규모 해외 공급업체로부터 필기된 상업 송장, 스탬프와 메모가 있는 스캔된 선하증권, 팩스로 보내고 다시 스캔한 원산지 증명서 양식을 자주 받습니다. 기존 OCR은 기계로 생성되지 않은 문서에는 어려움을 겪습니다. 비전 AI(이미지를 먼저 텍스트로 변환하지 않고 이미지로 처리하는 대규모 멀티모달 모델)로 구동되는 의미론적 추출은 필기 값을 읽고, 텍스트 위에 겹쳐진 스탬프를 해독하며, 다세대 스캔 아티팩트를 처리합니다 — 중개인의 받은 편지함에 매일 도착하는 종류의 문서입니다.
파일은 안전하게 처리되며 저장되지 않습니다.
세관 신고에 필요한 필드(품목 설명, 신고 가치, 원산지 국가)를 입력하고 AI가 문서의 어느 위치에 있든 각 필드를 찾는 방법을 확인해 보세요. 한 레이아웃에서 송장 데이터를 추출하는 동일한 메커니즘이 문서 유형별 구성 없이 모든 문서 유형에서 세관 관련 필드를 추출합니다.
실용적인 통관 데이터 추출 워크플로우
수동 입력에서 의미론적 추출로 전환한다고 해서 통관 신고 시스템을 교체할 필요는 없습니다. 시스템에 데이터를 공급하는 데이터 입력 단계만 대체할 뿐입니다. 월 50건의 선적을 3개 무역 경로로 처리하는 수입업자가 워크플로우를 재구성하는 방법은 다음과 같습니다.
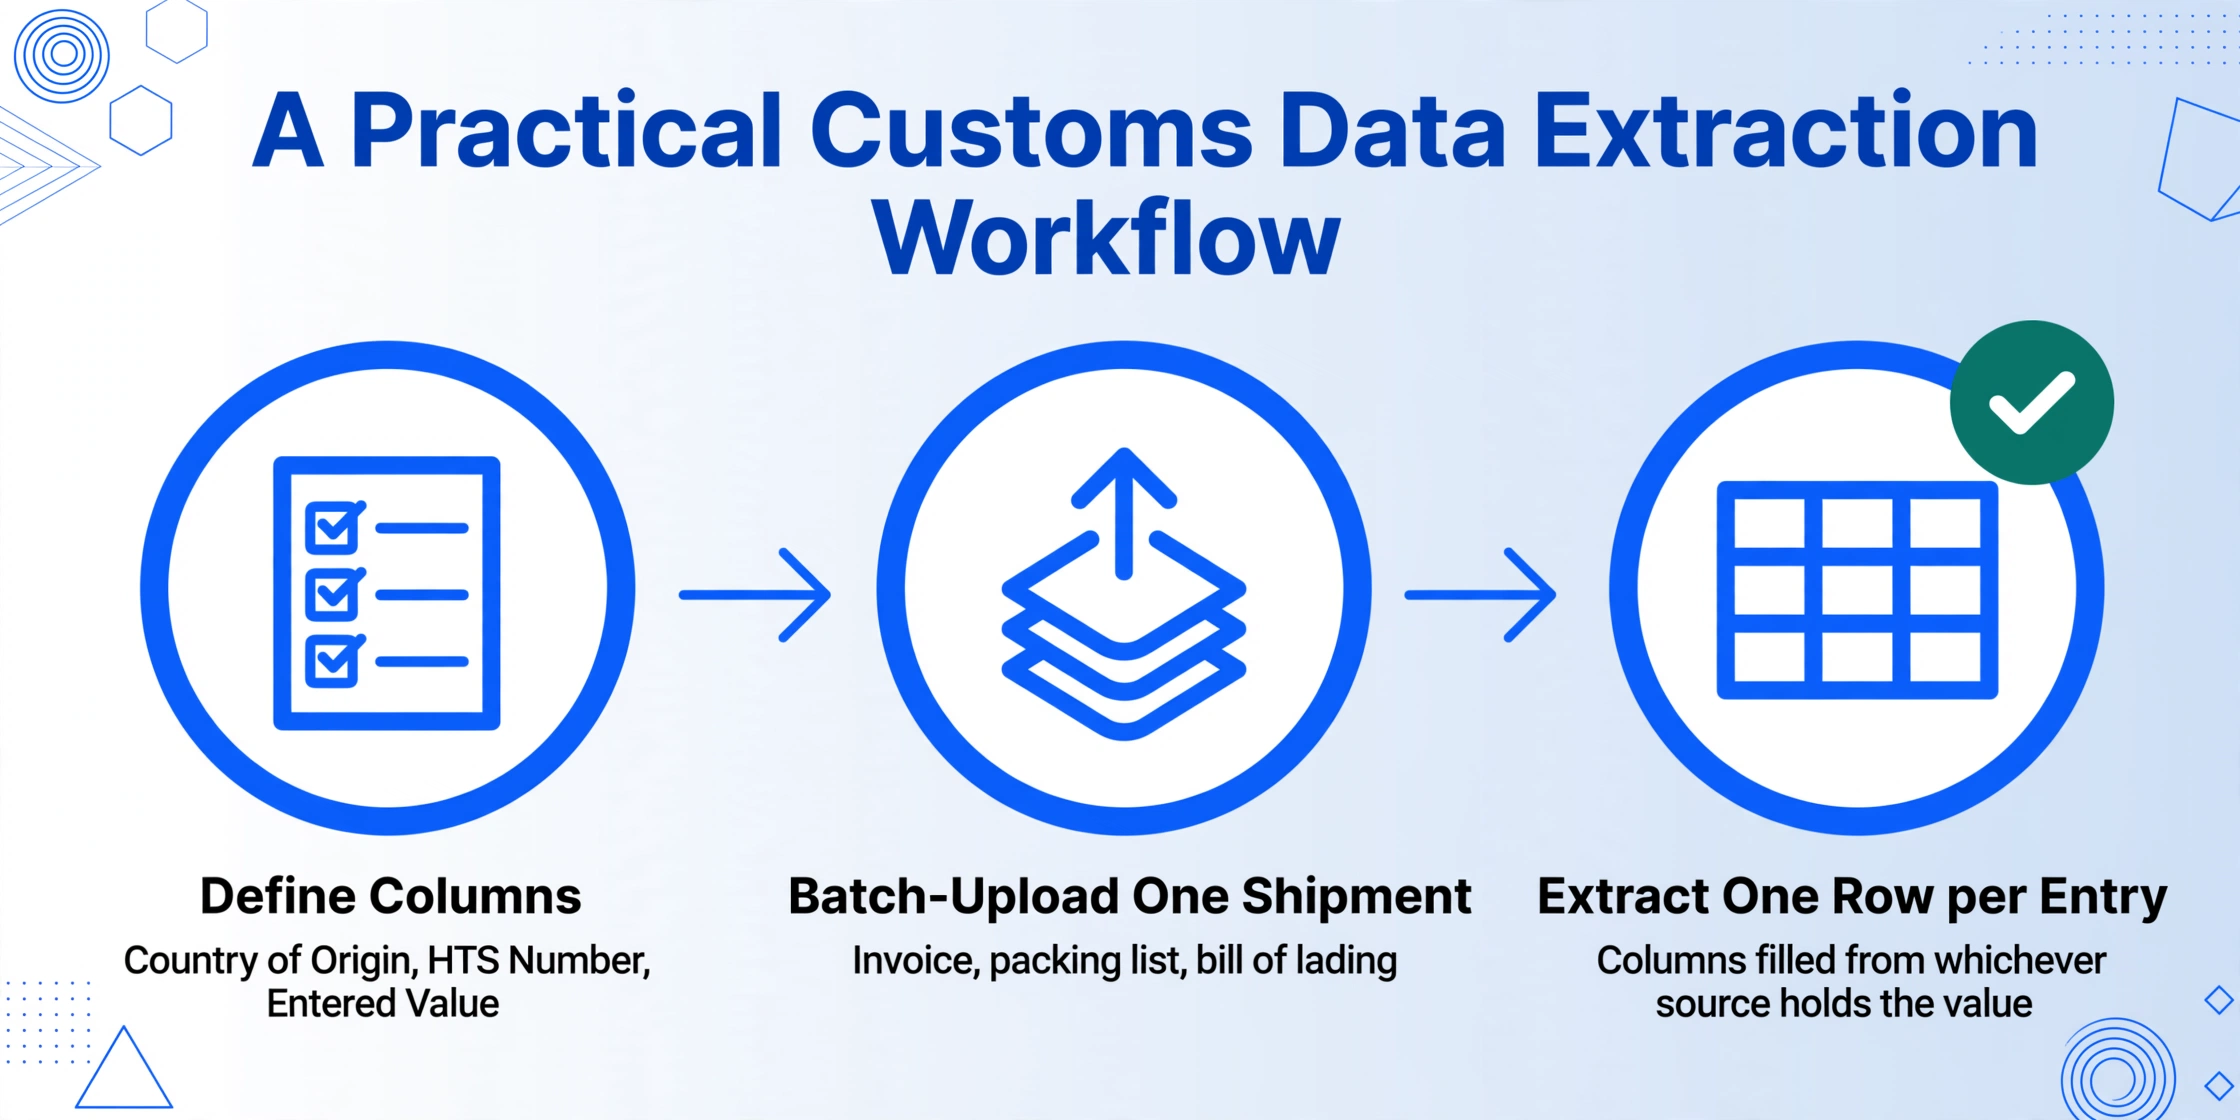
필요한 신고 필드를 식별하십시오. CBP 양식 7501을 통한 미국 수입의 경우 핵심 추출 필드는 다음과 같습니다: 입항 번호, 수입자, 원산지 국가, HTS 코드(10자리), 상품 설명, 신고 가액, 수량, 항구 코드, 운송 수단. EU SAD 신고자의 경우: 상품 코드, 원산지 국가(란 16), 수하인(란 8), 신고 가액, 순 중량, 절차 코드(란 37). 이를 추출 열로 한 번 정의하십시오.
각 선적에 대한 증빙 서류 세트를 일괄 업로드하십시오. 단일 통관 건의 경우 일반적으로 상업 송장, 포장 명세서, 선하증권 또는 항공화물운송장, 원산지 증명서, 공급업체 신고서가 포함됩니다. 이들을 하나의 배치로 함께 업로드하면 추출 엔진이 이를 하나의 문서 세트로 처리하고 각 값이 포함된 출처에서 열 필드를 채웁니다.
배치 전체에서 추출을 실행하십시오. AI가 각 문서를 읽고 열 정의와 일치하는 데이터를 찾아 통합 테이블을 채웁니다. 건당 한 행씩, 각 신고 필드에 대한 열이 생성됩니다. 포장 명세서의 수기 값, 상업 송장의 기계 인쇄 HS 코드, 증명서의 날인된 원산지 신고 — 모두 동일한 구조화된 출력으로 추출됩니다.
신고 양식과 대조하여 검증하십시오. 제출 전에 추출된 데이터를 의도한 신고 값과 비교하십시오. 테이블 형식 덕분에 불일치를 한눈에 확인할 수 있습니다 — 전치된 HS 코드 숫자, 누락된 원산지 신고, 송장과 포장 명세서 간의 가액 불일치. 모든 필드가 아닌 예외 사항만 수정하십시오.
기존 시스템을 통해 제출하십시오. ACE(미국), CDS(영국), 또는 통관사 포털을 사용하든, 검증된 데이터는 재입력 없이 신고 시스템으로 흘러갑니다. 추출 단계가 문서-데이터 변환을 처리합니다. 신고는 이미 원본 문서와 대조 확인된 데이터로 진행됩니다.
브로커나 수입업자가 Google Sheets를 중간 도구로 사용하여 신고하는 경우 — 소규모 업체에서 신고 데이터를 스프레드시트에 먼저 작성한 후 제출하는 일반적인 패턴 — Google Sheets 애드온을 사용하면 업로드 후 다운로드하는 단계가 완전히 사라집니다. 추출 결과가 신고 데이터를 정리하는 스프레드시트에 바로 입력됩니다.
여러 공급업체나 고객으로부터 문서를 수집하는 업체의 경우, 수집 링크를 통해 외부 당사자가 로그인 없이 인보이스와 인증서를 처리 대기열에 직접 업로드할 수 있어, 이메일 첨부 파일을 추적할 필요가 없습니다. 문서는 출처별로 사전 정리되어 신고 필드로 일괄 추출할 준비가 됩니다.
규제 추세: 앞으로 더 어려워지는 이유
통관 데이터 추출 자동화의 필요성은 단순히 현재의 업무량 때문만이 아닙니다. 무역 규제 준수 정책이 나아가는 방향과 관련이 있습니다.
UNCTAD의 글로벌 무역 업데이트에 따르면, 2024년 글로벌 무역은 사상 최대인 33조 달러를 기록했으며 2023년 대비 3.7% 증가했습니다. 전 세계적으로 제출되는 통관 신고 건수도 이에 비례해 증가하고 있으며, 개발도상국의 무역은 전년 대비 4% 성장했습니다. 더 많은 무역은 더 많은 신고를 의미합니다. 더 많은 신고는 더 많은 데이터 포인트의 추출, 전사, 검증을 의미합니다.
동시에 신고 건당 데이터 밀도도 증가하고 있습니다. EU의 CBAM 탄소 보고 요건은 적용 대상 상품의 모든 SAD에 배출 데이터 필드를 추가합니다. 미국 섹션 232 확대는 철강 및 알루미늄 수입 건당 4개 필드를 추가하며, 이 필드에는 표준 상업 인보이스에 없는 추적성 데이터가 필요합니다. EU의 수입 통제 시스템 2(ICS2)는 이제 항공 및 해상 운송뿐만 아니라 모든 운송 수단에 대해 사전 화물 정보를 의무화합니다. 각 규제 업데이트는 신고 건당 독립적으로 추출 가능한 데이터 포인트 수를 증가시키며, 따라서 잠재적 전사 실패 지점도 늘어납니다.
세계관세기구(WCO)의 SAFE 프레임워크 표준은 규정 준수 이력을 가진 업체에 신속 통관을 부여하는 AEO(수권 경제 운영자) 프로그램을 지속적으로 추진하면서도 데이터 정확성에 대한 검증을 강화하고 있습니다. AEO 인증을 받은 수입업자가 일관되고 정확한 신고를 제출하면 상품 이동이 빨라집니다. 수정 및 정정 이력이 있는 수입업자는 점점 더 긴 검사 대기열에 직면하게 됩니다. 규정 준수 데이터 이력은 누적됩니다.
지금 문서 데이터 추출을 자동화하는 수입업체는 단순히 인건비를 절약하는 것이 아닙니다. 규정 준수 데이터 인프라를 구축하는 것입니다 — 모든 정확한 신고는 향후 통관 속도를 결정하는 규정 준수 프로필을 강화합니다.
자주 묻는 질문
AI가 CBP 양식 7501과 EU SAD 신고서에서 데이터를 추출할 수 있나요?
네. 시맨틱 AI 추출은 두 양식 유형과 그 첨부 문서(상업 송장, 포장 명세서, 선하증권)를 모두 읽고, 양식 레이아웃에 관계없이 신고서 필드를 채웁니다. 핵심 차이점은 페이지 상의 위치가 아닌 필드의 의미(예: "원산지")를 이해하여 작동하므로, CBP 7501 블록 11, SAD 상자 16, 그리고 원산지를 언급하는 모든 공급업체 송장에서 동일한 열 정의가 작동한다는 점입니다.
해외 공급업체의 수기 상업 송장은 어떻게 처리하나요?
문서 이미지를 직접 처리하는 비전 AI 모델(먼저 텍스트로 변환하지 않음)은 필기 값, 도장, 다세대 스캔을 읽을 수 있습니다. 선명한 필기의 정확도는 기계 인쇄 텍스트와 비슷합니다. 심하게 손상된 문서(여러 팩스 세대, 수분 손상, 극단적인 필기체)는 정확도가 낮아집니다. 이러한 경우 추출 시 낮은 신뢰도의 필드를 자동으로 잘못된 값을 반환하는 대신 사람이 검토하도록 표시할 수 있습니다.
데이터 추출을 자동화해도 여전히 관세사가 필요한가요?
네. 데이터 추출은 문서-데이터 변환 단계를 처리합니다. 면허를 가진 관세사는 분류 전문성, 규제 판단, 컴플라이언스 전략, 그리고 CBP에 신고서를 제출할 법적 권한을 제공합니다. 자동화는 수동 데이터 입력 작업량을 줄여줍니다. 상품을 올바르게 분류하거나, 무역 특혜 프로그램을 적용하거나, 집행 조치에 대응하는 데 필요한 전문가 판단을 대체하지는 않습니다. 19 CFR 111에 따라, 데이터를 추출한 도구와 관계없이 브로커의 주의 의무는 그대로 유지됩니다.
HS/HTS 코드 분류는 어떻게 처리하나요?
추출 도구는 원본 문서에서 HS 코드를 가져옵니다. 즉, 올바른 분류가 무엇이어야 하는지가 아니라, 적혀 있는 내용을 추출합니다. 공급업체 송장에 잘못된 HS 코드가 기재되어 있으면, 추출 도구는 그 코드를 충실히 보고합니다. 분류(제품 특성, 재료 구성, 의도된 용도에 기반하여 올바른 10자리 HTS 코드를 결정하는 것)는 여전히 전문가 판단 작업입니다. 추출 단계는 전사 오류(8471.30을 8471.80으로 잘못 입력하는 등)를 제거하지만, 분류 단계를 대체하지는 않습니다. 일부 수입업체는 추출 결과를 교차 확인 용도로 사용합니다. 즉, 신고 전에 공급업체가 명시한 코드와 브로커가 분류한 코드를 나란히 표시하여 불일치를 검토합니다.
비라틴 문자 문서(중국어, 일본어, 아랍어 공급업체 인보이스)는 어떻게 처리하나요?
최신 비전 AI 모델은 다국어를 지원합니다. 중국어, 일본어, 한국어, 아랍어 등 비라틴 문자로 된 문서도 읽고 데이터를 추출할 수 있습니다. 추출된 값은 목적지 세관 당국의 요구 사항에 따라 음역하거나 원래 문자 그대로 유지할 수 있습니다. 일본 수입 신고서(輸入申告書)의 경우 시스템이 한자 값과 함께 품목 코드, 신고 가격을 추출할 수 있습니다.
ACE / CDS / 세관 신고 시스템과 연동되나요?
ImageToTable.ai는 추출된 데이터를 Excel(XLSX), CSV, JSON 형식으로 내보냅니다. 이 형식들은 세관 신고 플랫폼, ERP 시스템 또는 스프레드시트 기반 준비 워크플로우에 가져올 수 있습니다. CBP나 EU 세관 당국에 직접 신고를 제출하지는 않습니다. 출력 데이터는 기존 신고 워크플로우에 입력됩니다. Google Sheets 사용자의 경우, 애드온이 추출된 데이터를 내보내기/가져오기 단계 없이 활성 스프레드시트에 직접 기록합니다.