Das Problem der Zollanmeldungsdaten
Das Template-OCR nie gelöst hat
Ein mittelständischer Elektronikimporteur in Chicago reichte im März 2025 47 CBP-Formular-7501-Einträge ein. Bei einem Eintrag war eine Ziffer im HTS-Code vertauscht – 8471.30 statt 8471.80. Die Abweichung löste ein automatisiertes CBP-Flag aus, das zu einer Fokussierten Prüfung eskalierte. Bis September prüften CBP-Wirtschaftsprüfer jeden Eintrag, den das Unternehmen in den vorangegangenen drei Jahren eingereicht hatte. Der ursprüngliche Fehler dauerte 4 Sekunden zum Tippen. Die Prüfung kostete das Compliance-Team 4 Monate Zeit. Dies – nicht die langsame Dateneingabe – sind die tatsächlichen Kosten der manuellen Verarbeitung von Zollanmeldungen.
Ein Tippfehler in vier Sekunden, ein Audit über vier Monate
Die Welthandelsorganisation zählt jährlich über 50.000 Änderungen von Zollsätzen in ihren 164 Mitgliedsstaaten. Ein einziger HS-Code kann sich um eine Ziffer zwischen einer zollfreien Einstufung und einem 25%igen Zollsatz unterscheiden – und jede Fehlklassifizierung hat finanzielle Folgen, die sich rückwirkend verstärken. Der US-Zoll (CBP) kann Anmeldungen gemäß 19 U.S.C. 1484 bis zu drei Jahre rückwirkend prüfen. Die EU-Zollbehörden haben gemäß dem Zollkodex der Union (Verordnung (EU) 952/2013) ähnliche Rückwirkungsbefugnisse. Ein heute gemachter Dateneingabefehler kostet nicht nur die Korrekturgebühr – er öffnet ein Fenster zu jeder Ihrer gestrigen Anmeldungen.
Doch die Logistik, diese Daten korrekt zu erfassen, bleibt hartnäckig manuell. Ein Importeur, der Waren von fünf Lieferanten aus drei Ländern erhält, bearbeitet das CBP-Formular 7501 (über 45 Felder in 43 Blöcken), das EU-Einheitsdokument (54 Felder), Handelsrechnungen in fünf verschiedenen Formaten von fünf verschiedenen Lieferanten, Packlisten mit unterschiedlichen Feldnamen und Konnossemente, die möglicherweise nicht mit den Anmeldewerten übereinstimmen. Jedes dieser Dokumente speist Daten in die Zollanmeldung ein – und jedes ist ein potenzieller Punkt für Übertragungsfehler.
Laut dem International Journal of Research Publication and Reviews sind über 30 % der Sendungsverzögerungen in Südostasien auf unvollständige oder fehlerhafte Zollpapiere zurückzuführen. Eine Vizion-Studie aus dem Jahr 2025 ergab, dass 32 % der Zollverzögerungen speziell durch Fehler oder fehlende Informationen auf Zollrechnungen verursacht werden. Dies sind keine Probleme der Verarbeitungsgeschwindigkeit. Es sind Probleme der Datenintegrität über Dokumentformate hinweg, die nie für die Interoperabilität ausgelegt wurden.
Die manuelle Zolldateneingabe hat eine Fehlerrate von 1–4 % pro Feld. Ein typisches CBP 7501 enthält 15–25 unabhängig voneinander übertragene Werte. Am unteren Ende dieser Spanne enthält jede vierte Anmeldung mindestens einen falschen Datenpunkt – jeder davon kann eine Compliance-Prüfung auslösen, die sich über Jahre erstreckt.
Warum Zollanmeldungen die OCR mit Vorlagen sprengen
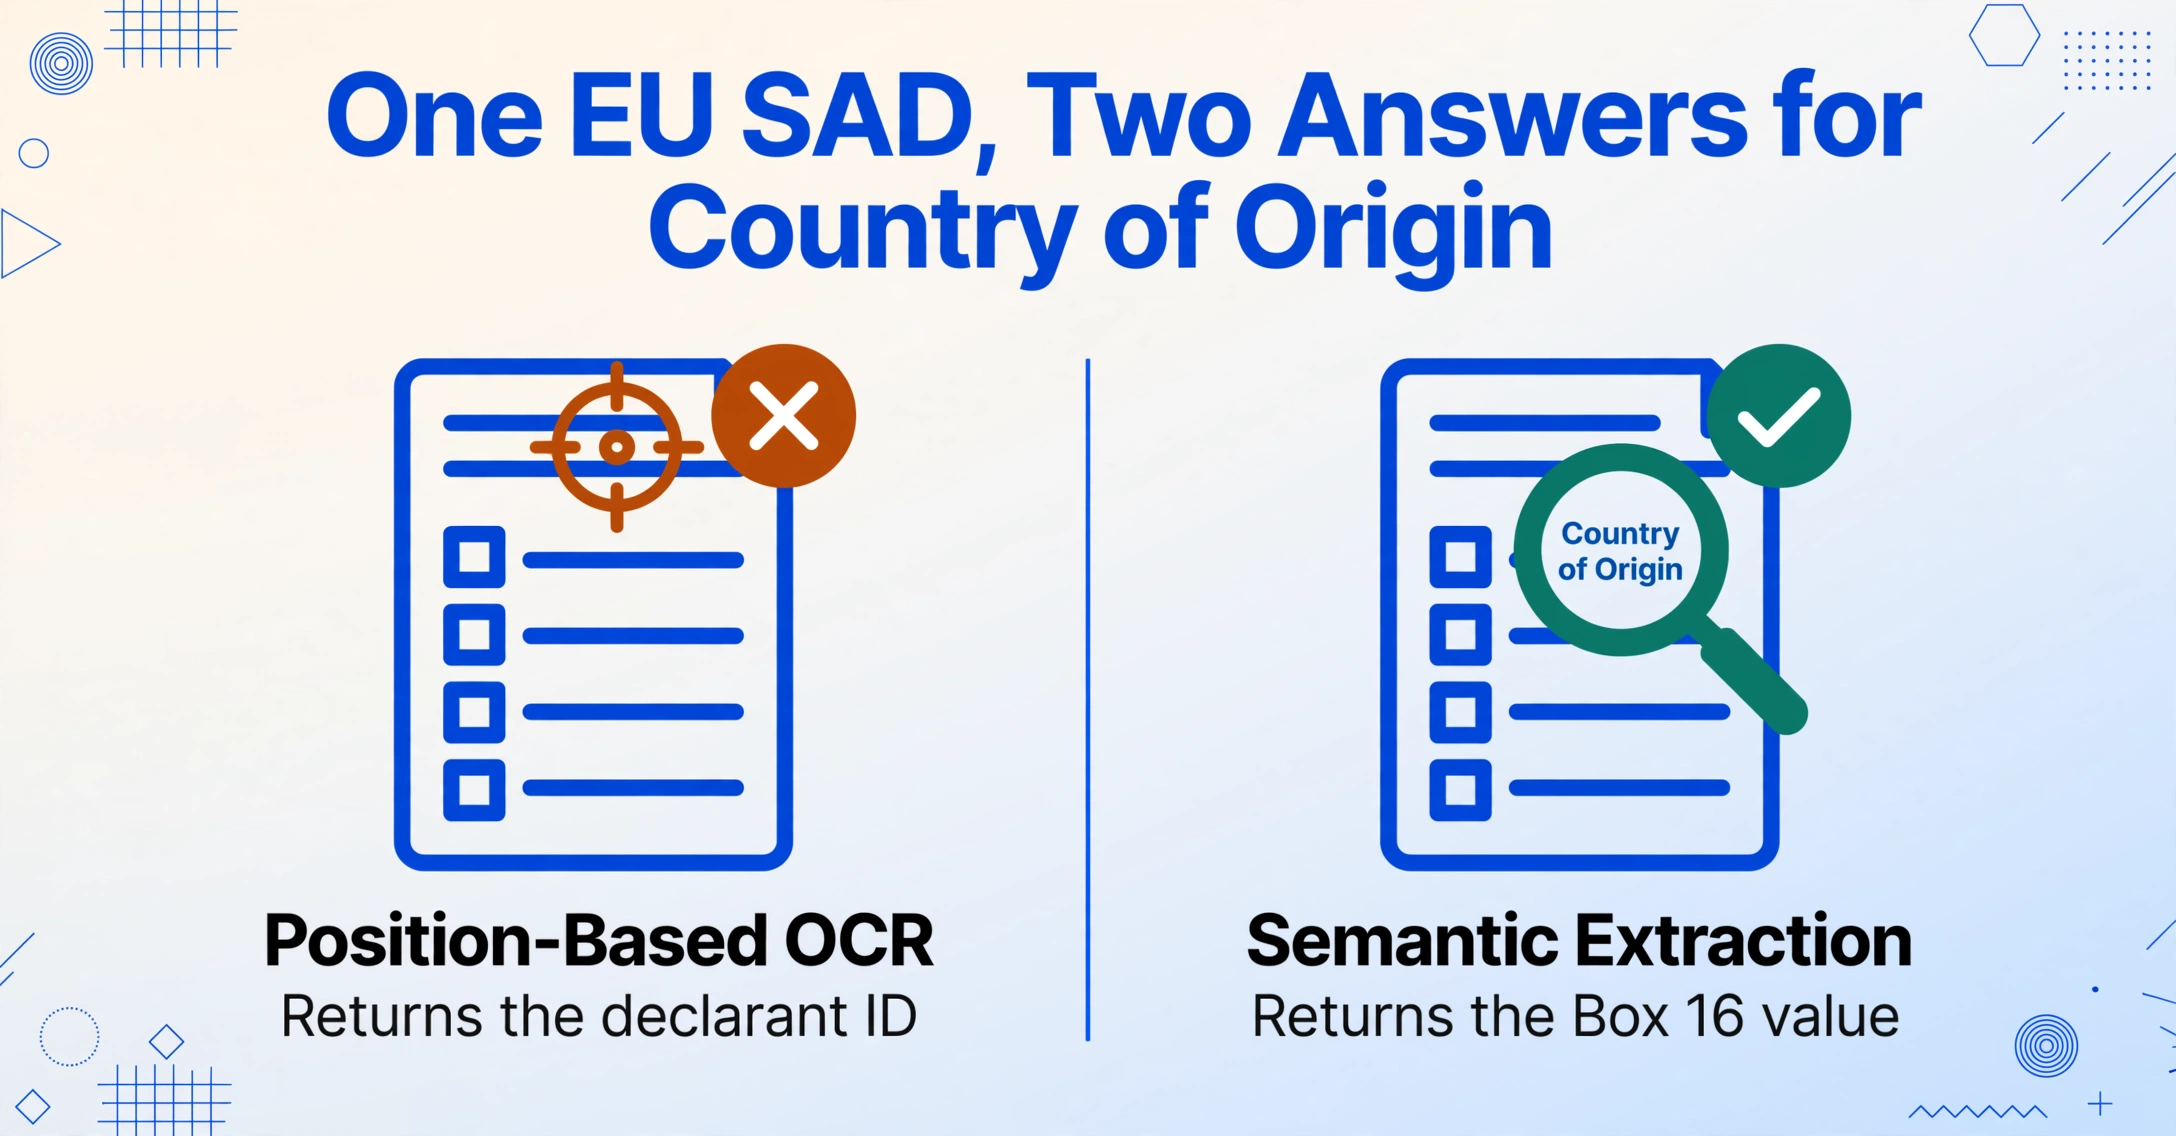
Vorlagenbasierte OCR – die Technologie hinter den meisten Dokumentextraktions-Tools auf dem Markt – funktioniert, indem sie feste Positionen auf einer Seite Datenfeldern zuordnet. Sie definieren eine Zone für „Importer of Record" auf dem CBP-Formular 7501, und jedes nachfolgende Formular führt den Inhalt dieser Zone derselben Spalte zu. Das Problem: Dieser Ansatz hängt von einem einzigen, unveränderlichen Dokumentlayout ab. Zollanmeldungen sind das Gegenteil von unveränderlich.
Betrachten Sie einen Importeur, der Anmeldungen in drei Rechtsgebieten einreicht. Das CBP-Formular 7501 platziert die Entry Number in Block 1, den Importer of Record in Block 12 und das Ursprungsland in Block 11 – jeweils als nummeriertes Feld in einem mehrteiligen behördlichen Formular. Das EU-SAD setzt den Anmelder in Feld 14, das Ursprungsland in Feld 16 und Warencodes über Feld 33 mit zusätzlichen Einheiten in Feld 41. Die britische C88-Variante ordnet diese Felder erneut anders an. Japans Zollanmeldung (輸入申告書) verwendet ein völlig anderes Layout. Eine Vorlage, die für das 7501-Formular eingerichtet ist, liest bei einem SAD nur Unsinn – die Koordinaten lassen sich nicht übertragen.
Der größere Schwachpunkt liegt jedoch nicht im Zollformular selbst, sondern in den Begleitdokumenten, die Daten dafür liefern. Die Handelsrechnung von Lieferant A in Shenzhen listet HS-Codes in Spalte 4 mit FOB-Shenzhen-Werten. Lieferant B in Stuttgart platziert Warencodes in einem Seitenblock und nennt EXW-Preise. Lieferant C in Monterrey sendet eine handschriftliche Rechnung mit Abkürzungen und ohne HS-Codes. Ein Zollagent auf Reddits r/CustomsBroker hat die Realität treffend beschrieben: „Unsere Unterlagen werden in Papierform aufbewahrt, aber Dokumente sind auch gegen die Anmeldung in unserem System hinterlegt. Wir erhalten sie alle per E-Mail." Die Dokumente kommen als PDFs, Scans, Fotos und Screenshots – und dann tippt jemand die Daten aus jedem einzelnen in das Anmeldesystem.
Das ist das strukturelle Problem, das vorlagenbasierte OCR nicht lösen kann: Wenn jeder Handelspartner Dokumente anders formatiert, brauchen Sie ein System, das nach Bedeutung liest, nicht nach Position. Ein Feld namens „HS-Code" auf einer Rechnung und „Zolltarifklassifikation" auf einer anderen ist dieselbe semantische Einheit – aber ein vorlagenbasiertes Tool sieht darin nicht zusammenhängende Zonen auf nicht zusammenhängenden Dokumenten.
Die Compliance-Kaskade: Was eine falsche Ziffer tatsächlich kostet
Es ist leicht, Zollfehler als bürokratische Ärgernisse abzutun – eine Korrekturgebühr hier, eine Verzögerung von zwei Tagen dort. In Wirklichkeit handelt es sich um eine Kette eskalierender Konsequenzen, die die meisten Importeure erst erkennen, wenn sie sie ausgelöst haben.
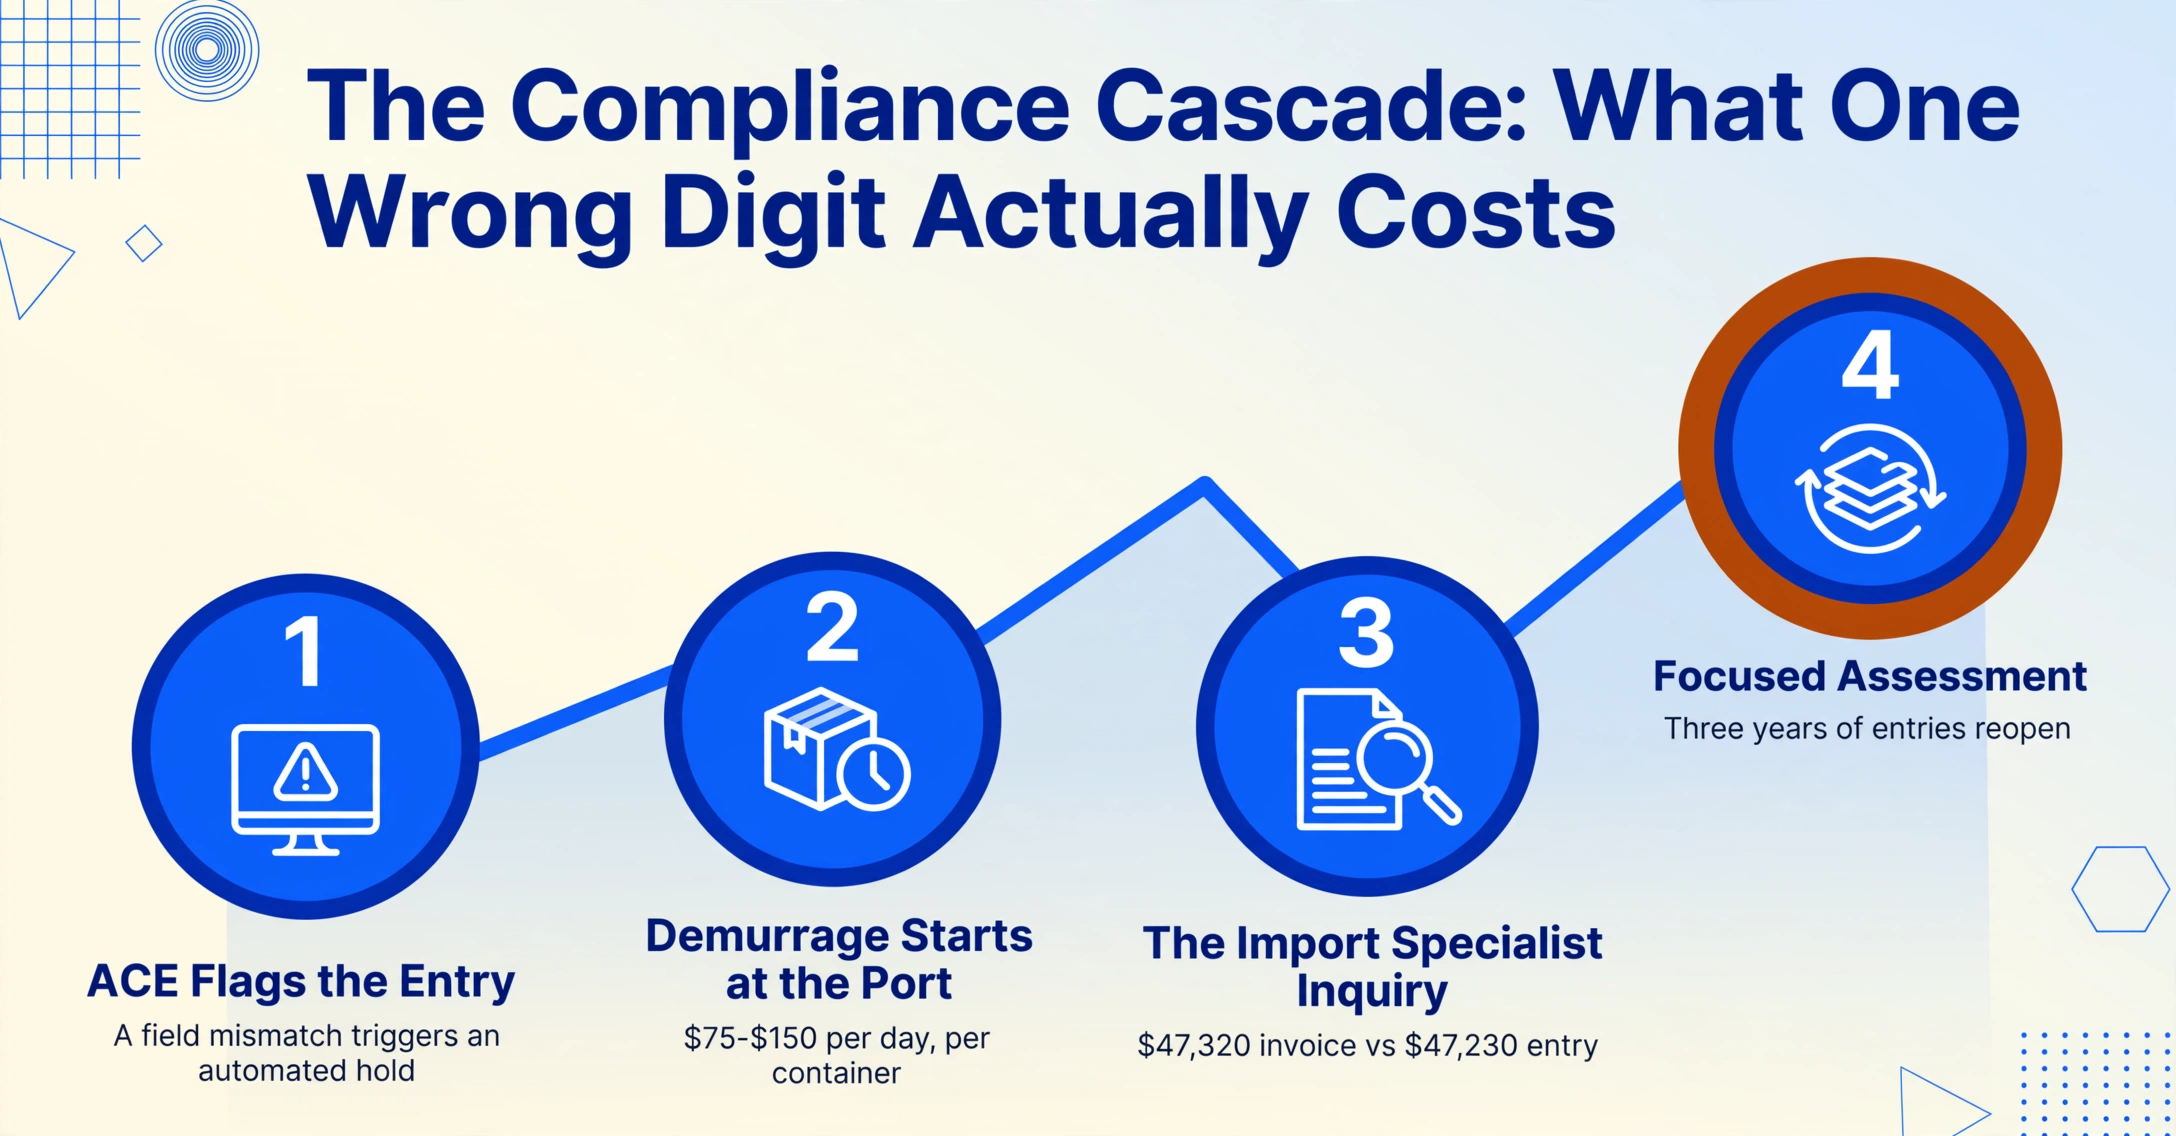
Der erste Dominostein: Automatische Kennzeichnung. Die Automated Commercial Environment der CBP führt bei jeder elektronischen Einfuhr algorithmische Prüfungen durch. Feldbezogene Unstimmigkeiten – ein deklarierter Wert, der von den statistischen Normen für diesen HTS-Code abweicht, ein Ursprungsland, das nicht der typischen Lieferkettenroute für diese Ware entspricht – lösen automatische Sperren aus. Die Sendung stoppt. Im Hafen fallen Liegegebühren an, in der Regel 75–150 $ pro Tag und Container an US-Häfen gemäß den Tarifplänen der Reedereien, wobei die Detention nach Verlassen des Terminals eine weitere Ebene täglicher Gebühren hinzufügt.
Der zweite Dominostein: Die Anfrage. Ein Import-Spezialist der CBP prüft die gekennzeichnete Einfuhr und fordert Unterlagen vom Importeur oder Makler an. Hier zeigen sich Übertragungsfehler. Eine Handelsrechnung weist 47.320 $ FOB aus, aber das Formular 7501 wurde mit 47.230 $ eingetragen. Ein 10-stelliger HTS-Code, der 8471.80.0100 lauten sollte, wird als 8471.30.0100 eingetragen – eine andere Unterposition mit einem anderen Zollsatz. Die CBP unterscheidet nicht zwischen einem Tippfehler und dem Versuch einer Falschdeklaration. Die Abweichung selbst ist das Compliance-Problem.
Der dritte Dominostein: Die Fokussierte Prüfung. Wenn Abweichungen bei mehreren Einfuhren auftreten – oder wenn eine einzelne Abweichung materiell bedeutsam genug ist – kann die CBP im Rahmen ihres Regulatory-Audit-Programms zu einer Fokussierten Prüfung (FA) eskalieren. Eine FA ist keine schnelle Dokumentenprüfung. Es ist eine umfassende Prüfung der Zoll-Compliance eines Importeurs, die Klassifizierung, Bewertung, Ursprungsland, Präferenzhandelsprogrammansprüche und Aufzeichnungspflichten abdeckt. Die Prüfer der CBP können Einfuhren der letzten drei Jahre untersuchen. Der Importeur trägt die Beweislast – 19 CFR 162.1a verlangt von Importeuren, „die Richtigkeit der in den Einfuhrpapieren geforderten Informationen nachzuweisen“. Wenn Sie nicht nachweisen können, dass Ihr deklarierter Wert korrekt war, weil die ursprüngliche Handelsrechnung ein PDF-Scan mit mehrdeutigen Ziffern war, verlieren Sie.
Der vierte Dominostein: Die Strafe. Im Jahr 2024 erreichte die US-Handelsdurchsetzung neue Höchstwerte. Das Bureau of Industry and Security (BIS) führte 26 Strafverfahren und fügte über 340 Unternehmen zu den Restriktionslisten hinzu. Verwaltungsstrafen für Handelsverstöße erreichten ein Maximum von 364.992 $ pro Verstoß oder den doppelten Transaktionswert – je nachdem, welcher Betrag höher ist – gemäß den aktualisierten Strafenkatalogen von 2024. Strafrechtliche Sanktionen reichen bis zu 20 Jahren Haft und 1 Million $ pro Verstoß. Das Justizministerium verhängte 2024 etwa ein Drittel mehr FCPA- und sanktionsbezogene Strafen als 2023, darunter eine Geldstrafe von 364 Millionen $ gegen ein Luft- und Raumfahrt- sowie Verteidigungsunternehmen wegen FCPA- und Exportkontrollverstößen.
Fahrlässigkeit ist keine Verteidigung. Gemäß 19 CFR 111 müssen Zollmakler bei der Erstellung von Einfuhranmeldungen die „gebotene Sorgfalt“ walten lassen. Wenn ein Importeur falsche Daten liefert und der Makler diese ohne Prüfung einreicht, haften beide Parteien. Die Lizenz des Maklers ist gefährdet. Die Kaution des Importeurs ist gefährdet. Der Dateneingabefehler eskaliert zu einem mehrseitigen Compliance-Versagen.
Im Jahr 2025 wächst die Compliance-Last, sie schrumpft nicht. Das aktualisierte CBP-Formular 7501 – veröffentlicht am 8. Juli 2025 – führte vier neue Pflichtfelder für Stahl- und Aluminiumimporte gemäß Abschnitt 232 ein: Land des Schmelzens und Gießens, Primäres Land des Erschmelzens, Sekundäres Land des Erschmelzens und Land des Aluminiumschmelzens und -gießens. Diese Felder erfordern Rückverfolgbarkeitsdaten, die oft nicht auf einer Standard-Handelsrechnung erscheinen, was Importeure zwingt, zusätzliche Dokumente von Lieferanten anzufordern und diese in noch mehr Deklarationsfelder zu übertragen.
Gleichzeitig erfordern die EU-SAD-Updates 2025 im Rahmen des CO2-Grenzausgleichssystems (CBAM – Verordnung (EU) 2023/956) CO2-Emissionsdaten pro Verkehrsträger. Die Corporate Sustainability Due Diligence Directive (CSDDD) verlangt Erklärungen über das Fehlen von Konfliktmineralien oder Zwangsarbeit in der Produktion. Jedes neue Regulierungsfeld ist ein weiterer Datenpunkt, der aus einem Lieferantendokument extrahiert, korrekt übertragen und fristgerecht eingereicht werden muss. Die Fehleranfälligkeit bei der Compliance wächst mit jeder regulatorischen Aktualisierung.
Semantische Extraktion vs. Positionsbasierte Extraktion: Warum es für den Zoll wichtig ist
Die Kernbeschränkung der Template-OCR in der Zollabwicklung ist nicht technischer Natur – sie ist architektonisch. Die positionsbasierte Extraktion geht von einer stabilen Beziehung zwischen der physischen Position eines Feldes auf der Seite und seiner Bedeutung aus. Zollerklärungen verletzen diese Annahme auf jeder Ebene von Natur aus.
Ein positionsbasiertes Tool, das auf dem CBP-Formular 7501 trainiert wurde, lernt, dass das Ursprungsland in Block 11 steht – etwa ein Drittel der Seite hinunter in der linken Spalte. Wenn dasselbe Tool auf eine SAD trifft, sucht es an denselben Koordinaten nach Daten und findet stattdessen die Identifikationsnummer des Anmelders. Die Extraktion ist falsch, und das Tool hat keinen Mechanismus, um zu erkennen, dass es falsch liegt, weil es nicht versteht, was „Ursprungsland“ bedeutet – es weiß nur, wo es normalerweise steht.
Die semantische Extraktion – manchmal auch als intentbasierte oder templatefreie Extraktion bezeichnet – kehrt diese Beziehung um. Anstatt Positionen abzubilden, bildet sie Bedeutung ab. Sie teilen dem System mit, was Sie wollen: „Ursprungsland“, „HTS-Code“, „Gestellungswert“, „Identifikationsnummer des Importeurs“. Die KI liest jedes Dokument – ob es sich um ein CBP 7501, eine EU-SAD, eine japanische Importanmeldung oder eine Handelsrechnung eines Lieferanten handelt – und lokalisiert die Daten, die jeder Felddefinition entsprechen, unabhängig davon, wo sie auf der Seite erscheinen oder wie sie beschriftet sind.
Dies ist der Unterschied zwischen dem Programmieren eines Tools zum Lesen eines Dokumentformats und dem Lehren eines Tools, zu verstehen, wie Zolldaten über alle Formate hinweg aussehen. Der erste Ansatz skaliert mit der Anzahl der Dokumentvorlagen, die Sie verwalten. Der zweite Ansatz funktioniert mit jedem Dokument, das die gesuchten Informationen enthält.
Speziell für Zollerklärungen bewältigt die semantische Extraktion drei strukturelle Herausforderungen, die positionsbasierte Tools scheitern lassen:
1. Feldnamen-Variation über Dokumente hinweg. Derselbe Datenpunkt erscheint unter verschiedenen Bezeichnungen in verschiedenen Rechtsordnungen: „HTS Number“ (USA), „Commodity Code“ (EU), „HS Code“ (WCO-Konventionssprache), „Tariff Code“ (UK), „統計品目番号“ (Japan). Ein semantisches System erkennt diese als dieselbe Entität. Ein Templatesystem sieht sie als nicht zusammenhängend an – was ein separates Template für jede Bezeichnungskonvention erfordert.
2. Integration unterstützender Dokumente. Zollanmeldungen stehen nicht für sich allein. Sie werden aus Daten zusammengestellt, die über Handelsrechnungen, Packlisten, Konnossemente, Ursprungszeugnisse und Lieferantenerklärungen verteilt sind. In einem traditionellen Arbeitsablauf liest jemand jedes Dokument und tippt die Werte in das Anmeldeformular. Mit semantischer Extraktion können Sie den gesamten Dokumentensatz stapelweise hochladen – Handelsrechnungen von fünf Lieferanten plus Packlisten plus Konnossemente – und alle anmelderelevanten Felder in einer einzigen Tabelle extrahieren. Die Ausgabe wird direkt auf die Felder abgebildet, die Sie für die Einreichung benötigen, unabhängig davon, welches Quelldokument welchen Datenpunkt enthielt.
3. Toleranz gegenüber handschriftlichen und gescannten Dokumenten. Zollagenten erhalten häufig handschriftliche Handelsrechnungen von kleineren Überseelieferanten, gescannte Konnossemente mit Stempeln und Vermerken sowie Ursprungszeugnisse, die gefaxt und erneut gescannt wurden. Herkömmliche OCR-Systeme haben Probleme mit Dokumenten, die nicht maschinell erstellt wurden. Semantische Extraktion, unterstützt durch Vision-KI (große multimodale Modelle, die Bilder als Bilder verarbeiten, anstatt sie zuerst in Text umzuwandeln), liest handschriftliche Werte, entschlüsselt überlagerten Text auf Stempeln und verarbeitet Artefakte aus mehreren Scangenerationen – die Art von Dokumenten, die täglich im Posteingang eines Zollagenten eintreffen.
Dateien werden sicher verarbeitet und nicht gespeichert.
Versuchen Sie, die Felder einzugeben, die Sie für eine Zollanmeldung benötigen – eine Warenbeschreibung, einen angemeldeten Wert, ein Ursprungsland – und beobachten Sie, wie die KI jedes einzelne findet, unabhängig davon, wo es auf dem Dokument steht. Derselbe Mechanismus, der Rechnungsdaten aus einem Layout extrahiert, extrahiert zollrelevante Felder aus jedem Dokumenttyp ohne dokumentenspezifische Konfiguration.
Ein praktischer Workflow zur Extraktion von Zolldaten
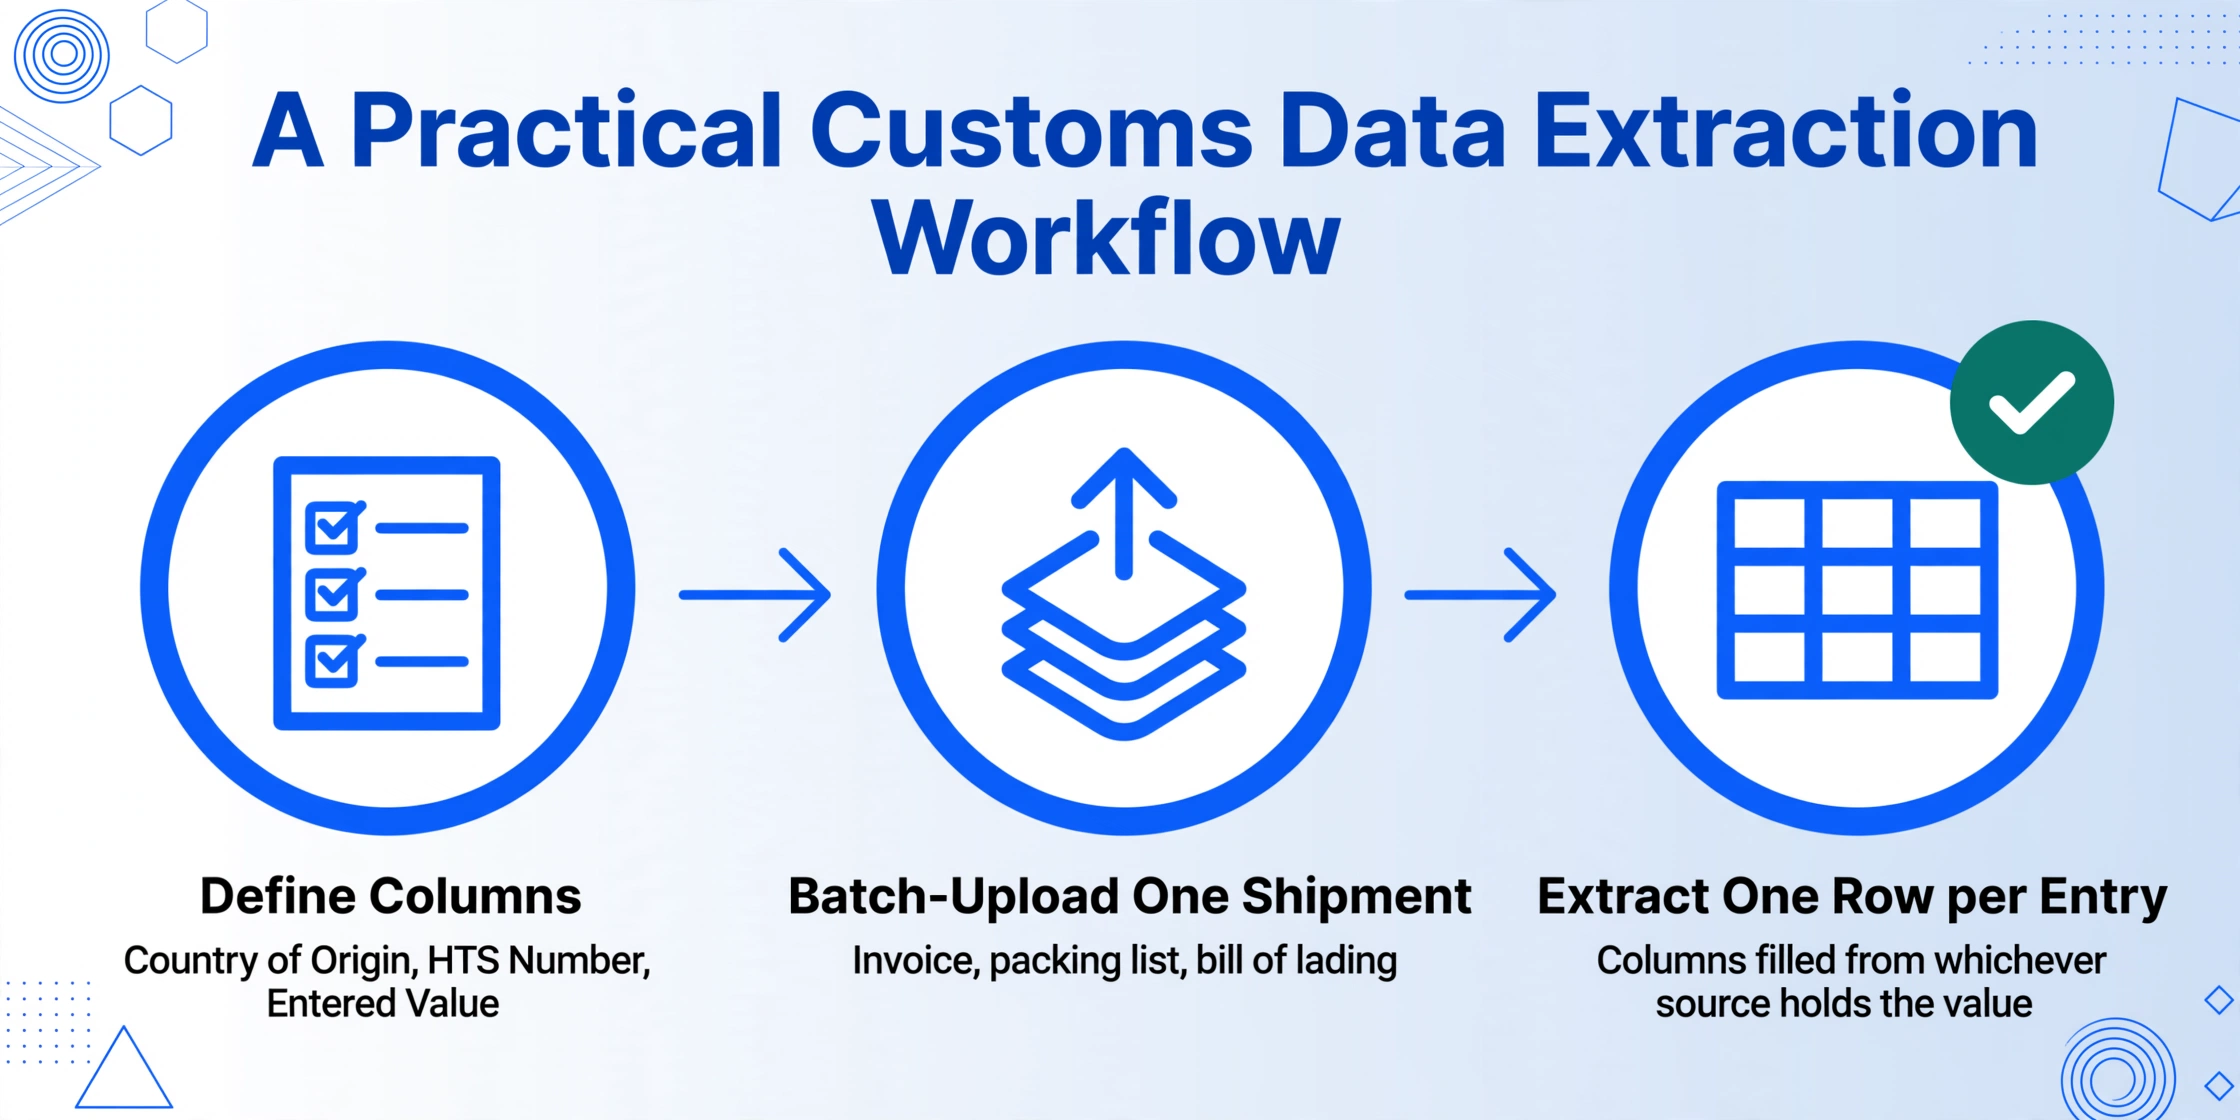
Die Umstellung von manueller Transkription auf semantische Extraktion erfordert nicht den Austausch Ihres Zollanmeldesystems. Sie ersetzt den Datenerfassungsschritt, der in dieses System führt. So könnte ein Importeur, der 50 Sendungen pro Monat über drei Handelsrouten abwickelt, den Workflow umstrukturieren:
Identifizieren Sie die Anmeldefelder, die Sie benötigen. Für US-Anmeldungen über das CBP Form 7501 gehören zu den wichtigsten extrahierbaren Feldern: Entry Number, Importer of Record, Country of Origin, HTS-Nummer (10-stellig), Description of Merchandise, Entered Value, Quantity, Port Code und Mode of Transport. Für EU-SAD-Anmelder: Warencode, Ursprungsland (Feld 16), Empfänger (Feld 8), angemeldeter Wert, Nettomasse und Verfahrenscode (Feld 37). Definieren Sie diese einmal als Ihre Extraktionsspalten.
Laden Sie die Belegunterlagen für jede Sendung im Stapel hoch. Für eine einzelne Zollanmeldung umfasst dies in der Regel: die Handelsrechnung, die Packliste, das Konnossement oder den Luftfrachtbrief, das Ursprungszeugnis sowie etwaige Lieferantenerklärungen. Laden Sie diese gemeinsam in einen einzigen Stapel hoch – die Extraktionsengine behandelt sie als einen Belegsatz und füllt die Spaltenfelder aus der jeweiligen Quelle, die den Wert enthält.
Führen Sie die Extraktion über den Stapel aus. Die KI liest jedes Dokument, findet die Daten, die Ihren Spaltendefinitionen entsprechen, und füllt eine einheitliche Tabelle. Eine Zeile pro Anmeldung, mit Spalten für jedes Anmeldefeld. Handschriftliche Werte auf der Packliste, maschinell gedruckte HS-Codes auf der Handelsrechnung und gestempelte Ursprungserklärungen auf dem Zertifikat – alles in dieselbe strukturierte Ausgabe extrahiert.
Validieren Sie anhand des Anmeldeformulars. Vergleichen Sie vor der Abgabe die extrahierten Daten mit Ihren beabsichtigten Anmeldewerten. Das Tabellenformat macht Abweichungen auf einen Blick sichtbar – eine vertauschte Ziffer im HS-Code, eine fehlende Ursprungserklärung, eine Wertabweichung zwischen Rechnung und Packliste. Korrigieren Sie die Ausnahmen, nicht jedes Feld.
Melden Sie über Ihr bestehendes System an. Ob Sie ACE (US), CDS (UK) oder das Portal eines Zollagenten verwenden – die validierten Daten fließen ohne erneutes Abtippen in das Anmeldesystem. Der Extraktionsschritt übernimmt die Umwandlung von Dokument zu Daten. Die Anmeldung erfolgt mit Daten, die bereits gegen die Quelldokumente abgeglichen wurden.
Für Makler oder Importeure, die über Google Sheets als Zwischenstufe arbeiten — ein häufiges Muster bei kleineren Firmen, die Anmeldedaten in Tabellen vorbereiten, bevor sie sie einreichen — macht das Google-Sheets-Add-on den Upload-Download-Schritt komplett überflüssig. Die Extraktionsergebnisse landen direkt in der Tabelle, in der die Anmeldedaten zusammengestellt werden.
Für Firmen, die Dokumente von mehreren Lieferanten oder Kunden sammeln, ermöglicht ein Sammellink externen Parteien, ihre Rechnungen und Zertifikate direkt in eine Verarbeitungswarteschlange hochzuladen — ohne Anmeldung auf Lieferantenseite, ohne E-Mail-Anhänge, denen man hinterherlaufen muss. Die Dokumente kommen nach Quelle vorsortiert an und sind bereit für die Batch-Extraktion in Anmeldefelder.
Der regulatorische Verlauf: Warum es ab hier schwieriger wird
Das Argument für die Automatisierung der Zolldatenextraktion betrifft nicht nur die heutige Arbeitslast. Es geht darum, wohin sich die Handelscompliance-Regulierung entwickelt.
Der globale Handel erreichte 2024 laut UNCTAD Global Trade Update einen Rekordwert von 33 Billionen US-Dollar — ein Anstieg von 3,7 % gegenüber 2023. Das Volumen der weltweit eingereichten Zollanmeldungen steigt parallel dazu, wobei der Handel der Entwicklungsländer jährlich um 4 % wächst. Mehr Handel bedeutet mehr Anmeldungen. Mehr Anmeldungen bedeuten mehr Datenpunkte, die extrahiert, übertragen und geprüft werden müssen.
Gleichzeitig nimmt die Datendichte pro Anmeldung zu. Die CBAM-Berichtspflichten der EU fügen jedem SAD für betroffene Waren Emissionsdatenfelder hinzu. Die US-Erweiterung von Section 232 fügt vier Felder pro Stahl- oder Aluminiumeintrag hinzu — Felder, die Rückverfolgbarkeitsdaten erfordern, die in Standard-Handelsrechnungen oft fehlen. Das Import Control System 2 (ICS2) der EU schreibt nun Vorab-Frachtinformationen für alle Transportarten vor, nicht nur für Luft- und Seefracht. Jede regulatorische Aktualisierung erhöht die Zahl der unabhängig extrahierbaren Datenpunkte pro Anmeldung — und damit die Zahl potenzieller Übertragungsfehlerquellen.
Der SAFE Framework of Standards der Weltzollorganisation treibt weiterhin Programme für zugelassene Wirtschaftsbeteiligte (AEO) voran, die Compliance-Vergangenheit mit beschleunigter Abfertigung belohnen — aber auch die Prüfung der Datengenauigkeit verschärfen. Ein AEO-zertifizierter Importeur, der konsistente, korrekte Anmeldungen einreicht, bewegt Waren schneller. Ein Importeur mit einer Historie von Korrekturen und Änderungen sieht sich zunehmend längeren Inspektionswarteschlangen gegenüber. Der Compliance-Datenpfad verstärkt sich selbst.
Importeure, die die Dokumentdatenextraktion jetzt automatisieren, sparen nicht nur Arbeitskosten. Sie bauen eine Compliance-Dateninfrastruktur auf, die sich selbst verstärkt — jeder korrekte Eintrag stärkt das Compliance-Profil, das darüber entscheidet, wie schnell künftige Sendungen abgefertigt werden.
Häufig gestellte Fragen
Kann KI Daten aus dem CBP-Formular 7501 und EU-SAD-Anmeldungen extrahieren?
Ja. Die semantische KI-Extraktion liest beide Formulartypen – sowie deren Begleitdokumente (Handelsrechnungen, Packlisten, Frachtbriefe) – und befüllt die Anmeldefelder unabhängig vom Formularlayout. Der entscheidende Unterschied ist, dass sie versteht, was ein Feld bedeutet (z. B. „Ursprungsland"), anstatt wo es auf der Seite steht. Daher funktioniert dieselbe Spaltendefinition für CBP 7501 Block 11, SAD Feld 16 und jede Lieferantenrechnung, die den Ursprung nennt.
Was ist mit handschriftlichen Handelsrechnungen ausländischer Lieferanten?
Vision-KI-Modelle, die Dokumentbilder direkt verarbeiten (statt sie erst in Text umzuwandeln), können handschriftliche Werte, Stempel und Scans in mehrfacher Kopie lesen. Bei gut lesbarer Handschrift ist die Genauigkeit mit maschinengedrucktem Text vergleichbar. Stark beeinträchtigte Dokumente – mehrfach gefaxt, wassergeschädigt, extreme Schreibschrift – haben eine geringere Genauigkeit. In diesen Fällen kann die Extraktion Felder mit geringer Konfidenz zur manuellen Prüfung markieren, anstatt stillschweigend falsche Werte zu liefern.
Brauche ich trotz automatisierter Datenextraktion noch einen Zollbroker?
Ja. Die Datenextraktion übernimmt den Schritt der Umwandlung von Dokumenten in Daten. Ein lizenzierter Zollbroker bietet Klassifizierungsexpertise, regulatorische Beurteilung, Compliance-Strategie und die rechtliche Befugnis, Anmeldungen beim CBP einzureichen. Die Automatisierung reduziert den manuellen Übertragungsaufwand – sie ersetzt nicht die fachliche Beurteilung, die für die korrekte Klassifizierung von Waren, die Anwendung von Präferenzabkommen oder die Bewältigung von Durchsetzungsmaßnahmen erforderlich ist. Gemäß 19 CFR 111 bleibt die Sorgfaltspflicht des Brokers unabhängig vom verwendeten Extraktionstool bestehen.
Wie funktioniert das mit der HS/HTS-Code-Klassifizierung?
Extraktionstools lesen den HS-Code aus den Quelldokumenten – sie extrahieren, was geschrieben steht, nicht die korrekte Klassifizierung. Wenn die Rechnung eines Lieferanten einen falschen HS-Code angibt, meldet die Extraktion diesen Code getreu. Die Klassifizierung – die Bestimmung des korrekten 10-stelligen HTS-Codes anhand von Produkteigenschaften, Materialzusammensetzung und Verwendungszweck – bleibt eine fachliche Beurteilungsaufgabe. Der Extraktionsschritt eliminiert Übertragungsfehler (Eingabe von 8471.30 statt 8471.80), ersetzt aber nicht den Klassifizierungsschritt. Manche Importeure nutzen das Extraktionsergebnis als Gegenprüfung: der vom Lieferanten angegebene Code versus der vom Broker klassifizierte Code, nebeneinander zur Abweichungsprüfung vor der Anmeldung.
Wie verhält es sich mit Dokumenten in nicht-lateinischen Schriftzeichen – chinesischen, japanischen, arabischen Lieferantenrechnungen?
Moderne visuelle KI-Modelle sind mehrsprachig – sie können Daten aus Dokumenten in Chinesisch, Japanisch, Koreanisch, Arabisch und anderen nicht-lateinischen Schriften lesen und extrahieren. Die extrahierten Werte können je nach Anforderung der zuständigen Zollbehörde transliteriert oder in ihrer Originalschrift belassen werden. Für japanische Zollanmeldungen (輸入申告書) kann das System Kanji-Werte zusammen mit Warennummern und angemeldeten Werten extrahieren.
Lässt sich dies in ACE / CDS / Zollanmeldesysteme integrieren?
ImageToTable.ai exportiert extrahierte Daten als Excel (XLSX), CSV oder JSON – Formate, die in Zollanmeldeplattformen, ERP-Systeme oder tabellenbasierte Vorbereitungsworkflows importiert werden können. Es übermittelt Anmeldungen nicht direkt an CBP oder EU-Zollbehörden. Die Ausgabe speist sich in Ihren bestehenden Anmelde-Workflow ein. Für Google Sheets-Nutzer schreibt das Add-on extrahierte Daten direkt in die aktive Tabelle, ohne Export-/Import-Schritte.