L'IA peut-elle lire les dossiers vétérinaires ?
Oui — mais l'écriture manuscrite complique la tâche
Oui. L'IA de vision moderne peut extraire des données de dossiers vétérinaires — y compris les notes manuscrites, les formulaires imprimés et les étiquettes d'ordonnance — avec une précision nettement supérieure à celle de l'OCR traditionnel. Mais les dossiers vétérinaires comptent parmi les types de documents les plus difficiles à traiter pour l'IA, car ils combinent un taux d'écriture manuscrite exceptionnellement élevé, une terminologie médicale spécialisée et une quasi-absence de standardisation des formats entre les cliniques.
Points clés à retenir
- Une IA qui atteint 96,9 % de sensibilité sur les dossiers vétérinaires électroniques chute à 65-80 % sur les notes SOAP manuscrites que la plupart des cliniques indépendantes produisent réellement — car « OD : mod gingivitis, stage 2 dental dz » écrit en cursive précipitée met en échec même les meilleurs modèles de vision.
- Le champ le plus difficile de tout dossier vétérinaire est l'ordonnance — une erreur de lecture de posologie est un incident de sécurité patient, pas une simple erreur de saisie, et les noms de médicaments en cursive comme Clavamox combinés à des abréviations comme BID x 14d font chuter la précision sous 70 % sur les ordonnances rédigées à la hâte.
- La vraie valeur ne réside pas dans une extraction parfaite mais dans le passage de 45 minutes de saisie par dossier à 5 minutes de vérification — laissez l'IA extraire les parties imprimées et les tableaux structurés, et concentrez votre attention sur les 10-15 % de champs où l'écriture manuscrite franchit le seuil de lisibilité.
Pourquoi les dossiers vétérinaires sont si difficiles à lire
La médecine vétérinaire est en retard sur la médecine humaine en matière de numérisation. De nombreuses cliniques indépendantes s'appuient encore sur des notes SOAP manuscrites, des résultats de laboratoire imprimés et collés dans des dossiers, et des étiquettes d'ordonnance griffonnées au stylo. Cela crée un ensemble unique de défis :
- Taux élevé d'écriture manuscrite — Contrairement aux hôpitaux humains où la plupart des dossiers sont saisis dans des EHR, de nombreuses cliniques vétérinaires génèrent leurs dossiers à la main. L'écriture cursive, les abréviations et les griffonnages parfois illisibles qui en résultent sont ce que l'OCR traditionnel ne peut tout simplement pas lire.
- Formats non standardisés — Chaque clinique utilise sa propre mise en page de dossiers. La page de vaccination d'une clinique est complètement différente de celle d'une autre — il n'existe pas d'équivalent des normes HL7 ou FHIR de la santé humaine.
- Terminologie médicale et abréviations — Les dossiers vétérinaires mélangent des noms de médicaments latins, une terminologie spécifique à l'espèce et des abréviations propres à chaque clinique (« FIV/FeLV nég », « dkm : 1/2 comprimé BID × 10 j »).
- Qualité variable des documents — Les dossiers arrivent sous forme de photocopies, de télécopies, de photos téléphoniques en basse résolution ou de papier thermique décoloré. Chaque type de dégradation perturbe une partie différente du pipeline d'extraction.
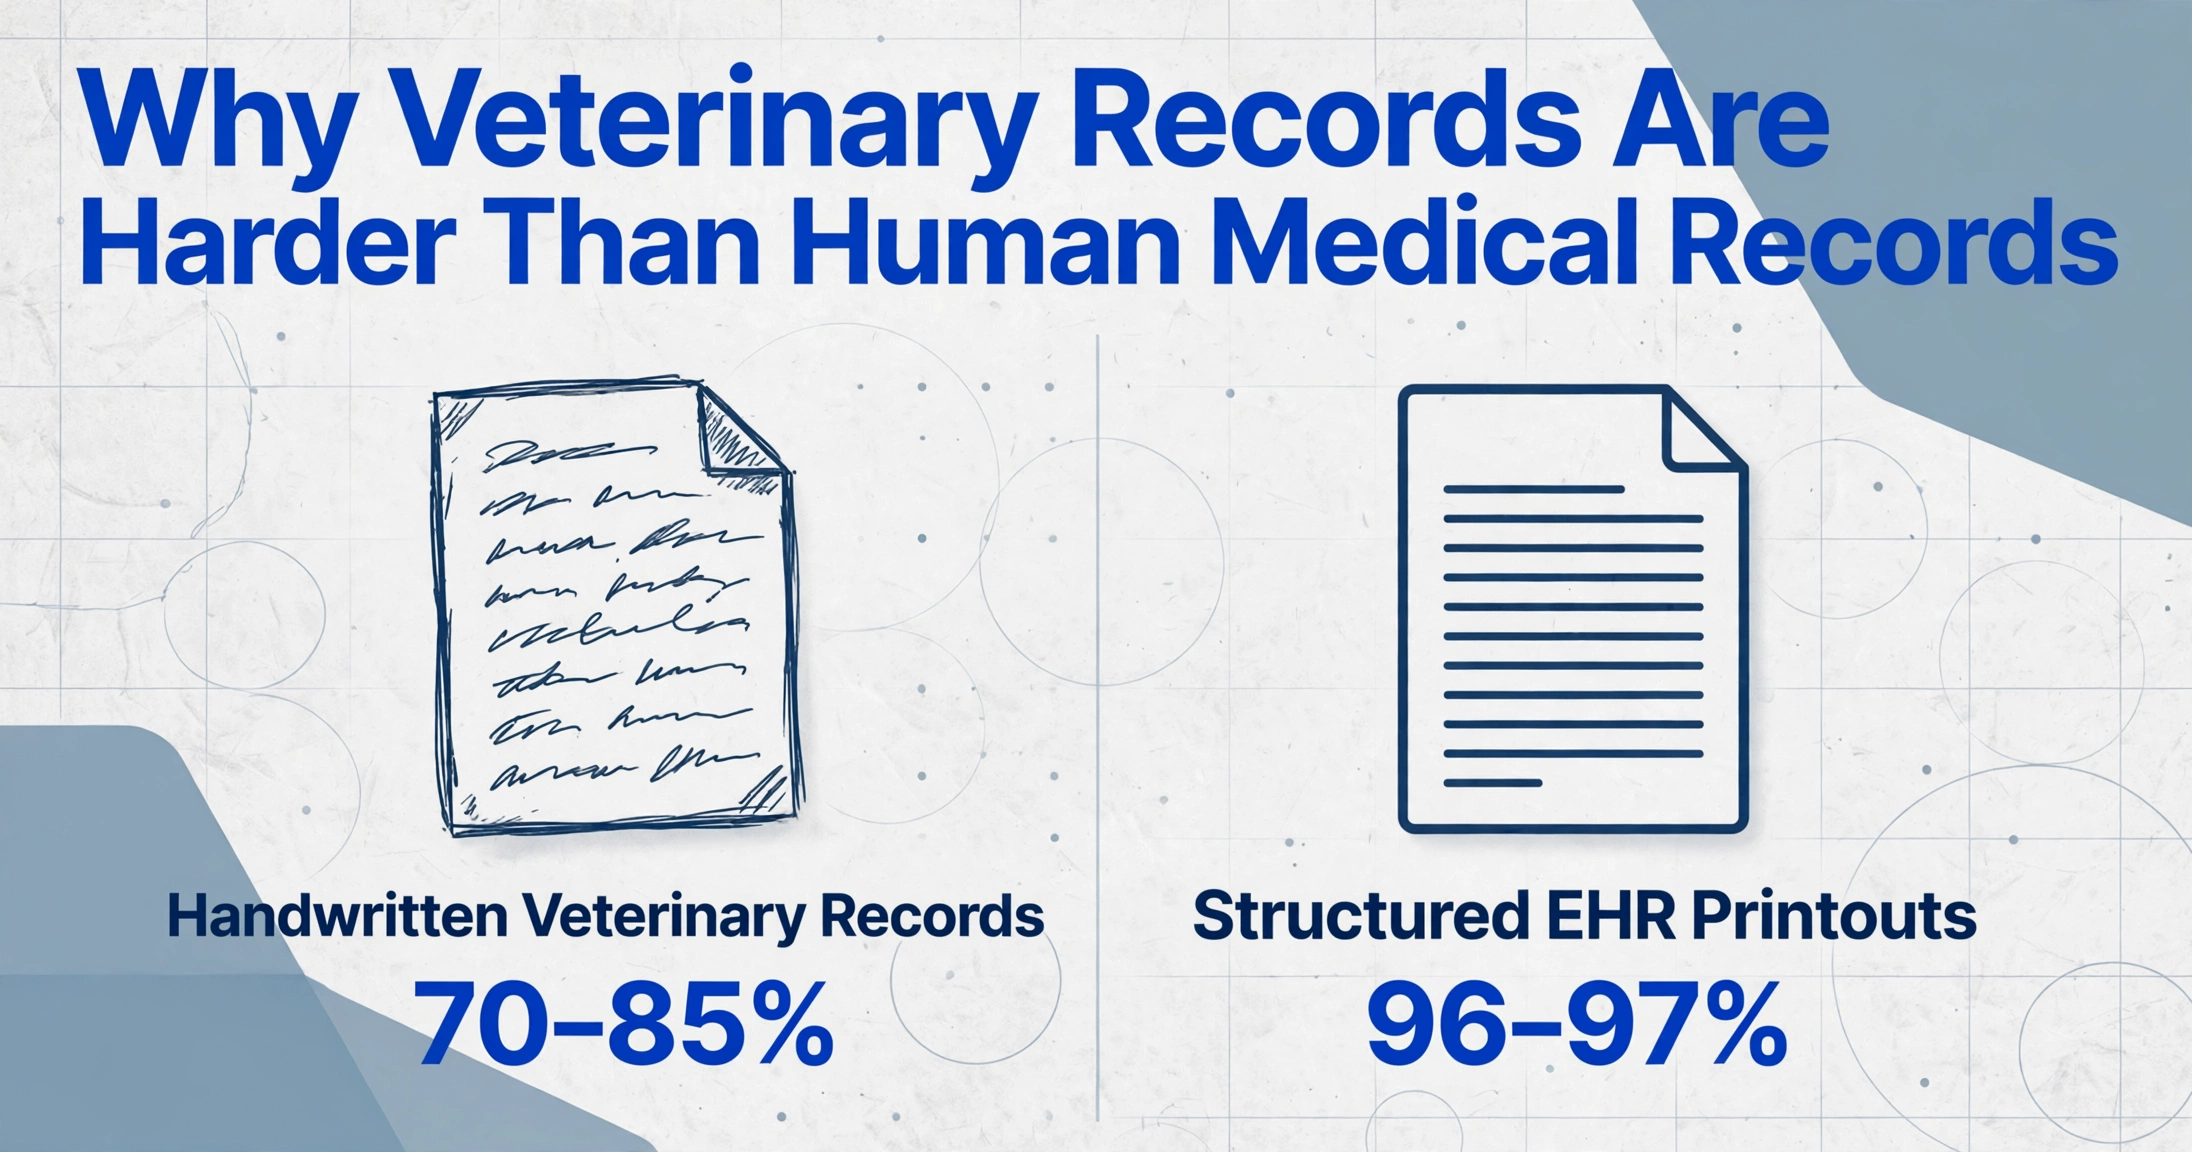
Cela rend les dossiers vétérinaires sans doute plus difficiles à traiter par l'IA que les dossiers médicaux humains, qui bénéficient d'impressions EHR structurées. Pourtant, les cliniques vétérinaires traitent des milliers de dossiers chaque jour pour la documentation des soins de santé, les réclamations d'assurance et les références — en y consacrant manuellement 15 à 45 minutes par dossier.
Analyse champ par champ : ce que l'IA lit réellement
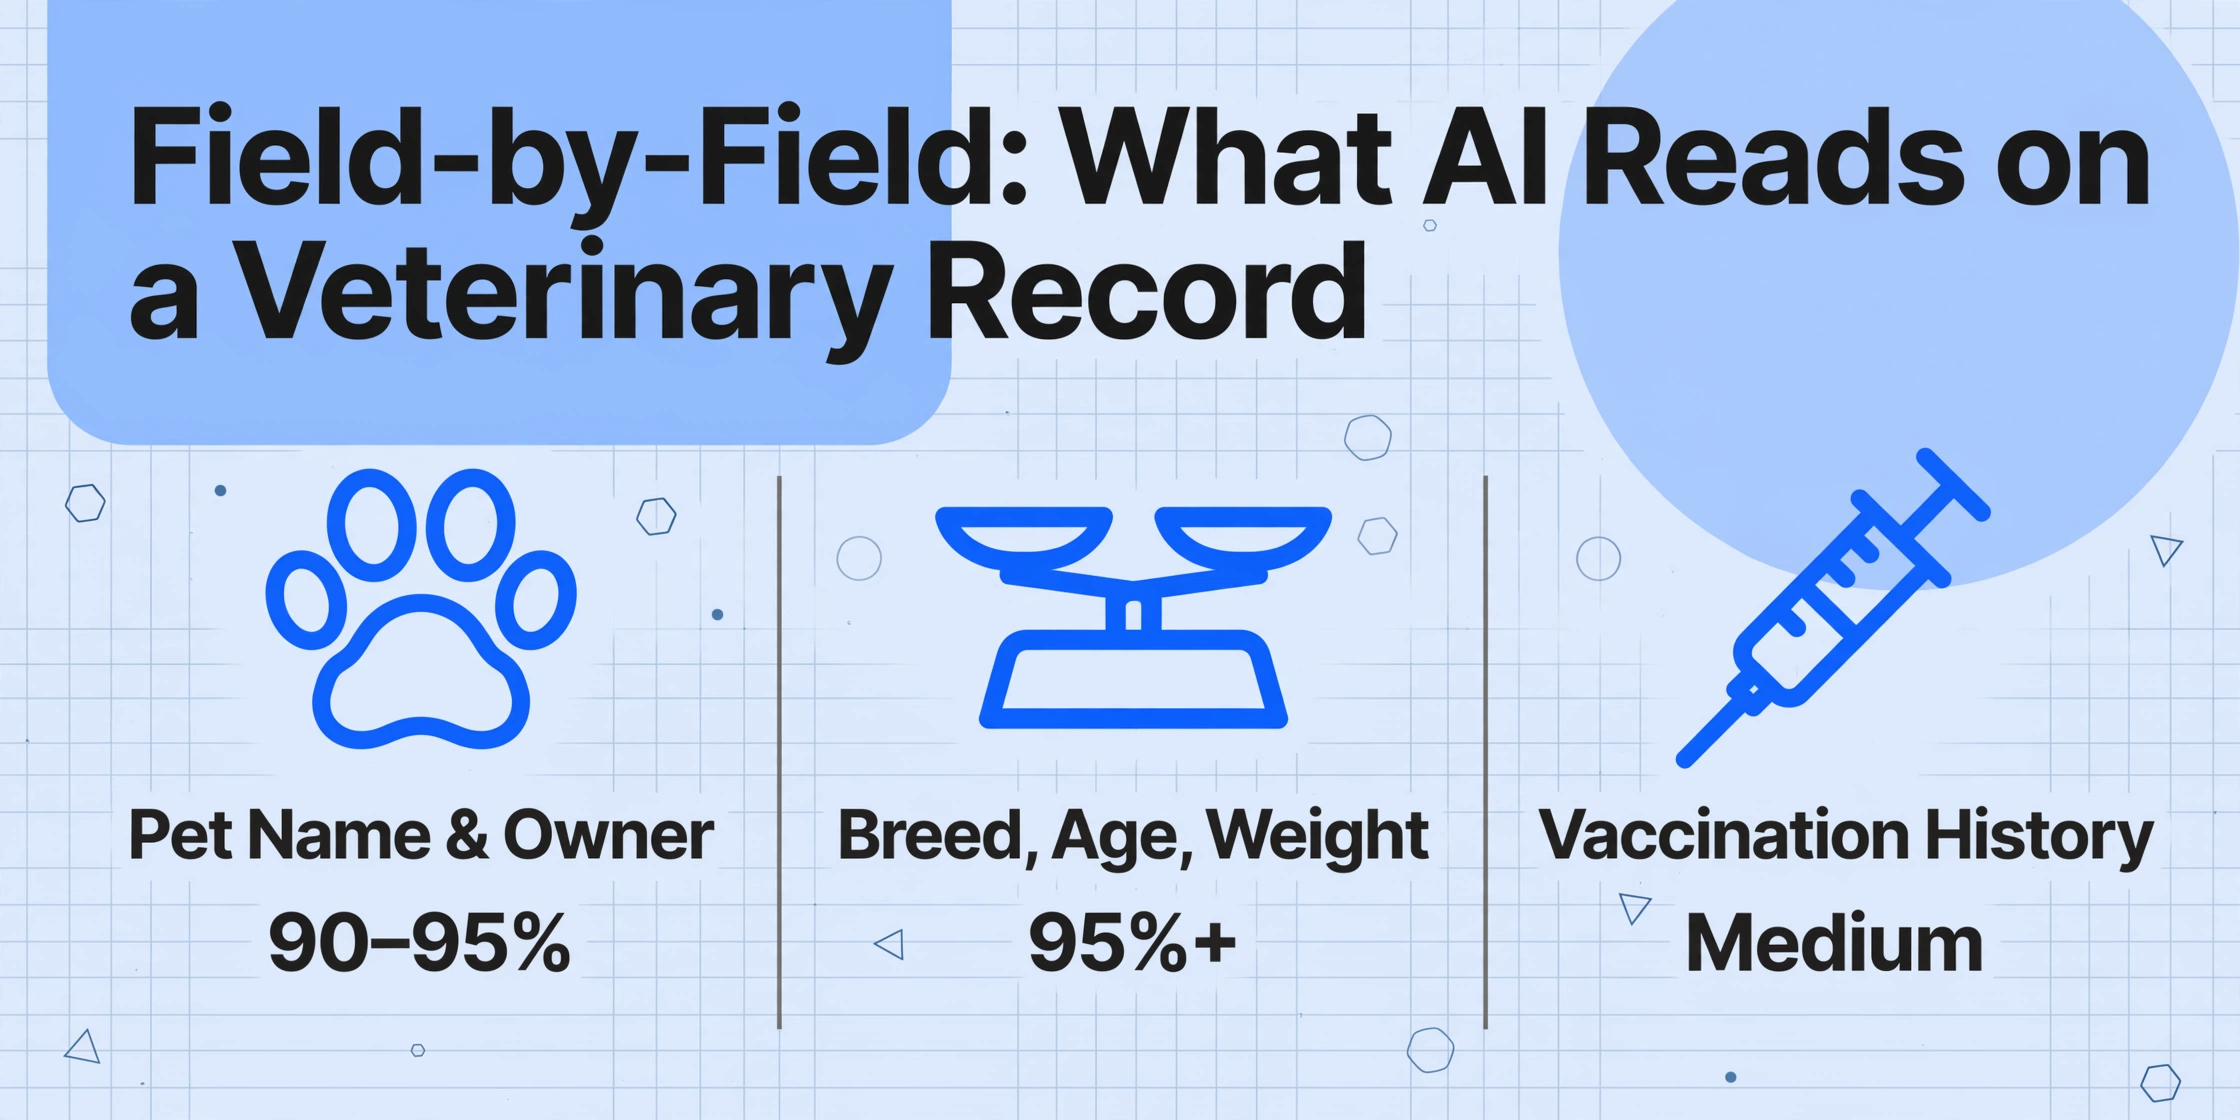
Tous les champs d'un dossier vétérinaire ne présentent pas la même difficulté. Certains sont systématiquement faciles pour l'IA ; d'autres repoussent les limites de ce qui est possible aujourd'hui. Voici une évaluation réaliste champ par champ.
Nom de l'animal et informations sur le propriétaire
Difficulté : faible à moyenne. Les noms d'animaux sont généralement écrits à la main sur les formulaires d'admission, mais ils sont courts, souvent écrits lisiblement, et suivent des schémas prévisibles (« Max », « Bella », « Luna »). Les noms des propriétaires et leurs coordonnées sur le même formulaire sont tout aussi extractibles. Les modèles de vision-langage modernes (VLM) les traitent confortablement avec une précision de 90 à 95 % lorsque l'écriture est lisible. Les problèmes surviennent uniquement lorsque l'encre est pâle ou que le nom est écrit en cursive qui se prolonge sur la ligne suivante.
Race, âge et poids
Difficulté : faible. Ce sont parmi les champs les plus faciles. La race est souvent imprimée sur l'en-tête du formulaire (cases à cocher ou champs prédéfinis). L'âge et le poids sont des valeurs numériques courtes — « 3 ans », « 14,2 kg » — écrites en chiffres que les VLM lisent avec une grande fiabilité. Même manuscrits, les chiffres sont plus cohérents que le texte en cursive. Attendez-vous à une précision de 95 % et plus sur des dossiers de qualité raisonnable.
Historique de vaccination
Difficulté : moyenne. Les dossiers de vaccination se présentent sous deux formes : des tableaux structurés (date, nom du vaccin, numéro de lot, prochaine date de rappel) et des notes manuscrites en texte libre. Le format tableau est simple — l'IA extrait les lignes colonne par colonne, comme elle traite tout tableau structuré. Les notes de vaccination manuscrites sont plus difficiles car elles mélangent des abréviations (« DHPP », « FeLV », « rage »), des dates et des numéros de lot dans des agencements imprévisibles. Attendez-vous à 85–90 % pour les dossiers au format tableau et 70–80 % pour les entrées manuscrites en texte libre.
Diagnostic et notes cliniques
Difficulté : Élevée. Une note de diagnostic pourrait se lire : « OD : gingivite modérée, stade 2 de la maladie dentaire. Plan : détartrage sous AG, radiographies complètes. » Le mélange d'abréviations (« OD » = œil droit, « dz » = maladie, « GA » = anesthésie générale), de termes latins et de conditions spécifiques à l'espèce exige une connaissance du domaine — pas seulement une reconnaissance de caractères. Une étude de Wulcan et al. (Frontiers in Veterinary Science, 2025) a constaté que GPT-4 Omni atteint une sensibilité de 96,9 % et une spécificité de 97,6 % pour l'extraction des signes cliniques à partir de dossiers vétérinaires électroniques. Mais sur les notes de diagnostic manuscrites, la précision réelle chute à une estimation de 65 à 80 %, selon fortement la lisibilité.
Prescription et posologie
Difficulté : Maximale. Les prescriptions combinent des noms de médicaments manuscrits (« Clavamox », « Metronidazole »), des dosages numériques (« 12,5 mg/kg ») et des fréquences d'administration (« BID × 14 j »). Une erreur de lecture du dosage est un risque pour la sécurité du patient, pas seulement une erreur de saisie. Ce domaine exige le niveau de précision le plus élevé. Sur une écriture claire, attendez-vous à une précision de 80 à 85 %. Sur des ordonnances rédigées à la hâte, elle peut tomber à 60–70 %.
Le constat honnête : L'OCR des dossiers vétérinaires n'est pas un problème résolu dans l'ensemble. Pour le contenu imprimé ou formaté en tableaux, la précision est excellente. Pour les notes cliniques et les prescriptions fortement manuscrites, l'IA actuelle fonctionne mieux comme outil d'assistance — elle extrait ce qu'elle peut et signale le reste pour examen humain.
Là où l'extraction par IA excelle
Malgré les défis, plusieurs parties des dossiers vétérinaires sont bien gérées par l'IA de vision moderne — dans certains cas, bien mieux que l'OCR traditionnel.
Formulaires imprimés et cases à cocher. Les formulaires d'admission pré-imprimés, les formulaires de consentement et les carnets de vaccination avec étiquettes imprimées et cases à cocher sont triviaux à lire pour l'IA. Les cases à cocher — cochées, barrées ou entourées — sont reconnues de manière fiable, ce que l'OCR traditionnel n'a jamais bien géré.
Résultats de laboratoire et impressions de diagnostic. Les analyses sanguines et les résultats d'urinalyse imprimés depuis les analyseurs sont propres et structurés. L'extraction des données des rapports de laboratoire suit les mêmes schémas que les laboratoires médicaux humains — l'IA lit les noms des analytes, les valeurs et les plages de référence avec une précision supérieure à 95 %.
Dossiers numériques des systèmes de gestion de cabinet. Les cliniques utilisant ezyVet, Vetspire, Avimark, Cornerstone ou des PMS similaires produisent des impressions numériques propres. L'extraction par IA sur ceux-ci est quasi parfaite — cohérente avec la conclusion de Wulcan et al. d'une précision de 96 à 97 % sur les dossiers électroniques.
Le point clé : plus le dossier est structuré, plus la précision est élevée. L'extraction par IA sans modèle gère mieux les cas non structurés que les outils basés sur des modèles (qui nécessiteraient un modèle séparé pour chaque disposition de clinique), mais la structure aide toujours.
Là où cela reste difficile
Reconnaître ses limites renforce la confiance. Voici les scénarios où l'extraction de dossiers vétérinaires risque le plus d'échouer — et pourquoi.
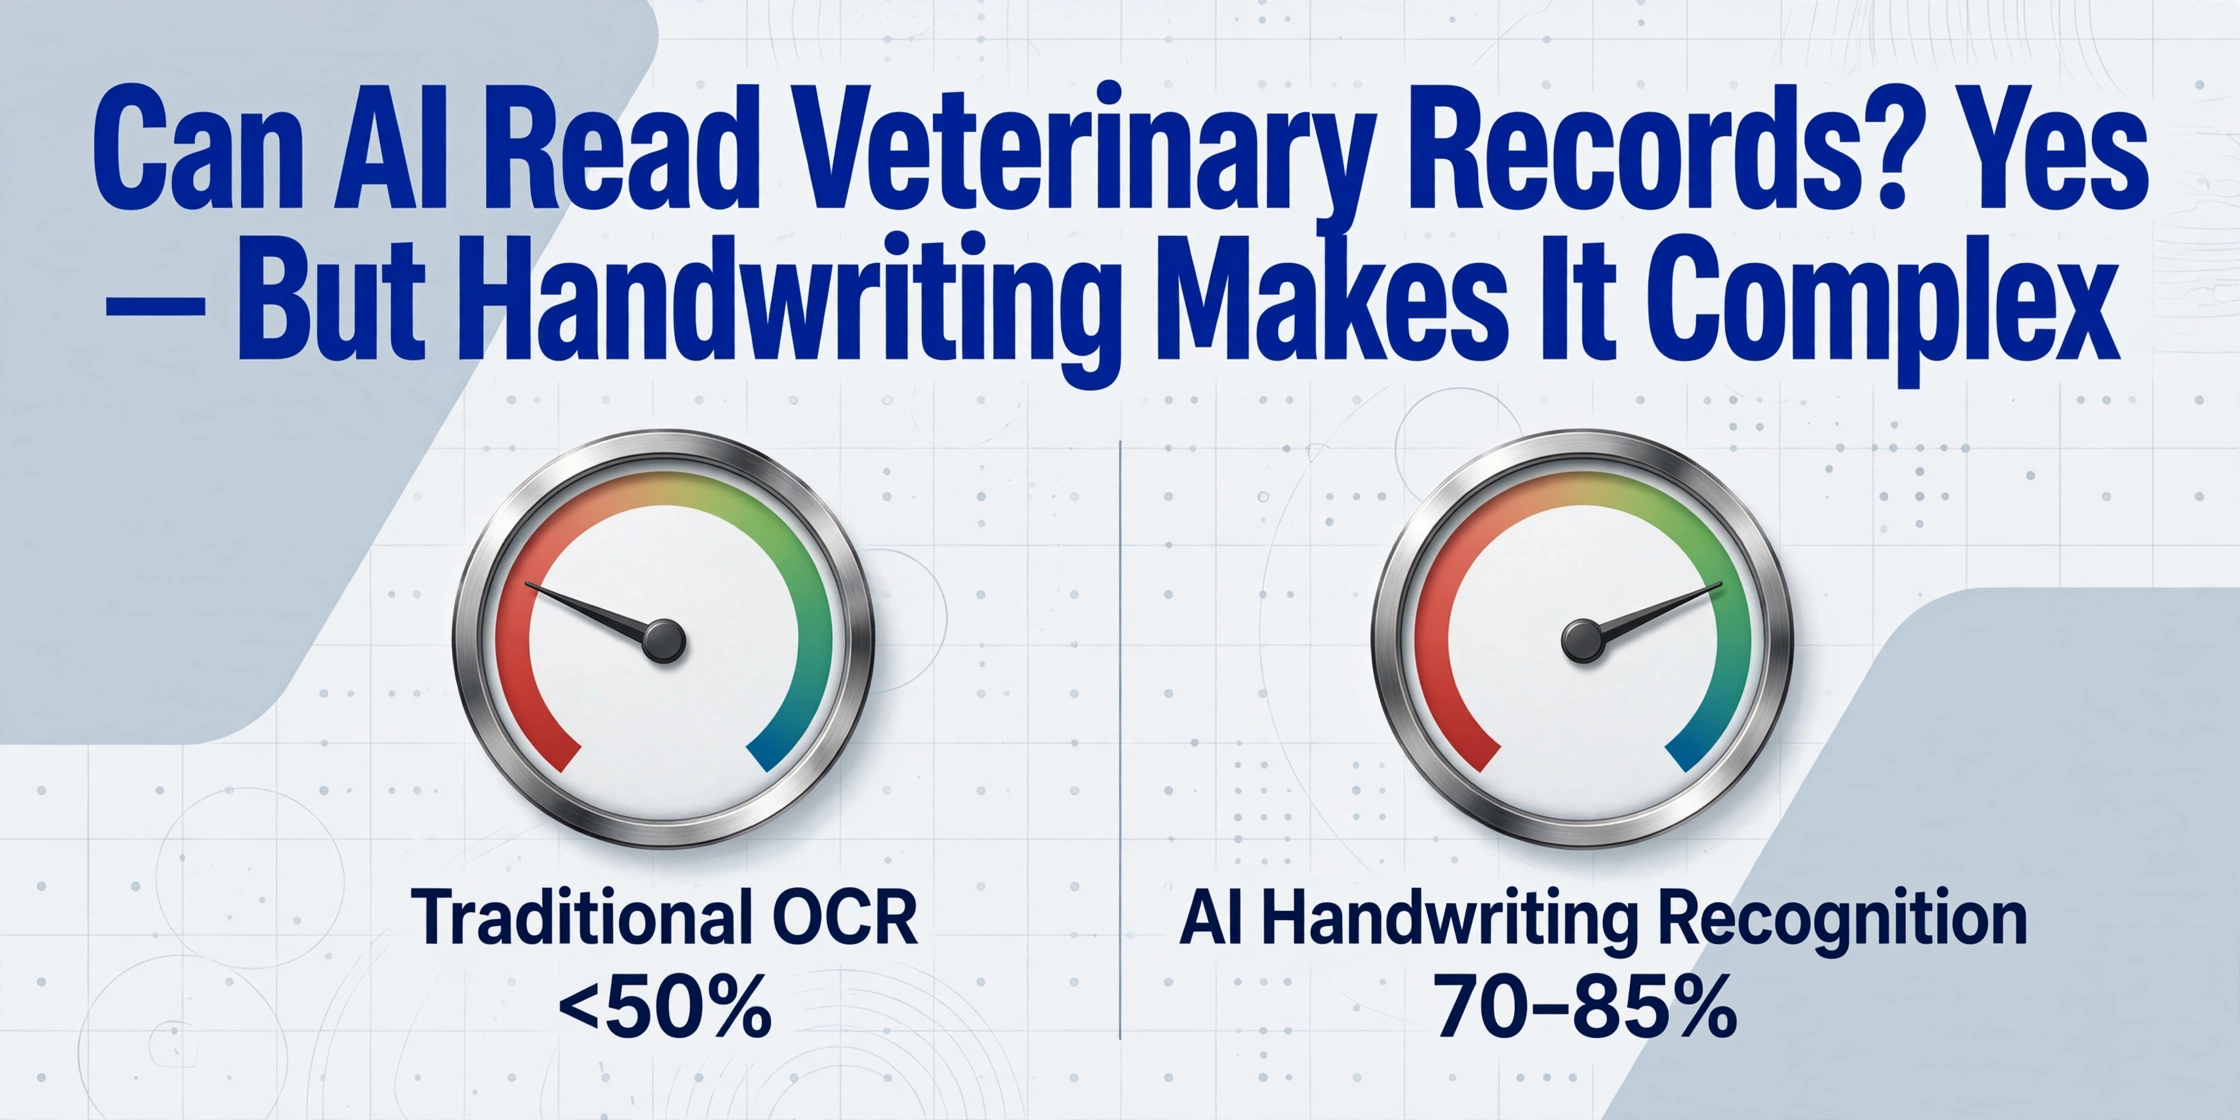
Écriture cursive illisible. C'est le principal obstacle. Les notes rédigées à la hâte par un vétérinaire — boucles sans limites de lettres claires, mots qui se chevauchent — peuvent déjouer même les meilleurs modèles de vision. L'OCR traditionnel tombe sous les 50 % sur la cursive. Les VLM modernes font mieux (70–85 % sur une cursive modérée), mais si un pharmacien ne peut pas lire la note originale, l'IA ne le pourra pas non plus.
Scans et télécopies de mauvaise qualité. Les dossiers transmis entre cliniques par télécopie à 150 DPI introduisent des artefacts qui brouillent les limites des caractères. Le papier thermique s'estompe avec le temps, transformant un texte noir en gris sur gris clair.
Abréviations non standard. Contrairement aux codes standardisés ICD-10 et CPT de la médecine humaine, la médecine vétérinaire repose sur des raccourcis propres à chaque clinique. « R/O » (rule out), « DJD » (degenerative joint disease), « HBC » (hit by car) — ces abréviations sont lisibles en tant que caractères, mais leur signification dépend d'un contexte qu'une IA généraliste peut ne pas résoudre correctement.
Comment obtenir de meilleurs résultats avec l'extraction de dossiers vétérinaires
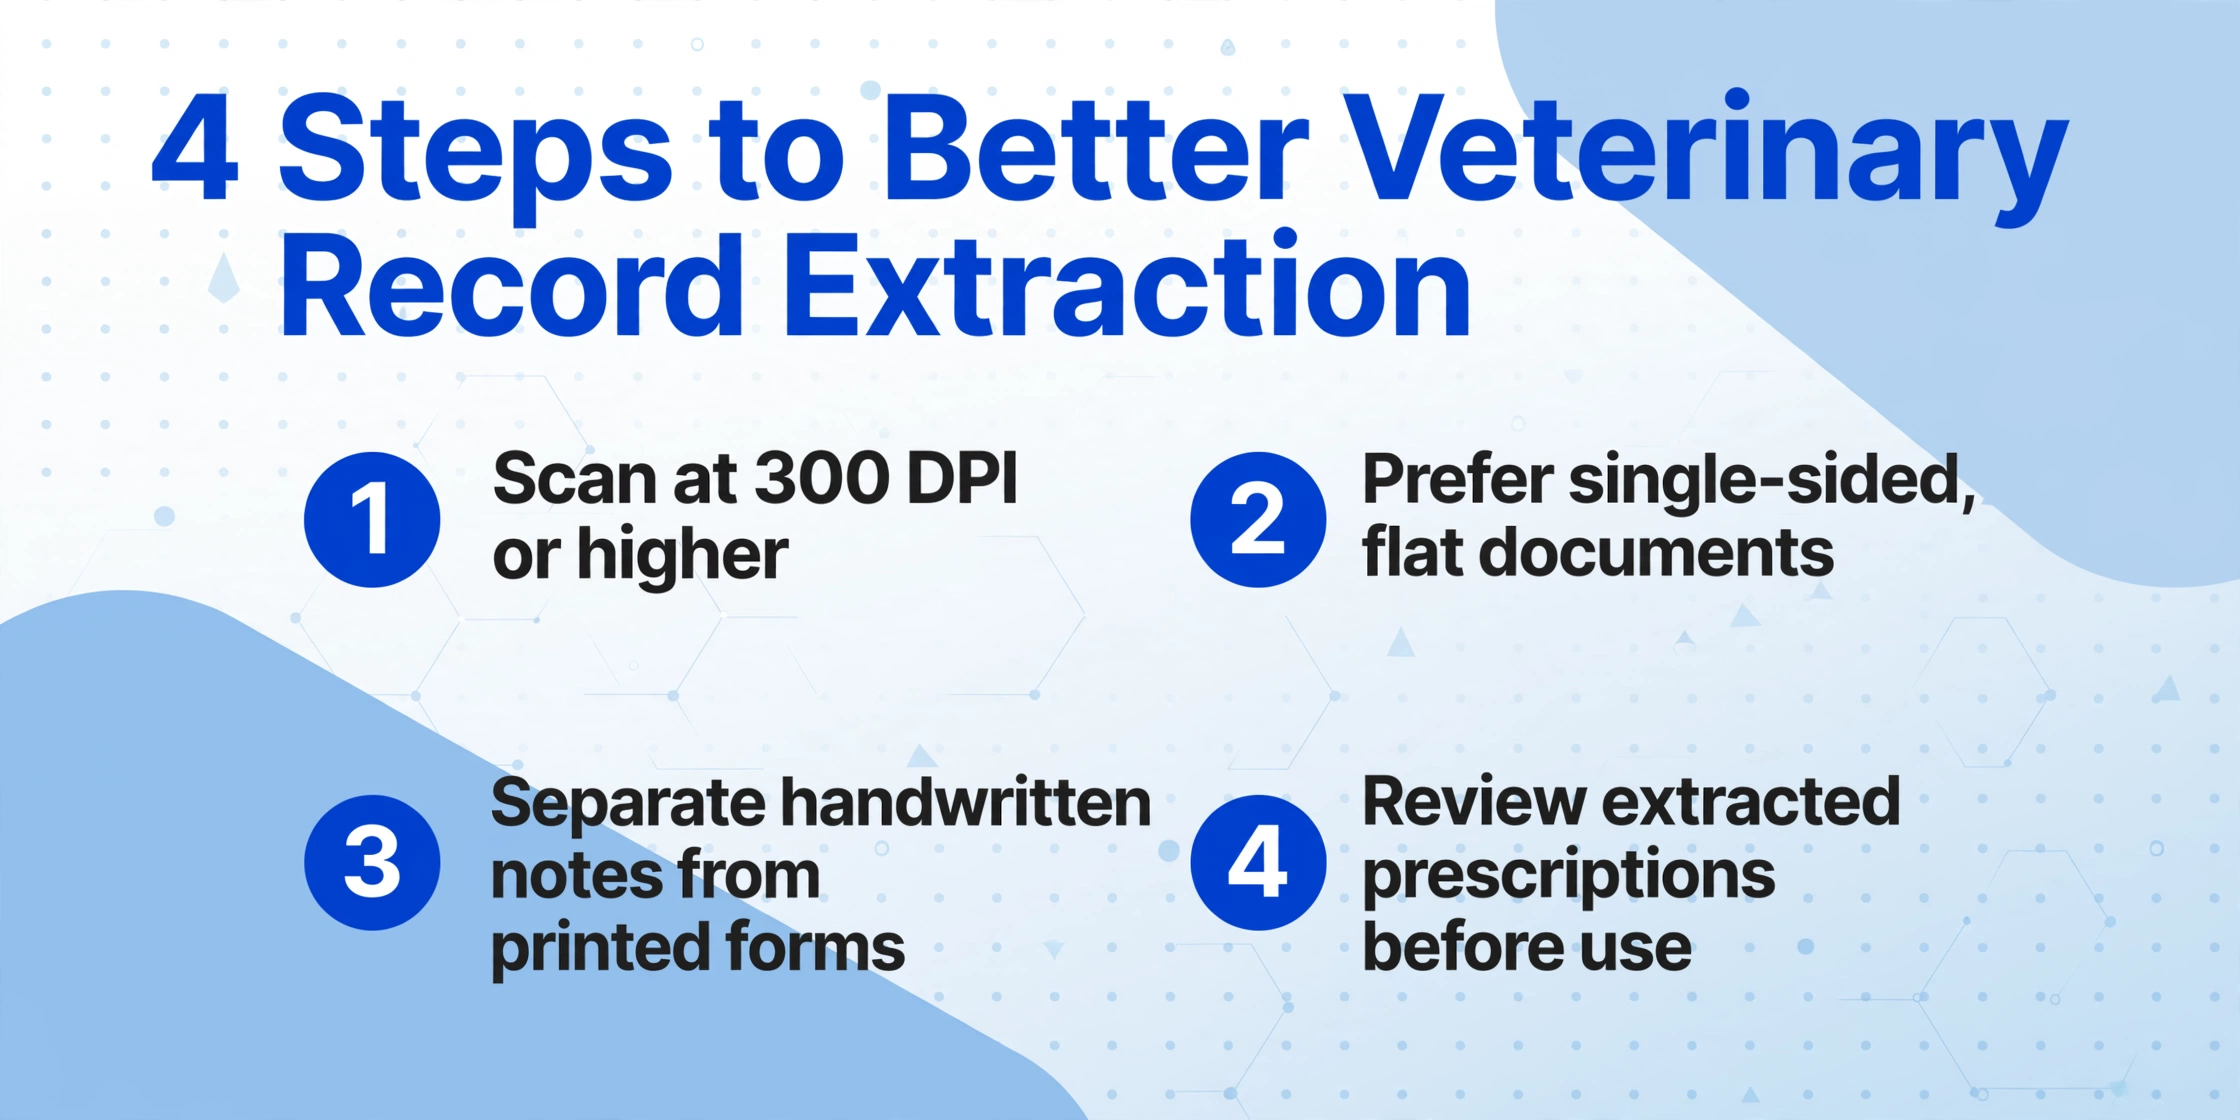
Si vous êtes gestionnaire de clinique ou professionnel vétérinaire cherchant à numériser des dossiers, ces étapes pratiques amélioreront considérablement la précision de l'extraction par IA :
Ces étapes ne suppriment pas la nécessité d'une relecture, mais elles font passer l'équilibre de « l'IA doit tout revérifier » à « l'IA a obtenu 85 à 90 % de bonnes réponses, je n'ai plus qu'à corriger les parties délicates ». C'est la différence entre 45 minutes de saisie manuelle et 5 minutes de vérification.
Questions fréquemment posées
L'IA peut-elle lire les dossiers vétérinaires manuscrits aussi précisément que les dossiers imprimés ?
Non. L'extraction de texte imprimé atteint une précision de 95 à 99 % sur des documents propres. Le contenu manuscrit varie de 70 à 90 % selon la lisibilité, les notes médicales en cursive se situant à l'extrémité inférieure et les formulaires en lettres majuscules à l'extrémité supérieure. L'étude de Wulcan et al. 2025 montrant une précision de 96 à 97 % s'applique aux dossiers de santé vétérinaires électroniques, et non aux dossiers papier manuscrits.
L'IA doit-elle être formée à la terminologie spécifique à la médecine vétérinaire ?
Non. Les modèles modernes de vision-langage incluent des connaissances médicales générales issues de leurs données d'entraînement, couvrant les noms de médicaments vétérinaires courants, les abréviations (BID, TID, PO, SQ) et les affections spécifiques à chaque espèce. Aucune formation supplémentaire ni collecte d'échantillons n'est nécessaire. Les abréviations largement utilisées seront facilement reconnues, bien que les abréviations propres à une clinique puissent ne pas l'être.
Puis-je extraire des données de dossiers vétérinaires reçus par télécopie ?
Partiellement. Les télécopies à 200 DPI perdent des détails pour l'écriture manuscrite. Le texte imprimé reste lisible, mais les notes manuscrites sur les télécopies sont nettement plus difficiles à traiter. Demandez des scans directs ou des photos lorsque c'est possible.
L'extraction des dossiers vétérinaires par IA est-elle conforme à la réglementation ?
La plupart des lois des États sur l'exercice de la médecine vétérinaire sont neutres quant au format. Les directives sur l'IA de l'AAVSB de 2025 confirment que les dossiers assistés par IA sont soumis aux mêmes réglementations que ceux créés manuellement : le vétérinaire reste responsable de l'exactitude, de l'exhaustivité et de la conservation appropriée (3 à 5 ans selon l'État). Les données extraites par IA, relues et vérifiées, sont généralement conformes.
En quoi l'extraction par IA diffère-t-elle des outils de prise de notes par IA ?
Les outils de prise de notes par IA (PawfectNotes, ScribbleVet, VetGeni) écoutent la conversation entre le vétérinaire et le client et génèrent des notes SOAP à partir de l'audio. L'extraction par IA lit les documents existants — dossiers manuscrits, formulaires imprimés, résultats de laboratoire — et les convertit en données structurées. Une clinique peut utiliser les deux : une IA de prise de notes pour générer de nouveaux dossiers et une IA d'extraction pour numériser les archives papier des années précédentes.
En résumé
Les dossiers vétérinaires font partie des types de documents les plus difficiles à extraire par IA. L'écriture manuscrite, la terminologie médicale, les formats non standardisés et la qualité variable créent des défis que les documents plus simples n'atteignent pas. Mais « difficile » ne veut pas dire « impossible ».
L'IA de vision moderne extrait de manière fiable les parties structurées et imprimées, traite l'écriture manuscrite claire sur les formulaires et assiste dans les notes cliniques complexes. Les 15 à 45 minutes par dossier actuellement consacrées à la saisie manuelle peuvent être réduites à 5 à 10 minutes de vérification assistée par IA.
La limite honnête : les notes diagnostiques cursives et les prescriptions complexes nécessitent encore une relecture humaine. Mais cette limite recule à mesure que les modèles de vision s'améliorent. Ce que vous pouvez faire aujourd'hui : testez sur vos propres dossiers. Téléchargez un échantillon — un carnet de vaccination imprimé, une note SOAP manuscrite, un tirage de laboratoire — et voyez où l'extraction par IA fonctionne pour les documents spécifiques de votre clinique.