5 devis fournisseurs, un tableau comparatif unique :
Comment examiner les prix sans copier-coller
Un professionnel des achats sur Reddit a décrit sa revue trimestrielle des fournisseurs : « 5 fournisseurs, 5 formats PDF, 1 feuille de calcul comparative. Le modèle prend 15 minutes à configurer. Le remplir prend 3 heures. » Son modèle de comparaison fonctionne très bien — mise en forme conditionnelle, notation pondérée, tout l'ensemble. Le goulot d'étranglement, c'est d'extraire les données des PDF et de les intégrer au modèle. C'est cette étape, et non la conception du modèle, qui fait échouer la plupart des flux de comparaison de devis.
Le vrai goulot d'étranglement dans la comparaison des devis, ce n'est pas le tableur
Cherchez « comparaison de devis fournisseurs » et vous trouverez des dizaines de modèles Excel. Matrices de notation pondérées. Mise en forme conditionnelle par prix. Tableaux croisés dynamiques par fournisseur. Graphiques radar pour l'évaluation multicritères. Ce sont tous des problèmes résolus — un utilisateur compétent d'Excel peut construire une feuille de comparaison en 20 minutes.
Le problème non résolu, celui qui fait travailler les équipes achats tard le vendredi, c'est la saisie de données. Cinq devis fournisseurs arrivent sous forme de cinq pièces jointes PDF. Chaque PDF a sa propre mise en page : le fournisseur A place les prix unitaires dans la colonne 3 d'un tableau en page 2. Le fournisseur B détaille tout dans une liste verticale en page 1. Le fournisseur C envoie une image scannée d'un formulaire de devis manuscrit. Votre tableur de comparaison se moque de tout cela — il a juste besoin de chiffres dans des cellules — mais vous devez faire le pont entre « cinq PDF désordonnés » et « un tableur propre ».
Un responsable achats sur r/procurement a demandé comment les autres équipes gèrent cela. Les meilleures réponses étaient des variantes de : filtres Excel, RECHERCHEV, et « copier/coller manuel ». Pas parce qu'il n'existe pas d'outils — mais parce que les outils existants exigent soit une configuration de modèle par fournisseur (ce qui va à l'encontre du but de l'automatisation), soit ce sont des suites achats complètes que les petites et moyennes équipes ne peuvent pas justifier.
Le vrai coût : Un professionnel des achats sur r/procurement a détaillé un processus d'appel d'offres standard avec neuf étapes manuelles. L'étape 5 — « comparer les inclusions/exclusions entre ce que les fournisseurs ont offert et ce que nous avons demandé » — a été désignée comme la plus chronophage. « Certains fournisseurs nous ont simplement envoyé des brochures de ce qui est inclus au lieu de remplir nos formulaires standardisés. » Ce n'est pas un manque d'outils ; c'est un fossé de format que l'extraction basée sur des modèles ne peut pas combler.
Le problème du « même article, nom différent »
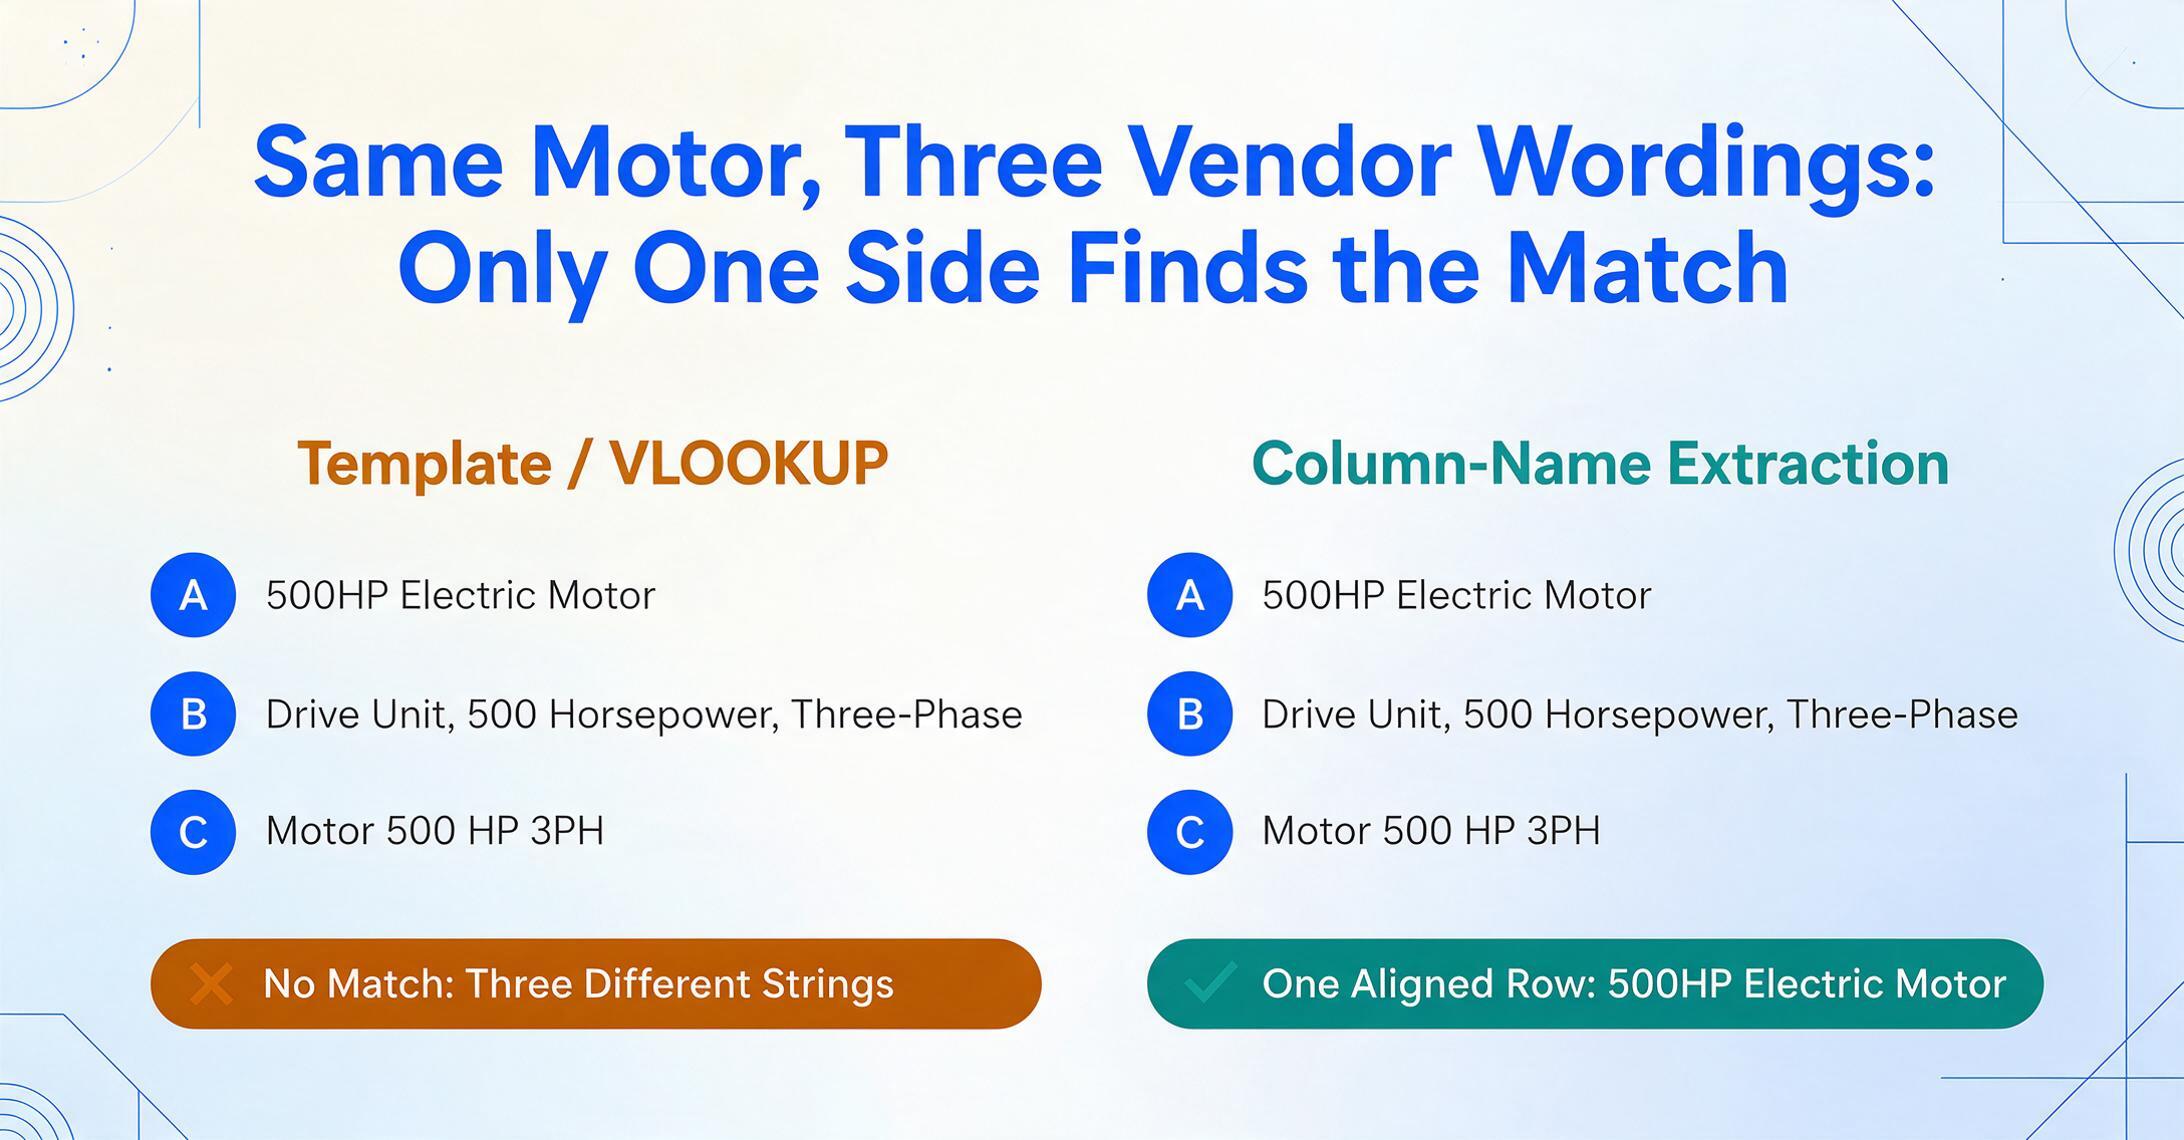
Même après avoir importé les données dans une feuille de calcul, une deuxième couche de friction apparaît : l'alignement sémantique. Trois fournisseurs qui soumissionnent sur le même poste de l'RFQ le décriront de trois façons différentes. « Moteur électrique 500 CV, triphasé » chez le fournisseur A. « Unité d'entraînement, 500 chevaux, triphasé » chez le fournisseur B. « Moteur 500 CV 3PH » chez le fournisseur C. Un VLOOKUP voit des chaînes différentes. Un tableau croisé dynamique voit des catégories différentes. Un humain doit lire les trois, reconnaître qu'il s'agit du même article et aligner manuellement les lignes.
Pour un RFQ de 10 postes, c'est agaçant. Pour un projet de construction avec 450 postes — c'est ce que décrit le blog ProQsmart dans ses études de cas — aligner les descriptions d'articles entre trois soumissions représente trois jours d'un travail épuisant sur feuille de calcul. Le modèle de comparaison était censé faire gagner du temps ; au lieu de cela, il est devenu un projet de normalisation des données.
Le problème sous-jacent est que la diversité des formats ne concerne pas seulement la mise en page — elle concerne le vocabulaire. Différents fournisseurs utilisent différents systèmes ERP, différentes conventions de nommage, différentes abréviations. Les outils d'extraction basés sur un modèle peuvent gérer le problème de mise en page en mappant les coordonnées des pixels aux champs, mais ils n'ont aucune réponse au problème de vocabulaire. Si le fournisseur A appelle cela « code article » et le fournisseur B « SKU », un modèle indique « colonne introuvable ». Un humain comprend qu'ils veulent dire la même chose.
Comment l'extraction par nom de colonne unifie les données de devis, quel que soit le format
L'extraction par nom de colonne résout les deux problèmes — la variance de mise en page et la variance de vocabulaire — avec un seul mécanisme. Au lieu d'indiquer à l'outil où trouver les données sur le PDF de chaque fournisseur, vous lui indiquez quelles données vous voulez. Vous définissez vos colonnes de comparaison une seule fois : « Description de l'article / Nom du fournisseur / Quantité / Prix unitaire / Total de la ligne / Délai de livraison / Conditions de paiement. » L'IA localise chaque valeur dans chaque document en comprenant ce qu'elle signifie, et non où elle se trouve.
Pour le problème de vocabulaire, l'IA fait correspondre les termes sémantiquement équivalents. Si votre colonne s'appelle « Description de l'article », elle reconnaît que « Nom du produit », « Description des marchandises », « Article » et « Matériau » dans le document du vendeur renvoient tous au même concept. Vous n'avez pas à maintenir une liste de synonymes. Vous n'avez pas à configurer de correspondances par fournisseur. La compréhension linguistique de l'IA gère l'alignement — de la même manière qu'une personne lisant les documents reconnaîtrait que « Unité d'entraînement, 500 HP » et « Moteur électrique 500HP » décrivent le même article d'approvisionnement.
C'est la différence entre l'extraction et la compréhension. L'OCR traditionnel extrait des chaînes de texte. Les outils basés sur un modèle extraient des valeurs de champs par position. L'extraction par nom de colonne extrait des points de données par rôle sémantique — ce qui signifie qu'elle fonctionne avec n'importe quel format de devis sans configuration par fournisseur, et qu'elle aligne les articles entre fournisseurs sans correspondance manuelle des lignes. Pour une ventilation champ par champ de ce qu'il faut extraire d'un devis fournisseur — des données d'en-tête comme le numéro de devis et la date de validité jusqu'aux spécifications des postes — consultez notre guide complet d'extraction de devis fournisseur.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Traitement par lots : de 5 devis PDF à un tableau comparatif unique
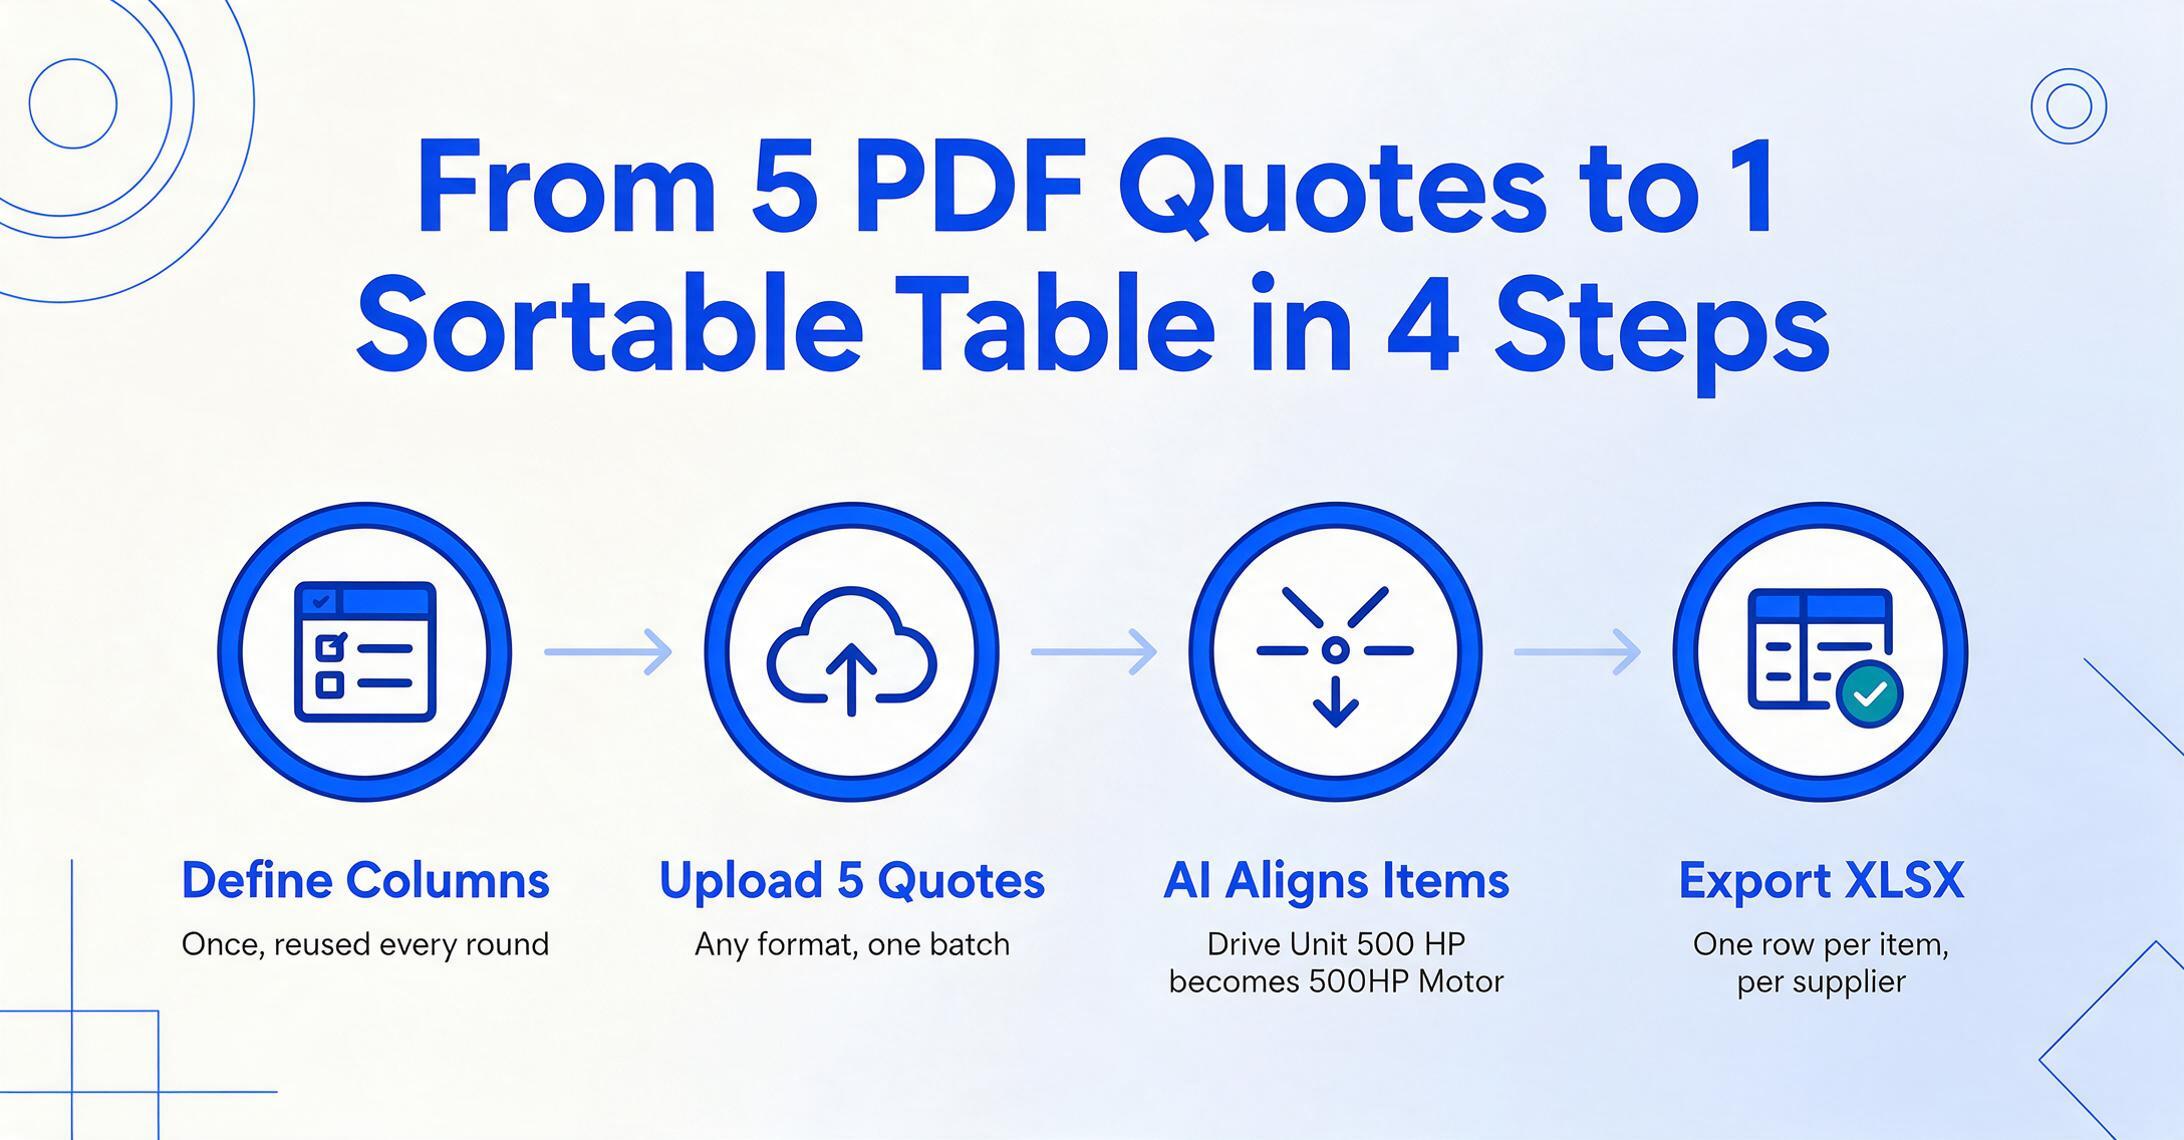
Voici comment fonctionne le flux de comparaison par lots en pratique — de la réception des PDF des fournisseurs à un tableau comparatif triable prêt pour votre notation pondérée :
Définissez vos colonnes de comparaison. Saisissez les champs à comparer entre fournisseurs : « Nom du fournisseur / Description du poste / Quantité / Prix unitaire / Total du poste / Délai (jours) / Conditions de paiement / Conditions de livraison. » Ceux-ci deviennent les en-têtes de votre feuille de calcul. Configurez-les une fois ; réutilisez-les pour chaque cycle de RFQ.
Importez tous les devis fournisseurs en un seul lot. Glissez le PDF généré par l'ERP du fournisseur A, l'Excel envoyé par e-mail du fournisseur B, le devis manuscrit scanné du fournisseur C — n'importe quel mélange de formats. Le lot les traite ensemble, pas un par un.
L'IA extrait et aligne. Chaque devis est traité selon vos définitions de colonnes. Les postes sont alignés sémantiquement — « Drive Unit 500 HP » du fournisseur A correspond à « 500HP Electric Motor » du fournisseur B dans le résultat. Les points de données manquants apparaissent comme des cellules vides ; aucune erreur, aucun décalage de modèle.
Exportez le tableau comparatif. Téléchargez-le au format XLSX. Le résultat contient une ligne par poste et par fournisseur, avec une colonne Nom du fournisseur identifiant la source de chaque ligne. Ajoutez vos propres formules de notation pondérée par-dessus, filtrez par poste, triez par prix — les données sont structurées exactement comme votre processus de comparaison l'attend. Si votre équipe travaille dans Google Sheets plutôt que dans Excel, découvrez comment le même flux par lots aboutit directement dans un tableau comparatif Google Sheets.
Pour un RFQ typique de 5 fournisseurs et 20 postes, l'ensemble du processus — de l'import des PDF à la feuille de calcul prête à comparer — se termine en moins de 10 minutes. Avec la saisie manuelle, la même tâche prend 2 à 3 heures, et ce avant même de commencer à aligner les descriptions de postes entre fournisseurs.
Comparez les flux : La voie traditionnelle est : recevoir les devis par e-mail → télécharger les PDF → ouvrir chacun d'eux → saisir manuellement les descriptions de postes, quantités, prix, délais et conditions dans votre feuille de comparaison → remarquer que le fournisseur B utilise des noms différents → réaligner manuellement les lignes → appliquer vos formules de notation. La voie de l'extraction par nom de colonne est : recevoir les devis → importer le lot → examiner le tableau extrait → appliquer les formules de notation. L'étape d'extraction remplace deux à trois heures de copier-coller par quelques secondes de traitement IA.
Recevez les devis directement des fournisseurs sans fouiller votre boîte mail
Avant de pouvoir comparer les devis, vous devez les collecter. Si votre processus actuel est « envoyer un e-mail à chaque fournisseur → attendre les réponses → télécharger les pièces jointes PDF → les enregistrer dans un dossier → les téléverser dans l'outil de comparaison », vous avez automatisé la moitié du pipeline mais laissé la partie la plus fastidieuse intacte.
La meilleure solution dépend de ceci : invitez-vous les fournisseurs à soumettre des devis, ou vont-ils continuer à vous les envoyer par e-mail comme ils l'ont toujours fait ?
Si vous envoyez un RFQ et souhaitez une page que vous contrôlez pour que les fournisseurs y soumettent leurs devis, le Lien de collecte s'en charge : vous générez une URL unique, vous l'incluez dans votre e-mail RFQ, et les fournisseurs ouvrent le lien, saisissent un code de vérification court et téléversent leur devis. Les fichiers arrivent directement dans votre file de traitement, sans téléchargement d'e-mail, sans organisation de dossiers et sans courir après les pièces jointes. Les fournisseurs n'ont besoin ni de compte ni d'identifiants, seulement d'un navigateur.
Si les fournisseurs continueront d'envoyer les devis par e-mail quoi que vous fassiez, Email Inbox supprime complètement l'étape du lien. Chaque compte dispose d'une adresse de boîte mail dédiée : vous pouvez la donner directement aux fournisseurs ou rediriger les devis entrants de votre propre boîte mail à mesure qu'ils arrivent ; les pièces jointes arrivent dans votre file de traitement automatiquement, sans page de téléversement à mémoriser. Activez l'Auto-Process avec un modèle de comparaison lié et l'extraction démarre dès qu'un devis arrive, au lieu d'attendre que vous ouvriez le fichier. Une liste blanche d'expéditeurs limite cette boîte aux adresses que vous avez approuvées, afin qu'elle ne devienne pas un dépotoir pour des courriers sans rapport.
Les deux chemins aboutissent au même cycle : les devis arrivent sans téléchargement manuel, le traitement par lots extrait les données, et la sortie Excel alimente votre modèle de comparaison. La seule étape humaine restante est celle qui requiert réellement du jugement : examiner la comparaison et choisir le meilleur fournisseur.
Sur quels formats de devis cela fonctionne-t-il ?
L'extraction par nom de colonne est indépendante du format, car elle lit le contexte, pas la mise en page :
- PDF générés par ERP — Sorties SAP, Oracle, NetSuite. Chaque système formate les devis différemment ; l'IA s'adapte automatiquement.
- Feuilles de calcul Excel — Certains fournisseurs envoient des devis en pièces jointes XLSX. Ceux-ci sont traités de la même manière que les PDF.
- Devis papier scannés — Les petits fournisseurs envoient parfois des devis imprimés par fax ou par courrier. Une photo de téléphone ou un PDF scanné fonctionne comme entrée.
- Devis dans le corps d'un e-mail — Fournisseurs qui saisissent les devis directement dans un e-mail. Capture d'écran → téléversement → extraction.
- Lots de formats mixtes — Téléversez les cinq devis fournisseurs ensemble, quel que soit le format. L'IA traite chacun indépendamment et fusionne les résultats.
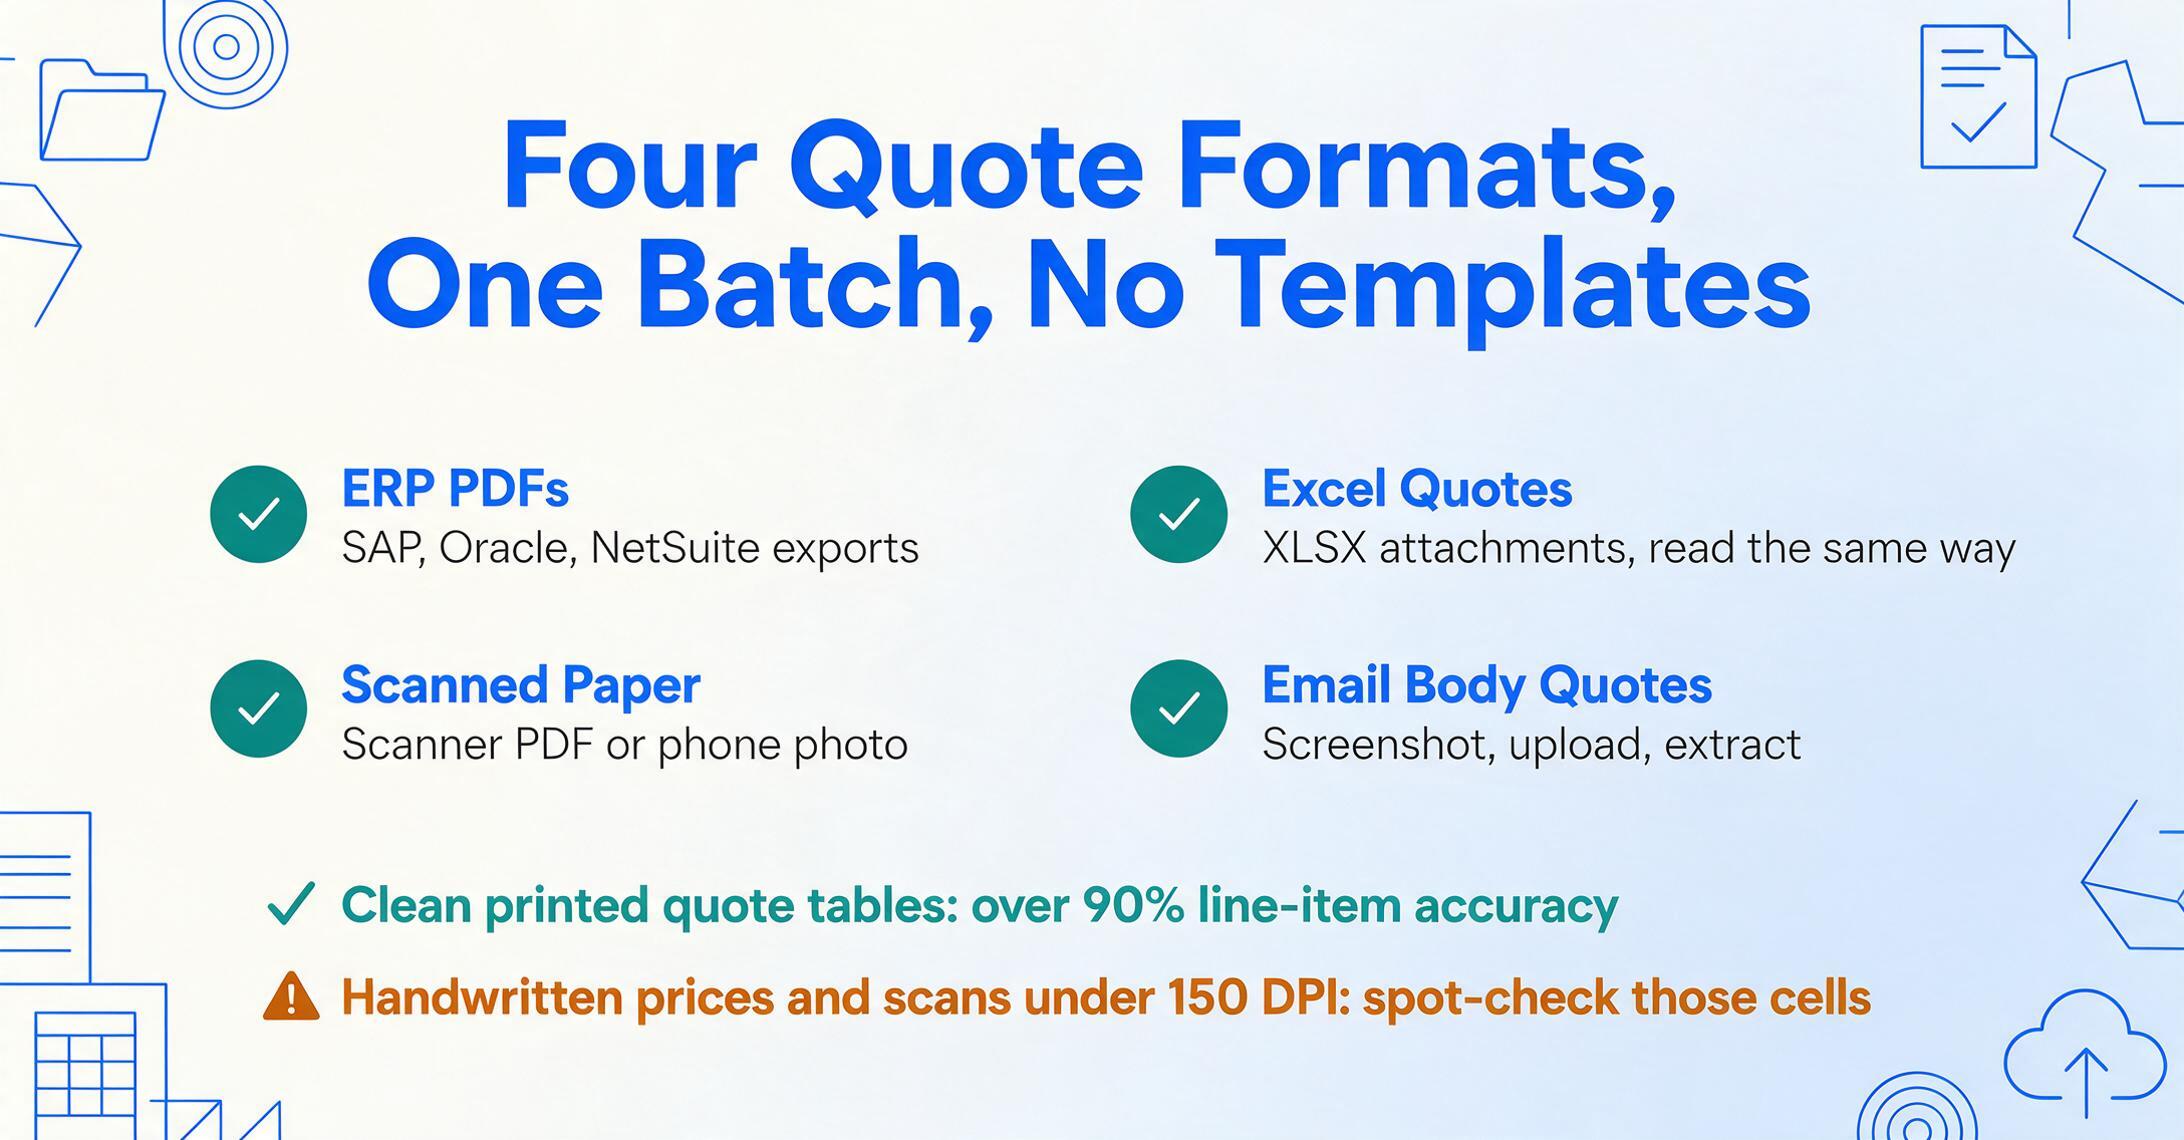
Où la précision diminue : Les tableaux fortement mis en forme avec des cellules fusionnées, les prix manuscrits (par opposition aux prix imprimés) et les scans en très basse résolution (sous 150 DPI) réduiront la précision d'extraction pour ces cellules spécifiques. Pour les tableaux de devis imprimés propres — ce qui décrit la grande majorité des devis fournisseurs — la précision d'extraction dépasse 90 % pour les postes. Les devis manuscrits ou fortement annotés peuvent nécessiter des vérifications manuelles sur les données extraites.
Questions fréquentes
Que faire si les fournisseurs utilisent des unités différentes — par exemple, l'un indique « à l'unité » et l'autre « par 100 » ?
L'IA extrait les valeurs et unités telles qu'elles apparaissent dans le document. Elle ne convertit pas automatiquement les unités (ex. « par 100 » en « à l'unité ») — ce niveau de normalisation relève de votre feuille de calcul comparative avec une formule de conversion. Ce qu'elle fait, c'est conserver le champ d'unité de mesure pour que vous puissiez voir l'écart et effectuer la conversion vous-même. L'IA ne normalisera pas silencieusement « par 100 » en « par 1 » pour vous donner un prix unitaire trompeur.
Peut-elle détecter si un fournisseur a omis un poste du cahier des charges ?
Indirectement, oui. Comme la sortie est structurée sous forme de tableau comparatif avec des colonnes cohérentes, vous pouvez rapidement comparer le nombre de postes par fournisseur ou filtrer les éléments manquants. L'IA ne signale pas automatiquement les écarts de périmètre — cela nécessite de connaître vos postes RFQ comme ensemble de référence — mais une rapide comparaison du nombre de lignes dans le tableau de sortie rend les omissions évidentes.
Comment gère-t-elle les devis multidevises ?
L'IA extrait les codes de devise (USD, EUR, GBP, etc.) avec les montants et les conserve dans une colonne Devise. Elle ne convertit pas les devises en une seule base au taux de change actuel. Vous pouvez ajouter une colonne de conversion de taux de change dans votre feuille de calcul comparative pour normaliser tous les prix dans votre devise de reporting. La couche d'extraction vous donne des valeurs précises et non modifiées ; la couche de logique comparative est celle où vous appliquez les conversions de change.
Dois-je configurer quelque chose par fournisseur ?
Non. Les définitions de colonnes que vous configurez une fois fonctionnent pour tous les fournisseurs. Pas de création de modèle, pas de phase d'apprentissage, pas de mappage de champs par fournisseur. C'est la différence fondamentale entre l'extraction par nom de colonne et les outils de traitement de devis basés sur des modèles. Pour un utilisateur Reddit dans r/automation qui décrivait être « revenu au travail manuel sur Excel pour comparer les prix FOB et CIF » après avoir essayé l'automatisation basée sur des modèles, cette différence est la raison de changer d'approche.
Dois-je utiliser Lien de collecte ou Boîte de réception e-mail pour recevoir les devis des fournisseurs ?
Cela dépend de qui initie l'échange. Lien de collecte convient à un RFQ actif : vous voulez une page traçable unique sur laquelle un groupe défini de fournisseurs peut soumettre ses devis. Boîte de réception e-mail convient aux fournisseurs qui ont déjà l'habitude de vous envoyer un devis par e-mail et à qui vous préférez ne pas demander de changer leurs habitudes ; vous leur donnez plutôt une adresse de boîte de réception dédiée, et les devis arrivent dans votre file de traitement sans que personne n'ait à télécharger quoi que ce soit. Les deux ne sont pas exclusifs. Certaines équipes utilisent Lien de collecte pour les RFQ de nouveaux fournisseurs et Boîte de réception e-mail pour les fournisseurs récurrents dont elles ont déjà les coordonnées.
Qu'en est-il des devis qui incluent des conditions générales sur des pages séparées ?
L'IA traite l'intégralité du document. Si vos définitions de colonnes incluent des champs comme « Conditions de paiement » ou « Conditions de livraison », elle les localisera où qu'ils apparaissent — dans l'en-tête, dans une section séparée ou sur une page de conditions générales. Vous n'avez pas besoin d'indiquer à l'IA quelle page contient quel champ ; elle analyse l'intégralité du document de manière contextuelle.
Comment cela se compare-t-il à l'utilisation de VLOOKUP ou Power Query pour fusionner les devis ?
VLOOKUP et Power Query supposent que vos données de devis sont déjà au format tableur — ce sont des outils de fusion, pas d'extraction. Si vos devis fournisseurs arrivent en PDF, ces outils ne vous aident pas tant que vous n'avez pas saisi les données manuellement. L'extraction par nom de colonne résout l'étape précédant la fusion : obtenir des données structurées à partir de documents non structurés. Une fois extraites, la sortie XLSX peut être chargée dans Power Query pour une transformation supplémentaire si nécessaire — les deux approches sont complémentaires, pas concurrentes.
Pour l'approche fondamentale — définir les colonnes de comparaison et comprendre pourquoi l'extraction basée sur un modèle échoue avec des formats fournisseurs mixtes — commencez par comment extraire les données des devis fournisseurs dans un tableau comparatif.
Essayez l'outil d'extraction de devis fournisseur vers Excel pour transformer n'importe quel PDF de devis en feuille de calcul prête à comparer en quelques secondes.