Kann KI Bestellanforderungsdaten extrahieren?
PR-Extraktion ist nicht PO-Extraktion
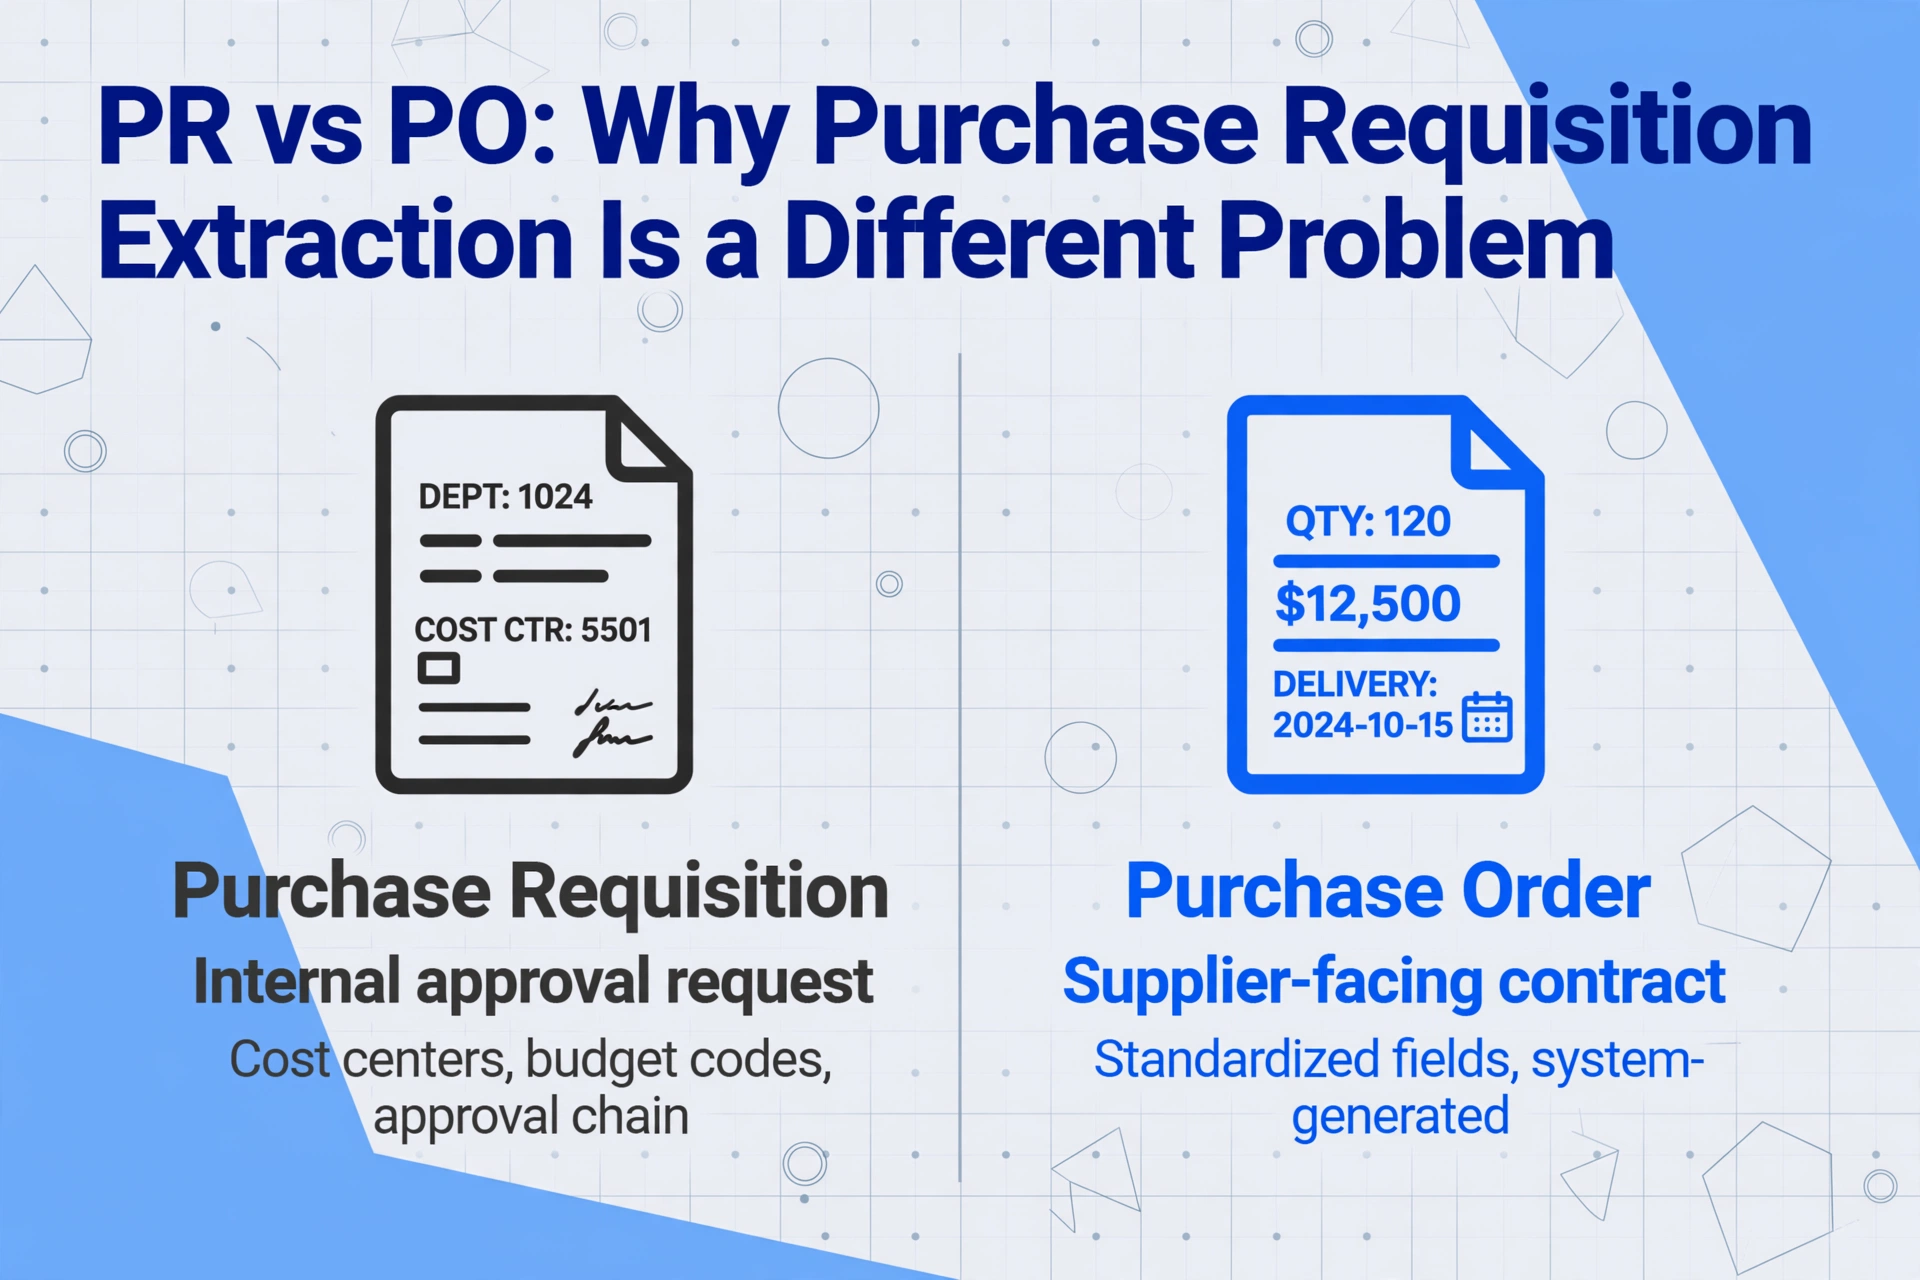
Ja. KI kann Bestellanforderungsdaten extrahieren – aber die PR-Extraktion unterscheidet sich grundlegend von der PO-Extraktion, da die Genehmigungskette und abteilungsspezifische Artikelcodes ein Verständnis auf Feldebene erfordern, nicht nur das Scannen von Text. Eine Bestellanforderung ist ein internes Dokument: Sie beantragt die Genehmigung, Geld auszugeben. Eine Bestellung ist ein externes Dokument: Sie weist einen Lieferanten an, Waren zu liefern. Das Extraktionstool, das beides verarbeitet, muss verstehen, welches Dokument es liest, denn derselbe Feldname bedeutet je nach Kontext etwas anderes.
Wichtige Erkenntnisse
- Eine Bestellanforderung ist ein interner Genehmigungsantrag, kein Lieferantenvertrag. Die Verwendung eines PO-Extraktionstools für Bestellanforderungen übersieht stillschweigend Kostenstellen, Budgetcodes und Genehmigungsunterschriften – jedes Feld, das für den Genehmigungsworkflow wichtig ist.
- Interne Formulare sind über Abteilungen hinweg null standardisiert. Vorlagenbasiertes OCR benötigt eine separate Vorlage für jedes selbst erstellte Formular einer Abteilung, während semantische Extraktion die Feldbedeutung liest, nicht die Position, sodass eine Spaltendefinition alle abdeckt.
- Genehmigungsunterschriften sind Daten, keine Dekoration. Die Erfassung, wer wann und auf welcher Ebene genehmigt hat, verwandelt manuelles Routing in analysierbare Daten – ohne einen einzigen Tastendruck.
Was eine Bestellanforderung von einer Bestellung unterscheidet
Der häufigste Fehler bei der PR-Extraktion ist, sie wie ein PO-Extraktionsproblem zu behandeln. Sie teilen ähnliche Feldnamen — Dokumentnummer, Datum, Anforderer, Lieferant, Positionen, Mengen, Summen —, aber Zweck und Struktur unterscheiden sich so stark, dass ein PO-fokussiertes Tool eine Bestellanforderung stillschweigend falsch interpretiert.
Eine Bestellung ist ein lieferantengerichteter Vertrag. Sie teilt einem Lieferanten Bestellmengen, vereinbarte Preise, Liefertermine und Zahlungsbedingungen mit. Ihre Felder sind relativ standardisiert, weil Lieferanten sie lesen und erfüllen müssen. PO-Nummernformate mögen variieren, aber das Konzept einer PO-Nummer ist bei jedem Lieferanten in jeder Branche universell.
Eine Bestellanforderung ist ein interner Genehmigungsantrag. Sie besagt: „Ich muss das kaufen — bitte genehmigen Sie die Ausgabe." Ihre Felder spiegeln die interne Geschäftsstruktur wider: Abteilungscodes, Kostenstellen, Budgetkontonummern, Genehmigungshierarchien, Begründungsnotizen, Vorschläge für bevorzugte Lieferanten. Keines dieser Felder erscheint auf einer Bestellung. Und anders als Bestellungen, die typischerweise systemgeneriert sind, kommen Bestellanforderungen noch immer als handschriftlich ausgefüllte Papierformulare, gedruckte und unterschriebene Excel-Tabellen oder formlose E-Mail-Anhänge — Formate mit praktisch keiner Standardisierung. Einen breiteren Überblick darüber, wie verschiedene Dokumenttypen unterschiedliche Extraktionsansätze erfordern, finden Sie in unserem Leitfaden dazu, was PO-Datenextraktion tatsächlich ist.
Die praktische Konsequenz: Wenn Sie ein PO-Extraktionstool auf Bestellanforderungen anwenden, findet es zuverlässig die Dokumentnummer und das Datum — und verpasst oder klassifiziert dann jedes Feld falsch, das für den Genehmigungsworkflow wichtig ist. Das Abteilungsfeld wird zu „Ship To", der Budgetcode wird ignoriert, und die Genehmigungsunterschriften werden nicht erfasst, weil das Tool nicht nach ihnen gesucht hat.
Interne Dokumente haben eine geringere Layout-Standardisierung als externe. Eine Lieferantenrechnung folgt genug Konventionen, dass ein Tool ohne Vorlage die Summe zuverlässig finden kann. Ein internes PR-Formular einer Abteilung kann völlig anders aussehen als das Formular einer anderen Abteilung im selben Unternehmen — weil jede Abteilung ihr eigenes Formular in der Software gestaltet hat, die ihr zur Verfügung stand.
Wo Bestellanforderungsdaten liegen: handgeschriebene Formulare, Excel-Exporte und gescanntes Papier
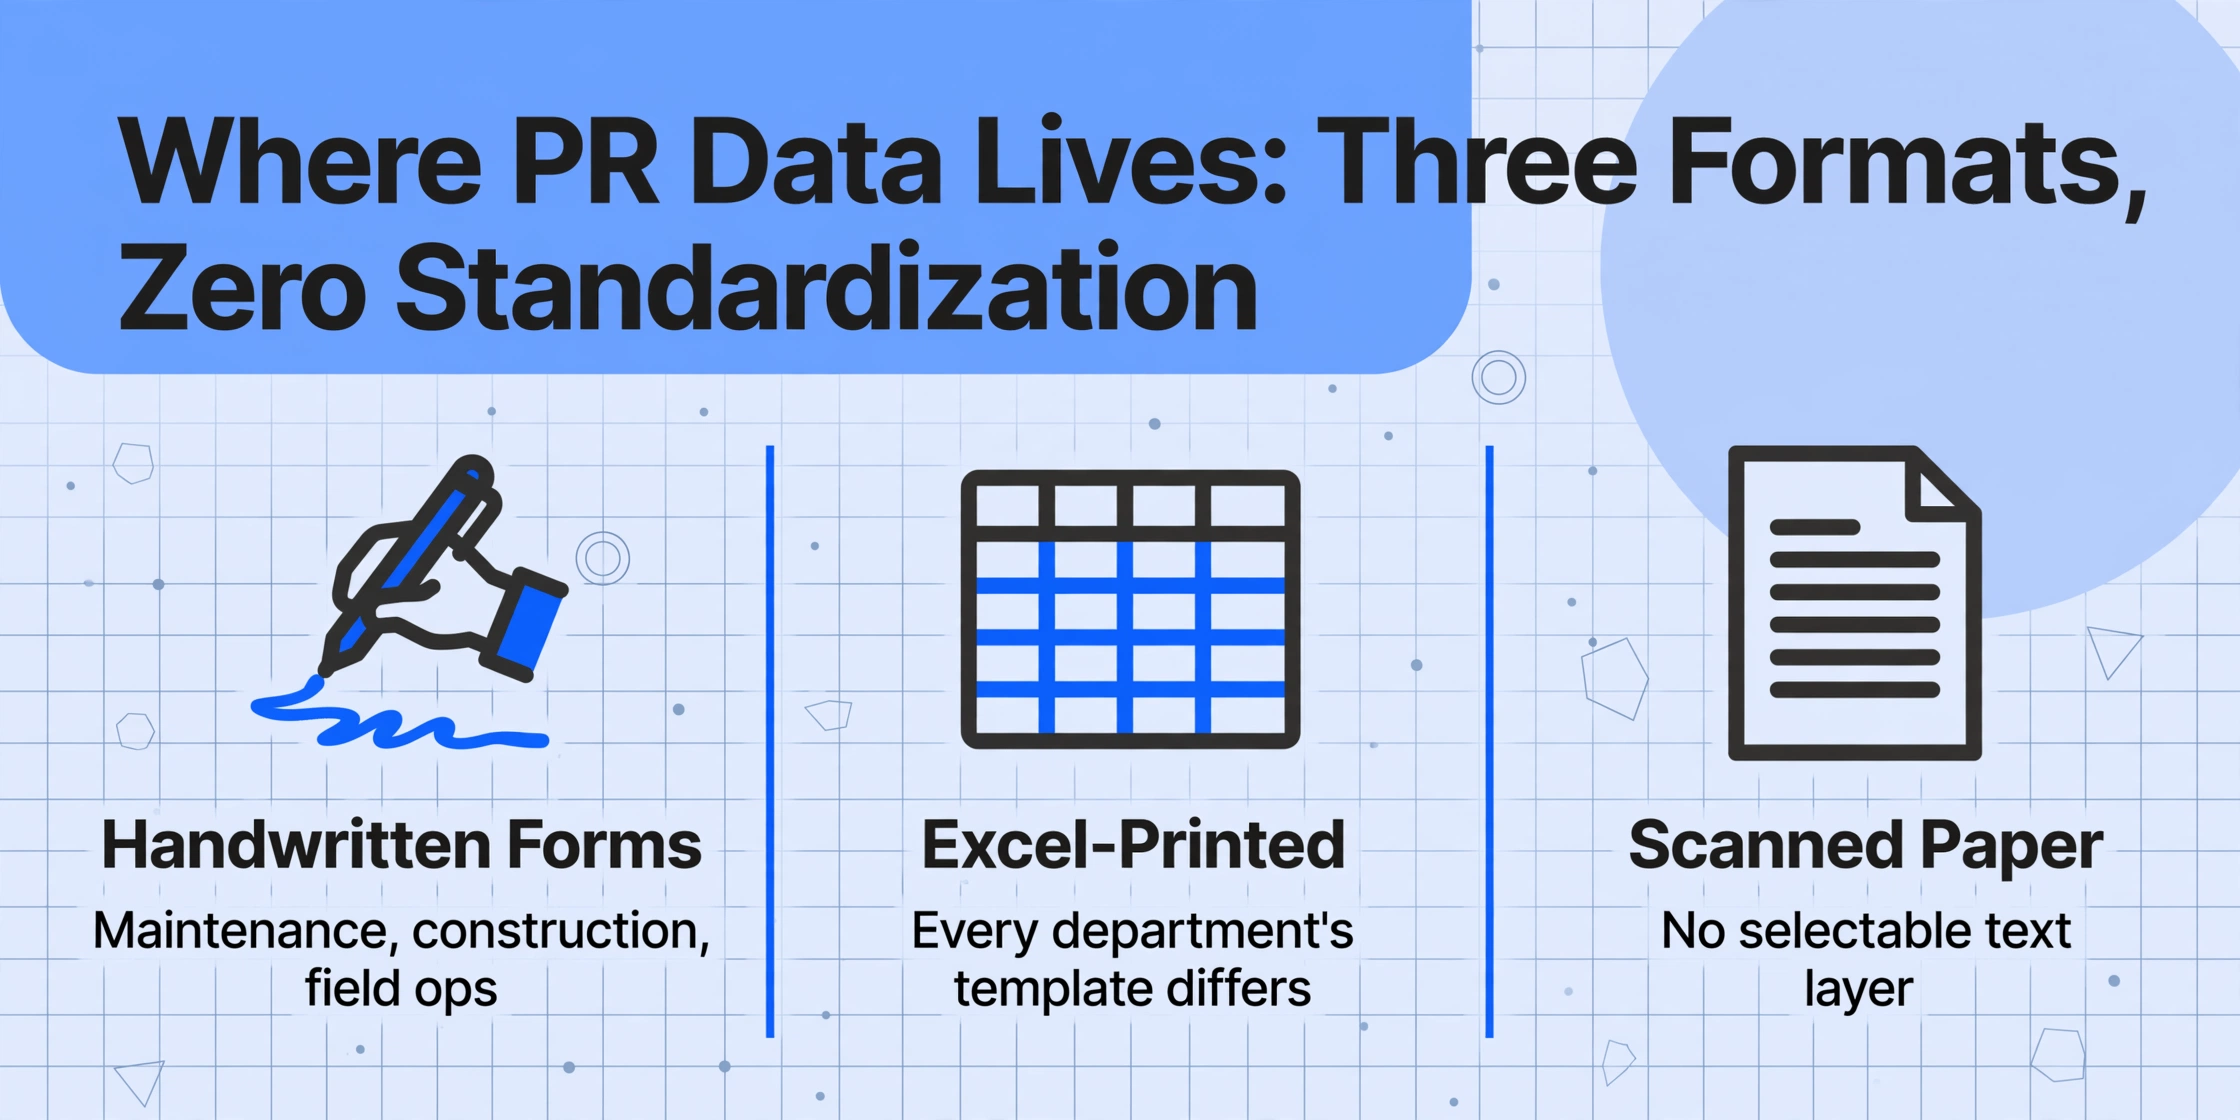
Anders als Bestellungen, die die meisten Unternehmen über ihr ERP erzeugen, stammen Bestellanforderungen weiterhin aus unterschiedlichen Quellen – und viele sind nicht digital entstanden.
Handgeschriebene Bestellanforderungsformulare. In Fertigung, Bauwesen und Außendienst werden Anforderungen per Hand ausgefüllt – ein Wartungsleiter notiert Teilenummern, schätzt Kosten aus dem Gedächtnis und reicht das Papierformular an den Einkauf weiter. Diese handgeschriebenen Bestellanforderungen enthalten Abkürzungen, aus dem Gedächtnis notierte Teilenummern und manuelle Kostenschätzungen. KI, die auf getippten Text angewiesen ist, liefert hier nichts Brauchbares. Die bildbasierte Extraktion liest die Handschrift als Teil des Dokumentbilds und erkennt „Menge: 5“ anhand des Feldkontexts, selbst wenn die Handschrift unleserlich ist.
Gedruckte und gescannte Excel-Bestellanforderungen. Viele Abteilungen nutzen Excel-Vorlagen als Anforderungsformulare – und die Vorlage jeder Abteilung ist anders. Spaltenpositionen verschieben sich, verbundene Kopfzeilen tauchen an unerwarteten Stellen auf, und die Zelle „Summe“ kann in einem Formular in Zeile 25 und in einem anderen in Zeile 40 stehen. Vorlagenbasiertes OCR scheitert, weil keine zwei gedruckten Excel-Bestellanforderungen dasselbe Layout haben. Die semantische Extraktion liest Werte anhand ihrer Spaltenbeschriftungen, nicht ihrer Positionen, sodass „Beschreibung“ in Spalte C des einen und Spalte E des anderen Formulars als dasselbe Feld erkannt wird. Selbst Unternehmen, die Bestellanforderungen digital erzeugen, drucken sie oft zum Unterschreiben aus und scannen die unterschriebene Kopie ein – das resultierende PDF ist ein Bild ohne auswählbaren Text. Mehr dazu, wie KI mit Dokumenten ohne Textebene umgeht, finden Sie in unserem Leitfaden dazu, ob KI Daten aus gescannten PDFs extrahieren kann.
Das Problem der Genehmigungskette: Unterschriften, Weiterleitung und Status
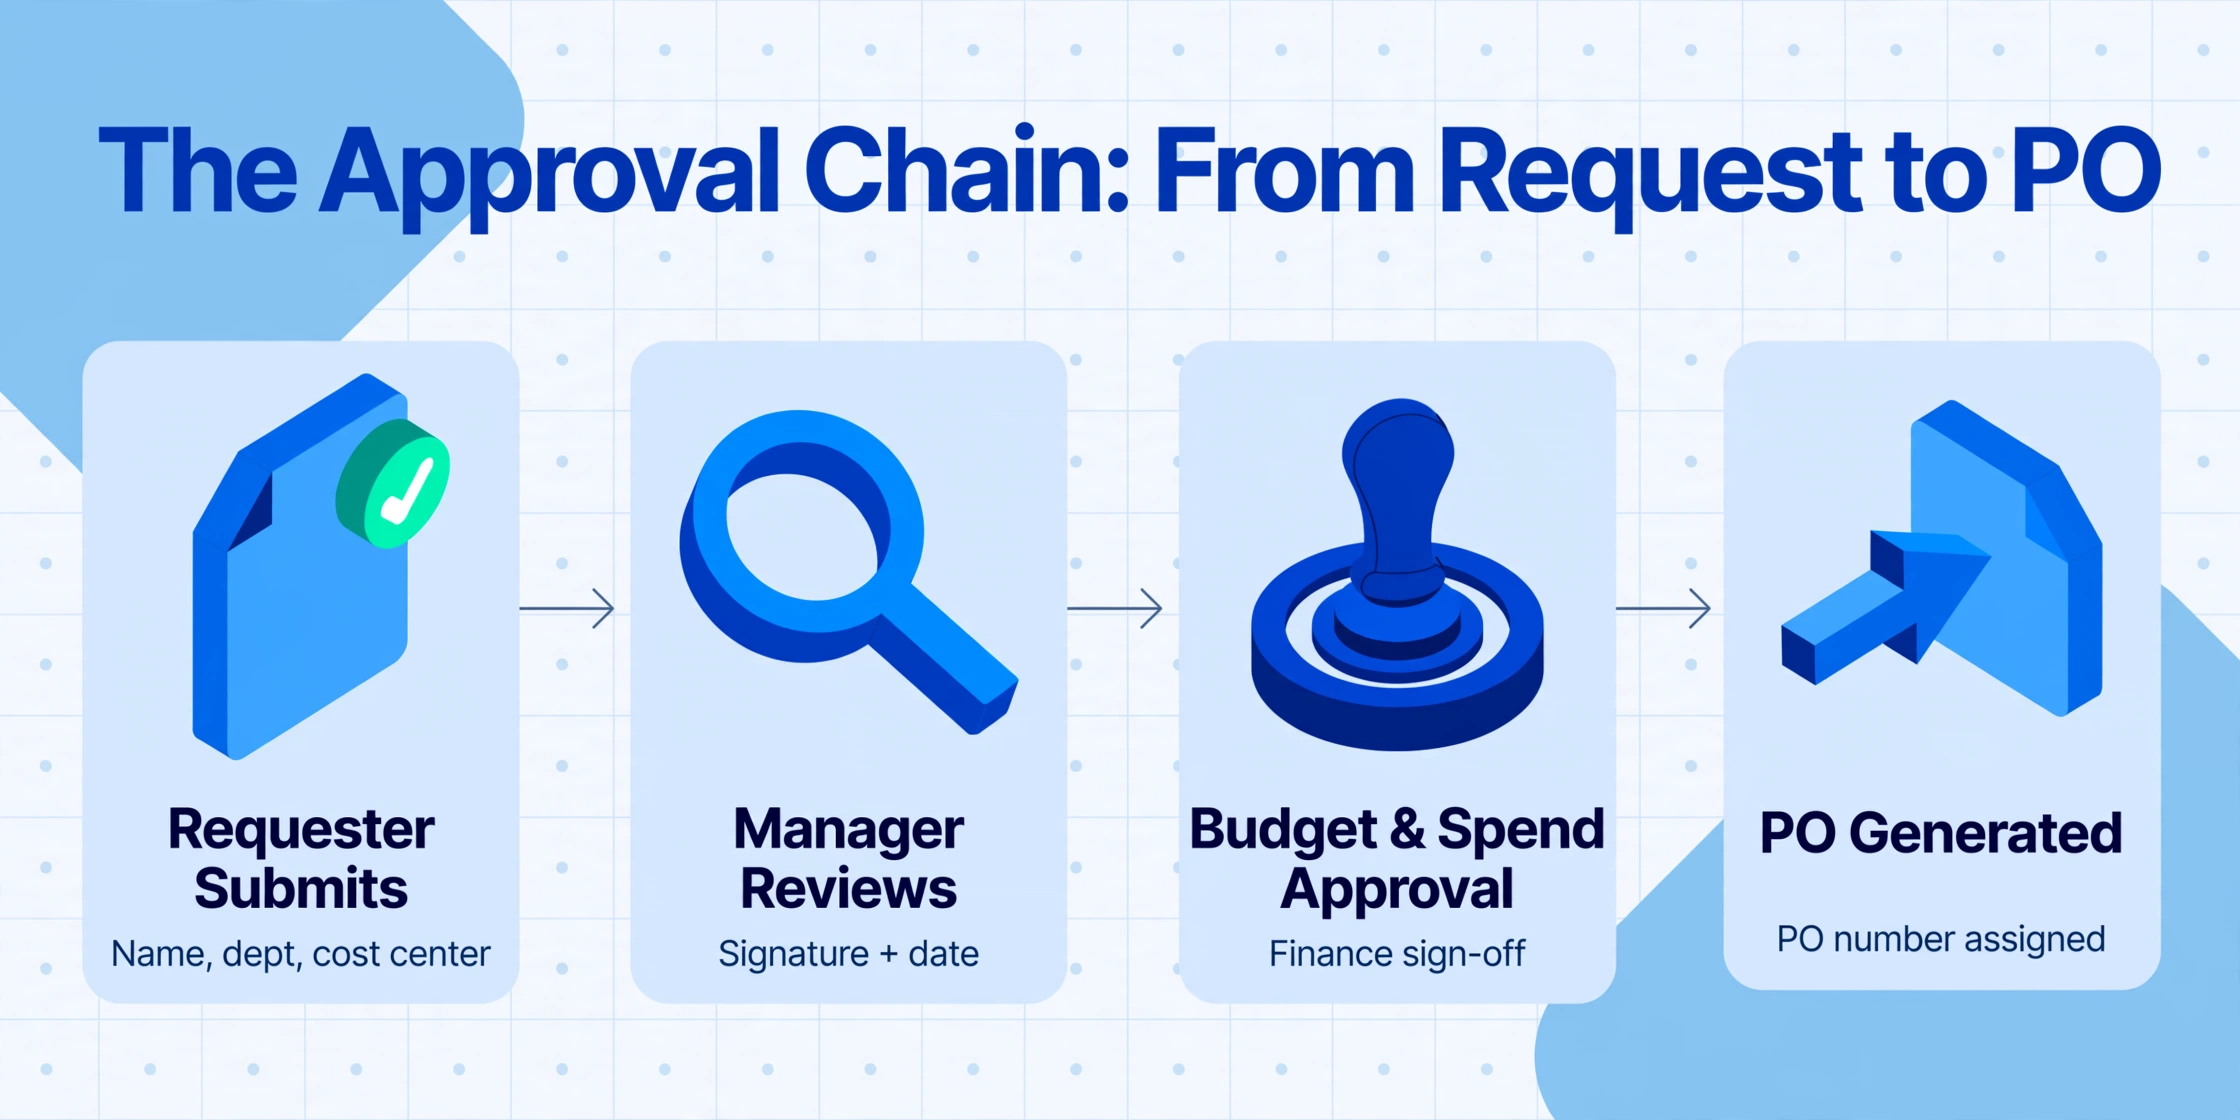
Dies ist die Extraktionsherausforderung, für die es bei der Bestellungsverarbeitung keine Entsprechung gibt. Eine Bestellanforderung ist kein einzelner Datensatz – sie ist ein Dokument mit einem Lebenszyklus. Genehmigungsunterschriften, Daten und Weiterleitungsentscheidungen sind Datenpunkte, die die PR-Extraktion erfassen muss, damit das Dokument nutzbar ist.
Eine typische Genehmigungskette auf einer Anforderung könnte so aussehen:
Ebene des Antragstellers
- Name des Antragstellers
- Abteilung / Kostenstelle
- Anforderungsdatum
- Begründung / Notizen
Genehmigung durch Vorgesetzten
- Unterschrift des Vorgesetzten
- Genehmigungsdatum
- Prüfung des Budgetcodes
- Genehmigung der Ausgabenkategorie
Beschaffung / Finanzen
- Genehmigung durch Einkauf
- Zugewiesene Bestellnummer
- Freigabe des Finanzcodes
- Datum der finalen Genehmigung
Jeder dieser Unterschriftsblöcke ist ein separates Extraktionsziel. Der Name des Antragstellers erscheint oben. Die Freigabe des Vorgesetzten erscheint in der Mitte – manchmal mit einem Kontrollkästchen für „Genehmigt" oder „Abgelehnt". Die finale Genehmigung des Einkäufers erscheint unten, oft mit der Bestellnummer, die aus der genehmigten PR erzeugt wurde. Ein Extraktionstool muss zwischen „Anforderungsdatum" und „Genehmigungsdatum" unterscheiden – zwei verschiedene Daten auf derselben Seite – und jedes der richtigen Spalte zuordnen.
Hier scheitert die positionsbasierte Extraktion am dramatischsten. Auf dem Formular einer Abteilung befindet sich das Unterschriftsfeld des Vorgesetzten unten rechts. Auf dem Formular einer anderen Abteilung befindet es sich in einer Seitenleiste links. Auf einem dritten ist es in eine Tabellenzeile neben Positionen eingebettet. Die semantische Extraktion löst dies, indem sie nach der Kombination aus der Bezeichnung „Genehmigung durch Vorgesetzten" oder „Genehmigt von" und einer Unterschrift oder einem Datum sucht – sie identifiziert den Genehmigungsblock anhand der Bedeutung, nicht anhand der Position.
Welche Felder bei der Extraktion von Bestellanforderungen wichtig sind
Bestellanforderungen enthalten einen bestimmten Satz von Feldern, der sich von Bestellungen unterscheidet. Eine vollständige PR-Extraktion sollte sowohl Informationen auf Kopfebene als auch Details zu Positionen erfassen:
PR-Kopffelder
- PR-Nummer / Anforderungs-ID
- Anforderungsdatum
- Name und Abteilung des Anforderers
- Kostenstelle / Budgetcode
- Lieferort / Abteilung
- Gewünschtes Lieferdatum
- Geschätzter Gesamtbetrag (budgetär)
- Begründung / geschäftlicher Bedarf
- Genehmigungsstatus (ausstehend/genehmigt/abgelehnt)
- Namen der Genehmiger und Genehmigungsdaten
- Umgewandelte Bestellnummer (falls genehmigt)
PR-Positionen
- Artikelbeschreibung
- Abteilungsartikelcode / SKU
- Angeforderte Menge
- Maßeinheit
- Geschätzte Stückkosten
- Geschätzter Positionsgesamtbetrag
- Bevorzugter Lieferant (falls angegeben)
- GL-Konto / Verrechnungscode
- Projekt- / Arbeitsauftragsnummer
Das Feld „Abteilungsartikelcode" verdient besondere Aufmerksamkeit. Anders als bei Bestellungen, bei denen Artikelcodes aus dem Katalog des Lieferanten stammen, verwenden interne PRs abteilungsspezifische Nummerierungssysteme – die Instandhaltung verwendet Gerätecodes, die IT verwendet Asset-Tags, das Engineering verwendet Zeichnungsnummern. Eine KI-Extraktion, die diese Codes korrekt liest, ohne für das System jeder Abteilung eine Nachschlagetabelle zu benötigen, verhindert, dass die Ausgabe beim Schritt der Bestellerstellung manuell korrigiert werden muss.
Ebenso sind die geschätzten Kosten in einer PR eine Budgetprüfung, kein verbindlicher Preis. Das Extraktionstool muss „Gesch. Kosten" oder „Geschätzter Stückpreis" als Schätzung erfassen und nicht mit einem bestätigten Preis verwechseln. Die semantische Extraktion bewältigt dies, weil sie die qualifizierende Feldbezeichnung liest, anstatt nur die nächstgelegene Zahl zu ziehen.
Wie KI die PR-Extraktion anders handhabt
Der Kernmechanismus – semantische Extraktion auf Basis von Vision-KI – ist dieselbe Technologie, die auch Rechnungen und Bestellungen verarbeitet, doch PR-Dokumente stellen andere Anforderungen daran.
Die Formatvielfalt ist größer. Eine Rechnung folgt genügend Konventionen, dass eine Einrichtung die meisten Lieferanten abdeckt. Eine Bestellanforderung hat keine Konventionen – jedes Unternehmen und oft jede Abteilung entwirft ihr eigenes Formular. Die semantische Extraktion bewältigt dies, weil sie die Bedeutung der Felder liest, statt Layouts abzugleichen. Sie definieren die Spalten einmal – „PR Number“, „Department“, „Item Description“, „Estimated Cost“, „Approved By“ – und die KI findet diese Werte überall auf dem Formular jeder Abteilung. Das ist Benutzerdefinierte Spaltenextraktion: Sie geben die Feldnamen ein, und die KI findet die passenden Daten, indem sie versteht, was jedes Textstück darstellt.
Handschrift ist die Regel, nicht die Ausnahme. In vielen Beschaffungsabteilungen enthalten mehr als die Hälfte der eingehenden Anforderungen handschriftliche Elemente – von Hand angepasste Mengen, Genehmigungsunterschriften, an den Rand gekritzelte Notizen. Vision-basierte KI liest diese als Teil des visuellen Dokuments. Bei handschriftlichen Artikelcodes und Mengen hängt die Genauigkeit von der Lesbarkeit ab, doch der semantische Kontext hilft: Eine KI, die nach „Quantity“ sucht, liest eine handschriftliche „5“ neben „pcs“ mit höherer Wahrscheinlichkeit korrekt als dasselbe Zeichen isoliert. Mehr dazu finden Sie in unserem Leitfaden zur KI-Handschrifterkennung.
Genehmigungsunterschriften sind Daten, keine Dekoration. Bei der PO-Extraktion sind Unterschriften meist irrelevant. Bei der PR-Extraktion sind sie entscheidend: wer genehmigt hat, wann und auf welcher Ebene. KI, die Name des Unterzeichners, Datum und Genehmigungsstatus erfasst, verwandelt manuelle Weiterverfolgung in analysierbare Daten. Eine praktische Anleitung finden Sie in unserem Leitfaden zum Extrahieren von Daten aus Bestellanforderungs-PDFs.
Häufig gestellte Fragen
Kann KI Daten aus handschriftlichen Bestellanforderungen extrahieren?
Ja. Vision-basierte KI liest handschriftliche Felder — Mengen, Teilenummern, Namen der Genehmiger — als Teil des Dokumentbilds. Saubere Druckschrift auf einem gut beleuchteten Scan wird mit 85–95 % Genauigkeit extrahiert. Dichte Schreibschrift oder Scans mit geringem Kontrast (Durchschläge) liefern schlechtere Ergebnisse. Der Vorteil gegenüber manueller Eingabe besteht darin, die 80 % der Felder zu erfassen, die getippt oder klar gedruckt sind, und dann unsichere Handschrift zur Prüfung zu markieren, statt eine vollständige manuelle Neueingabe zu erfordern.
Wie unterscheidet sich die PR-Extraktion von der PO-Extraktion?
Drei wesentliche Unterschiede. Erstens enthalten Bestellanforderungen Felder, die Bestellungen nicht haben: Kostenstellen, Budgetcodes, Begründungsnotizen, Daten zum Genehmigungsweg und geschätzte Preise. Zweitens kommen Bestellanforderungen in vielfältigeren Formaten — handschriftliche Formulare, Excel-Ausdrucke, gescanntes Papier — während Bestellungen typischerweise systemgenerierte PDFs sind. Drittens muss die PR-Extraktion die Genehmigungskette erfassen: wer unterschrieben hat, wann und auf welcher Ebene. Ein PO-Extraktionstool, das Genehmigungsunterschriften und Kostenstellencodes übersieht, liefert bei einer Bestellanforderung unvollständige Ergebnisse. Mehr dazu finden Sie in unserem Leitfaden zur PO-Datenextraktion.
Kann ich sowohl Kopffelder als auch Positionen aus einer Bestellanforderung in einem Durchgang extrahieren?
Ja. Definieren Sie Spalten für Kopffelder (PR-Nummer, Abteilung, Kostenstelle) und Positionsfelder (Beschreibung, Menge, geschätzte Stückkosten). Die KI extrahiert die Kopfwerte einmal und wiederholt sie in jeder Positionszeile. Eine Bestellanforderung mit 12 Positionen erzeugt 12 Ausgabezeilen, die jeweils den vollständigen Kopfkontext tragen — kompatibel mit ERP-Import und Excel-Pivot-Tabellen.
Benötigt das Tool eine separate Vorlage für das PR-Formular jeder Abteilung?
Nein. Dies ist der zentrale Vorteil der semantischen Extraktion gegenüber vorlagenbasierter OCR. Definieren Sie die Spaltennamen einmal — „PR-Nummer", „Artikelbeschreibung", „Geschätzte Kosten" — und die KI findet die passenden Daten in jedem Abteilungsformular, indem sie versteht, was jedes Feld bedeutet. Das SAP-Formular der Technik, das Excel-Blatt des Marketings und die handschriftliche Anfrage eines Lagerleiters werden mit derselben Spaltendefinition verarbeitet. Eine vollständige Erklärung finden Sie unter wie KI Daten ohne Vorlagen extrahiert.
Welche Dateiformate kann ich für die PR-Extraktion verwenden?
Moderne KI-Extraktionstools akzeptieren PDF (digital und gescannt), JPG, PNG und WebP. Gescanntes PDF ist für Bestellanforderungen am häufigsten — Dokumente, die gedruckt, unterschrieben und gescannt werden. Handyfotos von Papier-Bestellanforderungen funktionieren, solange das Bild scharf ist. Aus Excel erzeugte PDFs (aus Tabellenkalkulationsvorlagen gedruckt) funktionieren ebenfalls. Für die Batch-Verarbeitung laden Sie Bestellanforderungen aus verschiedenen Abteilungen in einem einzigen Durchlauf hoch und erhalten eine einheitliche Tabelle mit allen zusammengeführten Dokumenten.
Kann ich PR-Extraktionsergebnisse direkt in mein ERP oder meine Buchhaltungssoftware exportieren?
Die meisten Extraktionstools geben Ergebnisse als Excel (XLSX), CSV oder JSON aus — Formate, die jedes ERP importieren kann. Der Standard-Workflow: PR-Daten extrahieren → markierte Handschrift- oder Schätzfelder prüfen → in Ihr Beschaffungssystem importieren (SAP, Oracle, Coupa, QuickBooks, NetSuite). Die Daten kommen vorstrukturiert an, mit PR-Nummern als Identifikatoren und Positionen in flachen Zeilen, bereit für den Budgetabgleich. Für Google-Sheets-Nutzer können Ergebnisse über das Google-Sheets-Add-on direkt in eine Tabelle geschrieben werden, wodurch der Export-Import-Schritt entfällt.
Mit der Extraktion von Bestellanforderungsdaten beginnen
Die Extraktion von Bestellanforderungen liegt an der Schnittstelle zweier Gegebenheiten, die die meisten Beschaffungsabteilungen als unvermeidlich hinnehmen: Interne Formulare sind nicht standardisiert, und die manuelle Bearbeitung von Bestellanforderungen verursacht über jede Abteilung und jede Genehmigungsstufe hinweg kumulierte Kosten. Die KI-Extraktion ändert das, indem sie jede Bestellanforderung als visuelles Dokument behandelt, das sie durch Lesen versteht – nicht durch Abgleich mit Vorlagen. Dieselbe Spaltendefinition funktioniert bei handschriftlichen Wartungsanforderungen, in Excel gedruckten Konstruktionsanforderungen und eingescannten Lagerbestellungen gleichermaßen.
Die entscheidende Frage lautet nicht „Kann KI Bestellanforderungen extrahieren?" – die Antwort ist ja. Die Frage ist, ob das Extraktionstool den Unterschied zwischen einer internen Genehmigungsanforderung und einer Bestellung bei einem Lieferanten versteht. Diese Unterscheidung entscheidet darüber, ob Ihre Ausgabe vollständig ist oder die Hälfte der relevanten Felder fehlt.
Laden Sie eine Beispiel-Bestellanforderung hoch – in jedem Format, aus jeder Abteilung – und sehen Sie, wie sie mit Ihren eigenen Dokumenten umgeht.