Warum die besten ZUGFeRD-Extraktionstools
die Hälfte Ihrer Rechnungen übersehen
Wer 2026 nach den besten ZUGFeRD-Extraktionstools sucht, findet in fast jeder Liste denselben Test: Parst es das eingebettete XML? Das ist die richtige Frage für eine Datei, die eine vollständige XML-Nutzlast enthält. Es ist die falsche erste Frage für ein Team der Kreditorenbuchhaltung, denn die Antwort hängt davon ab, was Ihre Lieferanten tatsächlich senden. Deutschland verlangt seit Januar 2025, dass Unternehmen strukturierte E-Rechnungen empfangen können, aber die Pflicht zum Ausstellen wird bis 2028 schrittweise eingeführt. Während der Übergangsphase ist ein großer Teil dessen, was in Ihrem Posteingang landet, noch ein gewöhnliches PDF. Selbst eine echte ZUGFeRD-Datei kann einen XML-Anhang enthalten, der zu dünn für die Buchung ist. Ein Tool, das nur XML liest, ist eine hervorragende Antwort auf eine Frage, die die Hälfte Ihrer Rechnungen gar nicht stellt.
Wichtigste Erkenntnisse
- Jedes ZUGFeRD-Tool-Ranking für 2026 ist heimlich ein Ranking einer einzigen Fähigkeit: wie gut ein Tool das im PDF versteckte XML parst.
- Die Hälfte der Rechnungen in einem deutschen AP-Posteingang sind einfache PDFs oder Scans, und selbst eine echte ZUGFeRD-Datei kann ein MINIMUM- oder BASIC-WL-Profil ohne Positionen enthalten.
- Die richtige Shortlist beginnt mit Ihrem Lieferantenmix, nicht mit dem Parser, der ganz oben auf der Liste steht.
Was tatsächlich in einer ZUGFeRD-Datei steckt
ZUGFeRD (Zentraler User Guide des Forums elektronische Rechnung Deutschland) ist Deutschlands hybrides E-Rechnungsformat. Eine Datei, technisch ein PDF/A-3-Dokument nach ISO 19005-3, enthält zwei Kopien derselben Rechnung: die sichtbaren Seiten, die eine Person liest und druckt, sowie ein XML-Dokument, das gemäß den Archivierungsregeln für eingebettete Dateien im PDF eingebettet ist. Dieses XML folgt der UN/CEFACT Cross Industry Invoice (CII)-Syntax und ist in Deutschland die rechtlich entscheidende Ebene. Factur-X ist der französische Name für denselben Standard, und seit ZUGFeRD 2.1 sind beide technisch identisch – eine Spezifikation, die in Deutschland und Frankreich unter zwei Namen veröffentlicht wird.
Das XML wird in einem von mehreren Profilen geschrieben, und das Profil bestimmt, wie viel von der Rechnung die strukturierte Ebene tatsächlich enthält. Dies ist der Teil, den die meisten Tool-Vergleiche auflisten, ohne zu erklären, was er für die Person bedeutet, die eine AP-Tabelle erstellt.
| Profil | Positionen im XML | EN 16931-konform | Gültige E-Rechnung nach §14 UStG |
|---|---|---|---|
| MINIMUM | Nein | Nein | Nein |
| BASIC WL (ohne Zeilen) | Nein | Nein | Nein |
| BASIC | Ja | Ja | Ja |
| EN 16931 (COMFORT) | Ja | Ja | Ja |
| EXTENDED | Ja | Ja | Ja |
| XRECHNUNG (Referenzprofil) | Ja | Ja, als CIUS | Ja |
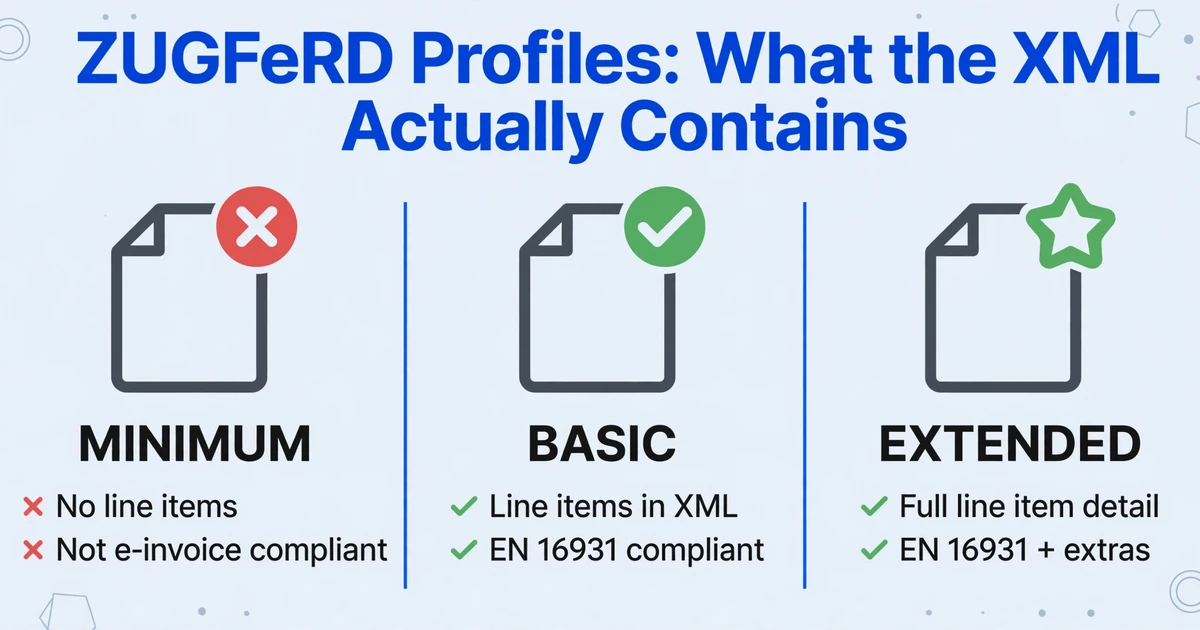
Das deutsche Bundesfinanzministerium akzeptiert ZUGFeRD ab Version 2.0.1, schließt jedoch MINIMUM und BASIC WL aus, da diese beiden Profile zu oberflächlich sind, um als konforme E-Rechnungen zu gelten. Die aktuelle Spezifikation, gepflegt von FeRD zusammen mit dem französischen FNFE-MPE, wird mit dem im XML deklarierten Profil veröffentlicht und von Validatoren sowie Buchhaltungssystemen gleichermaßen gelesen. Die genauen Profilregeln und Dateibenennungskonventionen sind auf der offiziellen ZUGFeRD-Informationsseite dokumentiert.
Das Profil – nicht allein das Vorhandensein eines XML-Anhangs – entscheidet, ob eine ZUGFeRD-Datei die Positionen enthält, die Ihre AP-Tabelle benötigt. MINIMUM und BASIC WL enthalten überhaupt keine.
XRechnung steht für die meisten praktischen Zwecke neben ZUGFeRD und nicht darin. Es ist ein reines XML-Format, entweder in CII- oder UBL-Syntax, ohne menschenlesbare PDF-Ebene, gepflegt von KoSIT und für Rechnungen an die deutsche öffentliche Verwaltung erforderlich. ZUGFeRD definiert außerdem ein XRECHNUNG-Referenzprofil, das ein XRechnung-konformes XML in das hybride PDF einbettet. Diese Unterscheidung ist später wichtig, da sie entscheidet, welche Tools eine Datei überhaupt öffnen können.
Das XML-native Tool und das visuelle Tool lösen unterschiedliche Probleme
Nahezu jeder ZUGFeRD-Vergleich läuft auf zwei technische Familien hinaus, und der sinnvolle Schritt ist zu verstehen, was jede einzelne liest, statt zu fragen, welche fortschrittlicher klingt.
Ein XML-natives Tool lokalisiert das eingebettete CII-XML und parst es direkt. Es gibt keinen Erkennungsschritt, daher sind die Feldwerte deterministisch: Das Tool liest dieselben Bytes, die auch ein Validator lesen würde. Es verarbeitet das XML, egal ob der Datensatz an eine PDF angehängt oder als eigenständige XRechnung-Datei geliefert wird. Sein blinder Fleck ist jede Rechnung ohne verwertbares XML – dazu gehören einfache PDFs, Scans, Fotos und Dateien mit geringem Profil, deren XML keine Positionen enthält.
Ein Tool auf visueller Ebene liest die gerenderte Seite so, wie ein Mensch sie sieht, und nutzt OCR sowie ein Vision-Modell, um zu verstehen, was jeder Wert bedeutet. Es kann jede Datei mit einer lesbaren Seite verarbeiten: eine echte ZUGFeRD-PDF, eine flache Lieferanten-PDF, einen Scan oder ein Handyfoto. Sein blinder Fleck ist das rohe XRechnung-XML, das keine Seite zum Lesen hat, und es kann nicht die Byte-genaue Sicherheit des Parsings bieten.
| Eingangseingabe | XML-natives Tool | Tool auf visueller Ebene |
|---|---|---|
| ZUGFeRD-PDF, EN 16931 (COMFORT) oder EXTENDED | Liest das eingebettete XML exakt | Liest die gerenderten Seiten |
| ZUGFeRD-PDF, MINIMUM oder BASIC WL | Liest nur Kopfdaten, keine Positionen | Liest, was die Seiten zeigen |
| Einfache PDF oder gescannte Rechnung | Nichts zu parsen | Liest die Seite |
| Rohes XRechnung-XML (ohne PDF) | Liest das XML direkt | Keine Seite zum Lesen |
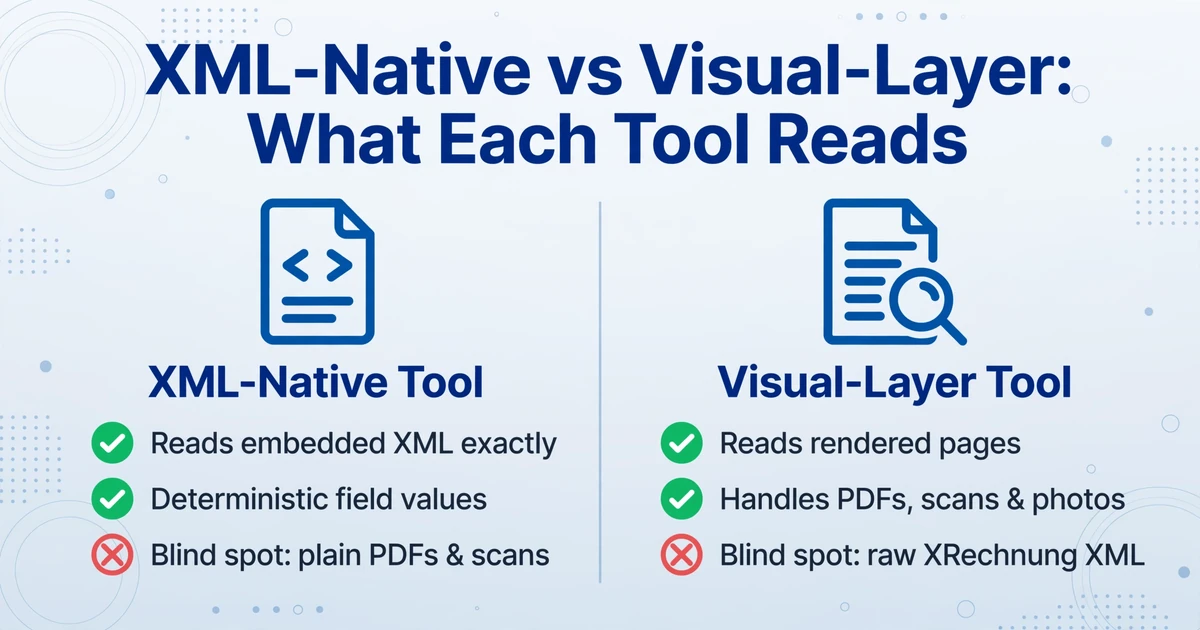
Die beiden Familien werden nicht gegeneinander bewertet. Sie werden auf die Eingabe abgestimmt, und die meisten realen Posteingänge benötigen irgendwann beide Arten der Abdeckung.
Warum „Einfach das XML parsen“ in einem echten AP-Posteingang scheitert
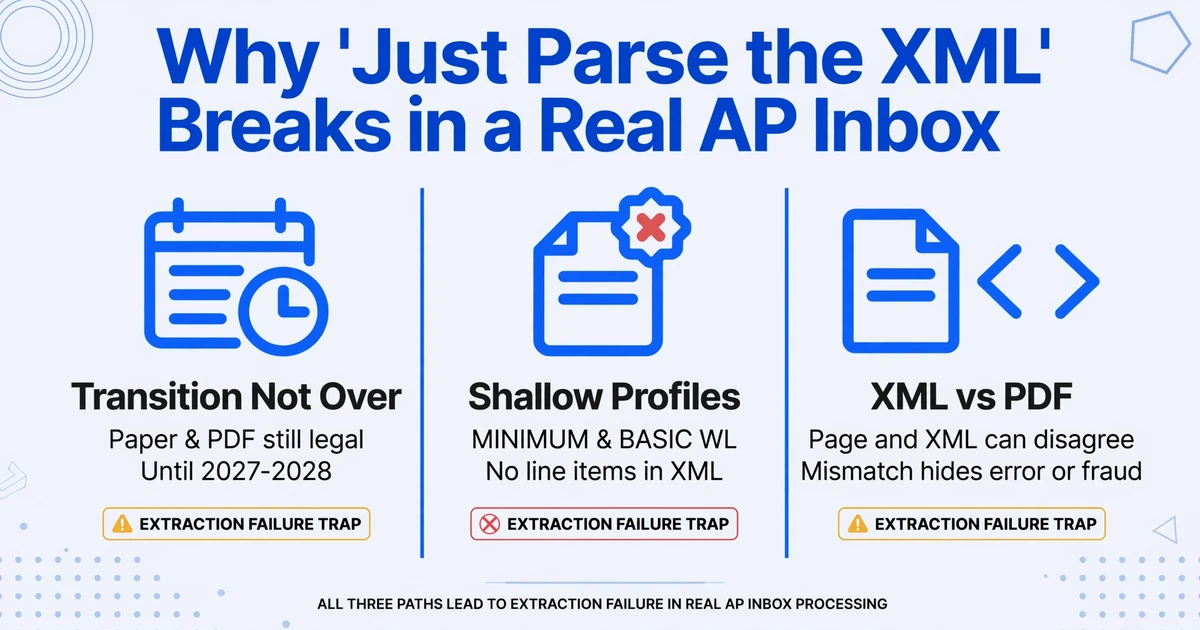
Drei konkrete Gegebenheiten erklären, warum der XML-First-Ansatz Lücken hinterlässt – und jede davon zeigt sich heute in der deutschen und europäischen Kreditorenbuchhaltung.
Die Übergangsphase ist noch nicht vorbei. Seit dem 1. Januar 2025 muss jedes Unternehmen in Deutschland in der Lage sein, E-Rechnungen nach EN 16931 zu empfangen, und die E-Rechnungs-Seite der Europäischen Kommission für Deutschland legt den gestaffelten Start fest: Lieferanten mit einem Umsatz über 800.000 EUR müssen ab dem 1. Januar 2027 E-Rechnungen ausstellen, alle übrigen Lieferanten ab dem 1. Januar 2028. Bis zu diesen Terminen – und für kleinere Unternehmen im Rahmen der Übergangsregelungen – dürfen Lieferanten mit Zustimmung des Empfängers weiterhin Papier- oder einfache PDF-Rechnungen senden. Ein Team, das 2026 seine PDF-Verarbeitung entfernt, weil „E-Rechnungen jetzt Pflicht sind“, lässt jeden Lieferanten außen vor, der noch nicht umgestellt hat. Den vollständigen rechtlichen Zeitplan, einschließlich der Trennung von XRechnung und ZUGFeRD, finden Sie in unserem Leitfaden zur E-Rechnungspflicht in Deutschland.
Nicht jedes XML ist es wert, geparst zu werden. Die Profiltabelle oben ist keine Nebensächlichkeit. MINIMUM und BASIC WL sind ausdrücklich von der Pflicht ausgenommen, was bedeutet, dass ein Lieferant, der eines davon sendet, die Anforderung ebenfalls nicht erfüllt – dennoch treffen diese Dateien weiterhin ein und werden oft an die Kreditorenbuchhaltung weitergeleitet, als wären sie vollständig. Wenn Ihre Ausgabetabelle Mengen pro Position, Einzelpreise und Steuerschlüssel benötigt, liefert ein Parser, der eine BASIC-WL-Datei brav liest, Kopfsummen und stoppt. Das XML existiert. Die Daten, die Sie benötigen, nicht. Legacy-ZUGFeRD-1.0-Dateien, die vor EN 16931 entstanden sind und ein anderes Wurzelelement verwenden, verursachen dasselbe Problem bei archivierten Rechnungen.
XML und PDF können voneinander abweichen. Diesen Punkt überspringen die Tool-Listen vollständig, und die offizielle ZUGFeRD-Dokumentation spricht ihn direkt an. Da eine Hybriddatei zwei Darstellungen enthält, kann eine betrügerische oder fehlerhafte Rechnung auf der Seite einen Betrag und im XML einen anderen zeigen. Die ZUGFeRD-FAQ warnt davor, nur die PDF zu prüfen und dann die XML-Version zu bezahlen, und merkt an, dass die automatische Erkennung von Abweichungen OCR und Rechnungserkennung erfordert, mit Ergebnissen, die höchstwahrscheinlich nicht perfekt sein werden. In der Praxis wirkt das in beide Richtungen: Die visuelle Ebene ist es wert, gelesen zu werden, selbst wenn XML existiert, und keine Methode – visuell oder XML – kann für sich beanspruchen, perfekt zu sein.
Die gelebte Version dieses Problems klingt weniger technisch. In einem r/Accounting-Thread zur Verarbeitung deutscher E-Rechnungen in nicht-deutschen ERPs beschrieb ein Praktiker die Lage schlicht: „Die meisten deutschen Lieferanten senden trotz des ganzen E-Rechnungs-Hypes weiterhin normale PDFs, und unser ERP (nicht SAP) behandelt XRechnung im Grunde wie eine Fremdsprache, also ja, es findet immer noch viel manuelle Erfassung statt. Die OCR-Tools, die wir ausprobiert haben, waren an einem guten Tag vielleicht zu 70 % genau“ (r/Accounting). Lieferanten, die PDFs senden, ERPs, die kein XML sprechen, und Tools, die Felder übersehen – all das erscheint im selben Satz.
Die Frage, die über Ihr Ergebnis entscheidet, ist nicht „parst es XML“. Sie lautet: „Erzeugt es die Spalten, die meine Ausgabe benötigt, aus jeder Art von Datei, die meine Lieferanten senden?“
Die besten ZUGFeRD-Extraktionstools 2026, nach Ansatz gruppiert
Es gibt keinen einzelnen Gewinner unter den ZUGFeRD-Extraktionstools für 2026, da die Tools für unterschiedliche Eingaben gebaut sind. Eine Gruppierung nach Ansatz ist nützlicher als eine einzelne Rangliste. Die folgenden Einträge decken die Namen ab, die in ernsthaften Shortlists immer wieder auftauchen, plus die Option auf der visuellen Ebene. Wenn Sie Ihre Kriterien noch über die breitere Kategorie hinweg definieren, geht unser Vergleich von Software zur Rechnungsdatenextraktion weiter.
| Tool | Ansatz | Am besten geeignet für | Achtung |
|---|---|---|---|
| FormX | XML-nativer REST-API, kostenloses Einzeldokument-Tool | Entwickler, deren Dateien vollständiges XML enthalten und die JSON über eine API möchten | Nur gehostet; prüfen Sie, ob es Ihren Datenresidenz-Regeln entspricht |
| InvoiceXML | XML-nativer API für Extraktion, Erstellung, Validierung, Konvertierung | Teams, die auch E-Rechnungen erzeugen oder validieren müssen | Entwicklerorientiert; keine AP-Prüfungsoberfläche |
| Rossum | Enterprise-Dokument-KI, ML-Extraktion mit Workflow-Regeln | Gemischte Portfolios, in denen ZUGFeRD nur ein Format unter vielen ist | Prüfen Sie, ob ZUGFeRD-Eingaben über XML oder die visuelle Ebene laufen |
| Klippa (Doxis) | EU-Dokumentverarbeitungsplattform mit Prüf-UI und API | EU-Teams im mittleren Markt, die menschliche Prüfung neben Automatisierung möchten | Anbietergeführtes Onboarding und Preise |
| ABBYY | Enterprise-IDP, in Richtung XML konfigurierbar | Organisationen, die bereits auf ABBYY standardisiert sind | Konfigurations- und Implementierungsaufwand für einen reinen ZUGFeRD-Umfang |
| Docsumo | Dokument-KI für Finanzdokumente, OCR-first | Eine Plattform für Kontoauszüge, Rechnungen und Bestellungen | Bestätigen Sie, dass ZUGFeRD-XML direkt gelesen und nicht neu erkannt wird |
| Mustang | Open-Source-Java-Bibliothek für CII-XML | Java-Teams, keine Lizenzkosten, Self-Hosting und Datenresidenz | Sie bauen und betreiben den Dienst; typisierte Objekte, keine UI |
| ImageToTable.ai | Extraktion auf visueller Ebene von PDF oder Scan, keine XML-Analyse | Gemischte Posteingänge mit einfachen PDFs, Scans und ZUGFeRD-Dateien mit geringem Profil, die nach Excel oder Sheets gehen | Kann keine rohe XRechnung-XML-Datei lesen; verwenden Sie ein XML-natives Tool, wenn das XML die Quelle der Wahrheit ist |
Ein paar Hinweise zum Lesen dieser Tabelle. „Am besten geeignet für" beschreibt das Eingabeprofil, für das ein Tool gebaut wurde, keine allgemeine Qualitätsrangliste. Die Funktionen der Tools ändern sich, also prüfen Sie die aktuelle Dokumentation, bevor Sie sich festlegen. Und die richtige Antwort sind oft zwei Tools statt einem: ein XML-nativer Parser für die Dateien mit vollständigen strukturierten Daten plus ein Tool auf visueller Ebene für die einfachen PDFs, Scans und unvollständigen Dateien, die von Anfang an kein brauchbares XML hatten. Diese zweite Kategorie ist größer, als die Tool-Listen während der deutschen Umstellung vermuten lassen.
So wählen Sie basierend darauf, was Ihre Lieferanten tatsächlich senden
Das Entscheidungsgerüst, das in der Praxis Bestand hat, beginnt mit einer Zählung, nicht mit einer Funktionsmatrix. Ziehen Sie Ihre letzten hundert eingehenden Lieferantenrechnungen und sortieren Sie sie in vier Stapel: echte ZUGFeRD- oder Factur-X-PDFs mit einem EN 16931- oder EXTENDED-Profil, rohe XRechnung-XML, gewöhnliche PDFs und Scans oder Fotos. Die Größe jedes Stapels beantwortet den Großteil der Auswahlfrage.
Wenn fast alles vollständige XML enthält
Wählen Sie einen XML-nativen Parser oder eine API. Sie erhalten deterministische Felder, können gegen die EN-16931-Regeln validieren, und das rohe XML bleibt für die Archivierung verfügbar, die die deutschen Aufbewahrungsvorschriften als Original erwarten. Ein visuelles Tool bringt hier wenig.
Wenn ein nennenswerter Anteil einfaches PDF oder Scan ist
Sie benötigen ein Tool für die visuelle Ebene oder ein Zwei-Tool-Setup. Das ist der übliche Fall 2026: eine Lieferantenbasis, die sich auf frühe E-Rechnungs-Anwender und Unternehmen innerhalb des Übergangszeitraums verteilt. Ein visuelles Tool liest sowohl echte ZUGFeRD-Seiten als auch flache PDFs über dieselbe Pipeline.
Wenn Sie rohe XRechnung-XML lesen müssen
Ein XML-natives Tool ist die einzige Option. Eine reine XML-Datei hat keine Seite, die ein visuelles Tool lesen könnte. Teams, die von deutschen öffentlichen Auftraggebern Rechnungen erhalten, sollten dies als harte Anforderung betrachten, nicht als Präferenz.
Entscheiden Sie, wo die Daten landen sollen
DATEV, Lexware und SAP importieren die eingebettete XML direkt. Wenn dieser Weg für Sie bereits funktioniert, ist die verbleibende Lücke das PDF. Wenn Ihr Ziel eine Tabellenkalkulation oder eine Importvorlage ist, entfernt ein visuelles Tool, das Excel oder CSV ausgibt und optional in Google Sheets schreibt, das meiste erneute Abtippen.
Passen Sie das Tool an Ihr Volumen und Ihre Positionsdichte an
Batch-Verarbeitung wird wichtig, sobald Sie über einen Rinnsal von Rechnungen pro Tag hinaus sind oder einzelne Rechnungen Hunderte von Positionen über viele Seiten umfassen. Ein Pro-Dokument-API-Aufrufmodell und ein Batch-Upload-Modell fühlen sich in einer Demo gleichwertig an und weichen bei Monatsendvolumen deutlich voneinander ab.
Eine weitere Überlegung, die nichts mit Formaten zu tun hat: grenzüberschreitende E-Rechnungsstellung wird nur breiter. Im Rahmen des EU-Pakets VAT in the Digital Age wird strukturierte E-Rechnungsstellung plus digitale Meldepflicht für innergemeinschaftliche B2B-Transaktionen ab dem 1. Juli 2030 verpflichtend, und die Europäische Kommission hat den Mitgliedstaaten bereits erlaubt, nationale E-Rechnungsstellung ohne spezielle Ausnahmegenehmigung vorzuschreiben. Der XML-Anteil wird weiter steigen. Die Tools, die nützlich bleiben, sind diejenigen, die den strukturierten Pfad abdecken, ohne die Dateien aufzugeben, die weiterhin als Dokumente ankommen.
Was die PDF-Ebenen-Extraktion für ZUGFeRD leisten kann und was nicht
Hier liegt die Grenze unseres eigenen Tools, und es lohnt sich, das klar zu sagen. ImageToTable.ai liest die visuelle Ebene einer Rechnung. Es parst kein eingebettetes XML. Diese eine Tatsache bestimmt sowohl, wofür es gut ist, als auch, was es nicht kann.
Der Mechanismus ist die Benutzerdefinierte Spaltenextraktion: Sie geben die gewünschten Spaltennamen ein, z. B. „Lieferant", „Rechnungsnummer", „Rechnungsdatum", „Nettobetrag", „Umsatzsteuerbetrag" und „Positionstext", und die KI lokalisiert jeden Wert, indem sie versteht, was er bedeutet, statt wo er auf der Seite steht. Es gibt keine Vorlage zum Zeichnen und kein Beispiel zum Trainieren, und die von Ihnen eingegebenen Spaltennamen werden zu den Kopfzeilen der Ausgabetabelle. Dadurch durchlaufen eine flache Lieferanten-PDF und eine echte ZUGFeRD-PDF denselben Vorgang, weil beide Seiten zum Lesen haben.
Für die Kreditorenbuchhaltung passen drei weitere Funktionen zur ZUGFeRD-Realität. Batch-Verarbeitung bedeutet, dass Sie viele Dateien auf einmal hochladen und diese in einer einzigen Excel-Tabelle mit konsistenten Spalten zusammengeführt werden, sodass ein gemischter Ordner aus ZUGFeRD-PDFs und Scans einen Datensatz statt einer Datei pro Lieferant erzeugt. Die Mehrseiten-Zusammenführung gruppiert Ergebnisse, die zum selben logischen Dokument gehören, sodass eine lange, sich über mehrere Seiten erstreckende Rechnung oder ein seitenweise fotografiertes Dokument in einer Zeile oder einer fortlaufenden Zeilengruppe zusammengefaltet wird, statt verstreut zu werden. Der Prüfmodus mit Bbox-Verifizierung ermöglicht es Ihnen, über eine extrahierte Zelle zu fahren oder sie anzuklicken und genau zu sehen, wo auf der Originalseite der Wert herkommt – wichtig für Finanzarbeit, wo eine falsch gelesene Ziffer zu einer falschen Zahlung wird. Zu den Eingaben gehören PDFs, einschließlich passwortgeschützter Dateien, sowie JPG, PNG, WebP, AVIF und Screenshots; die Ausgabe kann Excel, CSV, JSON oder Word sein.
Bei der Geschwindigkeit verarbeitet das Tool eine gedruckte Rechnungsseite in fünf bis zehn Sekunden, gegenüber durchschnittlich etwa drei Minuten manueller Eingabe, und erreicht bis zu 99 Prozent Erkennungsgenauigkeit bei gedruckten Tabellendaten. Dichte Handschrift oder ein minderwertiger Scan wird besser auf einer höheren Verarbeitungsstufe behandelt, die das Tool als Standard, Advanced oder Premium bereitstellt.
Die Grenzen sind ebenso konkret. Es liest, erzeugt oder validiert kein eingebettetes CII-XML, daher kann es für Teams, die das strukturierte Original erhalten oder validieren müssen, keinen XML-nativen Parser ersetzen. Es kann keine rohe XRechnung-XML-Datei verarbeiten, weil es keine Seite zum Lesen gibt. Es prüft keine Datei gegen die EN-16931-Regeln und bucht nichts in DATEV, Lexware oder SAP. Was es tut, ist, die Dokumente ohne nutzbare strukturierte Daten in die Tabellenzeilen zu verwandeln, die der Rest Ihres Prozesses konsumiert. Die Mechanismen übertragen sich auf die gewöhnliche deutsche Rechnungsextraktion (Rechnung), unabhängig davon, ob eine Datei zufällig ZUGFeRD ist.
Die visuelle Extraktion deckt die Ebene ab, die auf jeder eingehenden Rechnung vorhanden ist; das XML-Parsing deckt die Ebene ab, die nur manchmal vollständig ist. Keines ersetzt das andere, und zu wissen, welche Datei welche ist, ist die Fähigkeit, die Tool-Listen auslassen.
Häufig gestellte Fragen
Was ist das beste ZUGFeRD-Extraktionstool im Jahr 2026?
Das hängt davon ab, was Ihre Lieferanten senden. Wenn Ihre eingehenden Dateien zuverlässig vollständige EN 16931- oder EXTENDED-XML-Daten enthalten, liefert ein XML-nativer Parser wie ein API-basierter Extraktionsdienst deterministische Felder. Wenn ein erheblicher Anteil als einfache PDFs, Scans oder ZUGFeRD-Dateien mit geringem Profil ankommt, benötigen Sie ein Tool, das die gerenderten Seiten auf visueller Ebene liest. Viele Teams nutzen am Ende beides.
Sollte ein ZUGFeRD-Extraktionstool die XML- oder die PDF-Ebene lesen?
Beide Ansätze sind gültig und beantworten unterschiedliche Situationen. Das Lesen der XML ist exakt und kann gegen den Standard validieren, funktioniert aber nur, wenn die XML vorhanden und vollständig ist. Das Lesen der PDF oder des Scans funktioniert bei jeder Datei mit einer lesbaren Seite, einschließlich der einfachen Rechnungen, die während der deutschen Umstellung weiterhin viele Posteingänge dominieren. Der Fehler besteht darin anzunehmen, dass ein Ansatz die gesamte Lieferantenbasis abdeckt.
Kann ImageToTable.ai Daten aus einer ZUGFeRD-PDF extrahieren?
Ja, aus den sichtbaren PDF-Seiten. ZUGFeRD ist eine Hybriddatei, die immer eine für Menschen lesbare Ebene enthält, und ImageToTable.ai liest diese Ebene mithilfe der von Ihnen definierten Spalten. Es parst oder gibt die eingebettete XML nicht aus. Es ist also das richtige Werkzeug, um Positionen und Kopffelder in eine Tabellenkalkulation zu übernehmen, nicht jedoch zum Validieren oder Archivieren des strukturierten Originals.
Funktioniert ImageToTable.ai mit XRechnung-Rechnungen?
Nur wenn eine XRechnung als PDF oder Scan mit einer lesbaren Seite ankommt. Eine reine XRechnung-Datei ist reine XML ohne visuelle Ebene, und ImageToTable.ai akzeptiert keine XML als Eingabe. Für reine XRechnung-Dateien benötigen Sie einen XML-nativen Parser.
Kann ich viele ZUGFeRD-Rechnungen auf einmal stapelweise verarbeiten?
Ja. ImageToTable.ai ist auf Batch-First-Verarbeitung ausgelegt: Laden Sie mehrere Dateien hoch, und sie werden in einer Excel-Tabelle mit denselben Spalten zusammengeführt. Das funktioniert für einen Ordner, der echte ZUGFeRD-PDFs, einfache Lieferanten-PDFs und Scans mischt, da die Extraktion von den von Ihnen festgelegten Spaltennamen gesteuert wird und nicht vom Format der jeweiligen Datei.
Gibt es ein kostenloses ZUGFeRD-Extraktionstool?
Kostenlose Optionen existieren und lohnen sich für einen ersten Blick. Die Open-Source-Bibliothek Mustang parst ZUGFeRD- und Factur-X-XML tatsächlich ohne Lizenzkosten, allerdings müssen Sie den Dienst darum herum selbst aufbauen und betreiben. Mehrere kommerzielle Anbieter bieten ein kostenloses Online-Tool für Einzeldokumente oder eine Testversion an, typischerweise ohne Batch- oder API-Zugriff. Für Mengenverarbeitung ist ein kostenpflichtiger Plan oder ein selbst gehosteter Aufwand zu erwarten.
Was ist der Unterschied zwischen ZUGFeRD und Factur-X?
Es handelt sich um denselben technischen Standard unter zwei Namen. ZUGFeRD ist die deutsche Bezeichnung und Factur-X die französische, beide werden seit ZUGFeRD 2.1 gemeinsam gepflegt, mit identischen PDF/A-3-Containern, identischem CII-XML und denselben Profilen. Ein Tool, das das eine verarbeitet, sollte auch das andere verarbeiten; fragen Sie gezielt, wie es Dateien mit einem factur-x.xml-Anhang im Vergleich zum älteren Namen zugferd-invoice.xml behandelt.
Die Liste der „besten ZUGFeRD-Extraktionstools" ist eigentlich eine Liste von Antworten auf eine eng gefasste Frage: Welches Tool parst das eingebettete XML? Diese Frage ist berechtigt, und für einen vollständig strukturierten Lieferantensatz ist die XML-native Antwort die richtige. Aber das deutsche Mandat wird noch schrittweise eingeführt, einfache PDFs bleiben noch eine Weile zulässig, und die niedrigeren ZUGFeRD-Profile liefern XML ohne die Positionsdaten, die eine AP-Tabelle benötigt. Das Team, das weiß, welche seiner Rechnungen tatsächlich vollständige strukturierte Daten enthalten, wählt ein besseres Tool als das Team, das den am höchsten bewerteten Parser auswählt.