Como criar um fluxo de trabalho de correspondência tripla no Google Sheets:
Passo a passo do pedido de compra à aprovação de faturas
Nossa análise sobre por que a correspondência tripla falha na manufatura estabeleceu que o gargalo não é o algoritmo de correspondência — é a etapa de extração de dados que o precede. Os benchmarks de AP de 2025 da Ardent Partners colocam a taxa média de divergência na primeira passagem em 22%, e na manufatura — com pedidos de compra abertos, remessas parciais e variação de unidade de medida entre o recebimento e a fatura — esse número sobe ainda mais. O diagnóstico é claro: você não pode corresponder três documentos se dois deles ainda estão presos em PDFs não estruturados. A pergunta que este artigo responde é: o que você realmente constrói para resolver isso — e você pode construir sem um ERP? A base é uma etapa repetível de extração de PDF para o Google Sheets que transforma cada documento em linhas limpas antes que qualquer fórmula de correspondência seja executada.
Este é o guia de construção. Ele percorre as quatro camadas de extração e correspondência de um pipeline do Google Sheets passo a passo — quais colunas definir, quais fórmulas escrever e como os fornecedores enviam documentos diretamente por um Link de Coleta. Se você procura o framework de reconciliação — regras de tolerância, zonas de correspondência automática e como lidar com nomes de itens ambíguos durante a revisão — veja nosso guia complementar sobre correspondência tripla no Google Sheets sem ERP.
Principais Conclusões
- Uma taxa de divergência de 22% na primeira passagem parece um problema de algoritmo, mas começa a montante, na etapa de extração de dados.
- 66% das equipes de AP ainda digitam dados de faturas manualmente em seus ERPs, então o módulo de correspondência fica ocioso enquanto alguém termina a digitação.
- A extração de nomes de colunas do ImageToTable.ai lê o formato de cada fornecedor sem um modelo pré-configurado, transformando o que era uma investigação de três departamentos em um VLOOKUP e uma célula verde.
O que a Conciliação Tríplice Realmente Exige — Mais do que Limites de Tolerância
A conciliação tríplice é o processo de comparar um pedido de compra, um recebimento de mercadorias e uma fatura do fornecedor antes de autorizar o pagamento — verificando se o que foi pedido corresponde ao que foi recebido e ao que foi faturado. De acordo com a Cláusula 8.4 da ISO 9001:2015, a verificação de que os produtos adquiridos atendem aos requisitos especificados é obrigatória para fabricantes certificados, e a conciliação tríplice é o mecanismo operacional que a maioria das empresas usa para cumpri-la. O Relatório para as Nações 2024 da ACFE — que estima que as organizações perdem 5% da receita anual para fraudes ocupacionais — a identifica como um controle-chave contra esquemas de faturamento. A lógica regulatória é sólida. O problema de dados subjacente é o que quebra na prática.
A maioria dos conselhos sobre como corrigir a conciliação tríplice foca na camada de correspondência: apertar limites de tolerância, adicionar fluxos de aprovação, configurar regras de correspondência automática no ERP. Nada disso resolve o problema de que os três documentos chegam de três sistemas diferentes em três formatos diferentes — e dois deles são não estruturados. O pedido de compra está no sistema de compras. O recebimento de mercadorias pode ou não ter sido inserido a partir de um canhoto de entrega em papel. A fatura do fornecedor chega como um PDF. Antes que qualquer lógica de correspondência possa comparar esses documentos, alguém precisa extrair os dados dos dois que não estão em um formato estruturado, inseri-los em um layout comparável e torcer para que as unidades e os itens estejam alinhados. A camada de correspondência — PROCV, funções SE, formatação condicional — é a parte fácil. A camada de extração é onde o pipeline vive ou morre.
Um pipeline de conciliação tríplice funcional não começa com melhores regras de correspondência. Começa com a obtenção de todos os três documentos no mesmo formato estruturado na mesma planilha. Uma vez lá, a correspondência é um exercício de fórmulas. A parte difícil é colocá-los lá.
Por que o conselho de ERP não se aplica a um fluxo de trabalho com planilhas
O módulo MM do SAP, o Oracle E-Business Suite, o Microsoft Dynamics 365 — todos incluem módulos de correspondência de três vias com tolerâncias configuráveis. O SAP, por exemplo, lida com a correspondência por meio da conta de compensação GR/IR: o recebimento de mercadorias (transação MIGO) lança um débito, o recebimento de fatura (MIRO) lança um crédito, e o sistema compensa automaticamente os itens de linha correspondentes. A lógica é madura e bem documentada.
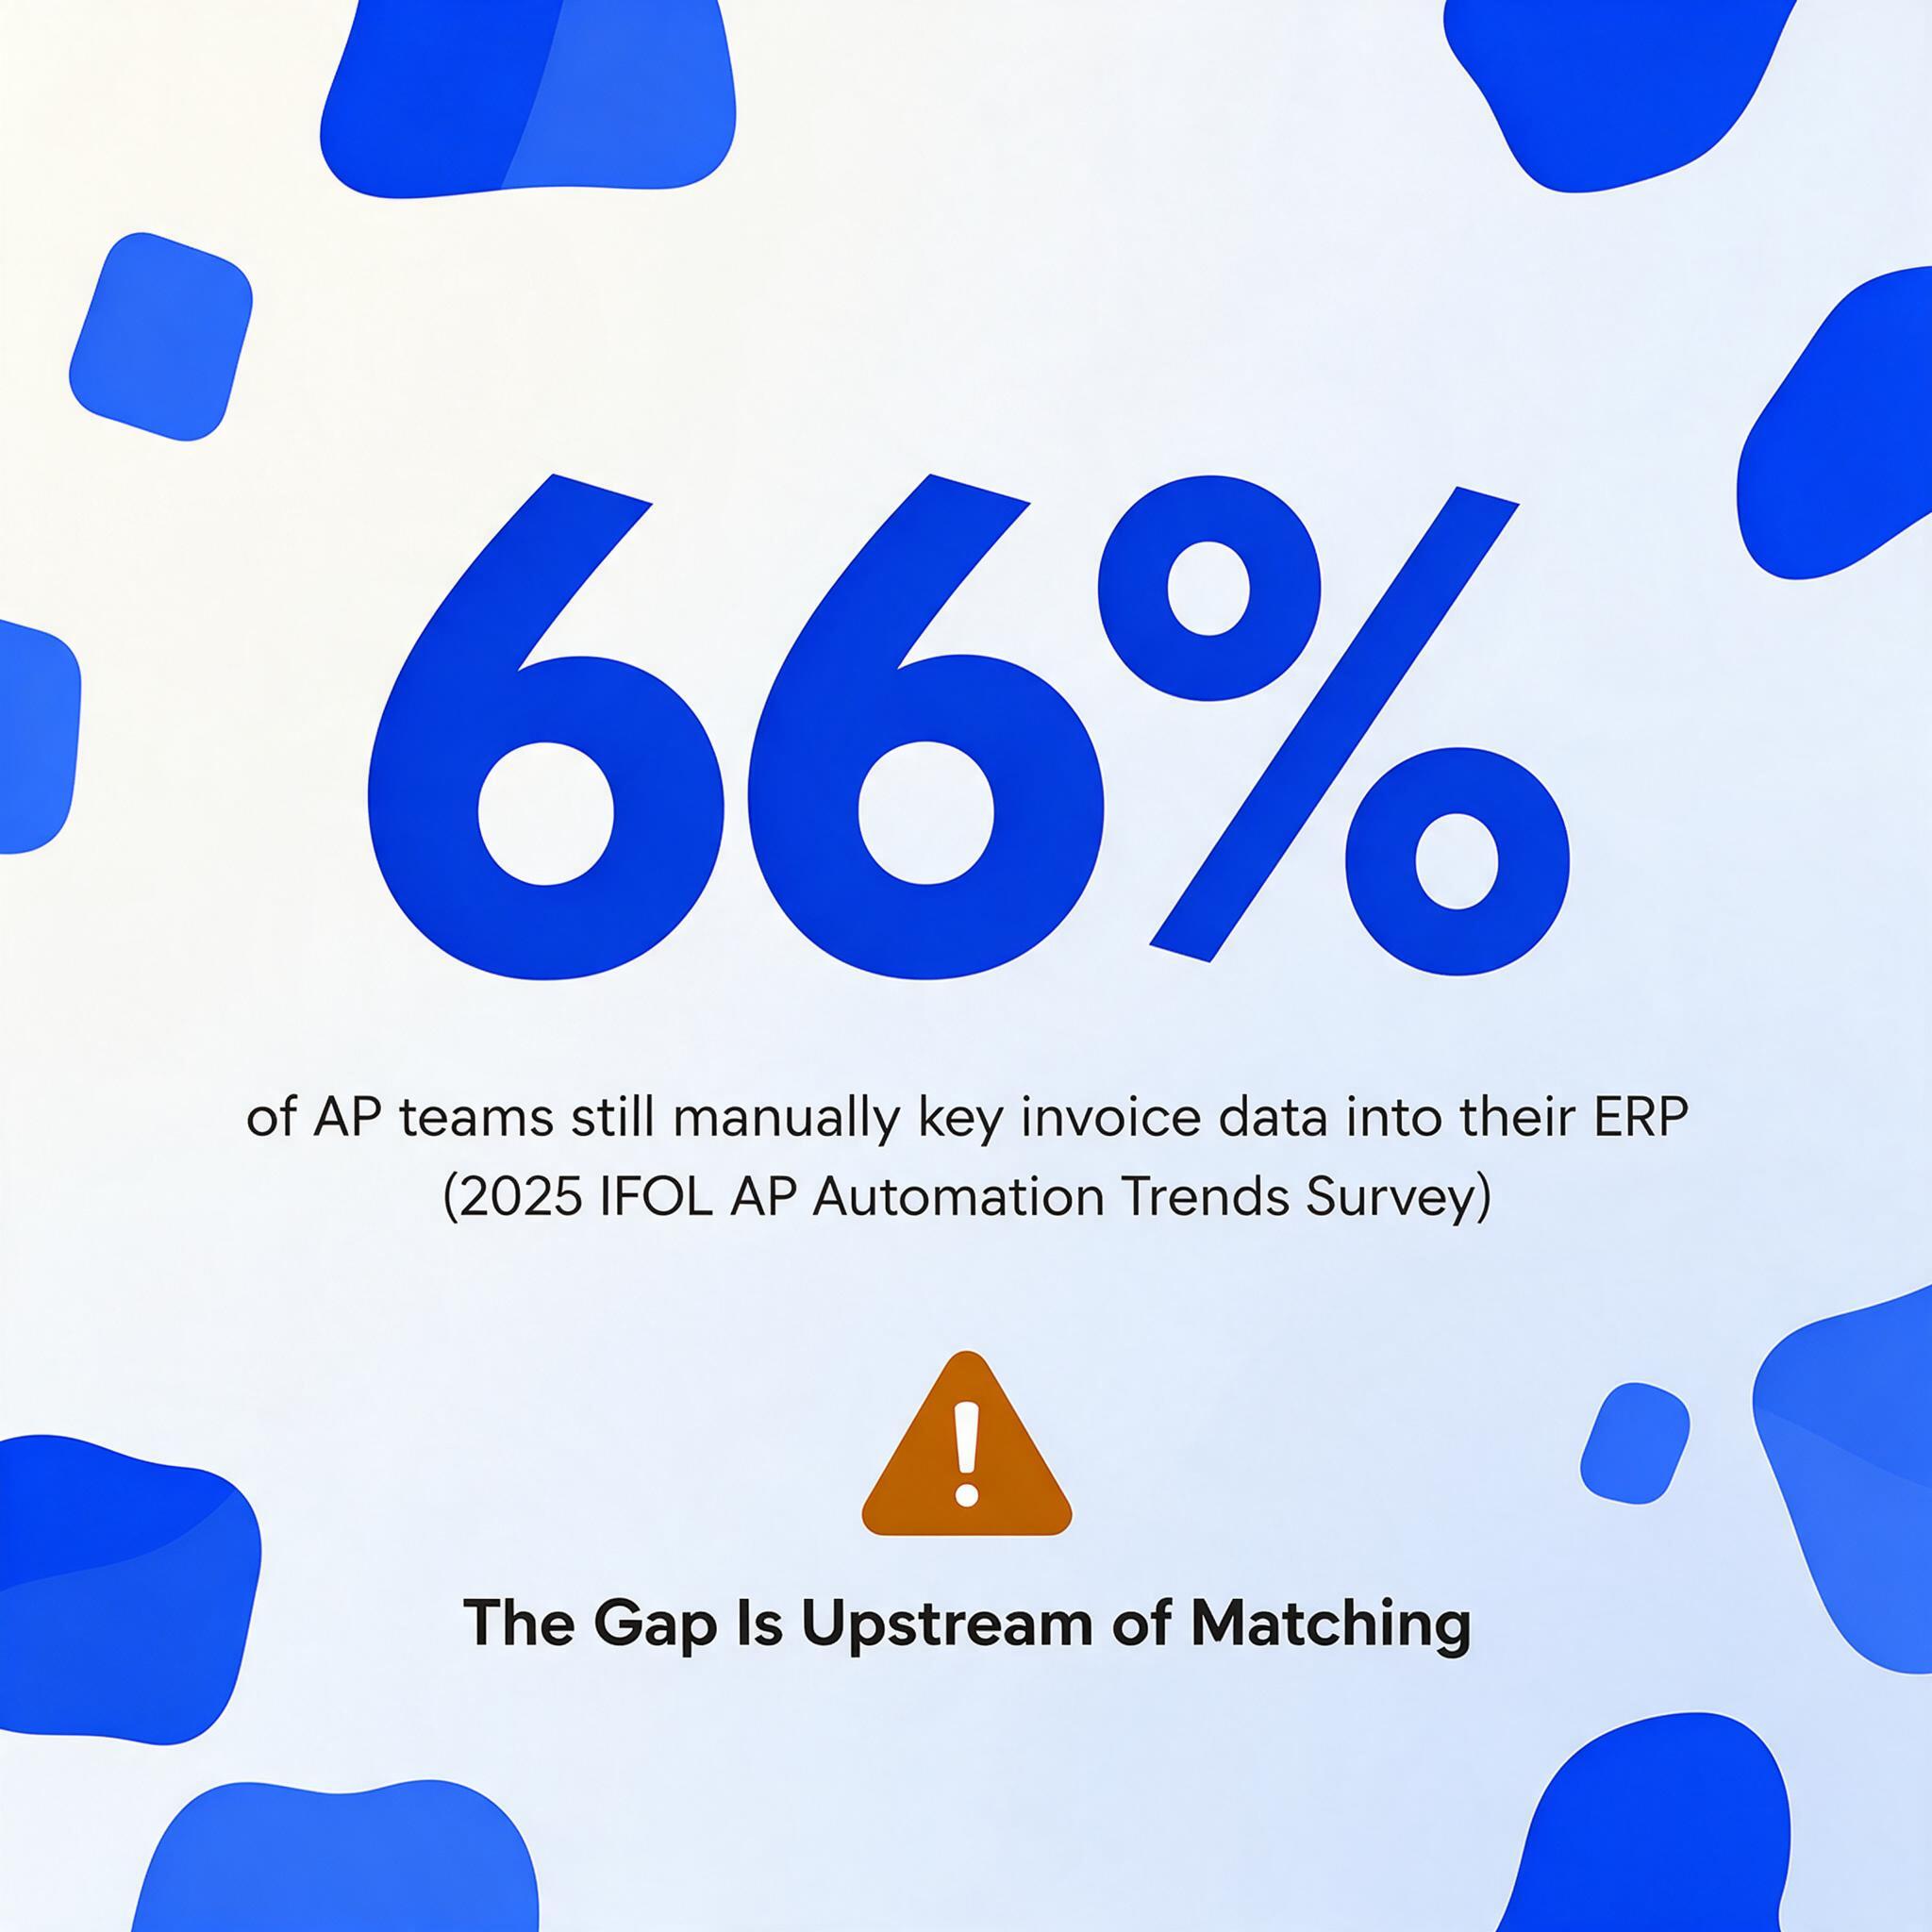
A lógica também pressupõe algo que, em um número substancial de operações de compras, não é verdade: que todos os três documentos existem como dados estruturados e comparáveis dentro do ERP antes que a lógica de correspondência seja executada. A pesquisa IFOL AP Automation Trends Survey de 2025 constatou que 66% das equipes de AP ainda inserem dados de fatura manualmente em seu ERP. Para equipes de compras que gerenciam relacionamentos com fornecedores em 50 a 200 fornecedores — muitos deles pequenas oficinas mecânicas, distribuidores locais e fornecedores especializados que enviam PDFs por e-mail — toda fatura é um evento de entrada manual de dados antes que a correspondência possa começar.
Se você está nesse grupo — seja porque sua empresa conduz compras por meio de planilhas, porque a captura de faturas do seu ERP exige configuração de modelo por fornecedor que você não tem tempo de manter, ou porque sua base de fornecedores inclui muitos pequenos fornecedores para os quais o PDF é o único formato enviado — o módulo de correspondência do ERP está resolvendo um problema a jusante do que você realmente tem. Você não precisa de um algoritmo de correspondência melhor. Você precisa de uma forma de reunir dados de PO, dados de recebimento e dados de fatura em uma única visão estruturada — e a ferramenta que você já usa para acompanhar compras provavelmente é uma planilha. A questão é como transformar essa planilha em um pipeline.
Arquitetura do Pipeline em Três Camadas
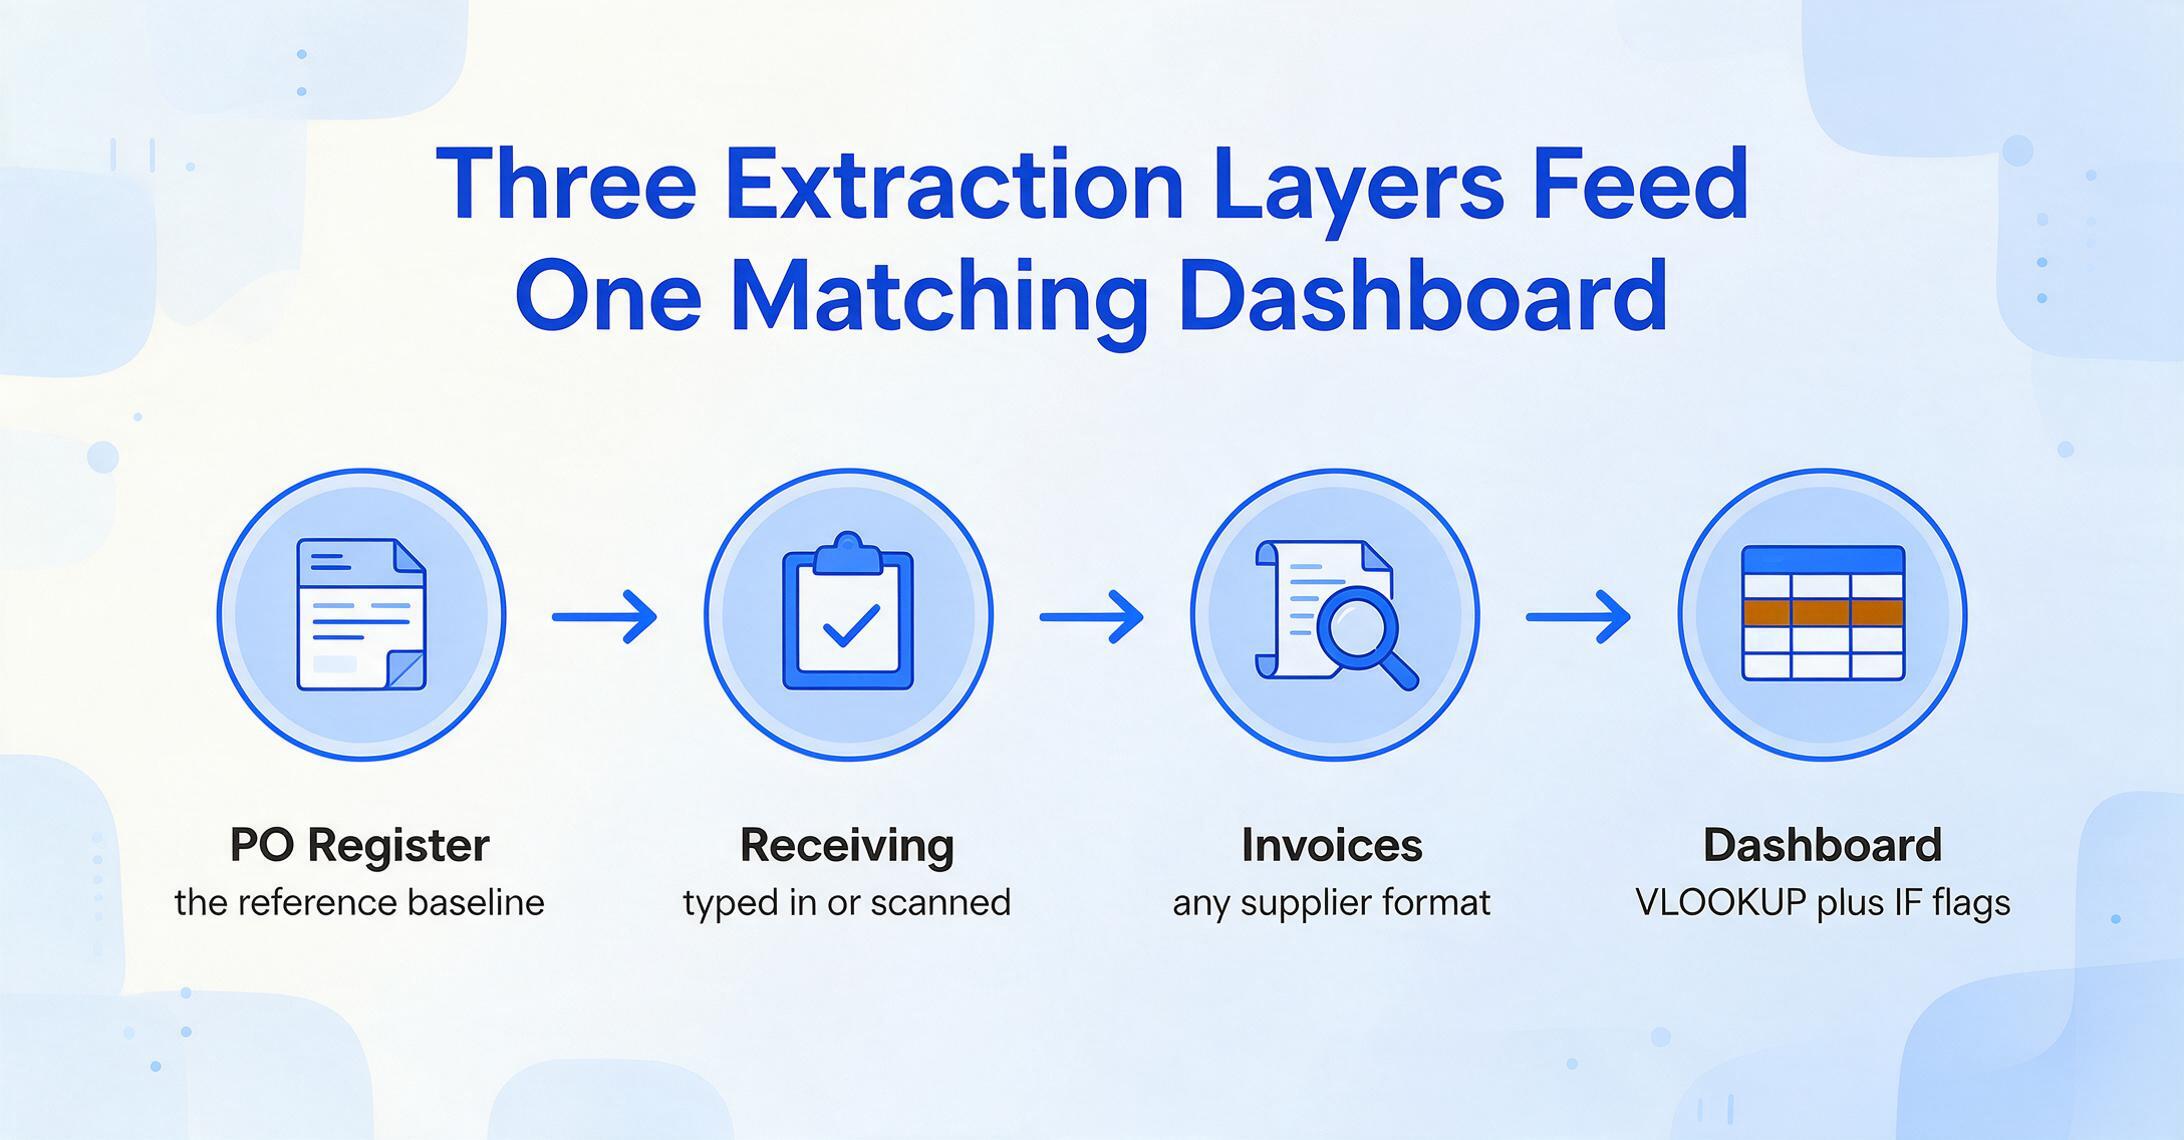
O pipeline tem três camadas, uma para cada documento na correspondência tripla, além de uma quarta que fica acima delas: o painel de correspondência. As três primeiras camadas extraem dados estruturados de documentos não estruturados. A quarta os compara. Se qualquer uma das três primeiras camadas produzir dados inconsistentes ou incompletos, a camada de correspondência não consegue fazer seu trabalho.
Cada camada preenche uma lacuna específica na cadeia de compras até o pagamento. A camada de pedidos estabelece a linha de base — o que foi pedido, a que preço, de quem. A camada de recebimento confirma o que chegou fisicamente. A camada de notas fiscais captura o que o fornecedor cobrou. O painel de correspondência é onde as três convergem — e onde a planilha substitui a investigação entre três departamentos que a análise do problema identificou como a fraqueza estrutural nos fluxos de correspondência tradicionais.
A ferramenta que viabiliza a conversão de não estruturado para estruturado nas camadas 1 e 3 é a Extração de Colunas Personalizadas: em vez de desenhar caixas ao redor dos campos em cada documento ou criar um modelo por formato de fornecedor, você digita os nomes das colunas desejadas — "Número do PO", "Nome do Fornecedor", "Item de Linha", "Quantidade", "Preço Unitário", "Total da Linha" — e a IA lê o documento para encontrar esses valores entendendo o que eles significam, não onde estão na página. Um PO estruturado do PDF do SAP e um PO manuscrito de um fornecedor local não se parecem em nada. Mas ambos contêm número de PO, nome do fornecedor, quantidades e preços. A extração por nome de coluna busca o significado desses campos em qualquer layout — eliminando a manutenção de modelos por fornecedor e por formato que torna o OCR baseado em modelos impraticável para equipes de compras que lidam com dezenas de formatos de documentos de fornecedores diferentes.
Camada 1 — Extração de Ordens de Compra: A Referência Base
Toda correspondência de três vias começa com a ordem de compra. O PO define os termos: qual fornecedor, quais itens, qual quantidade, a que preço, para entrega quando. Em um ambiente integrado ao ERP, esses dados já existem como itens de linha estruturados — o PO foi criado no sistema. Mas em um fluxo de trabalho de compras baseado em planilhas, os POs chegam em várias formas: PDFs gerados pelo próprio sistema do comprador, POs enviados por e-mail por fornecedores confirmando um pedido, ou documentos digitalizados de fornecedores menores que operam em papel. Colocar os dados do PO em um formato estruturado é o primeiro passo — e, para equipes baseadas em planilhas, é um passo que determina se o restante do pipeline é sequer possível.
As colunas de extração para um PO dependem do que seu processo de correspondência precisa referenciar. No mínimo:
| Coluna | O Que Ela Captura | Por Que Importa para a Correspondência |
|---|---|---|
| Número do PO | Identificador exclusivo do PO | O campo-chave — todo relatório de recebimento e fatura deve referenciar este campo para corresponder |
| Nome do Fornecedor | Nome do fornecedor conforme aparece no PO | Referência cruzada com o fornecedor da fatura — confirma o mesmo fornecedor |
| Item de Linha | Descrição do item, SKU ou número da peça | Corresponde aos itens de linha de recebimento e fatura para comparação em nível de item |
| Quantidade | Quantidade pedida por linha | Comparada com a quantidade recebida e a quantidade faturada |
| Preço Unitário | Preço unitário acordado por linha | Verificação de variação de preço — o sinalizador de auditoria mais comum |
| Total da Linha | Quantidade × Preço Unitário por linha | Comparado com o total da linha faturada — detecta erros de extensão |
| Data de Entrega | Data de entrega prevista | Usada para verificar datas de recebimento e sinalizar entregas atrasadas |
| Total do PO | Soma de todos os totais de linha | O valor agregado que a fatura não deve exceder sem explicação |
Para ordens de compra geradas internamente em um formato consistente — o modelo de PO da sua própria empresa — a extração é direta. A IA lê os mesmos campos do mesmo layout geral todas as vezes. Para POs de confirmação de fornecedor que chegam no formato do vendedor, a extração se adapta: os nomes das colunas permanecem os mesmos, e a IA localiza os valores independentemente do layout. Uma única execução de extração preenche a aba do registro de PO com dados estruturados — uma linha por PO, ou uma linha por item de linha, dependendo se você deseja granularidade em nível de cabeçalho ou de item para correspondência. O guia para extração de PO único com o complemento do Google Sheets percorre a configuração das colunas e o primeiro fluxo de extração. Para equipes de alto volume que processam dezenas de POs de uma vez, o painel de processamento de PO em lote aplica o mesmo mecanismo de extração em vários POs em uma única sessão.
Os arquivos são processados com segurança e não são armazenados.
A demonstração acima usa o preset de ordem de compra — um conjunto pré-configurado de colunas de extração projetado para documentos de PO. Envie uma ordem de compra e veja os campos serem preenchidos sem digitar. Se seus POs contiverem campos que o preset não cobre (uma linha de sobretaxa de mercadoria, uma seção de termos de frete, códigos internos de centro de custo), adicione-os como colunas personalizadas — o mecanismo de extração os trata da mesma forma. O preset fornece o ponto de partida. Suas colunas personalizadas o estendem para atender aos requisitos do seu painel de correspondência.
Camada 2 — Dados do Relatório de Recebimento: O Documento Intermediário Complicado
O recebimento de mercadorias é o documento com maior probabilidade de estar ausente em um sistema estruturado — e é o documento que torna a conciliação de três vias um processo de três vias. Sem a confirmação de recebimento, você está fazendo a conciliação de duas vias (pedido de compra vs. fatura) e pagando por mercadorias que não pode confirmar que foram entregues. A ACFE identifica especificamente o recebimento de mercadorias como o controle que previne fraudes de faturamento — pagar por mercadorias nunca enviadas. Ignorar isso não é um atalho. É uma lacuna na estrutura de controle.
Os dados de recebimento são mais difíceis de estruturar do que os dados de pedido de compra por causa de como são criados — no cais, muitas vezes em papel, por funcionários cuja prioridade é descarregar caminhões, não inserir dados. O romaneio é tipicamente um formulário de carbono em várias vias ou um documento impresso termicamente da transportadora. O funcionário do recebimento assina, registra a quantidade recebida (às vezes em unidades diferentes do pedido de compra) e arquiva a cópia física. Se esses dados entram em um sistema digital depende de alguém digitá-los depois — e esse passo é o primeiro a ser ignorado em um dia movimentado de recebimento.
Para o pipeline, os dados de recebimento têm dois caminhos viáveis de entrada. O primeiro é a inserção manual direta: o funcionário do recebimento — ou uma pessoa designada para entrada de dados — digita os campos-chave em uma Google Sheet como parte do fluxo de recebimento. As colunas espelham as colunas do pedido de compra: Número do Pedido (para vincular de volta), Item Recebido, Quantidade Recebida, Data de Recebimento, Transportadora, Condição. Este caminho funciona quando o volume de recebimento é moderado (menos de 30 remessas por dia) e o cais tem acesso a um dispositivo com Sheets aberto. A vantagem é o controle — os dados de recebimento são estruturados desde o momento da entrada, sem necessidade de conversão downstream.
O segundo caminho é a extração de documentos do próprio romaneio — tirar uma foto ou digitalizar o romaneio assinado e processá-lo pelo mesmo mecanismo de extração usado para pedidos de compra e faturas. Este caminho funciona quando a inserção manual não é viável — cais de alto volume, locais de recebimento remotos ou operações onde o romaneio é o único registro de recebimento. As colunas de extração são as mesmas: Número do Pedido, Descrição do Item, Quantidade Recebida, Data de Recebimento, Transportadora. Uma foto de celular de um romaneio processada pelo complemento da barra lateral preenche a aba de recebimento no mesmo formato estruturado que os dados inseridos manualmente. A principal limitação: a caligrafia nos romaneios reduz a precisão da extração em comparação com pedidos de compra e faturas impressos. Recomenda-se verificação pontual para remessas críticas. Para uma análise detalhada da precisão por qualidade do documento, consulte nosso guia sobre precisão de extração de documentos manuscritos — os mesmos princípios se aplicam a romaneios e relatórios de recebimento.
Qualquer que seja o caminho usado, o resultado é o mesmo: uma aba de registro de recebimento com o Número do Pedido como campo-chave que vincula cada recebimento ao seu pedido de compra de origem. Sem esse vínculo, o painel de conciliação não pode fazer seu trabalho.
Camada 3 — Extração de Faturas de Fornecedores: O Problema de Formato que Você Não Controla
Faturas de fornecedores são onde o problema da diversidade de formatos atinge seu ápice. Uma única operação de compras pode receber faturas de um grande distribuidor MRO em um PDF estruturado gerado por SAP, de um fornecedor regional de metais em um formato caseiro de Excel para PDF, de uma oficina mecânica local como um documento manuscrito fotografado, e de um fornecedor internacional com diferentes formatos de data, convenções de moeda e estruturas de linhas de impostos. O OCR baseado em modelos — onde você cria um modelo de mapeamento de campos para o layout de cada fornecedor e o atualiza quando o layout muda — quebra sob essa diversidade ou consome tanto tempo de manutenção que o esforço de extração equivale à entrada manual que deveria substituir.
A Extração de Colunas Personalizadas resolve isso desacoplando a lógica de extração de qualquer layout específico. Os nomes das colunas são definidos uma única vez. A IA lê cada fatura — independentemente do formato — e encontra os valores que correspondem a essas definições de coluna. Uma configuração de colunas de fatura para correspondência de três vias normalmente inclui:
| Coluna | Origem | Função na Correspondência |
|---|---|---|
| Número da Fatura | Extraído da fatura | Identificador único — evita pagamento duplicado |
| Número do Pedido de Compra | Extraído da fatura | O campo de vínculo crítico — deve corresponder a um pedido de compra na guia de registro de pedidos para que a correspondência funcione |
| Nome do Fornecedor | Extraído da fatura | Referência cruzada com o fornecedor do pedido de compra — detecta erros de referência de pedido incorreta |
| Data da Fatura | Extraído da fatura | Cálculo das condições de pagamento; análise de antiguidade |
| Data de Vencimento | Extraído da fatura | Acompanhamento da janela de desconto por pagamento antecipado |
| Descrição do Item de Linha | Extraído da fatura | Correspondência com o item de linha do pedido de compra — confirma que os mesmos produtos foram faturados e pedidos |
| Quantidade | Extraído da fatura | Verificação de variação em relação à quantidade do pedido de compra e à quantidade recebida |
| Preço Unitário | Extraído da fatura | Verificação de variação em relação ao preço unitário do pedido de compra — detecção de aumento de preço |
| Total da Linha | Extraído da fatura | Verificação de extensão — confirma que Qtd × Preço Unitário = Total da Linha na própria fatura |
| Total da Fatura | Extraído da fatura | Correspondência agregada com o total do pedido de compra ± tolerância; gatilho de autorização de pagamento |
Você também pode adicionar colunas inferidas — colunas que capturam dados não impressos explicitamente na fatura, mas deriváveis do seu contexto. Por exemplo, uma coluna definida como Match Status (options: Ready to Match/Needs PO Reference/Missing Line Items) permite que a IA classifique cada fatura durante a extração com base em se encontrou um número de PO e se os itens de linha foram extraíveis. Faturas que chegam de fornecedores que não incluem números de PO em seus documentos são sinalizadas imediatamente — elas entram no painel de correspondência com o status "Needs PO Reference", e o funcionário de contas a pagar sabe que não deve tentar uma correspondência até que o número de PO seja adicionado. Isso é categorização-como-extração: a decisão de classificação acontece na mesma passagem que preenche os dados, não em uma etapa de revisão separada.
Colunas calculadas lidam com a matemática que, de outra forma, exigiria fórmulas de planilha pós-extração. Defina uma coluna como Extension Check (Line Total - Quantity * Unit Price) e a IA realiza o cálculo durante a extração, sinalizando qualquer linha onde o total da linha faturada não seja igual à quantidade vezes o preço unitário. A saída é um número de variação — zero significa que a extensão está correta, um valor diferente de zero identifica um erro aritmético na fatura do fornecedor. Isso muda o papel do painel de correspondência de "encontrar os erros" para "revisar as linhas sinalizadas" — um fluxo de trabalho onde a IA faz a detecção e o humano faz a disposição. Para um tratamento completo da sintaxe e capacidades de colunas calculadas, consulte nosso guia de colunas calculadas em extração de documentos.
Diferenças de formato causam variações falsas antes que qualquer fórmula seja executada. Um fornecedor data uma fatura 05/06/2026, outro escreve 06/05/2026, e o mesmo número de peça pode ter um zero à esquerda em um documento e não no próximo. A camada de extração aplica um formato de saída consistente a datas e identificadores ao escrever cada linha, então uma incompatibilidade sinalizada no painel reflete uma discrepância real em vez de uma de formatação.
A mesma camada de extração de faturas que alimenta o pipeline de correspondência de três vias é o motor por trás do pipeline de fatura de fornecedor para contas a pagar — a estrutura de colunas difere, mas o mecanismo de extração é idêntico. Uma vez construído para correspondência, o mesmo pipeline alimenta relatórios de contas a pagar, cálculos de provisão e documentação de auditoria.
O Painel de Correspondência: VLOOKUP, IF e Formatação Condicional
Com todas as três camadas preenchidas — registro de pedidos de compra, registro de recebimento e registro de faturas — o painel de correspondência é onde elas convergem. Esta é uma única aba que extrae dados das três abas de origem usando funções de busca e aplica lógica de comparação para marcar correspondências, variações e dados ausentes. A lógica de correspondência em si não é complexa. Uma planilha pode fazer isso. O que sempre foi complexo — e o que o pipeline resolve — é colocar os dados em um estado onde a planilha possa fazer isso. Para a contraparte focada na conciliación deste pipeline — regras de tolerância, zonas de correspondência automática e a camada de julgamento humano para descripções de itens ambíguas — consulte nosso guía para correspondência tripla no Google Sheets sem ERP.
A estrutura do painel de correspondência, construida no Google Sheets:
| Coluna | Origem | Fórmula / Lógica |
|---|---|---|
| A: Número do PO | Extraído do registro de faturas | Chave primária — todas as colunas subsequentes referenciam esta |
| B: Número da Fatura | Do registro de faturas | Referência direta: ='Invoice Register'!A2 |
| C: Fornecedor | Do registro de faturas | Referência direta |
| D: Fornecedor do PO | VLOOKUP do registro de POs | =VLOOKUP(A2, 'PO Register'!A:H, 2, FALSE) |
| E: Quantidade do PO | VLOOKUP do registro de POs | Corresponde à quantidade de itens no PO |
| F: Qtd. Recebida | VLOOKUP do registro de recebimentos | =VLOOKUP(A2, 'Receiving'!A:G, 3, FALSE) |
| G: Qtd. Faturada | Do registro de faturas | Referência direta |
| H: Preço Unitário do PO | VLOOKUP do registro de POs | Base de preço para verificação de variação |
| I: Preço Unitário Faturado | Do registro de faturas | Referência direta |
| J: Variação de Qtd. | Calculada | =G2-E2 — positivo significa cobrado a mais do que o pedido |
| K: Variação de Preço | Calculada | =I2-H2 — positivo significa aumento no preço unitário vs. PO |
| L: Variação Total do Item | Calculada | =(G2*I2)-(E2*H2) — efeito combinado de quantidade + preço |
| M: Recebido vs. Faturado | Calculada | =G2-F2 — quantidade faturada vs. o que chegou |
| N: Status de Correspondência | Calculada | =IF(AND(J2=0,K2=0,M2=0),"MATCHED",IF(F2="","NO RECEIPT","VARIANCE")) |
| O: Observações | Manual | Explicação para variações: "Sobretaxa do fornecedor não está no PO," "Remessa parcial — saldo devido no próximo mês" |
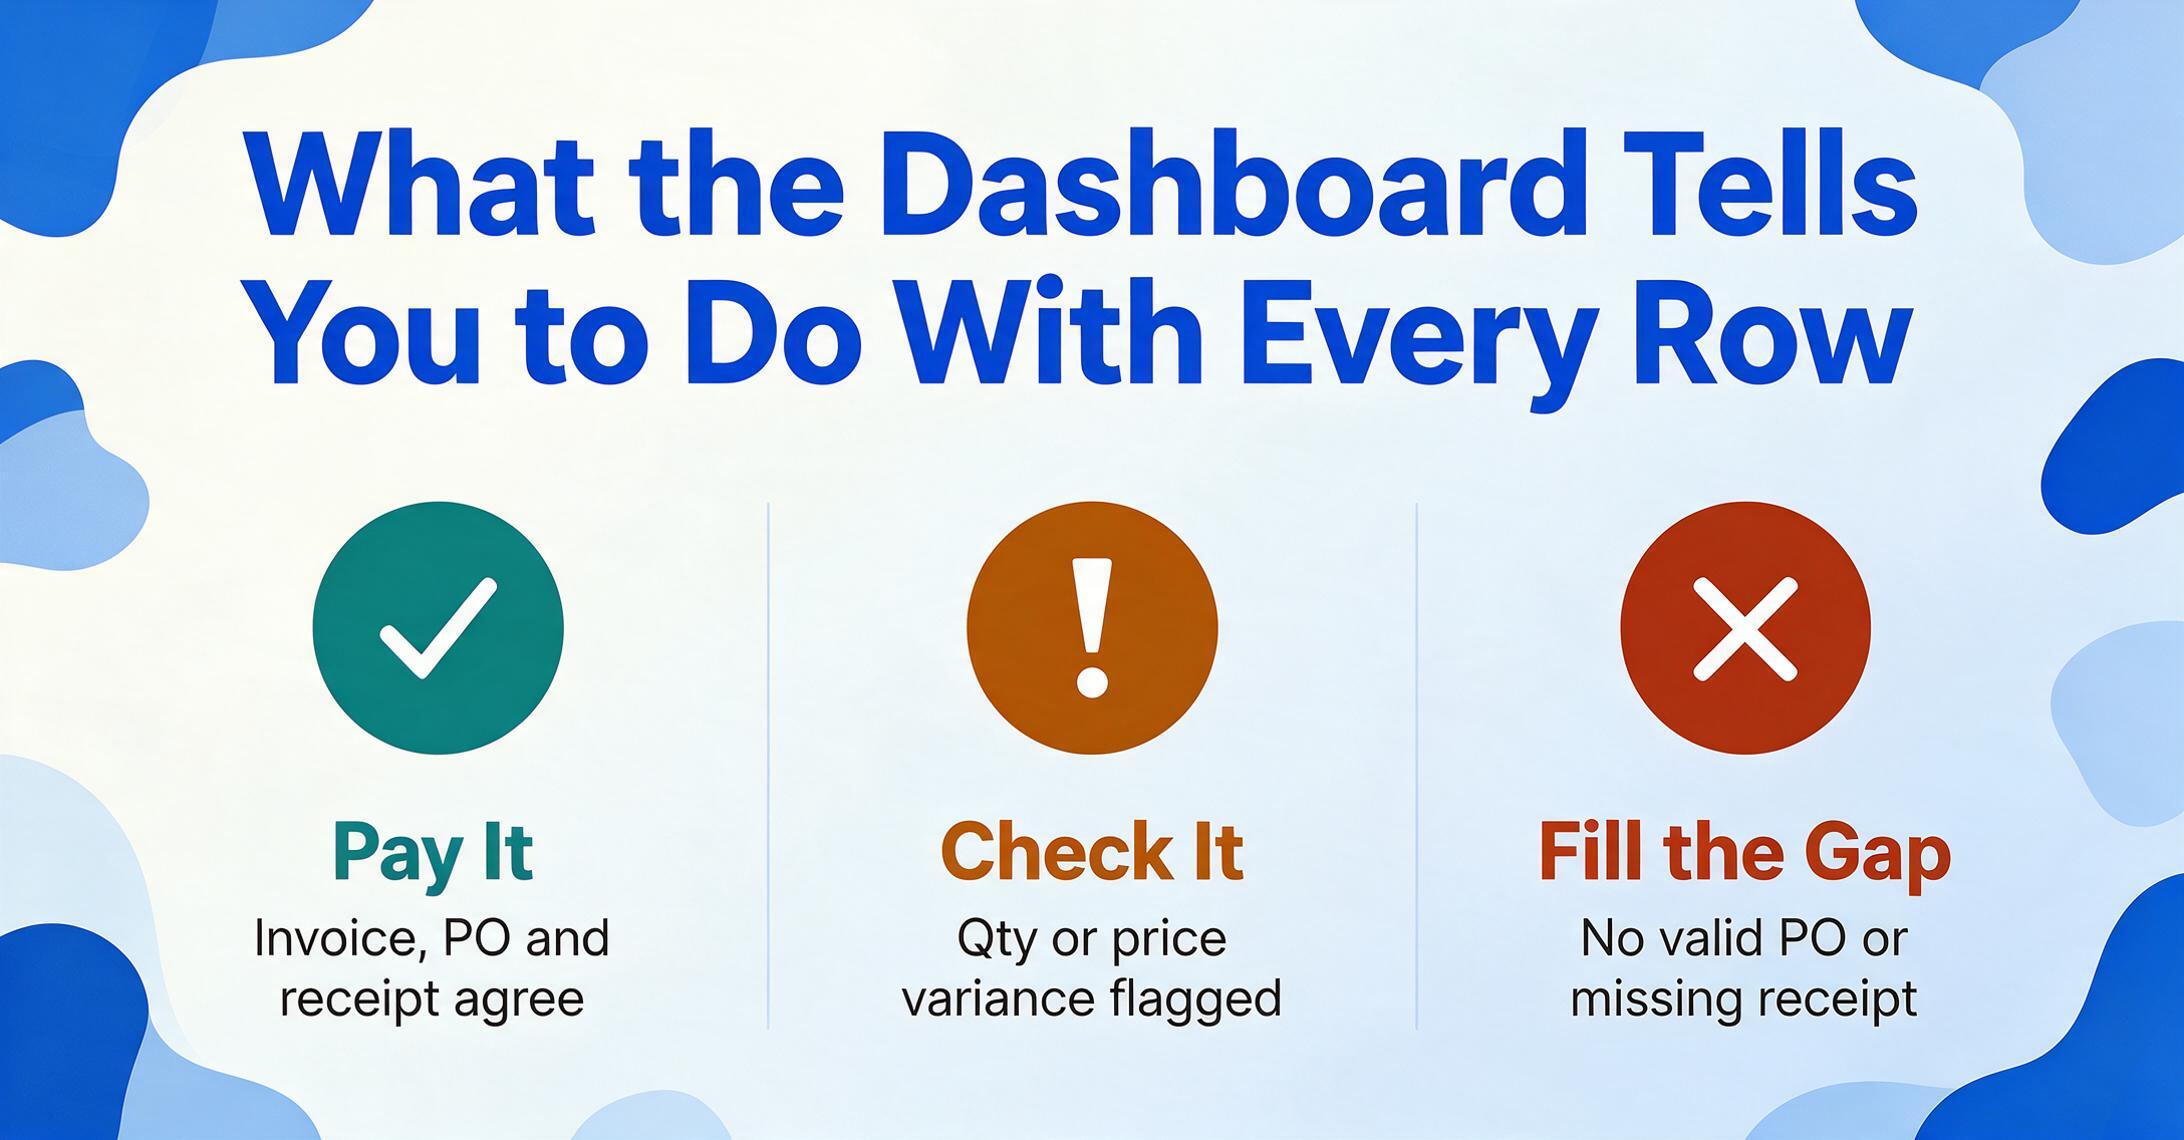
Formatação condicional transforma isso de uma tabela em um painel: destaque a coluna N em verde para "MATCHED", âmbar para "NO RECEIPT", vermelho para "VARIANCE". Aplique uma borda vermelha a qualquer linha onde a coluna J (Qty Variance) exceda um limite configurável — 5% para materiais a granel, 2% para componentes de engenharia de alto valor. Adicione um resumo na linha superior: =COUNTIF(N:N,"MATCHED") para contar faturas correspondentes, =COUNTIF(N:N,"VARIANCE") para exceções, =SUMIF(N:N,"VARIANCE",L:L) para o valor total em dólares das variações.
A decisão arquitetural principal é o Número de PO como chave universal. Cada VLOOKUP no painel de correspondência referencia a coluna de Número de PO. Se uma fatura de fornecedor não incluir um número de PO — e nossa análise do problema de correspondência confirmou que essa é a causa raiz mais comum de falha de correspondência — a linha é preenchida com erros #N/A em todas as colunas de VLOOKUP, imediatamente visíveis no painel. A correção é simples: adicione o número de PO à linha do registro de faturas e as fórmulas recalculam. Mas a visibilidade é o ponto. Sem o painel, uma fatura sem número de PO fica em uma fila até que alguém perceba. Com o painel, ela é sinalizada no momento em que a linha é preenchida.
As fórmulas de correspondência não são a parte difícil. Todo funcionário de contas a pagar que se sente confortável com VLOOKUP já construiu uma versão disso no Excel. O que muda é de onde vêm os dados: os itens de linha do PO, as quantidades recebidas e os detalhes da fatura chegam no mesmo formato estruturado, extraídos dos documentos originais em segundos em vez de digitados manualmente.
Para entregas parciais — a complexidade mais comum em compras de manufatura, onde um PO cobre vários embarques — adicione uma coluna "Número de Entrega" tanto ao registro de recebimento quanto ao registro de faturas. O VLOOKUP se torna uma consulta de duas chaves: correspondência no Número de PO E no Número de Entrega. Cada entrega parcial recebe sua própria linha de correspondência, e o cálculo de recebimento acumulado (=SUMIFS(F:F, A:A, A2, [Delivery], "<="&[@Delivery])) rastreia quanto da quantidade total do PO foi entregue em todos os embarques parciais. A mesma lógica lida com POs abertos com liberações mensais contínuas — o painel rastreia quantidades acumuladas contra a autorização total do PO.
Link de Coleta — Deixe os Fornecedores Enviarem Documentos Diretamente
Uma das ineficiências persistentes na conciliação de três vias é a transferência de documentos do fornecedor para sua equipe de contas a pagar. O fornecedor envia a fatura por e-mail. O funcionário de contas a pagar baixa o anexo, salva-o em uma unidade compartilhada ou pasta local e, em seguida, o envia para a ferramenta de extração. Esse ciclo de baixar e reenviar não é o gargalo — mas é uma etapa extra que acumula atrito quando você processa mais de 100 faturas por mês de 50 fornecedores diferentes.
Um Link de Coleta elimina essa etapa intermediária. É uma URL compartilhável (no formato /c/xxxx) que você gera e envia ao fornecedor. O fornecedor abre o link, insere um código de verificação curto exibido na página e envia a fatura diretamente — sem criar conta, sem login, sem instalação de software. O arquivo chega automaticamente à fila de processamento da sua conta, com o fornecedor identificado pelo link usado. Você pode criar um Link de Coleta separado para cada fornecedor (ou um por grupo de fornecedores), para que os arquivos recebidos sejam pré-classificados por origem antes mesmo da extração começar.
Aplicado ao fluxo de conciliação de três vias, um Link de Coleta muda o fluxo de documentos de "fornecedor envia fatura por e-mail → você baixa → você envia → você extrai" para "fornecedor envia diretamente → o arquivo aparece na sua fila → você extrai". Ele remove completamente a etapa de baixar e reenviar. Para fornecedores que enviam vários documentos — um romaneio e uma fatura para a mesma remessa — um único Link de Coleta captura ambos os arquivos, e o mecanismo de extração processa cada um de acordo com as definições de colunas na planilha. Para a configuração detalhada e o fluxo de trabalho, consulte nosso guia de coleta de documentos com extração.
O Link de Coleta não substitui os relacionamentos com fornecedores por um portal. Ele substitui o ciclo de download de anexos de e-mail por um caminho de envio direto. O fornecedor não precisa de treinamento, credenciais ou software. Ele precisa do link e do código de verificação. O restante é o mesmo fluxo de extração — apenas com uma etapa a menos entre "fornecedor envia" e "dados na sua planilha".
O Que Isso Substitui — e o Que Não Substitui
Um pipeline é uma afirmação específica: ele diz "esta sequência de etapas produz esta saída". É importante ser preciso sobre o que o pipeline descrito aqui substitui, o que complementa e o que nunca foi projetado para fazer.
O que substitui:
- Entrada manual de dados de POs e faturas em planilhas. As camadas de extração convertem documentos não estruturados em linhas estruturadas. Digitar itens de linha de PO e campos de fatura em uma planilha de controle é a etapa que desaparece.
- Manutenção de modelos OCR por fornecedor. A extração de nomes de colunas lê qualquer layout de documento sem modelos pré-configurados. Um novo fornecedor é integrado enviando a ele um Link de Coleta — sem necessidade de criar modelos.
- O ciclo de investigação entre três departamentos. Quando os dados de PO, recebimento e fatura estão todos em um painel estruturado, a pergunta "a fatura corresponde ao PO?" é respondida olhando para uma célula de formatação condicional, não ligando para compras e para o recebimento.
- Pontos cegos de documentos ausentes. A estrutura PROCV do painel expõe lacunas imediatamente: #N/D no PROCV do PO significa que a fatura não referencia um PO válido. Em branco na quantidade recebida significa que o recebimento de mercadorias nunca foi registrado. Esses não são achados de uma auditoria mensal — são visíveis em cada linha em tempo real.
O que não substitui:
- Um ERP para organizações que precisam de um. Com 2.000 a 3.000 faturas por mês, um painel de conciliação baseado em planilha atinge seu limite prático. O volume de exceções sobrecarrega a revisão manual. Nessa escala, o valor do ERP — conciliação automatizada, trilhas de auditoria integradas, segregação de funções — torna-se necessário, não opcional. O pipeline alimenta o ERP com dados estruturados; não substitui o ERP como ambiente de controle.
- Julgamento humano sobre exceções. O painel sinaliza variações. Ele não as resolve. Uma diferença de R$ 47,50 entre o preço unitário faturado e o do PO pode ser uma sobretaxa legítima que o departamento de compras negociou, mas nunca comunicou ao AP, ou pode ser um erro. A IA não pode saber qual é — e não deve ser solicitada a decidir. O sinalizador aciona a revisão humana. A revisão exige contexto de negócios que a IA não possui.
- O processo de recebimento em si. Se os recebimentos de mercadorias não estão sendo criados — se o cais não está registrando o que chega — o pipeline expõe a lacuna na aba de recebimento, mas não pode fabricar os dados. A camada de recebimento exige disciplina de processo: alguém precisa confirmar e registrar o que foi entregue. O pipeline estrutura esses dados. Ele não os cria do nada.
- Conformidade do fornecedor com a exigência de número de PO na fatura. O pipeline torna visível a ausência de um número de PO. Ele não faz com que os fornecedores incluam um. Isso exige uma política de compras — e aplicação — não uma solução técnica.
Perguntas Frequentes
Quantas notas fiscais esse pipeline consegue processar por mês antes de quebrar?
O limite estrutural não está no mecanismo de extração — ele lida com uploads em lote de vários arquivos em uma única sessão — mas sim na capacidade de revisão manual do painel de conciliação. Um único auxiliar de contas a pagar revisando e tratando divergências consegue lidar confortavelmente com cerca de 300 a 500 notas fiscais por mês com um painel bem estruturado, assumindo uma taxa de exceção de 22% (66 a 110 exceções para investigar). Acima de 1.000 notas fiscais por mês, o volume de exceções exige ou vários auxiliares de contas a pagar ou a migração para um ERP com regras automatizadas de conciliação. O valor do pipeline em volumes maiores muda de "ferramenta principal de conciliação" para "mecanismo de ingestão de dados que alimenta dados estruturados no ERP" — as camadas de extração continuam funcionando; o painel se torna uma etapa de validação pré-ERP, em vez do ambiente final de conciliação.
E se meus pedidos de compra usarem preços abertos que mudam mensalmente — o pipeline consegue lidar com preços variáveis?
Sim — mas exige que o registro de pedidos de compra seja mantido como um documento vivo, não uma extração única. Para um pedido de compra aberto com ajustes mensais de preço indexados a uma taxa de mercado, a linha do registro de pedidos de compra para aquele fornecedor precisa ser atualizada a cada mês com o preço vigente atual. O PROCV no painel de conciliação refletirá o preço atualizado. A alternativa — e a que preserva uma trilha de auditoria — é adicionar uma coluna "Data de Vigência" ao registro de pedidos de compra e usar um PROCV com correspondência por intervalo de datas: extrair o preço do pedido de compra que estava em vigor na data da nota fiscal, não o preço atual. Isso é mais complexo de configurar, mas reflete com precisão qual era o preço acordado no momento do embarque — que é o que a conciliação tripla deve verificar.
A extração funciona em romaneios e documentos de recebimento manuscritos?
Sim — a IA lê texto manuscrito, incluindo os números e anotações típicos de romaneios assinados no cais. No entanto, a precisão em documentos manuscritos é menor do que em documentos impressos, e documentos muito degradados (impressões térmicas desbotadas, cópias carbono com texto fraco, romaneios amassados e re-alisados) gerarão mais erros de extração. Para dados de recebimento especificamente, recomendamos: (a) se viável, que o conferente insira os campos-chave (Número do Pedido, Item, Quantidade, Data) diretamente na Planilha Google no cais — a entrada manual no ponto de recebimento é mais rápida e precisa do que a extração de um documento degradado posteriormente; (b) se a extração do romaneio for o único caminho viável, faça uma verificação pontual de uma amostra de linhas contra o documento original, especialmente para remessas de alto valor; (c) use a foto do romaneio como anexo armazenado junto com a linha de recebimento — mesmo que a extração perca um dígito, o documento original está a um clique de distância para verificação.
Posso usar este pipeline sem o complemento do Google Sheets — apenas com o aplicativo web?
Sim. O mecanismo de extração é o mesmo, seja você acessando pelo complemento na barra lateral do Sheets ou pelo aplicativo web em ImageToTable.ai. A vantagem do complemento é que a saída da extração é gravada diretamente na planilha ativa — sem ciclo de baixar e reenviar. Com o aplicativo web, você envia documentos no navegador, baixa o arquivo Excel extraído e cola ou importa as linhas no seu dashboard correspondente. As definições de coluna são as mesmas. A qualidade da extração é idêntica. O complemento elimina uma etapa (baixar e importar); o aplicativo web funciona com qualquer ferramenta de planilha, não apenas com o Google Sheets. Escolha com base em se essa etapa faz diferença no seu volume.
Qual é o tempo de configuração para o pipeline completo — registro de PO, registro de recebimento, registro de fatura e dashboard de correspondência?
Para alguém familiarizado com VLOOKUP e formatação condicional no Google Sheets, montar o pipeline completo de quatro abas leva cerca de duas horas: 30 minutos para projetar e criar as quatro abas com as estruturas de coluna descritas acima, 45 minutos para escrever e testar as fórmulas VLOOKUP e IF no dashboard de correspondência, 30 minutos para configurar a formatação condicional e as métricas de resumo, e 15 minutos para definir os conjuntos de colunas de extração na barra lateral do complemento. As definições de coluna são salvas na planilha e persistem entre sessões — você as define uma vez e elas ficam disponíveis toda vez que abrir a barra lateral e selecionar essa planilha. Após a configuração inicial, o fluxo de trabalho mensal é: (1) extrair novos POs para o registro de PO, (2) inserir ou extrair dados de recebimento, (3) extrair faturas de fornecedores, (4) abrir o dashboard de correspondência e revisar as linhas sinalizadas. O primeiro mês é o mais demorado por causa da configuração e da população de dados. O terceiro mês é rotina. Para uma visão completa dos recursos — tipos de campo suportados, formatos e detalhes do plano — consulte o complemento de extração de documentos do Google Sheets.
Como lidar com diferenças de moeda entre POs e faturas de fornecedores?
O mecanismo de extração captura o valor numérico e o símbolo da moeda conforme aparecem no documento. Ele não realiza conversão de moeda. Se o seu PO está em USD e um fornecedor emite fatura em EUR, o painel de correspondência mostrará uma variação porque os valores numéricos não coincidirão — mesmo que os valores convertidos estejam corretos. A solução é adicionar uma coluna "Moeda" tanto no registro de POs quanto no registro de faturas, e uma coluna "Taxa de Conversão" que faça referência a uma taxa de câmbio mantida manualmente ou alimentada por fórmula. A comparação de preços na correspondência usa então o valor convertido, em vez do valor extraído bruto. O trabalho do pipeline é a extração. A conversão de moeda é uma operação na camada da planilha.
A Conclusão
O pipeline de correspondência de três vias descrito aqui não substitui um ERP em organizações que precisam de um. É um sistema para equipes que já gerenciam compras por meio de planilhas — porque a captura de faturas do ERP exige manutenção de modelos que não conseguem sustentar, porque sua base de fornecedores abrange formatos que o módulo de correspondência não suporta, ou porque o volume de transações está no intervalo entre "complexo demais para correspondência manual" e "grande o suficiente para justificar uma atualização de ERP". Para essas equipes, a pergunta não é "devemos automatizar a correspondência". É "conseguimos colocar os três documentos no mesmo formato estruturado rápido o suficiente para que a correspondência se torne um exercício de fórmula, em vez de uma investigação entre três departamentos".
O pipeline responde a essa pergunta com três camadas de extração e um painel. A camada de PO fornece a linha de base de referência. A camada de recebimento confirma o que chegou. A camada de fatura captura o que foi cobrado. O painel de correspondência compara tudo — com VLOOKUP, declarações IF e formatação condicional — e sinaliza cada linha que precisa de atenção humana. O mecanismo de extração, alimentado por IA que lê documentos pelo significado, e não pela posição, lida com a diversidade de formatos que torna as abordagens baseadas em modelos insustentáveis em uma operação de compras com múltiplos fornecedores. O Link de Coleta elimina o ciclo de download de anexos de e-mail no processo de entrada de documentos.
A lacuna estrutural que nossa análise de problemas identificou — três departamentos, três sistemas, nenhum dono único do pipeline de dados — não desaparece. Mas quando os três tipos de documento chegam no mesmo formato estruturado na mesma planilha, com o mesmo Número de PO como chave universal, a etapa de correspondência não exige mais investigação entre departamentos. A lacuna organizacional permanece. Os dados não carregam mais o desvio acumulado de três canais de entrada diferentes. É isso que torna a correspondência um exercício de planilha, em vez de um problema de pessoal.
Comece com a camada de extração de PO. Envie uma ordem de compra na demonstração abaixo. Veja se os campos que importam para o seu fluxo de correspondência — número do PO, fornecedor, itens de linha, quantidades, preços — voltam estruturados em segundos, em vez de digitados em minutos. Se essa primeira camada funcionar, o restante do pipeline é construído no mesmo mecanismo.