So erstellen Sie einen Drei-Wege-Abgleich-Workflow in Google Sheets:
Schritt für Schritt von der Bestellung bis zur Rechnungsfreigabe
Unsere Analyse, warum der Drei-Wege-Abgleich in der Fertigung scheitert, hat gezeigt: Der Engpass liegt nicht am Abgleich-Algorithmus – sondern am vorgelagerten Schritt der Datenextraktion. Die AP-Benchmarks von Ardent Partners 2025 beziffern die durchschnittliche Fehlerquote beim ersten Durchlauf auf 22 %, und in der Fertigung – mit Rahmenbestellungen, Teillieferungen und Maßeinheits-Abweichungen zwischen Wareneingang und Rechnung – steigt diese Zahl noch weiter. Die Diagnose ist klar: Sie können keine drei Dokumente abgleichen, wenn zwei davon noch in unstrukturierten PDFs stecken. Die Frage, die dieser Artikel beantwortet: Was bauen Sie konkret, um das zu lösen – und geht das ohne ERP? Die Grundlage ist ein wiederholbarer PDF-zu-Google-Sheets-Extraktionsschritt, der jedes Dokument in saubere Zeilen verwandelt, bevor irgendeine Abgleich-Formel läuft.
Das ist der Bauleitfaden. Er führt Schritt für Schritt durch die vier Extraktions- und Abgleich-Ebenen einer Google-Sheets-Pipeline – welche Spalten Sie definieren, welche Formeln Sie schreiben und wie Lieferanten Dokumente direkt über einen Sammellink einreichen. Wenn Sie stattdessen das Abgleich-Framework suchen – Toleranzregeln, Auto-Match-Zonen und den Umgang mit mehrdeutigen Artikelnamen bei der Prüfung –, finden Sie das in unserem Begleitartikel zum Drei-Wege-Abgleich in Google Sheets ohne ERP.
Wichtigste Erkenntnisse
- Eine Fehlerquote von 22 % beim ersten Durchlauf klingt nach einem Algorithmus-Problem, beginnt aber vorgelagert im Schritt der Datenextraktion.
- 66 % der AP-Teams tippen Rechnungsdaten weiterhin manuell in ihr ERP ein – das Abgleich-Modul bleibt also ungenutzt, während jemand die Eingabe abschließt.
- Die Spaltennamens-Extraktion von ImageToTable.ai liest jedes Lieferantenformat ohne vorkonfigurierte Vorlage und verwandelt eine dreiköpfige Abteilungsuntersuchung in einen VLOOKUP und eine grüne Zelle.
Was Drei-Wege-Abgleich tatsächlich erfordert – mehr als Toleranzschwellen
Der Drei-Wege-Abgleich vergleicht eine Bestellung, einen Wareneingang und eine Lieferantenrechnung, bevor die Zahlung freigegeben wird – er prüft, ob das Bestellte mit dem Gelieferten und dem Berechneten übereinstimmt. Gemäß ISO 9001:2015, Abschnitt 8.4 ist die Überprüfung, ob gekaufte Produkte die festgelegten Anforderungen erfüllen, für zertifizierte Hersteller verpflichtend. Der Drei-Wege-Abgleich ist der operative Mechanismus, den die meisten Unternehmen dafür nutzen. Der ACFE-Bericht 2024 an die Nationen – der schätzt, dass Organisationen 5 % ihres Jahresumsatzes durch berufliche Betrugshandlungen verlieren – identifiziert ihn als zentrale Kontrolle gegen Abrechnungsmanipulation. Die regulatorische Logik ist solide. Das dahinterliegende Datenproblem ist es, das in der Praxis scheitert.
Die meisten Ratschläge zur Verbesserung des Drei-Wege-Abgleichs konzentrieren sich auf die Abgleichsebene: Toleranzschwellen verschärfen, Genehmigungsworkflows hinzufügen, Auto-Matching-Regeln im ERP konfigurieren. Nichts davon behebt das Problem, dass die drei Dokumente aus drei verschiedenen Systemen in drei verschiedenen Formaten kommen – und zwei davon sind unstrukturiert. Die Bestellung lebt im System der Beschaffung. Der Wareneingang wurde möglicherweise von einem Papier-Lieferschein erfasst oder auch nicht. Die Lieferantenrechnung kommt als PDF. Bevor eine Abgleichslogik diese Dokumente vergleichen kann, muss jemand die Daten aus den beiden nicht strukturierten Formaten extrahieren, in ein vergleichbares Layout eingeben und hoffen, dass Einheiten und Positionen übereinstimmen. Die Abgleichsebene – SVERWEIS, WENN-Funktionen, bedingte Formatierung – ist der einfache Teil. Die Extraktionsebene ist der Punkt, an dem die Pipeline steht oder fällt.
Eine funktionierende Drei-Wege-Abgleich-Pipeline beginnt nicht mit besseren Abgleichsregeln. Sie beginnt damit, alle drei Dokumente im selben strukturierten Format in derselben Tabelle zu haben. Sind sie erst einmal dort, ist der Abgleich eine Formelübung. Der schwierige Teil ist, sie dorthin zu bringen.
Warum ERP-Beratung nicht zu einem Spreadsheet-Workflow passt
SAPs MM-Modul, Oracle E-Business Suite, Microsoft Dynamics 365 – alle enthalten Drei-Wege-Abgleichmodule mit konfigurierbaren Toleranzen. SAP beispielsweise wickelt den Abgleich über das GR/IR-Konto ab: Der Wareneingang (Transaktion MIGO) bucht eine Belastung, der Rechnungseingang (MIRO) bucht eine Gutschrift, und das System gleicht automatisch übereinstimmende Positionen ab. Die Logik ist ausgereift und gut dokumentiert.
Die Logik setzt außerdem etwas voraus, das in einer beträchtlichen Anzahl von Beschaffungsabläufen nicht zutrifft: dass alle drei Dokumente als strukturierte, vergleichbare Daten im ERP existieren, bevor die Abgleichlogik ausgeführt wird. Die IFOL-AP-Automatisierungsumfrage 2025 ergab, dass 66 % der AP-Teams Rechnungsdaten weiterhin manuell in ihr ERP eingeben. Für Beschaffungsteams, die Lieferantenbeziehungen über 50 bis 200 Anbieter verwalten – viele davon kleine Maschinenbaubetriebe, lokale Händler und Speziallieferanten, die PDFs per E-Mail senden – ist jede Rechnung ein manueller Datenerfassungsvorgang, bevor der Abgleich beginnen kann.
Wenn Sie zu dieser Gruppe gehören – sei es, weil Ihr Unternehmen Beschaffung über Spreadsheets abwickelt, weil die Rechnungserfassung Ihres ERPs eine anbieterspezifische Vorlagenkonfiguration erfordert, die Sie nicht pflegen können, oder weil Ihre Lieferantenbasis genügend kleine Anbieter umfasst, sodass PDF das einzige von ihnen gesendete Format ist – adressiert das Abgleichmodul des ERPs ein Problem, das nachgelagert zu dem ist, das Sie tatsächlich haben. Sie brauchen keinen besseren Abgleichalgorithmus. Sie brauchen eine Möglichkeit, Bestelldaten, Wareneingangsdaten und Rechnungsdaten in einer strukturierten Ansicht zusammenzuführen – und das Tool, das Sie bereits für die Beschaffungsverfolgung nutzen, ist wahrscheinlich ein Spreadsheet. Die Frage ist, wie Sie dieses Spreadsheet in eine Pipeline verwandeln.
Die dreischichtige Pipeline-Architektur
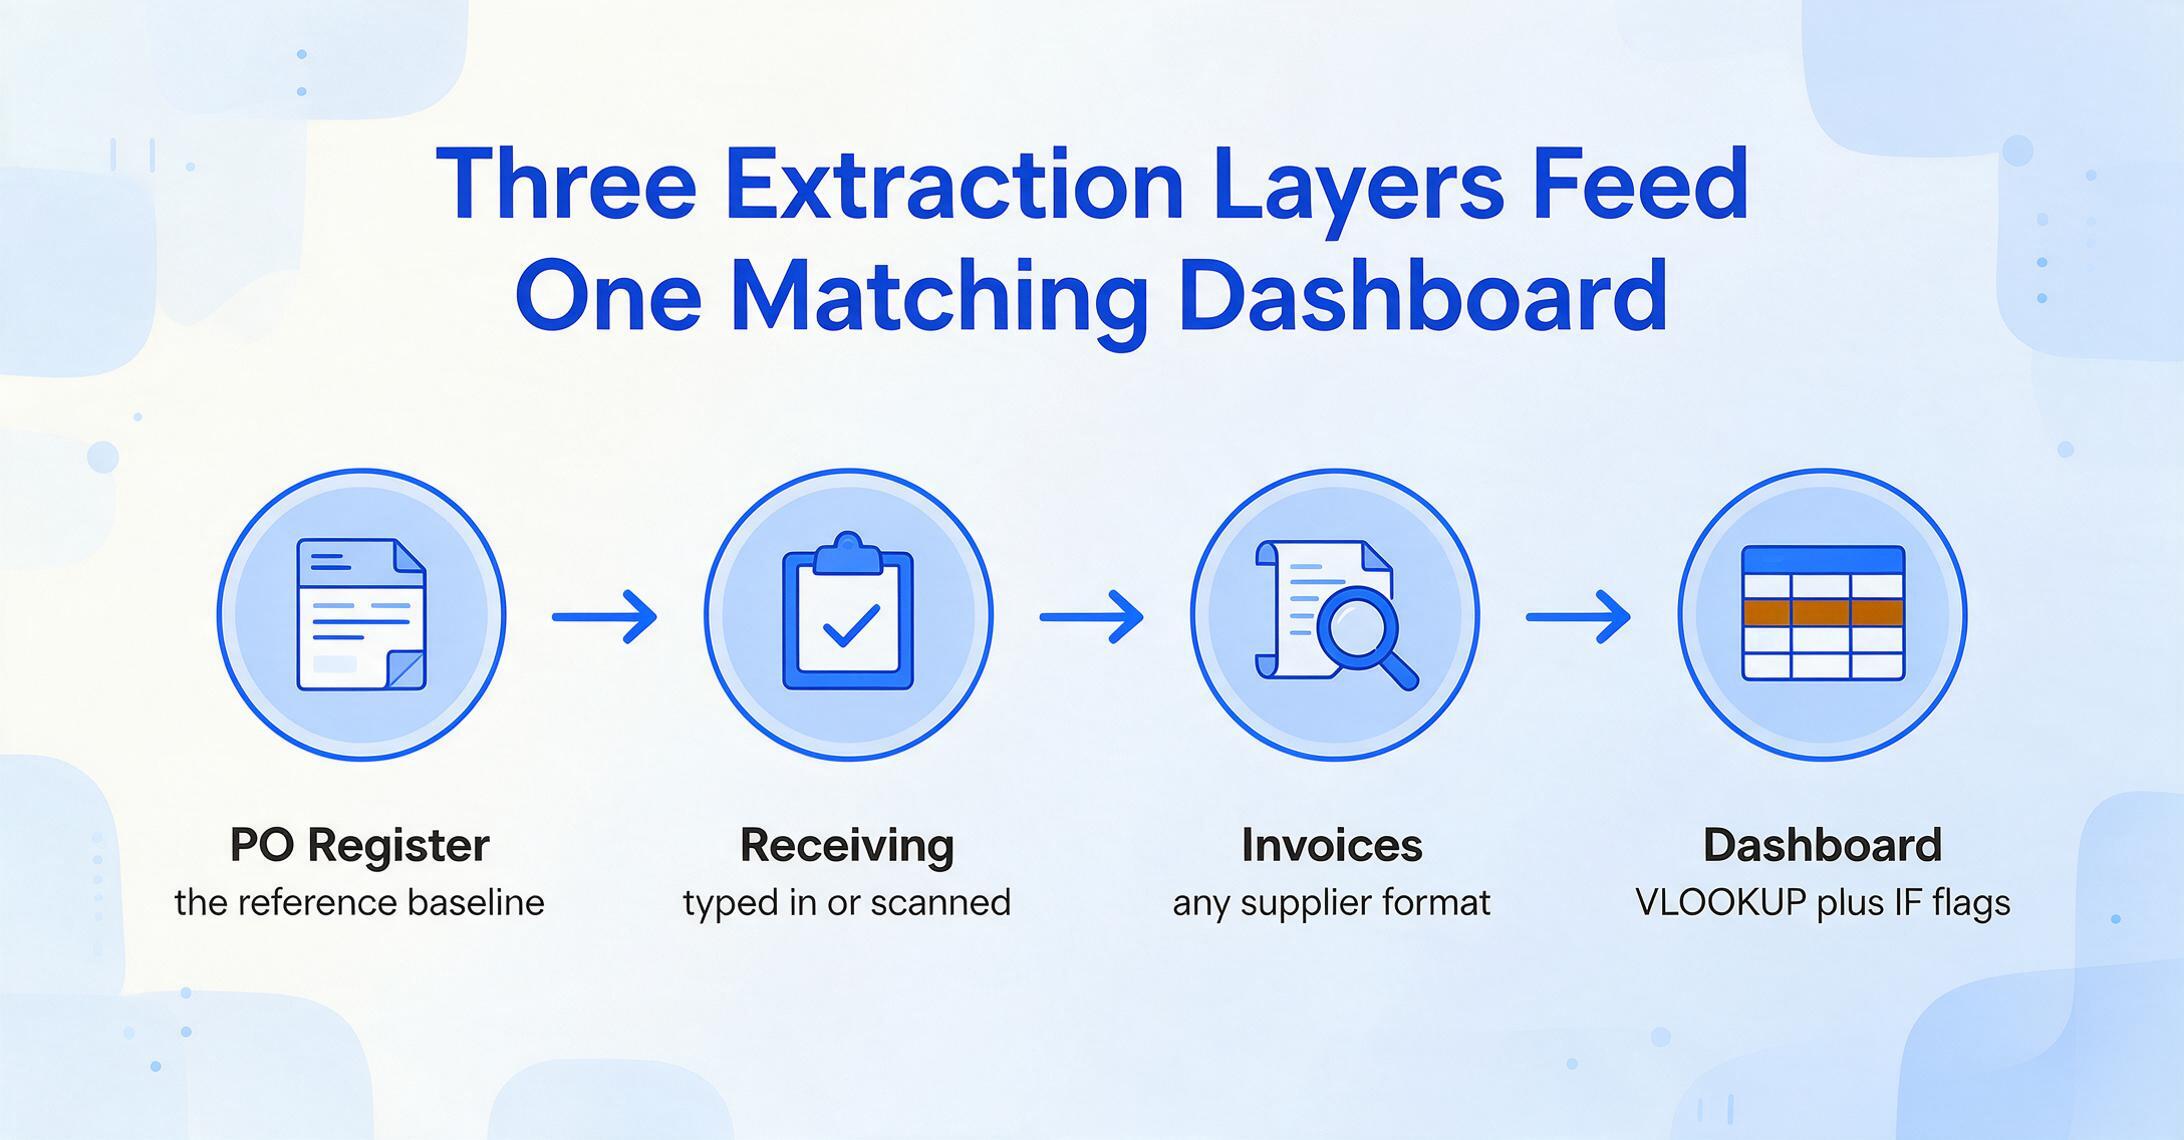
Die Pipeline besteht aus drei Schichten, eine für jedes Dokument im Drei-Wege-Abgleich, plus einer vierten darüber: dem Abgleich-Dashboard. Die ersten drei Schichten extrahieren strukturierte Daten aus unstrukturierten Dokumenten. Die vierte vergleicht sie. Wenn eine der ersten drei Schichten inkonsistente oder unvollständige Daten liefert, kann die Abgleichsschicht ihre Aufgabe nicht erfüllen.
Jede Schicht schließt eine spezifische Lücke in der Kette vom Einkauf bis zur Zahlung. Die Bestellschicht legt die Basis fest — was bestellt wurde, zu welchem Preis, von wem. Die Wareneingangsschicht bestätigt, was physisch angekommen ist. Die Rechnungsschicht erfasst, was der Lieferant in Rechnung gestellt hat. Das Abgleich-Dashboard ist der Ort, an dem alle drei zusammenlaufen — und an dem die Tabellenkalkulation die Drei-Abteilungs-Recherche ersetzt, die die Problemanalyse als strukturelle Schwäche traditioneller Abgleichs-Workflows identifiziert hat.
Das Tool, das die Umwandlung von unstrukturierten in strukturierte Daten in den Ebenen 1 und 3 ermöglicht, ist die Benutzerdefinierte Spaltenextraktion: Statt Felder auf jedem Dokument einzurahmen oder pro Lieferantenformat eine Vorlage zu erstellen, geben Sie die gewünschten Spaltennamen ein – „PO-Nummer", „Lieferantenname", „Position", „Menge", „Einzelpreis", „Positionssumme" – und die KI liest das Dokument, um diese Werte zu finden, indem sie versteht, was sie bedeuten, nicht wo sie auf der Seite stehen. Eine strukturierte Bestellung aus SAPs PDF-Ausgabe und eine handschriftliche Bestellung eines lokalen Lieferanten sehen völlig unterschiedlich aus. Aber beide enthalten eine PO-Nummer, Lieferantennamen, Mengen und Preise. Die Spaltennamensextraktion sucht nach der Bedeutung dieser Felder über jedes Layout hinweg – und eliminiert die pro Lieferant und pro Format erforderliche Vorlagenpflege, die vorlagenbasiertes OCR für Beschaffungsteams unpraktikabel macht, die mit Dutzenden verschiedener Lieferantendokumentformate arbeiten.
Ebene 1 – Bestellextraktion: Die Referenzbasislinie
Jeder Dreifachabgleich beginnt mit der Bestellung. Die Bestellung legt die Bedingungen fest: welcher Lieferant, welche Artikel, welche Menge, zu welchem Preis, für Lieferung wann. In einer ERP-integrierten Umgebung existieren diese Daten bereits als strukturierte Positionen – die Bestellung wurde im System erstellt. Aber in einem tabellenbasierten Beschaffungsworkflow treffen Bestellungen in mehreren Formen ein: PDFs, die vom eigenen System des Käufers erzeugt wurden, per E-Mail gesendete Bestellungen von Lieferanten, die eine Bestellung bestätigen, oder gescannte Dokumente von kleineren Anbietern, die auf Papier arbeiten. Bestelldaten in ein strukturiertes Format zu bringen ist der erste Schritt – und für tabellenbasierte Teams ein Schritt, der bestimmt, ob der Rest der Pipeline überhaupt möglich ist.
Die Extraktionsspalten für eine Bestellung hängen davon ab, worauf Ihr Abgleichsprozess verweisen muss. Mindestens:
| Spalte | Was sie erfasst | Warum sie für den Abgleich wichtig ist |
|---|---|---|
| PO-Nummer | Eindeutige Bestellkennung | Das Schlüsselfeld – jeder Wareneingang und jede Rechnung muss darauf verweisen, um abzugleichen |
| Lieferantenname | Lieferantenname, wie er auf der Bestellung erscheint | Querverweis mit dem Rechnungslieferanten – bestätigt denselben Lieferanten |
| Position | Artikelbeschreibung, SKU oder Teilenummer | Abgleich mit Wareneingangs- und Rechnungspositionen für positionsgenauen Vergleich |
| Menge | Bestellte Menge pro Position | Vergleich mit eingegangener Menge und berechneter Menge |
| Einzelpreis | Vereinbarter Einzelpreis pro Position | Preisabweichungsprüfung – das häufigste Prüfflag |
| Positionssumme | Menge × Einzelpreis pro Position | Vergleich mit der berechneten Positionssumme – erkennt Multiplikationsfehler |
| Lieferdatum | Erwartetes Lieferdatum | Wird verwendet, um Wareneingangsdaten zu verifizieren und verspätete Lieferungen zu kennzeichnen |
| Bestellsumme | Summe aller Positionssummen | Der Gesamtbetrag, den die Rechnung ohne Erklärung nicht überschreiten sollte |
Für intern erstellte Bestellungen in einem einheitlichen Format – Ihrer eigenen PO-Vorlage – ist die Extraktion unkompliziert. Die KI liest jedes Mal dieselben Felder aus demselben allgemeinen Layout. Bei Lieferantenbestätigungen, die im Format des Anbieters eintreffen, passt sich die Extraktion an: Die Spaltennamen bleiben gleich, und die KI findet die Werte unabhängig vom Layout. Ein einziger Extraktionslauf füllt den PO-Register-Tab mit strukturierten Daten – eine Zeile pro Bestellung oder eine Zeile pro Position, je nachdem, ob Sie Header- oder Zeilenebene für den Abgleich benötigen. Der Leitfaden zur Einzel-PO-Extraktion mit dem Google Sheets-Add-on führt Sie durch die Spalteneinrichtung und den ersten Extraktionsworkflow. Für Teams mit hohem Volumen, die Dutzende von Bestellungen gleichzeitig verarbeiten, wendet das Batch-PO-Verarbeitungs-Dashboard dieselbe Extraktions-Engine auf mehrere Bestellungen in einer Sitzung an.
Dateien werden sicher verarbeitet und nicht gespeichert.
Die Demo oben verwendet die Bestellvoreinstellung – einen vorkonfigurierten Satz von Extraktionsspalten für PO-Dokumente. Laden Sie eine Bestellung hoch und beobachten Sie, wie die Felder ohne Tippen ausgefüllt werden. Wenn Ihre Bestellungen Felder enthalten, die die Voreinstellung nicht abdeckt (eine Warenaufschlagszeile, einen Abschnitt zu Frachtbedingungen, interne Kostenzentrencodes), fügen Sie sie als benutzerdefinierte Spalten hinzu – die Extraktions-Engine behandelt sie genauso. Die Voreinstellung gibt Ihnen den Ausgangspunkt. Ihre benutzerdefinierten Spalten erweitern sie, um den Anforderungen Ihres Abgleich-Dashboards zu entsprechen.
Ebene 2 — Empfang von Belegdaten: Das knifflige mittlere Dokument
Der Wareneingang ist das Dokument, das in einem strukturierten System am wahrscheinlichsten fehlt — und es ist das Dokument, das den Drei-Wege-Abgleich zu einem Drei-Wege-Prozess macht. Ohne Wareneingangsbestätigung führen Sie nur einen Zwei-Wege-Abgleich durch (Bestellung vs. Rechnung) und bezahlen für Waren, deren Lieferung Sie nicht bestätigen können. Die ACFE identifiziert ausdrücklich den Wareneingang als die Kontrolle, die Abrechnungsbetrug verhindert — die Bezahlung für nie gelieferte Waren. Es zu überspringen ist keine Abkürzung. Es ist eine Lücke im Kontrollrahmen.
Wareneingangsdaten sind schwerer zu strukturieren als Bestelldaten, weil sie anders entstehen — am Dock, oft auf Papier, von Personal, dessen Priorität das Entladen von LKWs ist, nicht die Dateneingabe. Der Lieferschein ist typischerweise ein mehrteiliges Kohlepapierformular oder ein Thermodruckdokument des Spediteurs. Der Wareneingangsmitarbeiter unterschreibt ihn, notiert die empfangene Menge (manchmal in Einheiten, die von der Bestellung abweichen) und archiviert die physische Kopie. Ob diese Daten in ein digitales System gelangen, hängt davon ab, ob sie im Nachhinein jemand eintippt — und dieser Schritt ist der erste, der an einem hektischen Wareneingangstag übersprungen wird.
Für die Pipeline hat Wareneingangsdaten zwei gangbare Eingabewege. Der erste ist die direkte manuelle Eingabe: Der Wareneingangsmitarbeiter — oder eine dafür bestimmte Dateneingabeperson — tippt die Schlüsselfelder als Teil des Wareneingangsprozesses in ein Google Sheet. Die Spalten spiegeln die Bestellspalten wider: Bestellnummer (zur Verknüpfung), Artikel erhalten, Menge erhalten, Wareneingangsdatum, Spediteur, Zustand. Dieser Weg funktioniert, wenn das Wareneingangsvolumen moderat ist (unter 30 Sendungen pro Tag) und das Dock Zugriff auf ein Gerät mit geöffnetem Sheet hat. Der Vorteil ist Kontrolle — die Wareneingangsdaten sind ab dem Moment der Eingabe strukturiert, ohne nachgelagerte Konvertierung.
Der zweite Weg ist die Dokumentextraktion direkt vom Lieferschein — ein Foto oder Scan des unterschriebenen Lieferscheins wird durch dieselbe Extraktions-Engine geschickt, die auch für Bestellungen und Rechnungen verwendet wird. Dieser Weg funktioniert, wenn manuelle Eingabe nicht machbar ist — bei hohem Volumen am Dock, entfernten Wareneingangsstandorten oder Betriebsabläufen, in denen der Lieferschein der einzige Wareneingangsbeleg ist. Die Extraktionsspalten sind dieselben: Bestellnummer, Artikelbeschreibung, Menge erhalten, Wareneingangsdatum, Spediteur. Ein Handyfoto eines Lieferscheins, das über das Seitenleisten-Add-on verarbeitet wird, befüllt den Wareneingangs-Tab im selben strukturierten Format wie die manuell eingegebenen Daten. Die wichtigste Einschränkung: Handschrift auf Lieferscheinen reduziert die Extraktionsgenauigkeit im Vergleich zu gedruckten Bestellungen und Rechnungen. Stichprobenkontrollen werden für kritische Sendungen empfohlen. Für eine detaillierte Genauigkeitsaufschlüsselung nach Dokumentqualität finden Sie in unserem Leitfaden zur Genauigkeit der Extraktion handschriftlicher Dokumente — dieselben Prinzipien gelten für Lieferscheine und Wareneingangsberichte.
Welchen Weg Sie auch wählen, das Ergebnis ist dasselbe: ein Wareneingangsregister-Tab mit der Bestellnummer als Schlüsselfeld, das jeden Wareneingang mit seiner ursprünglichen Bestellung verknüpft. Ohne diese Verknüpfung kann das Abgleich-Dashboard seine Aufgabe nicht erfüllen.
Ebene 3 — Lieferantenrechnungsextraktion: Das Formatproblem, das Sie nicht kontrollieren
Lieferantenrechnungen sind der Höhepunkt des Formatvielfaltsproblems. Ein einziger Beschaffungsbetrieb kann Rechnungen von einem großen MRO-Händler als strukturierte SAP-PDF, von einem regionalen Metalllieferanten in einem selbst erstellten Excel-zu-PDF-Format, von einer lokalen Maschinenwerkstatt als fotografiertes handschriftliches Dokument und von einem internationalen Anbieter mit unterschiedlichen Datumsformaten, Währungskonventionen und Steuerzeilenstrukturen erhalten. Die OCR auf Vorlagenbasis — bei der Sie für jedes Lieferantenlayout eine Feldzuordnungsvorlage erstellen und bei Layoutänderungen aktualisieren — scheitert an dieser Vielfalt oder verbraucht so viel Wartungszeit, dass der Extraktionsaufwand der manuellen Eingabe gleicht, die sie ersetzen sollte.
Benutzerdefinierte Spaltenextraktion löst dies, indem die Extraktionslogik von jedem spezifischen Layout entkoppelt wird. Die Spaltennamen werden einmal definiert. Die KI liest jede Rechnung — unabhängig vom Format — und findet die Werte, die diesen Spaltendefinitionen entsprechen. Eine Rechnungsspaltenkonfiguration für den Drei-Wege-Abgleich umfasst typischerweise:
| Spalte | Quelle | Abgleichsrolle |
|---|---|---|
| Rechnungsnummer | Aus Rechnung extrahiert | Eindeutige Kennung — verhindert Doppelzahlung |
| Bestellnummer | Aus Rechnung extrahiert | Das kritische Verknüpfungsfeld — muss für den Abgleich einer Bestellung im Bestellregister entsprechen |
| Lieferantenname | Aus Rechnung extrahiert | Querverweis auf den Bestelllieferanten — erkennt Fehler bei falscher Bestellreferenz |
| Rechnungsdatum | Aus Rechnung extrahiert | Berechnung der Zahlungsbedingungen; Altersanalyse |
| Fälligkeitsdatum | Aus Rechnung extrahiert | Verfolgung des Skontofensters für Frühzahlung |
| Positionsbeschreibung | Aus Rechnung extrahiert | Abgleich mit Bestellposition — bestätigt, dass dieselben Waren wie bestellt berechnet werden |
| Menge | Aus Rechnung extrahiert | Abweichungsprüfung gegen Bestellmenge und empfangene Menge |
| Einzelpreis | Aus Rechnung extrahiert | Abweichungsprüfung gegen Bestelleinzelpreis — Erkennung von Preiserhöhungen |
| Positionssumme | Aus Rechnung extrahiert | Berechnungsprüfung — bestätigt Menge × Einzelpreis = Positionssumme auf der Rechnung selbst |
| Rechnungssumme | Aus Rechnung extrahiert | Gesamtabgleich gegen Bestellsumme ± Toleranz; Auslöser für Zahlungsfreigabe |
Sie können auch abgeleitete Spalten hinzufügen – Spalten, die Daten erfassen, die nicht explizit auf der Rechnung gedruckt sind, aber aus ihrem Kontext abgeleitet werden können. Beispielsweise kann eine Spalte, die als Match Status (options: Ready to Match/Needs PO Reference/Missing Line Items) definiert ist, die KI jede Rechnung während der Extraktion klassifizieren lassen, basierend darauf, ob eine PO-Nummer gefunden wurde und ob Positionen extrahierbar waren. Rechnungen von Lieferanten, die keine PO-Nummern auf ihren Dokumenten angeben, werden sofort markiert – sie erscheinen im Matching-Dashboard mit dem Status „Needs PO Reference", und der AP-Sachbearbeiter weiß, dass er keinen Abgleich versuchen sollte, bis die PO-Nummer hinzugefügt wurde. Dies ist Kategorisierung-als-Extraktion: Die Klassifizierungsentscheidung erfolgt im selben Durchgang, der die Daten befüllt, nicht in einem separaten Prüfschritt.
Berechnete Spalten übernehmen Mathematik, die sonst Tabellenformeln nach der Extraktion erfordern würde. Definieren Sie eine Spalte als Extension Check (Line Total - Quantity * Unit Price) und die KI führt die Berechnung während der Extraktion durch und markiert jede Position, bei der die berechnete Positionssumme nicht der Menge mal Einzelpreis entspricht. Das Ergebnis ist eine Abweichungszahl – null bedeutet, dass die Berechnung korrekt ist, ein Wert ungleich null identifiziert einen Rechenfehler auf der Lieferantenrechnung. Dies verschiebt die Rolle des Matching-Dashboards von „Fehler finden" zu „markierte Zeilen prüfen" – ein Workflow, bei dem die KI die Erkennung übernimmt und der Mensch die Entscheidung trifft. Eine vollständige Behandlung der Syntax und Funktionen berechneter Spalten finden Sie in unserem Leitfaden zu berechneten Spalten in der Dokumentextraktion.
Formatunterschiede verursachen falsche Abweichungen, bevor irgendeine Formel läuft. Ein Lieferant datiert eine Rechnung 05/06/2026, ein anderer schreibt 06/05/2026, und dieselbe Teilenummer kann auf einem Dokument eine führende Null tragen und auf dem nächsten nicht. Die Extraktionsebene wendet ein konsistentes Ausgabeformat auf Daten und Kennungen an, während sie jede Zeile schreibt, sodass eine markierte Abweichung im Dashboard eine echte Diskrepanz widerspiegelt und keine Formatierungsfrage.
Dieselbe Rechnungsextraktionsebene, die die Drei-Wege-Abgleich-Pipeline antreibt, ist die Engine hinter der breiteren Lieferanten-zu-AP-Rechnungspipeline – die Spaltenstruktur unterscheidet sich, aber der Extraktionsmechanismus ist identisch. Einmal für den Abgleich gebaut, speist dieselbe Pipeline die AP-Berichterstattung, Rückstellungsberechnungen und Prüfungsdokumentation.
Das Matching-Dashboard: VLOOKUP, IF und bedingte Formatierung
Wenn alle drei Ebenen befüllt sind — Bestellregister, Wareneingangsregister und Rechnungsregister — ist das Matching-Dashboard der Ort, an dem sie zusammenlaufen. Dies ist ein einzelner Tab, der Daten aus allen drei Quell-Tabs mithilfe von Suchfunktionen abruft und Vergleichslogik anwendet, um Abweichungen, Varianzen und fehlende Daten zu kennzeichnen. Die Matching-Logik selbst ist nicht komplex. Eine Tabellenkalkulation kann das leisten. Was immer komplex war — und was die Pipeline löst — ist, die Daten in einen Zustand zu bringen, in dem die Tabellenkalkulation es kann. Für das auf Abstimmung ausgerichtete Gegenstück zu dieser Pipeline — Toleranzregeln, Auto-Match-Zonen und die menschliche Urteilsinstanz für mehrdeutige Artikelbeschreibungen — siehe unseren Leitfaden zum Drei-Wege-Abgleich in Google Sheets ohne ERP.
Die Struktur des Matching-Dashboards, erstellt in Google Sheets:
| Spalte | Quelle | Formel / Logik |
|---|---|---|
| A: Bestellnummer | Aus dem Rechnungsregister | Primärschlüssel — jede nachfolgende Spalte referenziert diese |
| B: Rechnungsnummer | Aus dem Rechnungsregister | Direktbezug: ='Invoice Register'!A2 |
| C: Lieferant | Aus dem Rechnungsregister | Direktbezug |
| D: Bestell-Lieferant | SVERWEIS aus dem Bestellregister | =VLOOKUP(A2, 'PO Register'!A:H, 2, FALSE) |
| E: Bestellmenge | SVERWEIS aus dem Bestellregister | Entspricht der Positionsmenge in der Bestellung |
| F: Empfangene Menge | SVERWEIS aus dem Wareneingangsregister | =VLOOKUP(A2, 'Receiving'!A:G, 3, FALSE) |
| G: Berechnete Menge | Aus dem Rechnungsregister | Direktbezug |
| H: Bestell-Einzelpreis | SVERWEIS aus dem Bestellregister | Preisbasis für die Abweichungsprüfung |
| I: Berechneter Einzelpreis | Aus dem Rechnungsregister | Direktbezug |
| J: Mengenabweichung | Berechnet | =G2-E2 — positiv bedeutet: mehr berechnet als bestellt |
| K: Preisabweichung | Berechnet | =I2-H2 — positiv bedeutet: Einzelpreiserhöhung gegenüber Bestellung |
| L: Positionssummen-Abweichung | Berechnet | =(G2*I2)-(E2*H2) — kombinierter Mengen- und Preiseffekt |
| M: Empfangen vs. berechnet | Berechnet | =G2-F2 — berechnete Menge vs. tatsächlich eingegangene Menge |
| N: Abgleichstatus | Berechnet | =IF(AND(J2=0,K2=0,M2=0),"MATCHED",IF(F2="","NO RECEIPT","VARIANCE")) |
| O: Anmerkungen | Manuell | Erklärung für Abweichungen: „Lieferantenaufschlag nicht in der Bestellung", „Teillieferung — Restbetrag nächsten Monat fällig" |
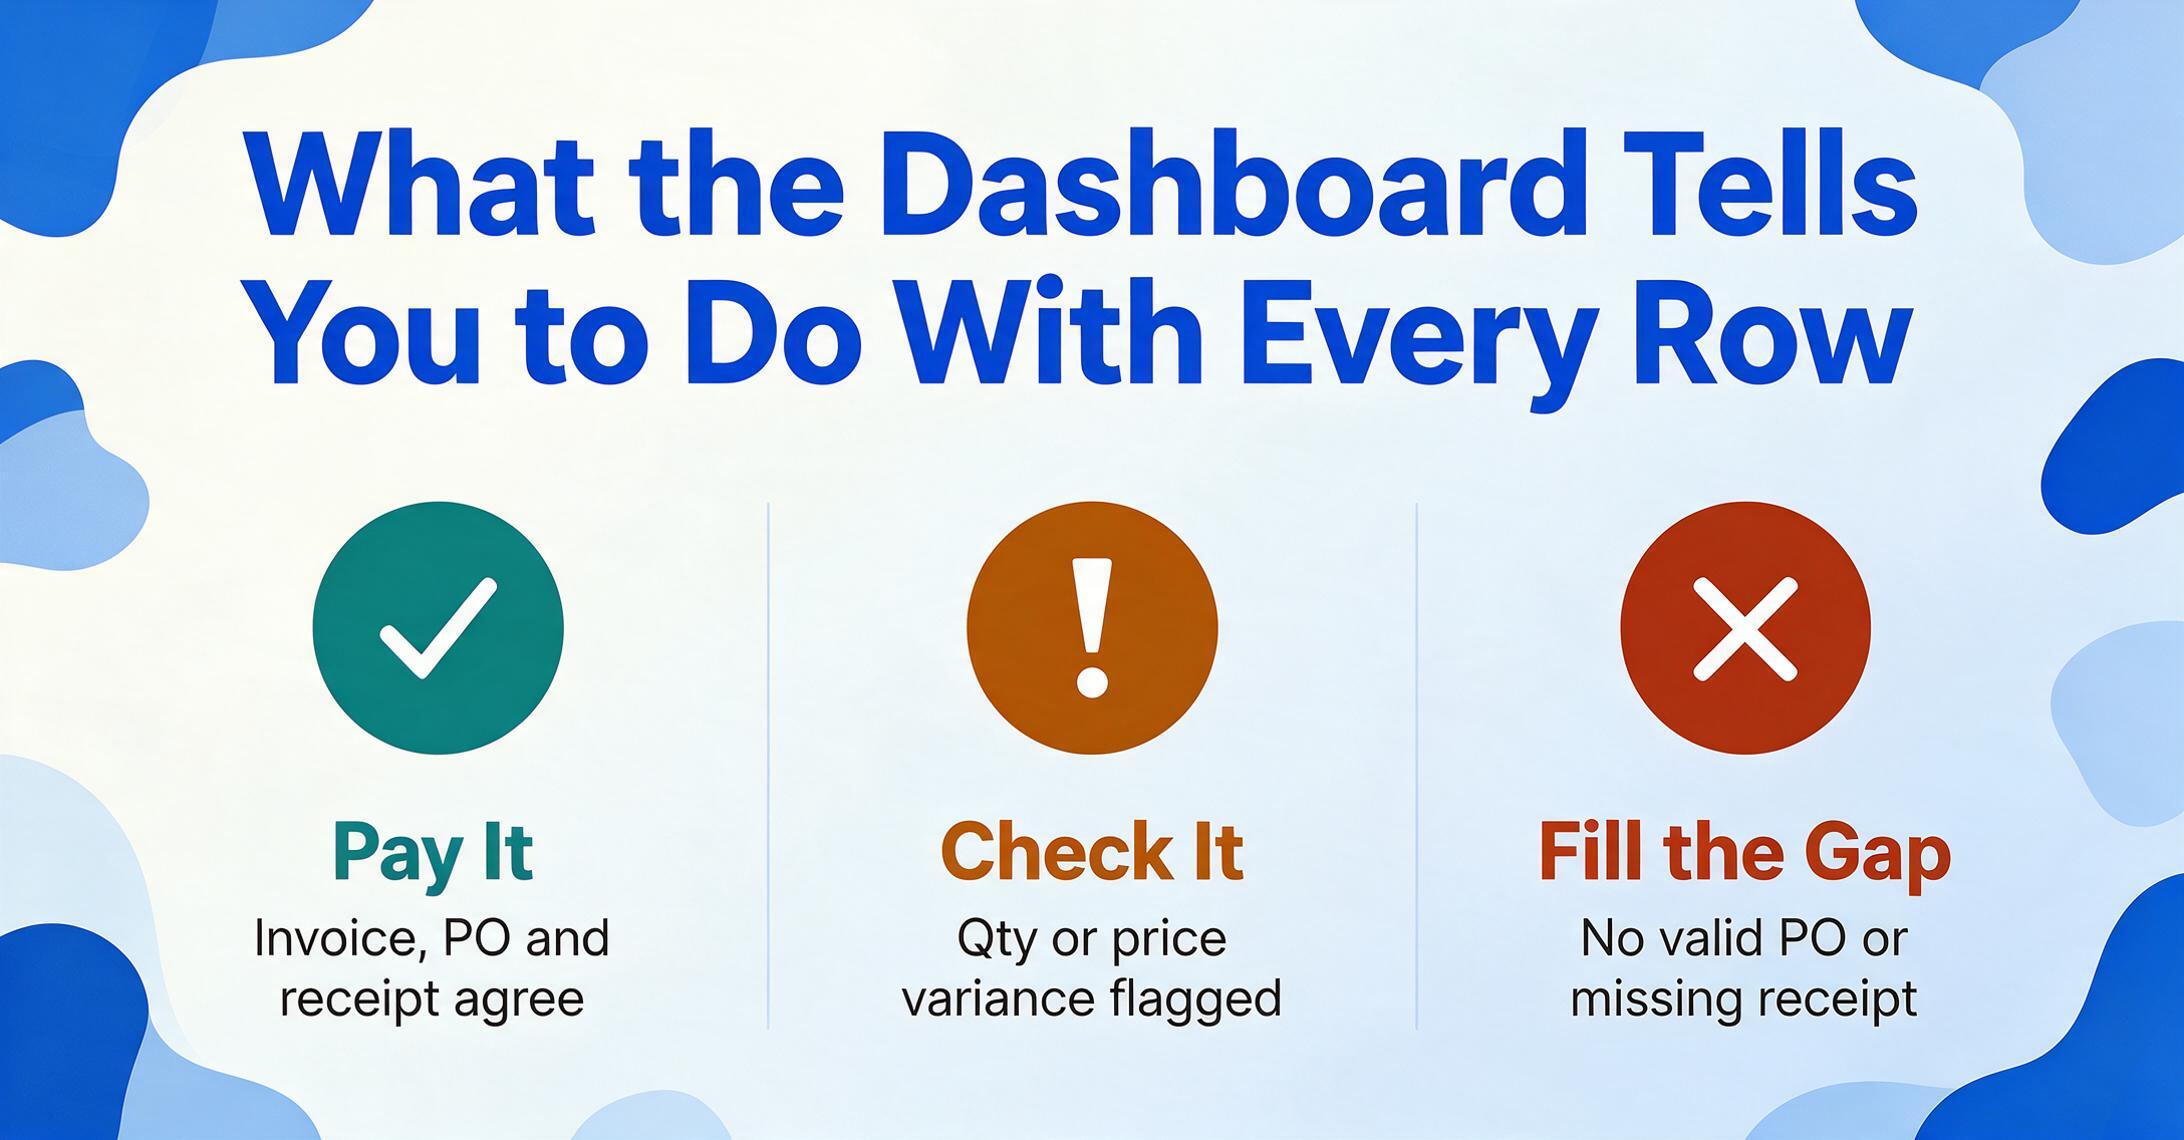
Bedingte Formatierung macht aus dieser Tabelle ein Dashboard: Spalte N grün hervorheben für „MATCHED", amber für „NO RECEIPT", rot für „VARIANCE". Wenden Sie einen roten Rahmen auf jede Zeile an, in der Spalte J (Qty Variance) einen konfigurierbaren Schwellenwert überschreitet — 5 % für Schüttgüter, 2 % für hochwertige technische Komponenten. Fügen Sie eine Zusammenfassung in der obersten Zeile hinzu: =COUNTIF(N:N,"MATCHED") zum Zählen übereinstimmender Rechnungen, =COUNTIF(N:N,"VARIANCE") für Ausnahmen, =SUMIF(N:N,"VARIANCE",L:L) für den gesamten Dollarwert der Abweichungen.
Die zentrale architektonische Entscheidung ist die PO-Nummer als universeller Schlüssel. Jeder VLOOKUP im Abgleich-Dashboard referenziert die PO-Nummern-Spalte. Wenn eine Lieferantenrechnung keine PO-Nummer enthält — und unsere Analyse des Abgleichproblems hat bestätigt, dass dies die häufigste Einzelursache für Abgleichfehler ist —, wird die Zeile in jeder VLOOKUP-Spalte mit #N/A-Fehlern befüllt, die im Dashboard sofort sichtbar sind. Die Lösung ist einfach: PO-Nummer zur Rechnungsregisterzeile hinzufügen und die Formeln berechnen neu. Aber die Sichtbarkeit ist der Punkt. Ohne Dashboard wartet eine Rechnung ohne PO-Nummer in einer Warteschlange, bis es jemandem auffällt. Mit Dashboard wird sie markiert, sobald die Zeile befüllt wird.
Die Abgleichformeln sind nicht der schwierige Teil. Jeder AP-Sachbearbeiter, der sich mit VLOOKUP auskennt, hat eine Version davon in Excel gebaut. Was sich ändert, ist die Datenquelle: Die PO-Positionen, die Wareneingangsmengen und die Rechnungsdetails kommen im selben strukturierten Format an, in Sekunden aus den Originaldokumenten extrahiert statt von Hand eingegeben.
Für Teillieferungen — die häufigste Komplexität in der Fertigungsbeschaffung, wenn eine PO mehrere Sendungen abdeckt — fügen Sie eine Spalte „Delivery Number" sowohl zum Wareneingangsregister als auch zum Rechnungsregister hinzu. Der VLOOKUP wird zu einem Zwei-Schlüssel-Lookup: Abgleich auf PO-Nummer UND Delivery Number. Jede Teillieferung erhält ihre eigene Abgleichzeile, und die Berechnung der kumulierten Liefermenge (=SUMIFS(F:F, A:A, A2, [Delivery], "<="&[@Delivery])) verfolgt, wie viel von der gesamten PO-Menge über alle Teillieferungen geliefert wurde. Dieselbe Logik behandelt Rahmenbestellungen mit rollierenden monatlichen Freigaben — das Dashboard verfolgt kumulierte Mengen gegen die gesamte PO-Freigabe.
Sammellink – Lassen Sie Lieferanten Dokumente direkt einreichen
Eine der anhaltenden Ineffizienzen beim Drei-Wege-Abgleich ist die Dokumentenübergabe vom Lieferanten an Ihre AP-Abteilung. Der Lieferant sendet die Rechnung per E-Mail. Der AP-Sachbearbeiter lädt den Anhang herunter, speichert ihn auf einem gemeinsamen Laufwerk oder in einem lokalen Ordner und lädt ihn dann in das Extraktionstool hoch. Dieser Download-und-Wieder-Upload-Zyklus ist nicht der Engpass – aber er ist ein zusätzlicher Schritt, der Reibung erzeugt, wenn Sie über 100 Rechnungen pro Monat von 50 verschiedenen Lieferanten verarbeiten.
Ein Sammellink eliminiert diesen Zwischenschritt. Es ist eine teilbare URL (im Format /c/xxxx), die Sie generieren und an einen Lieferanten senden. Der Lieferant öffnet den Link, gibt einen kurzen Verifizierungscode ein, der auf der Seite angezeigt wird, und lädt seine Rechnung direkt hoch – keine Kontoerstellung, kein Login, keine Softwareinstallation. Die Datei landet automatisch in der Verarbeitungswarteschlange Ihres Kontos, wobei der Lieferant über den verwendeten Link identifiziert wird. Sie können für jeden Lieferanten einen separaten Sammellink erstellen (oder einen pro Lieferantengruppe), sodass eingehende Dateien bereits vor der Extraktion nach Quelle vorsortiert sind.
Angewendet auf den Drei-Wege-Abgleich-Pipeline ändert ein Sammellink den Dokumentfluss von „Lieferant sendet Rechnung per E-Mail → Sie laden herunter → Sie laden hoch → Sie extrahieren" zu „Lieferant lädt direkt hoch → Datei erscheint in Ihrer Warteschlange → Sie extrahieren". Er entfernt den Download-und-Wieder-Upload-Schritt vollständig. Für Lieferanten, die mehrere Dokumente senden – einen Lieferschein und eine Rechnung für dieselbe Sendung – erfasst ein einzelner Sammellink beide Dateien, und die Extraktionsengine verarbeitet jede gemäß den Spaltendefinitionen im Blatt. Für die detaillierte Einrichtung und den Workflow finden Sie in unserem Leitfaden zur Dokumentenerfassung mit Extraktion.
Der Sammellink ersetzt keine Lieferantenbeziehungen durch ein Portal. Er ersetzt den E-Mail-Anhang-Download-Zyklus durch einen direkten Upload-Pfad. Der Lieferant benötigt keine Schulung, keine Anmeldedaten und keine Software. Er benötigt den Link und den Verifizierungscode. Der Rest ist dieselbe Extraktions-Pipeline – nur mit einem Schritt weniger zwischen „Lieferant sendet" und „Daten sind in Ihrem Blatt".
Was es ersetzt – und was nicht
Eine Pipeline ist eine konkrete Aussage: Sie besagt, dass diese Abfolge von Schritten diese Ausgabe erzeugt. Es ist wichtig, genau zu benennen, was die hier beschriebene Pipeline ersetzt, was sie ergänzt und wofür sie nie gedacht war.
Was sie ersetzt:
- Manuelle Dateneingabe aus Bestellungen und Rechnungen in Tabellen. Die Extraktionsschichten wandeln unstrukturierte Dokumente in strukturierte Zeilen um. Das Abtippen von Bestellpositionen und Rechnungsfeldern in eine Nachverfolgungstabelle entfällt.
- Wartung von OCR-Vorlagen pro Lieferant. Die Spaltennamenextraktion liest jedes Dokumentenlayout ohne vorkonfigurierte Vorlagen. Ein neuer Lieferant wird durch das Senden eines Sammlungslinks angebunden – kein Vorlagenbau erforderlich.
- Die abteilungsübergreifende Nachforschungsschleife. Wenn Bestelldaten, Wareneingangsdaten und Rechnungsdaten alle in einem strukturierten Dashboard vorliegen, wird die Frage „Stimmt die Rechnung mit der Bestellung überein?“ durch einen Blick auf eine bedingt formatierte Zelle beantwortet – nicht durch Anrufe bei Einkauf und Warenannahme.
- Blinde Flecken bei fehlenden Dokumenten. Die SVERWEIS-Struktur des Dashboards legt Lücken sofort offen: #NV beim Bestell-SVERWEIS bedeutet, dass die Rechnung keine gültige Bestellung referenziert. Leer bei der empfangenen Menge bedeutet, dass der Wareneingang nie erfasst wurde. Das sind keine Ergebnisse einer monatlichen Prüfung – sie sind in Echtzeit in jeder Zeile sichtbar.
Was sie nicht ersetzt:
- Ein ERP für Organisationen, die eines benötigen. Bei 2.000–3.000 Rechnungen pro Monat erreicht ein tabellenbasiertes Abgleich-Dashboard seine praktische Grenze. Das Ausnahmevolumen überfordert die manuelle Prüfung. In diesem Umfang wird der Wert eines ERP – automatisierter Abgleich, integrierte Prüfpfade, Funktionstrennung – notwendig, nicht optional. Die Pipeline speist das ERP mit strukturierten Daten; sie ersetzt das ERP nicht als Kontrollumgebung.
- Menschliches Urteilsvermögen bei Ausnahmen. Das Dashboard zeigt Abweichungen an. Es löst sie nicht auf. Eine Differenz von 47,50 € zwischen berechnetem und bestelltem Stückpreis könnte ein legitimer Zuschlag sein, den der Einkauf ausgehandelt, aber nie der Buchhaltung mitgeteilt hat, oder ein Fehler. Die KI kann das nicht wissen – und sollte nicht entscheiden müssen. Die Markierung löst eine manuelle Prüfung aus. Die Prüfung erfordert Geschäftskontext, den die KI nicht hat.
- Den Wareneingangsprozess selbst. Wenn keine Wareneingänge erfasst werden – wenn die Warenannahme nicht protokolliert, was ankommt – zeigt die Pipeline die Lücke im Wareneingangs-Tab, kann die Daten aber nicht erzeugen. Die Wareneingangsschicht erfordert Prozessdisziplin: Jemand muss bestätigen und aufzeichnen, was geliefert wurde. Die Pipeline strukturiert diese Daten. Sie erschafft sie nicht aus dem Nichts.
- Die Einhaltung der Bestellnummer auf Rechnungen durch Lieferanten. Die Pipeline macht das Fehlen einer Bestellnummer sichtbar. Sie zwingt Lieferanten nicht, eine anzugeben. Dafür ist eine Einkaufsrichtlinie erforderlich – und deren Durchsetzung –, keine technische Lösung.
FAQ
Wie viele Rechnungen verarbeitet diese Pipeline pro Monat, bevor sie an ihre Grenzen stößt?
Die strukturelle Grenze liegt nicht in der Extraktions-Engine – sie verarbeitet Batch-Uploads mehrerer Dateien in einer Sitzung –, sondern in der manuellen Prüfkapazität des Matching-Dashboards. Ein einzelner Kreditorenbuchhalter, der Abweichungen prüft und bearbeitet, kann mit einem gut strukturierten Dashboard bequem etwa 300–500 Rechnungen pro Monat bewältigen, bei einer Ausnahmequote von 22 % (66–110 zu untersuchende Abweichungen). Ab 1.000 Rechnungen pro Monat erfordert das Ausnahmevolumen entweder mehrere Kreditorenbuchhalter oder den Umstieg auf ein ERP mit automatischen Matching-Regeln. Der Wert der Pipeline verschiebt sich bei höheren Volumina vom „primären Matching-Tool“ zur „Datenextraktions-Engine, die strukturierte Daten in das ERP einspeist“ – die Extraktionsschichten arbeiten weiter; das Dashboard wird zu einem Pre-ERP-Validierungsschritt, nicht mehr zur finalen Matching-Umgebung.
Was ist, wenn meine Bestellungen Rahmenpreise mit monatlichen Änderungen haben – kann die Pipeline variable Preise verarbeiten?
Ja – aber das Bestellregister muss als lebendes Dokument gepflegt werden, nicht als einmalige Extraktion. Bei einer Rahmenbestellung mit monatlichen Preisänderungen, die an einen Rohstoffmarktpreis gekoppelt sind, muss die Zeile für diesen Lieferanten im Bestellregister monatlich mit dem aktuell gültigen Preis aktualisiert werden. Der SVERWEIS im Matching-Dashboard greift dann den aktualisierten Preis. Die Alternative – und diejenige, die eine Prüfspur erhält – ist, eine Spalte „Gültig ab“ zum Bestellregister hinzuzufügen und einen SVERWEIS mit Datumsbereichsabgleich zu verwenden: Es wird der Bestellpreis abgerufen, der am Rechnungsdatum gültig war, nicht der aktuelle Preis. Dies ist aufwändiger einzurichten, bildet aber genau den vereinbarten Preis zum Zeitpunkt des Versands ab – was der Dreifachabgleich eigentlich prüfen soll.
Funktioniert die Extraktion auch mit handschriftlichen Lieferscheinen und Wareneingangsbelegen?
Ja – die KI liest handschriftliche Texte, einschließlich der typischen Zahlen und Notizen auf unterschriebenen Lieferscheinen. Die Genauigkeit ist bei handschriftlichen Dokumenten jedoch geringer als bei gedruckten, und stark beschädigte Dokumente (verblasste Thermodrucke, Kohlepapierdurchschläge mit blasser Schrift, zerknitterte und wieder geglättete Lieferscheine) führen zu mehr Extraktionsfehlern. Für Wareneingangsdaten empfehlen wir: (a) falls möglich, soll der Wareneingangsmitarbeiter Schlüsselfelder (Bestellnummer, Artikel, Menge, Datum) direkt im Google Sheet am Wareneingang erfassen – die manuelle Eingabe am Empfangspunkt ist schneller und genauer als die spätere Extraktion aus einem beschädigten Dokument; (b) falls die Extraktion aus dem Lieferschein der einzig gangbare Weg ist, stichprobenartig einige Zeilen mit dem Originaldokument abgleichen, insbesondere bei hochwertigen Sendungen; (c) das Foto des Lieferscheins als Anhang zur Wareneingangszeile speichern – selbst wenn bei der Extraktion eine Ziffer fehlt, ist das Originaldokument für die Prüfung nur einen Klick entfernt.
Kann ich diese Pipeline ohne das Google-Sheets-Add-on nutzen — nur mit der Web-App?
Ja. Die Extraktions-Engine ist dieselbe, ob Sie sie über das Seitenleisten-Add-on in Sheets oder über die Web-Anwendung unter ImageToTable.ai nutzen. Der Vorteil des Add-ons besteht darin, dass die Extraktionsergebnisse direkt in das aktive Blatt geschrieben werden — kein Download-und-Neu-Upload-Zyklus. Mit der Web-App laden Sie Dokumente im Browser hoch, laden die extrahierte Excel-Datei herunter und fügen die Zeilen in Ihr passendes Dashboard ein oder importieren sie. Die Spaltendefinitionen sind dieselben. Die Extraktionsqualität ist identisch. Das Add-on entfernt einen Schritt (den Download-und-Import); die Web-App funktioniert mit jedem Tabellenkalkulationstool, nicht nur mit Google Sheets. Entscheiden Sie basierend darauf, ob dieser eine Schritt bei Ihrem Volumen eine Rolle spielt.
Wie lange dauert die Einrichtung der vollständigen Pipeline — Bestellregister, Wareneingangsregister, Rechnungsregister und Abgleich-Dashboard?
Für jemanden, der mit VLOOKUP und bedingter Formatierung in Google Sheets vertraut ist, dauert der Aufbau der vollständigen Pipeline mit vier Registerkarten etwa zwei Stunden: 30 Minuten für die Gestaltung und Erstellung der vier Registerkarten mit den oben beschriebenen Spaltenstrukturen, 45 Minuten zum Schreiben und Testen der VLOOKUP- und IF-Formeln im Abgleich-Dashboard, 30 Minuten für die Einrichtung der bedingten Formatierung und der Zusammenfassungskennzahlen und 15 Minuten zum Definieren der Extraktionsspaltensätze in der Seitenleiste des Add-ons. Die Spaltendefinitionen werden im Blatt gespeichert und bleiben über Sitzungen hinweg erhalten — Sie definieren sie einmal, und sie sind jedes Mal verfügbar, wenn Sie die Seitenleiste öffnen und dieses Blatt auswählen. Nach der Ersteinrichtung sieht der monatliche Arbeitsablauf wie folgt aus: (1) neue Bestellungen in das Bestellregister extrahieren, (2) Wareneingangsdaten eingeben oder extrahieren, (3) Lieferantenrechnungen extrahieren, (4) das Abgleich-Dashboard öffnen und die markierten Zeilen prüfen. Der erste Monat dauert am längsten wegen der Einrichtung und der Datenbefüllung. Der dritte Monat ist Routine. Für die vollständige Funktionsübersicht — unterstützte Feldtypen, Formate und Plandetails — siehe das Google-Sheets-Dokumentextraktions-Add-on.
Wie gehe ich mit Währungsunterschieden zwischen Bestellungen und Lieferantenrechnungen um?
Die Extraktions-Engine erfasst den Zahlenwert und das Währungssymbol genau so, wie sie im Dokument erscheinen. Sie führt keine Währungsumrechnung durch. Wenn Ihre Bestellung in USD vorliegt und ein Lieferant in EUR abrechnet, zeigt das Abgleich-Dashboard eine Abweichung, weil die Zahlenwerte nicht übereinstimmen – selbst wenn die umgerechneten Werte korrekt sind. Die Lösung besteht darin, sowohl dem Bestellregister als auch dem Rechnungsregister eine Spalte „Währung" hinzuzufügen sowie eine Spalte „Umrechnungskurs", die auf einen manuell gepflegten oder formelgestützten Wechselkurs verweist. Der Preisvergleich beim Abgleich verwendet dann den umgerechneten Betrag anstelle des roh extrahierten Betrags. Die Aufgabe der Pipeline ist die Extraktion. Die Währungsumrechnung ist eine Aufgabe auf Tabellenebene.
Das Fazit
Die hier beschriebene Drei-Wege-Abgleich-Pipeline ist für Organisationen, die ein ERP benötigen, kein Ersatz dafür. Sie ist ein System für Teams, die ihre Beschaffung bereits über Tabellenkalkulationen abwickeln – weil die Rechnungserfassung ihres ERPs eine Vorlagenpflege erfordert, die sie nicht leisten können, weil ihre Lieferantenbasis Formate umfasst, die ihr Abgleichmodul nicht verarbeiten kann, oder weil ihr Transaktionsvolumen in der Lücke zwischen „zu komplex für manuellen Abgleich" und „groß genug, um ein ERP-Upgrade zu rechtfertigen" liegt. Für diese Teams lautet die Frage nicht „Sollten wir den Abgleich automatisieren?", sondern „Können wir alle drei Dokumente schnell genug in dasselbe strukturierte Format bringen, sodass der Abgleich zu einer Formelübung wird statt zu einer abteilungsübergreifenden Untersuchung?"
Die Pipeline beantwortet diese Frage mit drei Extraktionsebenen und einem Dashboard. Die Bestellebene liefert die Referenzbasis. Die Wareneingangsebene bestätigt, was angekommen ist. Die Rechnungsebene erfasst, was in Rechnung gestellt wurde. Das Abgleich-Dashboard vergleicht sie – mit VLOOKUP, IF-Anweisungen und bedingter Formatierung – und markiert jede Zeile, die menschliche Aufmerksamkeit erfordert. Die Extraktions-Engine, gestützt auf KI, die Dokumente nach Bedeutung statt nach Position liest, bewältigt die Formatvielfalt, die vorlagenbasierte Ansätze in einer Beschaffung mit mehreren Lieferanten untragbar macht. Der Sammellink entfernt den E-Mail-Anhang-Download-Zyklus aus dem Dokumenterfassungsprozess.
Die strukturelle Lücke, die unsere Problemanalyse identifiziert hat – drei Abteilungen, drei Systeme, kein alleiniger Verantwortlicher für die Datenpipeline –, verschwindet nicht. Aber wenn alle drei Dokumenttypen im selben strukturierten Format in derselben Tabellenkalkulation ankommen, mit derselben Bestellnummer als universellem Schlüssel, erfordert der Abgleichschritt keine abteilungsübergreifende Untersuchung mehr. Die organisatorische Lücke bleibt bestehen. Die Daten tragen nicht länger die angesammelte Abweichung von drei verschiedenen Eingabekanälen. Das macht den Abgleich zu einer Tabellenübung statt zu einem Personalproblem.
Beginnen Sie mit der Bestellextraktionsebene. Laden Sie im Demo unten eine Bestellung hoch. Sehen Sie, ob die Felder, die für Ihren Abgleich-Workflow wichtig sind – Bestellnummer, Lieferant, Positionen, Mengen, Preise – in Sekunden strukturiert zurückkommen, statt in Minuten abgetippt zu werden. Wenn diese erste Ebene funktioniert, basiert der Rest der Pipeline auf derselben Engine.