Google Sheetsでスリーウェイマッチングのワークフローを構築する方法:
POから請求書承認までのステップバイステップガイド
製造業でスリーウェイマッチングが失敗する理由に関する分析で明らかになったのは、ボトルネックはマッチングアルゴリズムではなく、その前段階のデータ抽出ステップだということです。Ardent Partnersの2025年APベンチマークによると、初回の不一致率は平均22%で、製造業では包括購買発注書、分割出荷、ドックと請求書の間での単位のずれなどにより、その数値はさらに高くなります。診断結果は明確です。3つの書類のうち2つが構造化されていないPDFに閉じ込められている限り、マッチングはできません。この記事が答えるのは、実際に何を構築すれば解決できるのか、そしてERPなしで構築できるのか、という問いです。その基盤となるのは、マッチングの数式を実行する前に各書類をクリーンな行に変換する、再現可能なPDFからGoogle Sheetsへの抽出ステップです。
これは構築ガイドです。Google Sheetsパイプラインの4つの抽出・マッチングレイヤーをステップバイステップで解説します — 定義すべき列、記述すべき数式、そして仕入先がCollection Linkを通じて直接書類を提出する方法について。代わりに照合フレームワーク(許容範囲ルール、自動マッチゾーン、レビュー中の曖昧な品目名の処理方法)をお探しの場合は、ERPなしでのGoogle Sheetsスリーウェイマッチングに関する姉妹ガイドをご覧ください。
重要ポイント
- 初回不一致率22%はアルゴリズムの問題のように聞こえますが、その原因は上流のデータ抽出ステップにあります。
- APチームの66%は今でも請求書データを手作業でERPに入力しているため、誰かがキー入力している間、マッチングモジュールはアイドル状態です。
- ImageToTable.aiの列名抽出は、事前設定されたテンプレートなしで各仕入先のフォーマットを読み取り、3部門にまたがる調査をVLOOKUPと緑色のセルに変えます。
スリーマッチングに実際に必要なもの — 許容範囲の設定だけではない
スリーマッチングとは、支払いを承認する前に発注書、入庫伝票、仕入先請求書を照合し、発注内容と入庫内容、請求内容が一致するかを確認するプロセスです。ISO 9001:2015 第8.4項では、認証を受けた製造業者に対し、購入した製品が指定された要件を満たしていることの検証が義務付けられており、多くの企業がこれを満たすためにスリーマッチングを運用しています。ACFE「2024 Report to the Nations」(組織は年間収益の5%を職業上の不正により失うと推定)は、これを請求書不正に対する主要な対策として挙げています。規制上の論理は妥当です。しかし、その根底にあるデータの問題が、実務で機能不全を引き起こしています。
スリーマッチングの改善に関するアドバイスのほとんどは、照合レイヤーに焦点を当てています。すなわち、許容範囲の厳格化、承認ワークフローの追加、ERPでの自動照合ルールの設定などです。しかし、これらはいずれも、3つの文書が3つの異なるシステムから異なる形式で届き、そのうち2つが非構造化データであるという根本的な問題を解決しません。発注書は購買システムに存在します。入庫伝票は紙の納品書から入力されたかどうか定かではありません。仕入先請求書はPDFで届きます。照合ロジックがこれらの文書を比較する前に、構造化されていない2つの文書からデータを抽出し、比較可能な形式に変換し、単位や明細行が一致することを確認する必要があります。VLOOKUPやIF文、条件付き書式といった照合レイヤーは簡単な部分です。パイプラインの成否を分けるのは、データ抽出レイヤーです。
機能するスリーマッチングのパイプラインは、より優れた照合ルールから始まるのではありません。3つの文書すべてを同じスプレッドシート内の同じ構造化形式に変換することから始まります。それができれば、照合は数式の問題です。難しいのは、そこにたどり着くことです。
ERPのアドバイスがスプレッドシートのワークフローに合わない理由
SAPのMMモジュール、Oracle E-Business Suite、Microsoft Dynamics 365 — いずれも設定可能な許容範囲を持つスリーウェイマッチングモジュールを備えています。例えばSAPは、GR/IR清算勘定を通じてマッチングを処理します。入庫(トランザクションMIGO)は借方に計上され、請求書受領(MIRO)は貸方に計上され、システムは一致した明細行を自動的に清算します。このロジックは成熟しており、十分に文書化されています。
このロジックはまた、かなりの数の購買業務において当てはまらない前提を置いています。それは、マッチングロジックが実行される前に、3つのドキュメントすべてが構造化された比較可能なデータとしてERP内に存在するという前提です。2025年のIFOL AP自動化トレンド調査によると、APチームの66%が依然として請求書データをERPに手入力しています。50〜200社の仕入先とのサプライヤー関係を管理する購買チーム — その多くは、PDFをメールで送信する小規模な機械工場、地元の販売代理店、専門サプライヤーです — にとって、すべての請求書は、マッチングを開始する前に手動データ入力イベントとなります。
あなたがそのグループに該当する場合 — 会社がスプレッドシートで購買を管理している、ERPの請求書取り込みに仕入先ごとのテンプレート設定が必要でそれを維持する余裕がない、または仕入先基盤にPDFのみを送信する小規模ベンダーが十分に含まれている、といった理由で — ERPのマッチングモジュールは、実際に抱えている問題の下流にある問題に対処しています。より良いマッチングアルゴリズムは必要ありません。必要なのは、POデータ、入庫データ、請求書データを1つの構造化されたビューにまとめる方法です。そして、購買追跡にすでに使用しているツールは、おそらくスプレッドシートでしょう。問題は、そのスプレッドシートをパイプラインに変える方法です。
3層パイプラインアーキテクチャ
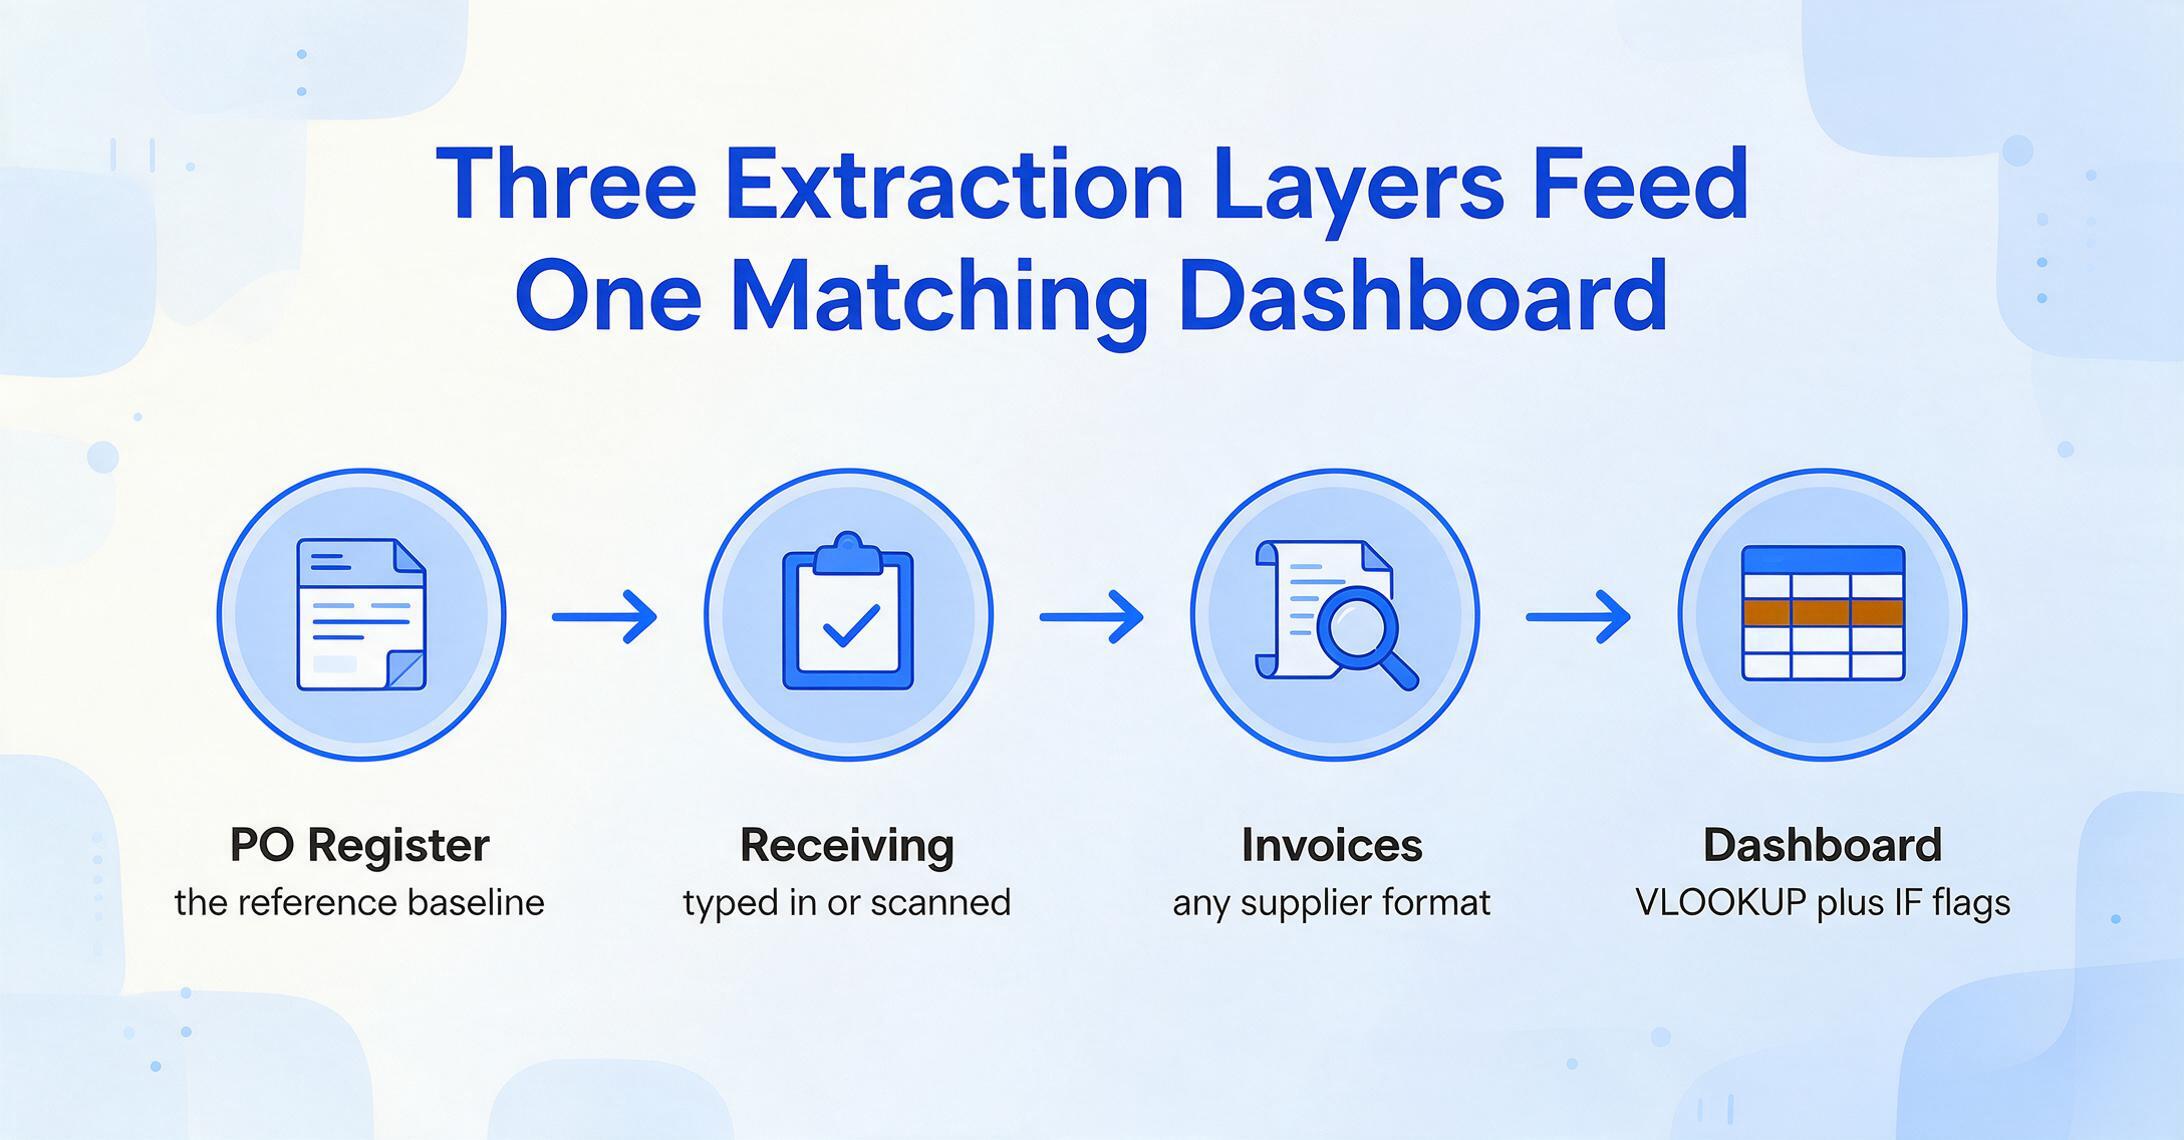
このパイプラインは、スリーウェイマッチングの各ドキュメントに対応する3つのレイヤーと、その上に位置する4つ目のレイヤー(マッチングダッシュボード)で構成されています。最初の3つのレイヤーは、非構造化ドキュメントから構造化データを抽出します。4つ目のレイヤーはそれらを比較します。最初の3つのレイヤーのいずれかが一貫性のないデータや不完全なデータを生成した場合、マッチングレイヤーはその役割を果たせません。
各レイヤーは、調達から支払いまでのチェーンにおける特定のギャップを埋めます。POレイヤーはベースライン(何を、いくらで、誰から注文したか)を確立します。入庫レイヤーは、物理的に何が到着したかを確認します。請求書レイヤーは、仕入先が請求した内容を取得します。マッチングダッシュボードは、これら3つがすべて収束する場所であり、問題分析で従来のマッチングワークフローの構造的な弱点として特定された3部門にわたる調査を、スプレッドシートが置き換える場所です。
レイヤー1とレイヤー3で非構造化データを構造化データに変換する仕組みを支えているのは、Custom Column Extractionです。各書類のフィールドに枠を描いたり、仕入先のフォーマットごとにテンプレートを作成したりする代わりに、「PO番号」「仕入先名」「明細行」「数量」「単価」「明細合計」など、必要な列名を入力するだけで、AIが書類を読み取り、ページ上の位置ではなく意味を理解して値を特定します。SAPのPDF出力による構造化されたPOと、地元の仕入先から届く手書きのPOは、見た目はまったく異なります。しかし、どちらにもPO番号、仕入先名、数量、価格が含まれています。列名抽出は、あらゆるレイアウトにわたってこれらのフィールドの意味を検索するため、多数の仕入先の書類フォーマットを扱う購買チームにとってテンプレートベースのOCRを非現実的にしている、仕入先ごと・フォーマットごとのテンプレート管理を排除します。
レイヤー1 — 購買発注書の抽出:照合の基準
スリーウェイマッチングは、必ず購買発注書から始まります。POは、どの仕入先から、どの品目を、どの数量で、どの価格で、いつ納品してもらうかという条件を定めます。ERP統合環境では、このデータはすでに構造化された明細行として存在します。POはシステム内で作成されているからです。しかし、スプレッドシートベースの購買ワークフローでは、POはいくつかの形式で届きます。自社システムが生成したPDF、注文を確認する仕入先からのメール添付のPO、紙で運用している小規模な仕入先からのスキャン書類などです。POデータを構造化された形式に変換することが最初のステップであり、スプレッドシートベースのチームにとっては、その後のパイプライン全体が実現可能かどうかを左右するステップです。
POの抽出列は、照合プロセスで参照する必要がある項目によって異なります。最低限必要なものは次のとおりです。
| 列 | 取得内容 | 照合で重要な理由 |
|---|---|---|
| PO番号 | POを一意に識別する番号 | キーとなるフィールド — すべての入庫報告書と請求書は、照合のためにこれを参照する必要があります |
| 仕入先名 | POに記載されている仕入先名 | 請求書の仕入先と照合し、同一の仕入先であることを確認します |
| 明細行 | 品目説明、SKU、または部品番号 | 入庫報告書と請求書の明細行に照合し、品目レベルの比較を行います |
| 数量 | 明細行ごとの発注数量 | 入庫数量および請求数量と比較します |
| 単価 | 明細行ごとの合意済み単価 | 価格差異チェック — 最も一般的な監査フラグです |
| 明細合計 | 明細行ごとの数量 × 単価 | 請求された明細合計と比較し、掛け算の誤りを検出します |
| 納期 | 予定納品日 | 入庫日を検証し、納品遅延をフラグ付けするために使用します |
| PO合計 | 全明細合計の合計額 | 説明なしに請求書が超過すべきではない総額です |
社内で統一された形式(自社のPOテンプレート)で生成される購買発注書の場合、抽出は簡単です。AIは毎回同じ一般的なレイアウトから同じフィールドを読み取ります。ベンダーの形式で届く仕入先確認用POの場合、抽出は適応します。列名は同じままで、AIはレイアウトに関係なく値を特定します。1回の抽出実行で、PO登録タブに構造化データが入力されます。マッチングの際にヘッダーレベルか明細行レベルの粒度のどちらが必要かに応じて、POごとに1行、または明細行ごとに1行が作成されます。Google Sheetsアドオンを使用した単一PO抽出ガイドでは、列の設定と最初の抽出ワークフローについて説明しています。一度に多数のPOを処理する高ボリュームのチーム向けに、バッチPO処理ダッシュボードでは、1つのセッションで複数のPOに同じ抽出エンジンを適用します。
ファイルは安全に処理され、保存されません。
上記のデモは、PO文書用に事前設定された抽出列である購買発注書プリセットを使用しています。購買発注書をアップロードすると、入力なしでフィールドが入力されるのを確認できます。POにプリセットがカバーしていないフィールド(商品サーチャージ行、運賃条件セクション、内部コストセンターコードなど)が含まれている場合は、カスタム列として追加できます。抽出エンジンはそれらを同じように扱います。プリセットは開始点を提供します。カスタム列は、マッチングダッシュボードの要件に合わせてそれを拡張します。
レイヤー2 — 入庫報告書データ:扱いが難しい中間書類
入庫報告書は、構造化されたシステムに最も欠けやすい書類であり、スリーウェイマッチングをスリーウェイプロセスにしている書類です。入庫確認がなければ、ツーウェイマッチング(POと請求書)を行い、納品が確認できない商品に対して支払いをしていることになります。ACFEは特に、入庫報告書を請求詐欺(納品されていない商品への支払い)を防ぐ統制として特定しています。これを省略することは近道ではありません。統制フレームワークの欠陥です。
入庫データは、その作成方法のためにPOデータよりも構造化が困難です。荷受け場で、多くの場合紙ベースで、荷降ろしを優先するスタッフによって作成され、データ入力は後回しにされます。梱包明細書は通常、複写式のカーボン紙か、運送会社のサーマルプリント書類です。受入担当者はそれに署名し、受入数量(POと異なる単位の場合もあります)を記録し、紙のコピーをファイルします。そのデータがデジタルシステムに入るかどうかは、後から誰かが入力するかどうかにかかっており、このステップが繁忙期の受入時に最初に省略されるのです。
パイプラインでは、入庫データには2つの実行可能な入力経路があります。1つ目は直接手動入力です。受入担当者、または指定されたデータ入力担当者が、受入ワークフローの一環として主要フィールドをGoogleシートに入力します。列はPO列を反映しています:PO番号(関連付け用)、受入品目、受入数量、受入日、運送会社、状態。この経路は、受入量が中程度(1日30件未満)で、荷受け場にシートを開けるデバイスがある場合に有効です。利点は管理性です。入力時点で入庫データが構造化され、後続の変換が不要です。
2つ目の経路は梱包明細書自体からの書類抽出です。署名済みの梱包明細書の写真またはスキャンを撮り、POや請求書に使用されているものと同じ抽出エンジンに通します。この経路は、手動入力が現実的でない場合に有効です。高稼働の荷受け場、遠隔地の受入場所、または梱包明細書が唯一の受入記録である業務です。抽出列は同じです:PO番号、品目説明、受入数量、受入日、運送会社。サイドバーアドオンで処理された梱包明細書のスマホ写真は、手動入力データと同じ構造化形式で受入タブに入力されます。主な制限:梱包明細書の手書き文字は、印刷されたPOや請求書と比較して抽出精度を低下させます。重要な出荷についてはスポットチェックをお勧めします。文書品質別の詳細な精度内訳については、手書き文書の抽出精度に関するガイドをご覧ください。同じ原則が梱包明細書と入庫報告書に適用されます。
どちらの経路を使用しても、出力は同じです。PO番号をキーフィールドとする受入台帳タブが作成され、各受入を発注元の購買発注書にリンクします。そのリンクがなければ、マッチングダッシュボードは機能しません。
レイヤー3 — 仕入先請求書の抽出:制御できないフォーマット問題
仕入先請求書は、フォーマットの多様性の問題が最も顕著になる領域です。単一の調達業務でも、大規模なMRO販売業者から構造化されたSAP生成PDFの請求書、地域の金属サプライヤーから独自のExcel-to-PDF形式、地元の機械工場から撮影された手書き文書、そして日付形式・通貨慣習・税行構造が異なる国際的なベンダーからの請求書を受け取る可能性があります。テンプレートベースのOCR(各サプライヤーのレイアウトにフィールドマッピングテンプレートを構築し、レイアウトが変更されるたびに更新する方法)は、この多様性の前で機能不全に陥るか、メンテナンスに多大な時間を費やし、抽出作業が本来置き換えるはずだった手作業入力と同じくらいの労力になってしまいます。
Custom Column Extractionは、抽出ロジックを特定のレイアウトから切り離すことでこの問題を解決します。列名は一度定義するだけです。AIはフォーマットに関係なく各請求書を読み取り、その列定義に一致する値を探し出します。スリーウェイマッチング用の請求書列設定には、通常以下の項目が含まれます:
| 列 | ソース | マッチングの役割 |
|---|---|---|
| 請求書番号 | 請求書から抽出 | 一意の識別子 — 重複支払いを防止 |
| PO番号 | 請求書から抽出 | 重要なリンクフィールド — マッチングが機能するには、PO登録タブのPOと一致する必要があります |
| ベンダー名 | 請求書から抽出 | POベンダーとの相互参照 — 誤ったPO参照エラーを検出 |
| 請求日 | 請求書から抽出 | 支払条件の計算、滞留分析 |
| 支払期日 | 請求書から抽出 | 早期支払い割引期間の追跡 |
| 明細行の説明 | 請求書から抽出 | PO明細行との照合 — 注文したものと同じ商品が請求されていることを確認 |
| 数量 | 請求書から抽出 | PO数量および受領数量との差異チェック |
| 単価 | 請求書から抽出 | PO単価との差異チェック — 価格上昇の検出 |
| 明細合計 | 請求書から抽出 | 掛け算チェック — 請求書上で数量×単価=明細合計を確認 |
| 請求書合計 | 請求書から抽出 | PO合計との許容範囲内での照合、支払い承認トリガー |
また、推論列を追加することもできます。これは、請求書に明示的に印刷されていないものの、その文脈から導き出せるデータを取得する列です。たとえば、マッチングステータス(オプション: マッチング準備完了/PO参照が必要/明細行が不足)として定義された列を使用すると、AIはPO番号が見つかったかどうか、明細行が抽出可能かどうかに基づいて、抽出中に各請求書を分類できます。PO番号を文書に含めない仕入先からの請求書は即座にフラグが付けられ、「PO参照が必要」ステータスでマッチングダッシュボードに入り、AP担当者はPO番号が追加されるまでマッチングを試みないことがわかります。これは抽出としての分類です。分類の決定は、データを入力するのと同じパスで行われ、別のレビューステップではありません。
計算列は、抽出後のスプレッドシートの数式を必要とする計算を処理します。延長チェック(明細行合計 - 数量 * 単価)として列を定義すると、AIは抽出中に計算を実行し、請求された明細行の合計が数量×単価と等しくない明細行にフラグを付けます。出力は差異の数値です。ゼロは延長が正しいことを意味し、ゼロ以外の値は仕入先の請求書の算術エラーを特定します。これにより、マッチングダッシュボードの役割は「エラーを見つける」から「フラグが付いた行をレビューする」へと移行します。AIが検出を行い、人間が処分を行うワークフローです。計算列の構文と機能の詳細については、ドキュメント抽出における計算列ガイドをご覧ください。
フォーマットの違いにより、数式が実行される前に誤った差異が発生します。ある仕入先は請求書の日付を05/06/2026と記載し、別の仕入先は06/05/2026と記載し、同じ部品番号に先行ゼロが含まれる場合と含まれない場合があります。抽出レイヤーは、各行を書き込む際に日付と識別子に一貫した出力形式を適用するため、ダッシュボードのフラグが付いた不一致は、フォーマット上の問題ではなく実際の食い違いを反映します。
スリーウェイマッチングパイプラインを支えるのと同じ請求書抽出レイヤーが、より広範な仕入先からAPへの請求書パイプラインのエンジンです。列構造は異なりますが、抽出メカニズムは同じです。マッチング用に構築された同じパイプラインは、APレポート、未払金計算、監査文書にも利用されます。
マッチングダッシュボード:VLOOKUP、IF、条件付き書式
3つのレイヤー(購買発注書台帳、入庫台帳、請求書台帳)がすべて入力されると、マッチングダッシュボードにそれらが集約されます。これは、ルックアップ関数を使用して3つのソースタブすべてからデータを取得し、比較ロジックを適用して一致、差異、欠落データをフラグ付けする単一のタブです。マッチングロジック自体は複雑ではありません。スプレッドシートで実行できます。常に複雑だったのは、スプレッドシートがそれを実行できる状態にデータを整えることです。このパイプラインの照合に焦点を当てた対応物(許容範囲ルール、自動マッチングゾーン、曖昧な品目説明のための人的判断レイヤー)については、ERPなしでGoogle Sheetsでスリーウェイマッチングを行うためのガイドをご覧ください。
Google Sheetsで構築されたマッチングダッシュボードの構造:
| 列 | ソース | 計算式 / ロジック |
|---|---|---|
| A: 購買発注書番号 | 請求書台帳から取得 | 主キー — 以降のすべての列がこれを参照 |
| B: 請求書番号 | 請求書台帳から | 直接参照: ='Invoice Register'!A2 |
| C: 仕入先 | 請求書台帳から | 直接参照 |
| D: 購買発注書の仕入先 | 購買発注書台帳からVLOOKUP | =VLOOKUP(A2, 'PO Register'!A:H, 2, FALSE) |
| E: 購買発注書の数量 | 購買発注書台帳からVLOOKUP | 購買発注書の明細行の数量と一致 |
| F: 受領数量 | 入庫台帳からVLOOKUP | =VLOOKUP(A2, 'Receiving'!A:G, 3, FALSE) |
| G: 請求数量 | 請求書台帳から | 直接参照 |
| H: 購買発注書の単価 | 購買発注書台帳からVLOOKUP | 差異チェックの基準価格 |
| I: 請求単価 | 請求書台帳から | 直接参照 |
| J: 数量差異 | 計算列 | =G2-E2 — 正の値は発注数量より多く請求されたことを意味 |
| K: 単価差異 | 計算列 | =I2-H2 — 正の値は購買発注書と比較して単価が上昇したことを意味 |
| L: 明細行合計差異 | 計算列 | =(G2*I2)-(E2*H2) — 数量と単価の影響を合わせたもの |
| M: 受領数量と請求数量の比較 | 計算列 | =G2-F2 — 請求数量と実際に到着した数量の比較 |
| N: マッチングステータス | 計算列 | =IF(AND(J2=0,K2=0,M2=0),"MATCHED",IF(F2="","NO RECEIPT","VARIANCE")) |
| O: 備考 | 手動 | 差異の説明: 「購買発注書にない仕入先追加料金」「分割出荷 — 残額は翌月請求」 |
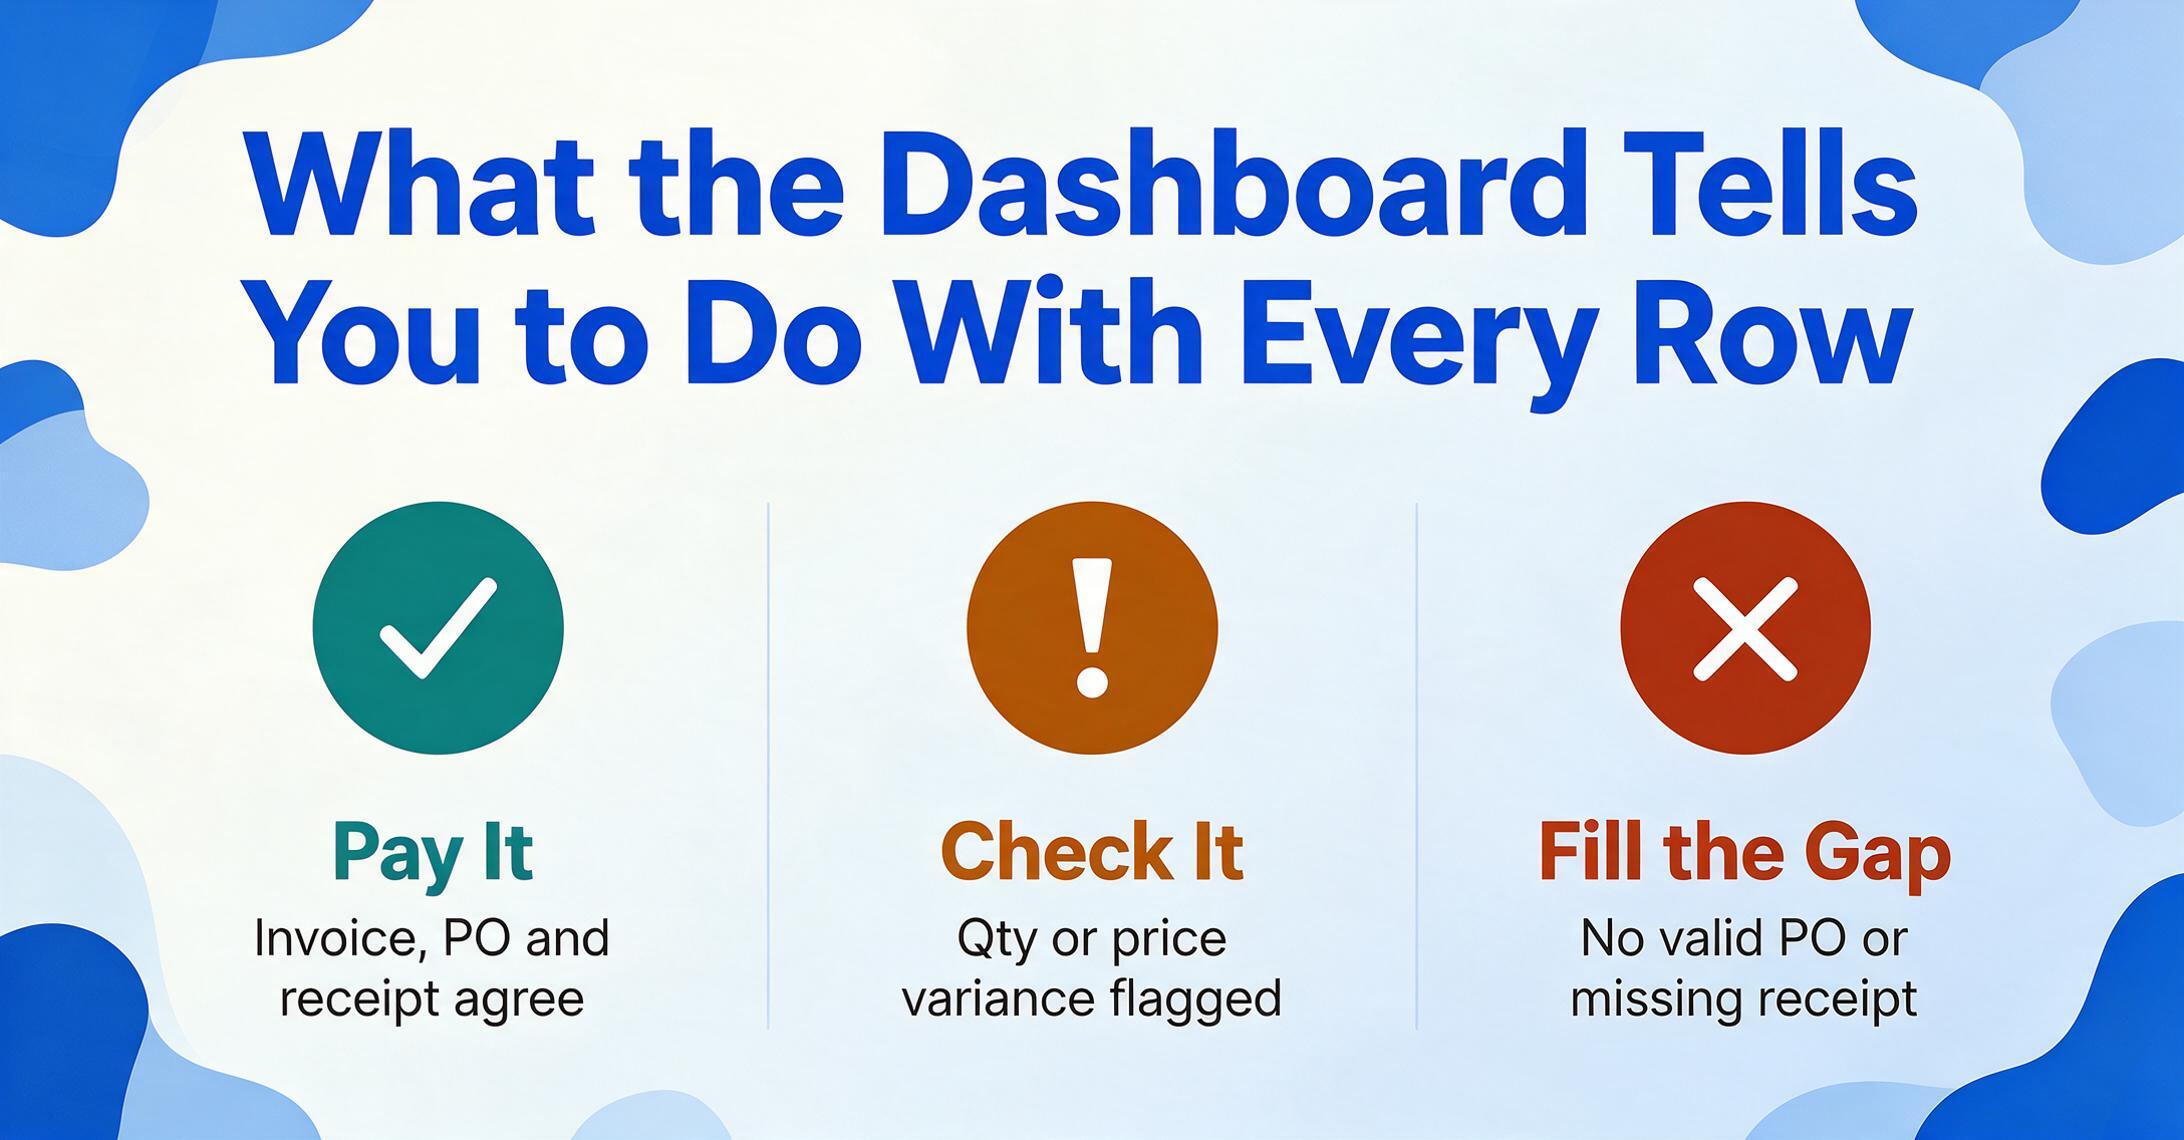
条件付き書式を使うと、この表はダッシュボードに変わります。「MATCHED」の列 N は緑、「NO RECEIPT」は琥珀色、「VARIANCE」は赤でハイライトします。列 J(数量差異)が設定可能なしきい値(バルク材は5%、高価値のエンジニアリング部品は2%)を超える行には赤い枠線を適用します。先頭行に集計を追加します:=COUNTIF(N:N,"MATCHED") でマッチした請求書をカウント、=COUNTIF(N:N,"VARIANCE") で例外をカウント、=SUMIF(N:N,"VARIANCE",L:L) で差異の合計金額を算出します。
重要な設計上の決定は、PO番号を共通キーとして使うことです。マッチングダッシュボードのすべてのVLOOKUPは、PO番号の列を参照します。仕入先請求書にPO番号が含まれていない場合(マッチング問題の分析で、これがマッチング失敗の最も一般的な根本原因であることが確認されています)、その行はすべてのVLOOKUP列で#N/Aエラーになり、ダッシュボードですぐに確認できます。修正は簡単です:請求書レジスタの行にPO番号を追加すれば、数式が再計算されます。しかし、可視化こそが重要なのです。ダッシュボードがなければ、PO番号のない請求書は誰かが気づくまでキューに残ります。ダッシュボードがあれば、行が入力された瞬間にフラグが立てられます。
マッチングの数式自体は難しい部分ではありません。VLOOKUPに慣れているAP担当者なら誰でも、Excelでこのバージョンを作ったことがあるでしょう。変わるのはデータの出所です:POの明細行、入庫数量、請求書の詳細が、同じ構造化された形式で届き、手入力ではなく数秒で元のドキュメントから抽出されます。
分割出荷(製造業の調達で最も一般的な複雑さで、1つのPOが複数の出荷をカバーする場合)については、入庫レジスタと請求書レジスタの両方に「配送番号」列を追加します。VLOOKUPは2キー検索になります:PO番号と配送番号の両方でマッチングします。各分割出荷は独自のマッチング行を持ち、累積受領計算(=SUMIFS(F:F, A:A, A2, [Delivery], "<="&[@Delivery]))は、すべての分割出荷にわたってPO総数量のうちどれだけが納品されたかを追跡します。同じロジックは、毎月のリリースがローリングされる包括購買発注書にも対応します。ダッシュボードは、POの総承認額に対する累積数量を追跡します。
Collection Link — サプライヤーが直接書類を提出できるようにする
スリーウェイマッチングにおける慢性的な非効率のひとつが、サプライヤーからAPチームへの書類の受け渡しです。サプライヤーは請求書をメールで送信します。AP担当者は添付ファイルをダウンロードし、共有ドライブやローカルフォルダに保存してから、抽出ツールにアップロードします。このダウンロードと再アップロードのサイクル自体はボトルネックではありませんが、50社のサプライヤーから毎月100件以上の請求書を処理する場合、この余分なステップが摩擦を蓄積させます。
Collection Linkは、その中間ステップを排除します。これは共有可能なURL(/c/xxxx形式)で、生成してサプライヤーに送信します。サプライヤーはリンクを開き、ページに表示される短い確認コードを入力して、請求書を直接アップロードします。アカウント作成もログインもソフトウェアのインストールも不要です。ファイルは自動的にアカウントの処理キューに登録され、使用されたリンクによってサプライヤーが識別されます。サプライヤーごとに(またはサプライヤーグループごとに)個別のCollection Linkを作成できるため、抽出が始まる前に、受信ファイルは送信元ごとに事前分類されます。
スリーウェイマッチングのパイプラインに適用すると、Collection Linkは書類の流れを「サプライヤーが請求書をメール送信 → ダウンロード → アップロード → 抽出」から「サプライヤーが直接アップロード → ファイルがキューに表示 → 抽出」に変えます。ダウンロードと再アップロードのステップを完全に排除します。同じ出荷に対する梱包明細書と請求書など、複数の書類を送信するサプライヤーの場合、1つのCollection Linkで両方のファイルを取得でき、抽出エンジンはシート内の列定義に従って各ファイルを処理します。詳細な設定とワークフローについては、文書収集と抽出のガイドをご覧ください。
Collection Linkは、サプライヤーとの関係をポータルに置き換えるものではありません。メールの添付ファイルのダウンロードループを、直接アップロードの経路に置き換えるものです。サプライヤーはトレーニングも資格情報もソフトウェアも必要ありません。必要なのはリンクと確認コードだけです。それ以外は同じ抽出パイプラインです。「サプライヤーが送信」から「データがシートに反映される」までのステップが1つ減るだけです。
本パイプラインで置き換わるもの、置き換わらないもの
パイプラインとは、「この一連のステップがこの出力を生み出す」という具体的な主張です。ここで説明するパイプラインが何を置き換え、何を補完し、そもそも何を目的としていないのかを正確に理解することが重要です。
置き換わるもの:
- 発注書や請求書からの手動データ入力。 抽出レイヤーが非構造化文書を構造化された行に変換します。発注明細や請求書項目を追跡シートに手入力する作業が不要になります。
- 仕入先ごとのOCRテンプレート管理。 列名抽出機能があらゆる文書レイアウトを読み取るため、事前設定テンプレートは不要です。新規仕入先はコレクションリンクを送るだけで登録完了。テンプレート作成は必要ありません。
- 3部門にわたる調査ループ。 発注データ、受入データ、請求書データが1つの構造化ダッシュボードに集約されれば、「請求書は発注書と一致するか?」という問いは、条件付き書式のセルを見るだけで解決します。購買部門や入荷 dock に電話する必要はありません。
- 書類不足による死角。 ダッシュボードのVLOOKUP構造は、ギャップを即座に露呈します。発注VLOOKUPで#N/Aが出れば、請求書が有効な発注書を参照していないことを意味します。受入数量が空白なら、入庫が未登録です。これらは月次監査で発見されるものではなく、すべての行でリアルタイムに可視化されます。
置き換わらないもの:
- ERPシステム(必要な組織向け)。 月間2,000~3,000件の請求書を処理する場合、スプレッドシートベースの照合ダッシュボードは実用限界に達します。例外処理のボリュームが手動レビューを圧倒します。この規模では、自動照合、統合監査証跡、職務分掌の強制といったERPの価値が必須となります。本パイプラインはERPに構造化データを供給しますが、統制環境としてのERPを置き換えるものではありません。
- 例外に対する人間の判断。 ダッシュボードは差異をフラグ付けしますが、解決はしません。請求単価と発注単価の47.50ドルの差は、購買チームが交渉したが買掛金部門に伝えていなかった正当な追加料金かもしれませんし、エラーかもしれません。AIにはどちらか判断できず、判断を委ねるべきでもありません。フラグは人間によるレビューをトリガーします。そのレビューには、AIが持たないビジネスコンテキストが必要です。
- 入庫プロセスそのもの。 入庫が作成されていない場合、つまり dock で到着品が記録されていない場合、パイプラインは受入タブでそのギャップを明らかにしますが、データを生成することはできません。受入レイヤーにはプロセス規律が必要です。誰かが納品されたものを確認し記録しなければなりません。パイプラインはそのデータを構造化しますが、無から作り出すことはしません。
- 仕入先による請求書への発注番号記載の遵守。 パイプラインは発注番号の欠落を可視化しますが、仕入先に番号を記載させることはできません。それには、技術的解決策ではなく、購買ポリシーとその執行が必要です。
よくある質問
このパイプラインは月に何件の請求書を処理できますか?
構造上の限界は抽出エンジンではなく、マッチングダッシュボードの手動レビュー容量にあります。適切に構築されたマッチングダッシュボードを使用すれば、1人のAP担当者が差異の確認と処理を快適に行えるのは、月に約300~500件の請求書が目安です(例外率22%の場合、調査対象は66~110件)。月1,000件を超えると、例外処理のボリュームが増大するため、複数のAP担当者を配置するか、自動マッチングルールを持つERPへの移行が必要になります。高ボリュームでは、このパイプラインの価値は「主要なマッチングツール」から「構造化データをERPに供給するデータ取り込みエンジン」へと移行します。抽出レイヤーは引き続き機能し、ダッシュボードは最終的なマッチング環境ではなく、ERPへの事前検証ステップとなります。
POが毎月変動する包括価格を使用している場合、パイプラインは変動価格に対応できますか?
はい。ただし、POレジスターを一度限りの抽出ではなく、生きた文書として維持する必要があります。商品市況に連動して毎月価格が調整される包括POの場合、その仕入先のPOレジスター行を毎月、その時点の有効価格で更新する必要があります。マッチングダッシュボードのVLOOKUPは更新された価格を反映します。監査証跡を残すもう一つの方法は、POレジスターに「有効日」列を追加し、日付範囲マッチングでVLOOKUPを使用することです。現在の価格ではなく、請求書日付時点で有効だったPO価格を取得します。設定は複雑ですが、出荷時に合意された価格を正確に反映するため、三者照合の本来の検証目的に適っています。
手書きの納品書や受領書でも抽出は機能しますか?
はい。AIは手書き文字を読み取ります。ドックでサインされた納品書に典型的な数字や記述も含みます。ただし、手書き文書の精度は印刷文書より低く、劣化の激しい文書(かすれた感熱印刷、薄い文字のカーボンコピー、しわくちゃで伸ばした納品書)では抽出エラーが増加します。受領データについては、以下をお勧めします。(a) 可能であれば、受領担当者がドックで主要項目(PO番号、品目、数量、日付)を直接Googleスプレッドシートに入力する。受領時点での手入力は、後日劣化文書から抽出するより速く正確です。(b) 納品書からの抽出が唯一の方法である場合、特に高額な出荷については、抽出行のサンプルを元の文書と照合してください。(c) 納品書の写真を受領行と一緒に添付ファイルとして保存する。抽出で数字を逃しても、元の文書をワンクリックで確認できます。
このパイプラインをGoogle Sheetsアドオンなしで、Webアプリだけで使用できますか?
はい、可能です。抽出エンジンは、Sheets内のサイドバーアドオンからアクセスする場合も、ImageToTable.aiのWebアプリケーションからアクセスする場合も同じです。アドオンの利点は、抽出結果がアクティブなシートに直接書き込まれることです。ダウンロードして再アップロードする手間がありません。Webアプリでは、ブラウザでドキュメントをアップロードし、抽出されたExcelファイルをダウンロードして、行をマッチングダッシュボードに貼り付けるかインポートします。列定義は同じです。抽出品質も同一です。アドオンは1つのステップ(ダウンロードとインポート)を省きます。WebアプリはGoogle Sheetsだけでなく、あらゆるスプレッドシートツールで動作します。その1つのステップがお客様の処理量にとって重要かどうかで選択してください。
フルパイプライン(POレジスタ、入庫レジスタ、請求書レジスタ、マッチングダッシュボード)のセットアップ時間はどのくらいですか?
Google SheetsでのVLOOKUPと条件付き書式に慣れている方であれば、4タブのフルパイプラインの構築にはおよそ2時間かかります。上記の列構造を持つ4つのタブの設計と作成に30分、マッチングダッシュボードでのVLOOKUPとIF数式の作成とテストに45分、条件付き書式とサマリーメトリクスの設定に30分、アドオンサイドバーでの抽出列セットの定義に15分です。列定義はシートに保存され、セッションをまたいで保持されます。一度定義すれば、サイドバーを開いてそのシートを選択するたびに利用できます。初期セットアップ後、毎月のワークフローは次のとおりです:(1)新しいPOをPOレジスタに抽出する、(2)入庫データを入力または抽出する、(3)仕入先請求書を抽出する、(4)マッチングダッシュボードを開いてフラグが付いた行を確認する。最初の月はセットアップとデータ投入のため最も時間がかかります。3か月目には日常的な作業になります。対応フィールドタイプ、形式、プラン詳細などの完全な機能一覧については、Google Sheetsドキュメント抽出アドオンをご覧ください。
POと仕入先請求書の通貨の違いにはどう対応すればよいですか?
抽出エンジンは、文書に表示されている数値と通貨記号をそのまま取得します。通貨換算は行いません。POがUSDで、仕入先請求書がEURの場合、換算後の値が正しくても数値が一致しないため、マッチングダッシュボードには差異が表示されます。この問題を解決するには、PO台帳と請求書台帳の両方に「通貨」列を追加し、手動または数式で管理される為替レートを参照する「換算レート」列を追加します。これにより、マッチング時の価格比較は、抽出された生の金額ではなく換算後の金額を使用します。パイプラインの役割は抽出です。通貨換算はスプレッドシート側の操作です。
まとめ
ここで説明したスリーウェイマッチングのパイプラインは、ERPが必要な組織にとってERPの代替となるものではありません。これは、すでにスプレッドシートで購買業務を運用しているチームのための仕組みです。ERPの請求書取り込みに維持できないテンプレート管理が必要な場合、サプライヤー基盤がマッチングモジュールで処理できない形式にまたがっている場合、または取引量が「手動マッチングには複雑すぎる」と「ERPアップグレードを正当化できるほど大きい」の間にある場合です。そのようなチームにとって、問題は「マッチングを自動化すべきか」ではありません。「3つの文書すべてを、マッチングが3部門の調査ではなく数式の作業になるほど迅速に同じ構造化形式に変換できるか」です。
このパイプラインは、3つの抽出レイヤーと1つのダッシュボードでその問いに答えます。POレイヤーは基準となるベースラインを提供します。入庫レイヤーは到着したものを確認します。請求書レイヤーは請求されたものを取得します。マッチングダッシュボードは、VLOOKUP、IFステートメント、条件付き書式を使用してそれらを比較し、人間の注意が必要なすべての行にフラグを立てます。位置ではなく意味で文書を読み取るAIを搭載した抽出エンジンは、複数サプライヤーの購買業務でテンプレートベースのアプローチを持続不可能にする形式の多様性を処理します。Collection Linkは、文書取り込みプロセスからメール添付ファイルのダウンロードループを排除します。
私たちの問題分析で特定された構造的なギャップ(3つの部門、3つのシステム、データパイプラインの単一の所有者がいない)は消えません。しかし、3種類すべての文書が同じ構造化形式で同じスプレッドシートに、同じPO番号を共通キーとして届けば、マッチングのステップはもはや部門間の調査を必要としません。組織的なギャップは残ります。データはもはや3つの異なる入力チャネルの累積的なずれを抱えていません。それが、マッチングを人員問題ではなくスプレッドシートの作業にする理由です。
PO抽出レイヤーから始めましょう。以下のデモで購買発注書をアップロードしてください。マッチングワークフローに重要なフィールド(PO番号、仕入先、明細行、数量、価格)が、手入力の数分ではなく数秒で構造化されて返されるかどうかを確認してください。最初のレイヤーが機能すれば、パイプラインの残りは同じエンジンで構築されています。