人事契約管理抽出とは?
従業員オンボーディングデータ自動化
人事契約管理抽出とは、署名済みの雇用契約書およびオファーレターから、開始日、役職、給与、ボーナス体系、試用期間、福利厚生受給資格、競業避止条項の範囲、通知期間、ビザステータスなどの従業員固有のデータ項目を自動的に読み取り、HRIS入力、給与設定、オンボーディングワークフローのトリガーに利用できる構造化された行として出力するプロセスです。署名済みのPDFがWorkday、BambooHR、SAP SuccessFactorsのデータになる必要がある地点に位置し、人事担当者が各文書を開いて同じ項目を一つずつ手入力する手作業を置き換えます。
HR契約管理データ抽出の本質
HR契約管理と一般的な契約管理は、一見同じ活動のように聞こえます。文書レベルでは確かに同じです。どちらも契約、期限、義務を追跡します。しかし、類似点はフォルダ構造で終わります。法務や調達チームが運用する一般的な契約管理は、取引先名、契約額、更新期間、準拠法、補償上限などの商業条件を追跡します。その目的は、ベンダー契約、MSA、パートナーシップ契約のポートフォリオ全体のリスク管理です。
HR契約管理が追跡するのは、根本的に異なるもの、すなわち雇用ライフサイクルデータです。雇用契約は、ベンダーMSAのような商業契約とは異なります。給与計算が開始される開始日、最初の給与明細を決定する給与帯や賞与目標、厳格なレビュー期限を生み出す試用期間(90日の試用期間を逃すと、業績不良の従業員が自動的に正社員になる管轄区もあります)、退職するエンジニアが来月競合他社に入社できるか、1年間待機しなければならないかを決定する競業避止義務の範囲、そしてHRが従業員の辞表が届く前に把握すべき予告期間(12週間の予告期間が必要なシニアディレクターと、2週間のアソシエイトでは、移行のタイムラインが大きく異なります)などが含まれます。
抽出という側面、つまりこれを単なる文書問題ではなくデータ問題にするのは、これらのフィールドのすべてが署名済みPDFの中に存在するという点です。ページ上には存在しますが、どのシステムにもありません。一般的な機能としての契約データ抽出は、あらゆる契約タイプでこの問題を解決します。HR契約管理データ抽出は、雇用フィールドに特化したアプリケーションです。カラムヘッダーは「従業員名」「開始日」「試用期間終了日」であり、「当事者A」「発効日」「終了条項」ではありません。
この違いが重要なのは、下流での用途が異なるからです。法務チームは準拠法条項を抽出してポートフォリオ全体の訴訟リスクを評価します。HRは開始日を抽出して、従業員が初日から給与を受け取れるようにします。どちらも抽出です。しかし、一方はリスク台帳に、もう一方は給与システムにデータを供給します。フィールドスキーマ、精度要件、出力形式が十分に異なるため、法務用の抽出ツールをHR業務に設定すると、削減される手間よりも増える手間の方が多くなります。
人事契約抽出と法務契約抽出の違い:同じテクノロジーが異なる問いに応える理由
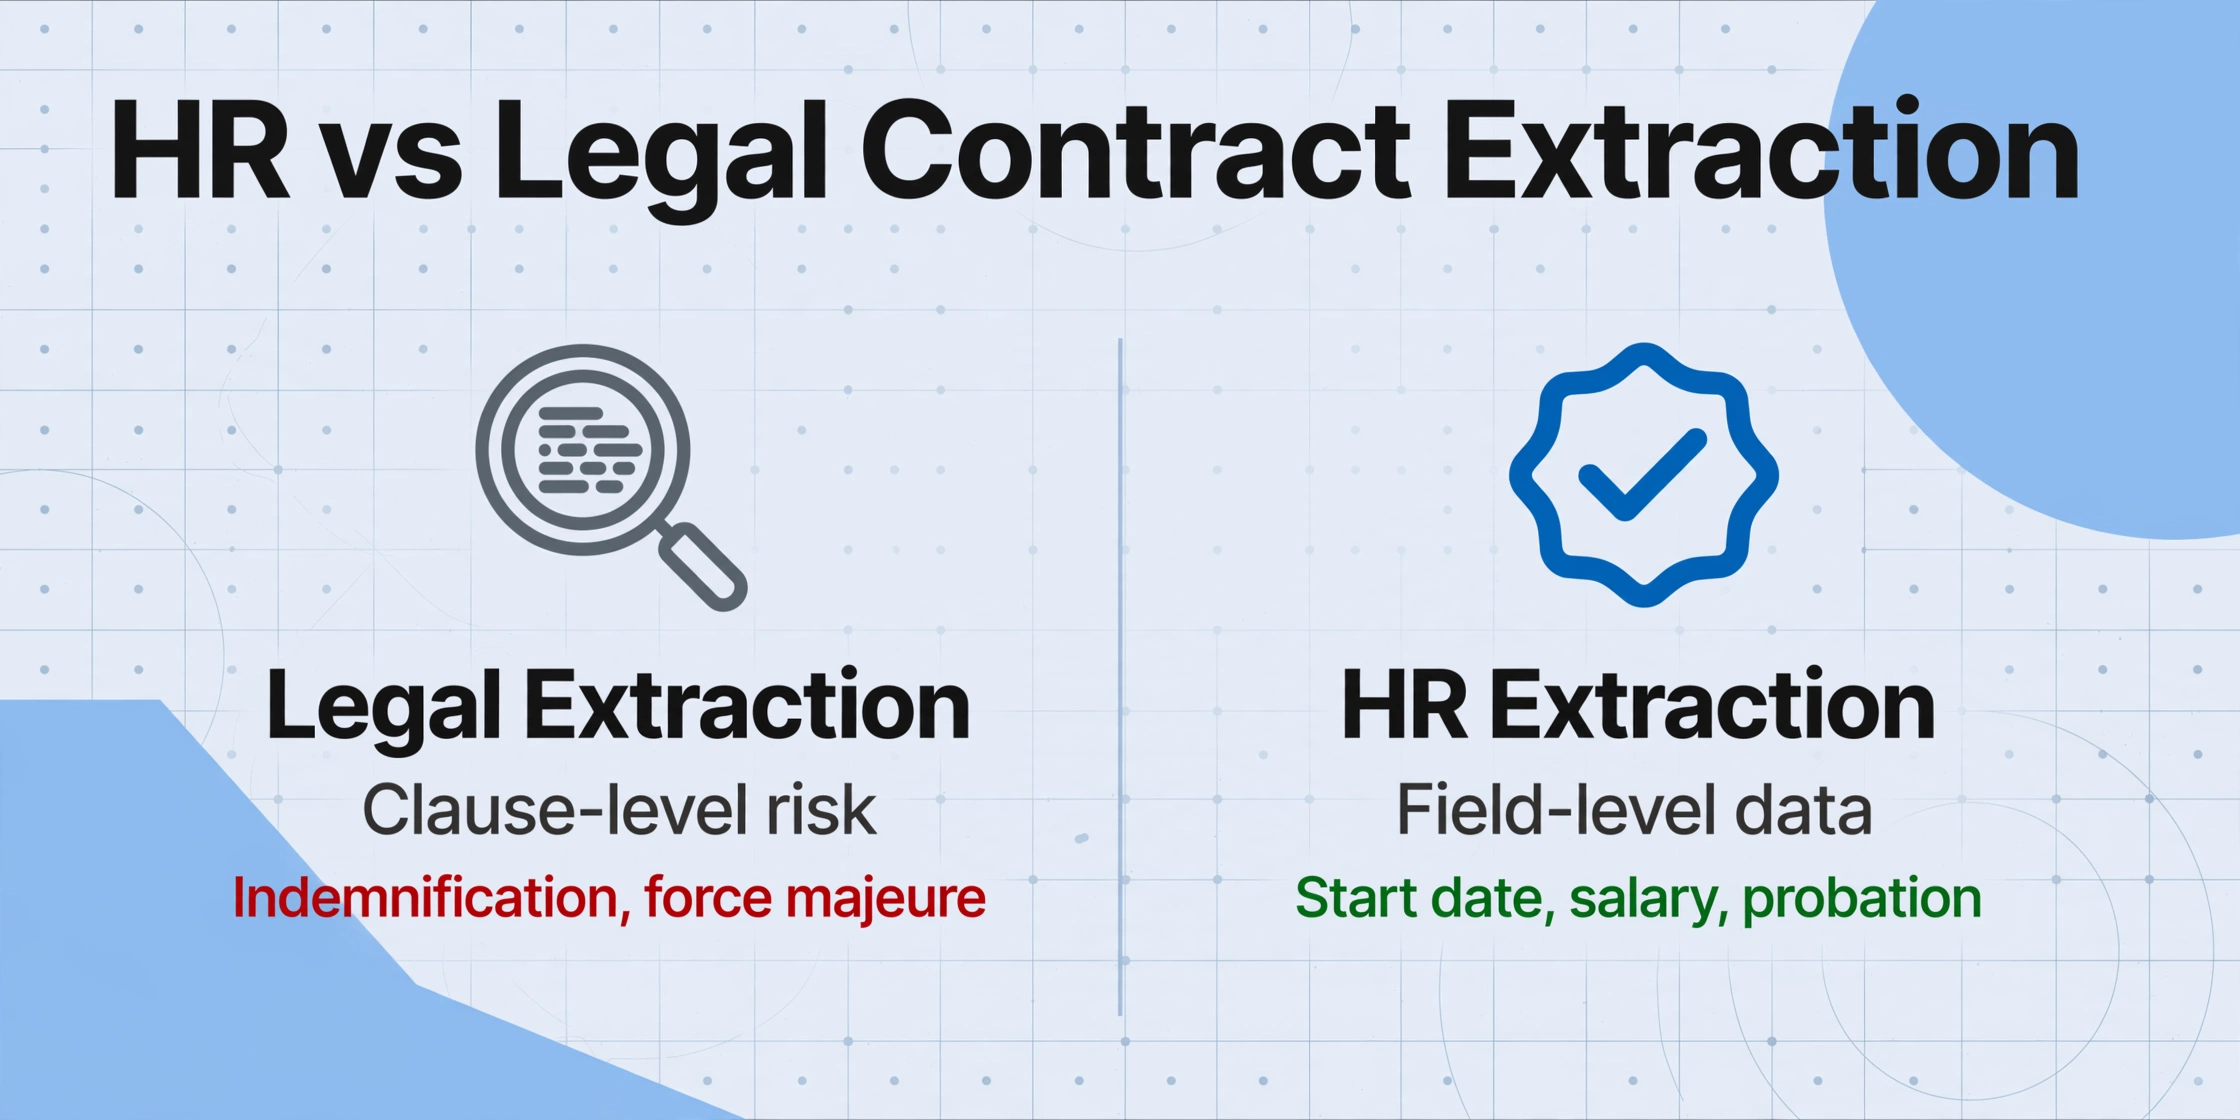
人事チームも法務チームも、契約書からデータを抽出します。どちらも同じセマンティックAIテクノロジーを利用できます。しかし、抽出するフィールドと、そのフィールドが答える問いは大きく異なるため、両者を「同じもの」と比較すると、それぞれが実際に必要としているものが曖昧になってしまいます。
法務契約抽出は条項レベルで機能します。買収対象企業の契約ポートフォリオをレビューする法務チームは、次のことを把握する必要があります。上限のない補償条項を含む契約はどれか。買収時に自動終了を引き起こす経営権変更条項が含まれる契約はどれか。最も重要なベンダー契約50件の準拠法は何か。これらはリスク評価に関する問いです。抽出対象は、複数段落にわたる複雑な法的条項(補償、責任制限、不可抗力、譲渡、秘密保持)であり、その境界は契約ごとに異なり、解釈が必要な文言が含まれます。法務契約抽出はポートフォリオレベルのリスクに関する問いに答え、その出力は通常、CLMデータベースやデューデリジェンスレポートに取り込まれます。
人事契約抽出はフィールドレベルで機能します。採用活動後に30件の新入社員契約を処理する人事チームは、次のことを把握する必要があります。オリエンテーションをスケジュールするための各従業員の開始日はいつか。給与計算を設定するための給与はいくらか。レビュー面談をスケジュールするための試用期間の終了日はいつか。健康保険プランに従業員を登録するための福利厚生受給資格日はいつか。これらは運用上のデータ入力に関する問いです。抽出対象は、$85,000、「2026-08-15」、「開始日から3ヶ月」といった短い個別の値であり、HRIS内のフィールドに直接マッピングされます。出力はリスクレジスターではなく、WorkdayへのCSVインポートに取り込まれます。
| 観点 | 人事契約抽出 | 法務契約抽出 |
|---|---|---|
| 主要フィールド | 従業員名、開始日、給与、試用期間、福利厚生、競業避止条項、通知期間 | 準拠法、補償範囲、賠償責任の上限、不可抗力、契約譲渡、契約終了 |
| 出力形式 | 従業員ごとの行、HRIS(人事情報システム)フィールドの列 → CSVインポート | 契約ごとの行、条項をタグ付きテキストとして → CLM/デューデリジェンスレポート |
| 回答する質問 | 「人事システムにはどのようなデータが入るのか?」 | 「契約ポートフォリオにはどのようなリスクが存在するのか?」 |
| 下流の利用者 | HRIS(人事情報システム)、給与計算、福利厚生管理、オンボーディングワークフロー | 法務チーム、コンプライアンス、M&Aデューデリジェンス、CLMリポジトリ |
| 成功指標 | 最初の給与サイクルでフィールドが正しいこと | レビュー中に重大なリスクを見逃さないこと |
どちらも有効であり、両方を必要とする組織もあります。しかし、法務契約抽出ツールを購入してHRIS(人事情報システム)を効率的に埋めることを期待したり、人事契約抽出ツールを購入して上限のない補償条項を特定することを期待したりすることは、設計された用途とは異なるユースケースのためにツールを設定することになります。技術は重複していますが、フィールドスキーマと出力形式は異なります。
人事契約管理抽出の仕組み
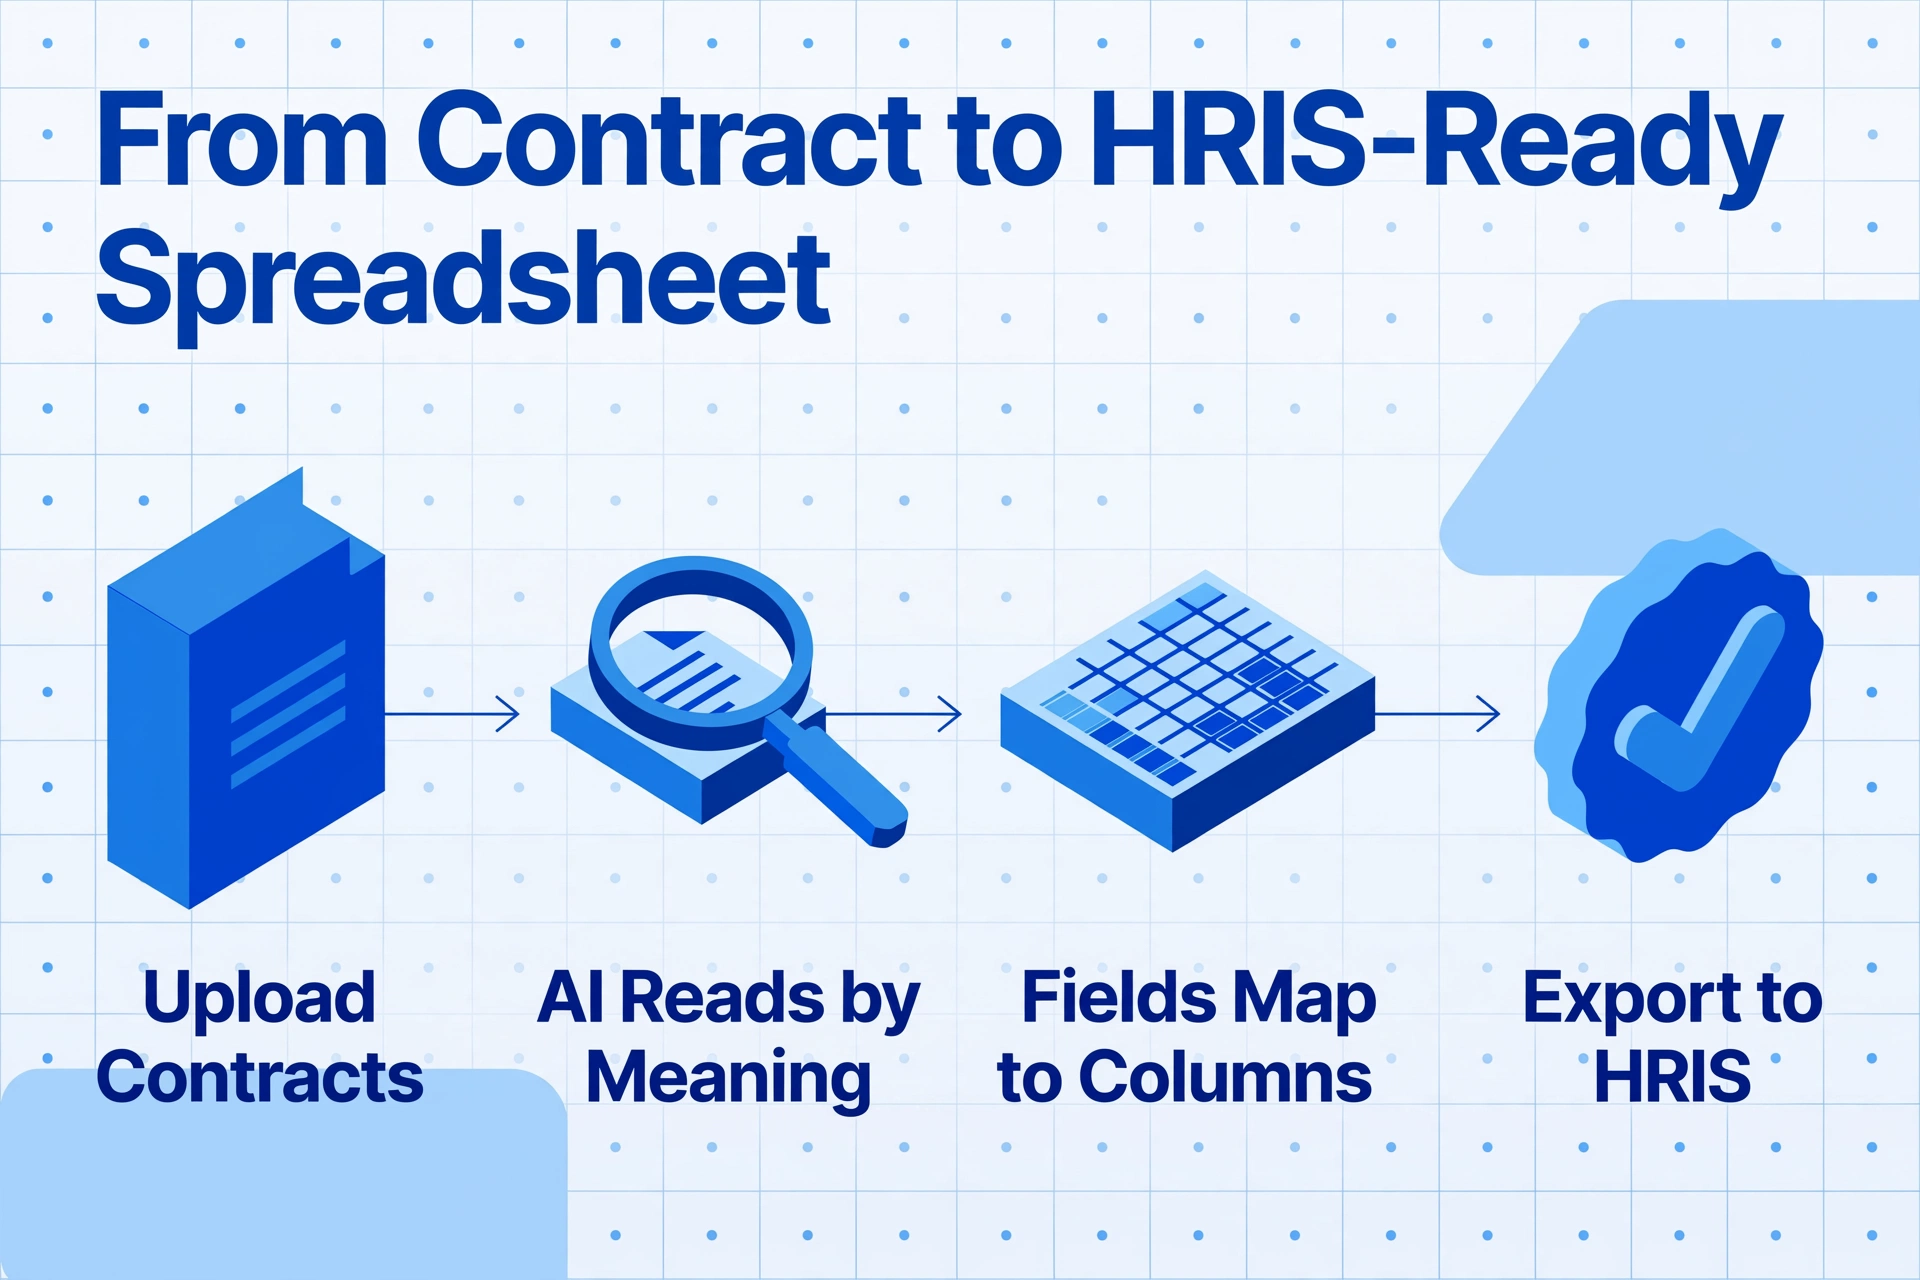
インターフェースはシンプルです。文書をアップロードし、必要なフィールドを指定し、スプレッドシートを受け取ります。しかし、その背後にある仕組みによって、組織が実際に使用している雇用契約書の形式全体で抽出が一貫して機能するかどうかが決まります。
テンプレートベースの抽出(旧来のツールや多くのCLMプラットフォームで採用されている手法)では、各フィールドがページ上のどこに位置するかを定義する必要があります。「開始日は1ページ目のヘッダー下、『本契約』の3行後」といった具合です。問題は、法務部門が標準文言を更新すると、自社のオファーレターのテンプレートが変わってしまうことです。報酬セクションに新しい段落が追加されると、「給与」が14行目から19行目に移動し、テンプレートは黙って誤った数値を抽出します。これが部門、職位レベル、国ごとに異なる雇用契約書の形式で増幅されると、テンプレートのメンテナンスが解決策ではなくボトルネックになります。
セマンティック抽出(最新のAIツールで採用されている手法)は、位置ではなく意味に基づいて機能します。システムにフィールドがページのどこにあるかを指定するのではなく、何を抽出したいかを指定します。これがカスタム列抽出です。HRISのフィールドに合わせた列名(「従業員名」「役職」「開始日」「給与」「試用期間」「通知期間」「福利厚生ティア」「競業避止範囲」など)を入力すると、AIがすべての契約書の全ページを読み取り、文脈における意味を理解して各値を特定し、正しい出力列にマッピングします。出力を定義するのはあなたです。入力を読み取るのはAIです。同じ手法が、2ページのオファーレターから15ページの役員雇用契約書(付属書付き)まで、給与を「Compensation」と表記するオファーレターと「Remuneration」と表記するオファーレターの両方、そして「90暦日」または「開始日から3か月」と記載された試用期間にも対応します。
雇用契約書をアップロード
署名済みのオファーレター、雇用契約書、修正契約書のPDFを、単体または一括でドロップしてください。1件でも採用ラッシュ時の30件でも、プロセスは同じです。AIはテキストレイヤーを解析するのではなく、文書を視覚的に読み取るため、スキャンした直筆署名入りPDFもデジタル版も同じように処理されます。
HRISフィールドを定義
「従業員名」「開始日」「役職」「年俸」「試用期間」「通知期間」「福利厚生受給開始日」「競業避止範囲」など、ご利用のシステムに合わせた列名を入力します。これらが出力スプレッドシートのヘッダーになります。同じフィールド名がすべての契約書フォーマットで機能します。テンプレート設定も、領域指定も、トレーニングも不要です。
AIが意味的役割に基づいて値をマッピング
ビジョンモデルがすべての契約書の全ページを読み取ります。ある契約書の1ページ目にある開始日も、別の契約書の8ページ目の別紙内にある開始日も、同じ「開始日」列に格納されます。基本給と入社時ボーナス、目標ボーナスを区別し、それぞれを正しいフィールドにマッピングします。試用期間の記載が「3ヶ月」でも「90暦日」でも読み取り、両方を同じ日付ベースの出力に正規化します。
エクスポートまたは人事システムへ読み込み
Excel、CSV、JSONでダウンロードするか、Google Sheetsに直接書き込めます。各従業員が1行になり、各フィールドがそれぞれの列に入ります。出力はHRISのインポート形式に直接対応します。30人の採用で従業員1人あたり12フィールドを入力する代わりに、1つのファイルをアップロードするだけです。雇用契約書からExcelへの変換ツールが、このワークフローを最初から最後まで実行します。
ファイルは安全に処理され、保存されることはありません。
人事チームが契約書抽出を必要とするケース
すべての人事部門が自動抽出を必要とするわけではありません。月に3人を採用するチームであれば、40数項目のフィールドを1時間以内にHRIS(人事情報システム)へ手入力できます。抽出が価値を持つのは、手入力が小さな雑務ではなくなり、勤務日全体を消費したり、コンプライアンス上のリスクを生み出したりする、件数と時間的プレッシャーの閾値に達したときです。ここでは、最も一般的な3つの引き金となる状況を紹介します。
1. 一括採用と季節変動のあるオンボーディング。 ホリデーシーズン前に季節従業員80名を採用する小売業者。新規クリニック開設のために看護師40名をオンボーディングする医療提供者。資金調達ラウンド後に30名のエンジニアチームを増強するテック企業。新規採用者ごとに署名済みの雇用契約書が発生し、そのデータは給与、福利厚生、ITアクセス権限付与に届ける必要があり、多くの場合、厳格なコンプライアンス期間内に処理しなければなりません。I-9確認は、連邦法により開始日から3営業日以内に完了する必要があります。同じ週に30件の契約書が届き、それぞれに12項目のフィールドを手入力する必要がある場合、データ入力だけで3〜4営業日を消費します。そして、コンプライアンスの時計は初日から刻々と進んでいます。抽出により、これは単一のアップロードサイクルに短縮されます。その規模の採用波では、オファーレターと契約書のバッチワークフローのバージョンを最初に読む価値があります。
2. 連鎖的な日付を生み出す契約ライフサイクルイベント。 雇用契約書は一度きりのデータ入力イベントではありません。その開始日は給与設定を引き起こします。試用期間は、誰かがスケジュールしなければならないレビュー期限を生み出します。福利厚生受給資格日は、健康保険の適用がいつ始まるかを決定します。終了日(有期契約の場合)は、更新対応が必要な時期を決定します。通知期間は、辞職が届いたときの移行タイムラインを定義します。20件の契約書が別々のPDFに散在している場合、手動での追跡は、各日付が個別の検索作業になります。抽出により、すべての日付がスプレッドシートの列になります。フィルタリング、ソート、監査が、単一のドキュメントを開くことなく可能になります。この問題の追跡側 — HRISとCLMツールの両方が雇用契約のタイムラインを見逃す理由 — については、人事チームが今も契約満了日をスプレッドシートで追跡する理由を参照してください。
3. コンプライアンス監査の準備。 年次人事監査、または買収前のデューデリジェンスでは、次のような質問への回答が必要になります。競業避止条項を含む雇用契約書はどれか、その地理的範囲はどこか。カリフォルニア州AB5法に基づく分類に影響を与える可能性のある排他条項を伴う請負業者契約はどれか。今後90日以内に満了する有期契約はどれか。これらの質問には回答がありますが、その回答は個々のPDFの中に存在し、ダッシュボードにはありません。抽出によりデータが表面化され、人事部門は監査の質問に、ドキュメントを1件ずつレビューする数日ではなく、数分で回答できるようになります。
HR契約書抽出ツールに求めるべきポイント
抽出ツールは、HRワークフロー向けに設計されているか、汎用的な契約書プラットフォームを流用しているかで大きく異なります。以下は、問題を解決するツールと、テンプレート管理の手間を増やすだけのツールを見分ける基準です。
テンプレート不要、ゼロセットアップでの抽出。 サンプル契約書に領域を定義させたり、10件の雇用契約書サンプルでモデルを学習させる必要がある抽出ツールは、作業を減らすどころか、単に手作業の種類を変えているにすぎません。雇用契約書の形式は、雇用主、職位、地域、更新サイクルによって異なります。テンプレート不要のツールは、各項目の意味を意味的に理解することで文書を読み取り、前回出現した位置を記憶するわけではありません。初回使用前にセットアップが必要なツールは、来四半期にオファーレターのテンプレートが変われば、再セットアップが必要になります。
法律条項抽出ではなく、雇用項目を認識する抽出。 多くの抽出プラットフォームは法務部門向けに構築され、「補償」や「責任制限」の抽出に最適化されています。HRに必要なのは、雇用固有の違いを認識できるツールです。つまり、開始日と署名日の違い、基本給と賞与を含む総報酬額の違い、月単位と暦日単位の試用期間の違い、競業避止義務と秘密保持義務の違いです。汎用的なNDAやMSAではなく、実際の雇用契約書でツールをテストしてください。
報酬体系の解析。 一部の雇用契約書は、基本給、賞与目標、株式報酬、入社祝い金を一つの「総報酬」段落にまとめています。別の契約書では、これらを個別のセクションに分け、表形式で記載することもあります。「$150,000」を「給与」として抽出できても、隣接する3行の賞与体系(四半期目標、年間上限、業績倍率)を見逃すツールでは、不完全な報酬情報しか得られません。単純な給与明細だけでなく、構造化された報酬表を含む契約書でテストしてください。
一括処理と統一出力。 30件の雇用契約書からは、1つのスプレッドシート(30行、従業員1人につき1行)が生成されるべきであり、手動でマージしなければならない30件の個別抽出ジョブが生成されるべきではありません。バッチ処理を前提とした設計では、出力は1つのテーブルとなり、開始日で並べ替え、部門でフィルタリングし、即座に完全性を確認できます。ファイルを1件ずつ処理するツールでは、マージ工程が排除されておらず、そのマージ工程こそが手動エラーが再び混入するポイントです。
よくある質問
HR契約管理抽出はオファーレターにも対応していますか、それとも正式な雇用契約書のみですか?
両方に対応しています。オファーレターは通常2〜3ページと短く、項目が明確にラベル付けされているため、高い精度で抽出できます。正式な雇用契約書は5〜15ページ以上と長く、給与、福利厚生、試用期間、通知期間などの条件が別紙やスケジュールに埋もれている場合があります。優れた抽出ツールは、異なる設定を必要とせずに両方に対応します。主な違いは、長い契約書にはより多くのデータがより多くのページに分散しているため、抽出に少し時間がかかりますが、従業員ごとの項目数も増える可能性があることです。
抽出ツールは基本給、入社時ボーナス、株式報酬を区別できますか?
一般的には、文書内でこれらが明確にラベル付けされたセクションに分かれていれば可能です。ほとんどの雇用契約書では、「基本給」「入社時ボーナス」「株式付与」にそれぞれ異なる見出しが使用されており、セマンティック抽出ツールはこれらを別々の出力列にマッピングできます。難しいケースは、報酬が合計額として提示されている場合です(例:「従業員には総報酬$180,000を支給する。内訳は基本給$140,000、業績ボーナス最大$40,000」)。この場合もAIは構成要素を解析できますが、精度は文言が金額をどの程度明確に分離しているかに依存します。各報酬構成要素に個別の列を定義することをベストプラクティスとして行うと、AIが何を探すべきかを把握しやすくなります。
抽出はスキャン済みまたは手書き署名付きのPDFにも対応していますか、それともデジタル文書のみですか?
ビジョンベースの抽出ツールは、埋め込まれたテキストレイヤーではなく、ページの視覚的な外観を読み取ります。プリンターでスキャンした契約書、インクで手書き署名されたPDF、DocuSignで処理された添付ファイルは、すべて同じ方法で読み取られます。制限要因は画像品質です。スキャンが非常に薄い、傾いている、または低解像度で人間が読むのも困難な場合、AIも同様に困難になります。最新の雇用契約書は、署名済みのコピーであっても、信頼性高く抽出できるほど鮮明であることがほとんどです。
HR契約管理抽出は、一般的な契約データ抽出とどう違いますか?
一般的な契約抽出は、取引先名、発効日、契約金額、準拠法、解約条件などの商業・法的項目を対象としています。HR契約管理抽出は、従業員名、役職、開始日、給与、試用期間、福利厚生受給資格、競業避止条項の範囲、通知期間など、雇用固有の項目を対象としています。基盤となる技術は同じ(文書を読み取るセマンティックAI)ですが、フィールドスキーマと出力形式は異なる下流システム向けに調整されています。一般的な抽出スプレッドシートには「当事者A」や「発効日」などの列が含まれます。HR抽出スプレッドシートには「従業員名」「開始日」「試用期間終了日」などが含まれます。一般的な機能の技術的な全体像については、契約データ抽出とはをご覧ください。
請負契約のHRデータ抽出は、労働者分類のコンプライアンス対応に使えますか?
はい。ただし、抽出はデータを出力するものであり、法的判断を下すものではない点をご理解ください。分類に関連する項目(排他性の文言、備品提供、報酬体系(時給か案件単位か)、指揮命令の有無、契約期間など)を抽出できます。体系的な抽出により、「請負契約に誤分類のリスクはないか」という定性監査の課題を、リスク指標ごとに確認できるフィルタリング可能なスプレッドシートに変換できます。法的な分類判断は人事・法務部門に委ねられますが、抽出によって、数件を超える契約の体系的なレビューを妨げていた「読んで探す」というボトルネックが解消されます。
雇用契約書50件のバッチ抽出にはどのくらい時間がかかりますか?
最新のバッチ処理ツールは1件あたり数秒で処理します。50件の契約書なら通常5~10分で完了し、1つの統合スプレッドシートが出力されます。比較として、経験豊富な人事担当者が複数ページの雇用契約書1件から12項目を手動で抽出するには5~7分かかります。50件をそのペースで処理すると4~6時間の連続入力となり、1時間を過ぎると疲労の蓄積により正確性が著しく低下します。時間比較の本質は速度ではなく、その4~6時間を福利厚生の選択確認、従業員からの質問対応、次のオンボーディング準備などに充てられるという点にあります。
契約書抽出を機能させるにはHRISとの連携が必要ですか?
いいえ。抽出データはExcelまたはCSVとしてダウンロードでき、Workday、BambooHR、ADP、SAP SuccessFactors、Ripplingなど、従業員データの一括インポートに対応しているほとんどのHRISに取り込めます。抽出結果は構造化ファイルで、従業員ごとに1行、HRISフィールドごとに1列で構成され、アップロード可能な状態になっています。API連携があれば手動アップロードの手間が省けますが、抽出の価値を得るために必須ではありません。最小限のワークフローは「抽出→ダウンロード→インポート」であり、システム連携なしでも今日から利用できます。
次のステップ
人事契約管理抽出は、具体的で測定可能な問題を解決します。それは、デスクトップ上の署名済みPDFとHRIS(人事情報システム)内のデータベースレコードとの間のギャップです。開始日、給与、試用期間終了日、通知期間、福利厚生受給資格など、すべてのフィールドはすでにページ上に存在しています。問題は、システムが処理できる形式になっていないことです。このギャップを埋める手動の再入力は、判断を要する作業ではありません。これは、ソフトウェアが何年も前から実行できたデータ転送作業であり、現在利用可能なセマンティックAIモデルにより、以前の試みを非現実的にしていたテンプレート設定なしで実現できます。
チームが四半期ごとに数十件以上の雇用契約書を扱い、「来週入社する新入社員のコホートはどのグループか」「今月の試用期間レビューはどれか」「Q4までに更新が必要な有期契約はどれか」といった質問に定期的に答える必要がある場合、抽出によってこれらの質問は文書ごとの検索から、並べ替え可能なスプレッドシートの列へと変わります。雇用契約書のフィールドを人事スプレッドシートに抽出するステップバイステップのワークフローを確認して、署名済みPDFからHRIS対応テーブルまでの正確な手順を理解してください。または、雇用契約書をアップロードして抽出を実際に確認し、ご自身の文書でテストすることもできます。