請求書データをExcelに入力するのに4時間費やした。
それからこれを試した。
4時間の請求書データ入力が実際にどんなものかをお伝えします。生産性ブログの話ではなく、物理的な感覚としてです。37種類の異なるPDFレイアウトをスキャンして、それぞれが「請求書番号」を別の隅に配置しているのを見続けたあなたの目は、乾いて疲れています。何も新しいものを生み出さなかった6,000回のキーストロークを経たあなたの指。サプライヤーDが「Ref.」とラベル付けしたものが、サプライヤーGの「Document No.」と同じフィールドかどうかを23回目に判断したあなたの脳。
重要なポイント
- 財務プロフェッショナルの56%が反復的なデータ業務で燃え尽きています。タイピングそのものではなく、「Ref.」が「Invoice No.」と同じ意味かどうかを解釈するという静かな認知的消耗が原因です。
- 「コピー&ペースト」という言葉は、フィールドごとに6つの別々の精神的作業を隠しており、20件目の請求書までにエラー率は気づかないうちに40%上昇しています。
- タイピングをやめて抽出されたデータのレビューを始めると、あなたは人間のベルトコンベアではなく品質検査官になります。それが、あなたの脳が実際に雇われた役割です。
請求書データを4時間タイピングし続ける感覚とは
この作業が実際にどんなものか、正直に話しましょう。あなたは何かを生み出しているわけでも、分析しているわけでもありません。あなたは人間のベルトコンベアです。画面上のある四角から数字を拾い、別の四角に落とし込む。請求書番号。日付。ベンダー名。小計。税。合計。品目。品目。品目。次の請求書。繰り返し。何時間も。
ある小規模事業者がRedditで、この作業を経験した人なら誰でもすぐにわかる、あきらめにも似た疲労感を込めてこう語っています:「管理者が文字通り品目(価格、数量、SKU)を巨大なExcelシートに手動で入力している。毎週金曜日に4時間かかるんだ」(r/smallbusiness) 毎週金曜日に4時間。年間200時間、つまり丸5週間分の労働時間を、ある画面から数字を読んで別の画面に打ち込むだけの作業に費やしているのです。
身体への負担は現実的で、蓄積されていきます。この種の作業を少しでも長く続けたことがある人なら、その兆候をご存じでしょう:2時間目あたりから始まり、眠るまで消えない手首の痛み。30枚目あたりで目が焦点を失い、同じ欄を2回、3回と読み直してしまう感覚。複雑だからではなく、視覚システムが限界に達しているからです。フォントも間隔も、同じ情報の配置も異なる書類の間で絶えず微調整を続けることからくる頭痛。
ただ疲れるだけではありません。消耗するのです。この二つには違いがあります。疲れとは休息が必要な状態。消耗とは、取り戻せない何かを費やしてしまった状態です。注意力、忍耐力、何か重要なことに気づき、異常を指摘し、関連性を見出すことができたはずの脳の部分。それはもう失われています。43枚目の請求書に消えていったのです。
Parseurが800人以上の財務・業務担当者を対象に行った調査では、従業員の56%が反復的なデータ作業による燃え尽き症候群を経験していることが判明しました(Parseur)。Vic.aiの2025年AIモメンタムレポートでは、AP担当者の37%が、処理コストや承認遅延、その他すべての業務上の悩みを抑えて、手動データ入力を最大の悩みの種として挙げています(Vic.ai)。また、MakersHubが1,000人以上の会計専門家を対象に行った調査では、24%がデータ入力やエラー修正に週11〜20時間を費やし、15%は20時間以上を費やしていることがわかりました(MakersHub)。会計専門家の7人に1人にとって、週の半分はデータ入力です。分析でも、クライアントへの助言でもありません。ある場所から別の場所へ数字を打ち込むだけの作業です。
最悪なのはタイピングそのものではありません。それは、あるレベルで、これをコンピューターがやるべきだとわかっていることです。あなたが凝視しているPDFはすでにデジタルデータです。打ち直しているデータはすでに機械可読な形で存在しているのです。ただ、あなたのツールが解析できない文書レイアウトの中に閉じ込められているだけ。あなたは機械ができない作業をしているのではありません。機械がやるべき作業を、不十分な形でやっているのです。あなたのツールが扱える範囲と、実際の文書の見た目との間のギャップを、人間が埋めなければならないからです。
「コピー&ペースト」が請求書12枚目あたりで破綻する理由
「コピー&ペースト」という言葉は誤解を招きます。テキストを選択して貼り付ける、という2つのステップを連想させます。しかし実際に請求書データをExcelに「コピー&ペースト」するときに行っていることは、6つのステップに近く、そのすべてが認知エネルギーを消耗し、作業が長引くにつれて精度が落ちていきます。
書類を開く — 適切なビューアで
ある取引先はPDF、別の取引先はスキャンしたJPG、さらに別の取引先はスマホで撮影した紙の請求書の写真を送ってきます。フォーマットごとに異なるアプリケーションで開く必要があり、その切り替えのたびに視覚処理がリセットされるマイクロインタラプションが発生します。単にファイルを開いているだけではありません。数分おきに新しい書類の構造に再適応しているのです。
各フィールドをページ内で探す
「請求書番号」は、ある業者の書類では右上、別の業者では左上、さらに別の業者では表のヘッダー行にあります。そのたびにページ全体を目でスキャンすることになります。特に、3ページ目に条件が記載された複数ページの請求書の場合、スキャン範囲は想像以上に広くなります。このスキャン工程で、PO番号と請求書番号を間違えたり、単価と金額を読み違えたりする、ほとんどのエラーが発生します。
フィールドの実際の意味を解釈する
取引先Aは合計を「Grand Total」、取引先Bは「Amount Due」、取引先Cは「Invoice Total (incl. VAT)」と表記します。これらは同じ意味でしょうか? 通常は同じですが、常にそうとは限りません。その判断は、すべての書類のすべてのフィールドについて、あなたが下さなければなりません。この解釈工程にこそ、認知負荷の本質があります。疲れるのはタイピングではありません。絶え間なく続く、ささいな判断の積み重ねなのです。
コピー、ウィンドウ切替、貼り付け — 値ごとに
ページ上の異なる場所にある6つのフィールドをまとめてコピーすることはできません。各フィールドは、選択→コピー→Alt+Tab→クリック→貼り付け、という個別のシーケンスです。6フィールドあれば、書類とスプレッドシートの間を6往復することになります。ウィンドウ切り替えに1回2秒かかるとすると、書類1枚あたりの機械的なオーバーヘッドは約20秒。10枚の書類では約3分になります。これは「ただコピペしているだけ」という流れの中で、目に見えずに積み重なっていくアプリケーション切り替えの時間です。
間違った行に貼り付けていないか確認する
スプレッドシートは請求書1枚につき1行です。3~4件入力すると、行がぼやけて見えてきます。今貼り付けた$4,280.50は、取引先Cの行でしょうか、それとも取引先Dの行でしょうか? ある業者のデータを別の業者の行に入れてしまう「行ずれエラー」は、手入力ミスの中で最も危険です。数式では検出できず、スプレッドシートは間違った情報を、あたかも正しいかのように静かに報告するからです。
繰り返す — ただし効果は逓減
手動データ入力の真実を教えよう。最初の10件の書類は1件あたり約2〜3分。11〜20件目は3〜4分。21〜30件目は4〜5分。書類が難しくなるわけではない。注意力が低下するのだ。Quality Magazineによると、手動データ入力の標準エラー率は約1%(Infrrd)。しかしこの率は作業時間を通じて一定ではない。4時間の持続的な認知作業後、エラー率は最初の1時間と比べて約40%上昇する。午後4時に入力する請求書は、午前10時に入力したものより明らかに精度が低いのだ。
これが意味するのは、「4時間のデータ入力」は4時間タイピングしているわけではないということです。実際のキー入力は約45分で、残りの3時間以上は、探す・解釈する・切り替える・確認することに費やされています。タイピング自体は速い部分です。その周囲にあるすべて——文書レイアウトとスプレッドシートの列の間を行き来する認知作業——こそが、午後を丸ごと消費してしまう部分なのです。
「コピー&ペースト」という言葉は、本当のコストを隠しています。あなたはコピー&ペーストをしているのではありません。読む、探す、解釈する、変換する、転記する、確認する——という6つの異なる認知操作を行っており、同じ情報をそれぞれ異なる方法で配置した何十もの文書に対して、それを繰り返しているのです。これは単調なだけの単純作業ではありません。単純な作業を装った複雑な作業であり、だからこそ、本当に複雑な仕事では感じないような疲労をもたらすのです。
同じ20枚の請求書、異なる2つの午後
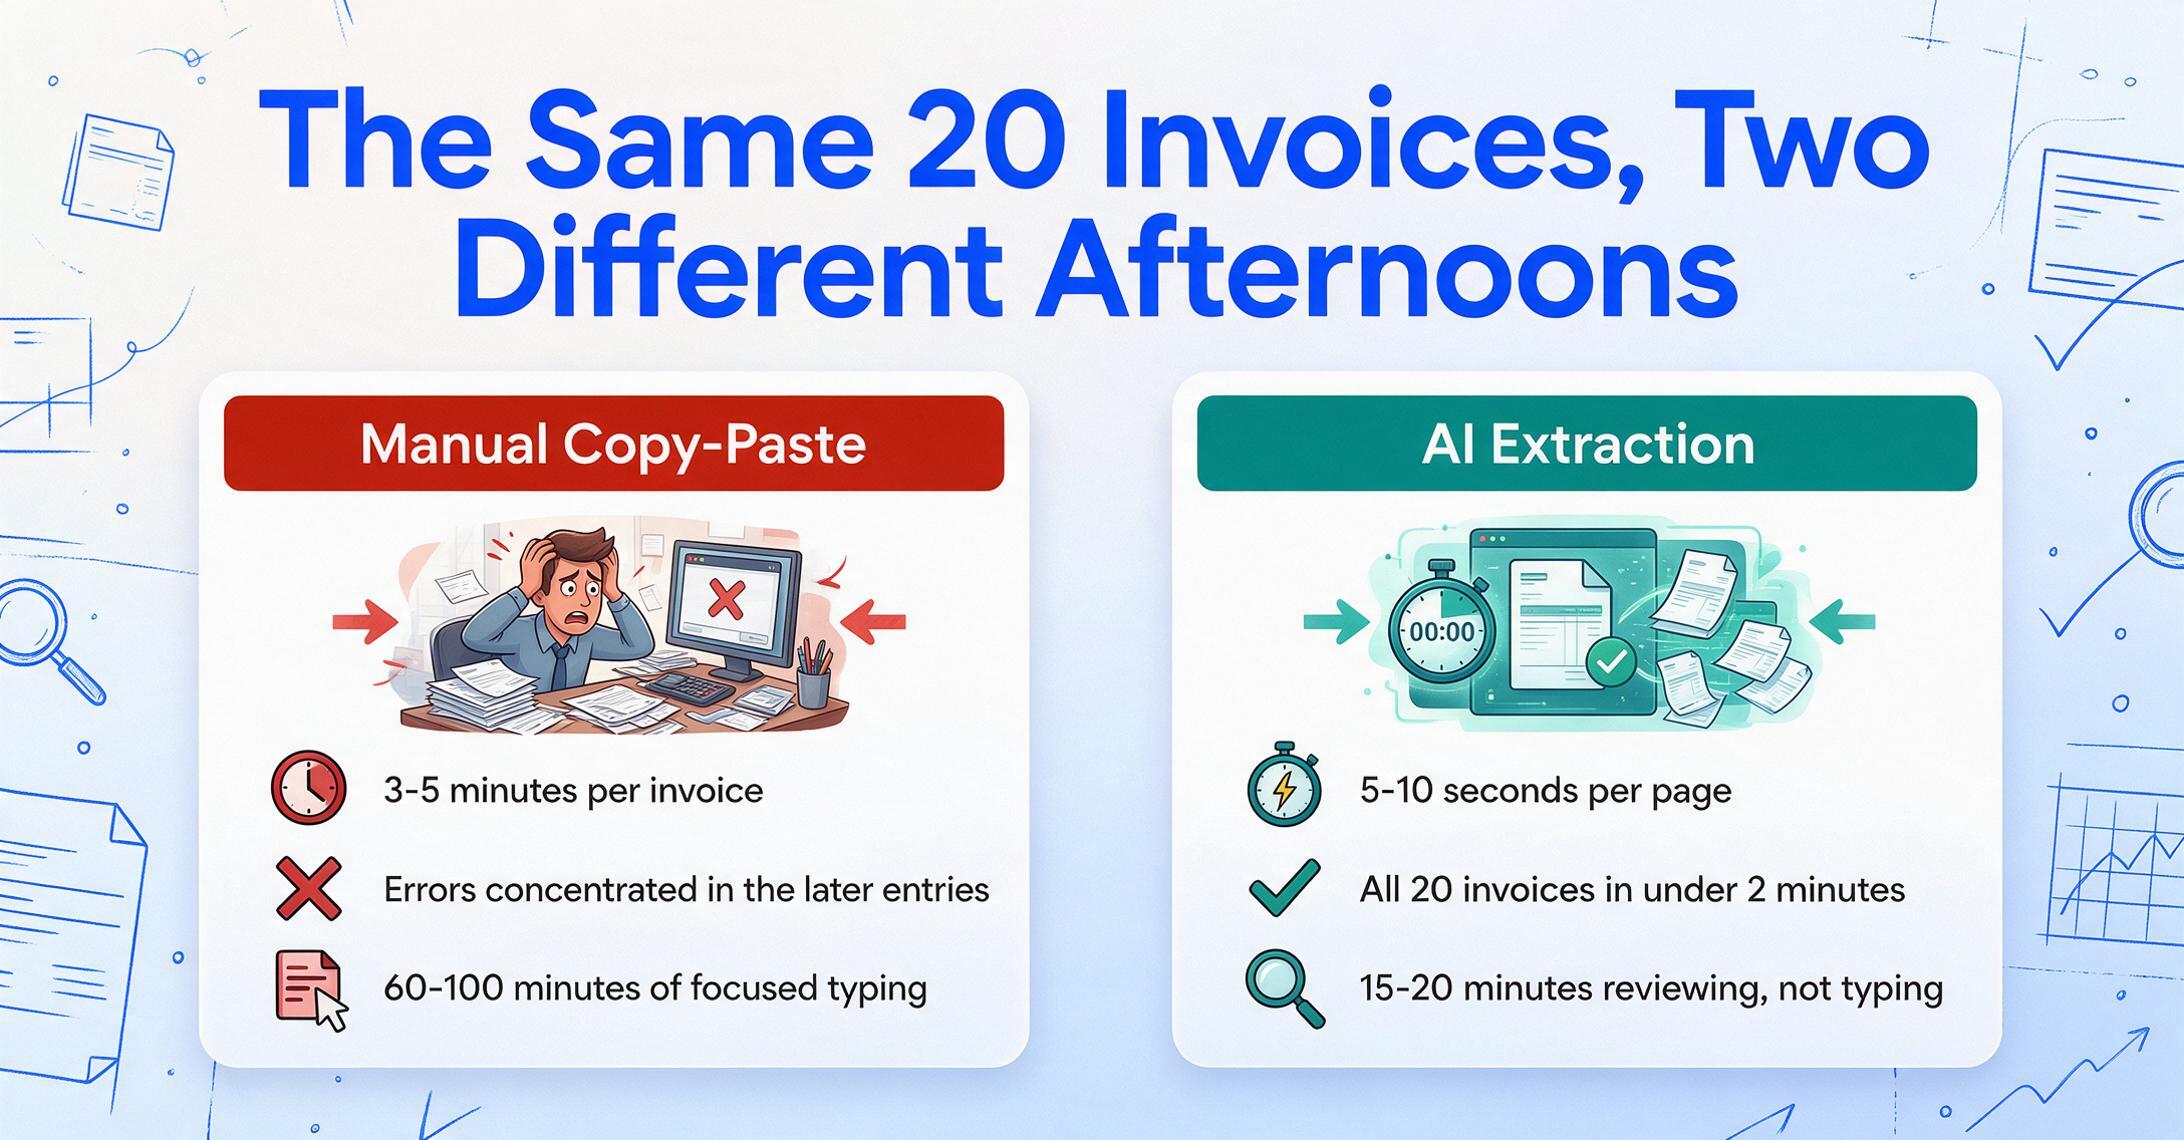
同じ作業、同じ文書——複数の仕入先からの請求書20枚——を、2つの異なるワークフローで処理した場合を比べてみましょう。1つは、あなたがすでに知っている方法です。もう1つは、抽出がタイピングに取って代わった場合に起こることです。
| 経路A:手動コピペ | 経路B:AI抽出 | |
|---|---|---|
| 準備 | ExcelかGoogleスプレッドシートを開く。列見出しを作成。別ウィンドウで最初のPDFを開く。 | ブラウザまたはGoogleスプレッドシートのサイドバーでツールを開く。「請求書番号」「取引先」「日付」「支払期日」「小計」「税」「合計」など、必要な列名を一度だけ入力または貼り付ける。 |
| 1文書あたり | 開く→レイアウトを確認→各フィールドを探す→ラベルを解釈→値を入力またはコピペ→行の位置を確認→次の文書へ。1枚あたり3~5分。 | バッチをドラッグ&ドロップ。AIが各文書を読み取り、画面上の位置ではなくフィールドの意味を理解。1ページあたり5~10秒。 |
| 形式対応 | 新しい取引先のレイアウトが出るたびに頭を切り替える必要あり。PDF、スキャンJPG、スマホ写真、Excel添付ファイル——それぞれ別のアプリ、別の表示モード、別の読み取りパターンが必要。 | すべての形式を同じ方法で処理。PDF、JPG、PNG、WebP、スクリーンショット——AIが文書を視覚的に読み取り、ファイル形式ではなく内容を理解。形式が変わっても作業フローは変わらない。 |
| 出力 | 60~100分の集中作業で1行ずつ作成されたスプレッドシート——後半になるほどエラーが集中。 | 20枚すべての請求書を2分未満で処理し、1つのスプレッドシートに統合。その後15~20分かけて結果を確認——転記ではなく検証。 |
| 20枚の合計時間 | 入力60~90分+確認・修正15~20分=75~110分 | 処理2分+確認15~20分=25分未満 |
| あなたの役割 | タイピング。1時間半。 | 読む、確認する、考える。機械がタイピングを担当。 |
違いは単に50~85分の時間短縮だけではない。その時間の質が違う。経路Aでは、PDFビューアとスプレッドシートの間で指をデータケーブルにして情報を物理的に移動させる。経路Bでは、情報が自動で移動する。あなたの仕事はAIが見つけた結果を確認し、再確認が必要な箇所にフラグを立てることになる。データの移動者からデータの確認者へ——タイピングする人からチェックする人へと変わる。
これがカスタム列抽出の仕組みだ。テンプレートベースのOCRのように画面上の各フィールドの位置を指定する(枠を描いたり座標ルールを書いたりする)必要はない。列に名前を付けるだけで、何が欲しいかをツールに伝えられる。「請求書番号」「取引先名」「支払期日」「合計」と入力する。AIが各文書を読み取り、列名に一致する値を意味を理解して見つけ出し、スプレッドシートに自動入力する。同じ列名がすべての取引先の形式で機能する——AIが位置ではなく意味を読み取るからだ。
ファイルは安全に処理され、保存されません。
入力をやめると、実際に何が変わるのか
この作業をやったことがない人にはわからないことがあります。回復するのは、取り戻した1時間だけではありません。問題は、午後が終わったときの疲れ方の種類です。
4時間かけて請求書データを入力すると、肉体的に疲れるだけでなく、指は痛み、目はしょぼしょぼします。そして、認知的に空っぽになります。判断力や分析力、創造性を必要とする決断を一切せずに、午後中ずっと過ごしてきたのです。あなたは周辺機器になっていたのです。そして午後5時、ノートパソコンを閉じたとき、達成感はありません。消耗したと感じます。まるで、自分が生み出したのではなく、何かを搾り取られたかのように。
同じ午後を、抽出されたデータのレビューに費やす場合(AIがベンダー名を正しく取得したか確認し、合計が一致するか検証し、手書きが読みにくかった請求書を1件フラグする)、それは根本的に異なる種類の仕事です。あなたは考えています。判断を下しています。問題を見つけています。最後には、信頼できるスプレッドシートが手に入り、人間の脳を必要とする部分に時間を使ったことになります。
文書処理ワークフローに関するRossumの分析は、これを直接的に述べています:「請求書からのデータの再入力は、精神的に消耗する作業です。企業はデータ入力の専門家を見つけるのがますます難しくなっています。これらの専門家の燃え尽き率は加速しており、彼らの交代と再訓練は労力とコストがかかります。」(Rossum)人々は給与が悪いからデータ入力の仕事を辞めるのではありません。仕事が人を空洞にするから辞めるのです。
入力からレビューへの移行は、わずかな改善ではありません。ベルトコンベアになることと、品質検査官になることの違いです。持久力の仕事と思考の仕事の違いです。そして、これこそが数字を単なる数字以上のものにしている理由です。20件の請求書バッチあたり50〜85分の節約は、単に取り戻した時間ではありません。取り戻したあなた自身です。仕事の残りの時間のために、まだエネルギーと注意力が残っているバージョンのあなたです。
この変化の背後にある具体的な数字(人件費、エラーコスト、機会費用の計算)を知りたい読者のために、手動データ入力の実際のコストに関する詳細な内訳で、ご自身のチーム向けに実行できる3つの部分からなる計算を説明しています。
複雑ではありません。思ったよりずっと簡単です。
「AI搭載のドキュメント抽出」と聞くと、複雑で、高額で、IT部門の承認や6か月の導入期間、誰も受ける時間のない研修が必要だ、という思い込みがほとんど反射的にあります。
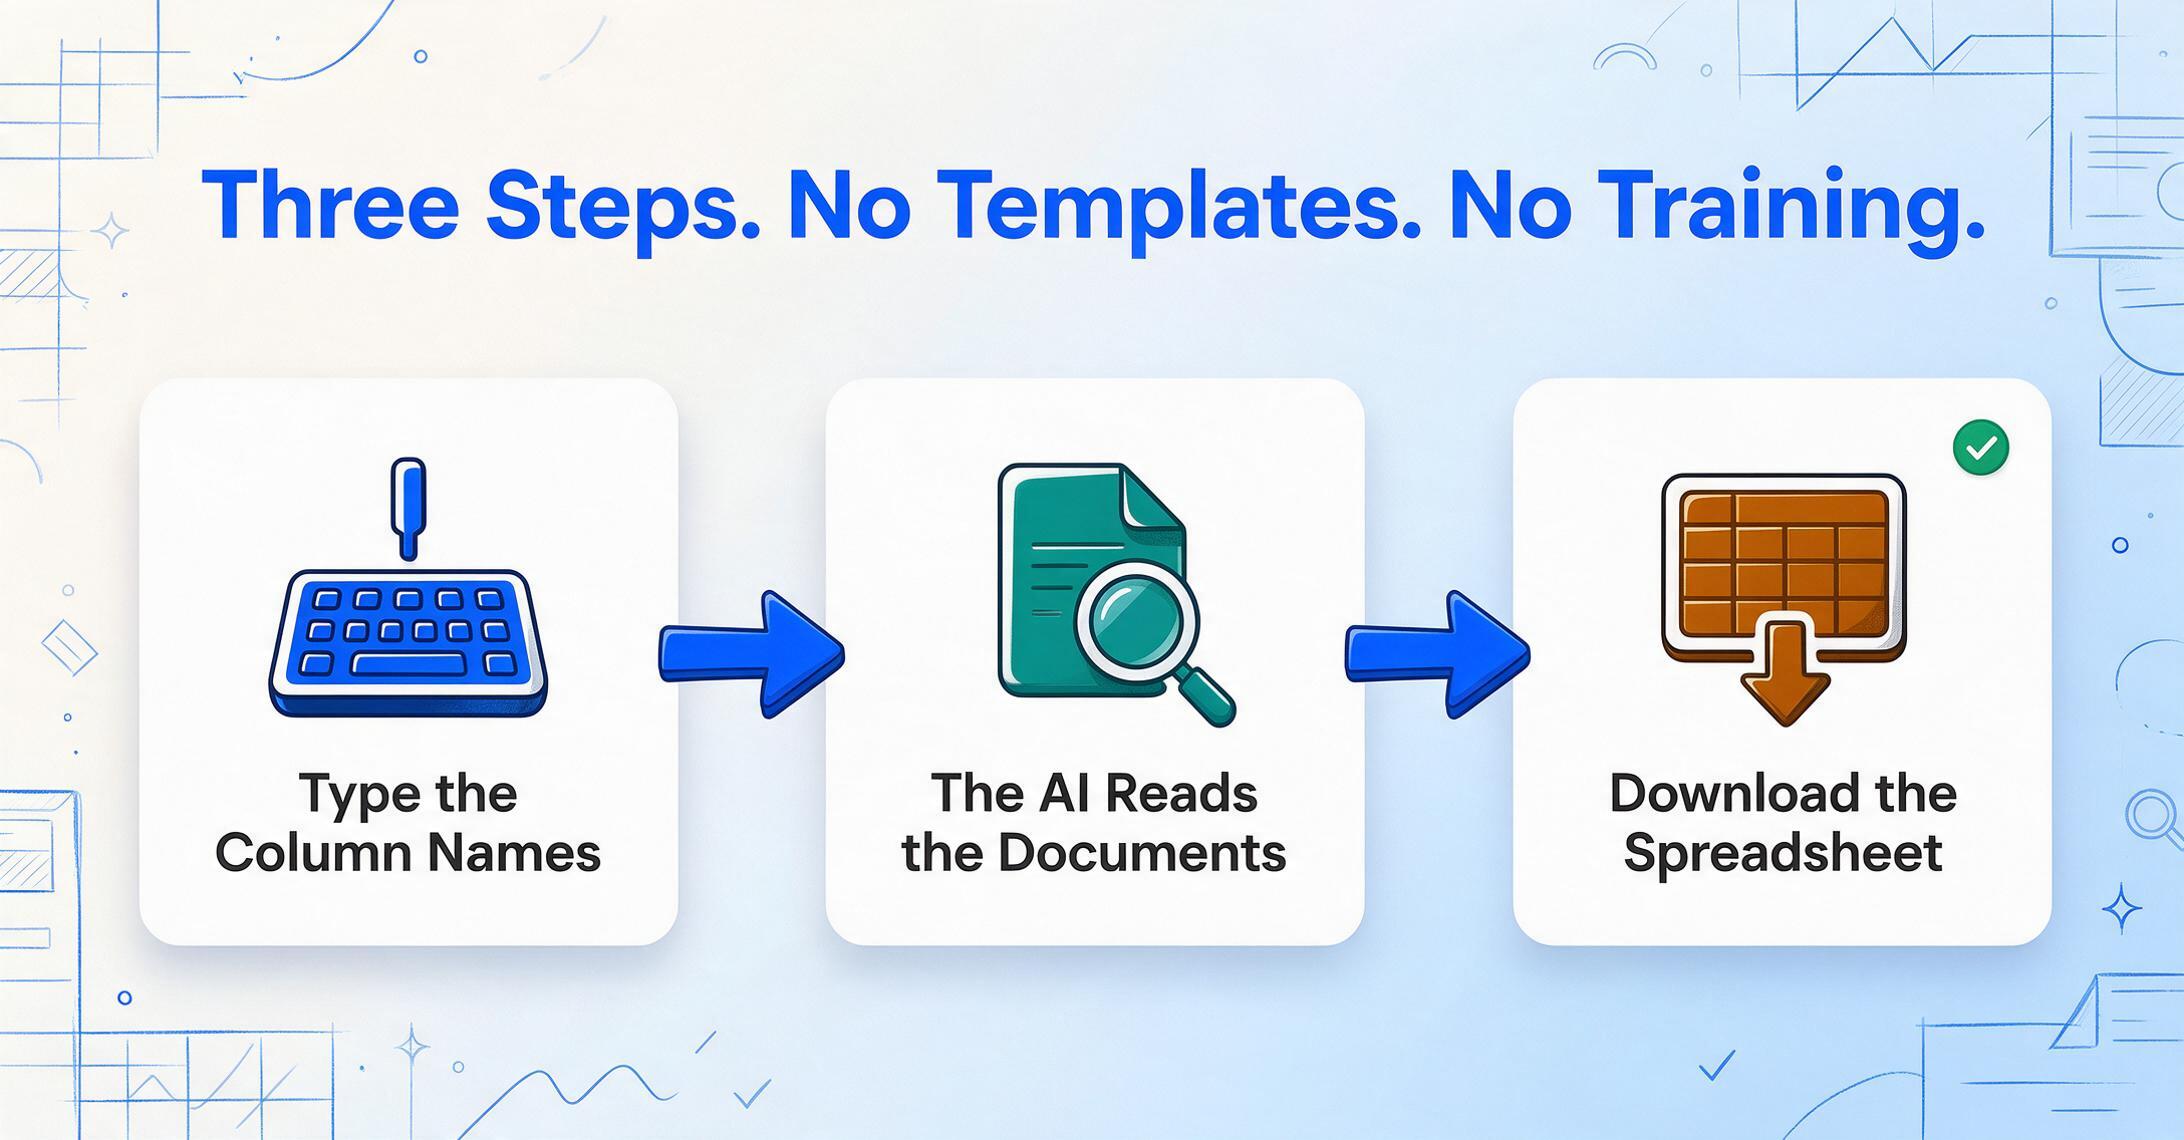
この思い込みは、エンタープライズ向けドキュメント処理市場によって強化されています。そこでは、導入コンサルタント、テンプレート設定、数か月に及ぶモデルトレーニングが本当に必要なツールが存在するからです。しかし、ここで説明しているのはそういうものではありません。上のデモで示した抽出アプローチは、別の前提に基づいています。テンプレート不要・トレーニング不要の抽出です。テンプレートを作る必要も、モデルをトレーニングする必要も、解析ルールを設定する必要もありません。欲しい列名を入力するだけ。AIがドキュメントを読み取り、スプレッドシートをダウンロードするだけです。
それだけです。中核となる仕組み、意味ベースの抽出は、AIがフィールドの「位置」ではなく「意味」を理解することを意味します。「合計」は、PDFの右下隅にあっても、Excelファイルの3列目にあっても、撮影したレシートの下部に手書きであっても、「合計」です。AIは意味によってそれを見つけ出し、意味はレイアウトが変わっても変わりません。具体的なワークフローの手順については、請求書フィールドのExcelへの抽出に関するガイドでフィールドごとの設定を解説しています。テンプレート不要の抽出がさまざまなドキュメントタイプでどのように機能するかについての詳しい説明は、テンプレートなしの意味ベース抽出に関するガイドをご覧ください。
技術的なベンチマーク: 印刷されたドキュメントのフィールド抽出は最大99%の精度に達します。1ページの処理時間は5〜10秒。同じページの平均的な手動入力時間は3分で、18倍の効率改善です。そして、すでに使っているツールとも連携します。ブラウザで直接ファイルをアップロードできます。Google スプレッドシートで作業している場合は、サイドバーアドオンがアクティブなスプレッドシートにデータを直接抽出します。エクスポートもインポートも、アプリの切り替えも不要です。AIベースのデータ入力という概念に馴染みがない方は、AIデータ入力の入門で基礎を学べます。
複雑ではありません。 複雑だったのは、コンピューターなら1分もかからない作業に毎週4時間も費やしていたことです。簡単なのは、ファイルをアップロードし、列に名前を付け、結果をダウンロードすることです。
よくある質問
PDF、スキャン画像、スマホ写真など、異なる文書形式でも使えますか?
はい。AIは文書を視覚的に読み取るため、PDF、JPG、PNG、WebP画像、スクリーンショットを区別なく処理します。スキャンした請求書、紙の領収書のスマホ写真、デジタル生成のPDFも、すべて同じ抽出パイプラインで処理されます。元画像の品質は精度に影響します(明るく鮮明な写真の方がぼやけたものより正確に抽出できます)が、形式の違い自体は制限になりません。
手書きの請求書も処理できますか?
はい、ただし重要な条件があります。AIは従来のOCRよりはるかに手書き文字を読み取れます。周囲の文脈から曖昧な文字を推測するためです(人間が文の流れから単語を推測するのと同様です)。読みやすい手書き文字は高い精度で抽出できます。しかし、筆記体が強い、かすれている、または傷んだ手書き文字は、特に金額などの重要な項目で精度が低下します。手書き文書を多く扱う場合は、結果をより注意深く確認することをお勧めします。
取引先や文書レイアウトごとにテンプレートを設定する必要がありますか?
いいえ。それがテンプレートベースのOCRとAI抽出の本質的な違いです。テンプレートベースのツールは、取引先のレイアウトごとに解析テンプレートを作成・維持し、書式が変更されるたびに更新する必要があります。AI抽出は文書を毎回新たに読み取り、位置ではなく意味的な役割(「このページで合計として機能するものは何か?」)でフィールドを特定します。新しい取引先の請求書も、長年取引のある取引先と同様に処理されます。テンプレートの作成も保守も不要です。
会計システムとの連携が必要な大規模なITプロジェクトですか?
いいえ。意図的にそう設計されています。出力は標準のExcel(XLSX)、CSV、またはJSONファイルで、どの会計システムでもインポート可能です。ほとんどのチームは抽出したスプレッドシートをダウンロードし、既存のワークフローの一部としてERPや会計ソフトにインポートしています。API連携は不要で、ITプロジェクトや開発者の時間、特定のコネクタへのソフトウェアベンダーの対応も必要ありません。Google Sheetsユーザー向けには、サイドバーアドオンがアクティブなスプレッドシートに直接データを追加します。
セキュリティはどうですか?請求書には機密性の高い財務データが含まれています。
デモまたはメインアプリケーションを通じてアップロードされたファイルは安全に処理され、処理完了後は保存されません。より厳格なコンプライアンス要件があるチーム向けに、Google Sheetsアドオンも同じ安全なパイプラインでデータを処理します。本サービスは業務用の財務文書向けに設計されており、消費者向け写真向けではありません。アーキテクチャもそれを反映しています。
登録やクレジットカードなしで試せますか?
はい。上記のデモはすぐに動作します。アカウント登録やクレジットカードは不要です。今すぐ請求書をアップロードして抽出結果をご確認いただけます。下記リンク先のゲストデモページも登録なしでご利用いただけます。大量のデータを処理したり、Googleスプレッドシートのアドオンをご利用になる際は、無料アカウントを作成すると追加機能が利用可能になります。
手作業でのデータ入力は、別の方法を知るまでは避けられないものに思えます。しかし、一度その方法を試せば、元には戻れません。ご自身の請求書でお試しください。登録不要、テンプレート不要、設定不要。アップロードするだけで、その違いを実感できます。
請求書抽出を試す — 登録不要