Ich habe 4 Stunden damit verbracht, Rechnungsdaten in Excel zu tippen.
Dann habe ich das ausprobiert.
So fühlt es sich wirklich an, vier Stunden lang Rechnungsdaten zu tippen – nicht im Sinne eines Produktivitäts-Blogs, sondern körperlich. Ihre Augen, trocken und angestrengt, nachdem Sie 37 verschiedene PDF-Layouts gescannt haben, die „Rechnungsnummer" jeweils in einer anderen Ecke platzieren. Ihre Finger, nach sechstausend Tastendrücken, die nichts Neues hervorgebracht haben. Ihr Gehirn, nachdem Sie zum 23. Mal entschieden haben, ob das, was Lieferant D als „Ref." bezeichnet, dasselbe Feld ist wie „Dokumentnr." von Lieferant G.
Wichtigste Erkenntnisse
- 56 % der Finanzfachleute brennen bei sich wiederholenden Datentätigkeiten aus – nicht wegen des Tippens, sondern wegen der stillen kognitiven Belastung, wenn sie interpretieren müssen, ob „Ref." dasselbe bedeutet wie „Rechnungsnr."
- Der Begriff „Kopieren und Einfügen" verbirgt sechs separate mentale Vorgänge pro Feld, und bis zur Rechnung 20 ist Ihre Fehlerquote um 40 % gestiegen, ohne dass Sie es bemerken.
- Wenn Sie aufhören zu tippen und anfangen, extrahierte Daten zu prüfen, sind Sie kein menschliches Fließband mehr, sondern ein Qualitätsprüfer – die Rolle, für die Ihr Gehirn eigentlich eingestellt wurde.
Wie sich 4 Stunden Rechnungsdateneingabe wirklich anfühlen
Seien wir ehrlich, worum es bei dieser Arbeit geht. Sie erschaffen nichts. Sie analysieren nichts. Sie sind ein menschliches Fließband – Sie nehmen eine Zahl von einem Rechteck auf Ihrem Bildschirm und übertragen sie in ein anderes Rechteck auf Ihrem Bildschirm. Rechnungsnummer. Datum. Lieferantenname. Zwischensumme. Steuer. Gesamtsumme. Positionsposition. Positionsposition. Positionsposition. Nächste Rechnung. Wiederholen. Stundenlang.
Ein Kleinunternehmer beschrieb es auf Reddit mit der resignierten Erschöpfung, die jeder, der diese Arbeit schon gemacht hat, sofort wiedererkennt: „Die Verwaltung tippt die Positionen – Preis, Menge, SKU – manuell in eine riesige Excel-Tabelle. Das dauert jeden Freitag etwa 4 Stunden.“ (r/smallbusiness) Vier Stunden jeden Freitag. Das sind 200 Stunden pro Jahr – fünf volle Arbeitswochen – für eine Aufgabe, die ausschließlich daraus besteht, Zahlen von einem Bildschirm abzulesen und auf einem anderen einzutippen.
Die körperliche Belastung ist real und sie summiert sich. Wenn Sie diese Art von Arbeit schon länger gemacht haben, kennen Sie die Anzeichen: das Ziehen im Handgelenk, das etwa ab der zweiten Stunde beginnt und erst verschwindet, wenn Sie schlafen gehen. Die Art, wie Ihre Augen ab dem 30. Dokument den Fokus verlieren – Sie lesen dasselbe Feld zweimal, dreimal, nicht weil es kompliziert ist, sondern weil Ihr visuelles System abgeschaltet hat. Die Kopfschmerzen durch die ständigen Mikroanpassungen zwischen Dokumenten mit unterschiedlichen Schriftarten, unterschiedlichem Abstand, unterschiedlichen Positionen derselben Information.
Es ist nicht nur ermüdend. Es ist entkräftigend. Da gibt es einen Unterschied. Müde bedeutet, Sie brauchen Ruhe. Entkräftet bedeutet, Sie haben etwas ausgegeben, das Sie nicht zurückbekommen – Ihre Aufmerksamkeit, Ihre Geduld, den Teil Ihres Gehirns, der etwas Wichtiges hätte bemerken, eine Anomalie markieren, eine Verbindung herstellen können. Das ist weg. Es steckt in der 43. Rechnung.
Eine Umfrage von Parseur unter über 800 Finanz- und Betriebsprofis ergab, dass 56 % der Mitarbeiter unter Burnout durch repetitive Datentätigkeiten leiden. Der AI-Momentum-Report 2025 von Vic.ai ergab, dass 37 % der AP-Profis die manuelle Dateneingabe immer noch als ihren größten Schmerzpunkt einstufen – noch vor Verarbeitungskosten, Genehmigungsverzögerungen und jedem anderen betrieblichen Problem. Und eine Umfrage von MakersHub unter über 1.000 Buchhaltungsprofis ergab, dass 24 % 11 bis 20 Stunden pro Woche mit Dateneingabe oder Fehlerkorrektur verbringen, während 15 % mehr als 20 Stunden aufwenden. Für jeden siebten Buchhaltungsprofi ist die halbe Arbeitswoche Dateneingabe. Keine Analyse. Keine Kundenberatung. Zahlen von einem Ort zum anderen tippen.
Das Schlimmste ist nicht das Tippen. Es ist das Wissen, irgendwo tief in sich, dass Computer das eigentlich tun sollten. Dass das PDF, auf das Sie starren, bereits digital ist. Dass die Daten, die Sie neu eintippen, bereits in maschinenlesbarer Form existieren – sie sind nur in einem Dokumentlayout gefangen, das Ihre Tools nicht parsen können. Sie tun keine Arbeit, die eine Maschine nicht kann. Sie tun Arbeit, die eine Maschine sollte, schlecht, weil die Lücke zwischen dem, was Ihre Tools verarbeiten können, und dem, wie Ihre Dokumente tatsächlich aussehen, von einem Menschen überbrückt werden muss.
Warum „Kopieren und Einfügen" ab Rechnung 12 nicht mehr einfach ist
Der Begriff „Kopieren und Einfügen" ist irreführend. Er suggeriert zwei Schritte: Text auswählen, einfügen. Was tatsächlich passiert, wenn Sie Rechnungsdaten per „Kopieren und Einfügen" in Excel übertragen, sind eher sechs Schritte – und jeder davon kostet kognitive Energie, die mit der Zeit nachlässt:
Dokument öffnen – im richtigen Viewer
Ein Lieferant sendet ein PDF. Ein anderer ein gescanntes JPG. Ein Dritter mailt ein Foto einer Papierrechnung, aufgenommen mit dem Handy. Jedes Format öffnet in einer anderen Anwendung. Jeder Wechsel ist eine Mikro-Unterbrechung, die Ihre visuelle Verarbeitung zurücksetzt. Sie öffnen nicht nur Dateien. Sie gewöhnen sich alle paar Minuten an eine neue Dokumentenstruktur.
Seite scannen, um jedes Feld zu finden
„Rechnungsnummer“ steht bei einem Lieferanten oben rechts, beim nächsten oben links und bei einem Dritten in einer Tabellenkopfzeile. Ihre Augen scannen jedes Mal die gesamte Seite – und bei einer mehrseitigen Rechnung mit Zahlungsbedingungen auf Seite 3 ist der Scanbereich viel größer, als Sie denken. Hier entstehen die meisten Fehler: Sie greifen die Bestellnummer, wenn Sie die Rechnungsnummer meinen, oder lesen den Einzelpreis, wenn Sie den Gesamtpreis brauchen.
Interpretieren, was das Feld tatsächlich bedeutet
Lieferant A bezeichnet die Summe als „Gesamtsumme“. Lieferant B nennt sie „Rechnungsbetrag“. Lieferant C verwendet „Rechnungssumme (inkl. MwSt.).“ Ist das dasselbe? Meistens, aber nicht immer – und die Entscheidung liegt bei Ihnen, für jedes Feld, in jedem Dokument. Dieser Interpretationsschritt ist die eigentliche kognitive Belastung. Nicht das Tippen ermüdet Sie. Es sind die ständigen, kleinen Abwägungen.
Kopieren, Fenster wechseln, einfügen – pro Wert
Sie können nicht sechs Felder von verschiedenen Stellen einer Seite gleichzeitig kopieren. Jedes Feld ist eine eigene Sequenz: Auswählen-Kopieren-Alt+Tab-Klicken-Einfügen. Sechs Felder bedeuten sechs Hin- und Rückwege zwischen Dokument und Tabelle. Bei zwei Sekunden pro Fensterwechsel beträgt der mechanische Aufwand fast 20 Sekunden pro Dokument – bei zehn Dokumenten fast drei Minuten. Das ist Zeit, die mit dem Hin- und Herschalten zwischen Anwendungen vergeht und unsichtbar im Fluss des „nur Kopieren und Einfügens“ anfällt.
Prüfen, ob Sie in die richtige Zeile eingefügt haben
Ihre Tabelle hat eine Zeile pro Rechnung. Nach drei oder vier Einträgen verschwimmen die Zeilen. Ist die soeben eingefügten 4.280,50 € in der Zeile für Lieferant C oder D gelandet? Ein Zeilenfehler – Daten eines Lieferanten in die Zeile eines anderen setzen – ist die gefährlichste Art manueller Eingabefehler, weil keine Formel ihn erkennt. Die Tabelle meldet stillschweigend falsche Informationen, die autoritativ wirken.
Wiederholen – mit abnehmendem Ertrag
Was Ihnen niemand über manuelle Dateneingabe sagt: Die ersten zehn Dokumente dauern jeweils etwa 2–3 Minuten. Dokumente 11–20 benötigen 3–4 Minuten pro Stück. Dokumente 21–30 brauchen 4–5 Minuten. Die Verlangsamung liegt nicht daran, dass die Dokumente schwieriger werden – das tun sie nicht. Sondern daran, dass Ihre Konzentration nachlässt. Das Magazin Quality stellte fest, dass die typische Fehlerquote bei manueller Dateneingabe bei etwa 1 % liegt (Infrrd) – aber diese Rate ist innerhalb einer Sitzung nicht konstant. Nach vier Stunden anhaltender kognitiver Arbeit steigen die Fehlerraten im Vergleich zur ersten Stunde um etwa 40 %. Die Rechnungen, die Sie um 16 Uhr eingeben, sind deutlich ungenauer als die, die Sie um 10 Uhr eingegeben haben.
In der Praxis bedeutet das: „4 Stunden Dateneingabe" sind nicht 4 Stunden Tippen. Es sind etwa 45 Minuten tatsächliche Tastatureingaben und über 3 Stunden für Suchen, Interpretieren, Wechseln und Prüfen. Das Tippen ist der schnelle Teil. Alles andere – die kognitive Arbeit des Übersetzens zwischen Dokumentlayouts und Tabellenspalten – ist das, worin der Nachmittag verschwindet.
Der Begriff „Kopieren und Einfügen" verdeckt die wahren Kosten. Sie kopieren und fügen nicht nur ein. Sie lesen, suchen, interpretieren, übertragen, transkribieren und prüfen – sechs verschiedene kognitive Vorgänge – und das wiederholt, über Dutzende von Dokumenten, die dieselben Informationen jeweils anders anordnen. Es ist keine einfache Aufgabe, die nur mühsam ist. Es ist eine komplexe Aufgabe, die als einfache getarnt ist – genau das ist der Grund, warum sie Sie auf eine Weise auslaugt, die wirklich komplexe Arbeit nicht tut.
Dieselben 20 Rechnungen, zwei verschiedene Nachmittage
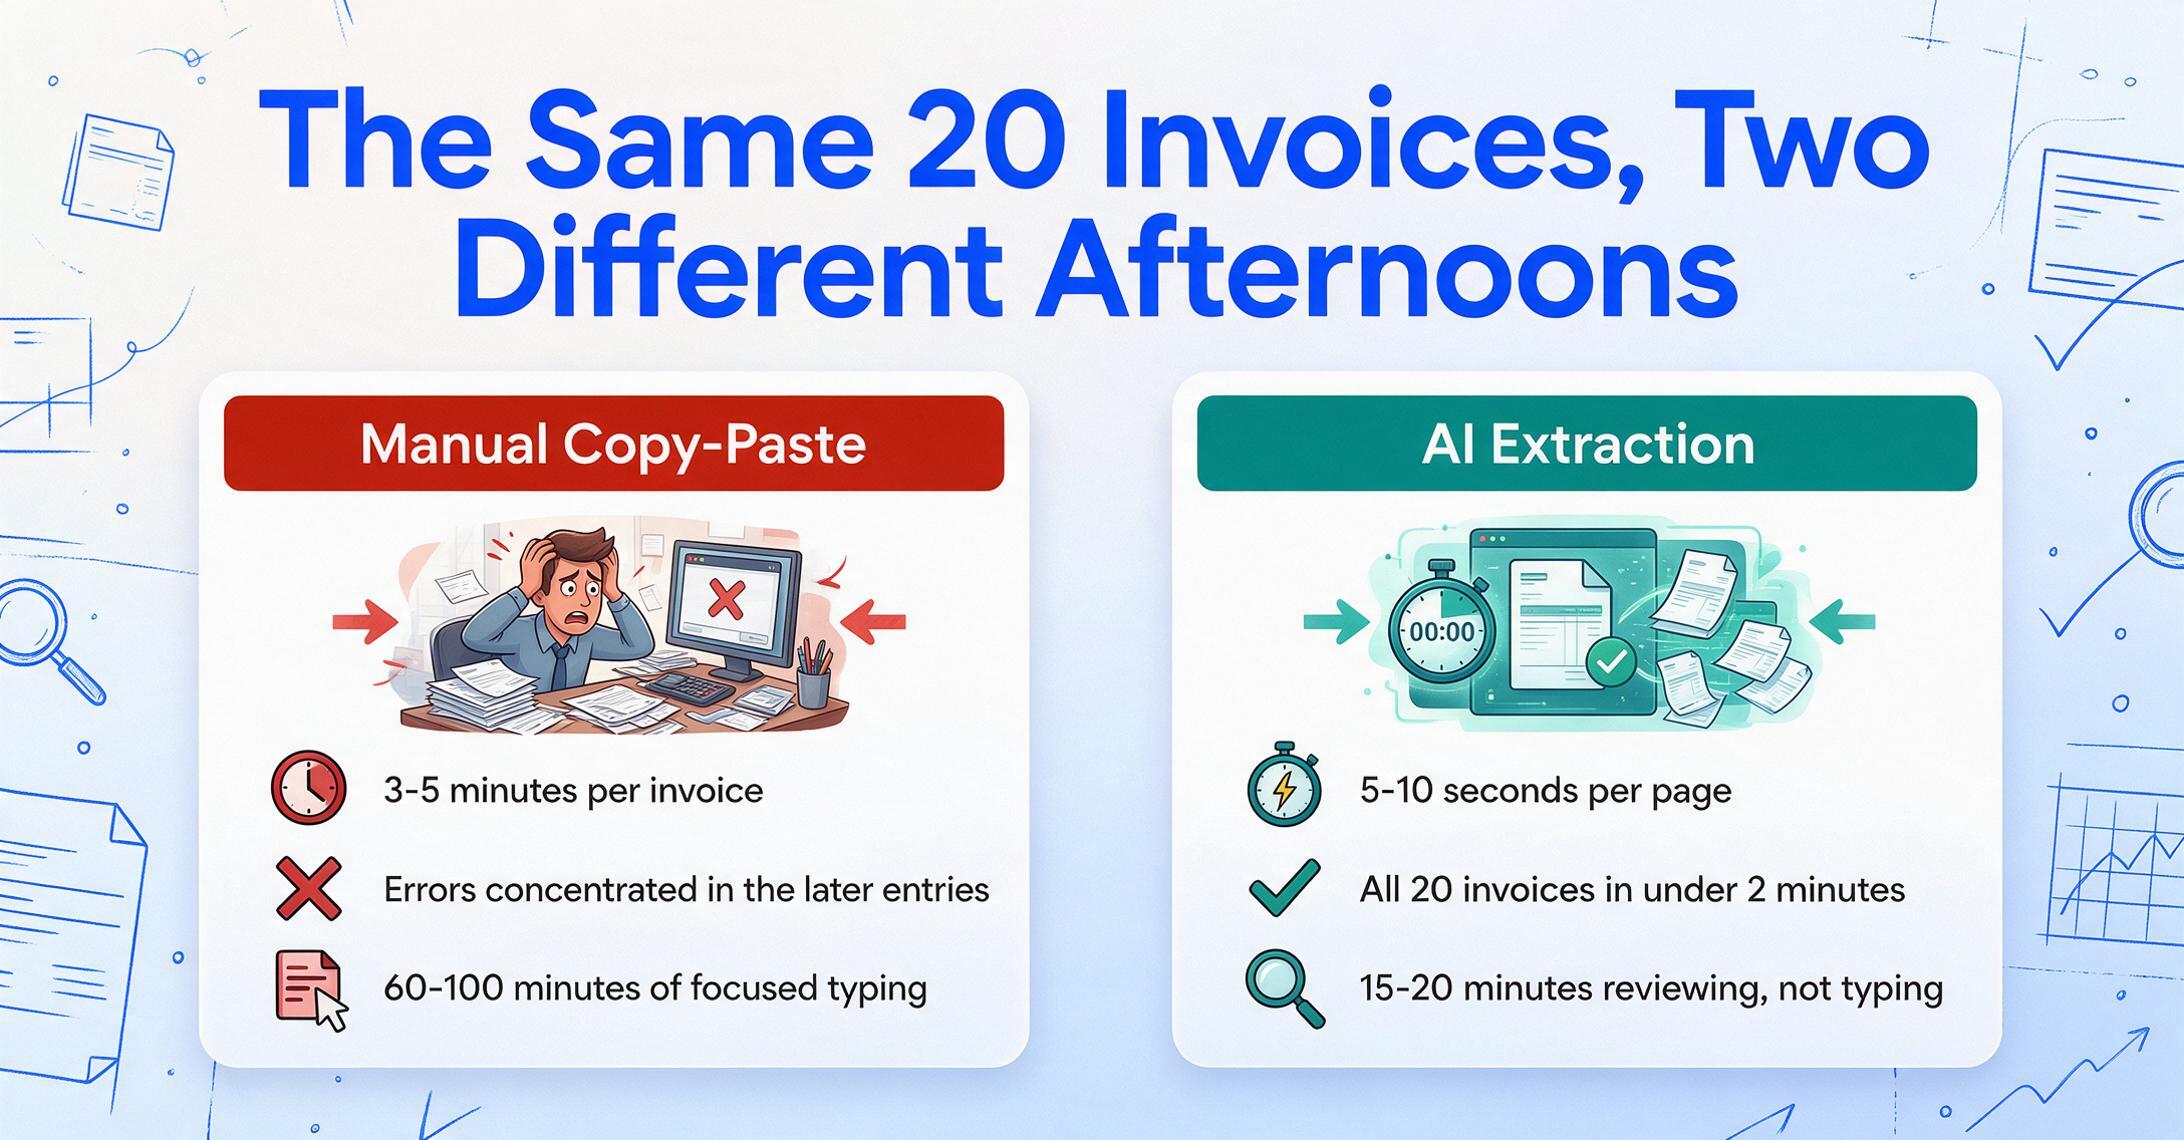
Hier ist dieselbe Arbeit, dieselben Dokumente – zwanzig Rechnungen von verschiedenen Lieferanten – in zwei verschiedenen Arbeitsabläufen. Ein Weg ist der, den Sie bereits kennen. Der andere ist das, was passiert, wenn Extraktion das Tippen ersetzt.
| Weg A: Manuelles Kopieren & Einfügen | Weg B: KI-Extraktion | |
|---|---|---|
| Einrichtung | Excel oder Google Sheets öffnen. Spaltenüberschriften anlegen. Erstes PDF in einem separaten Fenster öffnen. | Tool im Browser oder Google-Seitenleiste öffnen. Gewünschte Spaltennamen einmal eingeben oder einfügen – „Rechnungsnummer“, „Lieferant“, „Datum“, „Fälligkeitsdatum“, „Nettobetrag“, „Steuer“, „Gesamtbetrag“. |
| Pro Dokument | Öffnen → Layout scannen → jedes Feld suchen → Feldbezeichnungen interpretieren → Werte abtippen oder kopieren → Zeilenausrichtung prüfen → nächstes Dokument. 3–5 Minuten pro Rechnung. | Stapel per Drag & Drop einfügen. KI liest jedes Dokument, indem sie die Bedeutung der Felder versteht – nicht deren Position auf der Seite. 5–10 Sekunden pro Seite. |
| Formatverarbeitung | Jedes neue Lieferantenlayout bedeutet einen gedanklichen Neustart. PDF, gescanntes JPG, Handyfoto, Excel-Anhang – jedes erfordert eine andere Anwendung, eine andere Ansicht, ein anderes Scanmuster. | Alle Formate werden gleich verarbeitet. PDF, JPG, PNG, WebP, Screenshot – die KI liest das Dokument visuell und versteht den Inhalt, nicht den Dateityp. Formatvielfalt ändert den Arbeitsablauf nicht. |
| Ausgabe | Eine Tabelle, Zeile für Zeile in 60–100 Minuten konzentrierter Arbeit aufgebaut – mit Fehlerschwerpunkt in den späteren Einträgen. | Eine zusammengeführte Tabelle, alle 20 Rechnungen, in unter 2 Minuten Verarbeitungszeit befüllt. Dann 15–20 Minuten zur Prüfung der Ergebnisse – verifizieren, nicht übertragen. |
| Gesamtzeit für 20 Rechnungen | 60–90 Minuten Erfassung + 15–20 Minuten Prüfung und Fehlerkorrektur = 75–110 Minuten | 2 Minuten Verarbeitung + 15–20 Minuten Prüfung = unter 25 Minuten |
| Ihre Aufgabe | Tippen. Eineinhalb Stunden lang. | Lesen, prüfen, denken. Die Maschine tippt. |
Der Unterschied liegt nicht nur in den 50–85 Minuten. Sondern darin, woraus diese Minuten bestehen. Bei Weg A verbringen Sie die Zeit damit, Informationen physisch zu bewegen – Ihre Finger als Datenkabel zwischen PDF-Viewer und Tabelle. Bei Weg B bewegen sich die Informationen von selbst. Ihre Aufgabe wird es, die Ergebnisse der KI zu prüfen und alles zu markieren, was einen zweiten Blick braucht. Sie werden vom Datenträger zum Datenprüfer – von der Person, die tippt, zur Person, die kontrolliert.
So funktioniert die benutzerdefinierte Spaltenextraktion: Statt dem Tool zu sagen, wo sich jedes Feld auf der Seite befindet – wie es die vorlagenbasierte OCR erfordert, bei der Sie Kästchen zeichnen oder Koordinatenregeln schreiben –, sagen Sie ihm, was Sie wollen, indem Sie Ihre Spalten benennen. Geben Sie „Rechnungsnummer“, „Lieferantenname“, „Fälligkeitsdatum“, „Gesamtbetrag“ ein. Die KI liest jedes Dokument, findet die Werte, die zu diesen Spaltennamen passen, indem sie deren Bedeutung versteht, und füllt Ihre Tabelle. Dieselben Spaltennamen funktionieren bei jedem Lieferantenformat – weil die KI nach Bedeutung liest, nicht nach Position.
Dateien werden sicher verarbeitet und nicht gespeichert.
Was sich wirklich ändert, wenn Sie aufhören zu tippen
Das verstehen nur diejenigen, die diese Arbeit nie gemacht haben. Es geht nicht nur um die Stunde, die Sie zurückgewinnen. Es geht darum, welche Art von Müdigkeit Sie am Ende des Nachmittags spüren.
Wenn Sie vier Stunden damit verbringen, Rechnungsdaten abzutippen, sind Sie nicht nur körperlich erschöpft – Ihre Finger schmerzen, Ihre Augen brennen, sicher. Sie sind kognitiv leer. Sie haben einen ganzen Nachmittag damit verbracht, null Entscheidungen zu treffen, die Urteilsvermögen, Analyse oder Kreativität erforderten. Sie waren ein Peripheriegerät. Und um 17 Uhr, wenn Sie Ihren Laptop schließen, fühlen Sie sich nicht erfüllt. Sie fühlen sich ausgelaugt – als ob etwas aus Ihnen extrahiert wurde, statt von Ihnen produziert zu werden.
Wenn Sie denselben Nachmittag damit verbringen, extrahierte Daten zu prüfen – zu kontrollieren, dass die KI den Lieferantennamen richtig erkannt hat, zu verifizieren, dass die Summen stimmen, eine Rechnung zu markieren, bei der die Handschrift zu unleserlich war –, verrichten Sie eine grundlegend andere Art von Arbeit. Sie denken. Sie wenden Urteilsvermögen an. Sie entdecken Dinge. Am Ende haben Sie eine Tabelle, der Sie vertrauen, und Sie haben Ihre Zeit für den Teil der Arbeit aufgewendet, der tatsächlich ein menschliches Gehirn erfordert.
Rossums Analyse von Dokumentenverarbeitungs-Workflows bringt es direkt auf den Punkt: "Das Abtippen von Daten aus einer Rechnung ist eine geistig erschöpfende Aufgabe. Unternehmen finden es zunehmend schwierig, Datenerfassungsspezialisten zu finden; die Burnout-Rate dieser Spezialisten steigt, und das Ersetzen und Umschulen ist arbeitsintensiv und kostspielig." (Rossum) Menschen verlassen Datenerfassungsjobs nicht, weil die Bezahlung schlecht ist. Sie gehen, weil die Arbeit einen aushöhlt.
Der Wechsel vom Tippen zum Prüfen ist keine marginale Verbesserung. Es ist der Unterschied zwischen dem Fließband und der Qualitätskontrolle. Zwischen Ausdauerarbeit und Denkarbeit. Und genau das macht die Zahlen zu mehr als nur Zahlen: Die 50–85 Minuten, die pro 20-Rechnungen-Charge gespart werden, sind nicht nur zurückgewonnene Zeit. Es ist zurückgewonnenes Ich – die Version von Ihnen, die noch Energie und Aufmerksamkeit für den Rest des Arbeitstages hat.
Für Leser, die die harten Zahlen hinter diesem Wandel wollen – die Berechnungen zu Arbeitskosten, Fehlerkosten und Opportunitätskosten –, führt unsere detaillierte Aufschlüsselung unter die wahren Kosten der manuellen Dateneingabe durch die dreiteilige Berechnung, die Sie für Ihr eigenes Team durchführen können.
Nicht kompliziert. Einfacher, als Sie denken.
Es gibt eine Überzeugung, fast einen Reflex, dass alles, was als „KI-gestützte Dokumentextraktion" beschrieben wird, kompliziert sein muss. Teuer. Etwas, das IT-Freigabe, eine sechsmonatige Einführung und Schulungen erfordert, für die niemand Zeit hat.
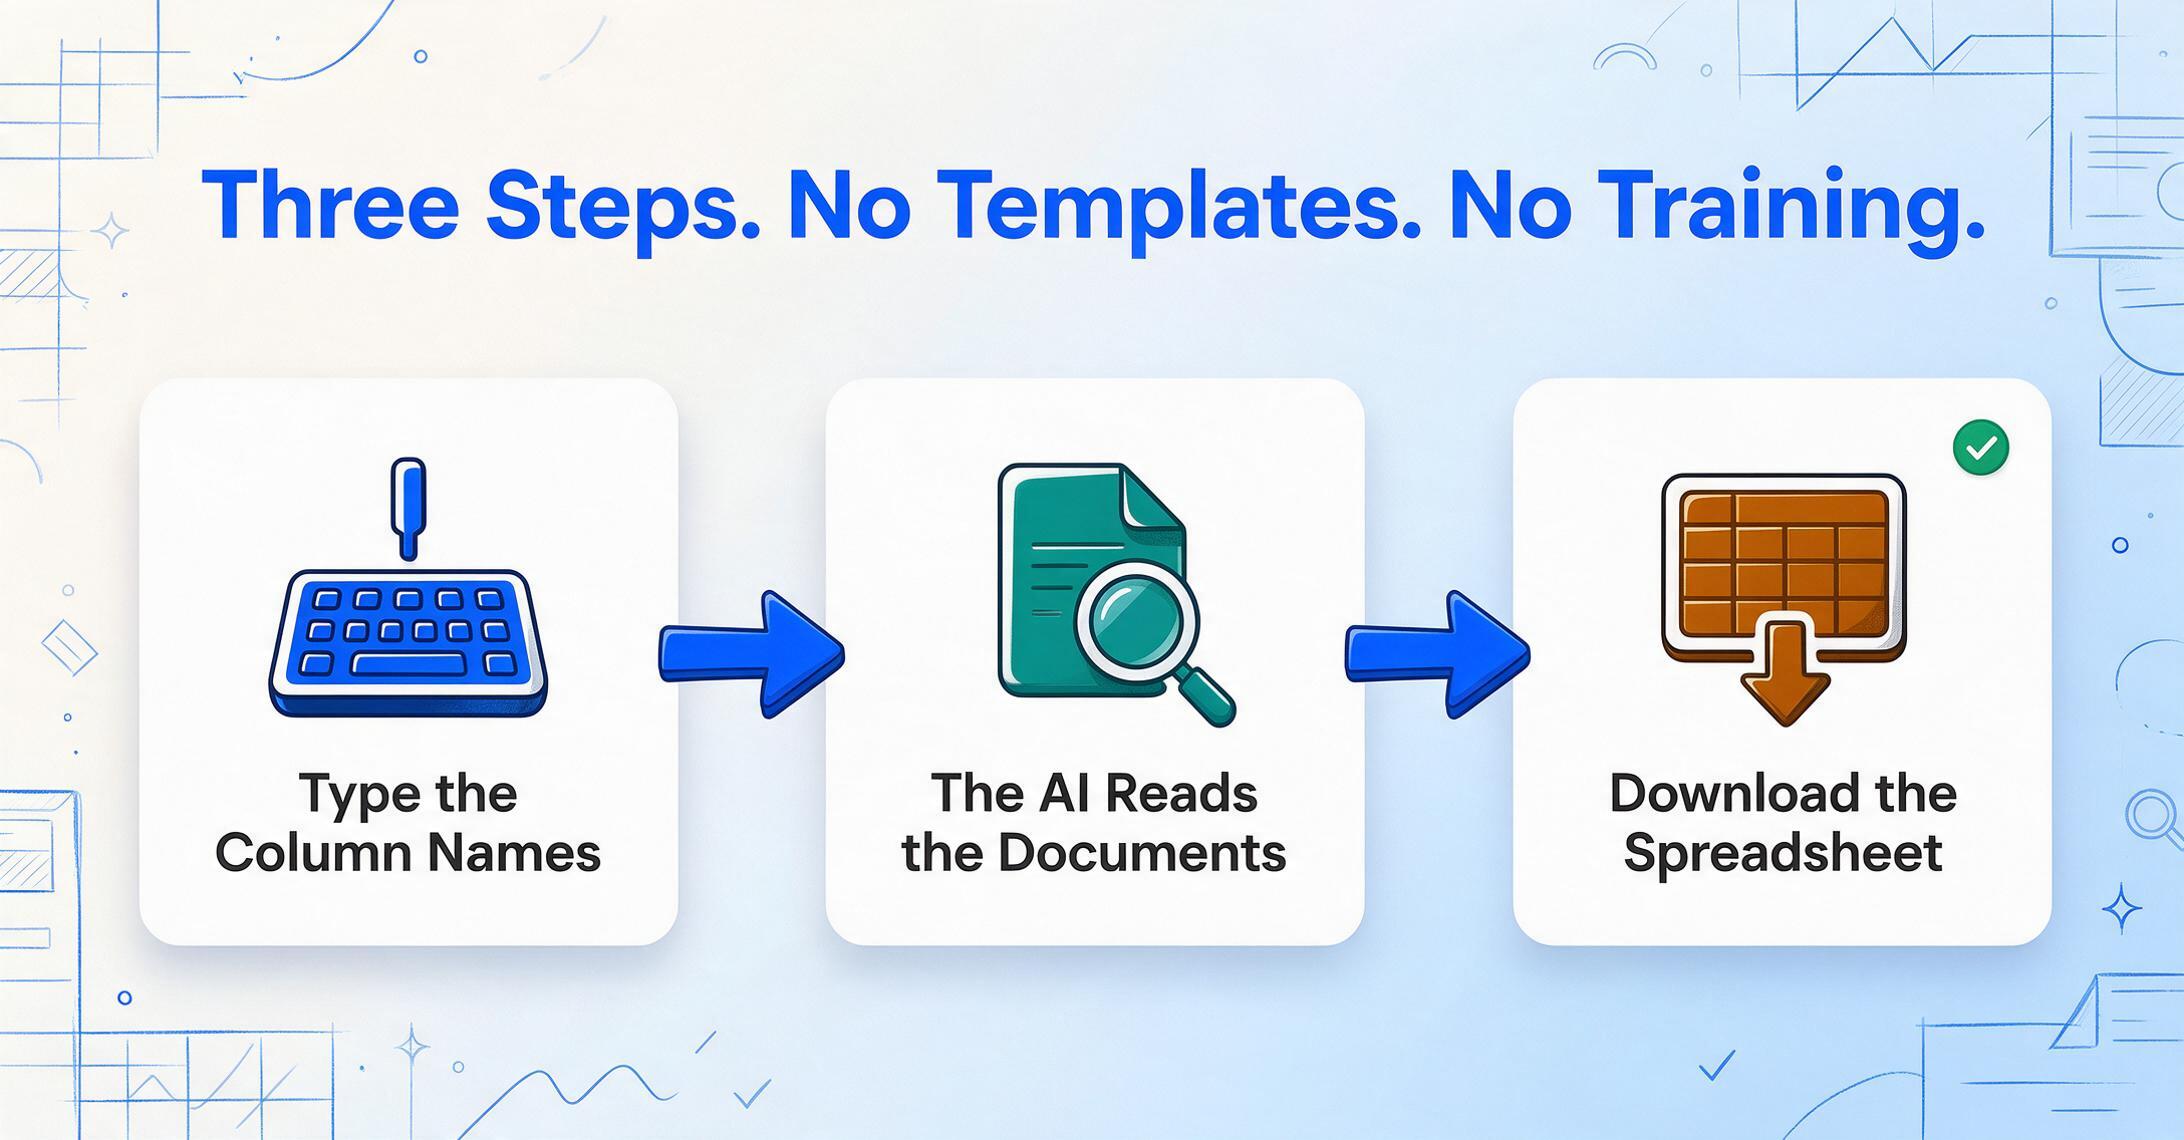
Diese Überzeugung wird vom Markt für Enterprise-Dokumentenverarbeitung verstärkt – wo Tools tatsächlich Implementierungsberater, Vorlagenkonfiguration und monatelanges Modelltraining erfordern. Aber das ist nicht das, was wir hier beschreiben. Der im obigen Demo gezeigte Extraktionsansatz basiert auf einer anderen Prämisse: vorlagenfreie Extraktion ohne Training. Sie erstellen keine Vorlagen. Sie trainieren keine Modelle. Sie konfigurieren keine Parsing-Regeln. Sie geben die gewünschten Spaltennamen ein. Die KI liest die Dokumente. Sie laden die Tabelle herunter.
Das ist alles. Der Kernmechanismus – semantische Extraktion – bedeutet, dass die KI versteht, was ein Feld ist, nicht wo es steht. „Gesamt" ist eine Gesamtsumme, egal ob sie in der unteren rechten Ecke einer PDF-Datei, in der dritten Spalte einer Excel-Datei oder am unteren Rand eines fotografierten Belegs gekritzelt steht. Die KI findet es über die Bedeutung, und die Bedeutung ändert sich nicht, wenn sich das Layout ändert. Für eine Schritt-für-Schritt-Anleitung des spezifischen Workflows finden Sie in unserem Leitfaden zu Rechnungsfeldern in Excel extrahieren die feldweise Einrichtung; für eine ausführlichere Erklärung, wie vorlagenfreie Extraktion über Dokumenttypen hinweg funktioniert, lesen Sie unseren Leitfaden zu semantischer Extraktion ohne Vorlagen.
Technische Kennzahlen: Die Extraktion von Feldern aus gedruckten Dokumenten erreicht eine Genauigkeit von bis zu 99 %. Eine Seite wird in 5–10 Sekunden verarbeitet – die durchschnittliche manuelle Eingabezeit für dieselbe Seite beträgt 3 Minuten, eine 18-fache Effizienzsteigerung. Und es funktioniert mit den Tools, die Sie bereits verwenden. Laden Sie Dateien direkt im Browser hoch. Wenn Sie mit Google Tabellen arbeiten, gibt es eine Seitenleisten-Erweiterung, die Daten direkt in Ihre aktive Tabelle extrahiert – kein Exportieren, kein Importieren, kein Anwendungswechsel. Wenn Sie mit dem Konzept der KI-basierten Extraktion noch nicht vertraut sind, behandelt unsere Einführung in die KI-Dateneingabe die Grundlagen.
Nicht kompliziert. Der komplizierte Teil war, vier Stunden pro Woche für Arbeiten aufzuwenden, die ein Computer in weniger als einer Minute erledigen kann. Der einfache Teil ist das Hochladen Ihrer Dateien, das Benennen Ihrer Spalten und das Herunterladen des Ergebnisses.
FAQ
Funktioniert das mit verschiedenen Dokumentformaten – PDF, gescannte Bilder, Handyfotos?
Ja. Die KI liest Dokumente visuell – sie verarbeitet PDFs, JPGs, PNGs, WebP-Bilder und Screenshots gleichermaßen. Eine gescannte Rechnung, ein Handyfoto eines Papierbelegs und ein digital erstelltes PDF durchlaufen dieselbe Extraktionspipeline. Die Qualität des Quellbilds beeinflusst die Genauigkeit – ein klares, gut beleuchtetes Foto liefert zuverlässigere Ergebnisse als ein unscharfes – aber die Formatvielfalt an sich ist keine Einschränkung.
Kann es handschriftliche Rechnungen verarbeiten?
Ja, mit einer wichtigen Einschränkung. Die KI liest Handschrift deutlich besser als herkömmliche OCR, da sie den umgebenden Kontext nutzt, um mehrdeutige Zeichen aufzulösen – ähnlich wie ein Mensch ein Wort aus dem Rest des Satzes errät. Klare, leserliche Handschrift wird in der Regel mit guter Genauigkeit extrahiert. Stark verschnörkelte, blasse oder beschädigte Handschrift verringert jedoch die Genauigkeit, insbesondere bei kritischen Feldern wie Geldbeträgen. Wenn Ihr Workflow viele handschriftliche Dokumente umfasst, sollten Sie diese Ergebnisse sorgfältiger prüfen.
Muss ich für jeden Anbieter oder jedes Dokumentenlayout Vorlagen erstellen?
Nein. Das ist der Kernunterschied zwischen templatebasierter OCR und KI-Extraktion. Templatebasierte Tools erfordern, dass Sie für jedes Anbieterlayout eine Parsing-Vorlage erstellen und pflegen – und sie aktualisieren, wenn der Anbieter sein Format ändert. Die KI-Extraktion liest jedes Dokument neu ein und lokalisiert Felder anhand ihrer semantischen Rolle („Was auf dieser Seite fungiert als Summe?“) statt anhand der Position. Eine Rechnung eines neuen Anbieters wird genauso verarbeitet wie die eines langjährigen Geschäftspartners. Keine Vorlagen zu erstellen, keine Vorlagen zu pflegen.
Ist das ein großes IT-Projekt, das eine Integration in unser Buchhaltungssystem erfordert?
Nein – und das ist beabsichtigt. Die Ausgabe ist eine Standard-Excel- (XLSX), CSV- oder JSON-Datei, die jedes Buchhaltungssystem importieren kann. Die meisten Teams laden die extrahierte Tabelle herunter und importieren sie im Rahmen ihres bestehenden Workflows in ihr ERP oder ihre Buchhaltungssoftware. Es ist keine API-Integration erforderlich, was bedeutet: kein IT-Projekt, kein Entwickleraufwand und keine Abhängigkeit davon, dass Ihr Softwareanbieter einen bestimmten Connector unterstützt. Für Google Sheets-Nutzer fügt das Seitenleisten-Add-on Daten direkt in Ihr aktives Tabellenblatt ein.
Wie sieht es mit der Sicherheit aus? Meine Rechnungen enthalten vertrauliche Finanzdaten.
Dateien, die über die Demo oder die Hauptanwendung hochgeladen werden, werden sicher verarbeitet und nach Abschluss der Verarbeitung nicht gespeichert. Für Teams mit strengeren Compliance-Anforderungen verarbeitet das Google Sheets-Add-on Daten über dieselbe sichere Pipeline. Der Dienst ist für geschäftliche Finanzdokumente konzipiert – nicht für Verbraucherfotos – und die Architektur spiegelt dies wider.
Kann ich es testen, ohne mich anzumelden oder eine Kreditkarte zu hinterlegen?
Ja. Die eingebettete Demo oben funktioniert sofort – kein Konto, keine Anmeldung, keine Kreditkarte. Sie können jetzt eine Rechnung hochladen und die Extraktionsergebnisse sehen. Die Gast-Demoseite unter dem folgenden Link funktioniert ebenfalls ohne Registrierung. Wenn Sie größere Mengen verarbeiten oder das Google Sheets-Add-on nutzen möchten, schaltet ein kostenloses Konto zusätzliche Kapazitäten frei.
Manuelle Dateneingabe fühlt sich unvermeidlich an – bis man sieht, wie es anders geht. Dann kann man es nicht mehr ignorieren. Testen Sie es mit Ihren eigenen Rechnungen. Keine Anmeldung, keine Vorlagen, keine Konfiguration. Einfach hochladen und sehen, was sich ändert.
Rechnungsextraktion testen – ohne Anmeldung