RMA返品データを
在庫システムに取り込む方法
返品が倉庫に届きます。スタッフが箱を開け、RMAフォームを取り出します。印刷されたPDF、手書きの伝票、あるいは理由コードが走り書きされた返品ラベルのこともあります。そして、RMA番号、SKU、理由コード、状態をスプレッドシートに入力します。そのスプレッドシートは共有ドライブに置かれたまま、在庫管理システムには届きません。あなたの業務において2番目に価値のあるデータセット、つまり「何が返ってきて、なぜ返ってきて、どのような状態だったか」という情報は、クリップボードで止まってしまうのです。
重要ポイント
- 2025年の小売返品額は8,499億ドルに上りますが、各RMAフォームのデータ(何が返ってきて、なぜ返ってきたか)はクリップボードで止まり、在庫システムに届いていません。
- 繁忙期には小売業者の60%が注文の発送と返品処理のどちらかを選ばざるを得ませんでした。転記作業が他の何よりも先に予算を消費してしまうからです。
- あらゆるベンダーのあらゆるRMAフォームを読み取り、構造化データをIMS (在庫管理システム)に直接取り込む抽出ステップを1つ追加するだけで、Shopify、WMS (倉庫管理システム)、倉庫の受入ワークフローを置き換える必要はありません。
返品が生み出す在庫の盲点
全米小売業協会 (NRF) は、2025年の米国小売業における返品総額を8,490億ドルと追跡しました — 全売上の15.8%に相当します。オンライン返品率はさらに高く、19.3%と推定されています。1月だけでも、小売業者はホリデーシーズンの購入の17%が返品されると予想していました。その返品の1件1件の背後には、必ずフォームがあります。RMA伝票、返品承認PDF、ベンダー提供の返品ラベル(欄が印刷されたもの)です。そして、ほとんどのワークフロー図が見落としているのは、そのフォーム上のデータこそが、在庫システムにその商品を在庫に戻すのか、再生処理に回すのか、廃棄するのかを伝えるものだという点です。しかし、ほとんどの現場では、その判断は倉庫の作業台で行われ、関連データ — SKU、理由コード、状態グレード、最終処分 — は紙のフォームに走り書きされたまま、またはどのシステムにも同期されないPDFの中に閉じ込められたままになります。
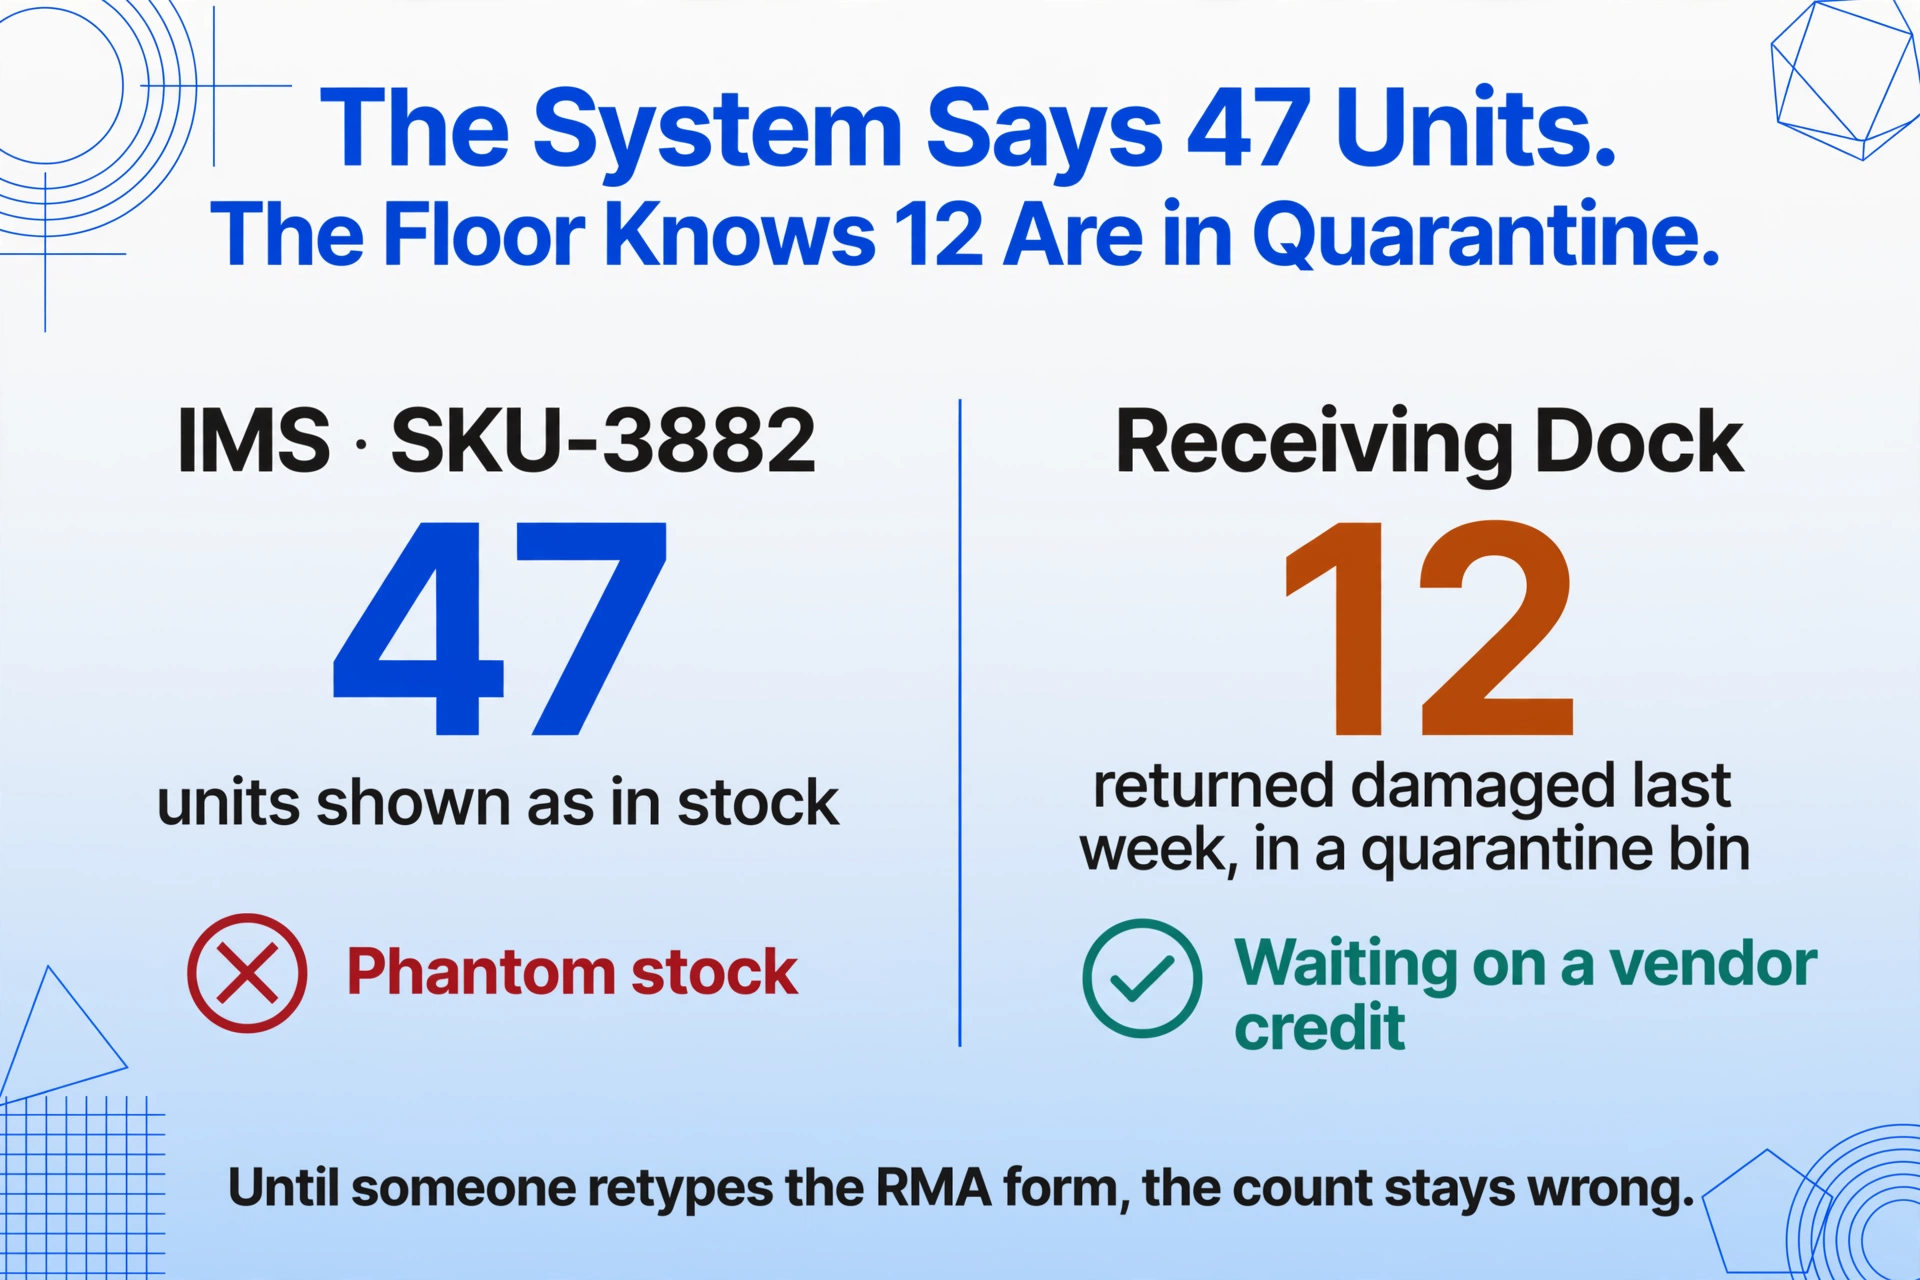
その結果、在庫数は返品サイクルを重ねるごとに実態から乖離していきます。IMSにはSKU-3882が47ユニット在庫として表示されています。倉庫の現場では、そのうち12個は先週、破損したパッケージで返品され、ベンダー返金待ちの隔離ビンに置かれていることを把握しています。しかし、誰かが手動でシステムを更新するまで — それは週末の照合作業まで行われないかもしれません — 在庫システムは間違ったままです。そして、間違った在庫は、過剰販売、販売機会の喪失、そしてファントム在庫に基づく発注を意味します。
RMAデータが失われる場所:入荷ドックでの引き継ぎ
問題はデータが存在しないことではありません。問題は、データがワークフローの間違った段階で、間違った形式で存在することです。ShipStationを使用するShopifyマーチャントの典型的なEコマース返品フローは次のようになります:顧客がShopifyで返品を開始 → ShipStationがRMA番号付きの返品ラベルを生成 → 荷物が倉庫に到着 → スタッフが箱を開け、商品を検査し、RMAフォームを見つけます。フォームにはRMA番号、注文番号、記載された返品理由、そして検査官が記入する必要のある状態チェックリストがよく含まれています。在庫ステータスを更新するために必要なものはすべてそのシートにあります。しかし、検査後の次のステップ — 商品の再入庫 — には、紙ではなくIMSのデータが必要です。そこで誰かが再入力することになります。
Loop Returnsや類似のプラットフォームは、顧客向け返品ポータルとラベル生成を担当します。Narvarは追跡と顧客コミュニケーションを管理します。ShipStationは配送ラベルとキャリアのルーティングを処理します。しかし、これらのツールのいずれも、RMA PDFからフォームデータ — 理由コード、状態、検査官の処分判断 — を抽出して在庫システムに取り込むことはしません。物理的なフォームからシステムレコードへのその引き継ぎは、チェーン内のすべてのツールが他の誰かが埋めてくれると想定している手動のギャップなのです。
NRFの2025年レポートによると、小売業者の60%がピーク期間中に「新規注文の発送か返品処理か」の選択を迫られたと報告しています。このトレードオフが存在するのは、返品処理が労働力を消費するためです — そして最大の労働力要素はデータ転記です。2026年の業界ベンチマークによると、1件の返品処理には、製品タイプと再販可能かどうかに応じて10ドルから65ドルのコストがかかります。そのコストの大部分は、配送や検査ではなく、正しいデータを正しいシステムに入力するのにかかる時間です。
抽出レイヤー:RMAフォームとIMSの間に入るもの
ツールのギャップが生じたときの直感は、新しいツールを探すことです。別の返品管理プラットフォーム、アップグレードしたIMS、返品機能が組み込まれたERPモジュールなどです。しかし、それはフォークリフト移行のようなものです。倉庫スタッフの再教育、Shopify連携の再設定、すでに機能しているShipStationのラベル生成フローを壊す可能性もあります。移行コストは、問題そのもののコストを上回ることがよくあります。
より軽量なアプローチ:抽出レイヤーを追加することです。これは、RMAフォームが倉庫に到着してから在庫記録が更新されるまでの間に位置するステップです。印刷されたPDF、スキャンされた返品伝票、手書きのメモなど、フォームを読み取り、IMSが期待するフィールドスキーマに一致する構造化データ(CSV、XLSX、JSON)を出力します。Shopify、ShipStation、倉庫の受入プロセス、再入庫の棚レイアウトなど、残りのワークフローはそのまま維持されます。既存のステップを置き換えるのではなく、新しいステップを1つ挿入するだけです。
これがカスタム列抽出が可能にするモデルです。ベンダーAは上部にフィールドがあるPDFを使用し、ベンダーBはバーコードと理由コードのドロップダウンが付いた印刷されたポータルページを送り返し、B2B顧客は納品書に「不良バッチ」と走り書きする——すべてのRMAフォームレイアウトに対応する解析テンプレートを構築する代わりに、必要な出力列を定義します:RMA番号、SKU、返品理由、状態、処分方法。AIは各文書を読み取り、ページ上の位置ではなく意味に基づいて各列名に一致する値を特定し、行を埋めます。選択した列名が、IMSのインポートパスに取り込まれるCSVまたはExcelファイルのヘッダーになります。
これは、各レイアウトの各フィールドの周囲にゾーンを描画する必要があるテンプレートベースのOCRとは異なります。15の異なるベンダーやマーケットプレイスからRMAフォームを受け取る場合、それぞれ独自のフォームレイアウトを持つため、テンプレートベースのツールでは15のテンプレートが必要になります。セマンティック抽出では、同じ列名セットが15の形式すべてで機能します。形式は無関係になります。重要なのは、文書にRMA番号、SKU、返品理由が含まれていることであり、AIがそれらを見つけ出します。最大のサプライヤーが来四半期にフォームレイアウトを変更しても、何も壊れません。更新するテンプレートも、再描画するゾーンも、再設定する下流プロセスもありません。抽出は、ソース形式に関係なく同じスプレッドシートを生成します。
このワークフローにはRMA専用のプリセットはありません——また、その必要もありません。固定テンプレートがないことがまさに要点です。抽出は、文書がどうあるべきかという事前構築された想定ではなく、定義した列から始まります。完全なフィールドセット、混合形式のバッチアップロード、エクスポートオプションのチュートリアルについては、RMAからExcelへの変換ツールをご覧ください。
ファイルは安全に処理され、保存されません。
RMAフィールドを在庫フィールドにマッピングする方法: 抽出すべき項目
抽出レイヤーがIMSで利用できないデータを出力する場合、ブリッジは役に立ちません。重要な設計上の決定は列マッピングです。抽出列の名前をどう付けるかによって、出力ファイルを直接インポートできるか、手動での再フォーマットが必要になるかが決まります。目標は、抽出とインポートの間でゼロ操作を実現することです。
以下は、Zoho InventoryまたはCin7を利用するShopifyマーチャント向けの標準的なRMAからIMSへのフィールドマッピングの例です:
| RMAフォームのフィールド | 抽出列名 | IMSターゲットフィールド | 備考 |
|---|---|---|---|
| RMA番号 | RMA Number | 返品ID / 参照番号 | 監査証跡のために、この返品レコードを元のRMAにリンクします |
| 元の注文番号 | Order Number | 販売注文参照 | 返金調整のために、返品を元の販売に接続します |
| SKU / 製品コード | SKU | 品目コード / SKU | IMSのSKU形式と正確に一致する必要があります — 大文字小文字と区切り文字が重要です |
| 返品数量 | Qty Returned | 返品数量 | 在庫調整に直接反映されます |
| 返品理由 | Return Reason | 返品理由コード | IMSが数値コードを使用する場合は、別のインポート手順としてルックアップテーブルを追加します |
| 商品状態 | Condition | 在庫ステータス / グレード | 商品が「販売可能」「検疫」「廃棄」のいずれに分類されるかを決定します |
| 処分方法 (推論) | Disposition (options: Restock / Refurbish / RTV / Liquidate / Dispose) | 倉庫ルート / ビン割り当て | 推論列 — AIが状態と理由を読み取り、経路を決定します。フォーム自体には存在しないフィールドです |
| 顧客 / ベンダー名 | Customer Name | 返品者 | ベンダークレジットを追跡する必要があるB2B返品に役立ちます |
Disposition列はこのマッピングで推論抽出を使用しています。これはRMAフォームに誰かが記入したフィールドではありません。代わりに、AIが理由コードと状態を読み取ります — 「不良品」+「梱包破損」→ ベンダー返品へ振り分け。「サイズ違い」+「未開封」→ 再入庫。オプションは列名自体で定義し、AIがフォームの内容に基づいて行ごとに正しいものを割り当てます。これにより、倉庫監督者が各品目の行き先を手動で決定し、別のスプレッドシートに入力する手順が不要になります。抽出出力にはすでに振り分け指示が組み込まれています。
組織がRMA返品データをExcelで追跡してきた独立したプロセスがある場合、手動追跡で使用していた同じ列定義をここで再利用できます — 唯一の違いは、出力がスプレッドシートで止まるのではなく、IMS内に直接入ることです。また、すでに返金照合のためにRMAフォームをバッチ処理している場合、バッチフローは同じです — フォームを一度アップロードし、すべての行を1つのファイルで取得し、一度インポートするだけです。
ステップバイステップ: 他の何にも触れずにRMAデータをシステムに取り込む
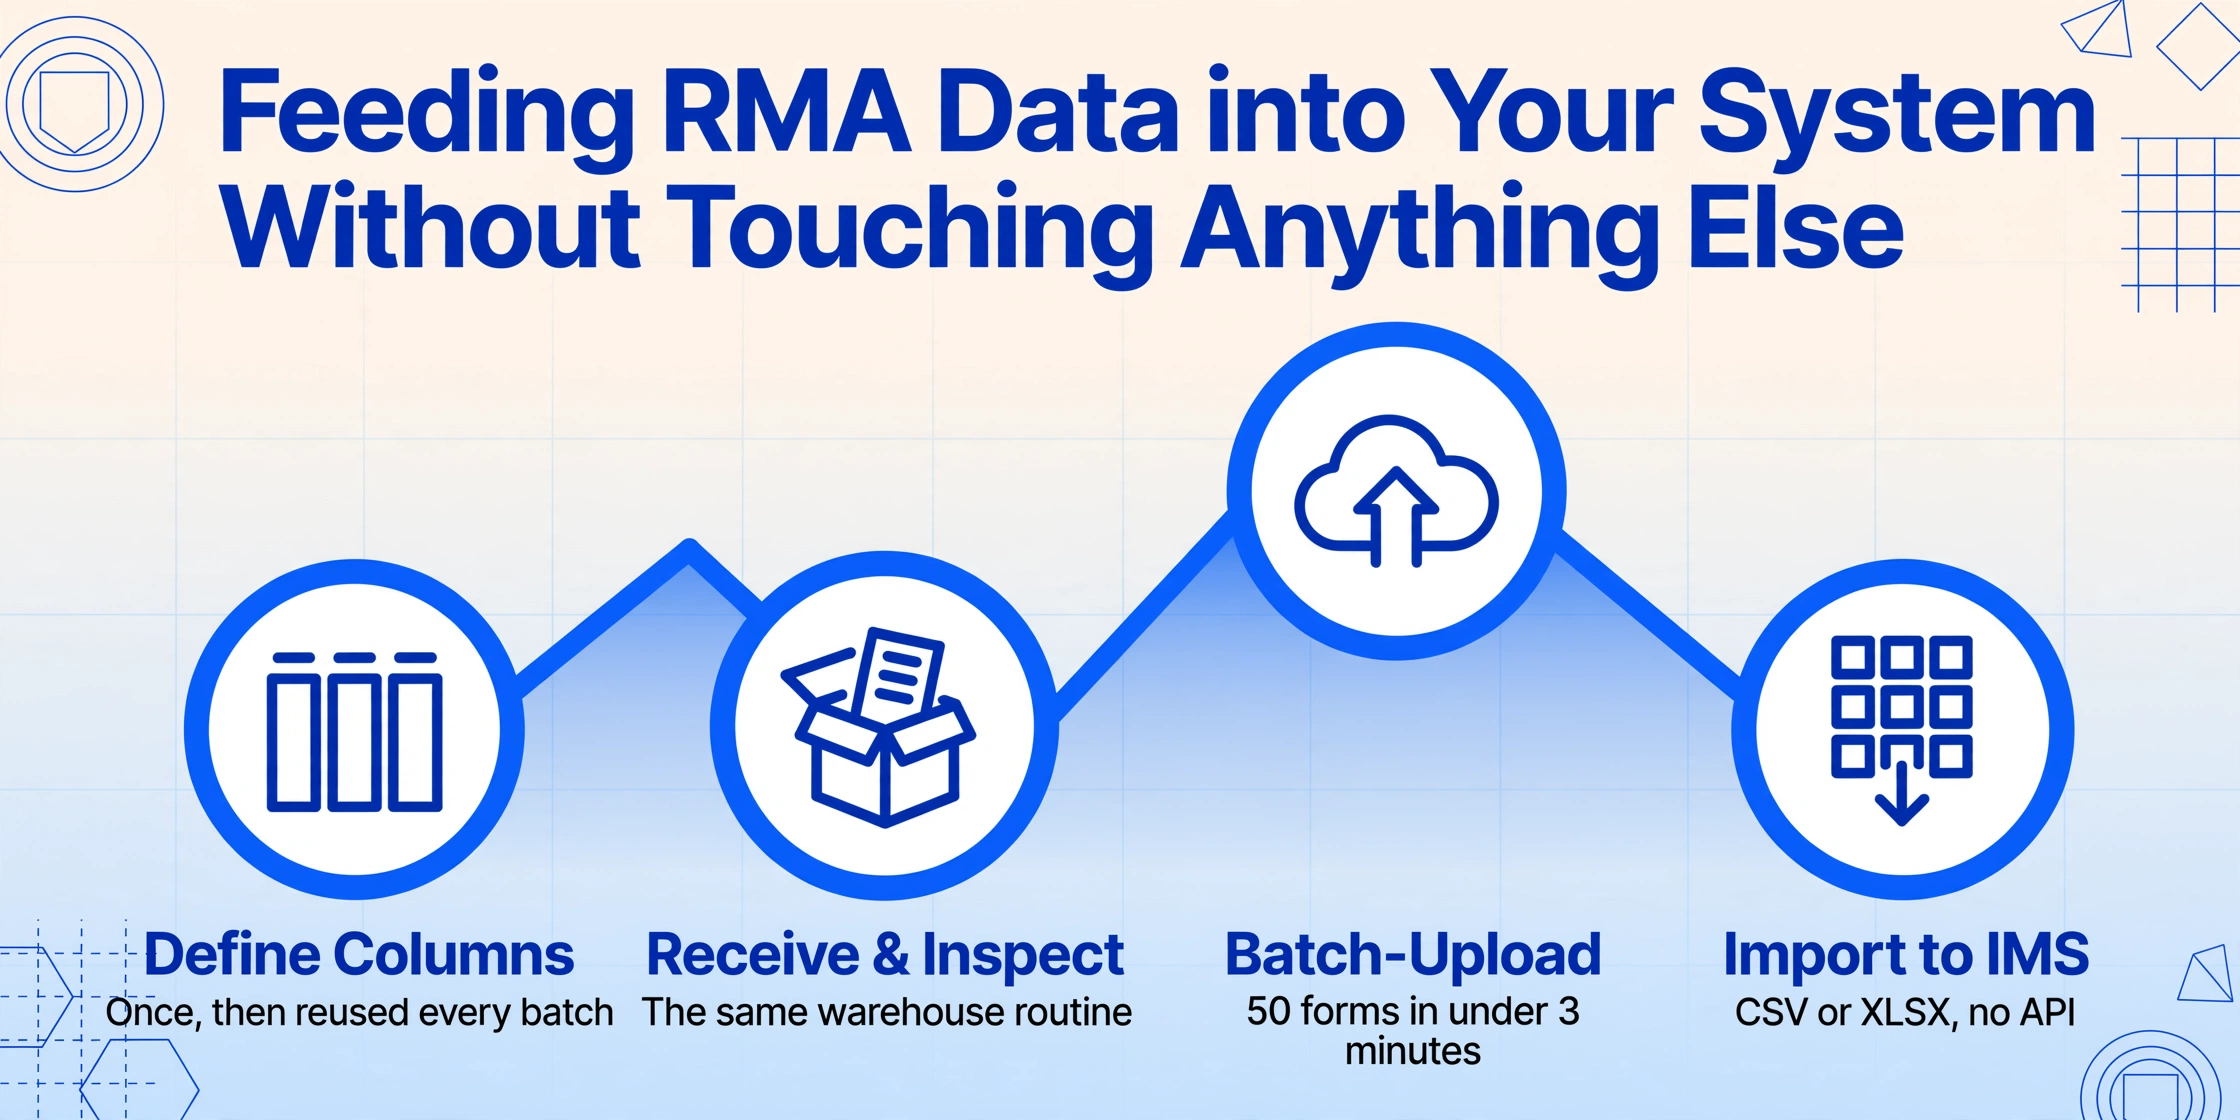
このワークフローは、既存の返品プロセスにちょうど1つの挿入ポイントで収まります: 物理検査の後、在庫更新の前です。典型的なShopify + IMS運用にどのように組み込まれるかを次に示します:
これはIMSの代替ではありません。返品管理プラットフォームの代替でもありません。これはそれらを接続するステップです — RMAフォームのフィールドをIMSレコードに変換するデータパイプラインです。ストアフロントにはShopify、出荷ラベルにはShipStation、顧客返品ポータルにはLoopまたはAfterShip、在庫管理にはIMSを引き続き使用します。新しい部分は、フォームをそれらのシステムが利用できる形に変換する抽出処理だけです。
すでに在庫元帳エントリ用の仕入先請求書データを処理したことがあれば、このパターンの筋肉記憶はすでにできています — バッチでドキュメントを入れ、構造化データを出し、一度インポートする。同じ原則がここにも当てはまります。入荷ドックでのドキュメントの種類が異なるだけです。
ベンダーがRMAフォームを変更するとどうなるか
ワークフロー統合に対する繰り返しの反対意見は脆弱性です。パイプラインを構築し、3ヶ月間は機能するが、その後ベンダーがRMAフォームを再設計すると全体が壊れてしまう。これはテンプレートベースの抽出における正当な懸念です。ゾーンベースのOCRツールは、フィールドの位置が変わると失敗します。また、大規模な返品業務ではテンプレートのメンテナンスがフルタイムの負担になる理由でもあります。サプライヤーが書類を更新するたびに、誰かがゾーンを描き直さなければならないからです。
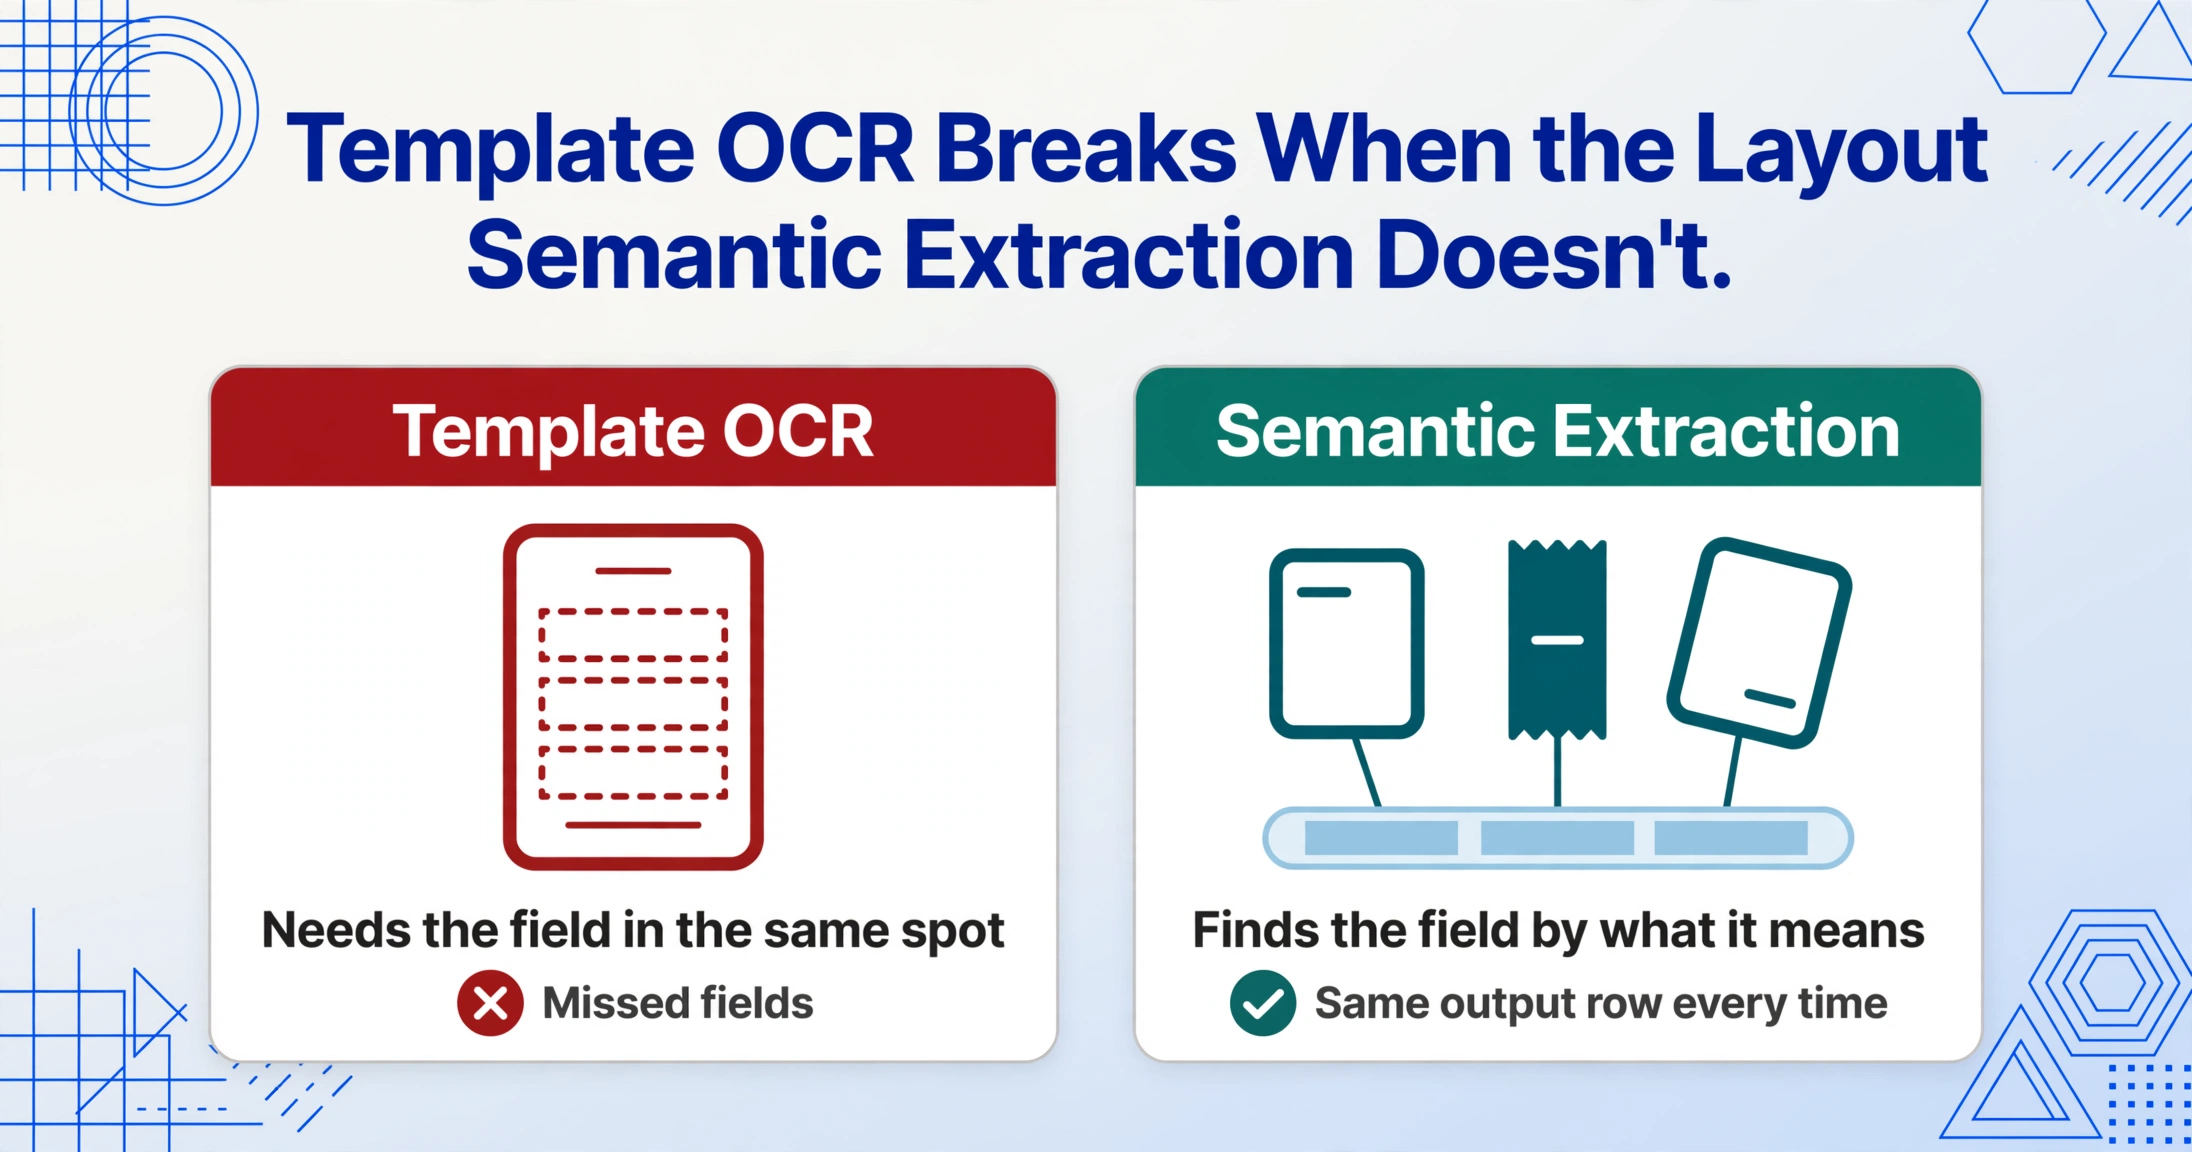
セマンティック抽出はこれを異なる方法で処理します。抽出はフィールドの位置やレイアウトに依存しません。フィールドの意味に依存します。RMA番号は、ブランド化されたPDFの右上隅に印刷されていようと、返品伝票の中央に手書きされていようと、人間が読めるテキストが隣にあるバーコードラベルに埋め込まれていようと、RMA番号です。AIは人間と同じ方法でそれを見つけます。テキストがどこにあるかではなく、何を意味するかを認識することによって。これが、位置ベースの抽出(テンプレートOCRが行うこと)とセマンティックベースの抽出(「このページのRMA番号を見つけて」と指示したときにビジョン言語モデルが行うこと)の実際的な違いです。
複数の販売チャネルからの返品を扱う倉庫チームにとって — ここではShopifyの注文、あそこではAmazon FBAの返品、卸売顧客からのB2B返品、別の書類セットでの保証請求 — このフォーマット非依存性こそが、抽出レイヤーを単一の挿入ポイントとして viable にするものです。同じ列定義が再設定なしで全てのRMAフォーマットで機能する場合、15の抽出パイプラインを維持しているわけではありません。1つを維持しているのです。
これは手書きのRMAフォームにも及びます。これは、返品顧客が倉庫カウンターで紙の伝票に記入するB2Bおよび卸売返品で今でも一般的です。チームが手書きの倉庫伝票を日次在庫ログに処理した経験があれば、パターンは同じです。AIは印刷されたテキストと同じように手書きを読み取ります。ボールペンで走り書きされたRMA番号も、Helveticaで組版されたものと同じように抽出可能です。定義した抽出列 — RMA番号 — はフォントや媒体を気にしません。意味を気にするのです。
よくある質問
この機能を使うためにIMSを変更する必要がありますか?
いいえ。抽出結果は標準のCSVまたはXLSXファイルです。お使いのIMSがスプレッドシートをインポートできるのであれば(Zoho Inventory、Cin7、NetSuite、Finale Inventory、Sellercloudなど主要なIMSはすべて対応しています)、出力ファイルは既に使用している一括在庫更新のインポートパスからそのまま取り込めます。API連携、ミドルウェア、新しいコネクタの保守は一切不要です。IMSにCSVインポートボタンがあれば、すぐにご利用いただけます。
RMAフォームにマッピングテーブルに記載されているフィールドがすべて揃っていない場合はどうなりますか?
AIは各フォームに存在するフィールドのみを抽出し、残りは空白のままにします。フォームにRMA番号とSKUはあるが返品理由がない場合、その2つの列はデータが入り、理由の列は空欄になります。出力に空のセルが含まれるのは正常であり、インポートエラーの原因にはなりません。お使いのIMSはオプションフィールドのnull値を適切に処理できます。すべてのフォームですべての列を埋める必要はありません。
手書きの返品伝票でも機能しますか?
はい。基盤となる抽出エンジンは、手書き文字、筆記体、印刷テキストを同等の能力で読み取ります。倉庫作業員が梱包伝票に手書きした「RMA #4421 — 留め具破損 — ベンダー返品」は、返品ポータルからの鮮明なPDFと同様に構造化された行として出力されます。重要なのは手書きが判読可能であることです。人間が読める文字であれば、AIも読み取れます。ひどく汚れていたり判読不能な文字は、手動転記と同様にエラーが発生します。
LoopやAfterShipのような返品管理プラットフォームとはどのように連携しますか?
これらのプラットフォームは返品のフロントエンド(顧客ポータル、返品ラベル、追跡)を管理します。「この返品はどこにあるのか?」という問いに答えるものです。物理的なRMAフォーム自体からデータを抽出するわけではありません。倉庫での受領後に追加する抽出レイヤーがそのギャップを埋めます。顧客体験とラベル生成にはLoopを引き続きご利用いただき、フォームデータからIMSへの受け渡しには抽出機能を追加します。両者は補完関係にあり、競合しません。
この方法で、全チャネルにわたる返品理由のトレンドを追跡できますか?
はい、可能です。そして、これこそがシステム全体としての真の価値が発揮されるポイントです。Shopify、Amazon、B2B、保証など、あらゆるチャネルからのRMAデータが一つの構造化された出力に集約されれば、統一されたデータセットが手に入ります。SKUレベルの返品理由、状態グレード、処分方法、タイムスタンプ — これらすべてが一つのテーブルにまとまります。このデータセットがあれば、どのSKUの不良率が22%なのか、どの理由コードが第4四半期に急増するのか、どのベンダーの製品が最も多くのRTV(ベンダー返品)クレームを発生させているのかが一目でわかります。抽出のステップがなければ、このデータセットは存在しません。情報は、誰も集計しないPDFや手書きの伝票に散在したままになります。
RMAフォームに記載されている内容と在庫システムが把握している内容のギャップは、技術的なギャップではなく、引き継ぎのギャップです。返品処理チェーンの各システムは、フォームデータを別のシステムが処理することを前提としています。抽出レイヤーは誰も構築していない部分です。現在、返品フォーム1件につき90秒のコストがかかっています。データが紙のままである限り、毎日在庫精度のコストがかかります。さらに、どの製品を修正すべきか、どのベンダーと再交渉すべきか、ストアフロントの製品説明を改善すればどの返品理由を排除できるかを教えてくれる理由コードデータのコストもかかっています。
初回の抽出にはサインアップは不要です