Como Alimentar Dados de Devolução RMA
no Seu Sistema de Inventário
Uma devolução chega ao seu armazém. Um funcionário abre a caixa, retira o formulário RMA — pode ser um PDF impresso, um bilhete manuscrito ou uma etiqueta de devolução com um código de motivo rabiscado — e digita o número RMA, o SKU, o código de motivo e a condição em uma planilha. Essa planilha fica em um drive compartilhado. Ela nunca chega ao seu sistema de gestão de inventário. O segundo conjunto de dados mais valioso da sua operação — o que voltou, por que voltou e em que condição — para em um clipboard.
Principais Conclusões
- US$ 849,9 bilhões em devoluções no varejo em 2025 e os dados de cada formulário RMA — o que voltou e por quê — pararam em um clipboard em vez de chegar ao sistema de inventário.
- 60% dos varejistas tiveram que escolher entre enviar pedidos e processar devoluções durante a alta temporada porque o trabalho de transcrição consome o orçamento antes de qualquer outra coisa.
- Adicione uma única etapa de extração que lê qualquer formulário RMA de qualquer fornecedor e insere dados estruturados no seu IMS (sistema de gestão de inventário) — sem substituir o Shopify, seu WMS (sistema de gestão de armazém) ou seu fluxo de recebimento no armazém.
O Punto Ciego de Inventário Que os Devolutions Criam
A National Retail Federation rastreou $849.9 bilhões em devoluciones no varejo dos EUA em 2025 — 15,8% de todas as vendas. As taxas de devolución online são mais altas, estimadas em 19,3%. Só em janeiro, os varejistas anteciparam que 17% das compras de feriado voltarían. Atrás de cada uma dessas devoluciones há um formulário: o slip de RMA, o PDF de autorização de devolución, a etiqueta de devolución fornecida pelo vendedor com campos impressos. E aqui está a parte que a maioria dos diagramas de fluxo de trabalho omite: os dados nesse formulário são o que diz ao seu sistema de inventário se o artigo volta ao stock, à reacondicionamento ou à eliminação. Mas na maioria das operações, essa decisão é tomada no banco do armazém, e os dados associados — SKU, código de motivo, grau de condição, disposição final — ficam anotados em um formulário de papel ou bloqueados dentro de um PDF que nunca se sincroniza com nenhun sistema.
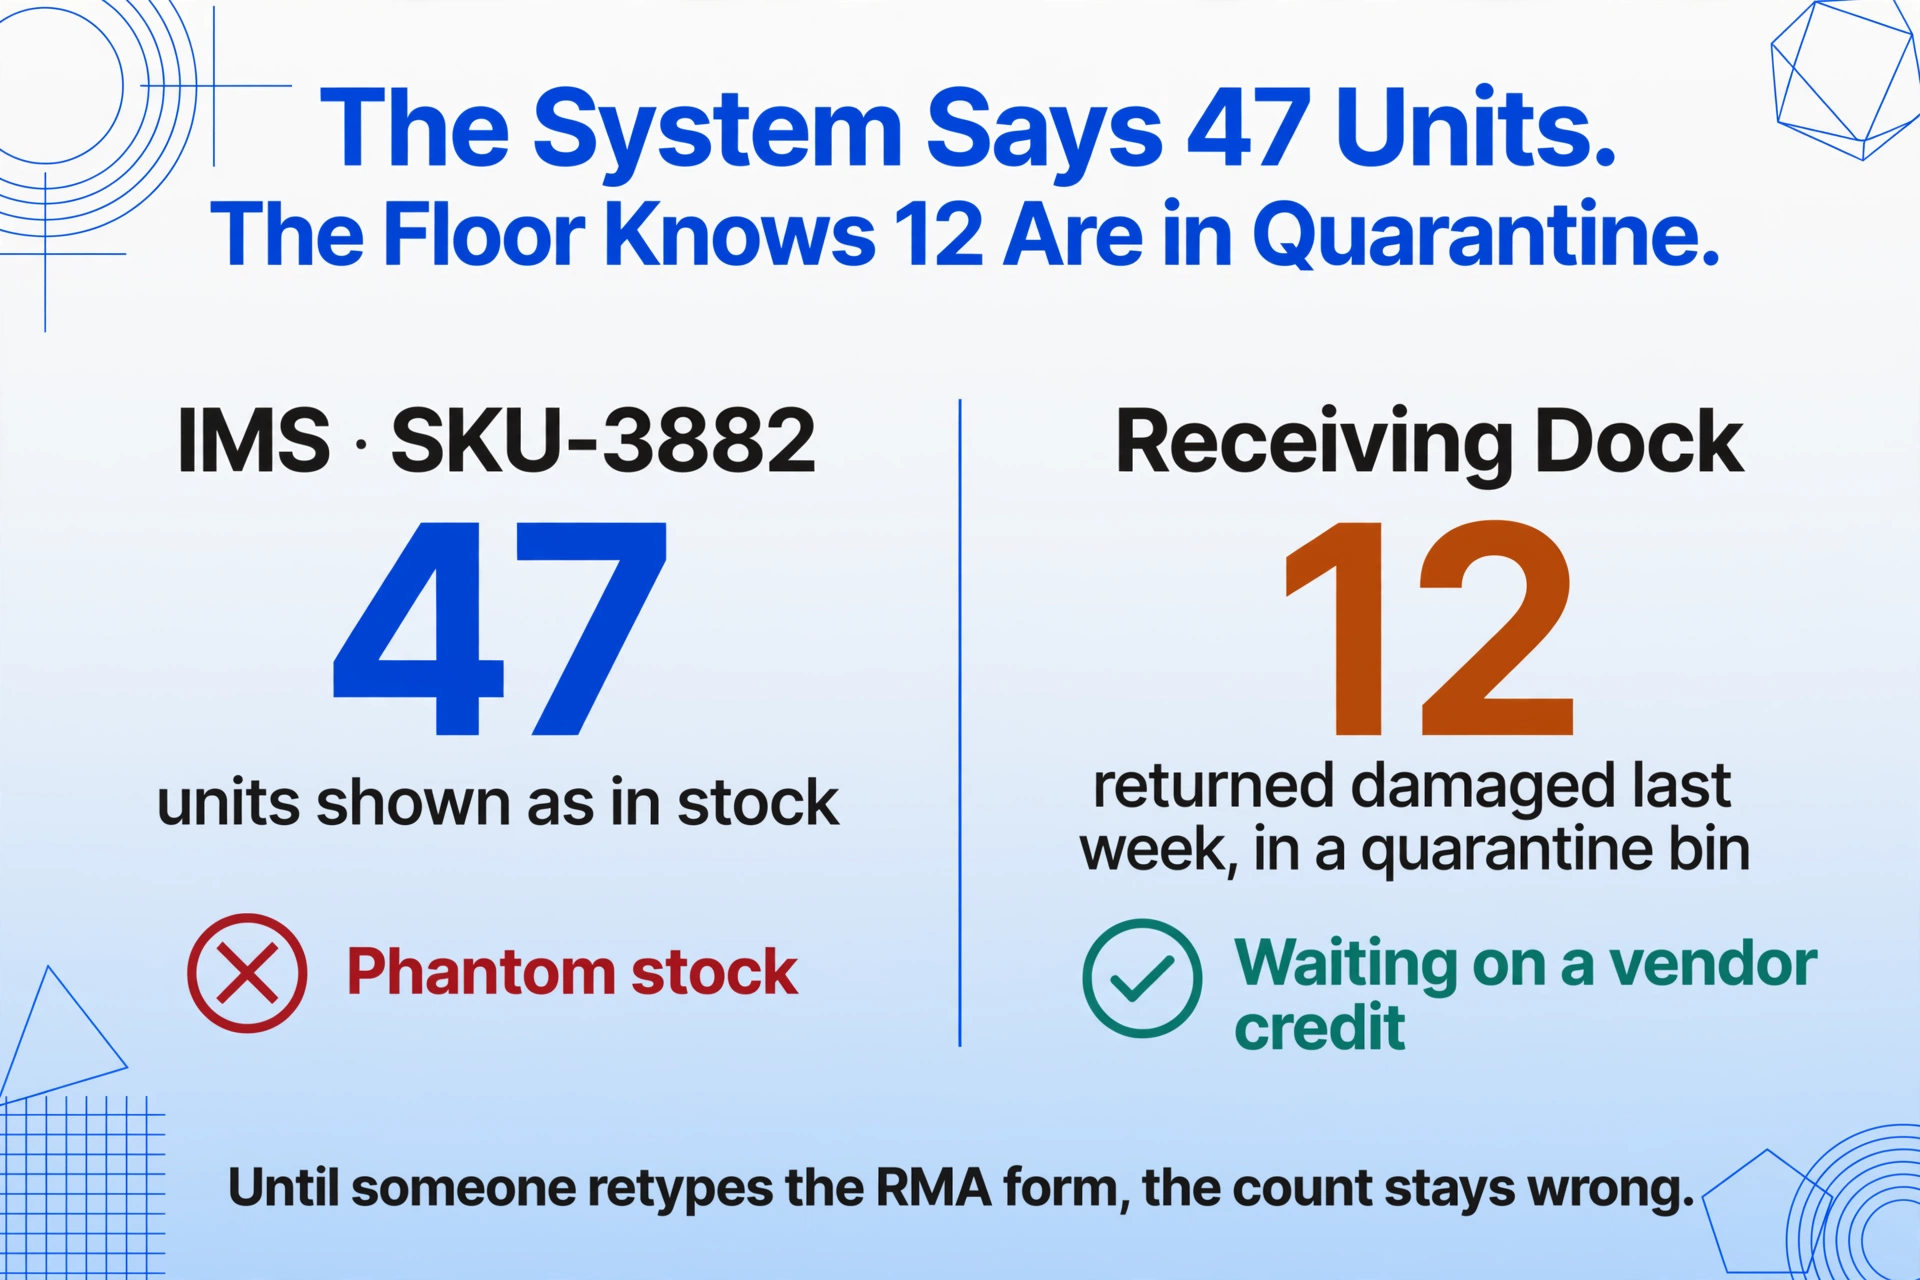
O resultado é uma contagem de inventário que se afasta cada vez mais da realidade com cada ciclo de devolución. Seu IMS diz que você tem 47 unidades de SKU-3882 em stock. O piso do armazém sabe que 12 dessas voltaron la semana passada com embalagem danada e estão em uma caixa de quarentena esperando um crédito do fornecedor. Mas até que alguém atualize manualmente o sistema — o que pode acontecer na conciliación de fin de semana — seu sistema de inventário está errado. E inventário errado significa sobrevender, subvender e ordens de compra baseadas em stock fantasma.
Onde os Dados de RMA se Perdem: A Transferência no Cais de Recepção
O problema não é que os dados não existam. O problema é que existem no formato errado na etapa errada do fluxo de trabalho. Um fluxo de devolución de e-commerce típico para um comerciante de Shopify que usa ShipStation se parece assim: o cliente inicia a devolución através de Shopify → ShipStation gera uma etiqueta de devolución com um número de RMA → o pacote chega ao armazém → o pessoal abre a caixa, inspecciona o artigo, encontra o formulário de RMA. O formulário tem o número de RMA, o número de pedido, o motivo de devolución listado e, muitas vezes, uma lista de verificação de condição que o inspector precisa preencher. Tudo o que é necessário para atualizar o estado do inventário está nessa folha. Mas o próximo passo depois da inspección — reponer o artigo — requer dados no IMS, não em papel. Então alguien os reescribe.
Loop Returns e plataformas similares manejam o portal de devolución voltado ao cliente e a generación de etiquetas. Narvar maneja o rastreo e a comunicación com o cliente. ShipStation maneja a etiqueta de envío e o roteamento da transportadora. Mas nenhuna dessas ferramentas extrae os dados do formulário do PDF de RMA — o código de motivo, a condição, a disposición do inspector — e os alimenta em seu sistema de inventário. Essa transferência — do formulário físico ao registro do sistema — é uma lacuna manual que toda ferramenta na cadena assume que outra pessoa preencherá.
Según o informe de 2025 da NRF, 60% dos varejistas informaron ter que escolher entre "enviar novos pedidos ou processar devoluciones" durante períodos pico. Essa compensación existe porque o processamento de devoluciones consome trabalho — e o maior componente individual de trabalho é a transcripción de datos. Processar uma única devolución custa entre $10 e $65 dependendo do tipo de produto e de se o artigo pode ser revendido, según benchmarks da industria de 2026. A maior parte desse custo não é o envío ou a inspección — é o tempo que leva para colocar os dados corretos no sistema correto.
A Camada de Extração: O Que Fica Entre Seus Formulários de RMA e Seu IMS
O instinto quando surge uma lacuna de ferramenta é procurar uma nova ferramenta — uma plataforma diferente de gestão de devoluções, um IMS atualizado, um módulo de ERP com funcionalidade de devoluções integrada. Mas isso é uma migração pesada. Significa retreinar a equipe do armazém, reconfigurar sua integração com o Shopify, possivelmente quebrar o fluxo de geração de etiquetas do ShipStation que já funciona. O custo da migração muitas vezes excede o custo do problema.
Uma abordagem mais leve: adicionar uma camada de extração. Esta é uma etapa que fica entre o formulário de RMA que chega ao armazém e o registro de inventário que é atualizado. Ela lê o formulário — seja um PDF impresso, um comprovante de devolução escaneado, uma anotação manuscrita — e gera dados estruturados (CSV, XLSX ou JSON) que correspondem ao esquema de campos que seu IMS espera. O restante do seu fluxo de trabalho — Shopify, ShipStation, o processo de recebimento do armazém, o layout das prateleiras de reposição — permanece exatamente como está. Você está inserindo uma nova etapa, não substituindo nenhuma das existentes.
Este é o modelo que a Extração de Colunas Personalizadas permite. Em vez de criar modelos de parsing para cada layout de formulário de RMA — seu fornecedor A usa um PDF com campos no topo, o fornecedor B envia de volta uma página de portal impressa com código de barras e um menu suspenso de código de motivo, e um cliente B2B rabisca "lote defeituoso" em um comprovante de remessa — você define quais colunas de saída precisa: Número do RMA, SKU, Motivo da Devolução, Condição, Destinação. A IA lê cada documento, localiza os valores que correspondem a cada nome de coluna com base no que eles significam — não onde estão na página — e preenche as linhas. Os nomes de coluna que você escolher se tornam os cabeçalhos do arquivo CSV ou Excel que entra no caminho de importação do seu IMS.
Isso é diferente do OCR baseado em modelo, que exige que você desenhe zonas ao redor de cada campo em cada variante de layout. Se você recebe formulários de RMA de 15 fornecedores ou marketplaces diferentes — cada um com seu próprio layout de formulário — você precisaria de 15 modelos com uma ferramenta baseada em modelo. Com extração semântica, o mesmo conjunto de nomes de coluna funciona em todos os 15 formatos. O formato se torna irrelevante. O que importa é que o documento contenha um número de RMA, um SKU e um motivo de devolução — e a IA os encontra. Quando seu maior fornecedor mudar o layout do formulário no próximo trimestre, nada quebra. Nenhum modelo para atualizar. Nenhuma zona para redesenhar. Nenhum processo downstream para reconfigurar. A extração produz a mesma planilha independentemente do formato de origem.
Não há um preset específico de RMA para este fluxo de trabalho — nem precisa haver. A ausência de um modelo fixo é exatamente o ponto. A extração começa das colunas que você define, não de uma suposição pré-construída sobre como o documento deveria ser. Para um passo a passo do conjunto completo de campos, upload em lote de formato misto e opções de exportação, consulte o conversor de RMA para Excel.
Os arquivos são processados com segurança e não são armazenados.
Mapeando Campos de RMA para Campos de Inventário: O Que Extrair
Se a camada de extração gerar dados que seu IMS (sistema de gestão de inventário) não consegue consumir, a ponte é inútil. A decisão de design mais importante é o mapeamento de colunas: como você nomeia suas colunas de extração determina se o arquivo de saída pode ser importado diretamente ou exige reformatação manual. O objetivo é zero manipulação entre extração e importação.
Veja como é um mapeamento padrão de campos de RMA para IMS (sistema de gestão de inventário) para um lojista da Shopify que usa Zoho Inventory ou Cin7:
| Campo do Formulário de RMA | Nome da Coluna de Extração | Campo de Destino no IMS | Observações |
|---|---|---|---|
| Número do RMA | RMA Number | ID de Devolução / Número de Referência | Vincula este registro de devolução ao RMA original para trilha de auditoria |
| Número do Pedido Original | Order Number | Referência do Pedido de Venda | Conecta a devolução à venda original para conciliação de reembolsos |
| SKU / Código do Produto | SKU | Código do Item / SKU | Deve corresponder exatamente ao formato de SKU do seu IMS — maiúsculas/minúsculas e delimitadores importam |
| Quantidade Devolvida | Qty Returned | Qtd. de Devolução | Alimenta diretamente o ajuste de estoque |
| Motivo da Devolução | Return Reason | Código do Motivo da Devolução | Se seu IMS usa códigos numéricos, adicione uma tabela de consulta como etapa separada de importação |
| Condição do Item | Condition | Status do Estoque / Classificação | Determina se o item vai para "Vendável", "Quarentena" ou "Baixa" |
| Disposição (coluna inferida) | Disposition (options: Restock / Refurbish / RTV / Liquidate / Dispose) | Rota de Armazém / Atribuição de Bin | Coluna inferida — a IA lê condição + motivo e decide o caminho. Não é um campo do formulário em si |
| Nome do Cliente / Fornecedor | Customer Name | Devolvido Por | Útil para devoluções B2B em que o crédito do fornecedor precisa ser rastreado |
A coluna Disposition neste mapeamento usa extração inferida: não é um campo que alguém preencheu no formulário de RMA. Em vez disso, a IA lê o código de motivo e a condição — "Defeituoso" + "Embalagem danificada" → encaminhar para devolução ao fornecedor. "Tamanho errado" + "Não aberto" → reposição. Você define as opções no próprio nome da coluna, e a IA atribui a opção correta por linha com base no que o formulário diz. Isso elimina a etapa em que um supervisor de armazém decide manualmente o destino de cada item e digita em uma planilha separada. A saída da extração já vem com a instrução de roteamento incorporada.
Se sua organização tem acompanhado dados de devoluções RMA no Excel como um processo independente, as mesmas definições de coluna que funcionaram para o acompanhamento manual podem ser reutilizadas aqui — a única diferença é que a saída agora chega ao seu IMS (sistema de gestão de inventário) em vez de parar em uma planilha. E se você já processou formulários de RMA em lote para conciliação de reembolsos, o fluxo em lote é idêntico — envie os formulários uma vez, obtenha todas as linhas em um arquivo, importe uma vez.
Passo a Passo: Alimentando Dados de RMA no Seu Sistema Sem Alterar Mais Nada
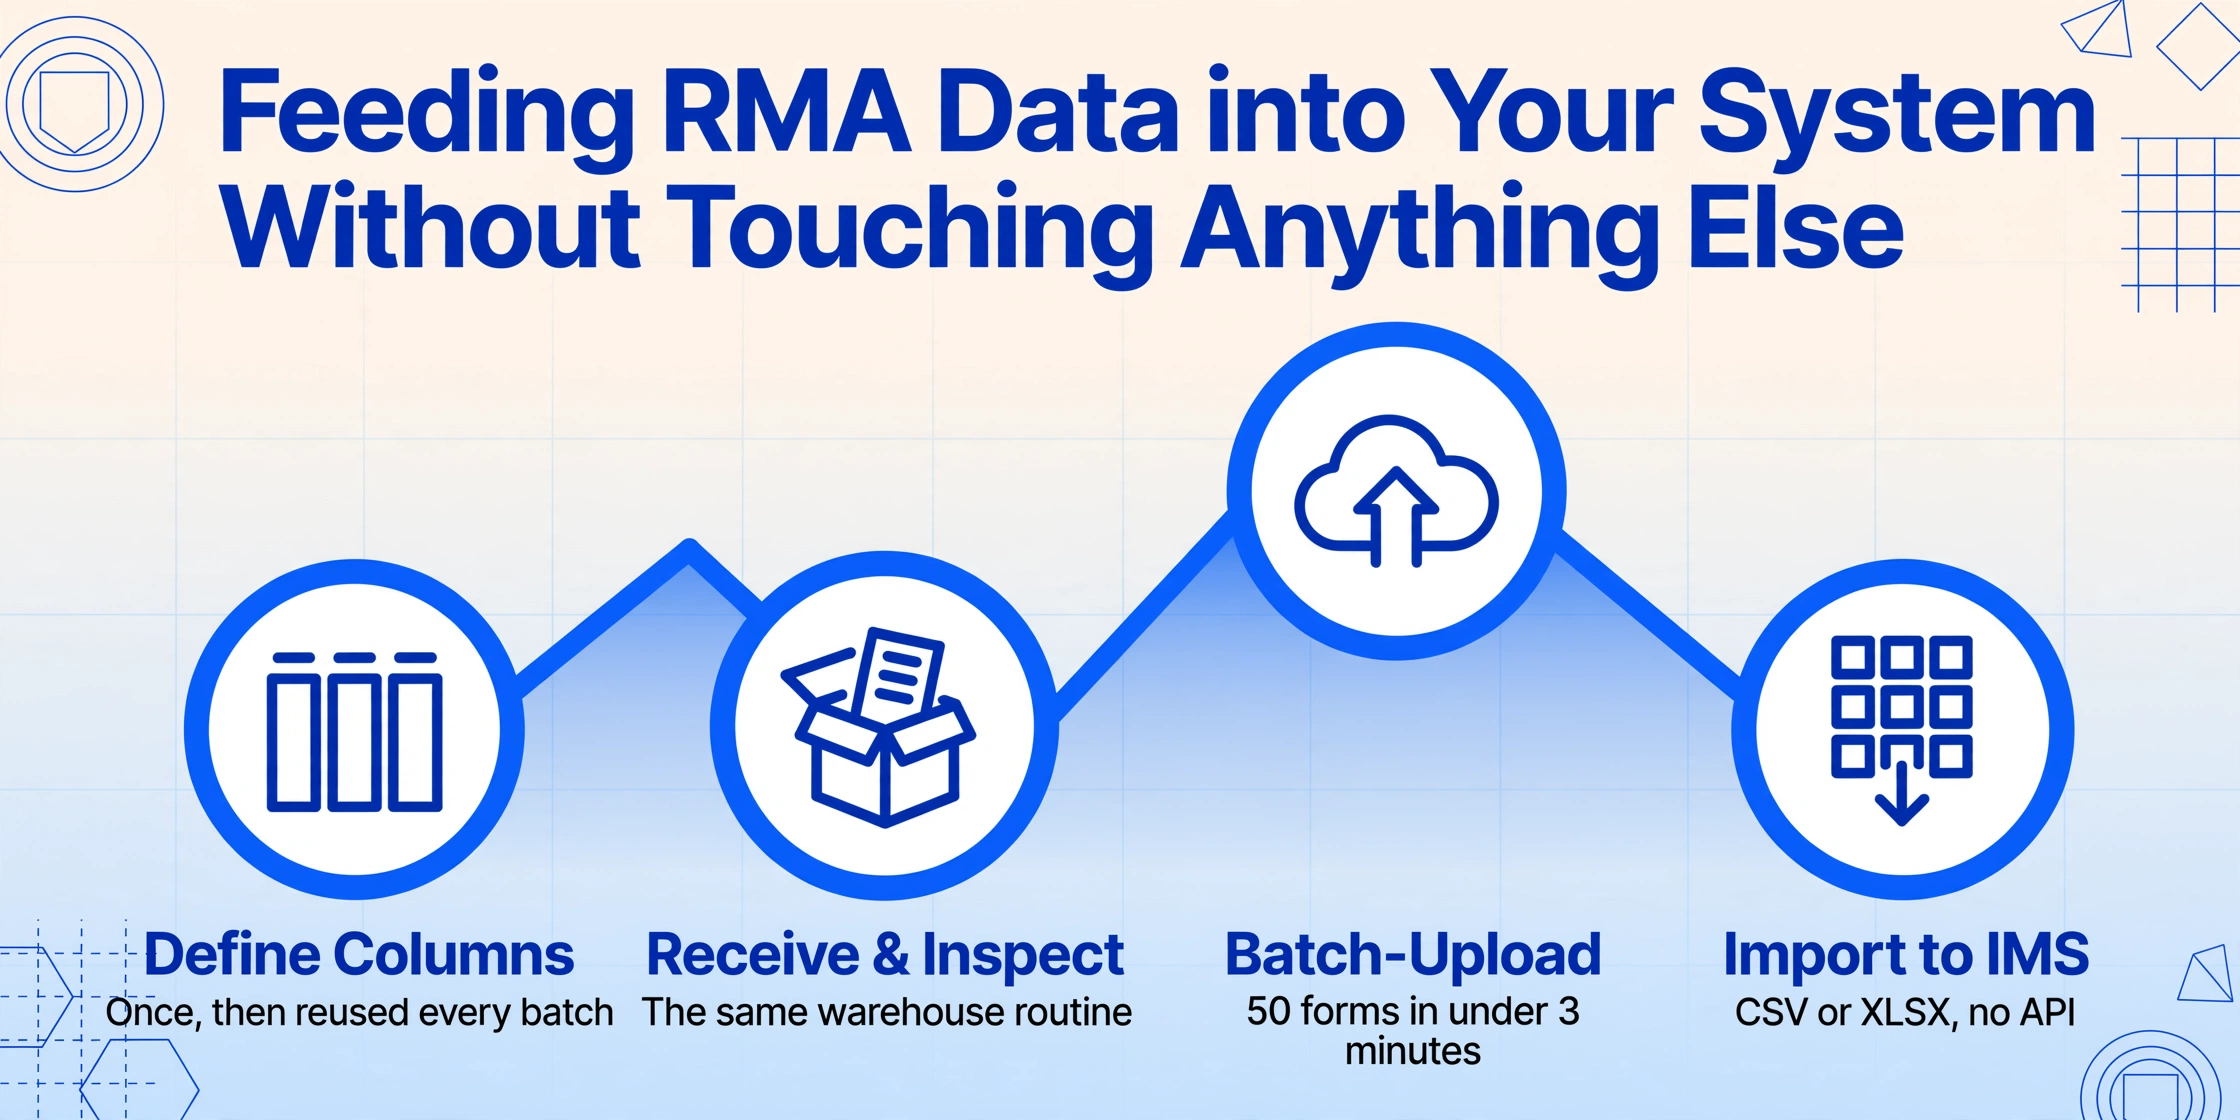
O fluxo de trabalho se encaixa no seu processo de devoluções existente em exatamente um ponto de inserção: após a inspeção física, antes da atualização de inventário. Veja como ele se integra em uma operação típica de Shopify + IMS:
Isso não substitui o seu IMS. Não substitui a sua plataforma de gestão de devoluções. É a etapa que os conecta — um pipeline de dados que converte os campos do formulário de RMA em registros do IMS. Você mantém o Shopify para a loja virtual, o ShipStation para etiquetas de envio, o Loop ou AfterShip para o portal de devoluções do cliente e o seu IMS para o inventário. A única novidade é a extração que transforma os formulários em algo que esses sistemas possam consumir.
Se você também já lidou com dados de faturas de fornecedores para lançamentos no livro de inventário, você já construiu a memória muscular para esse padrão — documentos em lote na entrada, dados estruturados na saída, importação única. O mesmo princípio se aplica aqui, apenas com um tipo diferente de documento no dock de entrada.
O Que Acontece Quando os Fornecedores Alteram Seus Formulários de RMA
Uma objeção recorrente a qualquer integração de fluxo de trabalho é a fragilidad: você constrói o pipeline, ele funciona por três meses, depois um fornecedor redesenha seu formulário de RMA e tudo desmorona. Esta é uma preocupação legítima com a extração baseada em modelos — as ferramentas de OCR baseadas em zonas falham quando as posições dos campos se deslocam. É também por isso que a manutenção de modelos se torna uma sobrecarga de tempo completo em operações de devolução em grande escala: alguém precisa redesenhar zonas toda vez que um fornecedor atualiza sua papelada.
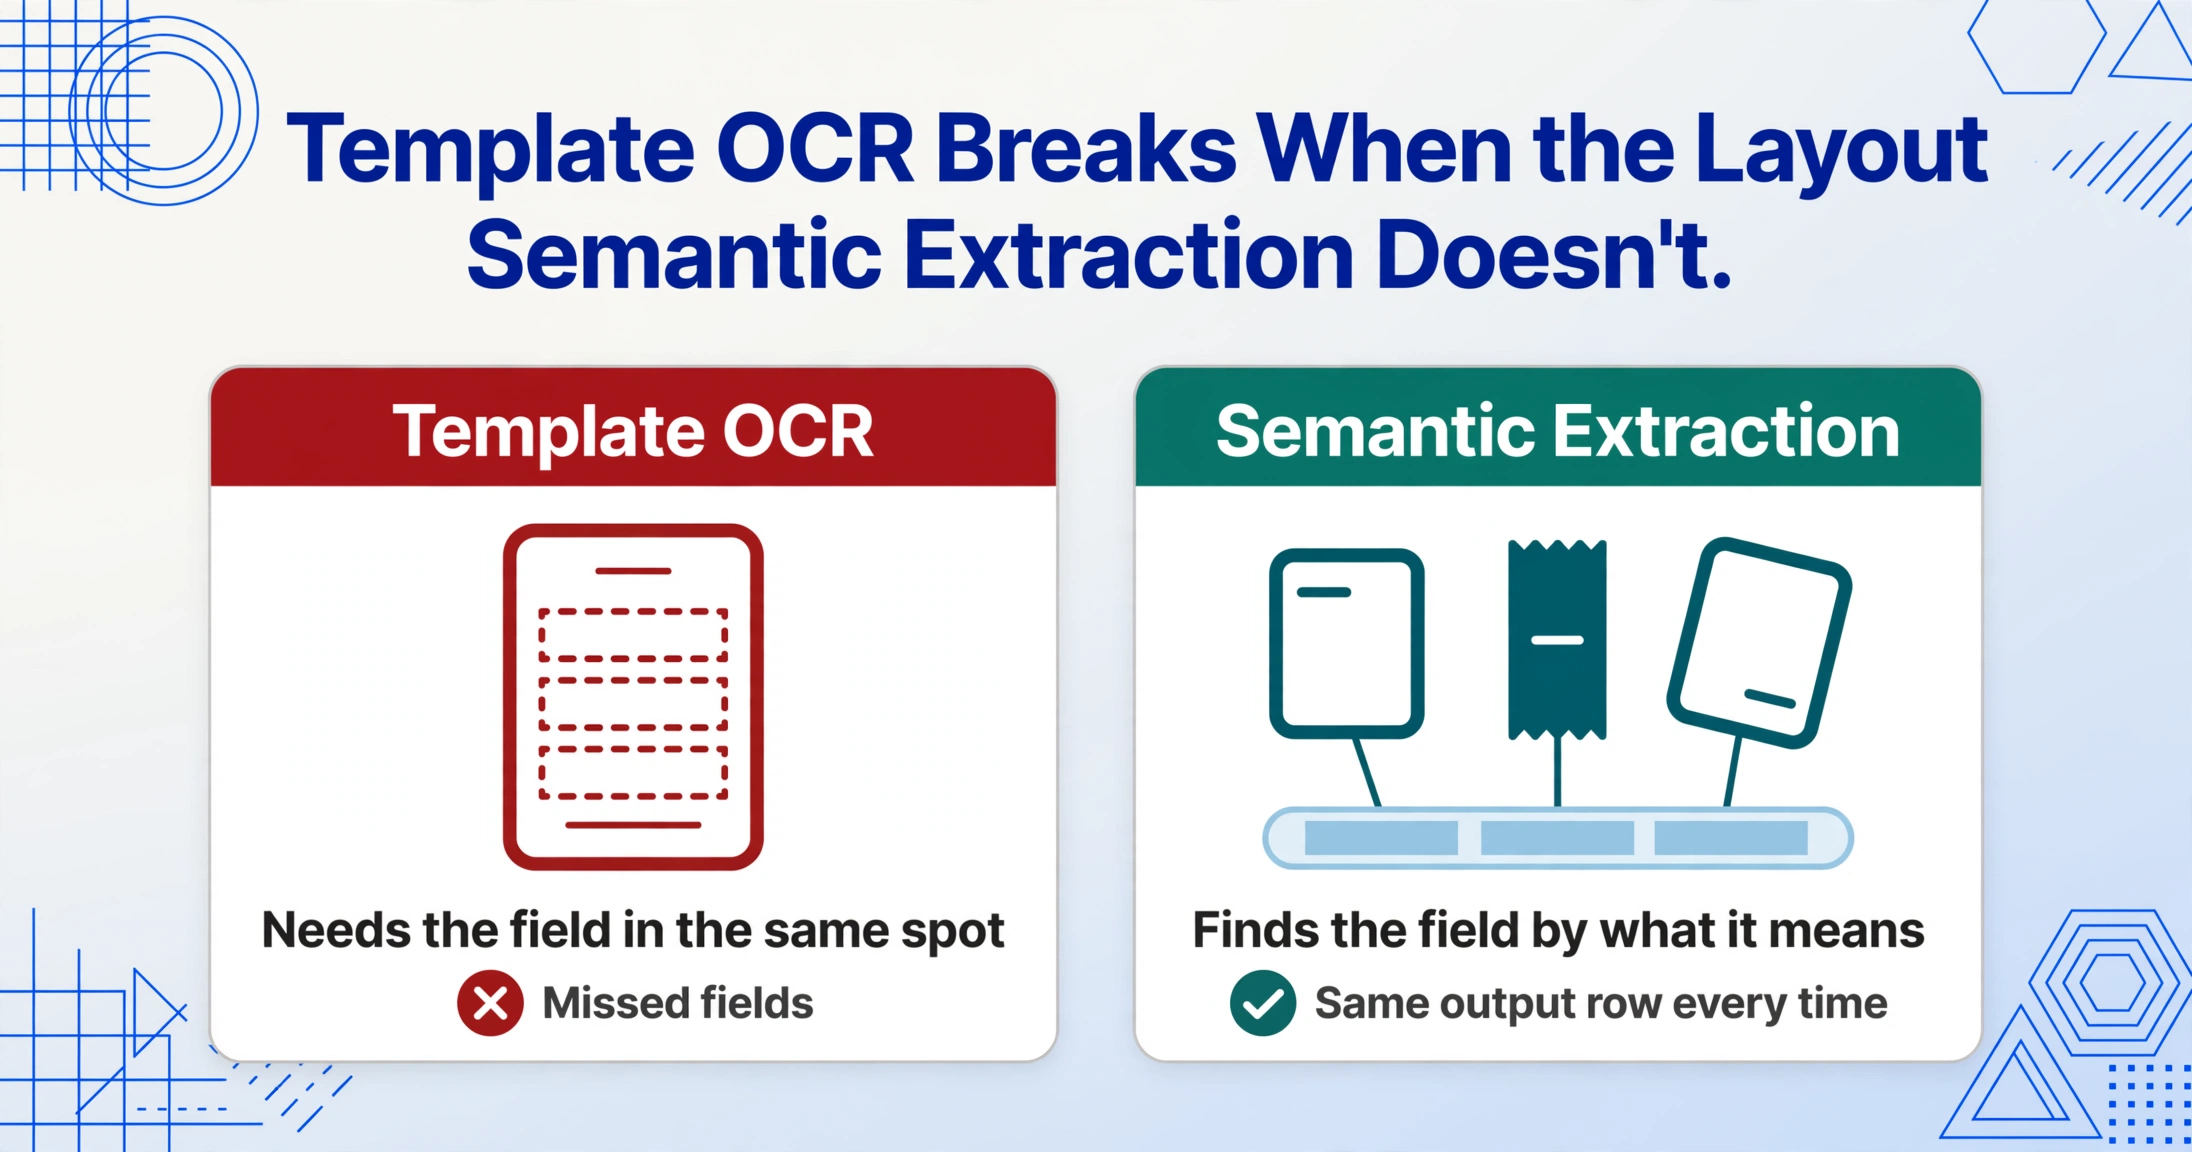
A extração semântica lida com isso de maneira diferente. A extração não depende das posições dos campos ou do layout. Depende do significado dos campos. Um número de RMA é um número de RMA, seja impresso no canto superior direito de um PDF com marca, escrito à mano no meio de um comprovante de devolução, ou embebido em uma etiqueta de código de barras com texto legible ao lado. A IA o localiza da mesma maneira que uma pessoa faría — reconhecendo o que o texto significa, não onde está. Esta é a diferença prática entre extração baseada em posição (que é o que o OCR por modelo faz) e extração baseada em semântica (que é o que um modelo de linguagem visual faz quando você lhe diz "encontre o número de RMA nesta página").
Para equipes de armazém que lidam com devoluções de múltiples canales de vendas — um pedido de Shopify aqui, uma remoção de Amazon FBA ali, uma devolución B2B de um cliente atacadista, uma reclamación de garantía em um conjunto diferente de papelada — esta independencia de formato é o que torna a capa de extracción viable como um único punto de inserción. Quando a mesma definición de columna funciona em todos los formatos de RMA sin reconfiguración, você não está manteniendo 15 pipelines de extracción. Você está manteniendo uno.
Esto también se extiende a los formularios de RMA escritos a mano — aún comunes en devoluciones B2B y mayoristas donde el cliente devolutor llena un comprobante en papel en el mostrador del almacén. Si tu equipo ha procesado comprobantes de almacén escritos a mano en registros de inventario diarios, el patrón es idéntico: la IA lee la escritura a mano de la misma manera que lee texto impreso. Un número de RMA garabateado en bolígrafo es tan extraíble como uno compuesto en Helvetica. La columna de extracción que definiste — RMA Number — no le importa la fuente ni el medio. Le importa el significado.
Perguntas Frequentes
Preciso alterar meu IMS (sistema de gestão de inventário) para isso funcionar?
Não. A saída da extração é um arquivo CSV ou XLSX padrão. Se o seu IMS consegue importar uma planilha — e todo grande IMS consegue, incluindo Zoho Inventory, Cin7, NetSuite, Finale Inventory e Sellercloud — a saída entra pelo mesmo caminho de importação que você já usa para atualizações em massa de estoque. Sem integração de API, sem middleware, sem novo conector para manter. Se seu IMS tem um botão de importar CSV, você está pronto.
E se meus formulários de RMA não tiverem todos os campos listados na tabela de mapeamento?
A IA extrai apenas os campos presentes em cada formulário e deixa os demais em branco. Se um formulário tem um número de RMA e um SKU, mas não tem motivo da devolução, você recebe essas duas colunas preenchidas e a coluna de motivo vazia. Células vazias na saída são normais — elas não causam erros de importação. Seu IMS lida com valores nulos em campos opcionais. Você não é obrigado a preencher todas as colunas em todos os formulários.
Isso funciona com notas de devolução escritas à mão?
Sim. O mecanismo de extração subjacente lê escrita à mão, cursiva e texto impresso com igual capacidade. O "RMA nº 4421 — fecho quebrado — devolver ao fornecedor" escrito à mão por um funcionário do armazém em um comprovante de remessa produz a mesma linha estruturada que um PDF nítido de um portal de devoluções. O ponto principal é que a caligrafia seja legível — se um humano consegue ler, a IA consegue ler. Escrita severamente borrada ou ilegível gerará erros, assim como na transcrição manual.
Como isso se encaixa com plataformas de gestão de devoluções como Loop ou AfterShip?
Essas plataformas gerenciam a parte frontal das devoluções — o portal do cliente, a etiqueta de devolução, o rastreamento. Elas respondem à pergunta "onde está essa devolução?". Elas não extraem os dados do formulário físico de RMA em si. A camada de extração que você adiciona após o recebimento no armazém preenche essa lacuna. Você mantém o Loop para a experiência do cliente e a geração de etiquetas. Você adiciona a extração para o handoff dos dados do formulário para o IMS. Os dois são complementares, não conflitantes.
Posso acompanhar as tendências de motivo de devolução em todos os canais com esta abordagem?
Sim — e é aqui que reside o retorno em nível de sistema. Quando os dados de RMA de todos os canais (Shopify, Amazon, B2B, garantia) alimentam uma única saída estruturada, você tem um conjunto de dados unificado: motivos de devolução por SKU, notas de condição, disposições e carimbos de data/hora — tudo em uma única tabela. Este é o conjunto de dados que mostra qual SKU tem uma taxa de defeito de 22%, qual código de motivo atinge o pico no 4º trimestre e quais produtos de qual fornecedor geram mais reclamações de devolução ao fornecedor. Sem a etapa de extração, este conjunto de dados não existe — as informações permanecem dispersas em PDFs e formulários manuscritos que ninguém consolida.
A lacuna entre o que seus formulários RMA dizem e o que seu sistema de inventário sabe não é uma lacuna tecnológica — é uma lacuna de transferência. Cada sistema na sua cadeia de devoluções assume que outro sistema lida com os dados do formulário. A camada de extração é a peça que ninguém construiu. Ela custa 90 segundos por formulário de devolução hoje. Ela custa a precisão do inventário todos os dias em que os dados permanecem no papel. E custa os dados de código de motivo que, de outra forma, diriam quais produtos corrigir, com quais fornecedores renegociar e quais motivos de devolução você pode eliminar com melhores descrições de produtos na sua loja virtual.
Sem necessidade de cadastro para sua primeira extração