Cómo introducir los datos de devolución RMA
en su sistema de inventario
Una devolución llega a su almacén. Un miembro del personal abre la caja, saca el formulario RMA — puede ser un PDF impreso, una nota manuscrita o una etiqueta de devolución con un código de motivo garabateado — y escribe el número RMA, el SKU, el código de motivo y la condición en una hoja de cálculo. Esa hoja de cálculo vive en una unidad compartida. Nunca llega a su sistema de gestión de inventario. El segundo conjunto de datos más valioso de su operación — qué devolvieron, por qué y en qué condición — se detiene en un portapapeles.
Conclusiones clave
- $849.9 mil millones en devoluciones minoristas en 2025 y los datos de cada formulario RMA — qué devolvieron y por qué — se detuvieron en un portapapeles en lugar de llegar al sistema de inventario.
- El 60% de los minoristas tuvo que elegir entre enviar pedidos y procesar devoluciones durante la temporada alta porque el trabajo de transcripción consume el presupuesto antes de que ocurra cualquier otra cosa.
- Agregue un solo paso de extracción que lea cualquier formulario RMA de cualquier proveedor y envíe datos estructurados a su IMS (sistema de gestión de inventario) — sin reemplazar Shopify, su WMS (sistema de gestión de almacenes) ni su flujo de recepción en el almacén.
El punto ciego del inventario que crean las devoluciones
La National Retail Federation (NRF) registró $849.9 mil millones en devoluciones en el comercio minorista de EE. UU. en 2025, un 15.8% de todas las ventas. Las tasas de devolución en línea son más altas, estimadas en un 19.3%. Solo en enero, los minoristas anticiparon que el 17% de las compras navideñas regresarían. Detrás de cada una de esas devoluciones hay un formulario: el comprobante RMA, el PDF de autorización de devolución, la etiqueta de devolución proporcionada por el proveedor con campos impresos. Y aquí está la parte que la mayoría de los diagramas de flujo omiten: los datos de ese formulario son los que le indican a su sistema de inventario si el artículo vuelve a stock, pasa a reacondicionamiento o se desecha. Pero en la mayoría de las operaciones, esa decisión se toma en el banco de trabajo del almacén, y los datos asociados (SKU, código de motivo, grado de condición, disposición final) quedan anotados en un formulario en papel o encerrados en un PDF que nunca se sincroniza con ningún sistema.
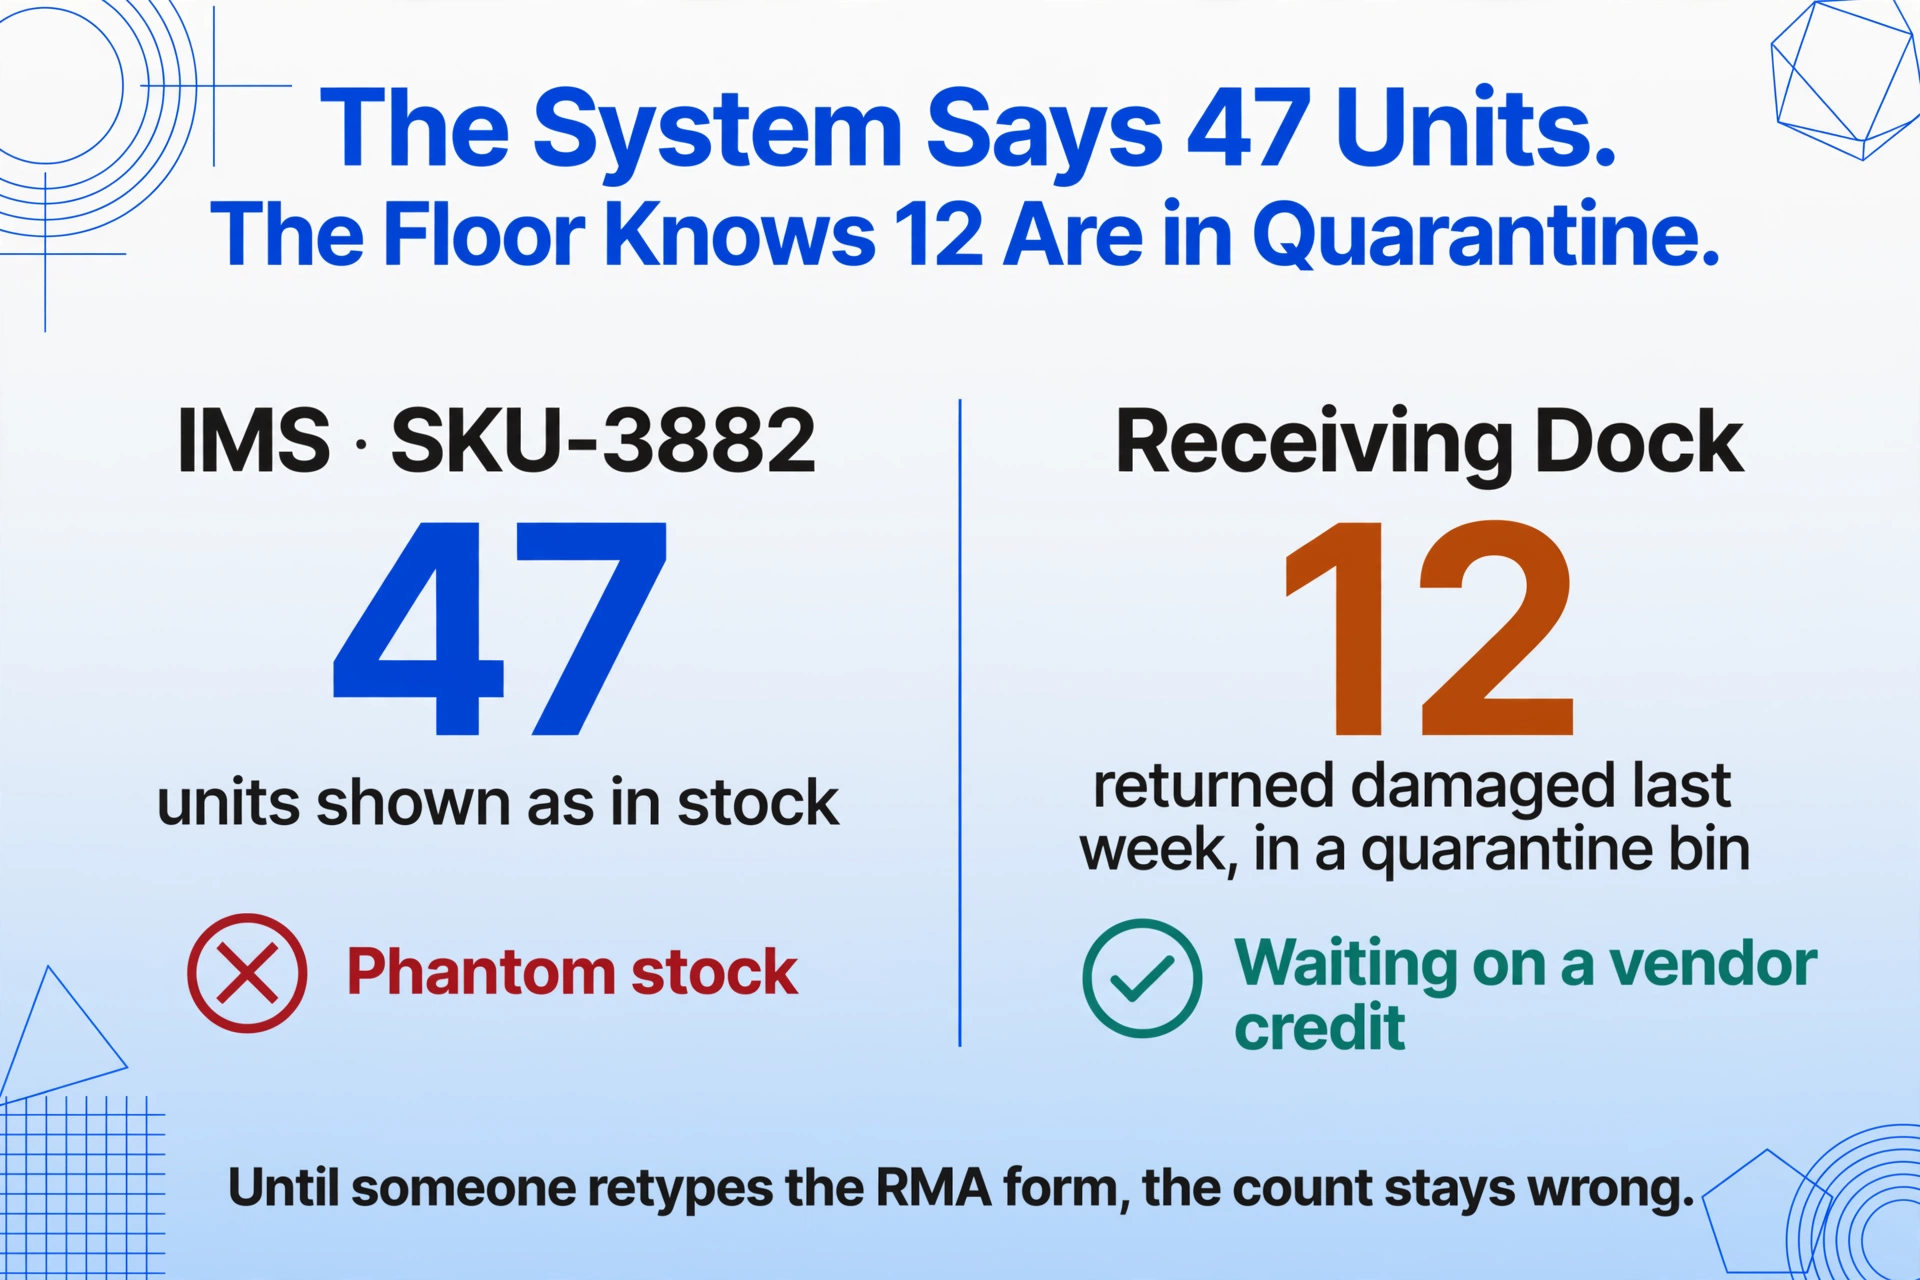
El resultado es un conteo de inventario que se aleja cada vez más de la realidad con cada ciclo de devolución. Su IMS (sistema de gestión de inventario) indica que tiene 47 unidades de SKU-3882 en stock. El piso del almacén sabe que 12 de esas llegaron la semana pasada con empaque dañado y están en un contenedor de cuarentena a la espera de un crédito del proveedor. Pero hasta que alguien actualice el sistema manualmente —lo que podría ocurrir en la conciliación de fin de semana—, su sistema de inventario está equivocado. Y un inventario equivocado significa sobreventa, subventa y órdenes de compra basadas en stock fantasma.
Dónde se pierden los datos RMA: la transferencia en el muelle de recepción
La brecha no es que los datos no existan. La brecha es que existen en el formato incorrecto en la etapa incorrecta del flujo de trabajo. Un flujo típico de devoluciones de comercio electrónico para un comerciante de Shopify que usa ShipStation se ve así: el cliente inicia la devolución a través de Shopify → ShipStation genera una etiqueta de devolución con un número RMA → el paquete llega al almacén → el personal abre la caja, inspecciona el artículo y encuentra el formulario RMA. El formulario tiene el número RMA, el número de pedido, el motivo de devolución indicado y, a menudo, una lista de verificación de condición que el inspector debe completar. Todo lo necesario para actualizar el estado del inventario está en esa hoja. Pero el siguiente paso después de la inspección —reponer el artículo— requiere datos en el IMS (sistema de gestión de inventario), no en papel. Así que alguien vuelve a teclear.
Loop Returns y plataformas similares gestionan el portal de devoluciones orientado al cliente y la generación de etiquetas. Narvar gestiona el seguimiento y la comunicación con el cliente. ShipStation gestiona la etiqueta de envío y el enrutamiento del transportista. Pero ninguna de estas herramientas extrae los datos del formulario del PDF RMA —el código de motivo, la condición, la disposición del inspector— y los introduce en su sistema de inventario. Esa transferencia —del formulario físico al registro del sistema— es una brecha manual que cada herramienta de la cadena asume que otra persona cubre.
Según el informe de 2025 de la NRF, el 60% de los minoristas informó tener que elegir entre "enviar nuevos pedidos o procesar devoluciones" durante los períodos pico. Esa disyuntiva existe porque el procesamiento de devoluciones consume mano de obra —y el componente de mano de obra más grande es la transcripción de datos. Procesar una sola devolución cuesta entre $10 y $65 según el tipo de producto y si el artículo puede revenderse, según los puntos de referencia de la industria de 2026. La mayor parte de ese costo no es el envío ni la inspección —es el tiempo que se tarda en ingresar los datos correctos en el sistema correcto.
La capa de extracción: lo que va entre sus formularios RMA y su IMS
Cuando aparece una brecha de herramientas, el instinto es buscar una herramienta nueva: otra plataforma de gestión de devoluciones, un IMS actualizado, un módulo de ERP con funcionalidad de devoluciones integrada. Pero eso es una migración de gran escala. Significa volver a capacitar al personal del almacén, reconfigurar su integración de Shopify y posiblemente romper el flujo de generación de etiquetas de ShipStation que ya funciona. El costo de la migración a menudo supera el costo del problema.
Un enfoque más ligero: agregar una capa de extracción. Este es un paso que se sitúa entre el formulario RMA que llega al almacén y el registro de inventario que se actualiza. Lee el formulario —ya sea un PDF impreso, una nota de devolución escaneada o una nota manuscrita— y genera datos estructurados (CSV, XLSX o JSON) que coinciden con el esquema de campos que su IMS espera. El resto de su flujo de trabajo —Shopify, ShipStation, el proceso de recepción del almacén, la disposición de los estantes de reposición— permanece exactamente igual. Usted está insertando un nuevo paso, no reemplazando ninguno existente.
Este es el modelo que habilita la Extracción de Columnas Personalizadas. En lugar de crear plantillas de análisis para cada diseño de formulario RMA —su proveedor A usa un PDF con campos en la parte superior, el proveedor B envía una página de portal impresa con un código de barras y un menú desplegable de códigos de motivo, y un cliente B2B garabatea "lote defectuoso" en una nota de empaque— usted define qué columnas de salida necesita: Número RMA, SKU, Motivo de devolución, Condición, Disposición. La IA lee cada documento, localiza los valores que coinciden con cada nombre de columna según su significado —no según su posición en la página— y completa las filas. Los nombres de columna que elija se convierten en los encabezados del archivo CSV o Excel que llega a su ruta de importación del IMS.
Esto es diferente del OCR basado en plantillas, que requiere dibujar zonas alrededor de cada campo en cada variante de diseño. Si recibe formularios RMA de 15 proveedores o marketplaces diferentes —cada uno con su propio diseño de formulario— necesitaría 15 plantillas con una herramienta basada en plantillas. Con la extracción semántica, el mismo conjunto de nombres de columna funciona en los 15 formatos. El formato se vuelve irrelevante. Lo que importa es que el documento contenga un número RMA, un SKU y un motivo de devolución —y la IA los encuentra. Cuando su proveedor más grande cambie el diseño de su formulario el próximo trimestre, nada se rompe. Sin plantilla que actualizar. Sin zona que redibujar. Sin proceso posterior que reconfigurar. La extracción produce la misma hoja de cálculo independientemente del formato de origen.
No hay un ajuste preestablecido específico para RMA en este flujo de trabajo —ni lo necesita. La ausencia de una plantilla fija es precisamente el punto. La extracción comienza desde las columnas que usted define, no desde una suposición preconstruida sobre cómo debería verse el documento. Para ver un recorrido completo del conjunto de campos, la carga por lotes de formato mixto y las opciones de exportación, consulte el convertidor de RMA a Excel.
Los archivos se procesan de forma segura y no se almacenan.
Asignación de campos RMA a campos de inventario: qué extraer
Si la capa de extracción genera datos que su IMS no puede consumir, el puente es inútil. La decisión de diseño clave es la asignación de columnas: cómo nombre sus columnas de extracción determina si el archivo de salida se puede importar directamente o requiere reformateo manual. El objetivo es cero manipulación entre la extracción y la importación.
Así es como se ve una asignación estándar de campos RMA a IMS para un comerciante de Shopify que utiliza Zoho Inventory o Cin7:
| Campo del formulario RMA | Nombre de la columna de extracción | Campo de destino en IMS | Notas |
|---|---|---|---|
| Número de RMA | RMA Number | ID de devolución / N.º de referencia | Vincula este registro de devolución al RMA original para el seguimiento de auditoría |
| Número de pedido original | Order Number | Referencia de pedido de venta | Conecta la devolución con la venta original para la conciliación de reembolsos |
| SKU / Código de producto | SKU | Código de artículo / SKU | Debe coincidir exactamente con el formato de SKU de su IMS: mayúsculas y delimitadores importan |
| Cantidad devuelta | Qty Returned | Cantidad de devolución | Alimenta directamente el ajuste de existencias |
| Motivo de devolución | Return Reason | Código de motivo de devolución | Si su IMS usa códigos numéricos, agregue una tabla de referencia como paso de importación separado |
| Condición del artículo | Condition | Estado de existencias / Clasificación | Determina si el artículo va a «Vendible», «Cuarentena» o «Baja» |
| Disposición (inferida) | Disposition (options: Restock / Refurbish / RTV / Liquidate / Dispose) | Ruta de almacén / Asignación de ubicación | Columna inferida: la IA lee la condición y el motivo y decide la ruta. No es un campo del formulario en sí |
| Nombre del cliente / proveedor | Customer Name | Devuelto por | Útil para devoluciones B2B donde se debe rastrear el crédito del proveedor |
La columna Disposition en esta asignación utiliza extracción inferida: no es un campo que alguien haya escrito en el formulario de RMA. En su lugar, la IA lee el código de motivo y la condición — «Defectuoso» + «Embalaje dañado» → derivar a devolución al proveedor. «Talla incorrecta» + «Sin abrir» → reabastecer. Usted define las opciones en el propio nombre de la columna, y la IA asigna la correcta a cada fila según lo que dice el formulario. Esto elimina el paso en el que un supervisor de almacén decide manualmente el destino de cada artículo y lo escribe en una hoja de cálculo aparte. El resultado de la extracción ya incluye la instrucción de enrutamiento incorporada.
Si su organización ha estado registrando datos de devoluciones RMA en Excel como un proceso independiente, las mismas definiciones de columna que funcionaron para el registro manual pueden reutilizarse aquí — la única diferencia es que el resultado ahora llega a su IMS (sistema de gestión de inventario) en lugar de quedarse en una hoja de cálculo. Y si ya ha procesado por lotes formularios RMA para la conciliación de reembolsos, el flujo por lotes es idéntico: cargue los formularios una vez, obtenga todas las filas en un solo archivo, importe una vez.
Paso a paso: cómo introducir datos RMA en su sistema sin tocar nada más
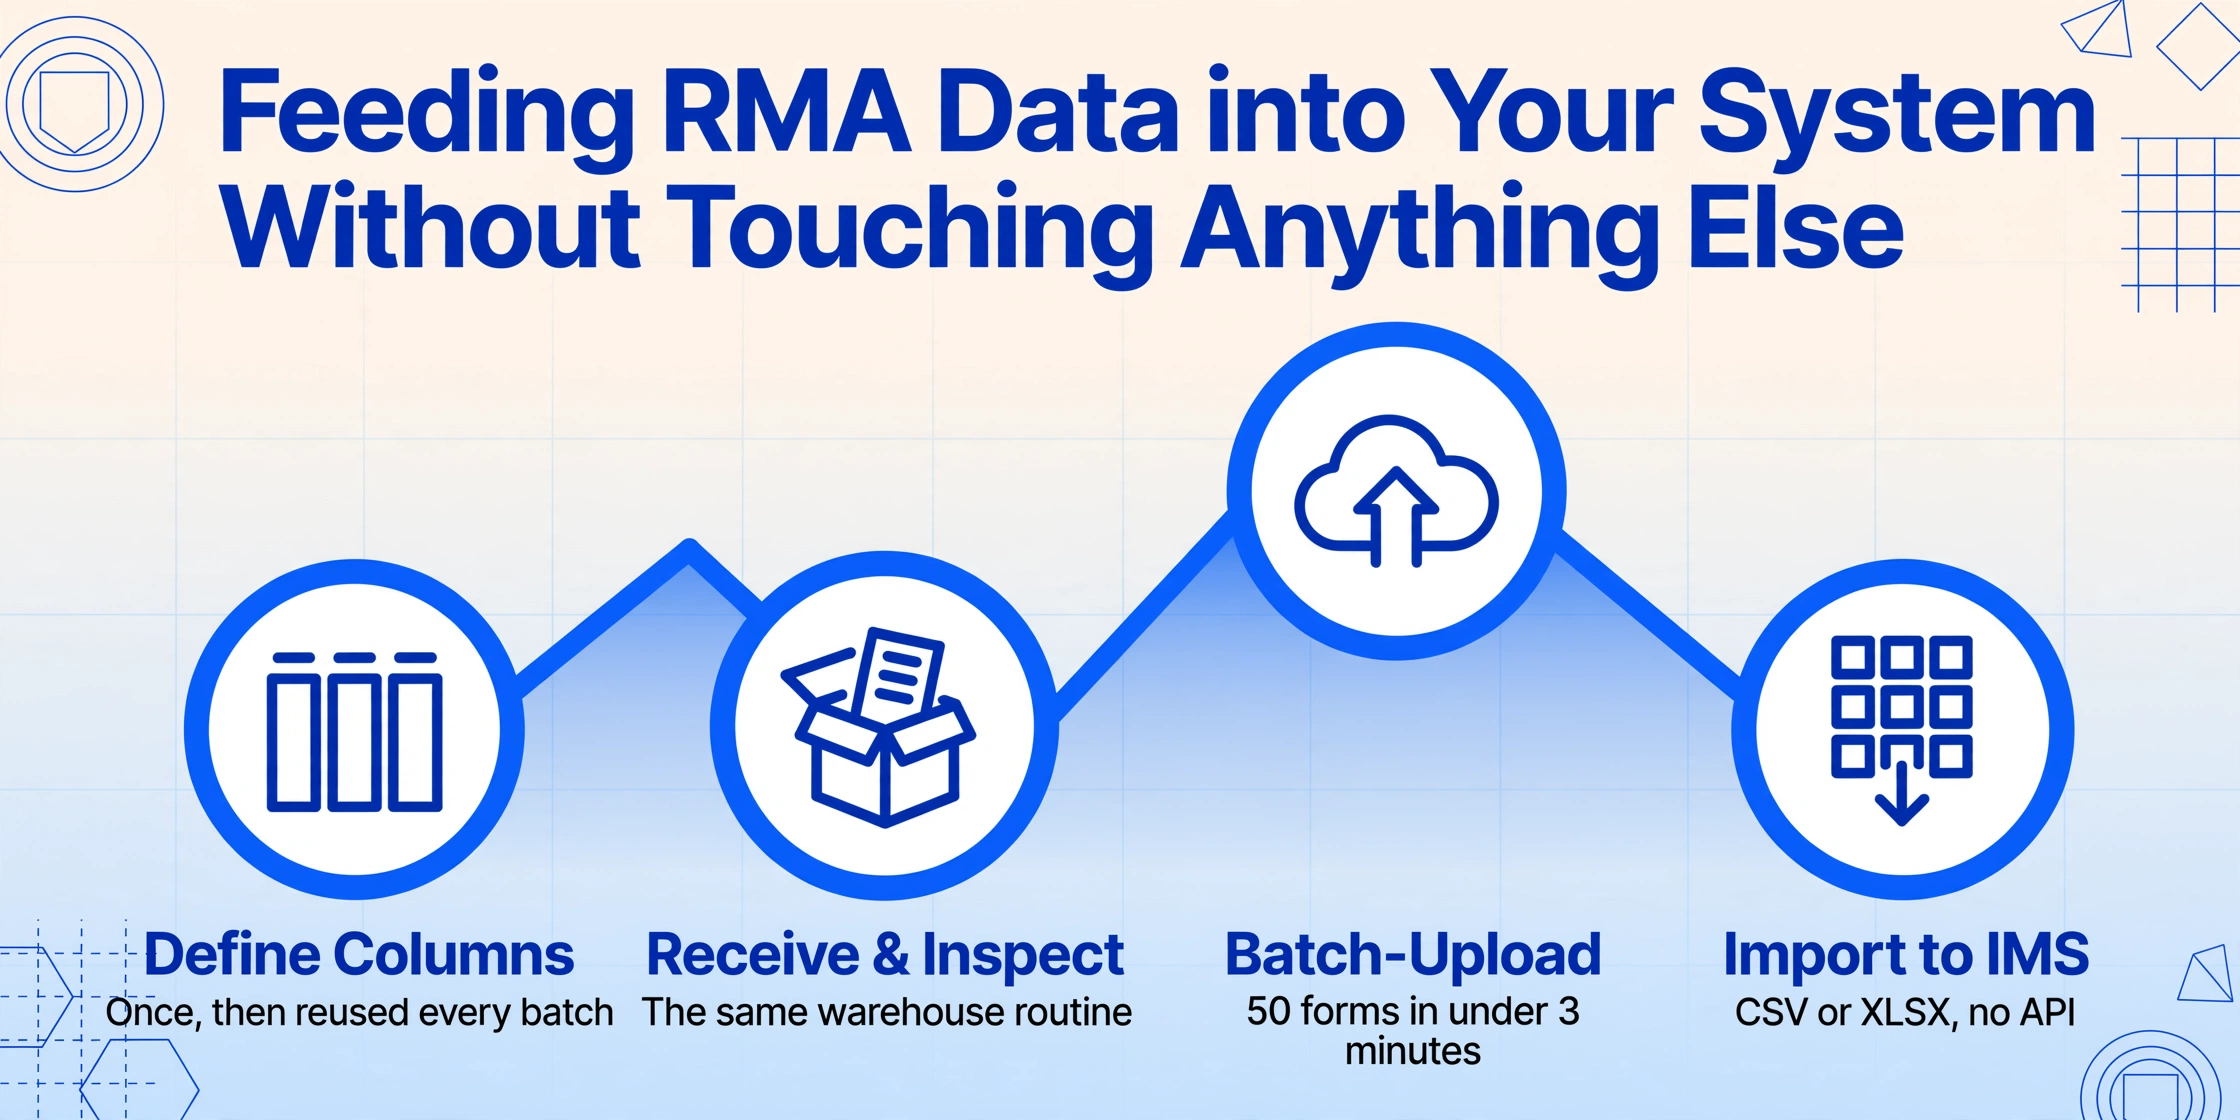
El flujo de trabajo encaja en su proceso de devoluciones existente en exactamente un punto de inserción: después de la inspección física, antes de la actualización de inventario. Así es como se integra en una operación típica de Shopify + IMS:
Esto no reemplaza su IMS. No reemplaza su plataforma de gestión de devoluciones. Es el paso que los conecta: un canal de datos que convierte los campos del formulario RMA en registros del IMS. Usted conserva Shopify para la tienda, ShipStation para las etiquetas de envío, Loop o AfterShip para el portal de devoluciones del cliente y su IMS para el inventario. La única pieza nueva es la extracción que convierte los formularios en algo que esos sistemas puedan consumir.
Si también ha manejado datos de facturas de proveedores para asientos de inventario, ya ha desarrollado la memoria muscular para este patrón: documentos por lotes, datos estructurados de salida, importación única. El mismo principio aplica aquí, solo que con un tipo de documento diferente en el muelle de entrada.
Qué sucede cuando los proveedores cambian sus formularios de RMA
Una objeción recurrente a cualquier integración de flujo de trabajo es la fragilidad: usted crea el proceso, funciona durante tres meses, y luego un proveedor rediseña su formulario de RMA y todo se rompe. Esta es una preocupación legítima con la extracción basada en plantillas: las herramientas de OCR basadas en zonas fallan cuando las posiciones de los campos cambian. También es la razón por la que el mantenimiento de plantillas se convierte en una carga de tiempo completo en operaciones de devoluciones grandes: alguien tiene que redibujar las zonas cada vez que un proveedor actualiza su documentación.
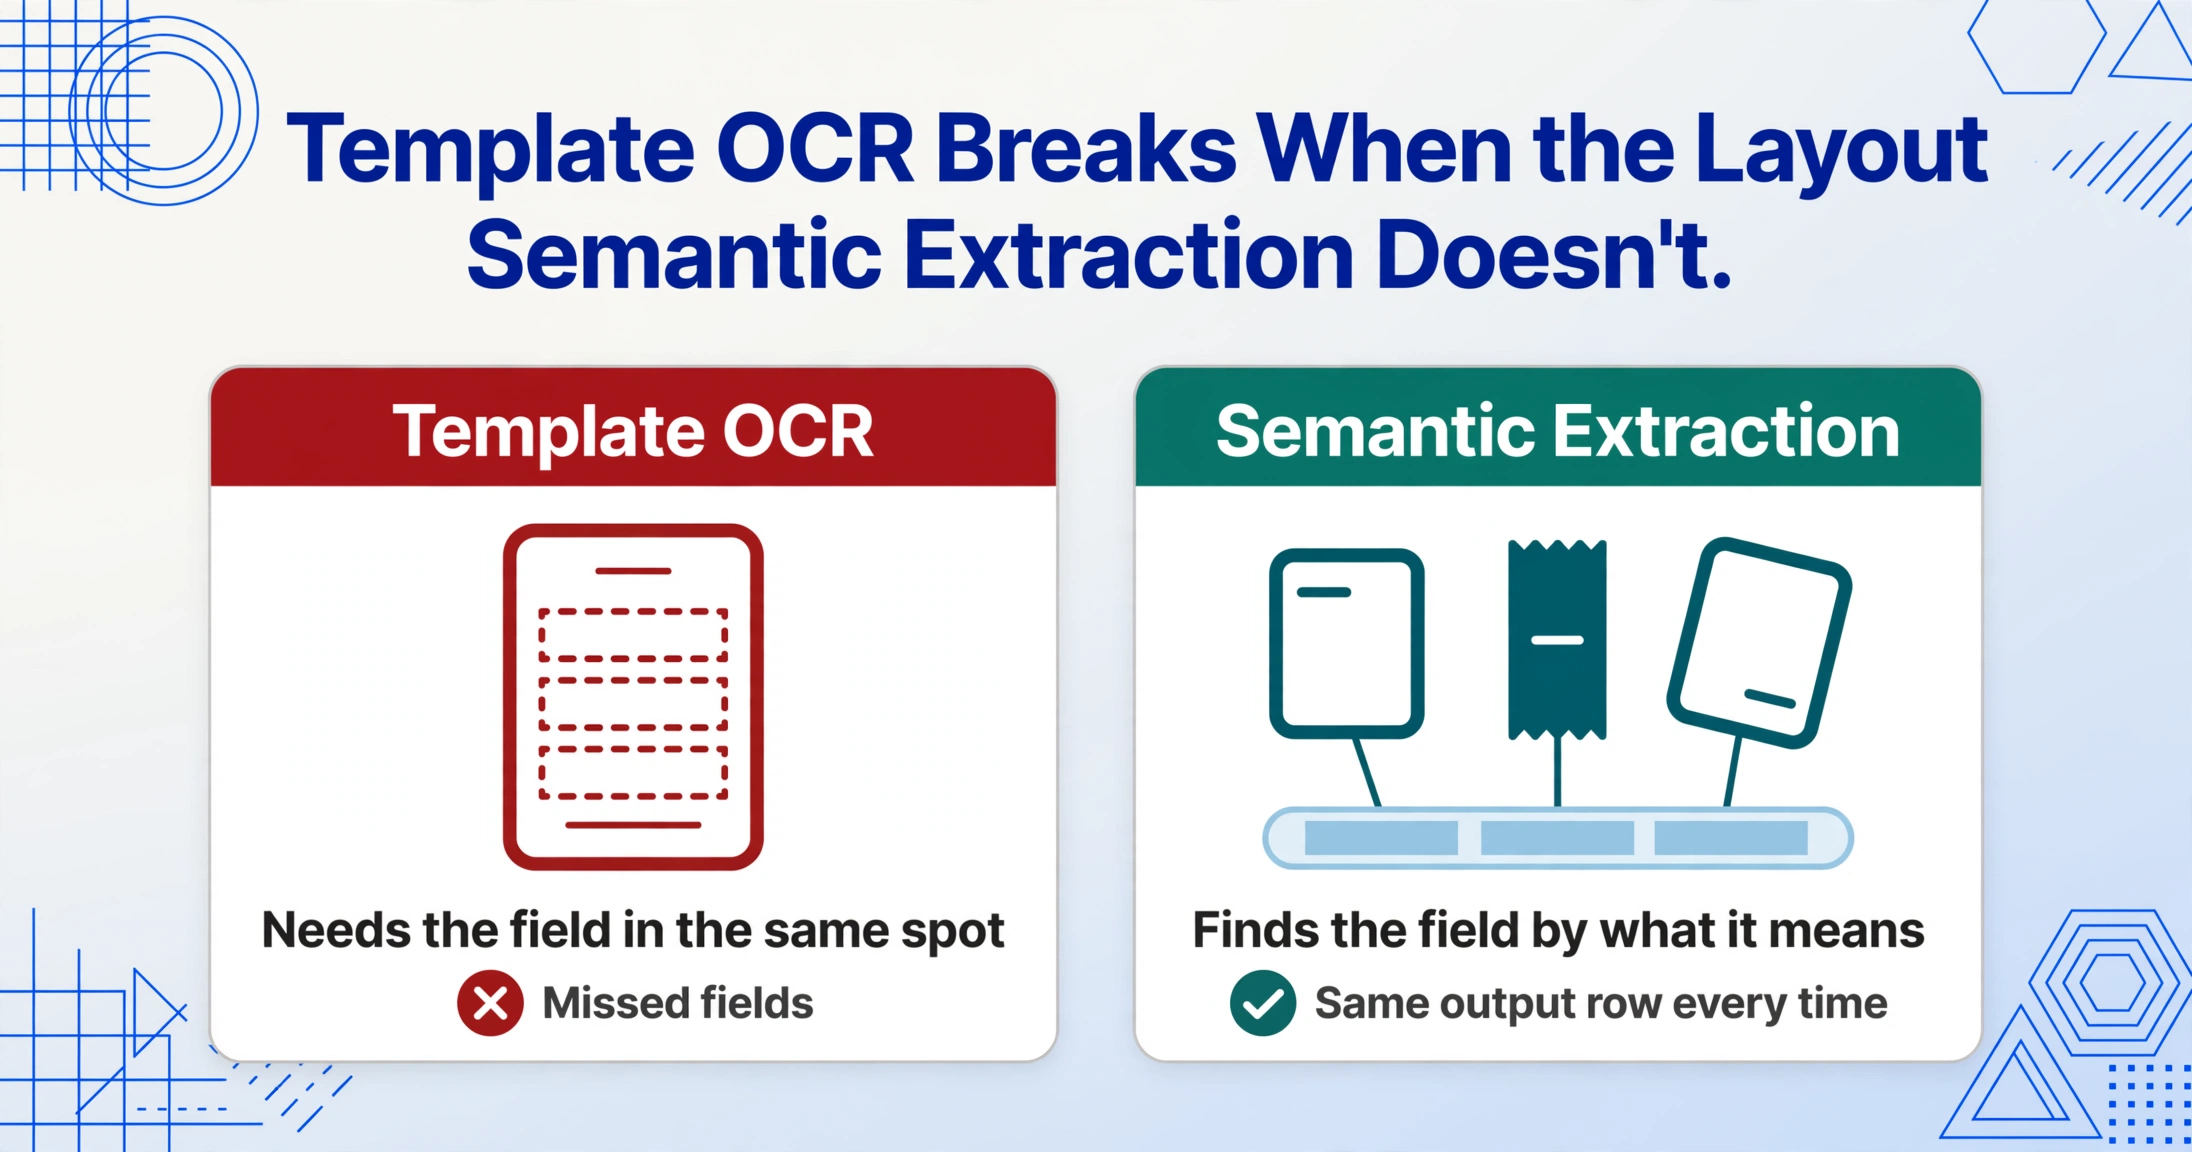
La extracción semántica maneja esto de manera diferente. La extracción no depende de las posiciones de los campos ni del diseño. Depende del significado del campo. Un número de RMA es un número de RMA ya sea que esté impreso en la esquina superior derecha de un PDF con marca, escrito a mano en el medio de un formulario de devolución, o incrustado en una etiqueta de código de barras con texto legible junto a él. La IA lo localiza de la misma manera que lo haría una persona: reconociendo lo que significa el texto, no dónde está ubicado. Esta es la diferencia práctica entre la extracción basada en posición (que es lo que hace el OCR de plantillas) y la extracción basada en semántica (que es lo que hace un modelo de lenguaje visual cuando usted le dice "encuentre el número de RMA en esta página").
Para los equipos de almacén que manejan devoluciones de múltiples canales de venta — un pedido de Shopify aquí, una eliminación de Amazon FBA allá, una devolución B2B de un cliente mayorista, una reclamación de garantía en un conjunto diferente de documentación — esta independencia del formato es lo que hace que la capa de extracción sea viable como un punto de inserción único. Cuando la misma definición de columna funciona en todos los formatos de RMA sin reconfiguración, usted no está manteniendo 15 procesos de extracción. Está manteniendo uno.
Esto también se extiende a los formularios de RMA escritos a mano — aún comunes en devoluciones B2B y mayoristas donde el cliente que devuelve llena un formulario de papel en el mostrador del almacén. Si su equipo ha procesado formularios de almacén escritos a mano en registros de inventario diarios, el patrón es idéntico: la IA lee la escritura a mano de la misma manera que lee texto impreso. Un número de RMA garabateado en bolígrafo es tan extraíble como uno tipografiado en Helvetica. La columna de extracción que usted definió — RMA Number — no le importa la fuente ni el medio. Le importa el significado.
Preguntas Frecuentes
¿Necesito cambiar mi IMS para que esto funcione?
No. El resultado de la extracción es un archivo CSV o XLSX estándar. Si su IMS puede importar una hoja de cálculo — y todos los IMS principales pueden, incluyendo Zoho Inventory, Cin7, NetSuite, Finale Inventory y Sellercloud — el resultado ingresa por la misma ruta de importación que ya usa para actualizaciones masivas de existencias. Sin integración de API, sin middleware, sin un nuevo conector que mantener. Si su IMS tiene un botón de importación CSV, está listo.
¿Qué sucede si mis formularios de RMA no tienen todos los campos indicados en la tabla de mapeo?
La IA extrae únicamente los campos presentes en cada formulario y deja el resto en blanco. Si un formulario tiene un número de RMA y un SKU pero no un motivo de devolución, obtendrá esas dos columnas completas y la columna de motivo vacía. Las celdas vacías en el resultado son normales; no causan errores de importación. Su IMS puede manejar valores nulos en campos opcionales. No es necesario completar todas las columnas en cada formulario.
¿Funciona esto con notas de devolución escritas a mano?
Sí. El motor de extracción subyacente lee escritura a mano, cursiva y texto impreso con igual capacidad. Un "RMA #4421 — broche roto — devolver al proveedor" escrito a mano por un empleado de almacén en un albarán produce la misma fila estructurada que un PDF nítido de un portal de devoluciones. La clave es que la escritura sea legible: si un humano puede leerla, la IA puede leerla. La escritura muy manchada o ilegible generará errores, igual que la transcripción manual.
¿Cómo encaja esto con plataformas de gestión de devoluciones como Loop o AfterShip?
Estas plataformas gestionan la parte frontal de las devoluciones: el portal del cliente, la etiqueta de devolución, el seguimiento. Responden a la pregunta "¿dónde está esta devolución?". No extraen los datos del formulario físico de RMA. La capa de extracción que usted añade después de la recepción en el almacén llena ese vacío. Usted conserva Loop para la experiencia del cliente y la generación de etiquetas. Añade la extracción para el traspaso de datos del formulario al IMS. Ambos son complementarios, no conflictivos.
¿Puedo rastrear las tendencias de los motivos de devolución en todos los canales con este enfoque?
Sí — y aquí es donde reside el beneficio a nivel de sistema. Una vez que los datos de RMA de cada canal (Shopify, Amazon, B2B, garantía) se integran en una salida estructurada, usted obtiene un conjunto de datos unificado: motivos de devolución a nivel de SKU, calificaciones de condición, disposiciones y marcas de tiempo, todo en una sola tabla. Este conjunto de datos le indica qué SKU tiene una tasa de defectos del 22 %, qué código de motivo aumenta en el cuarto trimestre y qué productos de qué proveedor generan la mayor cantidad de reclamaciones de RTV (devolución al proveedor). Sin el paso de extracción, este conjunto de datos no existe: la información permanece dispersa en archivos PDF y notas manuscritas que nadie consolida.
La brecha entre lo que dicen sus formularios RMA y lo que sabe su sistema de inventario no es una brecha tecnológica — es una brecha de transferencia. Cada sistema en su cadena de devoluciones asume que otro sistema maneja los datos del formulario. La capa de extracción es la pieza que nadie construyó. Le cuesta 90 segundos por formulario de devolución hoy. Le cuesta precisión de inventario cada día que los datos permanecen en papel. Y le cuesta los datos de códigos de motivo que de otro modo le dirían qué productos corregir, con qué proveedores renegociar y qué motivos de devolución puede eliminar con mejores descripciones de producto en su tienda en línea.
No se requiere registro para su primera extracción