So speisen Sie RMA-Retourendaten
in Ihr Inventarsystem ein
Eine Retoure trifft in Ihrem Lager ein. Ein Mitarbeiter öffnet den Karton, zieht das RMA-Formular heraus – es kann ein ausgedrucktes PDF, ein handgeschriebener Zettel oder ein Retourenaufkleber mit einem hingekritzelten Grundcode sein – und tippt die RMA-Nummer, SKU, den Grundcode und den Zustand in eine Tabelle. Diese Tabelle liegt auf einem gemeinsamen Laufwerk. Sie erreicht nie Ihr Inventarverwaltungssystem. Der zweitwertvollste Datensatz in Ihrem Betrieb – was zurückkam, warum und in welchem Zustand – endet auf einem Klemmbrett.
Wichtigste Erkenntnisse
- 849,9 Milliarden US-Dollar an Einzelhandelsretouren im Jahr 2025 – und die Daten auf jedem RMA-Formular – was zurückkam und warum – endeten auf einem Klemmbrett, statt das Inventarsystem zu erreichen.
- 60 % der Einzelhändler mussten sich während der Hochsaison zwischen dem Versand von Bestellungen und der Verarbeitung von Retouren entscheiden, weil die Transkriptionsarbeit das Budget auffrisst, bevor irgendetwas anderes passiert.
- Fügen Sie einen einzigen Extraktionsschritt hinzu, der jedes RMA-Formular von jedem Anbieter liest und strukturierte Daten in Ihr IMS einspeist – ohne Shopify, Ihr WMS oder Ihren Wareneingangs-Workflow zu ersetzen.
Der Inventar-Blindfleck, den Retouren erzeugen
Die National Retail Federation verzeichnete 2025 Retouren im Wert von 849,9 Milliarden US-Dollar im US-Einzelhandel – 15,8 % aller Verkäufe. Die Online-Retourenquote ist mit geschätzten 19,3 % höher. Allein im Januar rechneten Einzelhändler damit, dass 17 % der Weihnachtseinkäufe zurückkommen würden. Hinter jeder dieser Retouren steckt ein Formular: der RMA-Schein, die Retourengenehmigung als PDF, das vom Lieferanten bereitgestellte Retourenlabel mit aufgedruckten Feldern. Und hier ist der Teil, den die meisten Workflow-Diagramme auslassen: Die Daten auf diesem Formular sagen Ihrem Inventarsystem, ob der Artikel zurück ins Lager, zur Aufarbeitung oder zur Entsorgung geht. Doch in den meisten Betrieben wird diese Entscheidung am Lagerarbeitsplatz getroffen, und die zugehörigen Daten – SKU, Grundcode, Zustandsbewertung, endgültige Verwendung – bleiben auf einem Papierformular notiert oder in einer PDF gespeichert, die nie mit einem System synchronisiert wird.
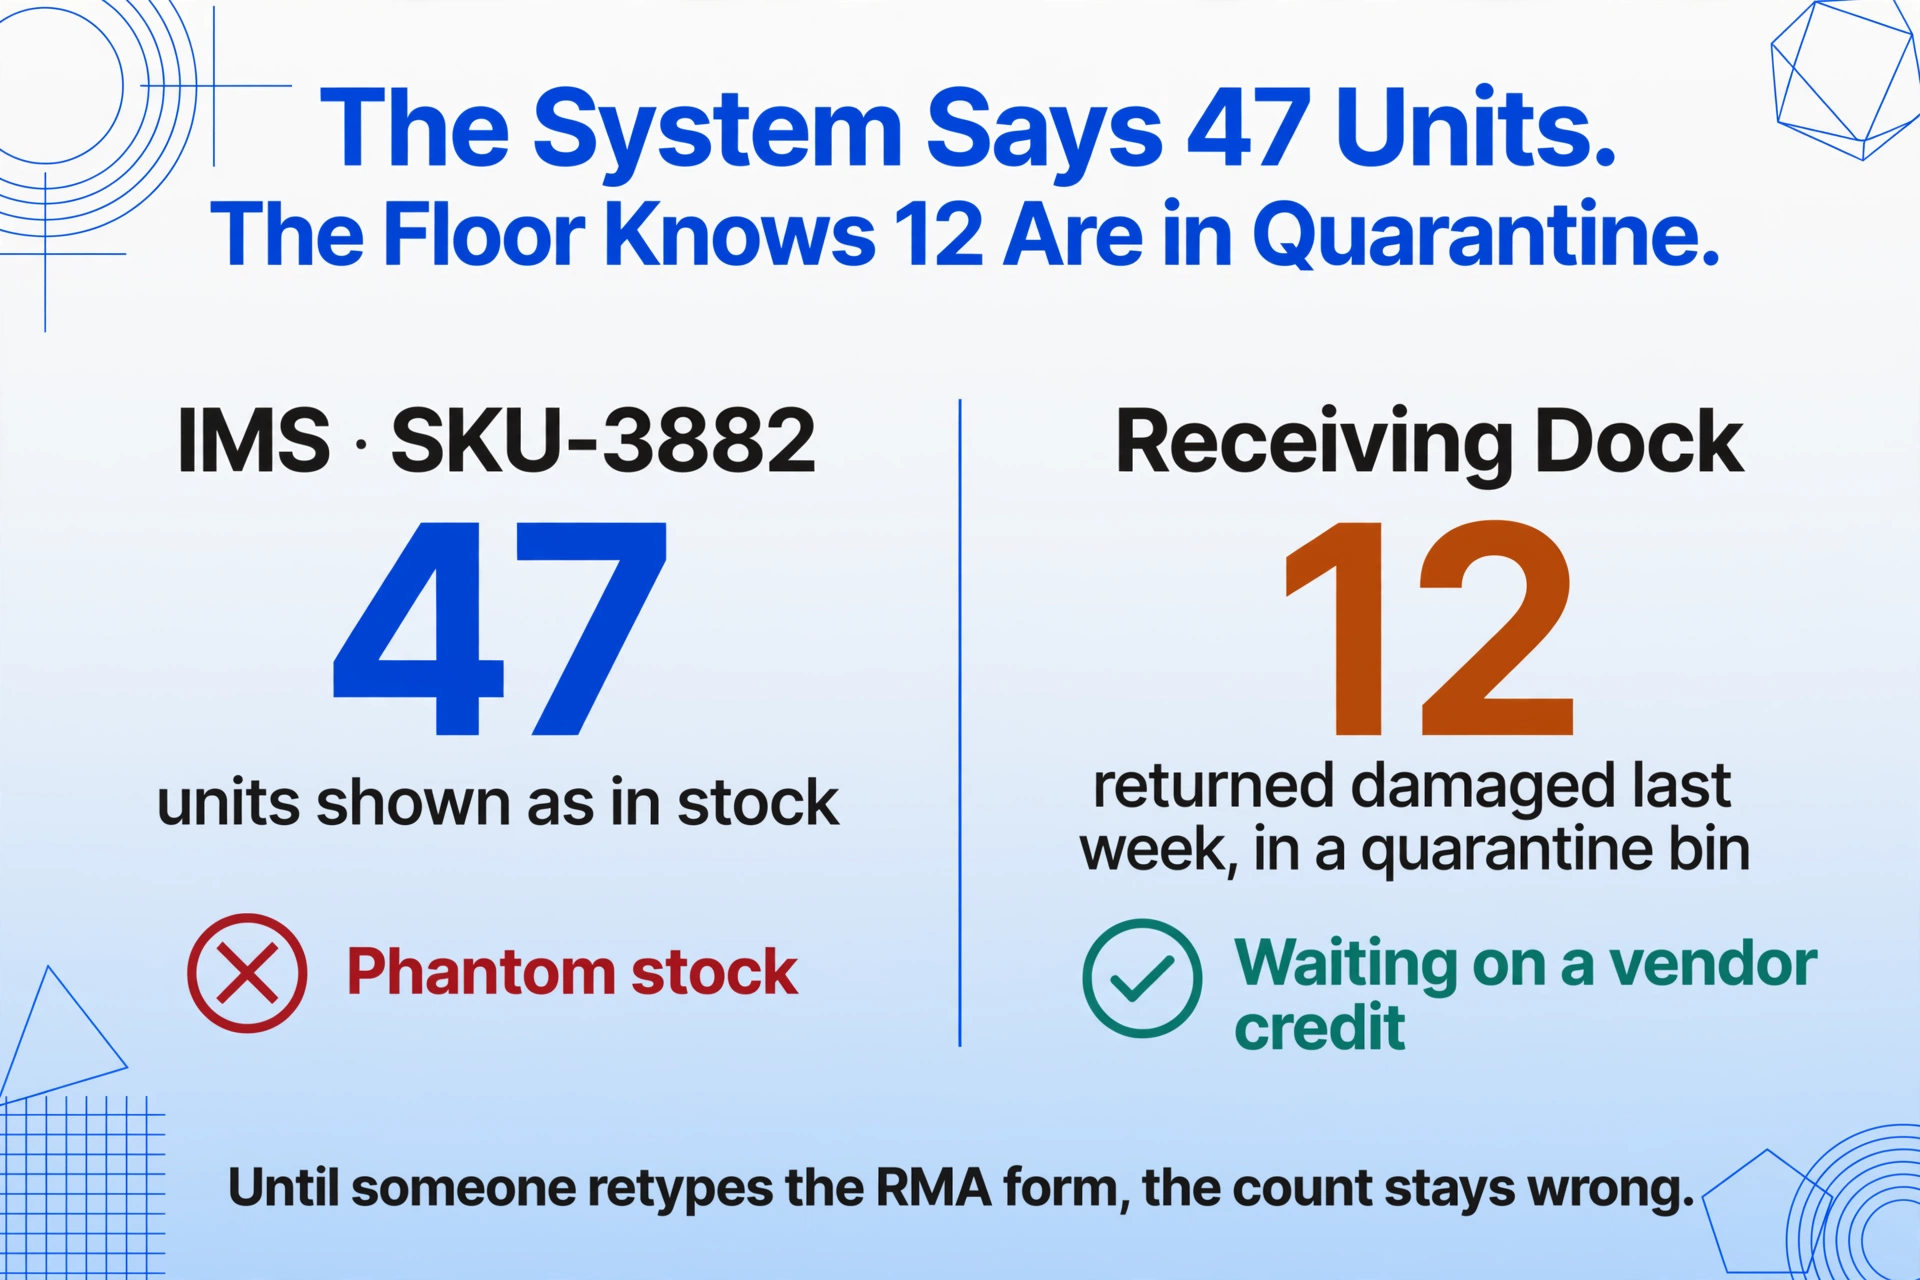
Das Ergebnis ist ein Inventarbestand, der mit jedem Retourenzyklus weiter von der Realität abweicht. Ihr IMS zeigt 47 Einheiten von SKU-3882 auf Lager. Das Lagerpersonal weiß, dass 12 davon letzte Woche mit beschädigter Verpackung zurückkamen und in einem Quarantäne-Behälter auf eine Gutschrift des Lieferanten warten. Doch bis jemand das System manuell aktualisiert – was möglicherweise erst beim Wochenabschluss passiert – ist Ihr Inventarsystem falsch. Und falscher Bestand bedeutet Überverkäufe, Unterverkäufe und Bestellungen auf Basis von Phantom-Bestand.
Wo RMA-Daten verloren gehen: Die Übergabe am Wareneingang
Die Lücke besteht nicht darin, dass die Daten nicht existieren. Die Lücke besteht darin, dass sie im falschen Format und in der falschen Workflow-Phase vorliegen. Ein typischer E-Commerce-Retourenablauf für einen Shopify-Händler mit ShipStation sieht so aus: Kunde initiiert Retoure über Shopify → ShipStation erzeugt ein Retourenlabel mit RMA-Nummer → Paket kommt im Lager an → Mitarbeiter öffnet Karton, prüft Artikel, findet das RMA-Formular. Das Formular enthält die RMA-Nummer, die Bestellnummer, den angegebenen Retourengrund und oft eine Zustandscheckliste, die der Prüfer ausfüllen muss. Alles, was zur Aktualisierung des Inventarstatus nötig ist, steht auf diesem Blatt. Doch der nächste Schritt nach der Prüfung – die Wiedereinlagerung – erfordert Daten im IMS, nicht auf Papier. Also tippt jemand die Daten neu ab.
Loop Returns und ähnliche Plattformen übernehmen das kundenorientierte Retourenportal und die Labelerzeugung. Narvar verwaltet Tracking und Kundenkommunikation. ShipStation übernimmt Versandlabel und Speditionsrouting. Doch keines dieser Tools extrahiert die Formulardaten aus der RMA-PDF – den Grundcode, den Zustand, die Entscheidung des Prüfers – und speist sie in Ihr Inventarsystem ein. Diese Übergabe – vom physischen Formular zum Systemdatensatz – ist eine manuelle Lücke, von der jedes Tool in der Kette annimmt, dass ein anderes sie füllt.
Laut dem NRF-Bericht 2025 gaben 60 % der Einzelhändler an, in Spitzenzeiten zwischen „neue Bestellungen versenden oder Retouren bearbeiten“ wählen zu müssen. Dieser Kompromiss entsteht, weil die Retourenbearbeitung Arbeitskraft bindet – und der größte einzelne Arbeitsanteil ist die Datenerfassung. Die Bearbeitung einer einzelnen Retoure kostet je nach Produkttyp und Wiederverkaufsfähigkeit zwischen 10 und 65 US-Dollar, so Branchenbenchmarks für 2026. Der Großteil dieser Kosten entfällt nicht auf Versand oder Prüfung – sondern auf die Zeit, die benötigt wird, um die richtigen Daten in das richtige System zu bringen.
Die Extraktionsebene: Was zwischen Ihre RMA-Formulare und Ihr IMS gehört
Wenn eine Tool-Lücke auftritt, ist der Instinkt, nach einem neuen Tool zu suchen — einer anderen Retourenverwaltungsplattform, einem aufgerüsteten IMS, einem ERP-Modul mit integrierter Retourenfunktion. Aber das ist eine Migration mit dem Vorschlaghammer. Sie bedeutet, Lagerpersonal neu zu schulen, Ihre Shopify-Integration neu zu konfigurieren und möglicherweise den ShipStation-Etikettendruck-Workflow zu unterbrechen, der bereits funktioniert. Die Kosten der Migration übersteigen oft die Kosten des Problems.
Ein leichterer Ansatz: Fügen Sie eine Extraktionsebene hinzu. Das ist ein Schritt, der zwischen dem Eintreffen des RMA-Formulars im Lager und der Aktualisierung des Inventardatensatzes liegt. Er liest das Formular — ob es sich um ein gedrucktes PDF, einen gescannten Retourenbeleg oder eine handschriftliche Notiz handelt — und gibt strukturierte Daten (CSV, XLSX oder JSON) aus, die dem Feldschema entsprechen, das Ihr IMS erwartet. Der Rest Ihres Workflows — Shopify, ShipStation, der Wareneingangsprozess im Lager, das Regallayout für die Wiedereinlagerung — bleibt genau so, wie er ist. Sie fügen einen neuen Schritt ein, ohne bestehende zu ersetzen.
Dies ist das Modell, das Benutzerdefinierte Spaltenextraktion ermöglicht. Statt Parsing-Vorlagen für jedes RMA-Formularlayout zu erstellen — Ihr Lieferant A verwendet ein PDF mit Feldern oben, Lieferant B sendet eine gedruckte Portalseite mit Barcode und einem Grundcode-Dropdown zurück, und ein B2B-Kunde kritzelt „defekte Charge“ auf einen Lieferschein — definieren Sie, welche Ausgabespalten Sie benötigen: RMA-Nummer, SKU, Retourengrund, Zustand, Verfügung. Die KI liest jedes Dokument, findet die Werte, die zu jedem Spaltennamen passen, basierend auf ihrer Bedeutung — nicht auf ihrer Position auf der Seite — und füllt die Zeilen. Die von Ihnen gewählten Spaltennamen werden zu den Kopfzeilen der CSV- oder Excel-Datei, die in Ihren IMS-Importpfad gelangt.
Das unterscheidet sich von vorlagenbasierter OCR, die erfordert, dass Sie Zonen um jedes Feld in jeder Layoutvariante zeichnen. Wenn Sie RMA-Formulare von 15 verschiedenen Lieferanten oder Marktplätzen erhalten — jedes mit seinem eigenen Formularlayout — bräuchten Sie 15 Vorlagen mit einem vorlagenbasierten Tool. Mit semantischer Extraktion funktioniert derselbe Satz von Spaltennamen über alle 15 Formate hinweg. Das Format wird irrelevant. Entscheidend ist, dass das Dokument eine RMA-Nummer, eine SKU und einen Retourengrund enthält — und die KI findet sie. Wenn Ihr größter Lieferant sein Formularlayout im nächsten Quartal ändert, bricht nichts zusammen. Keine Vorlage zu aktualisieren. Keine Zone neu zu zeichnen. Kein nachgelagerter Prozess neu zu konfigurieren. Die Extraktion erzeugt dieselbe Tabelle, unabhängig vom Quellformat.
Es gibt keine RMA-spezifische Voreinstellung für diesen Workflow — und es muss auch keine geben. Das Fehlen einer festen Vorlage ist genau der Punkt. Die Extraktion geht von den von Ihnen definierten Spalten aus, nicht von einer vorgefertigten Annahme darüber, wie das Dokument aussehen sollte. Für eine vollständige Übersicht des Feldsatzes, den Batch-Upload mit gemischten Formaten und die Exportoptionen siehe den RMA-zu-Excel-Konverter.
Dateien werden sicher verarbeitet und nicht gespeichert.
RMA-Felder auf Inventarfelder abbilden: Was extrahiert werden sollte
Wenn die Extraktionsebene Daten ausgibt, die Ihr IMS nicht verarbeiten kann, ist die Brücke nutzlos. Die wichtigste Designentscheidung ist die Spaltenzuordnung: Wie Sie Ihre Extraktionsspalten benennen, bestimmt, ob die Ausgabedatei direkt importiert werden kann oder eine manuelle Neuformatierung erfordert. Das Ziel ist null Bearbeitung zwischen Extraktion und Import.
So sieht eine Standard-Zuordnung von RMA-zu-IMS-Feldern für einen Shopify-Händler aus, der Zoho Inventory oder Cin7 verwendet:
| RMA-Formularfeld | Name der Extraktionsspalte | IMS-Zielfeld | Hinweise |
|---|---|---|---|
| RMA-Nummer | RMA Number | Retouren-ID / Referenznummer | Verknüpft diesen Retourendatensatz mit der ursprünglichen RMA für den Prüfpfad |
| Ursprüngliche Bestellnummer | Order Number | Verkaufsauftragsreferenz | Verbindet die Retoure mit dem ursprünglichen Verkauf für die Erstattungsabstimmung |
| SKU / Produktcode | SKU | Artikelnr. / SKU | Muss exakt dem SKU-Format in Ihrem IMS entsprechen – Groß-/Kleinschreibung und Trennzeichen sind wichtig |
| Zurückgegebene Menge | Qty Returned | Retourenmenge | Fließt direkt in die Bestandsanpassung ein |
| Retourengrund | Return Reason | Retourengrundcode | Wenn Ihr IMS numerische Codes verwendet, fügen Sie eine Nachschlagetabelle als separaten Importschritt hinzu |
| Artikelzustand | Condition | Bestandsstatus / Einstufung | Bestimmt, ob der Artikel als „Verkäuflich“, „Quarantäne“ oder „Abschreibung“ eingestuft wird |
| Verfügung (abgeleitet) | Disposition (options: Restock / Refurbish / RTV / Liquidate / Dispose) | Lagerroute / Behälterzuweisung | Abgeleitete Spalte – KI liest Zustand + Grund und entscheidet den Weg. Kein Feld im Formular selbst |
| Kunden-/Lieferantenname | Customer Name | Zurückgegeben von | Nützlich für B2B-Retouren, bei denen Lieferantengutschriften nachverfolgt werden müssen |
Die Spalte Disposition in diesem Mapping verwendet abgeleitete Extraktion: Sie ist kein Feld, das jemand auf dem RMA-Formular ausgefüllt hat. Stattdessen liest die KI den Grundcode und den Zustand – „Defekt“ + „Beschädigte Verpackung“ → Weiterleitung an Return-to-Vendor. „Falsche Größe“ + „Ungeöffnet“ → Wieder einlagern. Sie definieren die Optionen im Spaltennamen selbst, und die KI weist jeder Zeile basierend auf dem Formularinhalt die richtige Option zu. Das eliminiert den Schritt, in dem ein Lagerleiter manuell das Ziel jedes Artikels entscheidet und es in eine separate Tabelle eintippt. Die Extraktionsausgabe enthält die Weiterleitungsanweisung bereits eingebettet.
Wenn Ihre Organisation RMA-Retourendaten in Excel als eigenständigen Prozess erfasst hat, können dieselben Spaltendefinitionen, die für die manuelle Erfassung funktioniert haben, hier wiederverwendet werden – der einzige Unterschied besteht darin, dass die Ausgabe jetzt in Ihrem IMS landet, statt in einer Tabelle zu enden. Und wenn Sie bereits RMA-Formulare per Batch für die Erstattungsabstimmung verarbeitet haben, ist der Batch-Ablauf identisch – Formulare einmal hochladen, alle Zeilen in einer Datei erhalten, einmal importieren.
Schritt für Schritt: RMA-Daten in Ihr System einspeisen, ohne etwas anderes anzufassen
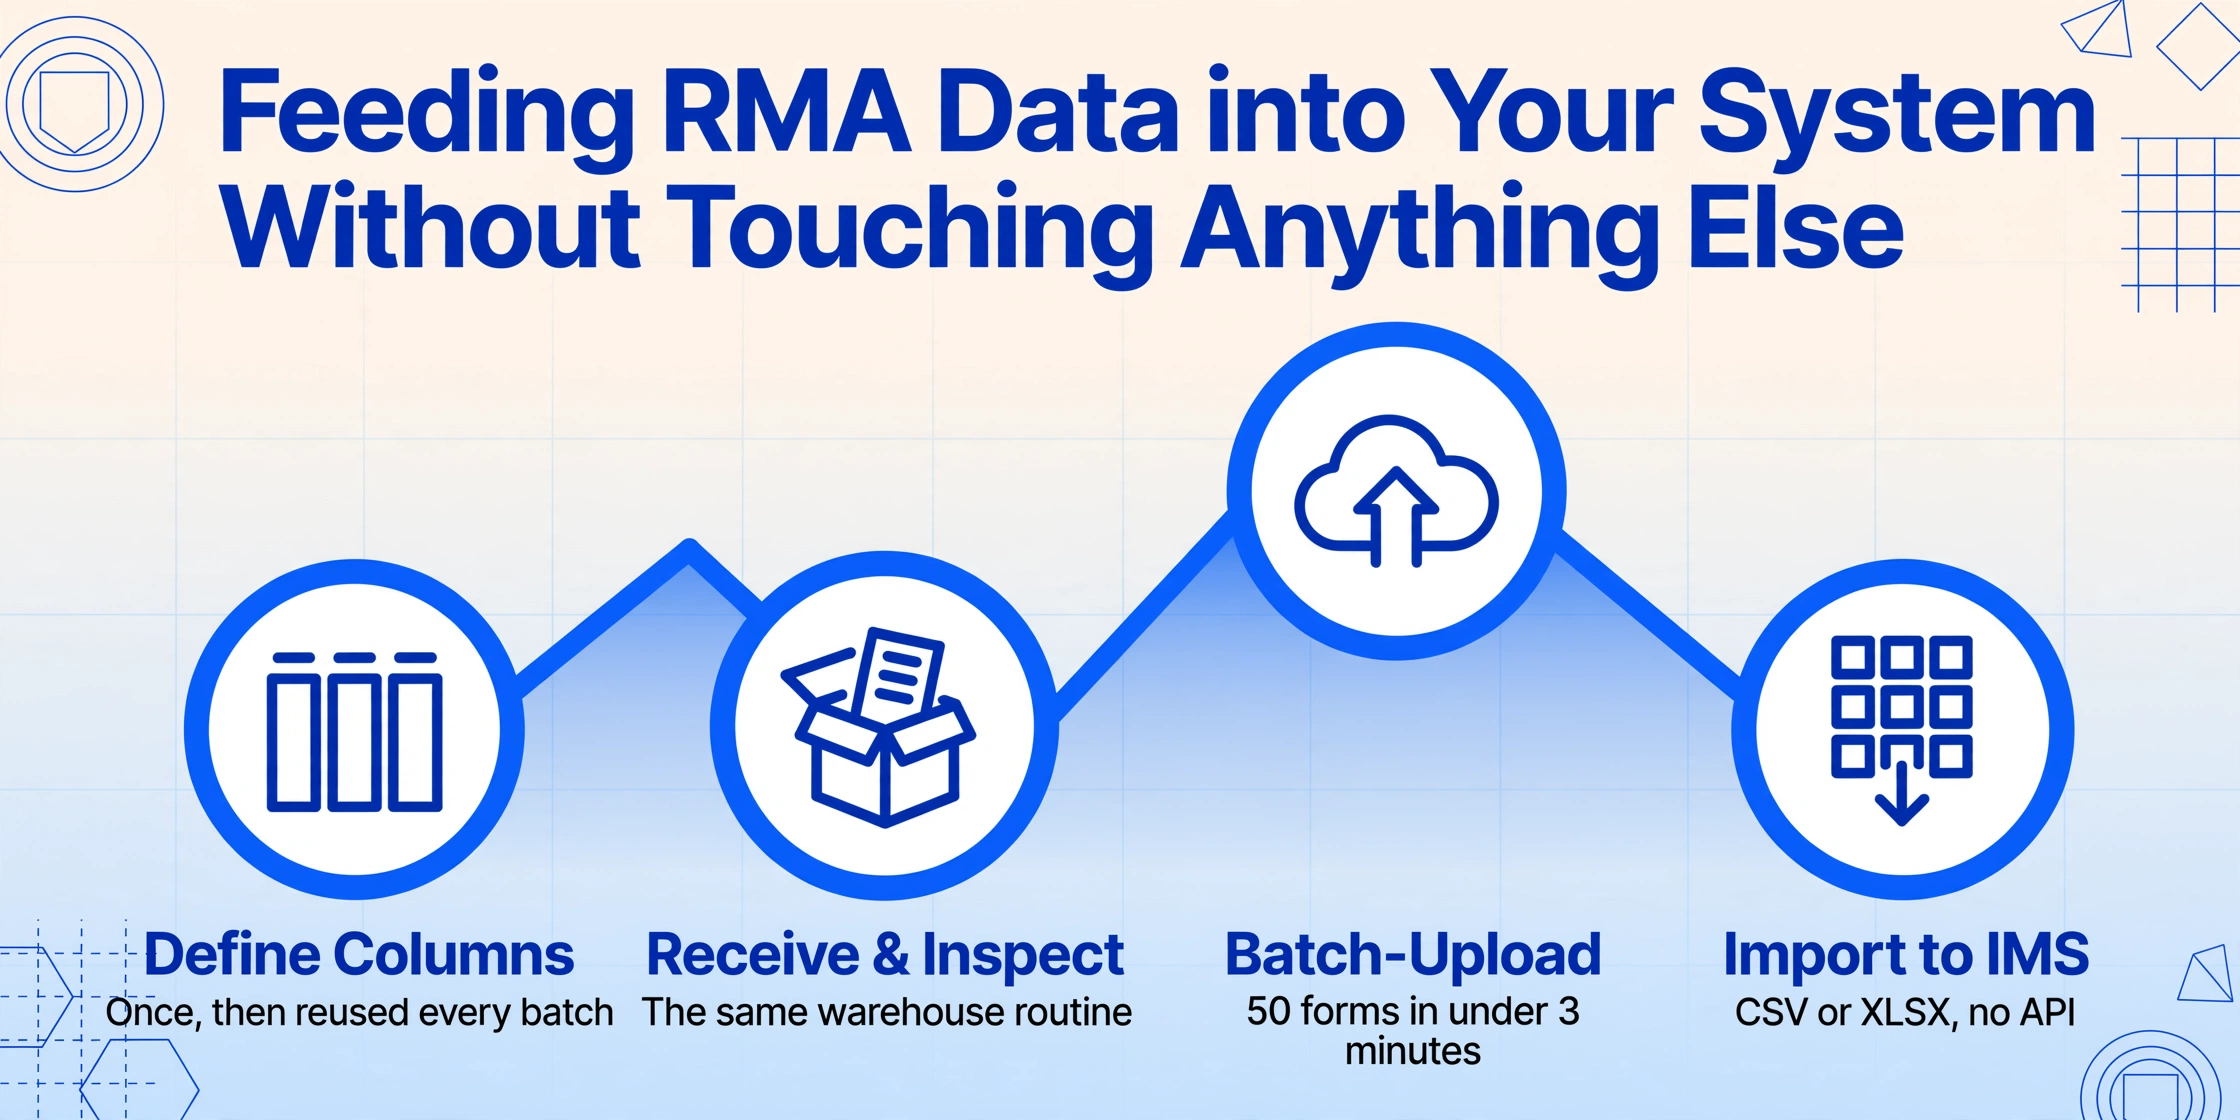
Der Workflow fügt sich an genau einer Stelle in Ihren bestehenden Retourenprozess ein: nach der physischen Prüfung, vor der Bestandsaktualisierung. So fügt er sich in einen typischen Shopify + IMS-Betrieb ein:
Dies ist kein Ersatz für Ihr IMS. Es ist kein Ersatz für Ihre Retourenverwaltungsplattform. Es ist der Schritt, der sie verbindet – eine Datenpipeline, die RMA-Formularfelder in IMS-Datensätze umwandelt. Sie behalten Shopify für den Onlineshop, ShipStation für Versandetiketten, Loop oder AfterShip für das Kundenretourenportal und Ihr IMS für den Bestand. Das einzige neue Element ist die Extraktion, die die Formulare in etwas verwandelt, das diese Systeme konsumieren können.
Wenn Sie bereits Lieferantenrechnungsdaten für Inventar-Ledger-Einträge verarbeitet haben, haben Sie bereits das Muskelgedächtnis für dieses Muster aufgebaut – Dokumente im Stapel rein, strukturierte Daten raus, einmal importieren. Das gleiche Prinzip gilt hier, nur mit einem anderen Dokumenttyp am Wareneingang.
Was passiert, wenn Lieferanten ihre RMA-Formulare ändern
Ein häufiger Einwand gegen jede Workflow-Integration ist die Fragilität: Sie bauen die Pipeline auf, sie funktioniert drei Monate lang, dann gestaltet ein Lieferant sein RMA-Formular neu und das Ganze bricht zusammen. Dies ist ein berechtigtes Anliegen bei der vorlagenbasierten Extraktion – zonenbasierte OCR-Tools versagen, wenn sich Feldpositionen verschieben. Genau deshalb wird die Vorlagenpflege in großen Retourenabteilungen zum Vollzeitaufwand: Jemand muss die Zonen jedes Mal neu zeichnen, wenn ein Lieferant seine Unterlagen aktualisiert.
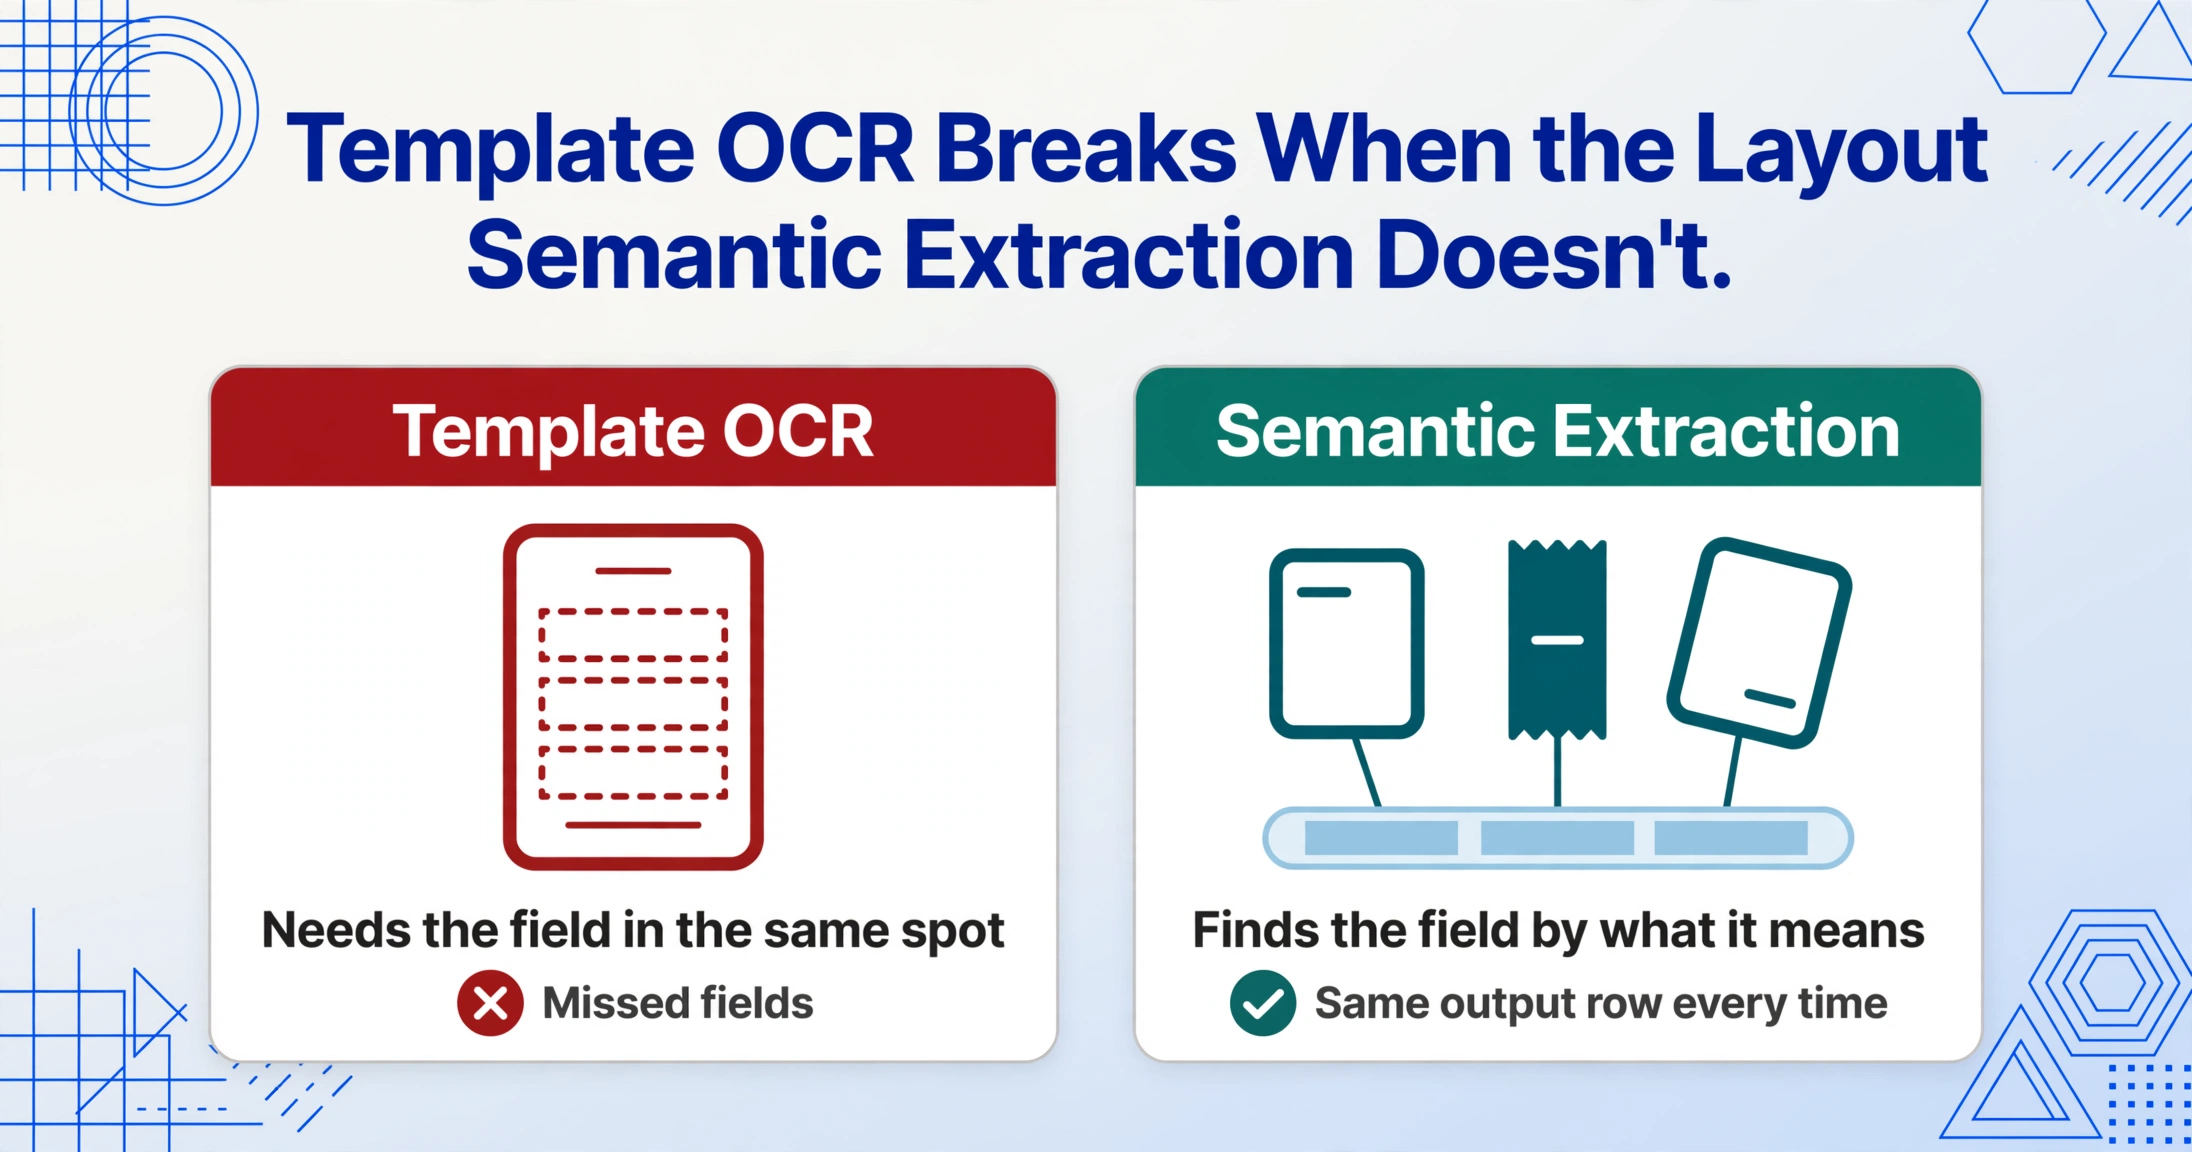
Semantische Extraktion geht anders damit um. Die Extraktion hängt nicht von Feldpositionen oder Layout ab. Sie hängt von der Feldbedeutung ab. Eine RMA-Nummer ist eine RMA-Nummer, egal ob sie in der oberen rechten Ecke eines gebrandeten PDFs gedruckt, handschriftlich in der Mitte eines Retourenbelegs notiert oder in ein Barcode-Etikett mit lesbarem Text daneben eingebettet ist. Die KI findet sie auf dieselbe Weise wie ein Mensch – indem sie erkennt, was der Text bedeutet, nicht wo er steht. Das ist der praktische Unterschied zwischen positionsbasierter Extraktion (das macht Template-OCR) und semantischer Extraktion (das macht ein Vision-Language-Modell, wenn Sie ihm sagen: „Finden Sie die RMA-Nummer auf dieser Seite“).
Für Lagerteams, die Retouren aus mehreren Verkaufskanälen verarbeiten – eine Shopify-Bestellung hier, eine Amazon-FBA-Entfernung dort, eine B2B-Retoure von einem Großhandelskunden, ein Garantieanspruch auf einem anderen Satz Unterlagen – ist diese Formatunabhängigkeit das, was die Extraktionsebene als einzigen Integrationspunkt tragfähig macht. Wenn dieselbe Spaltendefinition ohne Neukonfiguration über jedes RMA-Format funktioniert, pflegen Sie nicht 15 Extraktionspipelines. Sie pflegen eine.
Das gilt auch für handschriftliche RMA-Formulare – im B2B- und Großhandelsretourenbereich weiterhin üblich, wenn der retournierende Kunde am Lagerempfang einen Papierbeleg ausfüllt. Wenn Ihr Team bereits handschriftliche Lagerbelege in tägliche Inventarlogs verarbeitet hat, ist das Muster identisch: Die KI liest Handschrift genauso wie gedruckten Text. Eine mit Kugelschreiber gekritzelte RMA-Nummer ist genauso extrahierbar wie eine in Helvetica gesetzte. Die von Ihnen definierte Extraktionsspalte – RMA Number – kümmert sich nicht um Schriftart oder Medium. Sie kümmert sich um die Bedeutung.
FAQ
Muss ich mein IMS ändern, damit das funktioniert?
Nein. Die Extraktionsausgabe ist eine Standard-CSV- oder XLSX-Datei. Wenn Ihr IMS eine Tabelle importieren kann – und jedes gängige IMS kann das, einschließlich Zoho Inventory, Cin7, NetSuite, Finale Inventory und Sellercloud –, wird die Ausgabe über denselben Importpfad eingespielt, den Sie bereits für Bulk-Bestandsaktualisierungen verwenden. Keine API-Integration, keine Middleware, kein neuer Connector, den Sie warten müssen. Wenn Ihr IMS einen CSV-Import-Button hat, sind Sie bereit.
Was ist, wenn meine RMA-Formulare nicht alle in der Zuordnungstabelle aufgeführten Felder enthalten?
Die KI extrahiert nur die Felder, die auf jedem Formular vorhanden sind, und lässt den Rest leer. Wenn ein Formular eine RMA-Nummer und eine SKU, aber keinen Rückgabegrund enthält, erhalten Sie diese beiden Spalten ausgefüllt und die Grund-Spalte leer. Leere Zellen in der Ausgabe sind normal – sie verursachen keine Importfehler. Ihr IMS kann Nullwerte in optionalen Feldern verarbeiten. Sie müssen nicht jede Spalte auf jedem Formular ausfüllen.
Funktioniert das auch mit handschriftlichen Rücksendescheinen?
Ja. Die zugrundeliegende Extraktions-Engine verarbeitet Handschrift, Schreibschrift und Druckschrift gleichermaßen gut. Die handschriftliche Notiz eines Lageristen „RMA #4421 – defekter Verschluss – Rücksendung an Lieferanten“ auf einem Packzettel erzeugt dieselbe strukturierte Zeile wie ein klares PDF aus einem Retourenportal. Entscheidend ist, dass die Handschrift lesbar ist – wenn ein Mensch sie lesen kann, kann die KI sie lesen. Stark verschmierte oder unleserliche Schrift führt zu Fehlern, genau wie bei der manuellen Übertragung.
Wie passt das zu Retouren-Management-Plattformen wie Loop oder AfterShip?
Diese Plattformen verwalten das Frontend der Retouren – das Kundenportal, das Retourenlabel, die Sendungsverfolgung. Sie beantworten die Frage „Wo ist diese Retoure?“. Sie extrahieren jedoch nicht die Daten aus dem physischen RMA-Formular selbst. Die Extraktionsebene, die Sie nach dem Wareneingang im Lager hinzufügen, schließt diese Lücke. Sie behalten Loop für das Kundenerlebnis und die Labelerstellung. Sie fügen die Extraktion für die Übergabe der Formulardaten an das IMS hinzu. Beide ergänzen sich, sie schließen sich nicht aus.
Kann ich mit diesem Ansatz Retourengründe-Trends kanalübergreifend verfolgen?
Ja – und hier liegt der systemische Mehrwert. Sobald RMA-Daten aus allen Kanälen (Shopify, Amazon, B2B, Garantie) in eine strukturierte Ausgabe fließen, erhalten Sie einen einheitlichen Datensatz: Retourengründe auf SKU-Ebene, Zustandsbewertungen, Dispositionen und Zeitstempel – alles in einer Tabelle. Dieser Datensatz zeigt Ihnen, welche SKU eine Fehlerquote von 22 % aufweist, welcher Grundcode im vierten Quartal ansteigt und welche Produkte eines Lieferanten die meisten RTV-Fälle (Return to Vendor) verursachen. Ohne den Extraktionsschritt existiert dieser Datensatz nicht – die Informationen bleiben über PDFs und handschriftliche Zettel verstreut, die niemand zusammenführt.
Die Lücke zwischen dem, was Ihre RMA-Formulare aussagen, und dem, was Ihr Inventarsystem weiß, ist keine Technologielücke – es ist eine Übergabelücke. Jedes System in Ihrer Retourenkette geht davon aus, dass ein anderes System die Formulardaten übernimmt. Die Extraktionsebene ist das Stück, das niemand gebaut hat. Sie kostet Sie heute 90 Sekunden pro Retourenformular. Sie kostet Sie täglich Inventargenauigkeit, solange die Daten auf Papier bleiben. Und sie kostet Sie die Grundcodedaten, die Ihnen sonst sagen würden, welche Produkte Sie reparieren, mit welchen Lieferanten Sie neu verhandeln und welche Retourengründe Sie mit besseren Produktbeschreibungen in Ihrem Onlineshop eliminieren können.
Keine Anmeldung für Ihre erste Extraktion erforderlich