小売在庫スプレッドシートを構築
すべてのサプライヤーの発注書から
UNFIの発注書はEDI 850として届き、GTINコードとSSCC-18パレットラベルが付いています。Faireの注文は、まったく異なるレイアウトのポータル生成PDFとして受信トレイに届きます。小さな地域サプライヤーは、独自のSKU命名規則を使った手入力のExcelシートをメールで送ってきます。これらのドキュメントにはすべて同じ基本データ — SKU、数量、コスト、納期 — が含まれていますが、取り出すたびに異なる頭の使い方が必要です。サプライヤー15社、月30件のPOに掛け合わせると、数分で済むはずの作業が午後いっぱいを食いつぶします。
重要ポイント
- 15社のサプライヤーが15種類のレイアウトで発注書を送ってきます。そのすべてで、同じ4つの項目 — SKU、数量、コスト、納期 — をページの別の場所から探し出す必要があります。
- テンプレートベースの抽出ツールは、サプライヤーのレイアウトごとに1つのテンプレートを要求することでこの問題を解決します — つまり、15社分のデータ入力の問題が、15個のテンプレート保守の負担に変わり、サプライヤーがフォーマットを更新するたびに壊れてしまいます。
- 在庫列を一度定義すれば — 仕入原価単価(送料込み)や、注文数と受領数の別々の列など、小売特有のフィールドを含めて — ImageToTable.aiは、各フィールドがページのどこにあるかではなく、何を意味するかを理解することで、あらゆるサプライヤーのPOを読み取ります。
統一されたPOから在庫へのスプレッドシートが、一般的な問題ではなく小売業の問題である理由
ほとんどの発注書抽出ガイドは、POを独立したドキュメントとして扱います。ベンダー名、PO番号、日付、明細項目を抽出すれば完了です。その枠組みは、POを請求書と照合する買掛金担当者には機能します。しかし、小売バイヤーや在庫管理者は支払いを完了させるのではなく、在庫レベルを管理しているのです。
小売業では、POは在庫取引の出発点です。データはスプレッドシートに流れ込み、特定の質問に答える必要があります:SKU Xのユニットは現在何個注文中ですか?いつ届きますか?運賃と手数料を考慮した場合の1ユニットあたりの仕入原価はいくらですか?どのサプライヤーが一貫して部分納品をしており、いつ再発注をトリガーする必要がありますか?
これらは、一般的なPO抽出ワークフローが答える質問ではありません。ドキュメントロジックではなく、在庫ロジックを中心に設計されたスプレッドシート構造が必要です。その違いは重要です:「POテーブル」はPOごとに明細項目ごとに1行あります。在庫スプレッドシートはSKUごとに1行あり、PO全体を集約し、注文数量、受領数量、バックオーダー数量、累積仕入原価の列があります。前者から後者を構築することが、ほとんどのガイドが省略している小売特有のステップです。
Redditのスレッド「中小企業はどうやって30件以上の発注書を気が狂わずに追跡しているのか」が現実を捉えています:質問者はSAP、Tradogram、Procurifyなどの調達ソフトウェアを検討しましたが、月額$300〜$500の最低価格に躊躇しました。彼らは完全なERPを必要としていませんでした。タイピングせずにPOデータをスプレッドシートに入れる方法が必要だったのです。これは小売在庫の問題であり、調達自動化の問題ではありません。
小売在庫スプレッドシートがPOから必要とする4つのデータポイント
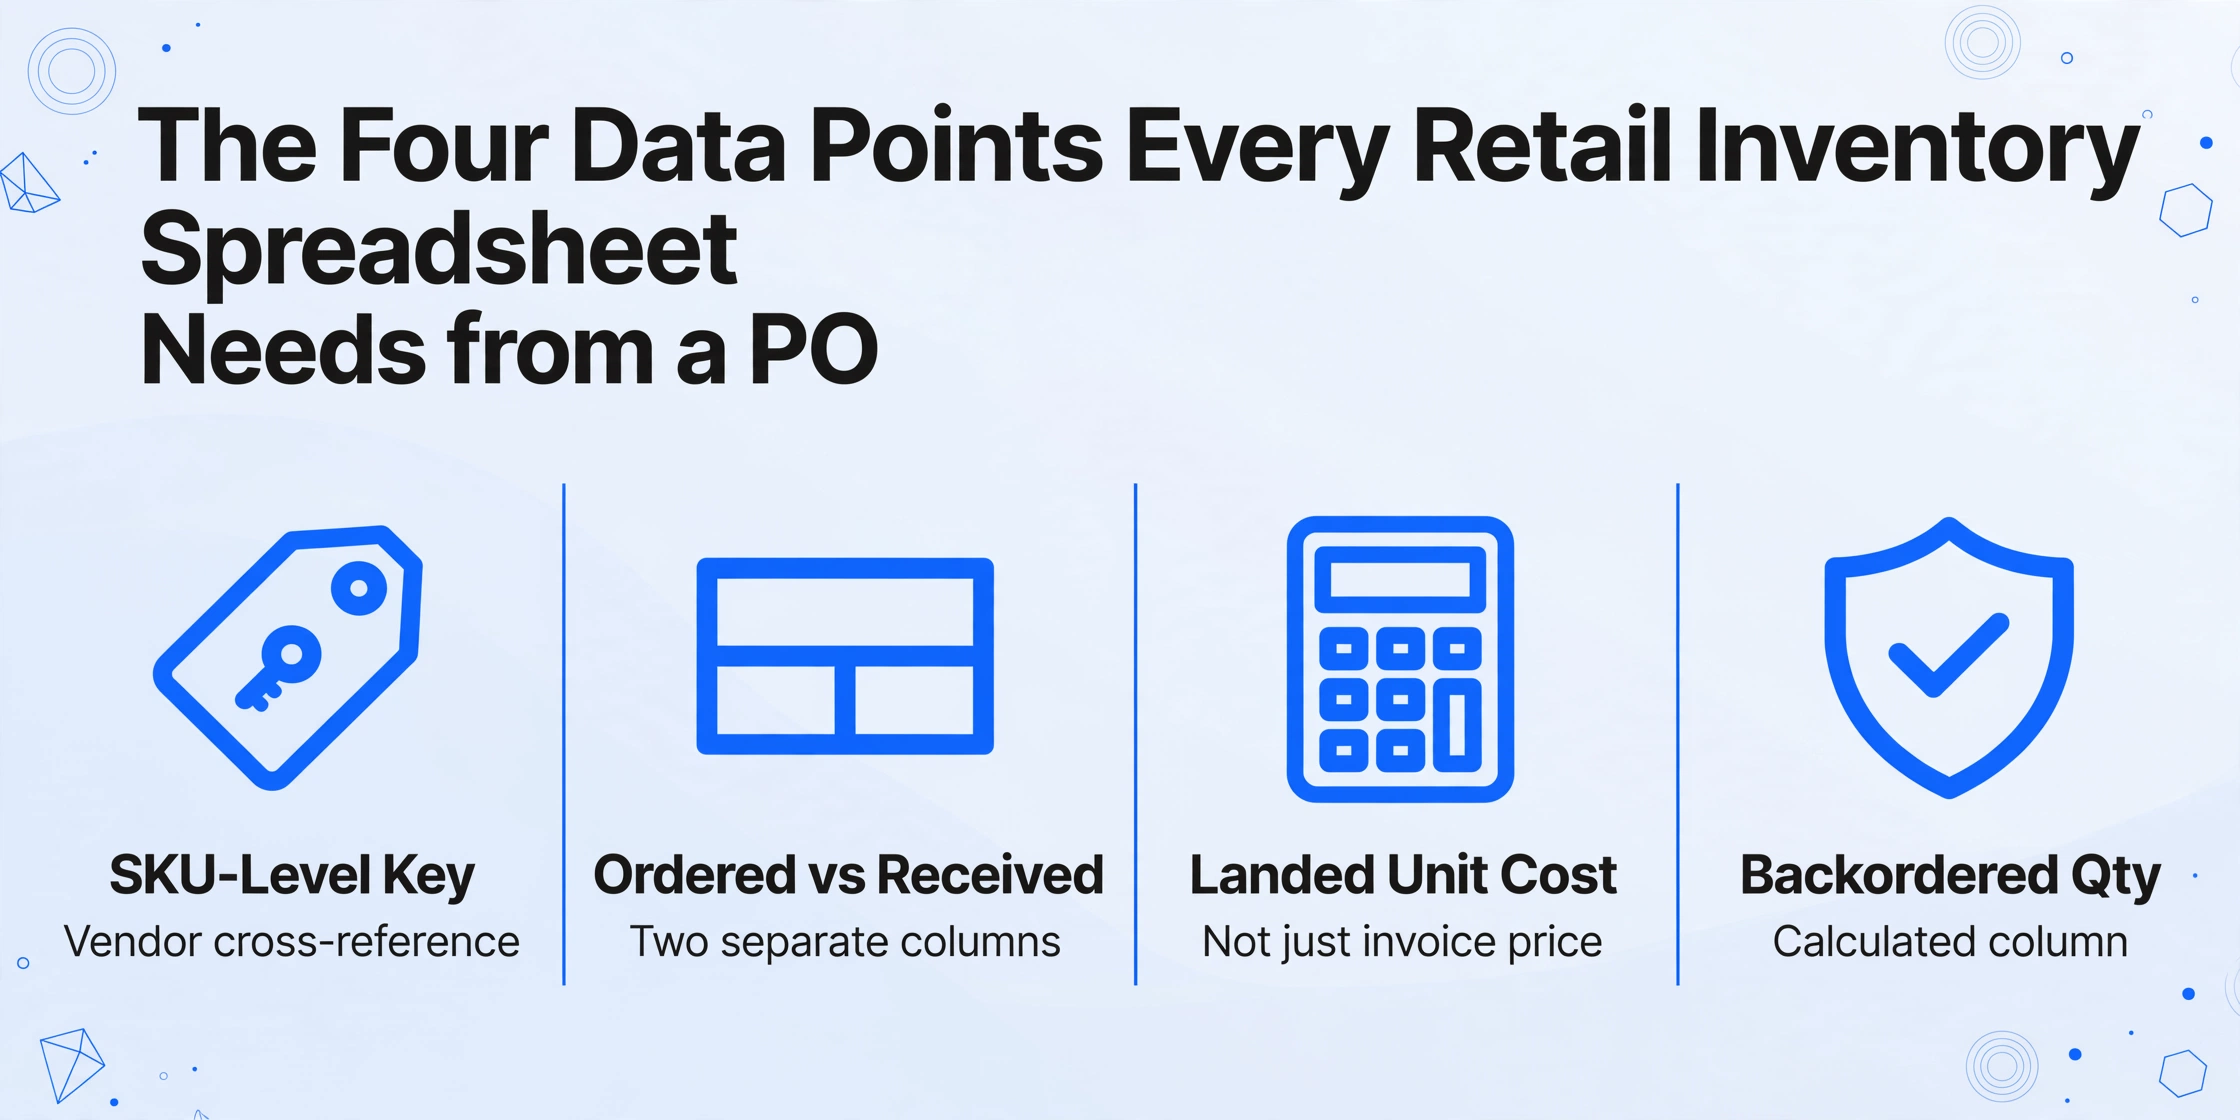
データの抽出方法を議論する前に、何を抽出するかを定義する価値があります。発注書から構築された小売在庫スプレッドシートには、一般的なPOログよりも多くの列が必要です。在庫対応シートとドキュメントアーカイブを区別する4つのポイントは次のとおりです:
SKUレベルのキーとベンダー相互参照
社内SKUがマスターキーです。しかし、サプライヤーのPOがそれを利用することはほとんどありません。UNFIはGTIN/UPCを参照し、Faireは独自の製品IDを使用し、小規模なベンダーは説明のみの場合もあります。スプレッドシートには、サプライヤーが使用した識別子を取得する列と、サプライヤーコードをSKUにマッピングする相互参照ルックアップ(別タブの単純なVLOOKUPテーブルでも可)が必要です。このマッピングがなければ、抽出されたPO明細項目で在庫数を更新できません。
注文数量と受領数量 — 2つの別々の列
サプライヤーが60ユニット中48ユニットを出荷し、残り12ユニットをバックオーダーした場合、両方の数値を把握する必要があります。到着したものだけを記録すると、確定済みだが未受領の在庫の可視性が失われます。単一の「数量」列は、小売業のPO追跡におけるスプレッドシート設計で最も一般的な間違いです。注文数量と受領数量の別々の列を使用し、バックオーダー(注文 - 受領)用の3番目の計算列を設けてください。
請求書価格だけでなく、仕入原価
POの単価が実際のコストであることは稀です。運送料、関税、港湾手数料、保険が加算されます。FASB ASC 330に基づき、これらのコストは即時費用化ではなく在庫価値に資本化する必要があります。小売会計では、スプレッドシートでサプライヤー単価と明細項目ごとの総仕入原価を追跡する必要があります。仕入原価の配分は通常、価値比例方式で行われます。製品Aが出荷の総請求額の40%を占める場合、運送料と取扱手数料の40%を吸収します。この列を含めることで、月次調整ではなく、初日から売上原価の計算が正確になります。
ステータスフラグ付きの納品予定日
POの「納品日」フィールドは多くの場合、希望的観測です。在庫計画にとって重要なのは、サプライヤーの約束日と実際の受領日の差です。納品予定日の列とステータスフラグ(予定通り / 遅延 / 一部 / 受領済み)により、各明細項目の現在の状態を1行で確認できます。この列は、在庫切れが発生する前に再発注をトリガーする必要があるかどうかを示します。
マルチサプライヤー形式の問題:一般的なPOガイドが的外れな理由
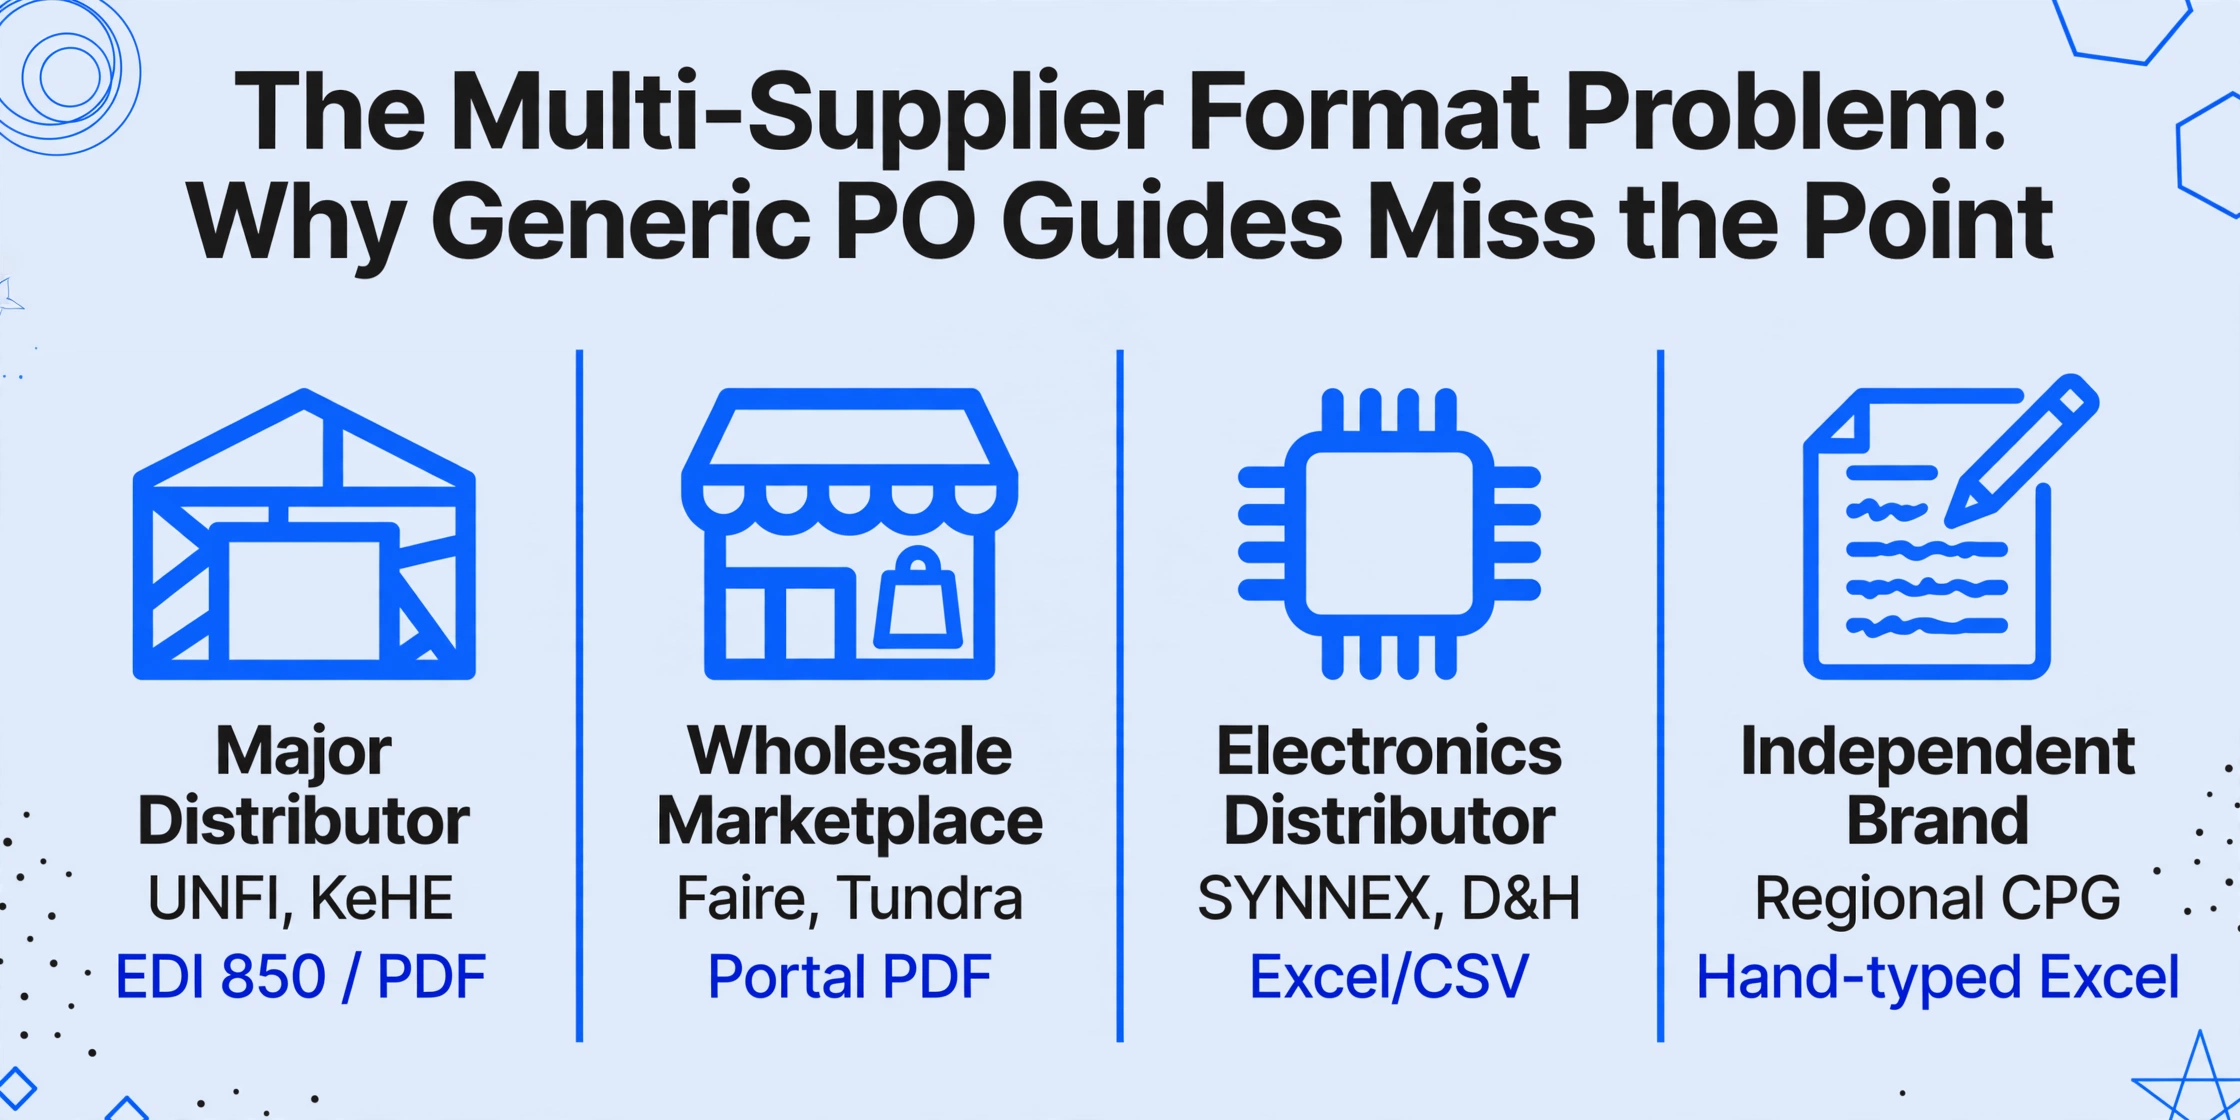
ほとんどのPO抽出記事は標準的な形式 — ヘッダーブロックとその下の明細行テーブルを持つPDF — を前提としています。しかし、小売バイヤーが直面する形式の多様性は、一般的なガイドが決して認識していないものです:
| サプライヤー区分 | 例 | 一般的な形式 | 抽出の課題 |
|---|---|---|---|
| 大手卸売業者(EDI) | UNFI、KeHE、McLane | EDI 850 / ポータルPDF書き出し | 自社のSKUではなくGTIN/UPCコードを使用。明細行はパレット単位のSSCC-18物流コードを参照しており、製品SKUと1対1で対応しない |
| 卸売マーケットプレイス | Faire、Tundra、Abound | ポータル生成PDF / メール確認 | 製品名がブランドデザインに埋め込まれている。SKUは画像下の小さな文字に記載されることが多い。注文合計が出荷期間ごとに分割されている |
| 家電卸売業者 | SYNNEX、D&H、Ingram Micro | Excel/CSVダウンロードまたはメール添付 | 列ヘッダーが卸売業者内部のコードを使用。商品説明は省略された技術仕様で、小売向けの製品名と一致しない |
| 独立ブランド / 小規模サプライヤー | 地域CPGブランド、地元の職人 | 手入力のExcelテンプレート、あるいは手書きフォームの写真 | 標準化されたフィールドがない。数量とコストに、代替品や納期変更に関する手書きメモが混在。ケースパックと単位の曖昧さ |
この形式の細分化こそが本当のボトルネックです。小売バイヤーに必要なのは1つの抽出設定ではなく、これらすべてに対応する1つの抽出設定です。当社のバッチPO抽出ガイドで説明したように、核となる仕組みは形式に関係なく同じです:抽出したい列を定義し、AIが各ドキュメントを読み取って一致する値を探します。しかし、小売特有のレイヤー — SKUクロスリファレンス、仕入原価の計算、部分受領の追跡 — こそが、抽出したデータを使える在庫インテリジェンスに変えるのです。
「サプライヤーごとに1つのフォーマット」という前提こそ、ほとんどのPO抽出ツールが小売業で失敗する理由です。
テンプレートベースのOCRツールでは、各サプライヤーのPOレイアウトにバウンディングボックスを描く必要があります。15社のサプライヤーがそれぞれ異なるフォーマットなら、15個のテンプレートが必要です。1社のフォーマットが変われば、テンプレートを作り直すことになります。小売業の在庫回転率は、テンプレートのメンテナンスを待ってはくれません。
ステップバイステップ:サプライヤーPOから小売在庫スプレッドシートを作成する
ここでは、あらゆるフォーマットの発注書から在庫管理に使えるスプレッドシートを生成するワークフローを紹介します — サプライヤーごとのテンプレート設定は不要です。
在庫スプレッドシートの列を定義する
空白のシートを開き、抽出結果が入力されるターゲット列(ヘッダー)を作成します。小売在庫スプレッドシートの場合、以下を含めます: 仕入先名、仕入先PO番号、仕入先SKU/コード、社内SKU、商品説明、発注数量、受領数量、仕入先単価、運送費(配賦)、仕入原価、納品予定日、ステータス。抽出ツールはこれらの列名を使用して各PO内の一致するデータを特定します。「仕入先SKU/コード」と列名を入力すると、すべての文書から仕入先の製品識別子を検索します。
すべてのPOを一度にアップロードする
FaireのPDF、SYNNEXのExcelシート、小規模ベンダーからのメールのスクリーンショットなど、あらゆる形式を1回のアップロードで取り込みます。仕入先や形式ごとに事前に分類する必要はありません。各文書は独立して処理され、結果は1つのテーブルに統合されます。各行は1つのPOの1つの明細項目を表します。ここでテンプレート不要の抽出が真価を発揮します: 10社の仕入先からの30件のPOを1ステップでアップロードでき、30分かかるセットアップを10回行う必要はありません。
統合テーブルを確認する — 特にSKUの相互参照
抽出により、すべてのPOの全明細項目を含む統合テーブルが生成されます。仕入先SKU/コード列をスポットチェックしてください。これは社内SKUへのマッピングの鍵となります。5分のレビューでエッジケースを発見できます: メインのSKUとは別のフィールドに「Variant: 8oz」と記載されているFaireのPO、または数量列に数値の代わりに「ea」と手入力されたExcelシートなど。データが実際の在庫シートに入る前に、異常を修正してください。
XLSXにエクスポートして在庫トラッカーに接続する
統合テーブルをExcelファイルとしてエクスポートします。マスター在庫スプレッドシートを管理している場合は、VLOOKUPまたはINDEX-MATCHを使用して、SKUごとに発注残数量を在庫シートに取り込みます。Cin7、Lightspeed Retail、Zoho Inventoryなどの在庫ソフトウェアを使用している場合、ほとんどのプラットフォームがPOデータのXLSXインポートに対応しています。重要なのは、インポートするファイルにすでに列構造が含まれていることです。抽出からインポートまでの再フォーマットは不要です。
上記のプロセスは標準的なPOデータに適用されます。以下の埋め込みツールで実際の動作をご確認いただけます — 発注書をアップロードすると、AIがページ上のどこに表示されていても各フィールドを特定する様子をご覧いただけます。
ファイルは安全に処理され、保存されることはありません。
抽出を超えて: 仕入原価、部分受け入れ、その他の小売現場の現実
POデータをスプレッドシートに取り込むことは前半です。後半 — 小売特化型スプレッドシートの成否を分ける部分 — は、数字がきれいに合わない場合に何が起こるかです。
仕入原価の配分: 「単価」が実際のコストになることは決してない理由
UNFIから出荷を受け取ったとしましょう: 商品価値$5,000、運送費$400、燃料サーチャージ$75、取り扱い手数料$25 — 追加コスト合計$500です。出荷額の60%がSKU A、40%がSKU Bの場合、SKU Aは運送費の$300を吸収し、SKU Bは$200を吸収します。サプライヤーの単価のみを記録するスプレッドシートは、実際の在庫コストを10%過小評価し、それが不正確な利益率レポートや誤った再発注判断につながります。
計算列の抽出を使用すると、この配分ロジックを抽出ステップに直接組み込むことができます。仕入原価単価(サプライヤー単価+配分運送費)という列を定義し、配分ルールを指定します — たとえば、出荷全体に対する価値比例配分など。AIは抽出中にこれを計算し、エクスポートされたスプレッドシートには調整済みのコストがすでに含まれています。別途の調整ステップは不要です。
部分受け入れ:60ユニット中48ユニットが届いた場合
サプライヤーが常に全量を出荷するとは限りません。60ユニットのPOが今週30ユニット、来週30ユニットで届くこともあれば、48ユニットが届き12ユニットが無期限にバックオーダーになることもあります。手動のスプレッドシートでは、行を2回更新し、どの数量がどの受領イベントに属するかを追跡する必要があります。上記のアプローチ(注文数量と受領数量の列を分け、バックオーダー列を計算する方法)はこれをネイティブに処理します。部分的な出荷を受け取るたびに、その明細行の受領数量のみを更新すれば、バックオーダー値は自動的に再計算されます。
正式な受領ワークフローを使用する小売業者の場合、発注書からExcelへの変換ツールを受領プロセスに統合できます:元のPOと一緒に梱包明細をスキャンまたはアップロードし、両方を抽出して、注文数量と受領数量を1つのビューで比較できます。
データから意思決定へ:再発注トリガー
このワークフロー全体の最終目標はスプレッドシートではなく、棚が空になる前に再発注のタイミングを知ることです。在庫シートに追加する価値のある1つの列は、シンプルな再発注フラグです:(手持ち数量+発注中数量-バックオーダー数量)が再発注点を下回ると、フラグが点灯します。抽出した正確なPOデータを利用するこの単一の数式は、静的な在庫リストをアクティブな在庫管理ツールに変えます。
よくある質問
海外サプライヤーからの異なる通貨に対応できますか?
はい。抽出はPOに表示されている通貨(USD、EUR、GBPなど)を読み取ります。在庫スプレッドシートで全コストを基準通貨にする必要がある場合は、抽出時に標準の為替レートを適用する計算列を追加してください。出力はコストが変換済みの統合テーブルになります。
小規模なサプライヤーが手書きのフォームや写真でPOを送ってきた場合は?
AIは手書きや紙のフォームのスマホ写真を読み取ります—スキャナーは不要です。スマホから記入済みのPOフォームの写真をメールで送るサプライヤーでも、機械生成のPDFと同じ抽出結果が得られます。手書きの数字(数量、価格)の精度は高いですが完璧ではありません。簡単な確認パスで誤読を修正できます。これは、文書全体をゼロから入力するよりはるかに速いです。
EDIを発注書に使う場合と比べてどうですか?
EDI(電子データ交換)は大規模な卸売業者には有効です。UNFIがEDI 850を送信し、あなたのシステムが自動で取り込みます。ただし、EDIは取引先ごとの設定が必要で(初期設定に1社あたり$1,500〜$5,000以上、さらに継続的な費用がかかります)、EDIに対応している仕入先でのみ利用できます。小規模ブランド、マーケットプレイス専売業者、海外の仕入先はEDI接続を提供することはほとんどありません。文書レベルの抽出がそのギャップを埋めます。仕入先が実際に送ってくるあらゆる形式を処理でき、仕入先ごとの設定は不要です。多くの小売業者はEDIを上位3〜5社の卸売業者に使い、残りの20社以上の仕入先には文書抽出を利用しています。この2つのアプローチは互いに補完し合います。
抽出後、私のデータはどうなりますか?
ファイルは抽出処理後に削除されます。抽出されたデータはスプレッドシートにエクスポートされ、セッション終了後は文書やデータは保持されません。商業上機密性の高い仕入先価格を扱う小売業者にとって、これはコストデータが第三者サーバーではなくスプレッドシートに残ることを意味します。
同じ列テンプレートを毎月再利用できますか?
はい。列構造(仕入先名、仕入先SKU、発注数量、受領数量、仕入原価単価、納品予定日、ステータス)を一度定義したら、テンプレートとして保存できます。翌月のバッチは同じ列、同じ抽出ロジックを使い、同じスプレッドシート構造にデータを出力します。変わるのはPO自体だけです。
どの小売バイヤーも、仕入先の数が手動データ入力の速度を上回る時点にいずれ到達します。スプレッドシート自体がボトルネックなのではなく、文書とセルの間の受け渡しが問題なのです。列名で定義された抽出でそのギャップを埋めることで、構造を一度定義すれば、形式に関係なくすべての仕入先のPOが同じ在庫ビューに取り込まれます。