請求処理の80% —
自動化が見落としている部分
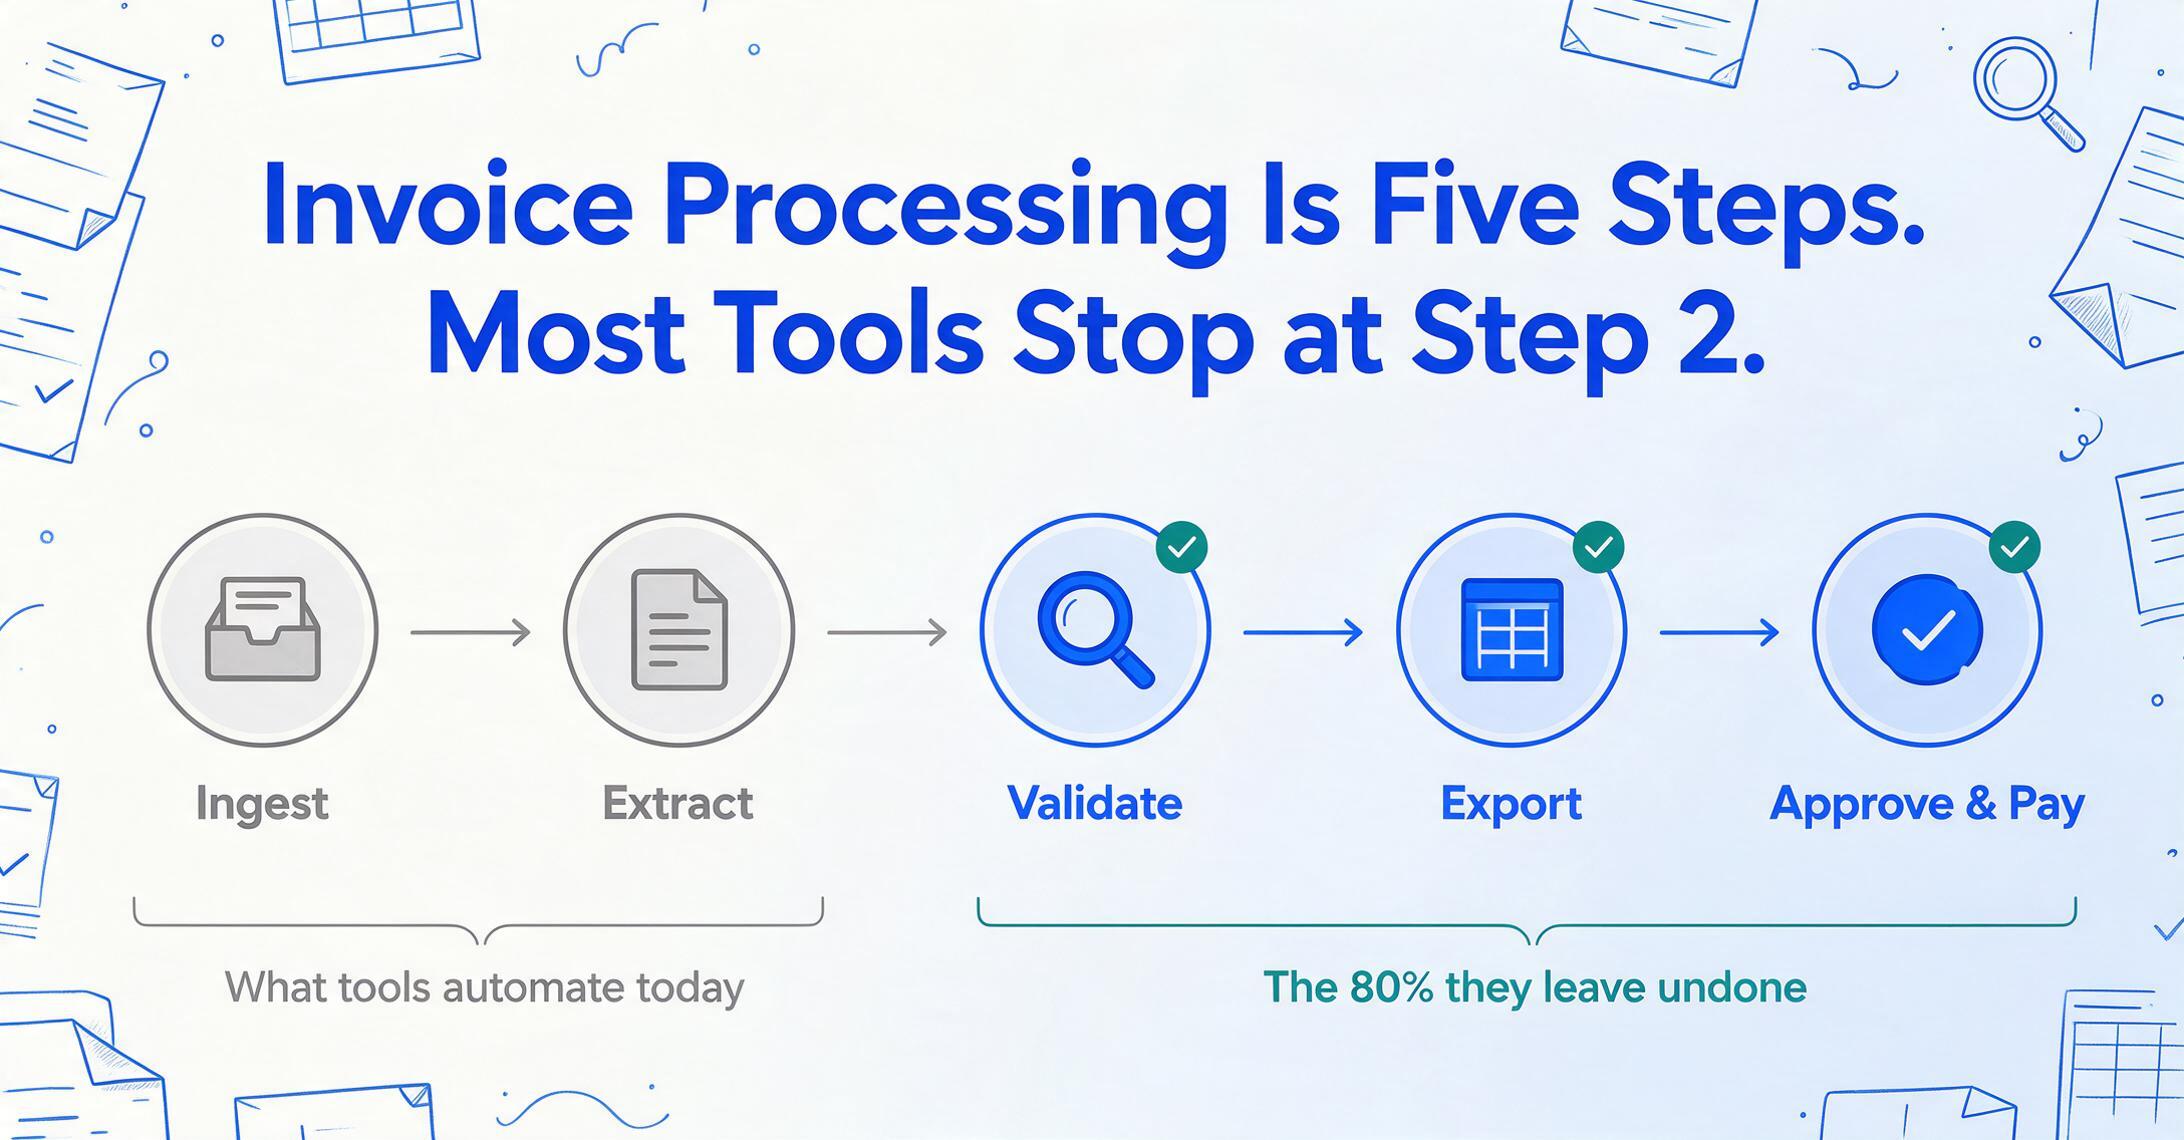
Vic.aiの2025年AIモメンタムレポートによると、AP担当者の37%が今も手動データ入力が最大の課題だと回答しています — 承認の遅さ、処理コストの高さ、支払い遅延よりも多い数字です。2026年において、これは驚くべき数字です。何年も前から「請求書自動化」ツールが多数市場に出ているにもかかわらずです。しかし、実際に請求書を処理している人々に話を聞くと、別の状況が見えてきます。r/AccountingのあるRedditユーザーはこう述べています。「抽出は、うまくいっても問題の20%程度に過ぎない。本当の時間の浪費はその周りにある — 正しいPOへの照合、合計が一致しない理由の解明、承認の追跡、例外処理だ。」ほとんどの自動化ツールは最初の20%を解決して、それで完了としています。
重要なポイント
- ほとんどの請求書自動化ツールは、最も簡単な20% — ページからテキストを読み取ること — だけを解決し、残りの80%の時間を消費する照合、検証、承認ステップにはまったく手を付けていません。
- ベストインクラスのAPチームの1件あたり$2.78と、その他のチームの$12.88という5倍のコスト差は、優れたOCRによるものではありません — 抽出後のすべてを自動化することによるものです。
- 取り込みから支払いスケジュールまでの完全なパイプラインにより、1件あたりのコストは$1.00未満に抑えられます。最大の節約は、手動プロセスでは決して気づかない目に見えない損失から生まれます — 見逃した早期支払割引だけで、$10 millionの買掛金に対して年間$140,000にも上る可能性があります。
請求書自動化が実際に機能しなくなるポイント
ほとんどの請求書自動化に関する記事 — そしてほとんどのツール — は同じ流れをたどります:PDFをアップロードし、ベンダー名、番号、日付、合計を抽出し、Excelにエクスポート。完了。問題は、実際の請求書処理がそういう仕組みではないことです。
抽出後、実際のAPチームは発注書と入庫確認に対するスリーウェイマッチングを行い、ベンダーが使用した形式に関係なく日付を標準化し、重複する請求書番号を検出し、請求書を適切な承認者にルーティングし、正しい総勘定元帳 (GL) 勘定に経費をコード化し、支払いをスケジュールできるようになる前にすべてを会計ソフトウェアに入力しています。そのどれもが抽出ステップでは発生しません。
数字がそれを裏付けています。APQCの2024-2025年のベンチマークデータによると、請求書1件の処理にかかる中央値コストは全体で$21.40、上位四分位の組織では$10.18です。Ardent Partnersの最新調査によると、ベストインクラスのAPチームは請求書を1件あたり$2.78で処理しているのに対し、他の企業は$12.88 — 約5倍の差があります。その違いは、ベストインクラスのチームがより優れたOCRを持っているからではありません。パイプライン全体を自動化しているからであり、このガイドがカバーするのはその点です。
データ取得と入力は、請求書処理コスト全体の30〜35%を占めており、最大の費目です。例外処理はさらに20〜25%を占めます。両方を一緒に自動化することで、経済性が変わります。
ステップ1: 処理開始前にすべての請求書を1か所に集める
各請求書を手動で探してアップロードする必要があるワークフローは、自動化されていません。AIに触れる前にできる最初の構造的な改善は、請求書の受け取り先を一元化することです。
請求書はさまざまな経路で届きます。メールの添付ファイル(ベンダーからのPDF)、サプライヤーポータルからのダウンロード、同僚からの転送、紙の請求書をスマートフォンで撮影した写真などです。プロセスが「まずファイルを探す」ことから始まるなら、すでに時間を失っています。
一般的な取り込みパターン3つ
メール転送
専用アドレス([email protected])を設定します。ベンダーや同僚がそこに請求書を転送すると、すべてが1つのキューに集まります。
クラウドフォルダーの監視
Google DriveやSharePointのフォルダーをツールに指定します。ファイルを置くと、処理が自動的に開始されます。
コレクションリンク
ベンダーやリモートスタッフにリンクを送信します。相手は直接アップロードでき、ファイルは処理キューに届きます。相手側のログインは不要です。自社のシステムを共有していない複数のサプライヤーから請求書を収集する場合に特に便利です。
ここでの目標は複雑さではなく、一元化です。すべての請求書が同じ受け取り窓口に届くようになれば、残りのワークフローは反復可能になります。
ステップ2: ベンダーごとにテンプレートを作らずにデータを抽出する
ここは、ほとんどの「自動化」記事が時間を費やすステップですが、重要な違いは抽出の方法です。従来のOCRツール — および多くの第一世代の請求書処理ツール — はテンプレートマッチングを使用します。ベンダーAの請求書テンプレートの請求書番号フィールドにボックスを描画すると、ツールは次回そこを確認することを記憶します。ベンダーAがレイアウトを変更したり、異なる形式のベンダーBを追加したりすると、テンプレートは壊れて再構築が必要になります。
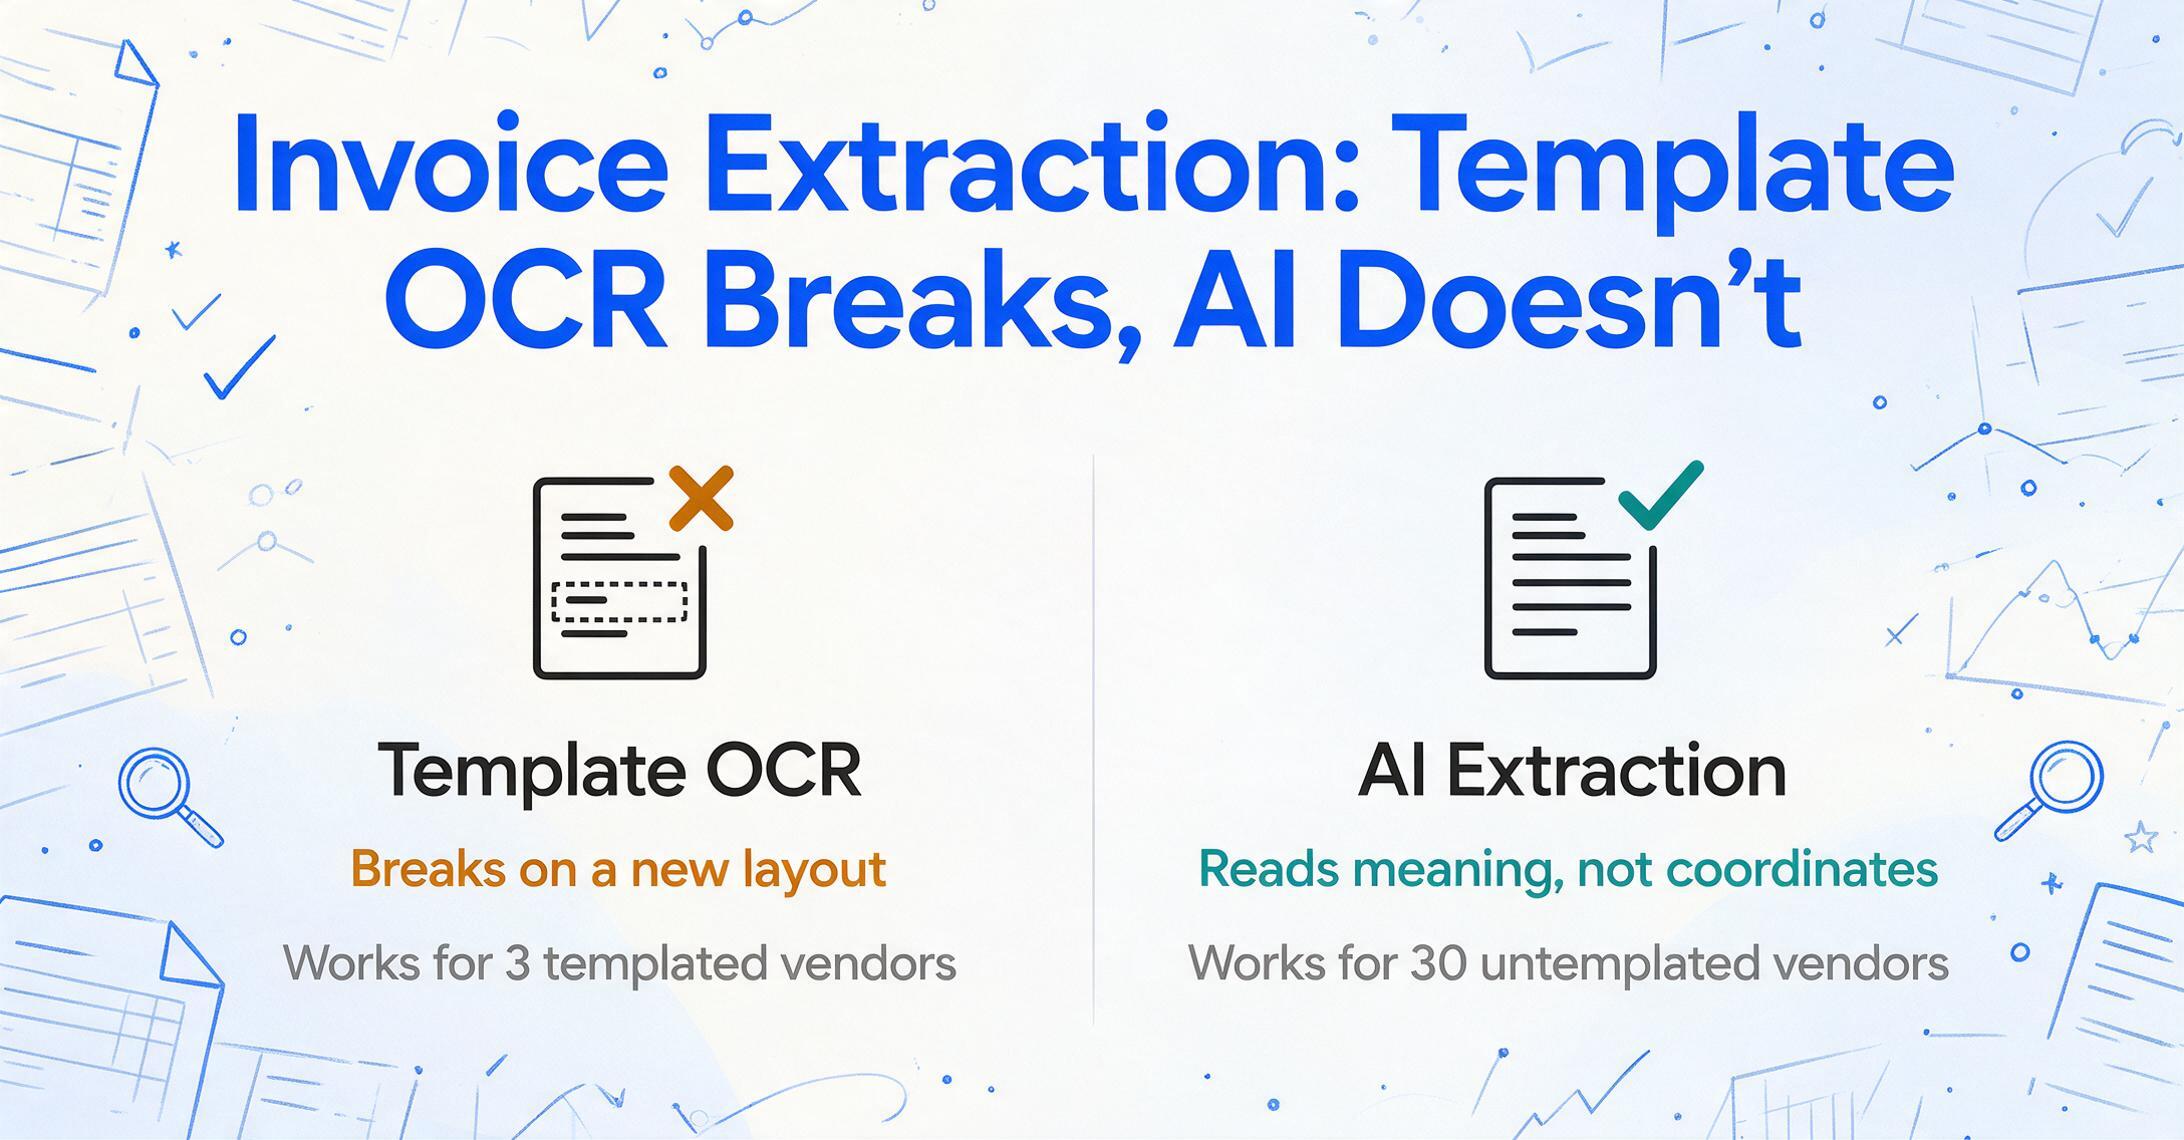
最新のAI搭載抽出は異なる方法で機能します — 請求書処理ワークフローでステップバイステップのデモをご覧ください。テンプレートベースまたはゾーンOCR(データがどこにあるかを記憶する)の代わりに、カスタム列抽出は視覚言語モデルを使用して、データがページのどこに表示されるかに関係なく、データが何を意味するかを理解します。抽出したいフィールド(「請求書番号」「支払期日」「合計金額」「明細項目」)を指定すると、AIは座標を照合するのではなく、ドキュメントの内容を意味的に理解して各値を特定します。
これは、テンプレート化した3社のベンダーで機能するシステムと、テンプレート化していない30社のベンダーで機能するシステムの違いです。また、サンプルデータでモデルをトレーニングしたり、サプライヤーごとに解析ルールを設定したりする必要がない理由でもあります — AIは人間と同じように各請求書を読み取り、位置を記憶するのではなく文脈を理解します。
ファイルは安全に処理され、保存されません。
バッチ処理を扱っている場合 — たとえば月末に50件のベンダー請求書 — このテンプレート不要のアプローチは急速に効果を発揮します。50件すべてを一度にアップロードし、列を一度定義するだけで、50件の個別抽出ではなく、1つの統合スプレッドシートが得られます。スケーリングの詳細については、バッチ請求書処理のガイドをご覧ください。
テンプレート不要の抽出は「少し速いOCR」ではありません。それは異なるパラダイムです。位置ベースの認識と意味理解の違いです。後者はフォーマットの変更に耐えます。前者は耐えられません。
ステップ3: 何かを台帳に反映する前に検証と標準化を行う
抽出は生の出力を生成します。ベンダーによって日付の形式は異なります(MM/DD/YYYY、DD/MM/YYYY、2026-06-22、「2026年6月22日」)。通貨記号($、€、£)を使うところもあれば、税込み合計を先に表示するところもあれば、税抜きを先に表示するところもあります。抽出した生データをそのまま会計システムにエクスポートすると、すべてのベンダーのフォーマットの不整合を受け継ぎ、それを自分の問題にしてしまうことになります。
検証レイヤーは最低限以下を処理する必要があります:
日付の標準化
すべての日付を単一の形式(YYYY-MM-DD)に正規化します。あるベンダーは3月を意味し、別のベンダーは4月を意味する場合に、03/04/2026を月でソートする必要はもうありません。
金額の検証
小計 + 税は合計と一致する必要があります。一致しない場合はフラグを立てます。請求書の合計が発注書 (PO) の金額と一致しない場合は、月末の照合作業ではなく、支払い前にフラグを立てます。
重複の検出
同じベンダー + 同じ請求書番号 = 重複の可能性があります。Redditの小さな会計事務所が、$5,000の重複支払いが発生し、回収に数週間かかったと報告しています。それが自動化に踏み切るきっかけとなりました。
形式ルールとフォーマット
請求書番号からベンダー固有のプレフィックス(「INV-」対「INV#」)を削除します。すべての金額を基準通貨に変換します。可能な場合は、記録から欠落している発注書 (PO) 番号を補完します。
この段階では、計算列も適用できます。これは抽出中に実行される計算であり、後でExcelで行うものではありません。例えば、「明細合計 (数量 × 単価)」として定義された列は、計算結果を出力テーブルに直接生成します。また、「カテゴリ (オプション: 事務用品/ソフトウェア/専門サービス/その他)」のような列では、文書に「カテゴリ」フィールドが表示されていなくても、AIが請求書の内容から経費カテゴリを推論します。これにより、通常は別の手動分類ステップとなるものを抽出自体に組み込むことができます。
計算列では、計算ロジックの定義が必要です。列名に直接記述するか(上記のデモで動作)、複雑な多段階の導出にはJSONルール形式を使用します(ログインユーザーが利用可能)。
ステップ4:実際のデータ保存先にエクスポート
抽出・検証済みのデータが処理ツール内に留まっている状態は、完成した請求書が誰かの机の上で手入力待ちになっているのと同じです。エクスポートの段階で多くのワークフローが停滞するのは、人々が依然として手作業でシステム間のデータを再入力しているからです。
出力先は利用しているシステム構成によって異なります。小規模事業者やフリーランサーにとっては、多くの場合、ExcelやGoogleスプレッドシートが最終地点です。これらは軽量な台帳や、QuickBooksやXeroにインポートする前の中間保管場所として使われます。中堅企業では、データは会計プラットフォームに直接送られます。大規模組織では、NetSuite、SAP、Microsoft DynamicsなどのERPが対象です。
ここで有用な機能がバッチエクスポートです。30件の請求書を処理し、30個の別々のファイルではなく、1つの出力ファイルを得ます。AIはバッチ内のすべての請求書から抽出データを収集し、1つのテーブルに統合します。各行が1つの請求書、各列が定義したフィールドです。この単一ファイル出力こそが、「データを抽出した」と「データを実際に使える」の違いを生みます。
ステップ5:ループを閉じる — 承認、コード付け、支払いスケジュール
ここまで、クリーンで検証済みのデータを会計システムに取り込めていれば、ほとんどのツールが無視する80%を自動化できたことになります。残りの自動化レイヤー(承認、GLコード付け、支払いスケジュール)は、プロセスをどこまで完全自動化するかを決める段階です。
小規模運用(月200件未満の請求書)では、これらのステップは意図的に手動のままでも構いません。自動処理された30件の請求書を5分でレビューするのは合理的で、人間によるチェックポイントには価値があります。月500件以上の請求書を処理するチームでは、経済性が変わります。
- 承認ルーティング:金額の閾値とベンダーカテゴリに基づいてルールを設定。定期的なベンダーで500ドル未満は自動承認。新規ベンダーや閾値を超える請求書は該当マネージャーにルーティング。これだけでも大きなボトルネック解消になります。Ardent Partnersのデータによると、ベストインクラスのAPチームは請求書処理を3.1日で完了するのに対し、その他のチームは17.4日かかります。
- GLコード付け:定期的なベンダーには、履歴に基づいて経費カテゴリとコストセンターを自動割り当て。新規ベンダーは手動コード付け用にフラグを立てます。ここでAIがカテゴリを推測し(ステップ3で説明)、コード付けのギャップを減らせます。
- 支払いスケジュール:支払条件と割引期間に基づいて最適な支払日を計算。早期支払割引を確実に獲得します。同じArdent Partnersの調査によると、手動APワークフローの企業は利用可能な早期支払割引の20~30%しか獲得できていないのに対し、自動化運用では80%以上を獲得しています。
実際にこれらのシステムを構築した人々のRedditスレッドでも確認されている最善の方法は、例外ベースの設定です。クリーンな70~80%の請求書をエンドツーエンドで自動処理し、残りは明確なルール(PO不一致、データ欠落、新規ベンダー、重複疑い)でフラグを立て、人間にのみルーティングします。これにより、完全自動化のスピードを、盲目的処理のリスクなしで実現できます。
規模別のワークフローの違い
同じ5ステップのワークフローも、取扱量やリソースに応じて最適な形が変わります。
| 小規模(月50~200件) | 中規模(月500~2,000件) | 大規模(月2,000件超) | |
|---|---|---|---|
| 取込 | メール転送+手動一括アップロード | 自動フォルダ監視+仕入先用コレクションリンク | API連携+複数チャネルからの自動取込 |
| 抽出 | テンプレート不要のAI、週1回バッチ処理 | 継続バッチ処理、定義済み列セット | クリーンな請求書はストレートスルー処理、それ以外はAI抽出 |
| 検証 | 簡易手動チェック(30件あたり5分) | 自動ルール+フラグ付き項目のみ目視確認 | 全自動検証、例外のみ目視確認 |
| 出力 | Excel/Googleスプレッドシート→QuickBooks/Xeroに取込 | QuickBooks/Xero/Sageに直接出力 | ERP(NetSuite、SAP、Dynamics)と直接連携 |
| 承認・支払 | 手動確認(この規模では合理的) | ルールベースの自動承認+支払スケジュール設定 | 例外ルーティングによる完全P2P自動化 |
分岐点は月500件の請求書です。それ未満であれば、半自動抽出と手動レビューの組み合わせが、スピードと管理のバランスとして最適です。500件を超えると、パイプライン全体を自動化しないことのコストが顕在化します。手作業で処理する請求書1件につき、人件費が$12~$22加算されます。月1,000件の場合、データ入力だけで月$12,000~$22,000のコストがかかる計算です。
全ワークフロー自動化の本当のROI
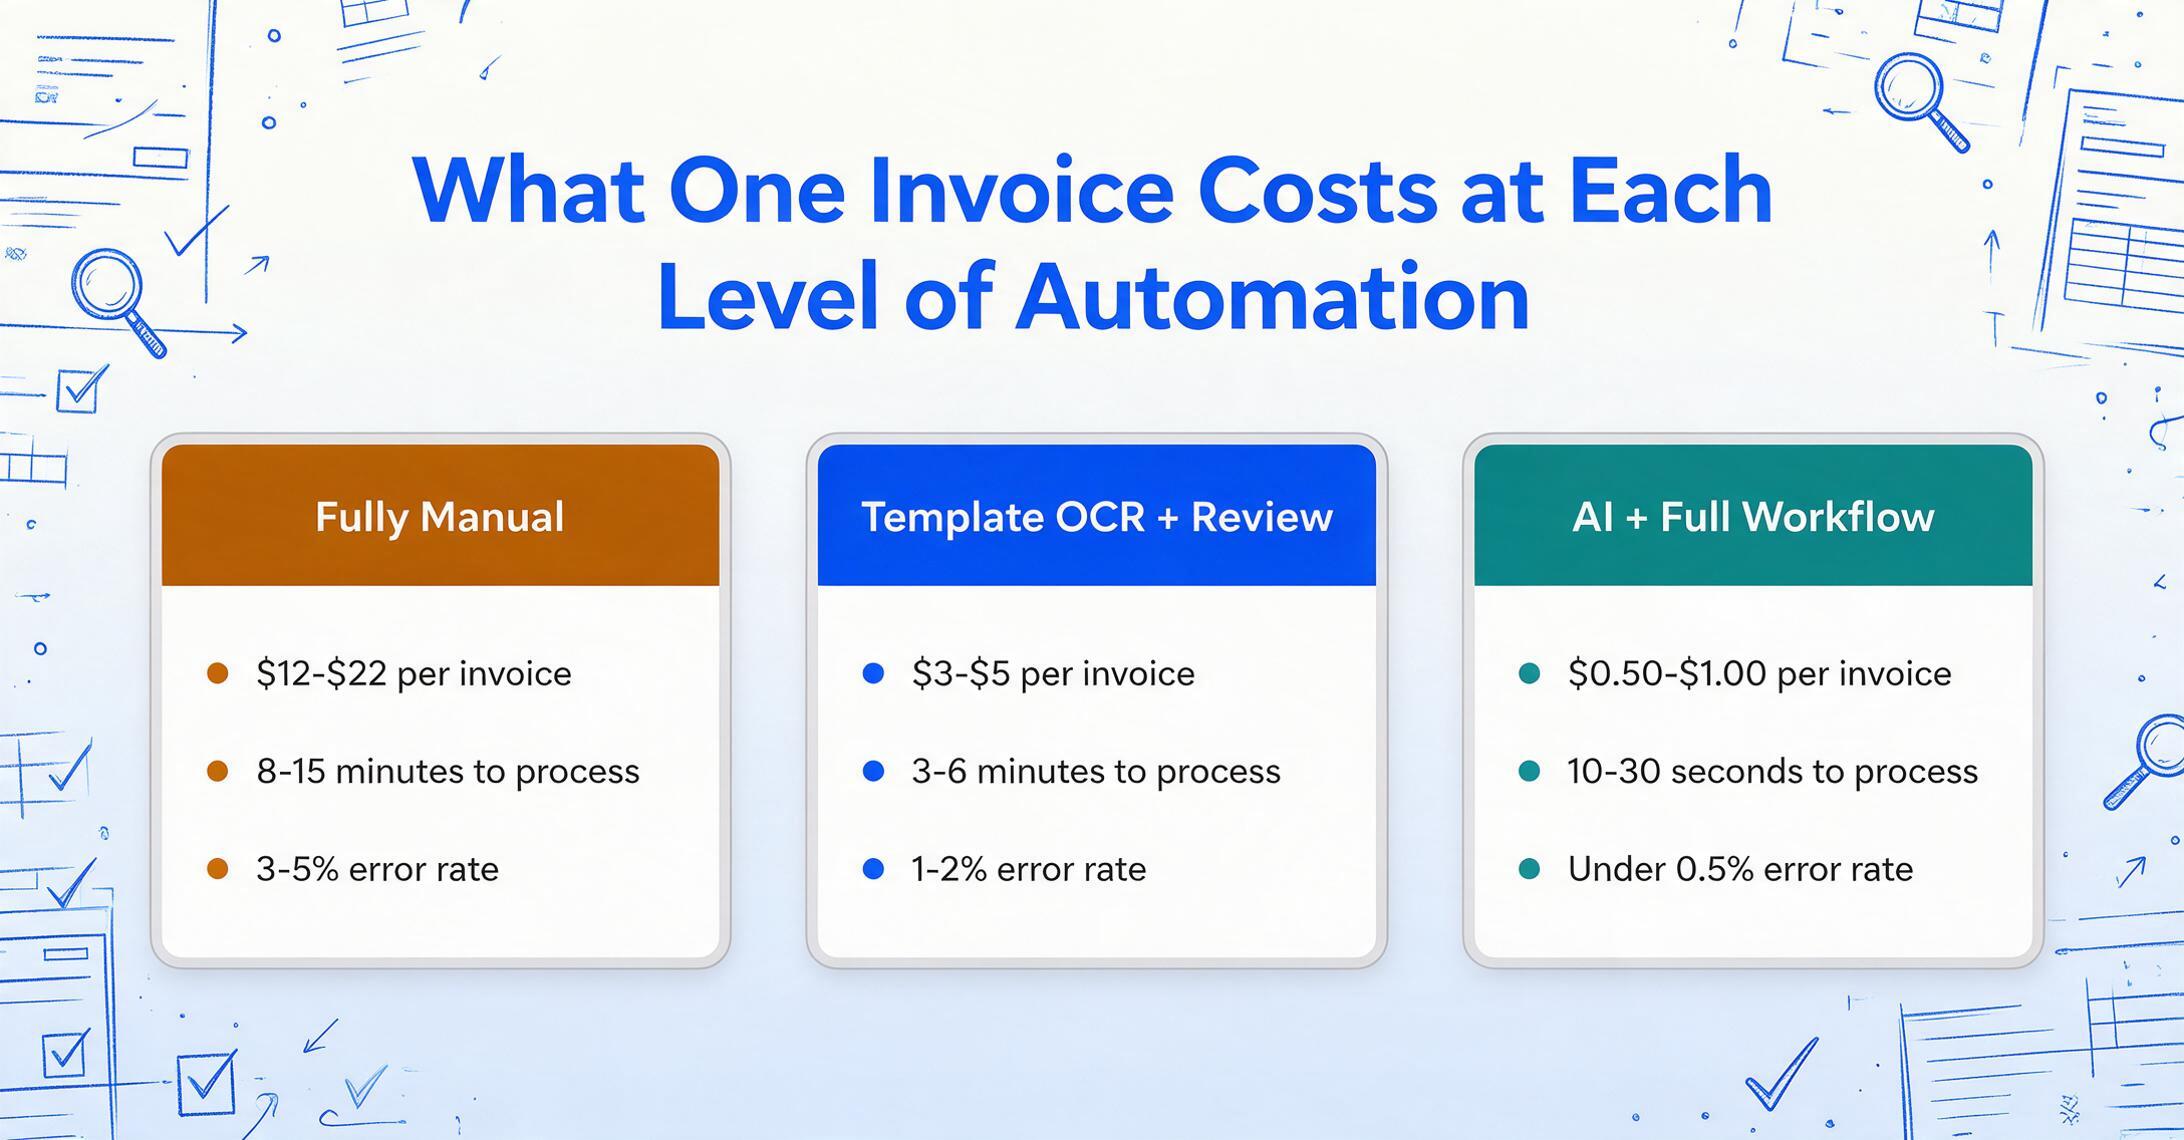
業界全体のコスト数値は、計画に役立つほど一貫しています。
| 自動化レベル | 請求書あたりのコスト | 処理時間 | エラー率 |
|---|---|---|---|
| 完全手動 | $12–$22 | 8〜15分 | 3〜5% |
| 半自動(テンプレートOCR+手動レビュー) | $3–$5 | 3〜6分 | 1〜2% |
| 完全自動(AI抽出+ワークフロー) | $0.50–$1.00 | 10〜30秒 | 0.5%未満 |
これらは理論上の数値ではありません。r/AiAutomationsのRedditユーザーが、小規模会計事務所が週15時間の手動請求書処理から45分に短縮し、6ヶ月間の延滞罰金ゼロを達成した事例を報告しています。エラー率は月12〜15件から1件未満に低下しました。同じチームで月200件の請求書処理から450件の処理に拡大しました。
節約効果は人件費だけではありません。Ardent Partnersによると、手動のAPワークフローを採用している企業は、利用可能な早期支払割引の20〜30%しか獲得できていません。年間$1,000万の買掛金で標準的な2/10 net 30条件の場合、逃した割引だけで年間$140,000〜$160,000に上ります。自動化されたワークフローでは、請求書が割引期間内に処理・承認されることで、獲得率が80%以上に向上します。
請求書自動化による最大のコスト削減は、データ入力時間の削減ではなく、早期支払割引の獲得、重複支払いの排除、延滞料金の回避によるものです。データ入力は目に見えるコストです。これらは目に見えないコストです。
よくある質問
AIは、まったく異なるレイアウトの複数ベンダーの請求書を処理できますか?
はい。それがテンプレートベースのOCR(ベンダーごとにテンプレートが必要)と、最新のAI抽出(請求書を意味的に読み取る)の本質的な違いです。AIは、ある請求書の「請求金額」と別の請求書の「支払総額」が同じ意味であることを理解します。ベンダーごとのフォーマットを学習する必要はありません。ただし、極端に特殊な装飾が施された請求書では、初回の精度が低下する可能性があります。そのため、検証ステップが存在します。
自動化された請求書ワークフローのセットアップにはどのくらい時間がかかりますか?
テンプレート不要のツールの場合、最初のバッチの請求書を1時間以内に処理できます。ファイルをアップロードし、抽出したい列を定義して、バッチを実行するだけです。完全なパイプライン(自動取り込み→抽出→検証→エクスポート→承認)の構築には時間がかかりますが、抽出自体にテンプレートのセットアップやモデルのトレーニングに数週間を要することはありません。あるRedditユーザーは、15社のクライアントに対して月200件以上の請求書を処理する完全なワークフローを合計40時間でセットアップしたと報告しています。単一企業向けのよりシンプルなセットアップは、それよりも短時間で済みます。
AIがフィールドを誤って抽出した場合はどうなりますか?
これが検証ステップの存在理由です。すべての抽出結果を盲目的に信頼するのではなく、ワークフローで信頼度の低いフィールドにフラグを立て、確認のために表示する必要があります。実際には、優れた抽出システムは、鮮明な文書であれば、標準的なフィールド(ベンダー名、請求書番号、日付、合計金額)を95~99%の確率で正確に抽出します。明細項目はより難しく、精度は表の複雑さによって異なります。目標は100%完全自動処理ではありません。目標は、「すべてのフィールドを手入力する」という手作業を、「注意が必要な5%を確認する」に減らすことです。
QuickBooksやXeroでも使えますか?
データ抽出と検証のステップでは、QuickBooks、Xero、またはスプレッドシートのインポートを受け付けるあらゆる会計ソフトウェアにインポート可能な構造化データ(Excel、CSV、Googleスプレッドシート)が生成されます。一部のツールは直接統合を提供していますが、統合がなくても、クリーンなデータをバッチエクスポートして会計プラットフォームにインポートする作業は、数時間の手作業による入力と比較して30秒で完了します。Googleスプレッドシートを使用するチームの場合、アドオンモデルを使用すると、スプレッドシートから離れることなく、抽出されたデータをアクティブなスプレッドシートに直接書き込むことができます。
自動化が費用対効果を持つまでに、何枚の請求書を処理する必要がありますか?
おおよその目安:月に50枚以上の請求書を手動で処理している場合、自動化は最初の四半期で元が取れます。月50枚の請求書を1枚あたり$15の手動コストで処理すると、データ入力に月$750(年間$9,000)を費やしていることになります。$9〜$59/月のAI抽出ツールを使えば、処理コストは月$50未満に削減され、93%の削減となります。月20枚未満の場合、時間の節約は実感できますが、費用対効果は薄くなります。月500枚を超えると、経済効果は圧倒的になります—遅延1ヶ月ごとに数千ドルのコストがかかります。
このワークフローは請求書以外の書類にも使えますか?
はい。同じテンプレート不要の抽出アプローチは、発注書、領収書、銀行明細書、納品書、配送伝票、タイムシート、検査報告書など、非構造化形式から構造化データを抽出したいほぼすべての書類タイプに適用できます。書類タイプごとに抽出したい列を定義します。特定の書類タイプの詳細については、請求書フィールドの抽出およびバッチ文書処理のガイドを参照してください。
請求書処理の自動化は抽出で終わりません。コストの大部分—そして節約の大部分—はその後のステップにあります。パイプライン全体をカバーするツールが、請求書1枚あたり$2.78で処理する最高水準のAPチームと、$12.88で処理する他のチームを分けています。その差はOCR精度ではなく、ワークフローの完全性にあります。
自分の請求書で抽出レイヤーをテストしてください—フィールドを定義し、バッチをアップロードして、結果を確認します。次に、現在のプロセスで次に何が起こるかを確認し、そのステップのうち何件がまだ人間がファイルを開いて入力を開始する必要があるかを考えてみてください。