返却された納品書から印字された出荷データと手書きの受領確認を抽出する方法
納品書はハイブリッド文書です。印字された出荷詳細と手書きの受領マークが含まれます。AI抽出が両方のレイヤーを1回の処理で扱う方法をご紹介します。
署名済み納品書が2つの文書を兼ねる理由
サプライヤーの倉庫を出発する納品書には、一連のデータが含まれています。品目コード、出荷数量、発注書番号、運送会社、出荷日です。これはサプライヤーが発送した内容の記録です。この文書は貨物とともに移動し、受入ドックに到着すると、2つ目のデータ層が追加されます。それは受領側による手書きの注記です。
その注記はノイズではありません。受入チームの運用上の判断であり、法的な重みを持ちます。統一商事法典(UCC第2条)に基づき、書面による例外事項が記載された署名済み納品書は、貨物が完全な状態で受け入れられなかったことを示す文書化された証拠となります。注記がなければ証拠もありません。受領側が、2つの段ボールが潰れて到着したことや、50ユニットの明細行のうち15ユニットが不足していたことを記載せずに署名した場合、サプライヤーは商品が完全な状態で受け入れられたと合理的に主張できます。
この課題は構造的なものであり、手続き上のものではありません。印刷されたデータは設計上、機械で読み取り可能です。手書きの受領確認事項(署名、損傷コード、数量修正、ドライバーIDのメモ)はそうではありません。 それらは紙の上に存在し、人間の目には見えますが、WMSやERPには見えません。受入チームがその日の業務を終えるとき、それらの注記は物理的なコピーに残ります。デジタル記録にはサプライヤーのバージョンがあります。真実は紙の上にあるのです。
これが2層構造の問題です。1枚の納品書、2つのデータシステム、そしてデジタル化されるのはそのうちの1つだけです。
印刷された層だけを読むと失われるもの
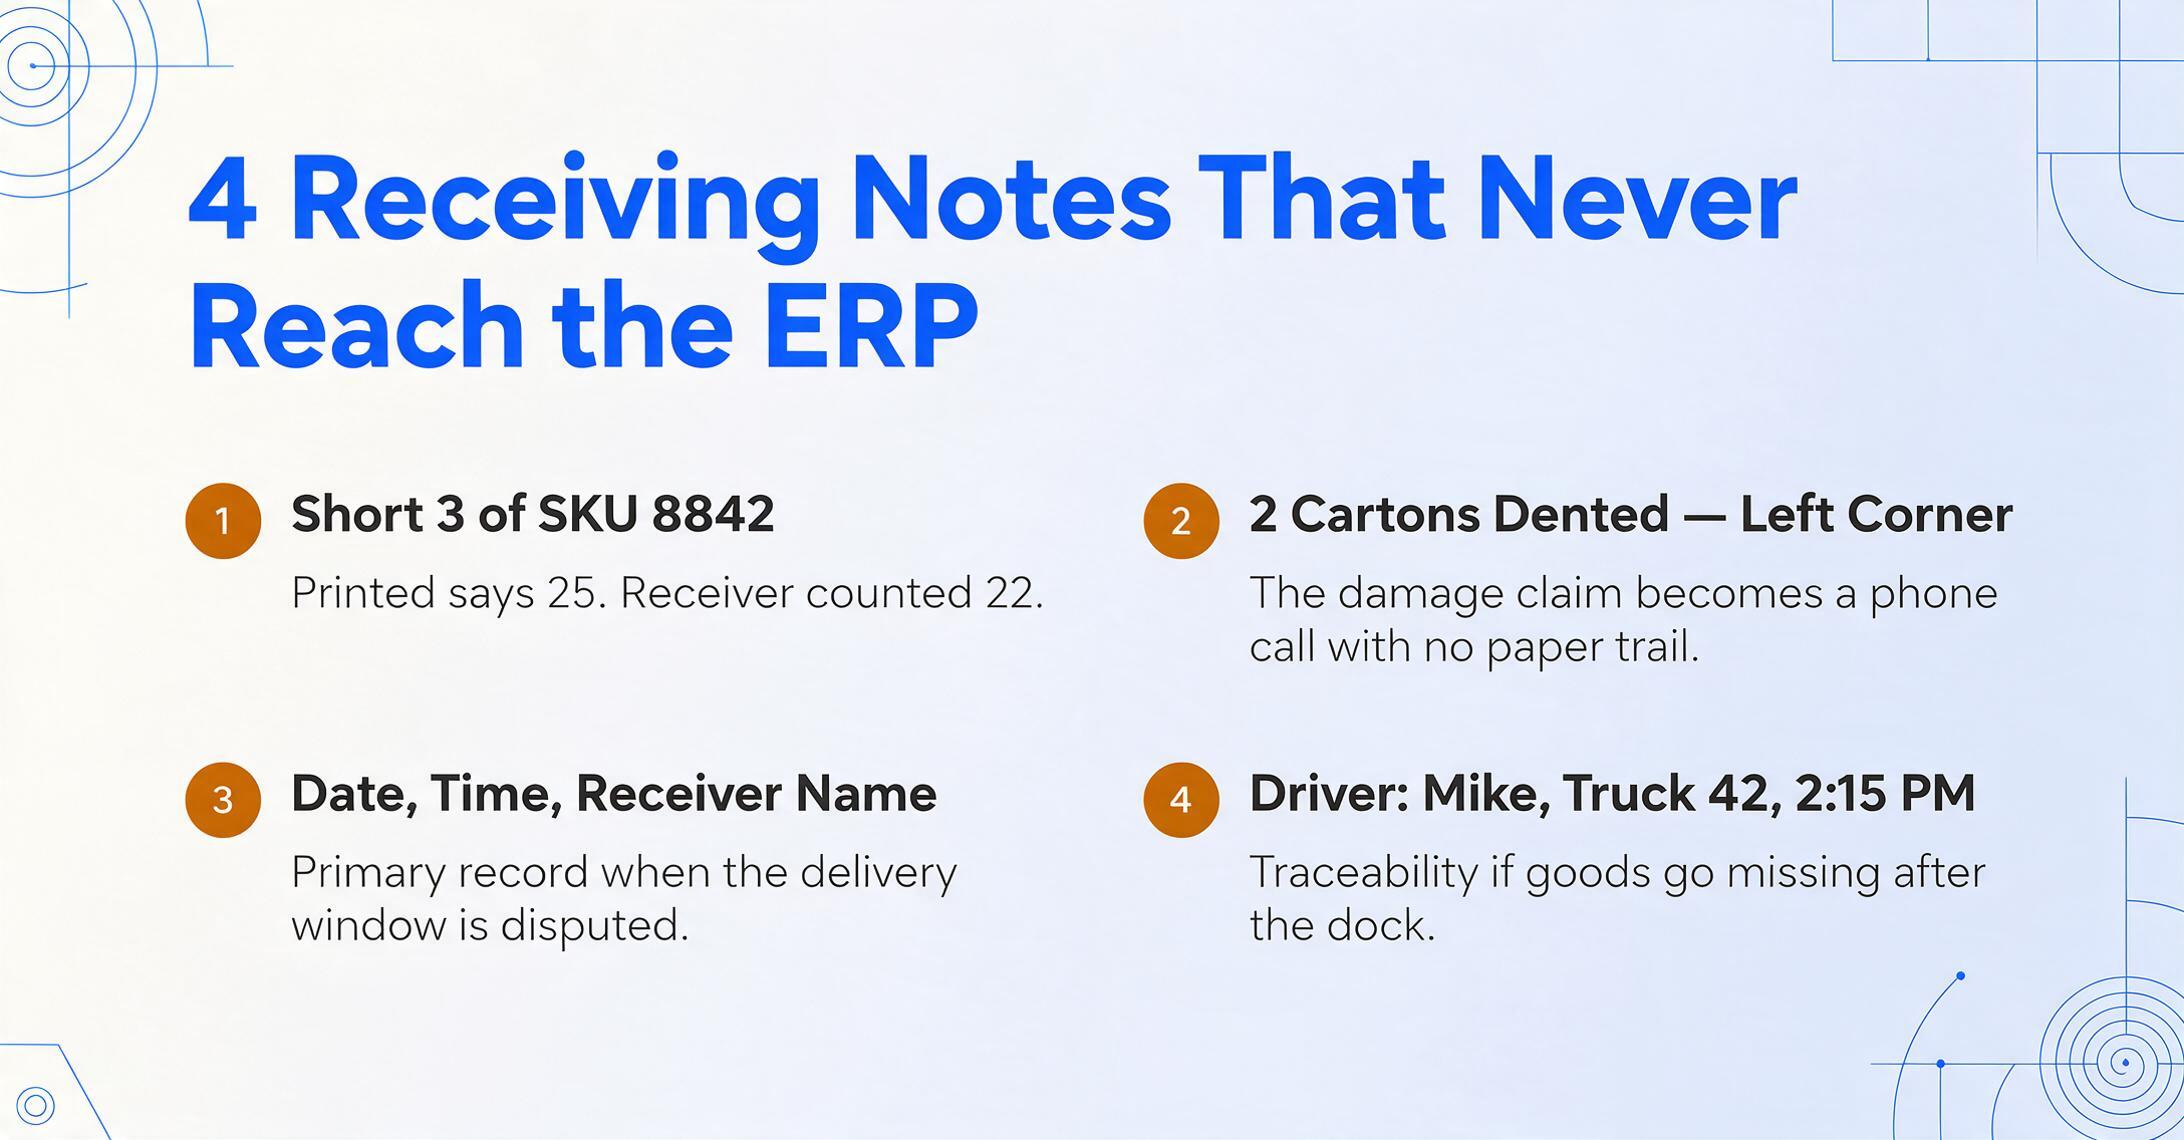
サプライヤーが出荷したものと、受領側が手書きで記録したものとの間のギャップは理論上の話ではありません。印刷されたフィールドだけを抽出する場合に消えてしまう受領注記には、次の4つのタイプがあります。
数量修正
明細行の横に「SKU 8842 が3足りない」と走り書きされている。サプライヤーの印刷数量には25ユニットが出荷されたとある。受領者は22ユニットを数えた。この手書きメモがシステムに入力されなければ、3点照合(発注書・納品書・サプライヤー請求書の照合)では、25ユニット分の全額支払いに対して請求書がフラグ付けされる。買掛金チームには差し止める根拠がない。
損傷の記載
ページ上部に「段ボール2箱が凹み — 左隅」と書かれている。これはサプライヤーが損害クレームを争ったときに必要になる証拠だ。デジタル化されていなければ、クレームは証跡のない電話連絡にすぎない。
受領の日時と署名
手書きの日付・時刻・受領者名は、いつ誰が荷物を受け入れたかを確定する。納品が契約期間内に到着したかどうかの紛争では、これが主要な記録となる。紙のままだと、デジタル監査では役に立たない。
運送会社とドライバーのメモ
「ドライバー: マイク、トラック42、午後2:15」— ドックから格納までの間に商品が紛失した場合のトレーサビリティに不可欠。
この層を失うコストは複利的に膨らむ。損傷メモを1件見逃すだけで、売れない商品に$200を支払うことになりかねない。中規模倉庫の標準的な量である1日50枚の納品書では、記録されない受領例外による月間エクスポージャーは5桁に達する可能性がある。しかもそれは把握できている事例だけだ。
AI抽出が両方の層を同時に読み取る仕組み
従来のOCRは納品書をフィールド位置の問題として扱う。PO番号を座標Xで、出荷日を座標Yで見つける。このアプローチは、サプライヤーがレイアウトを変更した瞬間、あるいは誰かが印刷テキストの上に書き込んだ瞬間に破綻する。
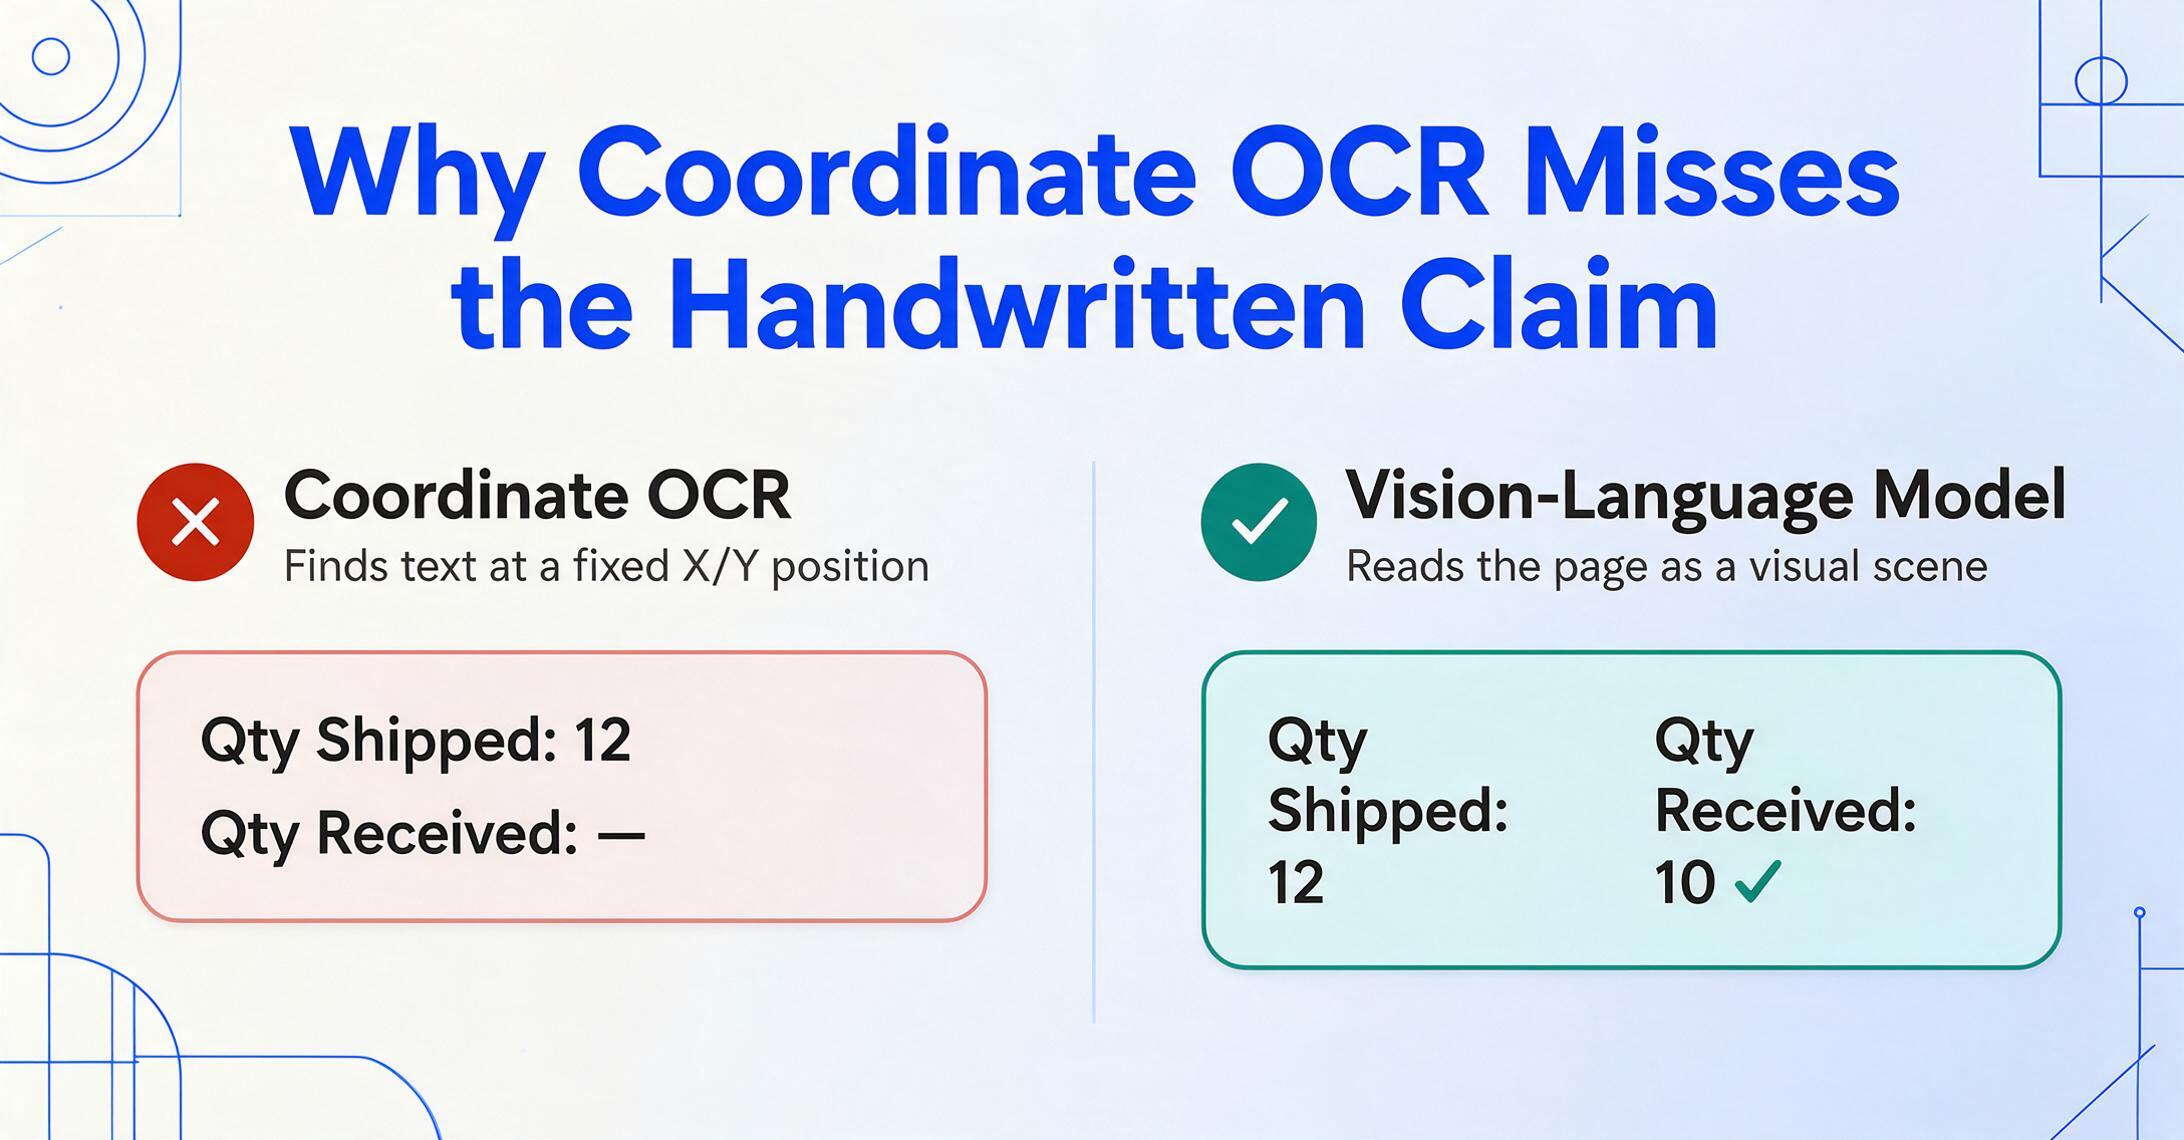
視覚言語モデル(VLM)はこの問題に異なるアプローチで取り組む。固定座標でテキストを探す代わりに、文書全体を視覚的なシーンとして読む。数量カラムに印刷された「12」と、その横に走り書きされた手書きの「10 ✓」が、同じデータポイントに関する2つの異なる主張であることを理解し、両方を別々のカラムに抽出できる。
これがカスタム列抽出の背後にある仕組みだ。「PO番号」「SKU」「出荷数量」「受領数量」「損傷メモ」「受領者」など、必要なカラムを定義すると、AIは値がどこにあるかではなく何を意味するかを理解して、ページ上のどこからでも各値を特定する。印刷フィールドはサプライヤーのテンプレートから、手書きフィールドは受領者の注記から取得される。それらは単一のスプレッドシートの同じ行に配置される。
重要な変化:手書きのマークを抽出の障害として扱うのではなく、印刷されたフィールドと同じように、レイアウト上の位置ではなく内容によって識別されるデータフィールドとして扱うことです。
この記事では、1枚の納品書における2層の問題に焦点を当てます。納品書と配送証明書のワークフロー全体(手作業処理が思ったよりコストがかかる理由、支払いと照合を左右するフィールド、ツールの選び方)については、納品書・配送証明書抽出の完全ガイドをご覧ください。請求やクレームに使用する署名入りの配送証明書が対象の場合は、専用の配送証明書データのExcel抽出チュートリアルをご覧ください。手書きの注記がある署名済み納品書で抽出を試すには、手書き納品書のExcel変換ツールをご利用ください。
ステップバイステップ:印刷フィールドと手書きフィールドを1回で抽出
署名済み納品書の束を、出荷内容と受領内容の両方を含む1つのスプレッドシートに変換するワークフローは次のとおりです。
ファイルは安全に処理され、保存されることはありません。
受入ドックで署名済みの納品書を回収します
ドライバー引き渡しのたびに、受入担当者は注釈入りのコピーを保管してください。ドックで紙の納品書をスキャンします(300 DPIのスマホ写真で十分です)。または、出荷後にサプライヤーがメールで送信するPDF版を収集します。重要なのは、署名済みの紙コピーを引き出しにしまわないことです。アップロードしてください。
両方のデータレイヤーに対応する抽出列を定義します
ここで2層アプローチが具体化します。印刷レイヤーの列:PO番号、SKU、品目説明、出荷数量、出荷日、運送会社、サプライヤー。手書きレイヤーの列:受入数量、損傷メモ(テキストフィールド)、受入者、受入日時、署名ステータス(あり/なし)。これらを抽出インターフェースに列名として入力します。AIは、手書きの注記が印刷テキストのどこに現れても、文書の対応する部分から各項目を自動入力します。
バッチをアップロードし、AIに両方のレイヤーを処理させます
朝の納品書をすべて1つのバッチでアップロードします。サプライヤーポータルからのPDF、ドックでスキャンした紙コピー、受入チームが撮影した写真などです。AIは各文書を列定義に照らして読み取ります。印刷フィールドはサプライヤーのレイアウトから抽出されます。手書きフィールドは受入者の注記から抽出されます。両方が同じ構造化テーブルに行単位で整列して格納されます。
すべてのフィールドではなく、例外のみを確認します
出力スプレッドシートでは、出荷数量(印刷)と受入数量(手書き)を並べて確認できます。不一致(受入者の数量がサプライヤーの数量と異なる場合)はすぐにわかります。差異でフィルタリングし、該当行をサプライヤークレーム処理に転送します。一致するものは追加対応は不要です。かつて50件の納品書を手作業で照合していた作業が、5分のフィルターとレビューで完了するようになります。
出力スプレッドシートの構成
マージされた出力では、明細行ごとに1行が作成され、両方のデータ層にわたる列が含まれます。構成は次のとおりです:
| 発注書番号 | SKU | 出荷数量 | 受領数量 | 損害メモ | 受領者 | 受領日 | ステータス |
|---|---|---|---|---|---|---|---|
| PO-8842 | VT-334 | 50 | 47 | 3個損傷 — 箱の角が潰れている | M. Chen | 2026-06-15 | 不一致 |
| PO-8842 | VT-338 | 100 | 100 | — | M. Chen | 2026-06-15 | OK |
| PO-8912 | SP-401 | 30 | 30 | — | J. Rivera | 2026-06-15 | OK |
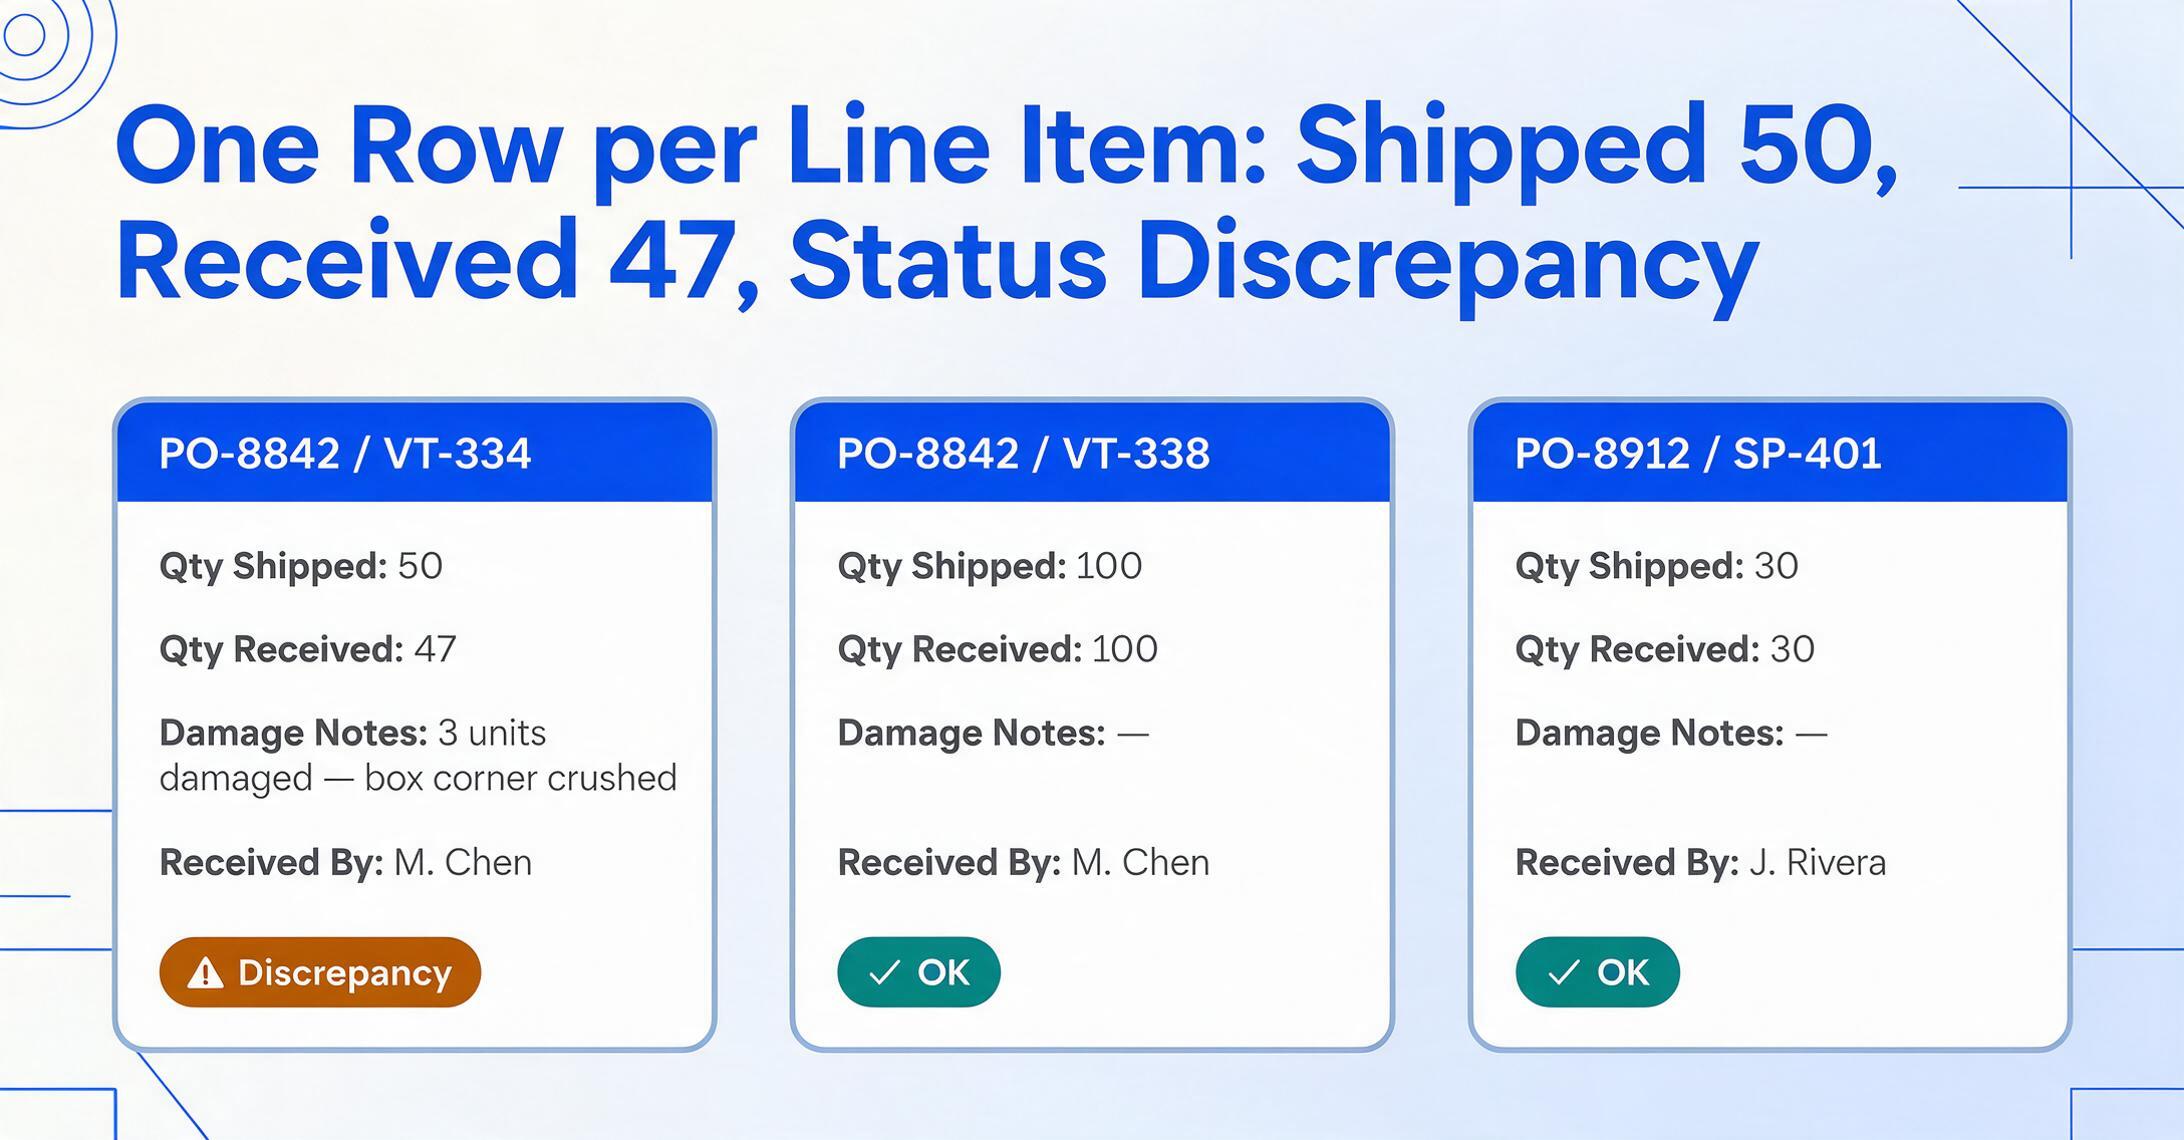
ステータス列は推論列で自動生成できます。ステータス(オプション: OK/不一致)のような列を定義すると、AIが損害メモと数量の不一致を読み取り、正しい値を判定します — 抽出と分類を1回のパスで実行します。標準的なケースでは、別途レビューのステップは不要です。
下流システムとの統合では、このテーブルは3点照合ワークフローに直接取り込まれます。買掛金チームは、請求書を承認する前に、実際に受領したもののデジタル記録を確認できます — サプライヤーが出荷したと主張したものだけでなく。発注書はサプライヤーの主張と一致します。納品書の抽出は実際に到着したものと一致します。これらが一致しない場合、文書化された証拠とともに支払いが保留されます。
よくある質問
納品書に手書きの注釈が密集している場合、手書き文字の抽出精度はどのくらいですか?
精度は読みやすさに依存します。丸で囲まれた数量、「ショート3」、署名など、明確な手書きの修正は確実に抽出されます。印刷文字の上に重ね書きされた密集した走り書き、ひどく擦れたカーボンコピー、水濡れした書類では精度が低下します。実際には、このワークフローはすべての項目を確認するのではなく、フラグが立った例外のみをレビューするように設計されています。AIは両方のレイヤーから可能な限り情報を抽出し、人間の解釈が必要な境界事例はレビューステップで捕捉します。それでも、すべての項目を手動で入力するよりはるかに高速です。
手書きの注釈が印刷テキストと異なる言語の場合でも機能しますか?
はい。視覚言語モデルは、印刷言語に関係なく手書き文字を読み取ります。納品書が英語で印刷されていても、受領担当者がスペイン語やフランス語で注釈を付けていても、AIは両方を抽出します。定義する列名が意味的な期待値を設定します。「受領数量」は、周囲のテキストの言語に関係なく、印刷された数量フィールドの近くにある数値の注釈を探すようにモデルに指示します。
出力で、異なる種類の手書き注釈を区別できますか?
受領数量、破損メモ、受領者など、注釈の種類ごとに個別の列を定義することで、各情報をそれぞれのフィールドに抽出するようAIに指示します。AIは、位置だけでなく、意味的なコンテキストに基づいて、数値の修正、テキストの破損メモ、署名を区別します。注釈が曖昧な場合、出力フィールドは空白または「不明」となり、レビュー時に簡単に識別できます。
受取人が何も注釈を付けず、納品書に署名だけがある場合はどうなりますか?
その場合、手書きレイヤーの列(破損メモ、受領数量調整)は空になり、ステータス列はデフォルトで「OK」になります。例外のない署名済み納品書は受領と見なされます。これは手動プロセスでもまったく同じ解釈です。違いは、デジタル記録によって、ドックで例外が記録されなかったことが正式に文書化される点です。これは「紙のコピーを紛失した」という証拠よりも強力です。
納品書以外に処理できる書類はありますか?
同じ2層抽出アプローチは、印刷データと手書き注釈が共存するあらゆる書類に適用できます。例えば、手書きの確認チェックマークが付いた梱包明細書、ドライバーメモ付きの配送証明書、検査官の注釈付きの入庫伝票、印刷テンプレートに現場所見が書き込まれた検査レポートなどです。抽出メカニズムはテンプレートベースではなくコンテンツベースであるため、書類間でフォーマットが変わってもワークフローが中断されることはありません。
サプライヤーが出荷したものと倉庫が受け取ったものとの間には、常にギャップが存在します。今や、納品書のどちらの面をデジタル化するかを選ぶ必要はありません。印刷された出荷データと手書きの受領確認の両方を抽出し、1つの構造化レコードに統合します。証拠が紙のままだという理由で紛争に負けることはもうありません。