Cómo extraer datos de envío impresos y confirmaciones de recepción manuscritas de albaranes de entrega devueltos
Los albaranes de entrega son documentos híbridos: detalles de envío impresos más marcas de recepción manuscritas. Aprenda cómo la extracción con IA maneja ambas capas en una sola pasada.
Por qué un albarán de entrega firmado es dos documentos en uno
Un albarán de entrega que sale del almacén de un proveedor lleva un conjunto de datos: códigos de artículo, cantidades enviadas, número de orden de compra, transportista, fecha de envío. Este es el registro del proveedor de lo que despachó. El documento viaja con la carga y, cuando llega al muelle de recepción, se añade una segunda capa de datos: las anotaciones manuscritas del receptor.
Esas anotaciones no son ruido. Son el veredicto operativo del equipo de recepción, y tienen peso legal. Según el Código Uniforme de Comercio (UCC Artículo 2), un albarán de entrega firmado con excepciones escritas constituye evidencia documentada de que el envío no fue aceptado en su totalidad. Sin anotaciones, no hay evidencia. Si el receptor firma sin indicar que dos cajas llegaron abolladas o que faltaban 15 unidades de una línea de pedido de 50, el proveedor puede argumentar razonablemente que la mercancía fue aceptada como completa.
El desafío es estructural, no procedimental. Los datos impresos son legibles por máquina por diseño. Las confirmaciones de recepción manuscritas — firmas, códigos de daño, correcciones de cantidad, notas de identificación del conductor — no lo son. Viven en el papel, visibles al ojo humano pero invisibles para el WMS o el ERP. Cuando el equipo de recepción cierra el día, esas anotaciones permanecen en la copia física. El registro digital tiene la versión del proveedor. La verdad está en el papel.
Este es el problema de dos capas: un albarán de entrega, dos sistemas de datos, solo uno se digitaliza.
Qué se pierde cuando solo se lee la capa impresa
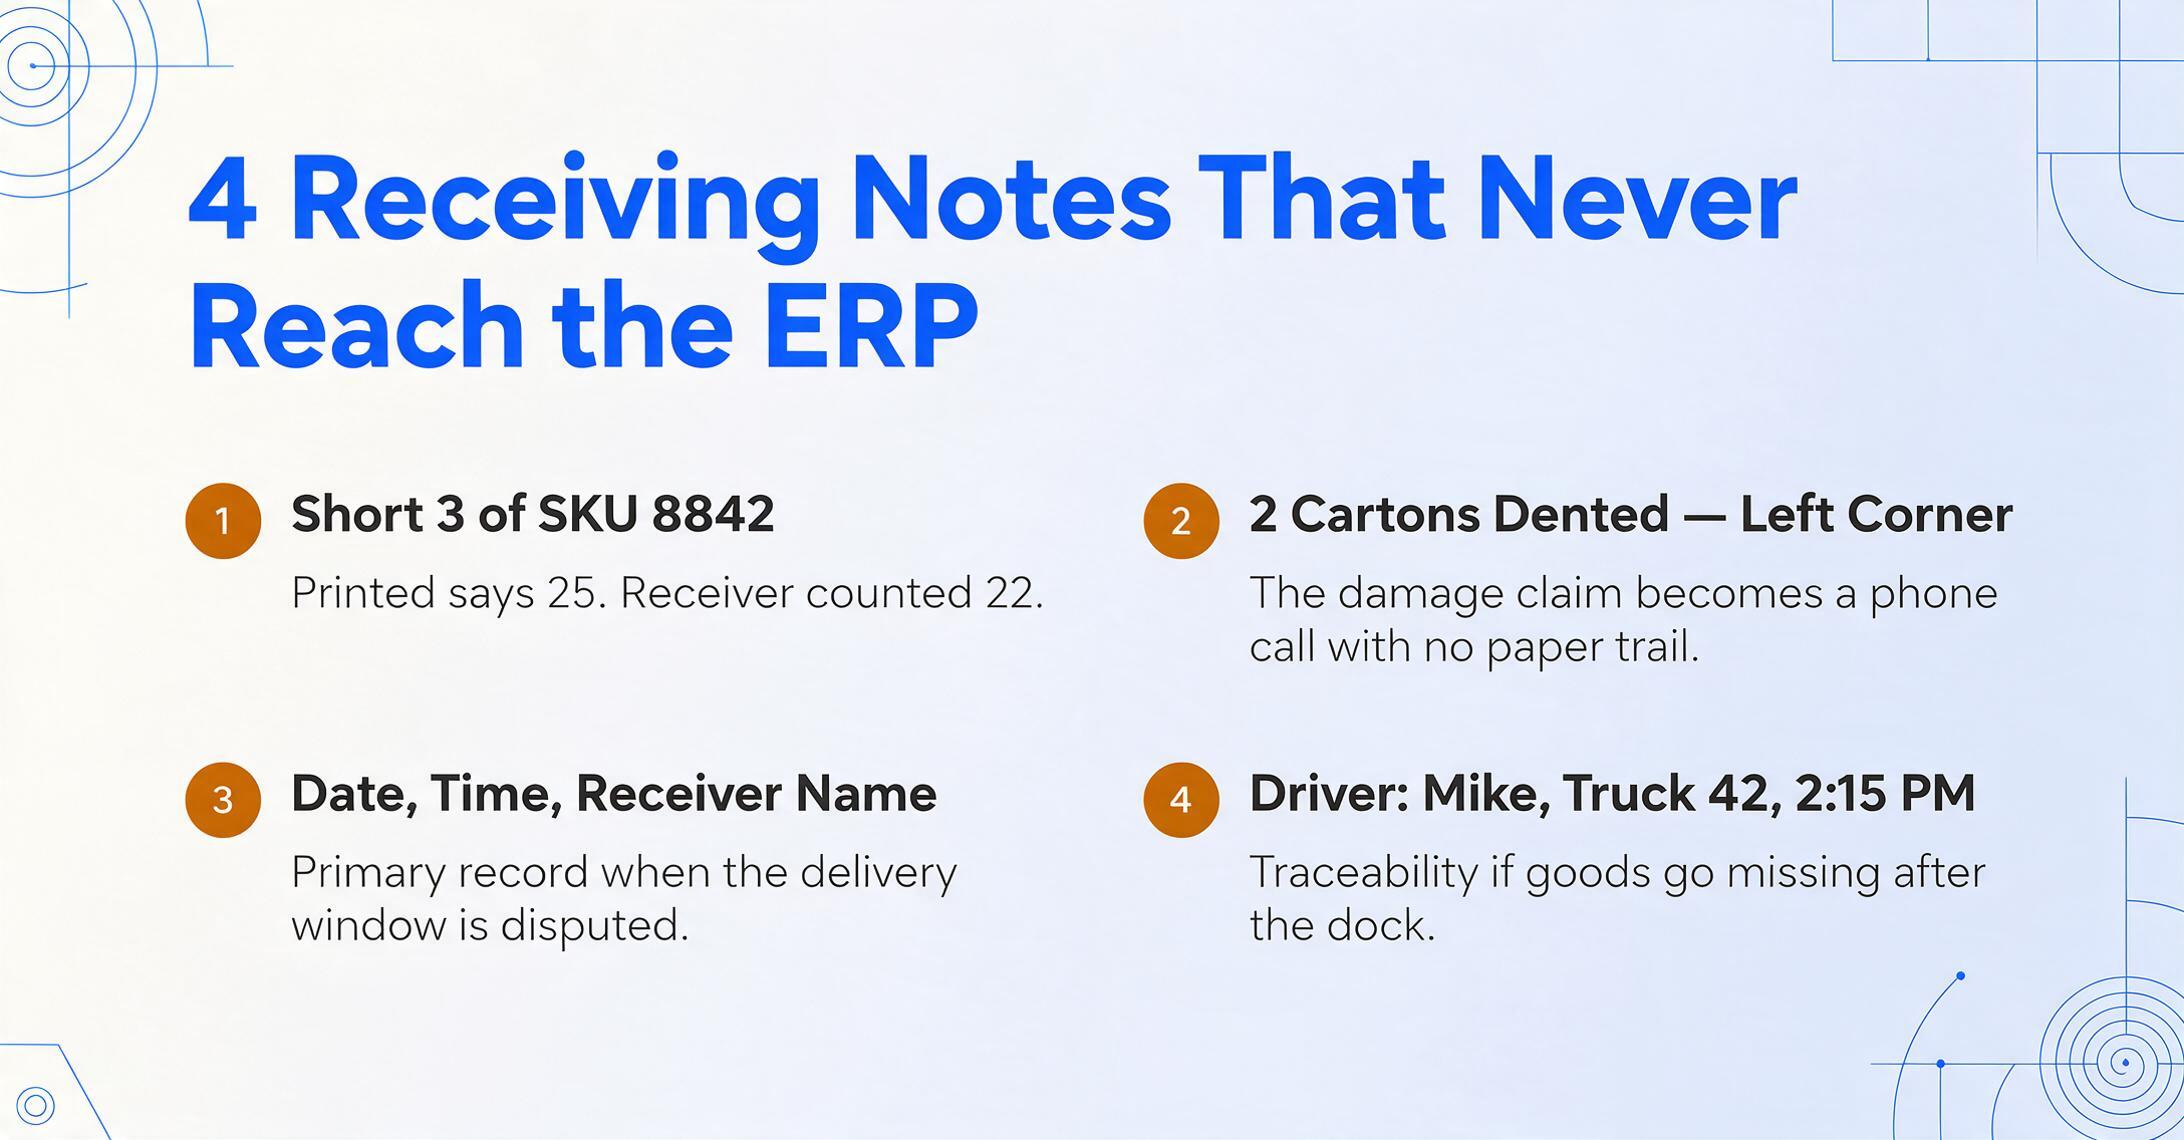
La brecha entre lo que el proveedor envió y lo que el receptor documentó a mano no es teórica. Estos son los cuatro tipos de anotaciones de recepción que desaparecen cuando los equipos solo extraen los campos impresos:
Correcciones de cantidad
«Faltan 3 de SKU 8842» anotado junto a la tabla de líneas de pedido. La cantidad impresa del proveedor indica que se enviaron 25 unidades. El receptor contó 22. Si esa nota manuscrita nunca entra en el sistema, la conciliación a tres bandas —que compara la orden de compra, el albarán de entrega y la factura del proveedor— marcará la factura para el pago completo de las 25 unidades. El equipo de cuentas por pagar no tiene base para retener el pago.
Anotaciones de daños
«2 cajas abolladas — esquina izquierda» escrito en la parte superior de la página. Esta es la evidencia que necesitará cuando el proveedor dispute la reclamación por daños. Sin ella en formato digital, la reclamación es una llamada telefónica sin rastro documental.
Marcas de tiempo y firmas de recepción
La fecha, hora y nombre del receptor escritos a mano establecen cuándo y quién aceptó el envío. En una disputa sobre si una entrega llegó dentro de la ventana contractual, este es el registro principal. Si permanece en papel, es inútil en una auditoría digital.
Notas del transportista y del conductor
«Conductor: Mike, Camión 42, 2:15 PM» — fundamental para la trazabilidad si la mercancía desaparece entre el muelle de recepción y la ubicación en estantería.
El costo de perder esta capa se acumula. Una sola nota de daño pasada por alto puede significar pagar $200 por mercancía que no puede vender. Con 50 albaranes de entrega al día —un volumen típico para un almacén mediano— la exposición mensual por excepciones de recepción no registradas puede alcanzar cinco cifras. Y esas son solo las incidencias de las que tiene conocimiento.
Cómo la extracción con IA lee ambas capas simultáneamente
El OCR tradicional trata un albarán de entrega como un problema de ubicación de campos: encontrar el número de orden de compra en la coordenada X, encontrar la fecha de envío en la coordenada Y. Ese enfoque falla en cuanto el proveedor cambia su diseño —o en cuanto alguien escribe sobre el texto impreso.
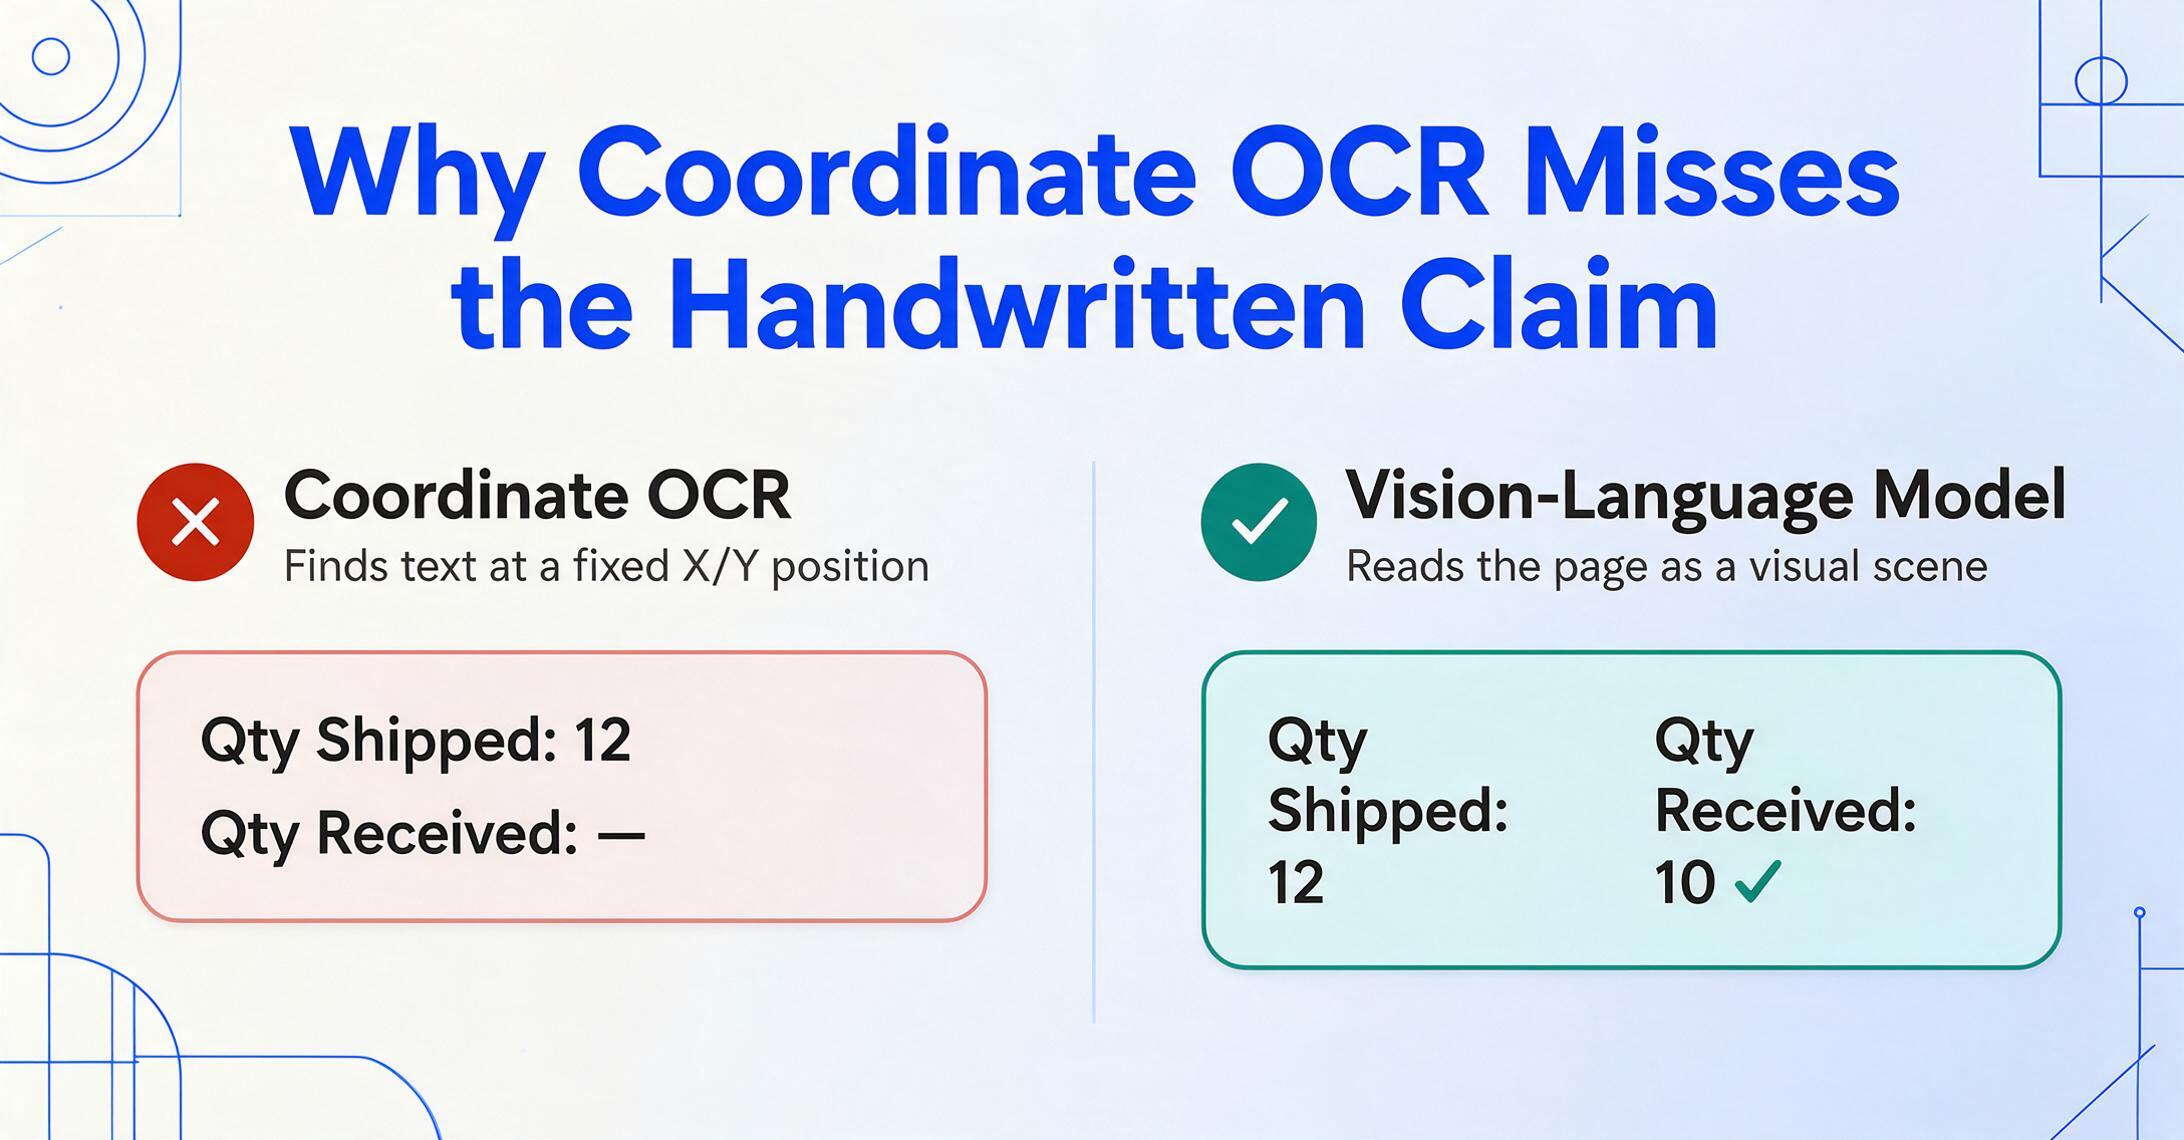
Los modelos de visión-lenguaje (VLM) abordan el problema de manera diferente. En lugar de buscar texto en coordenadas fijas, leen el documento completo como una escena visual. Entienden que el texto «12» impreso en la columna de Cantidad y el «10 ✓» manuscrito anotado junto a él son dos afirmaciones diferentes sobre el mismo dato —y pueden extraer ambos en columnas separadas.
Este es el mecanismo detrás de la Extracción de Columnas Personalizadas: usted define las columnas que desea —«Número de orden de compra», «SKU», «Cantidad enviada», «Cantidad recibida», «Notas de daños», «Recibido por»— y la IA localiza cada valor en cualquier parte de la página comprendiendo qué significa, no dónde está. Los campos impresos provienen de la plantilla del proveedor. Los campos manuscritos provienen de las anotaciones del receptor. Aterrizan en la misma fila de una sola hoja de cálculo.
El cambio clave: ya no trata las marcas manuscritas como obstáculos para la extracción. Las trata como campos de datos que deben extraerse, igual que los impresos, pero identificados por su contenido y no por su posición en el diseño.
Este artículo se centra en el problema de dos capas en un único albarán de entrega. Para el flujo de trabajo más amplio de albaranes de entrega y comprobantes de entrega (POD), por qué el procesamiento manual cuesta más de lo que cree, qué campos impulsan el pago y la conciliación, y cómo elegir una herramienta, consulte nuestra guía completa de extracción de albaranes de entrega y POD. Si el documento en cuestión es específicamente el comprobante de entrega firmado utilizado para facturación y reclamaciones, consulte nuestro tutorial dedicado de extracción de datos POD a Excel. Y para probar la extracción en un albarán de entrega firmado con anotaciones manuscritas, use el convertidor de albaranes de entrega manuscritos a Excel.
Paso a paso: extraiga campos impresos y manuscritos en una sola pasada
Este es el flujo de trabajo que convierte una pila de albaranes de entrega firmados en una única hoja de cálculo que contiene tanto lo que se envió como lo que se recibió.
Los archivos se procesan de forma segura y no se almacenan.
Recoja los albaranes de entrega firmados en el muelle de recepción
Tras cada entrega del conductor, el empleado de recepción debe conservar la copia anotada. Escanee los albaranes de entrega en papel en el muelle — una foto con el teléfono a 300 DPI es suficiente — o recopile las versiones en PDF que los proveedores envían por correo tras el envío. El punto clave: no guarde la copia firmada en papel en un cajón. Cárguela.
Defina sus columnas de extracción para ambas capas de datos
Aquí es donde toma forma el enfoque de dos capas. Sus columnas de capa impresa: N.º de orden de compra, SKU, descripción del artículo, cantidad enviada, fecha de envío, transportista, proveedor. Sus columnas de capa manuscrita: cantidad recibida, notas de daños (campo de texto), recibido por, fecha/hora de recepción, estado de la firma (presente/ausente). Escríbalas como nombres de columna en la interfaz de extracción; la IA completará cada una a partir de la parte correspondiente del documento, independientemente de dónde aparezca la nota manuscrita en relación con el texto impreso.
Cargue el lote y deje que la IA procese ambas capas
Cargue todos los albaranes de entrega de la mañana en un solo lote: PDF de los portales de proveedores, copias en papel escaneadas del muelle, fotos tomadas por el equipo de recepción. La IA lee cada documento según sus definiciones de columna. Los campos impresos se extraen del formato del proveedor. Los campos manuscritos se extraen de las anotaciones del receptor. Ambos llegan a la misma tabla estructurada, alineados por fila.
Revise las excepciones, no cada campo
La hoja de cálculo de salida le ofrece una vista lado a lado: cantidad enviada (impresa) frente a cantidad recibida (manuscrita). Las discrepancias — cuando el recuento del receptor difiere del del proveedor — son inmediatamente visibles. Filtre por discrepancia y envíe esas filas al proceso de reclamación al proveedor. Las que coinciden no requieren más acción. Lo que antes era una conciliación manual de 50 albaranes de entrega ahora es un proceso de filtrado y revisión de 5 minutos.
Cómo se ve la hoja de cálculo de salida
La salida combinada le ofrece una fila por línea de pedido, con columnas que abarcan ambas capas de datos. Esta es la estructura:
| N.º de orden de compra | SKU | Cant. enviada | Cant. recibida | Notas de daños | Recibido por | Fecha de recepción | Estado |
|---|---|---|---|---|---|---|---|
| PO-8842 | VT-334 | 50 | 47 | 3 unidades dañadas: esquina de la caja aplastada | M. Chen | 2026-06-15 | Discrepancia |
| PO-8842 | VT-338 | 100 | 100 | — | M. Chen | 2026-06-15 | OK |
| PO-8912 | SP-401 | 30 | 30 | — | J. Rivera | 2026-06-15 | OK |
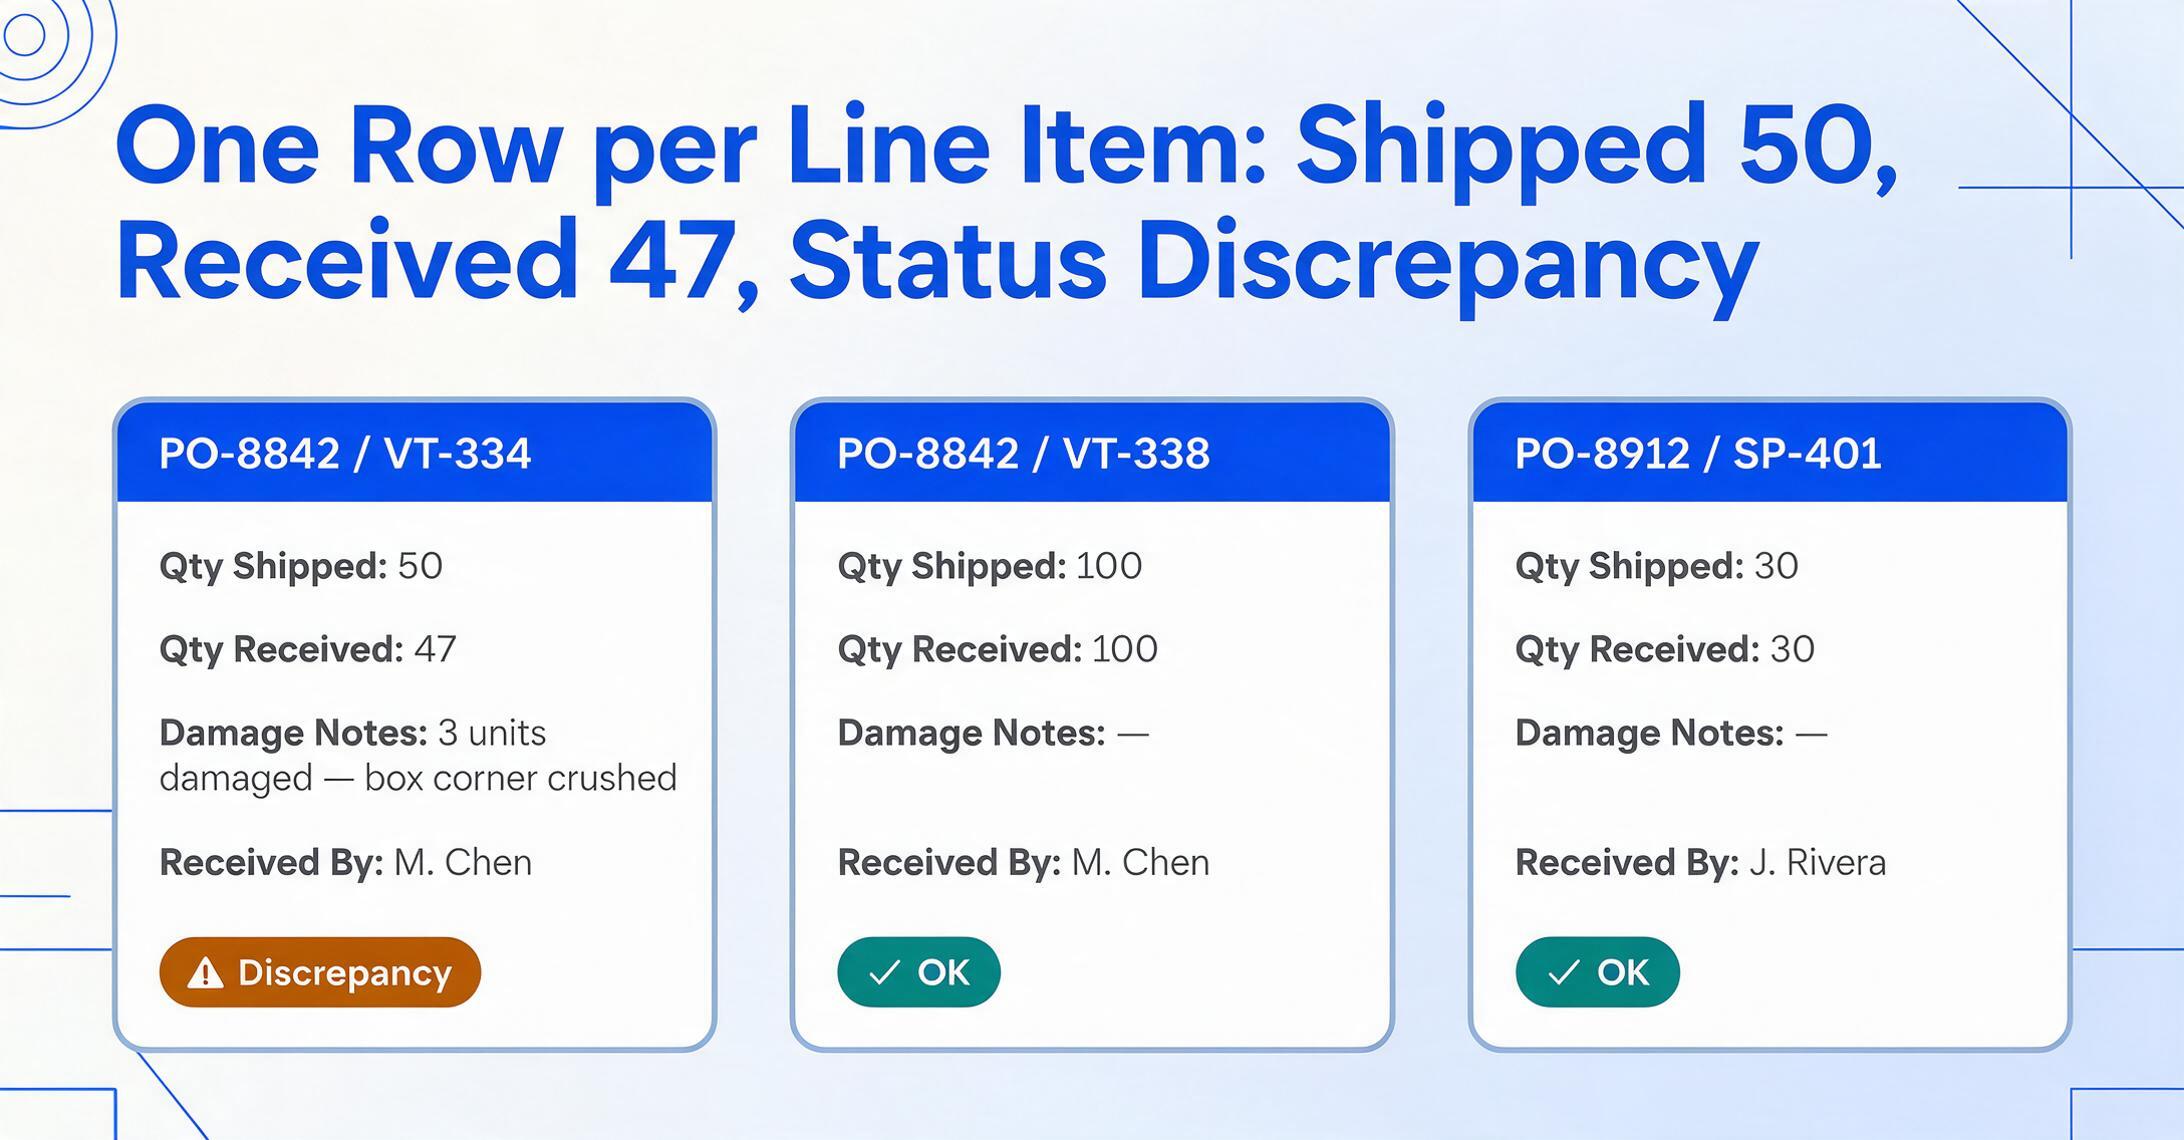
La columna Estado se puede generar automáticamente mediante columnas inferidas: defina una columna como Estado (opciones: OK/Discrepancia) y la IA lee las notas de daños y la discrepancia de cantidad para determinar el valor correcto: extrae y clasifica en una sola pasada. No se necesita un paso de revisión adicional para los casos estándar.
Para la integración posterior, esta tabla se alimenta directamente de su flujo de trabajo de conciliación a tres bandas. El equipo de cuentas por pagar ahora tiene un registro digital de lo que realmente se recibió, no solo de lo que el proveedor dijo que envió, antes de aprobar la factura. La orden de compra coincide con la reclamación del proveedor. La extracción del albarán de entrega coincide con lo que llegó. Si no coinciden, el pago se retiene con evidencia documentada.
Preguntas Frecuentes
¿Qué tan precisa es la extracción de escritura a mano en notas de entrega con anotaciones densas?
La precisión depende de la legibilidad. Las correcciones manuscritas claras — cantidades encerradas en círculos, "faltan 3", un nombre impreso — se extraen de forma confiable. Los garabatos densos escritos sobre texto impreso, páginas de copia carbón muy manchadas o documentos dañados por agua reducirán la precisión. En la práctica, el flujo de trabajo está diseñado para que revises las excepciones marcadas, no todos los campos: la IA extrae lo que puede de ambas capas, y el paso de revisión captura los casos límite que un humano necesita interpretar. Esto sigue siendo dramáticamente más rápido que ingresar manualmente cada campo desde cero.
¿Funciona cuando las notas manuscritas están en un idioma diferente al del texto impreso?
Sí. Los modelos de lenguaje-visión leen la escritura a mano independientemente del idioma impreso. Si la nota de entrega está impresa en inglés, pero el recepcionista la anotó en español o francés, la IA extrae ambas. Los nombres de columna que defines establecen la expectativa semántica — "Cantidad Recibida" le indica al modelo que busque una anotación numérica cerca del campo de cantidad impreso, independientemente del idioma del texto circundante.
¿Puede la salida distinguir entre diferentes tipos de anotaciones manuscritas?
Al definir columnas separadas para cada tipo de anotación — Cantidad Recibida, Notas de Daño, Recibido Por — le indicas a la IA que extraiga cada información en su propio campo. La IA distingue una corrección numérica de una nota textual de daño y de una firma basándose en el contexto semántico, no solo en la ubicación. Si una anotación es ambigua, el campo de salida estará en blanco o será incierto, lo que facilita su detección durante la revisión.
¿Qué pasa si el receptor no anotó nada — la nota de entrega solo está firmada?
En ese caso, las columnas de la capa manuscrita (Notas de Daño, ajustes de Cantidad Recibida) estarán vacías, y la columna Estado tendrá como valor predeterminado OK. Una nota de entrega firmada sin excepciones se trata como aceptación, que es exactamente como se interpretaría en un proceso manual. La diferencia es que el registro digital ahora documenta formalmente que no se observaron excepciones en el muelle, lo que constituye una evidencia más sólida que "perdimos la copia en papel".
¿Qué documentos puedo procesar además de notas de entrega?
El mismo enfoque de extracción de dos capas se aplica a cualquier documento donde coexistan datos impresos y anotaciones manuscritas: albaranes con marcas de verificación hechas a mano, formularios de prueba de entrega con notas del conductor, notas de recepción de mercancías con anotaciones del inspector e informes de inspección con observaciones de campo escritas sobre plantillas impresas. El mecanismo de extracción se basa en el contenido, no en plantillas, por lo que los cambios de formato entre documentos no interrumpen el flujo de trabajo.
La brecha entre lo que un proveedor envía y lo que un almacén recibe siempre ha existido. La diferencia ahora es que no tienes que elegir qué lado de la nota de entrega digitalizar. Extraes ambos — datos de envío impresos y confirmaciones de recepción manuscritas — en un solo registro estructurado, y dejas de perder disputas porque la evidencia nunca salió del papel.