So extrahieren Sie gedruckte Versanddaten und handschriftliche Empfangsbestätigungen aus zurückgesandten Lieferscheinen
Lieferscheine sind hybride Dokumente – gedruckte Versanddetails plus handschriftliche Empfangsvermerke. Erfahren Sie, wie KI-Extraktion beide Ebenen in einem einzigen Durchlauf verarbeitet.
Warum ein unterschriebener Lieferschein zwei Dokumente in einem ist
Ein Lieferschein, der das Lager eines Lieferanten verlässt, enthält einen Datensatz: Artikelnummern, versendete Mengen, Bestellnummer, Spediteur, Versanddatum. Dies ist die Aufzeichnung des Lieferanten darüber, was er versendet hat. Das Dokument reist mit der Fracht, und wenn es am Wareneingang ankommt, wird eine zweite Datenschicht hinzugefügt: die handschriftlichen Anmerkungen des Empfängers.
Diese Anmerkungen sind kein Rauschen. Sie sind das operative Urteil des Wareneingangsteams – und sie haben rechtliches Gewicht. Gemäß dem Uniform Commercial Code (UCC Article 2) stellt ein unterschriebener Lieferschein mit schriftlichen Ausnahmen einen dokumentierten Nachweis dar, dass die Sendung nicht vollständig angenommen wurde. Keine Anmerkungen, kein Nachweis. Wenn der Empfänger unterschreibt, ohne zu vermerken, dass zwei Kartons zerquetscht ankamen oder dass 15 Einheiten eines 50-Einheiten-Einzelpostens fehlten, kann der Lieferant plausibel argumentieren, dass die Ware als vollständig angenommen wurde.
Die Herausforderung ist struktureller, nicht verfahrenstechnischer Natur. Gedruckte Daten sind von Natur aus maschinenlesbar. Handschriftliche Empfangsbestätigungen – Unterschriften, Schadenscodes, Mengenkorrekturen, Fahrer-ID-Notizen – sind es nicht. Sie befinden sich auf dem Papier, für das menschliche Auge sichtbar, aber für das WMS oder ERP unsichtbar. Wenn das Wareneingangsteam den Tag abschließt, bleiben diese Anmerkungen auf der physischen Kopie. Der digitale Datensatz enthält die Version des Lieferanten. Die Wahrheit liegt auf dem Papier.
Das ist das Zwei-Ebenen-Problem: ein Lieferschein, zwei Datensysteme, nur eines wird digitalisiert.
Was verloren geht, wenn Sie nur die gedruckte Ebene lesen
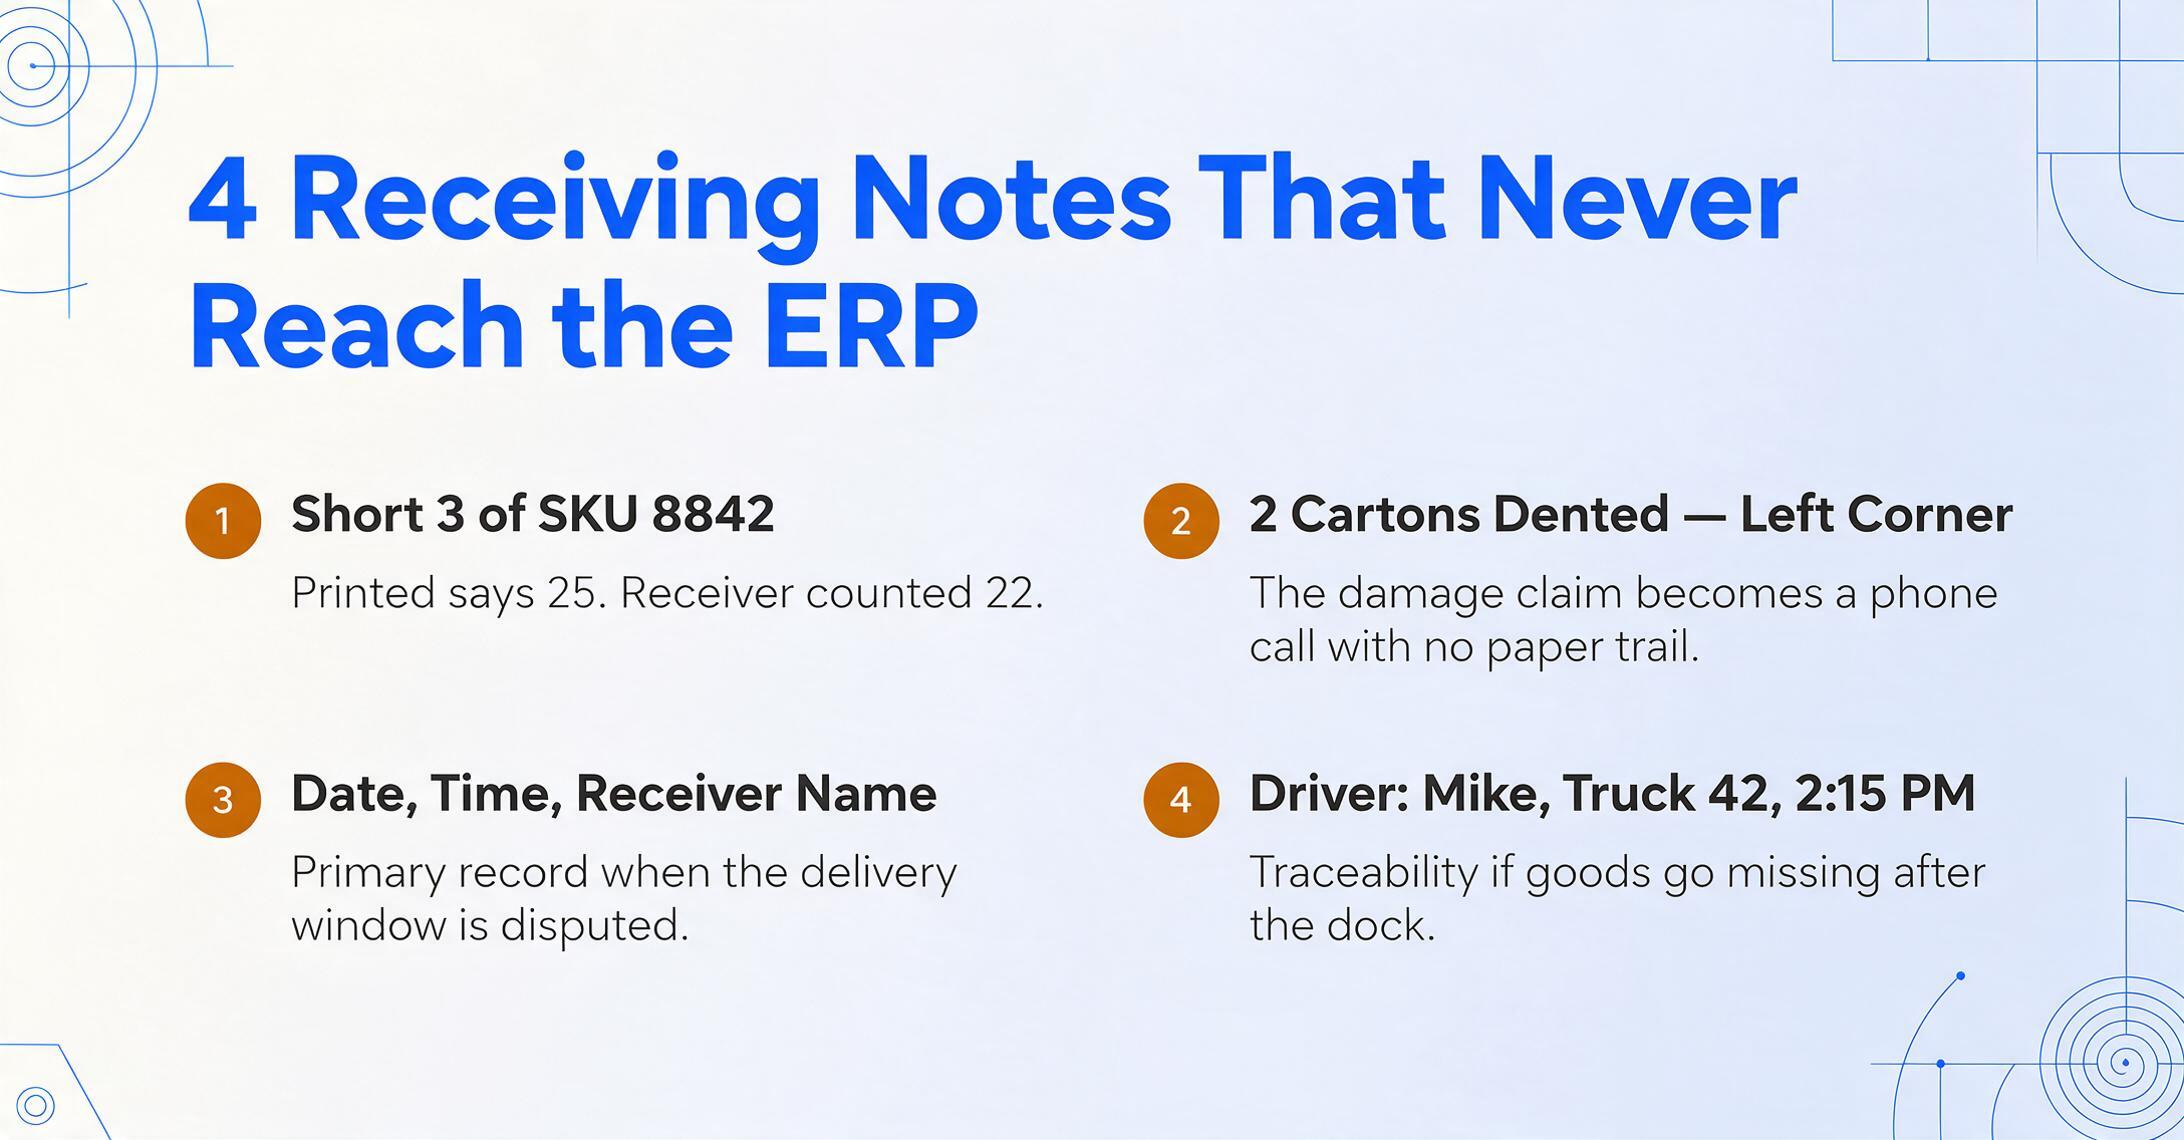
Die Lücke zwischen dem, was der Lieferant versendet hat, und dem, was der Empfänger handschriftlich dokumentiert hat, ist nicht theoretisch. Hier sind die vier Arten von Wareneingangsanmerkungen, die verschwinden, wenn Teams nur die gedruckten Felder extrahieren:
Mengenkorrekturen
„3 Stück von SKU 8842 fehlen“ – handschriftlich neben der Einzelposten-Tabelle notiert. Die gedruckte Menge des Lieferanten besagt, dass 25 Einheiten versendet wurden. Der Empfänger zählte 22. Wenn diese handschriftliche Notiz nie ins System gelangt, wird der Drei-Wege-Abgleich – der Vergleich von Bestellung, Lieferschein und Lieferantenrechnung – die Rechnung zur vollständigen Zahlung für 25 Einheiten freigeben. Die Kreditorenbuchhaltung hat keine Grundlage, um Zahlungen zurückzuhalten.
Schadensvermerke
„2 Kartons eingedrückt – linke Ecke“ – quer über die Seite geschrieben. Das ist der Beleg, den Sie benötigen, wenn der Lieferant die Schadensmeldung bestreitet. Ohne digitale Erfassung bleibt die Meldung ein Telefonat ohne Papiernachweis.
Empfangszeitstempel und Unterschriften
Handschriftliches Datum, Uhrzeit und Name des Empfängers legen fest, wann und von wem die Lieferung angenommen wurde. Bei einem Streit darüber, ob eine Lieferung innerhalb des vertraglich vereinbarten Zeitfensters eingetroffen ist, ist dies der primäre Nachweis. Bleibt er auf Papier, ist er bei einer digitalen Prüfung wertlos.
Notizen zu Spediteur und Fahrer
„Fahrer: Mike, LKW 42, 14:15 Uhr“ – entscheidend für die Rückverfolgbarkeit, wenn Waren zwischen Wareneingang und Einlagerung verloren gehen.
Die Kosten für den Verlust dieser Ebene summieren sich. Eine einzige übersehene Schadensnotiz kann bedeuten, dass Sie $200 für Waren zahlen, die Sie nicht verkaufen können. Bei 50 Lieferscheinen pro Tag – einem typischen Volumen für ein mittelgroßes Lager – kann die monatliche Belastung durch nicht erfasste Wareneingangsabweichungen fünfstellige Beträge erreichen. Und das sind nur die Vorfälle, von denen Sie wissen.
Wie KI-Extraktion beide Ebenen gleichzeitig liest
Traditionelle OCR behandelt einen Lieferschein als Feldpositionsproblem: PO-Nummer an Koordinate X finden, Versanddatum an Koordinate Y finden. Dieser Ansatz scheitert, sobald ein Lieferant sein Layout ändert – oder sobald jemand über den gedruckten Text schreibt.
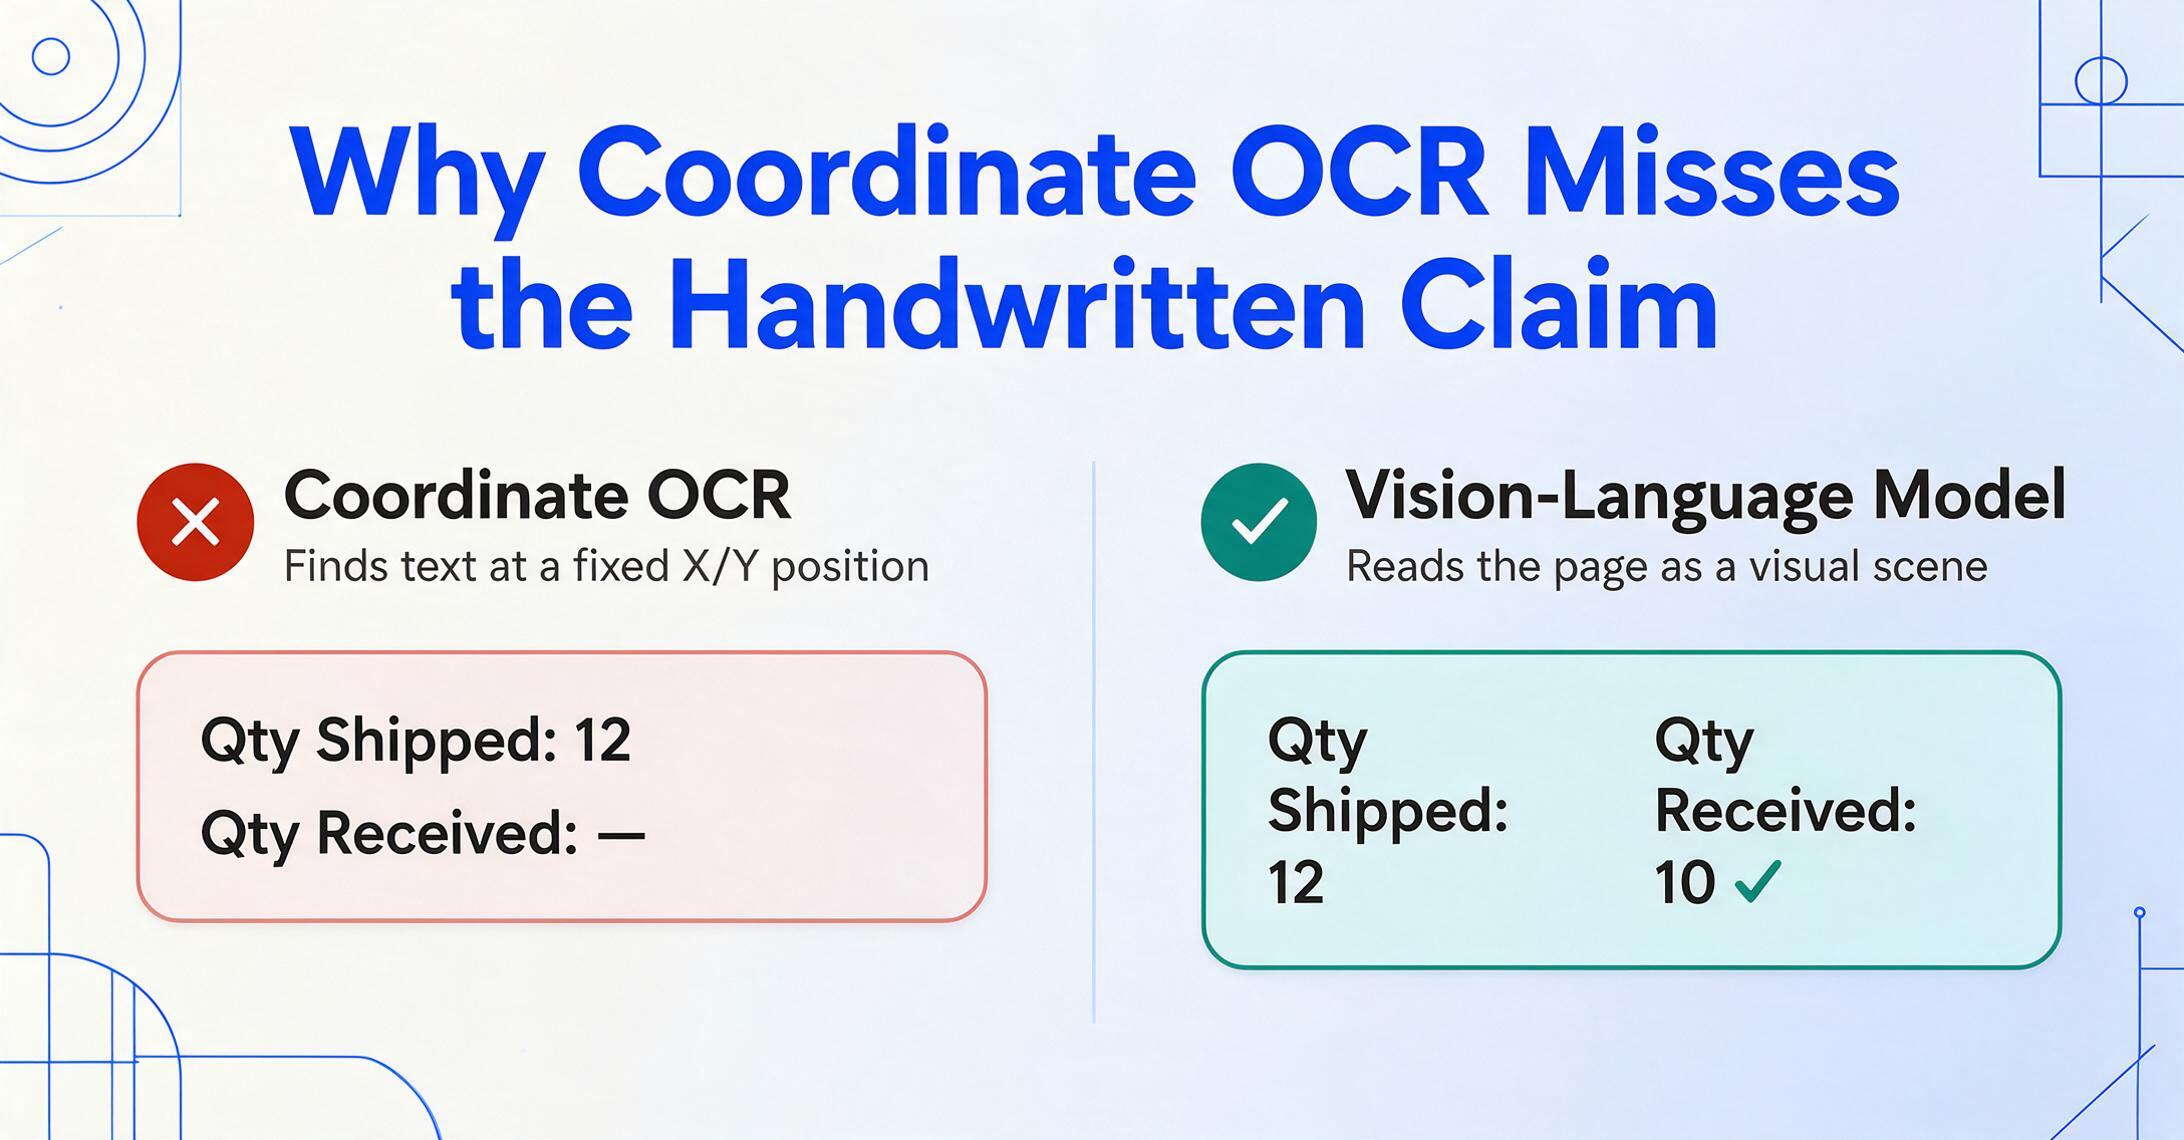
Vision-Language-Modelle (VLMs) gehen das Problem anders an. Statt nach Text an festen Koordinaten zu suchen, lesen sie das gesamte Dokument als visuelle Szene. Sie verstehen, dass der gedruckte Text „12“ in der Mengenspalte und das handschriftliche „10 ✓“ daneben zwei verschiedene Angaben zum selben Datenpunkt sind – und können beide in separate Spalten extrahieren.
Dies ist der Mechanismus hinter der Benutzerdefinierten Spaltenextraktion: Sie definieren die gewünschten Spalten – „PO-Nummer“, „SKU“, „Gelieferte Menge“, „Erhaltene Menge“, „Schadensnotizen“, „Empfangen von“ – und die KI lokalisiert jeden Wert überall auf der Seite, indem sie versteht, was er bedeutet, nicht wo er steht. Die gedruckten Felder stammen aus der Vorlage des Lieferanten. Die handschriftlichen Felder stammen aus den Anmerkungen des Empfängers. Sie landen in derselben Zeile einer einzigen Tabelle.
Der entscheidende Wandel: Handschriftliche Markierungen sind keine Hindernisse für die Extraktion mehr. Sie behandeln sie als Datenfelder, die extrahiert werden — genau wie die gedruckten, nur identifiziert durch Inhalt statt durch Position im Layout.
Dieser Artikel konzentriert sich auf das zweischichtige Problem bei einem einzelnen Lieferschein. Für den umfassenderen Lieferschein- und POD-Workflow — warum manuelle Verarbeitung mehr kostet, als Sie denken, welche Felder Zahlung und Abstimmung steuern und wie Sie ein Tool auswählen — lesen Sie unseren vollständigen Leitfaden zur Lieferschein- und POD-Extraktion. Wenn es sich bei dem Dokument konkret um den unterschriebenen Abliefernachweis für Abrechnung und Ansprüche handelt, lesen Sie unsere spezielle POD-Datenextraktion in Excel Schritt für Schritt. Und um die Extraktion an einem unterschriebenen Lieferschein mit handschriftlichen Anmerkungen zu testen, nutzen Sie den Konverter für handschriftliche Lieferscheine in Excel.
Schritt für Schritt: Gedruckte und handschriftliche Felder in einem Durchgang extrahieren
So funktioniert der Workflow, der einen Stapel unterschriebener Lieferscheine in eine einzige Tabelle verwandelt, die sowohl das Versendete als auch das Empfangene enthält.
Dateien werden sicher verarbeitet und nicht gespeichert.
Sammeln Sie die unterschriebenen Lieferscheine am Wareneingang
Nach jeder Fahrerübergabe sollte der Wareneingangsmitarbeiter die annotierte Kopie aufbewahren. Scannen Sie Papier-Lieferscheine direkt am Wareneingang – ein Handyfoto mit 300 DPI genügt – oder sammeln Sie die PDF-Versionen, die Lieferanten nach dem Versand per E-Mail senden. Der entscheidende Punkt: Legen Sie die unterschriebene Papierkopie nicht in eine Schublade. Laden Sie sie hoch.
Definieren Sie Ihre Extraktionsspalten für beide Datenschichten
Hier nimmt der Zwei-Schichten-Ansatz Gestalt an. Ihre Spalten für die gedruckte Schicht: Bestellnummer, SKU, Artikelbeschreibung, Versandmenge, Versanddatum, Spediteur, Lieferant. Ihre Spalten für die handschriftliche Schicht: Empfangsmenge, Schadensnotizen (Textfeld), Empfangen von, Empfangsdatum/-zeit, Unterschriftsstatus (Vorhanden/Fehlt). Geben Sie diese als Spaltennamen in der Extraktionsoberfläche ein – die KI füllt jede Spalte aus dem entsprechenden Teil des Dokuments, unabhängig davon, wo die handschriftliche Notiz relativ zum gedruckten Text erscheint.
Laden Sie den Batch hoch und lassen Sie die KI beide Schichten verarbeiten
Laden Sie alle Lieferscheine des Morgens in einem Batch hoch – PDFs aus Lieferantenportalen, gescannte Papierkopien vom Wareneingang, Fotos des Wareneingangsteams. Die KI liest jedes Dokument anhand Ihrer Spaltendefinitionen. Die gedruckten Felder werden aus dem Layout des Lieferanten extrahiert. Die handschriftlichen Felder werden aus den Anmerkungen des Empfängers extrahiert. Beide landen in derselben strukturierten Tabelle, zeilenweise ausgerichtet.
Prüfen Sie Ausnahmen, nicht jedes Feld
Die Ausgabetabelle bietet Ihnen eine Gegenüberstellung: Versandmenge (gedruckt) vs. Empfangsmenge (handschriftlich). Abweichungen – wenn die Zählung des Empfängers von der des Lieferanten abweicht – sind sofort sichtbar. Filtern Sie nach Abweichungen und leiten Sie diese Zeilen an den Lieferanten-Schadensprozess weiter. Die übereinstimmenden Zeilen erfordern keine weitere Aktion. Was früher ein manueller Abgleich von 50 Lieferscheinen war, ist jetzt ein 5-minütiger Filter- und Prüfungsdurchlauf.
So sieht die Ausgabetabelle aus
Die zusammengeführte Ausgabe enthält eine Zeile pro Einzelposten, mit Spalten, die beide Datenschichten abdecken. So ist die Struktur aufgebaut:
| Bestellnummer | SKU | Versandmenge | Empfangsmenge | Schadenshinweise | Empfangen von | Empfangsdatum | Status |
|---|---|---|---|---|---|---|---|
| PO-8842 | VT-334 | 50 | 47 | 3 Einheiten beschädigt – Kartonecke eingedrückt | M. Chen | 2026-06-15 | Abweichung |
| PO-8842 | VT-338 | 100 | 100 | — | M. Chen | 2026-06-15 | OK |
| PO-8912 | SP-401 | 30 | 30 | — | J. Rivera | 2026-06-15 | OK |
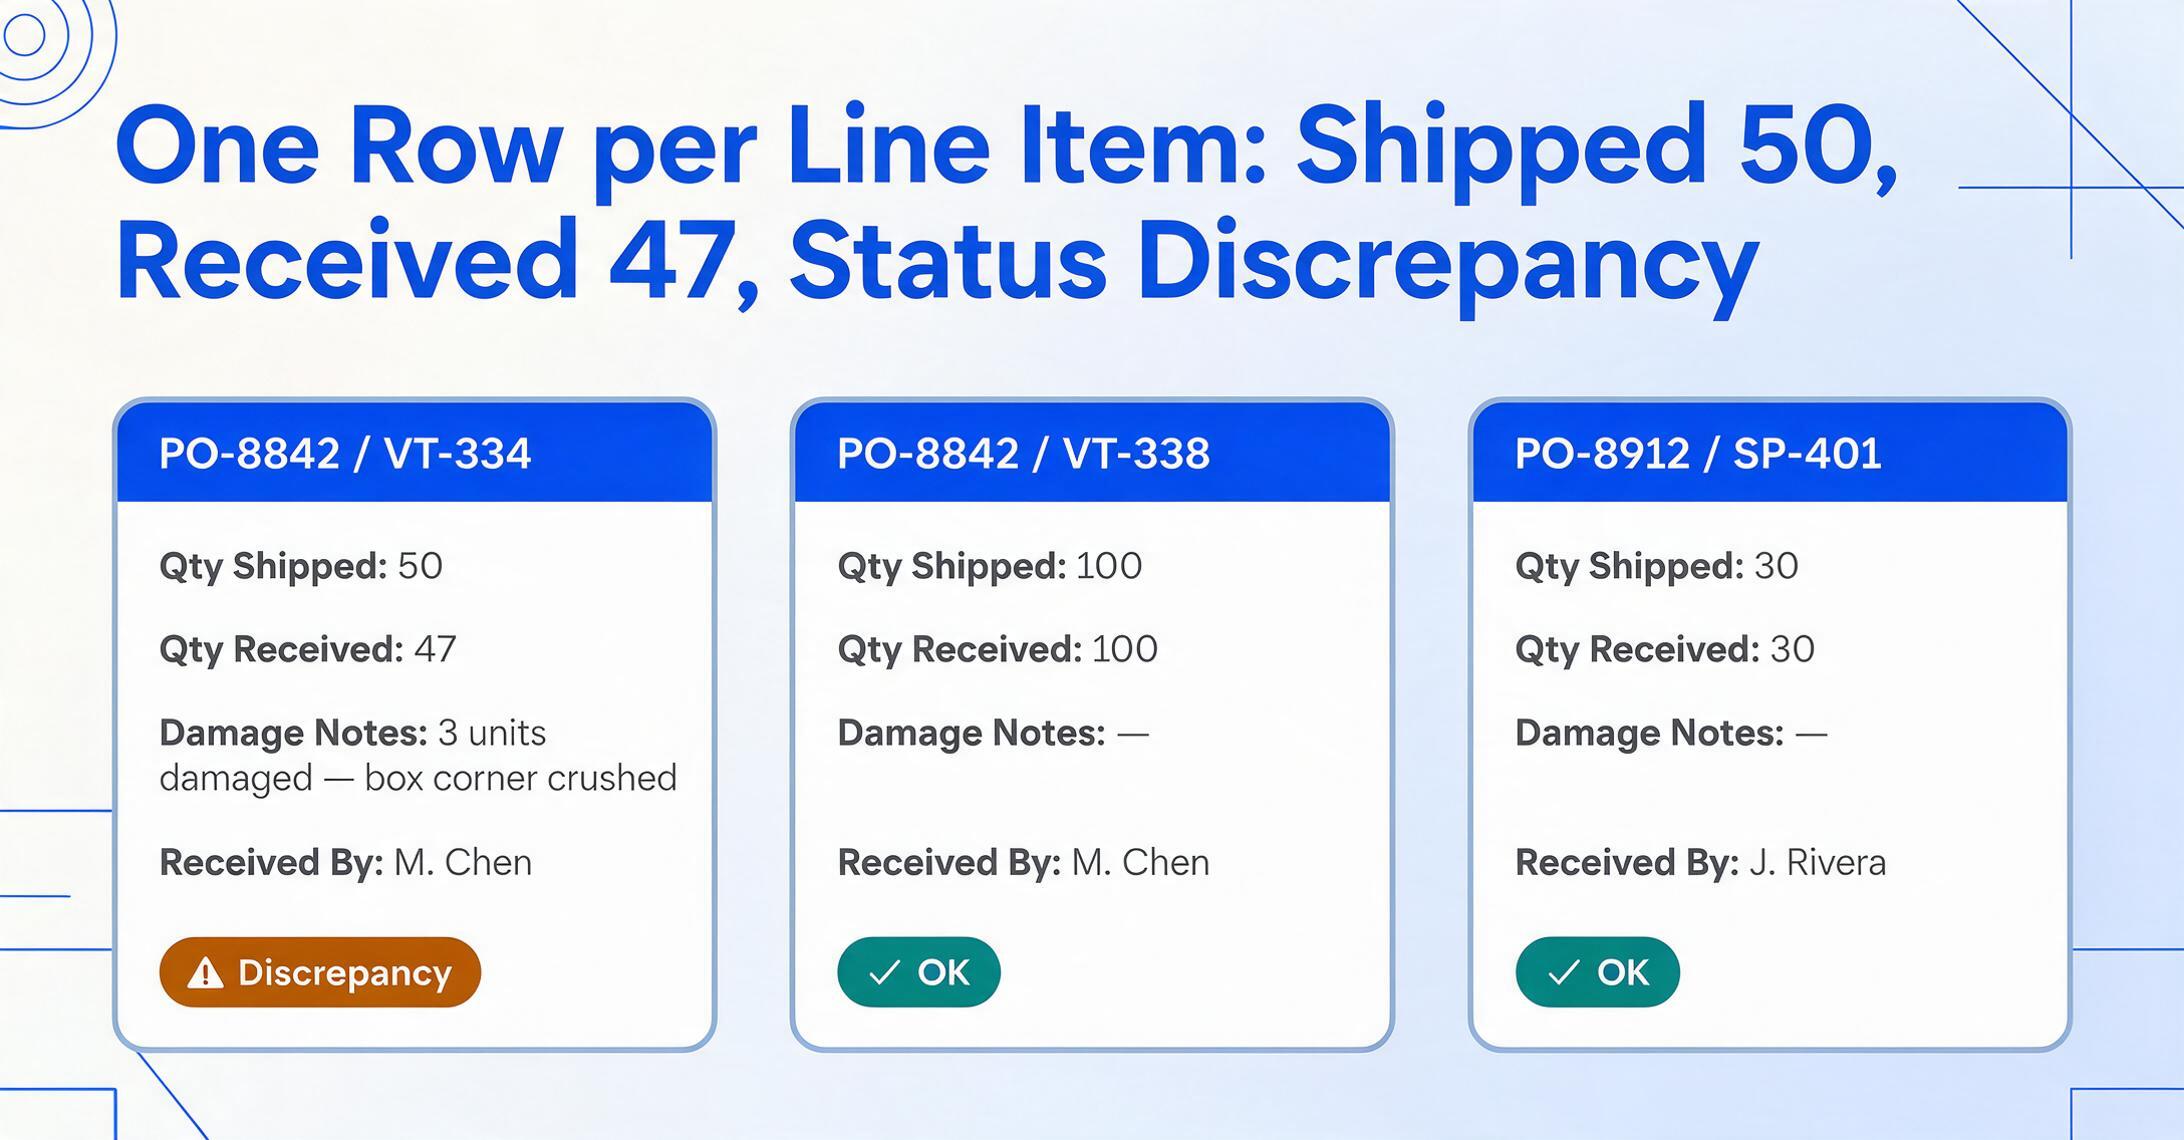
Die Statusspalte kann automatisch über abgeleitete Spalten generiert werden: Definieren Sie eine Spalte wie Status (Optionen: OK/Abweichung) und die KI liest die Schadenshinweise und Mengenabweichungen, um den korrekten Wert zu bestimmen – Extraktion und Klassifizierung in einem Durchgang. Für Standardfälle ist kein separater Prüfschritt erforderlich.
Für die nachgelagerte Integration speist diese Tabelle direkt in Ihren Drei-Wege-Abgleich-Workflow. Die Kreditorenbuchhaltung verfügt nun über einen digitalen Nachweis dessen, was tatsächlich empfangen wurde – nicht nur dessen, was der Lieferant laut eigenen Angaben versendet hat – bevor die Rechnung freigegeben wird. Die Bestellung stimmt mit der Angabe des Lieferanten überein. Die Lieferscheinextraktion stimmt mit dem überein, was angekommen ist. Wenn beides nicht übereinstimmt, wird die Zahlung mit dokumentierten Belegen zurückgehalten.
FAQ
Wie genau ist die Handschrifterkennung bei Lieferscheinen mit dichten Anmerkungen?
Die Genauigkeit hängt von der Leserlichkeit ab. Klare handschriftliche Korrekturen – eingekreiste Mengen, „kurz 3“, ein gedruckter Name – werden zuverlässig erfasst. Dichte Kritzeleien auf gedrucktem Text, stark verschmierte Durchschläge oder wassergeschädigte Dokumente verringern die Genauigkeit. In der Praxis ist der Workflow so ausgelegt, dass Sie markierte Ausnahmen prüfen, nicht jedes Feld: Die KI extrahiert, was möglich ist, und der Prüfschritt fängt die Grenzfälle, die ein Mensch interpretieren muss. Das ist dennoch deutlich schneller als jedes Feld manuell zu erfassen.
Funktioniert das auch, wenn die handschriftlichen Notizen in einer anderen Sprache als der gedruckte Text sind?
Ja. Visuelle Sprachmodelle lesen Handschrift unabhängig von der Drucksprache. Ist der Lieferschein auf Englisch gedruckt, der Empfänger hat aber auf Spanisch oder Französisch notiert, extrahiert die KI beides. Die von Ihnen definierten Spaltennamen geben die semantische Erwartung vor – „Menge erhalten“ sagt dem Modell, es solle nach einer numerischen Anmerkung in der Nähe des gedruckten Mengenfelds suchen, unabhängig von der Sprache des umgebenden Texts.
Kann die Ausgabe zwischen verschiedenen Arten handschriftlicher Anmerkungen unterscheiden?
Durch die Definition separater Spalten für jeden Anmerkungstyp – Menge erhalten, Schadensvermerke, Empfangen von – weisen Sie die KI an, jede Information in ihr eigenes Feld zu extrahieren. Die KI unterscheidet eine numerische Korrektur von einem textuellen Schadensvermerk von einer Unterschrift anhand des semantischen Kontexts, nicht nur der Position. Ist eine Anmerkung mehrdeutig, bleibt das Ausgabefeld leer oder unsicher, was die Prüfung erleichtert.
Was ist, wenn der Empfänger nichts notiert hat – der Lieferschein nur unterschrieben ist?
In diesem Fall bleiben die Spalten für die Handschrift (Schadensvermerke, Mengenanpassungen) leer, und die Statusspalte wird standardmäßig auf OK gesetzt. Ein unterschriebener Lieferschein ohne Ausnahmen gilt als Annahme – genau wie im manuellen Prozess. Der Unterschied: Der digitale Datensatz dokumentiert nun formal, dass am Wareneingang keine Ausnahmen festgestellt wurden – ein stärkerer Beleg als „wir haben das Papier verloren“.
Welche Dokumente kann ich außer Lieferscheinen verarbeiten?
Derselbe zweischichtige Extraktionsansatz gilt für jedes Dokument mit gedruckten Daten und handschriftlichen Anmerkungen: Packlisten mit handschriftlichen Prüfhäkchen, Zustellnachweise mit Fahrernotizen, Wareneingangsbelege mit Prüfervermerken und Inspektionsberichte mit Feldbeobachtungen auf gedruckten Vorlagen. Die Extraktion ist inhaltsbasiert, nicht vorlagenbasiert, sodass Formatänderungen den Workflow nicht stören.
Die Diskrepanz zwischen dem, was ein Lieferant versendet, und dem, was ein Lager erhält, gab es schon immer. Der Unterschied heute: Sie müssen sich nicht mehr entscheiden, welche Seite des Lieferscheins Sie digitalisieren. Sie extrahieren beide – gedruckte Versanddaten und handschriftliche Empfangsbestätigungen – in einen strukturierten Datensatz und verlieren keine Streitfälle mehr, weil der Beleg nie das Papier verlassen hat.