Comment extraire les données d'expédition imprimées et les confirmations de réception manuscrites des bons de livraison retournés
Les bons de livraison sont des documents hybrides — détails d'expédition imprimés plus marques de réception manuscrites. Découvrez comment l'extraction par IA traite les deux couches en une seule passe.
Pourquoi un bon de livraison signé est un document à deux volets
Un bon de livraison qui quitte l'entrepôt du fournisseur contient un premier jeu de données : codes articles, quantités expédiées, numéro de bon de commande, transporteur, date d'expédition. C'est l'enregistrement par le fournisseur de ce qu'il a expédié. Le document voyage avec la marchandise et, à son arrivée au quai de réception, une seconde couche de données s'y ajoute : les annotations manuscrites du réceptionnaire.
Ces annotations ne sont pas du bruit. Elles constituent le verdict opérationnel de l'équipe de réception — et elles ont une valeur juridique. En vertu de l'Uniform Commercial Code (UCC Article 2), un bon de livraison signé avec des exceptions écrites constitue une preuve documentée que la livraison n'a pas été acceptée en totalité. Pas d'annotations, pas de preuve. Si le réceptionnaire signe sans noter que deux cartons sont arrivés écrasés ou que 15 unités d'une ligne de commande de 50 unités manquent, le fournisseur peut raisonnablement soutenir que la marchandise a été acceptée comme complète.
Le défi est structurel, pas procédural. Les données imprimées sont conçues pour être lisibles par machine. Les confirmations manuscrites de réception — signatures, codes de dommage, corrections de quantités, notes d'identification du chauffeur — ne le sont pas. Elles restent sur le papier, visibles à l'œil humain mais invisibles pour le WMS ou l'ERP. Lorsque l'équipe de réception clôture la journée, ces annotations restent sur la copie physique. L'enregistrement numérique contient la version du fournisseur. La vérité est sur le papier.
C'est le problème des deux couches : un bon de livraison, deux systèmes de données, un seul est numérisé.
Ce que vous perdez en ne lisant que la couche imprimée
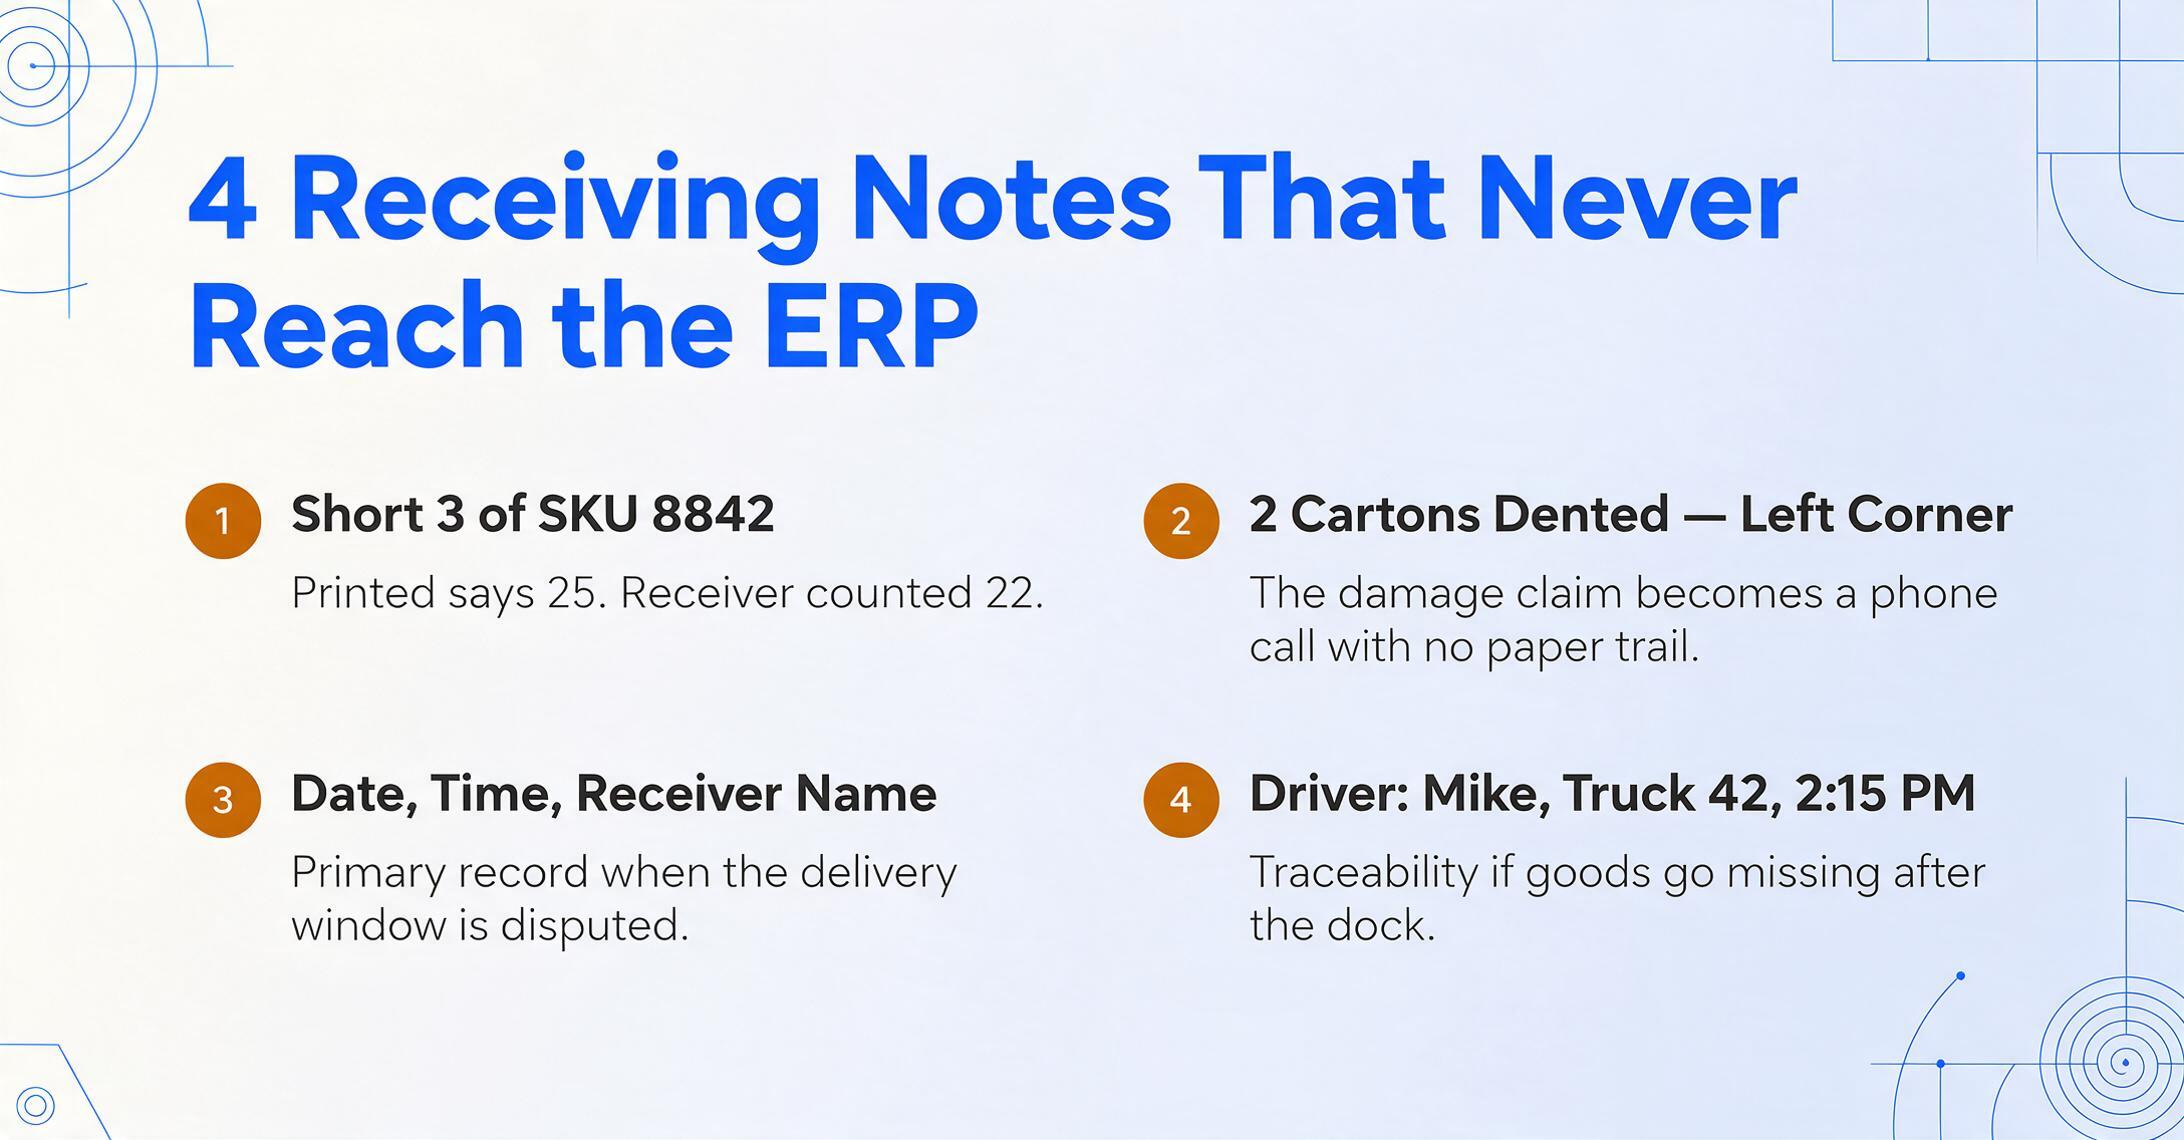
L'écart entre ce que le fournisseur a expédié et ce que le réceptionnaire a documenté à la main n'est pas théorique. Voici les quatre types d'annotations de réception qui disparaissent lorsque les équipes n'extraient que les champs imprimés :
Corrections de quantité
« Manque 3 sur la référence 8842 » griffonné à côté du tableau des lignes de commande. La quantité imprimée par le fournisseur indique que 25 unités ont été expédiées. Le réceptionnaire en a compté 22. Si cette note manuscrite n'entre jamais dans le système, le rapprochement à trois voies — comparant le bon de commande, le bon de livraison et la facture fournisseur — validera la facture pour un paiement intégral sur la base de 25 unités. La comptabilité fournisseurs n'a aucun fondement pour retenir le paiement.
Annotations de dommages
« 2 cartons bosselés — coin gauche » écrit en travers du haut de la page. C'est la preuve dont vous aurez besoin lorsque le fournisseur contestera la réclamation pour dommage. Sans version numérique, la réclamation se résume à un appel téléphonique sans trace écrite.
Horodatages et signatures de réception
La date, l'heure et le nom du réceptionnaire manuscrits établissent quand et par qui la livraison a été acceptée. En cas de litige sur le respect de la fenêtre de livraison contractuelle, c'est le document de référence. S'il reste sur papier, il est inutile lors d'un audit numérique.
Notes du transporteur et du chauffeur
« Chauffeur : Mike, Camion 42, 14 h 15 » — essentiel pour la traçabilité si des marchandises disparaissent entre le quai de réception et le rangement.
Le coût de la perte de cette couche se cumule. Une seule note de dommage manquée peut signifier payer 200 $ pour des marchandises invendables. Sur 50 bons de livraison par jour — un volume typique pour un entrepôt de taille moyenne — l'exposition mensuelle liée aux exceptions de réception non enregistrées peut atteindre cinq chiffres. Et ce ne sont que les incidents dont vous avez connaissance.
Comment l'extraction par IA lit les deux couches simultanément
L'OCR traditionnel traite un bon de livraison comme un problème de localisation de champs : trouver le numéro de bon de commande aux coordonnées X, trouver la date d'expédition aux coordonnées Y. Cette approche échoue dès qu'un fournisseur modifie sa mise en page — ou dès que quelqu'un écrit par-dessus le texte imprimé.
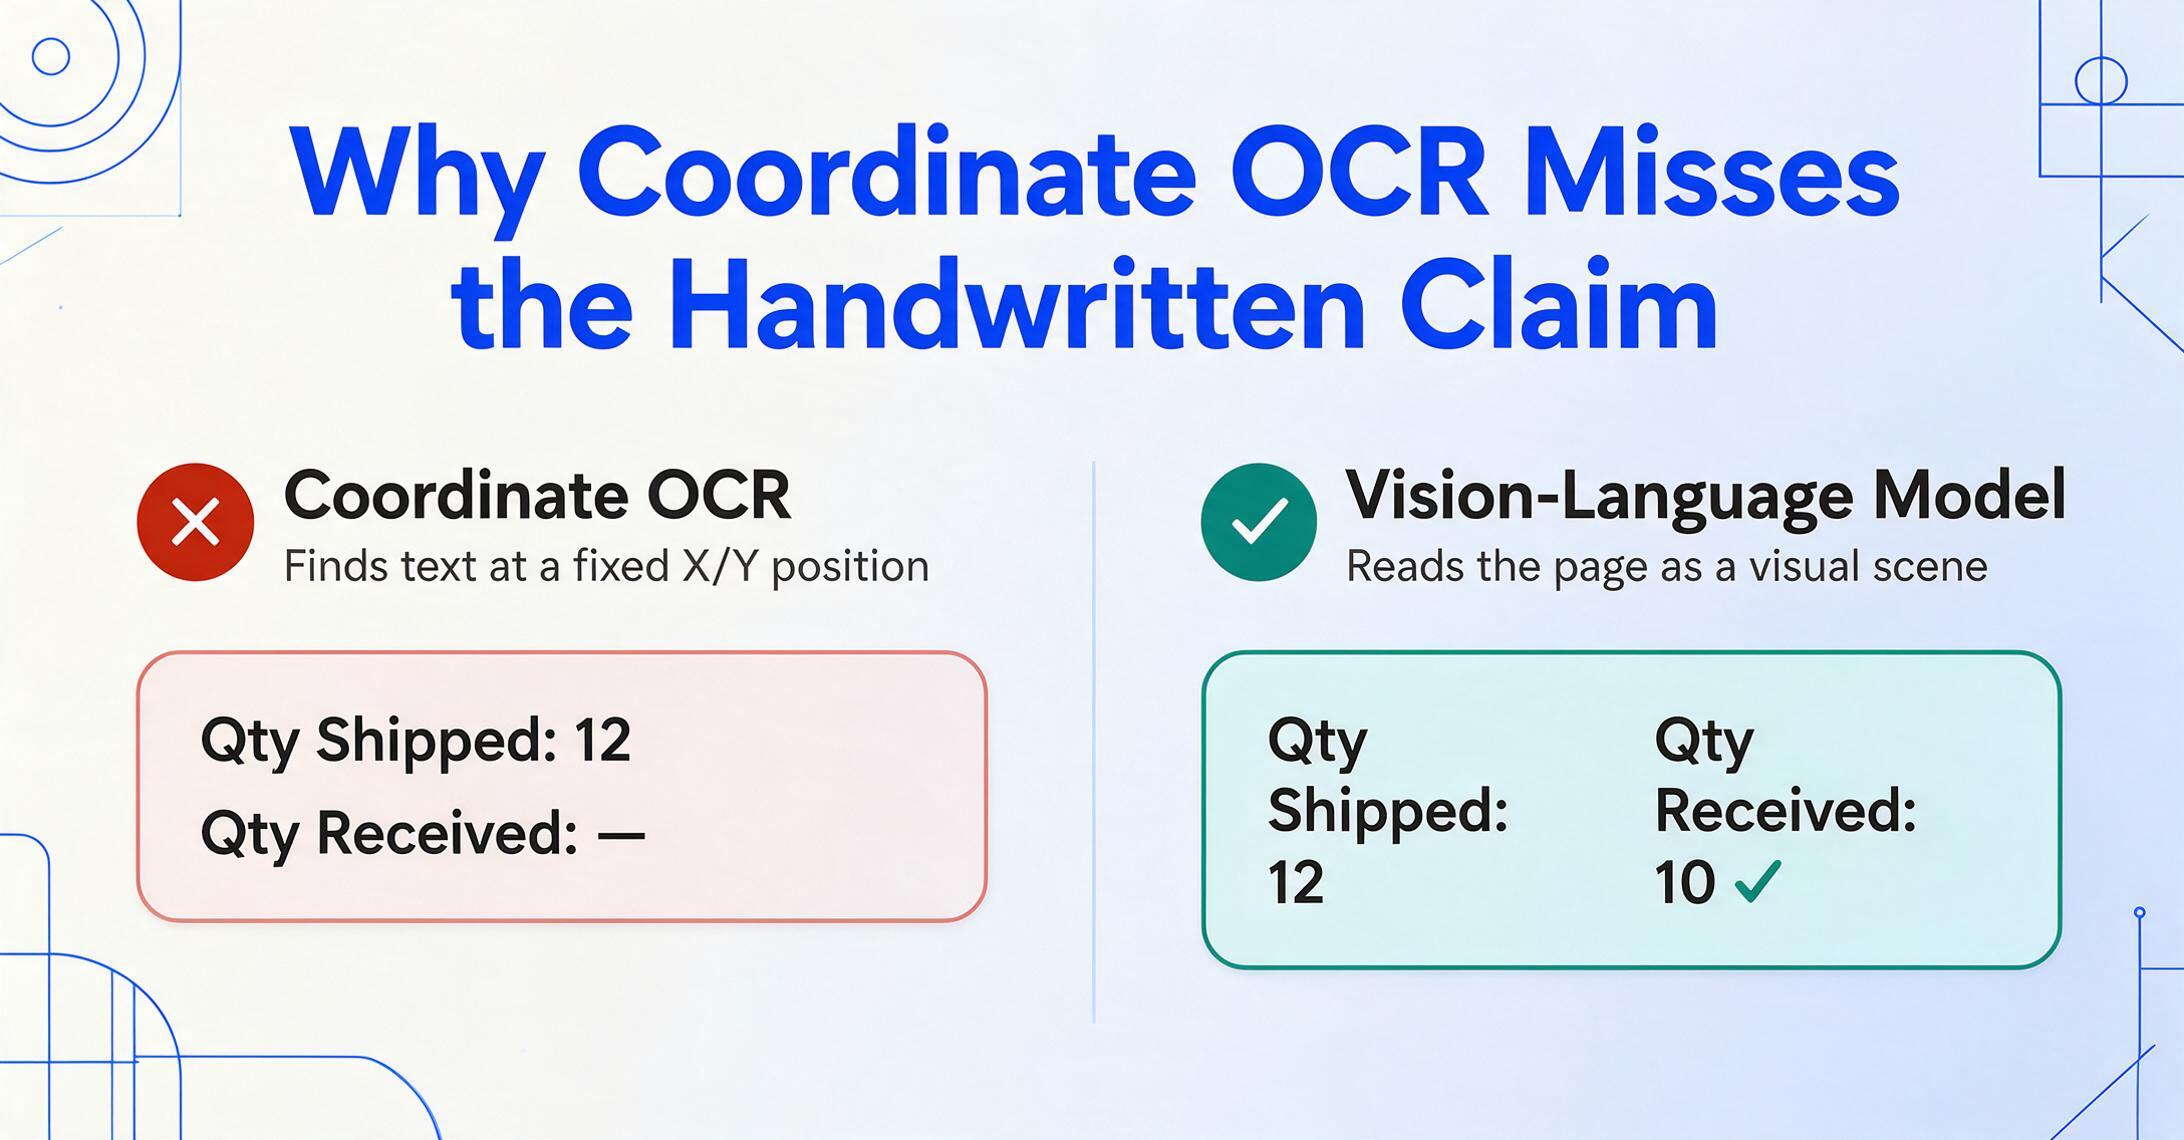
Les modèles vision-langage (VLM) abordent le problème différemment. Au lieu de chercher du texte à des coordonnées fixes, ils lisent l'ensemble du document comme une scène visuelle. Ils comprennent que le texte « 12 » imprimé dans la colonne Qté et le « 10 ✓ » manuscrit griffonné à côté sont deux affirmations différentes sur la même donnée — et ils peuvent extraire les deux dans des colonnes distinctes.
C'est le mécanisme derrière l'extraction de colonnes personnalisées : vous définissez les colonnes souhaitées — « N° de bon de commande », « SKU », « Qté expédiée », « Qté reçue », « Notes de dommages », « Reçu par » — et l'IA localise chaque valeur n'importe où sur la page en comprenant ce qu'elle signifie, et non où elle se trouve. Les champs imprimés proviennent du modèle du fournisseur. Les champs manuscrits proviennent des annotations du réceptionnaire. Ils atterrissent dans la même ligne d'un même tableur.
Le changement clé : vous ne considérez plus les annotations manuscrites comme des obstacles à l'extraction. Vous les traitez comme des champs de données à extraire — tout comme les champs imprimés, mais identifiés par leur contenu plutôt que par leur position dans la mise en page.
Cet article se concentre sur le problème à deux niveaux sur un seul bon de livraison. Pour le flux de travail plus large des bons de livraison et des preuves de livraison — pourquoi le traitement manuel coûte plus cher que vous ne le pensez, quels champs déterminent le paiement et le rapprochement, et comment choisir un outil — consultez notre guide complet sur l'extraction des bons de livraison et des preuves de livraison. Si le document en question est spécifiquement la preuve de livraison signée utilisée pour la facturation et les réclamations, consultez notre tutoriel dédié à l'extraction des données des preuves de livraison vers Excel. Et pour tester l'extraction sur un bon de livraison signé avec des annotations manuscrites, utilisez le convertisseur de bons de livraison manuscrits vers Excel.
Étape par étape : extraire les champs imprimés et manuscrits en une seule passe
Voici le flux de travail qui transforme une pile de bons de livraison signés en un seul tableur contenant à la fois ce qui a été expédié et ce qui a été reçu.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Collectez les bons de livraison signés au quai de réception
Après chaque remise par le chauffeur, le réceptionnaire doit conserver la copie annotée. Numérisez les bons de livraison papier au quai — une photo prise avec un téléphone à 300 DPI suffit — ou collectez les versions PDF que les fournisseurs envoient par e-mail après l'expédition. Le point clé : ne rangez pas la copie papier signée dans un tiroir. Téléversez-la.
Définissez vos colonnes d'extraction pour les deux couches de données
C'est ici que l'approche à deux couches prend forme. Vos colonnes pour la couche imprimée : numéro de bon de commande, SKU, description de l'article, quantité expédiée, date d'expédition, transporteur, fournisseur. Vos colonnes pour la couche manuscrite : quantité reçue, notes de dommage (champ texte), reçu par, date/heure de réception, statut de la signature (présente/absente). Saisissez ces noms de colonnes dans l'interface d'extraction — l'IA remplira chacune à partir de la partie correspondante du document, quel que soit l'emplacement de la note manuscrite par rapport au texte imprimé.
Téléversez le lot et laissez l'IA traiter les deux couches
Téléversez tous les bons de livraison du matin en un seul lot — PDF des portails fournisseurs, copies papier numérisées du quai, photos prises par l'équipe de réception. L'IA lit chaque document par rapport à vos définitions de colonnes. Les champs imprimés sont extraits de la mise en page du fournisseur. Les champs manuscrits sont extraits des annotations du réceptionnaire. Les deux aboutissent dans le même tableau structuré, alignés par ligne.
Vérifiez les exceptions, pas chaque champ
La feuille de calcul de sortie vous offre une vue côte à côte : quantité expédiée (imprimée) par rapport à quantité reçue (manuscrite). Les écarts — lorsque le compte du réceptionnaire diffère de celui du fournisseur — sont immédiatement visibles. Filtrez par écart et transmettez ces lignes au processus de réclamation fournisseur. Celles qui correspondent ne nécessitent aucune action supplémentaire. Ce qui était un rapprochement manuel de 50 bons de livraison est désormais un passage de filtrage et de vérification de 5 minutes.
À quoi ressemble la feuille de calcul de sortie
La sortie fusionnée vous donne une ligne par ligne de commande, avec des colonnes couvrant les deux couches de données. Voici la structure :
| N° de bon de commande | SKU | Qté expédiée | Qté reçue | Notes de dommage | Reçu par | Date de réception | Statut |
|---|---|---|---|---|---|---|---|
| PO-8842 | VT-334 | 50 | 47 | 3 unités endommagées — coin de la boîte écrasé | M. Chen | 2026-06-15 | Écart |
| PO-8842 | VT-338 | 100 | 100 | — | M. Chen | 2026-06-15 | OK |
| PO-8912 | SP-401 | 30 | 30 | — | J. Rivera | 2026-06-15 | OK |
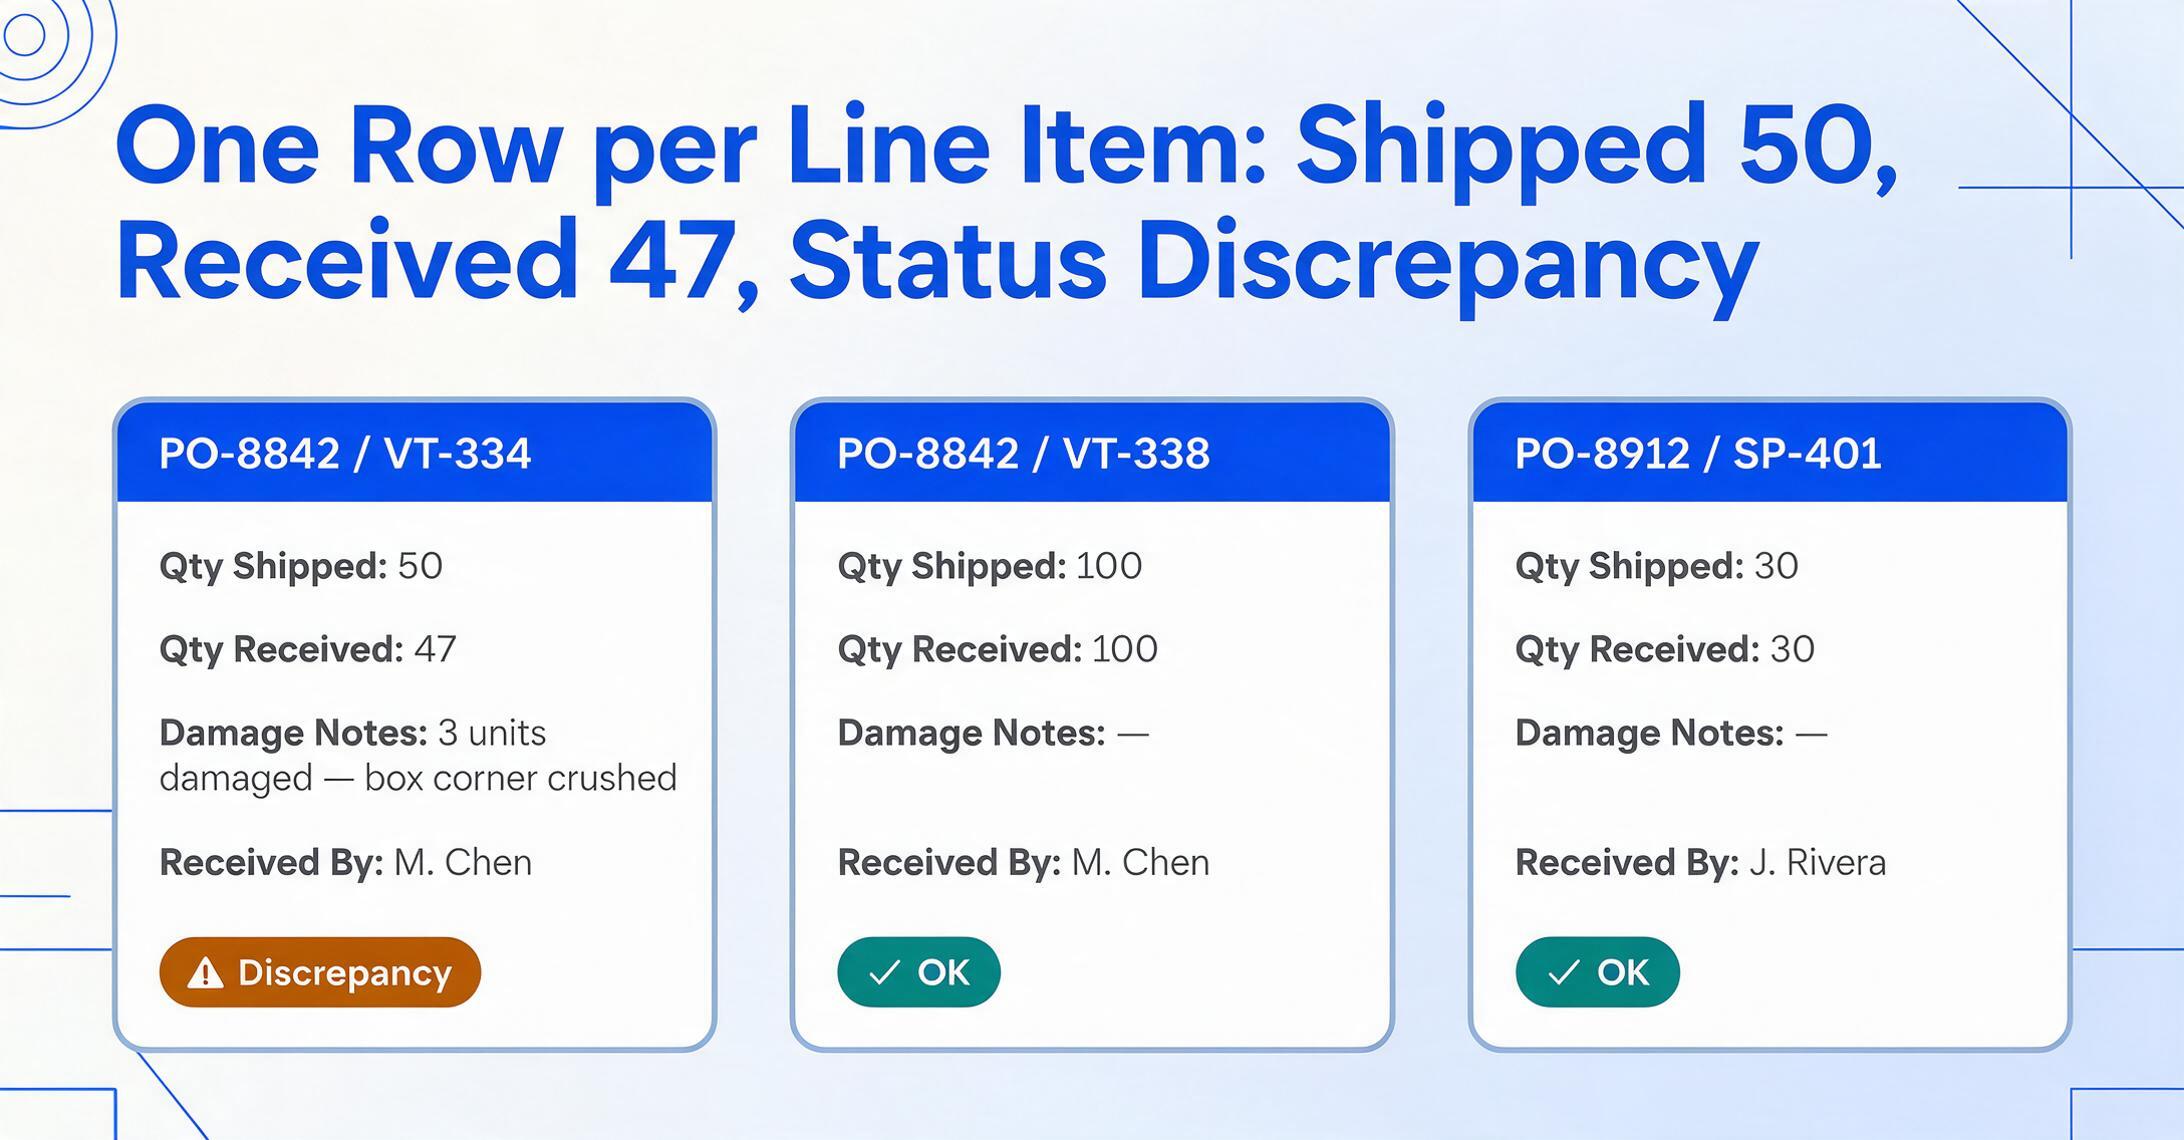
La colonne Statut peut être générée automatiquement via des colonnes inférées : définissez une colonne comme Statut (options : OK/Écart) et l'IA lit les notes de dommage et l'écart de quantité pour déterminer la valeur correcte — extraction et classification en une seule passe. Aucune étape de vérification séparée n'est nécessaire pour les cas standard.
Pour l'intégration en aval, ce tableau alimente directement votre flux de travail de rapprochement à trois voies. L'équipe de comptabilité fournisseurs dispose désormais d'un enregistrement numérique de ce qui a été réellement reçu — pas seulement de ce que le fournisseur a déclaré avoir expédié — avant d'approuver la facture. Le bon de commande correspond à la déclaration du fournisseur. L'extraction du bon de livraison correspond à ce qui est arrivé. S'ils ne correspondent pas, le paiement est retenu avec des preuves documentées.
FAQ
Quelle est la précision de l'extraction manuscrite sur des bons de livraison très annotés ?
La précision dépend de la lisibilité. Les corrections manuscrites claires — quantités entourées, « manque 3 », un nom imprimé — sont extraites de manière fiable. Les gribouillis denses sur du texte imprimé, les pages carbone très maculées ou les documents endommagés par l'eau réduiront la précision. En pratique, le flux est conçu pour que vous vérifiiez les exceptions signalées plutôt que chaque champ : l'IA extrait ce qu'elle peut des deux couches, et l'étape de relecture capture les cas limites qu'un humain doit interpréter. C'est néanmoins bien plus rapide que la saisie manuelle de tous les champs.
Cela fonctionne-t-il si les annotations manuscrites sont dans une langue différente du texte imprimé ?
Oui. Les modèles de vision-langage lisent l'écriture manuscrite indépendamment de la langue imprimée. Si le bon est en anglais mais que le réceptionnaire l'a annoté en espagnol ou en français, l'IA extrait les deux. Les noms de colonnes que vous définissez établissent l'attente sémantique — « Qté reçue » indique au modèle de chercher une annotation numérique près du champ de quantité imprimé, quelle que soit la langue du texte environnant.
La sortie peut-elle distinguer différents types d'annotations manuscrites ?
En définissant des colonnes séparées pour chaque type d'annotation — Qté reçue, Notes de dommage, Reçu par — vous demandez à l'IA d'extraire chaque information dans son propre champ. L'IA distingue une correction numérique d'une note textuelle de dommage ou d'une signature en se basant sur le contexte sémantique, pas seulement l'emplacement. Si une annotation est ambiguë, le champ de sortie sera vide ou incertain, ce qui facilite son repérage lors de la relecture.
Et si le réceptionnaire n'a rien annoté — le bon est simplement signé ?
Dans ce cas, les colonnes de la couche manuscrite (Notes de dommage, ajustements Qté reçue) seront vides, et la colonne Statut indiquera OK par défaut. Un bon signé sans exception est traité comme une acceptation — exactement comme dans un processus manuel. La différence est que l'enregistrement numérique documente désormais formellement qu'aucune exception n'a été notée à quai, ce qui constitue une preuve plus solide que « nous avons perdu la copie papier ».
Quels documents puis-je traiter en plus des bons de livraison ?
La même approche d'extraction bicouche s'applique à tout document où des données imprimées et des annotations manuscrites coexistent : bordereaux de colisage avec coches de vérification manuscrites, preuves de livraison avec notes du chauffeur, bons de réception avec annotations d'inspecteurs, et rapports d'inspection avec observations de terrain sur des modèles imprimés. Le mécanisme d'extraction est basé sur le contenu, non sur un modèle, donc les changements de format entre documents ne cassent pas le flux.
L'écart entre ce qu'un fournisseur expédie et ce qu'un entrepôt reçoit a toujours existé. La différence aujourd'hui est que vous n'avez plus à choisir quel côté du bon de livraison numériser. Vous extrayez les deux — les données d'expédition imprimées et les confirmations de réception manuscrites — en un seul enregistrement structuré, et vous cessez de perdre des litiges parce que la preuve n'a jamais quitté le papier.