計量伝票データをExcelに抽出する方法
鉄鋼・鉱業・穀物・化学調達向け
鉄鋼工場の調達担当者は、毎日の計量伝票ルーティンをこう語ります。朝のトラック納品で出た感熱紙の伝票の山。それぞれ異なるサプライヤーの計量所から届き、1枚はAvery Weigh-Tronix形式、2枚はB-TEKシステム、4枚はWinWeighのプリントアウト、3枚は地方の採石場からの手書きカーボンコピー。伝票1枚につき12項目。1日50枚。精算スプレッドシートへの入力に1枚3分。そして正味重量が1桁でも間違っていれば、鉄鉱石1台分で7,200ドルの支払い差異が月末の照合まで表面化しません。
重要ポイント
- SmartWeighだけでも30以上の伝票テンプレートを提供しており、12の計量所から調達するチームは、サプライヤーが計量台ソフトウェアをアップグレードするたびに壊れる12種類の形式に直面します。
- 手動データ入力のワークフローでは、各伝票で総重量−風袋重量=正味重量を確認する人は誰もいないため、正味重量の誤りが精算スプレッドシートに残り、数週間後にサプライヤーが支払いに異議を唱えるまで発見されません。
- ImageToTable.aiは同じ列定義であらゆる伝票形式を抽出し、抽出中にすべての正味重量の計算式を検証して、7,200ドルの精算紛争になる前に差異をフラグします。
計量伝票が実際に記録するもの — 2つの別々の計量イベント、1つの取引
抽出について説明する前に、計量伝票が、ほとんどの抽出ツールが想定している文書タイプと構造的にどう異なるかを理解しておく価値があります。計量伝票は明細項目の表ではありません。同じ車両、同じ計量台で数分間隔で行われる2つの独立した計量イベントを記録しており、その関係によって最終価格が決まります。
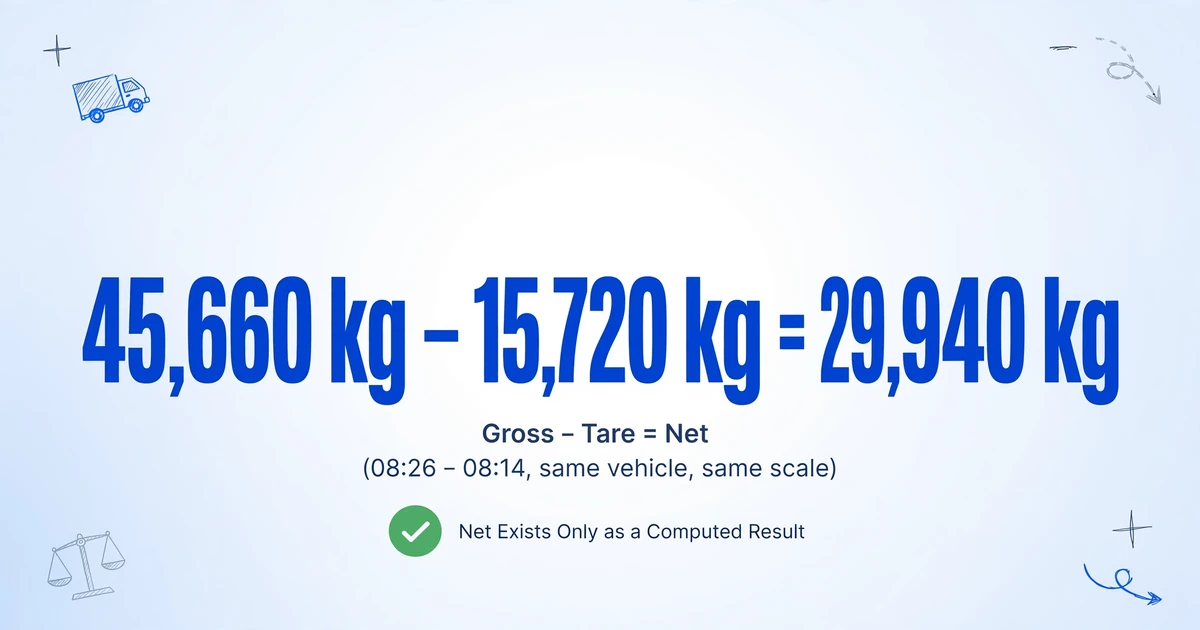
1回目の計量(風袋重量): 空のトラックが08:14に計量台に入ります。認定された計量器が積載時重量を記録します — 15,720 kg。計量台のオペレーターがタイムスタンプ、車両ナンバー、材料コードを記録します。トラックは計量台を離れ、積み込み場へ移動し、鉄鉱石、石灰石、穀物、またはバルク化学品などの貨物を受け取ります。
2回目の計量(総重量): 積載されたトラックが08:26に同じ計量台に戻ります。計量器は45,660 kgを記録します。風袋重量と総重量の両方の読み値が、タイムスタンプ、車両ID、オペレーターのイニシャル、材料の説明とともに、1枚の印刷された伝票に表示されます。
正味重量は計算結果としてのみ存在します: 正味重量 = 総重量 − 風袋重量。伝票にこの値が印刷される場合もあれば、されない場合もあります。印刷される場合でも、それは計量台ソフトウェアによって生成された数値であり、オペレーターが風袋重量を読み間違えたり、プリンターが誤作動したりした場合、印刷された「正味重量」は誤っており、誰かが引き算をやり直すまで不一致は発見されません。Loop ERPの分析によると、大量処理の計量台業務における手動データ入力のエラー率は一貫して1〜4%の範囲であり、1日200トンの処理量では、1%の計量不一致が年間$150,000を超える収益影響をもたらします。
これが、計量伝票の抽出が請求書やレシートの処理と根本的に異なる構造的な課題です。フラットな表からデータを抽出しているのではありません。2つのイベントからなる因果関係を再構築し、数値が調達精算スプレッドシートに入る前に計算を検証しているのです。
計量伝票の見た目が一枚ごとに異なる理由
計量台ソフトウェア市場は細分化されています。複数の供給元サイトから材料を受け入れる調達業務では、サイトごとに異なる伝票形式に遭遇することがあります。WinWeigh(Weightron)、Avery Weigh-Tronix、SmartWeigh、B-TEK ScaleSoft、Mettler Toledo JAGXTREME端末、Intercomp Weigh、および社内開発のカスタムソフトウェアで印刷された伝票が混在し、それぞれ独自のレイアウトを持っています。
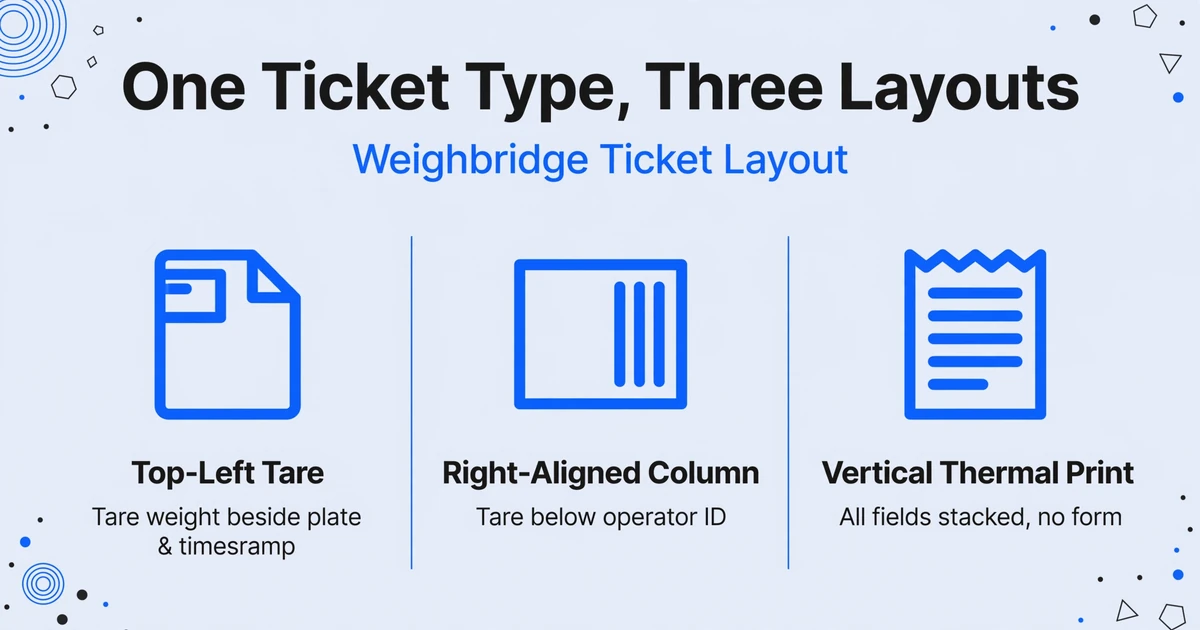
SmartWeighだけでも30以上の伝票テンプレートを提供しています。あるテンプレートでは風袋重量を車両ナンバーやタイムスタンプとともに左上隅に配置します。別のテンプレートでは、オペレーターIDの下に右寄せの列で印刷します。3つ目のテンプレートでは、すべてのフィールドをサーマルプリンターのレシートに縦に積み重ね、フォームらしさがほとんどありません。これらは珍しいバリエーションではなく、複数の計量所から調達するあらゆる調達業務が日常的に直面する現実です。
形式の多様性はレイアウトだけにとどまりません。一部の伝票では「First Weigh」と「Second Weigh」を別々のブロックとして明確にラベル付けした2ボックス構造を採用しています。他の伝票では、単一の連続テーブルに印刷され、どの行が風袋重量でどの行が総重量かを重量値自体から推測しなければなりません。中小の採石場や田舎の穀物エレベーターで今も一般的なカーボンコピー複写は、コントラストの低い用紙に薄い印字が重なり、従来のOCRエンジンではほとんど読み取れません。
テンプレートベースの抽出では、伝票レイアウトごとに個別のテンプレートを作成する必要があります。供給元サイトが12か所あれば、テンプレートも12個必要です。計量所がソフトウェアをWinWeigh IIIからWinWeigh IVにアップグレードすると、既存のテンプレートが静かに壊れます。新しい供給元が増えれば、新しいテンプレートの作成作業が発生します。テンプレートライブラリ自体が、排除しようとしていたボトルネックになってしまうのです。
重要な洞察: 計量台ソフトウェア業界はフロントエンドの問題を解決しました。スケールは正確に計量し、伝票を印刷します。しかし、バックエンドの問題は解決していません。印刷された伝票から調達チームのExcelスプレッドシートに、すべてのフィールドを再入力せずにデータを取り込むことです。すでに機能している計量台ハードウェアを運用している事業者にとって、ソフトウェア統合のためにシステム全体を交換することは、データ入力の問題に対する$10,000〜$50,000の解決策です。ドキュメント抽出は、そのギャップをわずかなコストで埋めます。
カスタム列抽出がすべての伝票レイアウトを読み取る仕組み
ここでは別のアプローチを紹介します。ツールに各フィールドがページのどこにあるかを伝えるのではなく、各フィールドが何を意味するかを伝える方法です。これがカスタム列抽出です。取得したいデータを表す列名を入力するだけで(例:「伝票番号」「車両ナンバープレート」「風袋重量」「総重量」「正味重量」「材料コード」「仕入先名」)、AIは画面上のピクセル座標ではなく、計量業務における役割を理解して各値を特定します。
「風袋重量」という列名は、AIに空車時の重量測定値(最初の計量イベントに関連する低い方の数値)を探すよう指示します。「総重量」は、2回目のイベントに関連する積載時の測定値を探すよう指示します。AIはAvery Weigh-Tronixの伝票で総重量が40列目にあるか105列目にあるかを気にしません。計量台の係員と同じように、各数値が積載プロセスで何を表すかを理解してドキュメントを読み取ります。
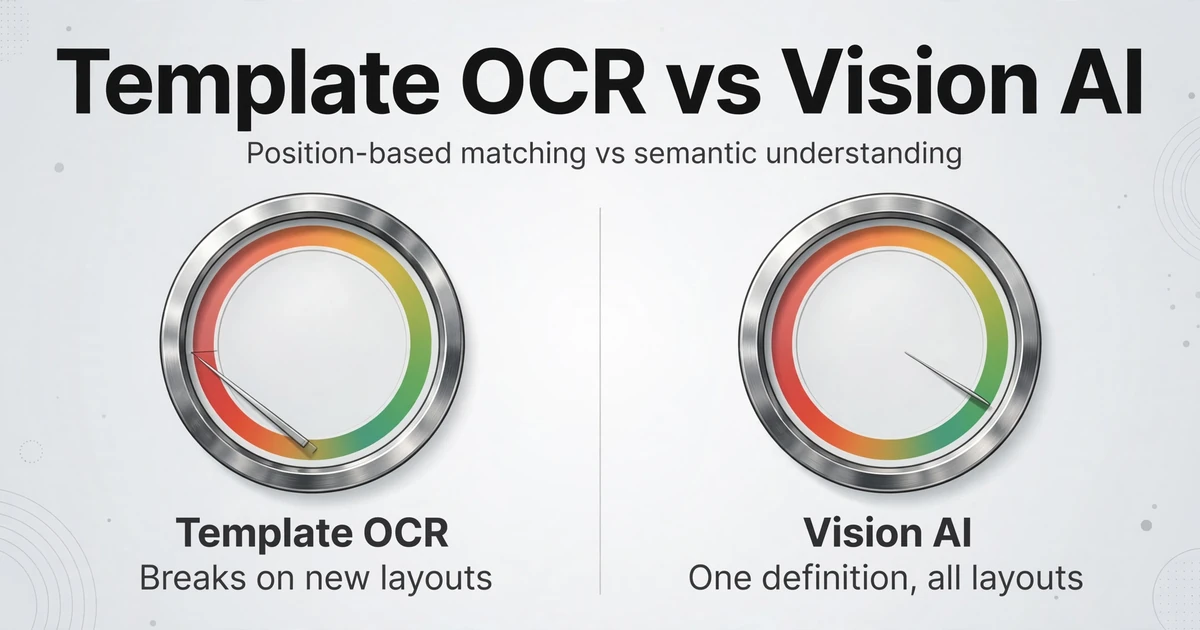
これがテンプレートOCRとビジョンAIの構造的な違いです。テンプレートOCRは位置によって文字を照合します。すべての伝票が同じレイアウトであれば機能しますが、異なる場合は破綻します。ビジョンAIは文脈と意味を理解してドキュメントを読み取ります。同じ列定義が、異なる計量所、異なるソフトウェアベンダー、異なる印刷形式の伝票全体で機能します。列を一度定義すれば、どの計量所で生成された伝票でも、同じ出力構造に揃えられたデータが得られます。
今すぐ1枚の伝票で試したい場合は、計量伝票のExcel変換ツールが1回のアップロードで同じ列ベースの抽出を実行します。必要なフィールドを入力し、伝票の写真またはPDFをドロップするだけで、検証済みのスプレッドシートが得られます。
バッチ処理ワークフロー:伝票50枚、スプレッドシート1つ、検証済みの正味重量
計量伝票の束を精算用のスプレッドシート1つに変換するワークフローは、4つのステップで構成されています。それぞれのステップは、ツールがお客様のドキュメントに適応するという原則に基づいて設計されており、その逆ではありません。
出力する列を一度だけ定義します。 すべての伝票に必要なフィールドを入力します:「シリアル番号/車両ナンバープレート/1回目の計量日時(風袋重量)/風袋重量/2回目の計量日時(総重量)/総重量/正味重量/材料コード/材料説明/仕入先名/運転手名」。これらがスプレッドシートの列ヘッダーになります。一度設定すれば、同じ列リストでAvery、WinWeigh、B-TEK、手書きの伝票を処理できます。
計算列を追加して、すべての正味重量を検証します。 「重量チェック(総重量 − 風袋重量 − 正味重量)」のような列を入力すると、AIが抽出時にすべての伝票について正味重量の計算式を算出します。結果がゼロであれば、3つの重量値が内部的に整合していることを意味します。ゼロ以外の結果は、その行をレビュー対象としてフラグ付けします。AIが値を誤読したか、元の伝票に計量台オペレーターのミスが含まれているかのいずれかです。いずれの場合も、データが精算用スプレッドシートに入力される前に差異が検出され、数週間後の照合時に発見されることはありません。
すべての伝票を一度にアップロードします。 スキャンした紙の伝票、計量台ソフトウェアからエクスポートしたPDF、計量所で撮影した写真など、計量伝票20枚、50枚、100枚を1つのバッチにドラッグ&ドロップします。対応する入力形式はPDF、JPG、PNG、WebPです。AIは各伝票を列定義に基づいて個別に処理しますが、すべての結果を1つの出力スプレッドシートに統合します。
検証済みのスプレッドシートを確認してエクスポートします。 各計量伝票が1行になります。風袋重量と総重量の計量イベントは、それぞれの列に整列します。計算列の「重量チェック」が隣に表示され、検証済みの行はゼロ、フラグ付きの差異はゼロ以外の値になります。XLSXとしてエクスポートすれば、書式設定・並べ替えが済んでおり、精算計算、ERPへのインポート、月末照合にすぐ使用できます。
処理速度は、フォーマットの複雑さではなく、ドキュメントの枚数に応じてスケールします。単一ページの計量伝票は5〜10秒で処理されます。50枚のバッチは数分で完了します。23枚目の伝票が異なるソフトウェアパッケージを実行している計量所からのものであっても、AIの処理が遅くなることはありません。セマンティック抽出は、フォーマットの多様性を設定のハードルではなく、問題ではないものとして扱います。
ファイルは安全に処理され、保存されることはありません。
抽出時の材料分類:不統一なコードからクリーンなカテゴリへ
計量伝票には、「IRN 62」「CRSH AGG 20mm」「FLY ASH DRY」「HRS 10mm」のように、省略されていたり、不統一だったり、計量所の内部システムに固有の材料コードが記載されていることがよくあります。複数のサプライヤー拠点から伝票が届く場合、同じ材料でも異なるコードで表示されることがあります。鉄鋼メーカーの調達チームが必要とするのは、全サプライヤーにわたる鉄鉱石の総トン数であり、3種類の異なる材料コード体系を照合することではありません。
推論列は、抽出時にこの問題を解決します。「材料カテゴリ(選択肢:鉄鉱石|石灰石|石炭|骨材|化学品|その他)」のような列を追加すると、AIが各伝票の材料説明またはコードを読み取り、最も近いカテゴリにマッチングして列を埋めます。抽出と分類は1回のパスで完了します — 後処理のVLOOKUPも、各コードの手動レビューも不要です。元の材料説明はソース・オブ・トゥルースのテキストとして独自の列に残り、推論されたカテゴリは精算スプレッドシートに必要な標準化されたグループ分けを提供します。
分類が価格決定を左右するコモディティグレードの材料を扱う調達業務 — 例えば62% Fe鉄鉱石と58% Feの区別 — では、グレード指定を推論カテゴリと並ぶ直接抽出列に保持してください。推論列は大まかな分類を処理し、直接抽出列は契約上の仕様を保持します。
メールの添付ファイル探しは不要:各計量所が直接アップロード
抽出の問題を解決しても、チケットファイルをシステムに取り込むという物流上の課題が残ります。一般的な調達ワークフローは、サプライヤーの計量所がチケットを印刷 → 誰かがスキャンまたは撮影 → PDFをメールで調達部門に送信 → 調達部門が添付ファイルをダウンロード → フォルダに保存 → 抽出ツールにアップロード、という流れです。抽出は自動化されていても、収集は自動化されていません。
コレクションリンクはこのギャップを埋めます。アカウントから固有のURLを生成し、各サプライヤーの計量所と共有します。計量所のオペレーターがリンクを開き、短い確認コードを入力して、その日のチケットバッチを直接あなたの処理キューにアップロードします。メールもダウンロードもフォルダも不要です。送信者はアカウントやログインを必要としません。
10~30のサプライヤーサイトからチケットを受け取る調達チームにとって、これはプロセスの中で最も非効率な部分、つまり散在するメールの添付ファイルを収集する人間が介在するステップを排除します。「20のサプライヤーメールを確認 → 20のバッチをダウンロード → 整理 → アップロード」ではなく、「サプライヤーがアップロード → チケットがキューに表示 → バッチ処理 → エクスポート」という流れになります。
カーボンコピーや手書きの計量チケットの扱い方
すべての計量所が鮮明なサーマル紙やレーザー印刷のチケットを生成するわけではありません。地方の採石場、小規模な穀物エレベーター、古い産業施設では、手書きで記入するカーボンコピー式のチケットがよく使われています。オペレーターが車両ナンバー、材料コード、両方の重量値を記入し、控えをドライバーに渡します。
これらのチケットは抽出に2つの課題をもたらします。第一に、カーボンコピーの控えは本質的にコントラストが低く、2枚目や3枚目の複写は原本よりも薄く、文字が欠けたりゴースト状になることがあります。第二に、これらのチケットの手書きの重量値は、他の手書きと同様にばらつきがあり、オペレーターの筆跡、擦れ、カーボン紙のにじみがすべて判読性に影響します。
カーボンコピーチケットの場合、可能な限り原本の1枚目をスキャンしてください。コントラストが控えよりも大幅に優れています。控えのみが残っているアーカイブの場合、AIの手書き文字認識は鮮明なカーボン印象であれば妥当な精度で処理できますが、色あせたり擦れたフィールドでは信頼性が低下することを想定してください。アーカイブ全体を処理する前に、サンプルバッチで計算列の正味重量チェックを実行してください。ほとんどの重量チェック値がゼロになる場合、抽出は信頼できます。ゼロ以外の値が一般的な場合は、該当する行を手動でスポットチェックしてください。
正直な限界: 著しく劣化したカーボンコピー(3枚目や4枚目の複写がほぼ白紙の場合)や、不規則な筆跡で密に手書きされたチケットでは、抽出精度が低下します。計算列による検証がセーフティネットとなり、抽出エラーが決済に波及する前に捕捉します。しかし、最も状態の悪いチケットについては、重要な重量フィールドの手動入力が依然として必要になる場合があります。このツールは、手動データ入力を「すべてのチケットのすべてのフィールド」から「一部のチケットの一部のフィールド」に削減します。
計量証明書の法的位置づけ:その重要性
バルク商品の調達において、計量証明書は単なるデータ記録ではなく、法的文書です。米国の商用計量機器の基準であるNISTハンドブック44に基づき、法定計量器は所定の精度許容差を満たし、取引重量を含む記録を出力しなければなりません。NTEP(国家型式評価プログラム)は、計量機器がこれらの要件に適合していることを認定します。NTEP認定の計量器でNISTハンドブック44準拠のスケールから発行された計量証明書は、取引における法的に有効な重量記録となります。
ケンタッキー州改正法363.780条(多くの州の類似法を代表)では、重量で販売されるバルク商品の納品には、販売者名・住所、購入者名・住所、正味重量、および正味重量の算出元となる総重量と風袋重量を記載した納品書の写しを添付することを義務付けています。49 CFR §375.519に基づき、計量証明書には計量器の完全な名称と設置場所、各計量の日付、風袋/総重量/正味重量の区分、および計量責任者の署名を含める必要があります。
これらの文書の法的な重みは、データ抽出に実務的な影響を及ぼします。抽出されるデータは、計量器が記録したデータそのものです。AIは計量器の校正を検証しません。証明書に印刷または記入された内容を抽出するだけです。計算列の重量チェックは内部的な整合性(総重量-風袋重量=正味重量か)を検証しますが、その朝に計量器が50kg高く表示していたかどうかは判断できません。計量器の校正監査は、計量器を保守する登録サービス事業者の管轄であり、文書抽出ツールの役割ではありません。
よくある質問
風袋と総重量の計量が別ページの計量券にも対応できますか?
はい — 両方のページを同じバッチでアップロードしてください。AIが各ページを個別に処理し、車両ナンバーとチケット番号で結果を紐付けます。計量所によって風袋と総重量の伝票が別々に発行される場合(1回計量方式でよくあるケース)も、まとめてアップロードすればAIが共通の識別子で2つの計量をペアリングします。
仕入先によって項目名が異なる場合(例:「風袋」「空車重量」「無積載重量」)はどうなりますか?
AIが意味的に同等な用語をマッピングします。列名として「風袋重量」を指定すれば、AIは計量券上の「風袋」「空車重量」「無積載重量」「Tare Mass」などのフィールドを探し出し、指定した風袋重量の列にマッピングします。類義語をすべて列挙する必要はありません — AIはこれらがすべて空車時の重量を示すことを理解します。
仕入先の計量所ごとに設定が必要ですか?
いいえ。一度定義した列リストは、すべての計量所とすべてのチケット形式で有効です。テンプレート作成、仕入先ごとの設定、学習フェーズは一切不要です。これが、フォーマットが混在する環境において、位置ベース抽出に対するセマンティック抽出の核となる利点です。
チケットにフィールドがない場合(例:運転手名が記載されていない計量券)はどうなりますか?
該当チケットのそのフィールドは、出力では空白になります。スプレッドシートの構造は全行で統一され、欠落フィールドは空セルとして表示されます。エラー、テンプレート不一致の警告、ワークフローの中断は一切発生しません。
データをERPのインポート形式でエクスポートできますか?
はい — 列名をERPのインポートフィールド名に合わせて設定してください。列定義時にERPの正確なヘッダー名を使用すれば、XLSX出力は直接インポート可能な構造になります。日付形式や数値形式は抽出設定で指定でき、SAP、Oracle NetSuite、Microsoft Dynamics、あるいはLoop ERPのような業界特化型プラットフォームなど、お使いのERPの要件に合わせることができます。
このツールは計量台のハードウェアに直接接続できますか?
いいえ。ImageToTable.aiは文書抽出ツールです。印刷、スキャン、または撮影された後の計量伝票を処理します。計量台のハードウェア、ロードセル、またはリアルタイム計量システムには接続しません。リアルタイムのハードウェア統合が必要な場合は、計量管理ソフトウェア(WinWeigh、B-TEK ScaleSoftなど)の領域です。このツールは、すでに存在する伝票(机の上にある50枚の伝票の束)の下流のデータ入力問題を解決します。
風袋重量、総重量、正味重量などの重要な重量フィールドの抽出精度はどのくらいですか?
計量ソフトウェアからの鮮明なデジタル印刷物(運用中の計量所からの伝票の大部分)の場合、重量フィールドの抽出精度は通常95%を超えます。主な精度低下の原因は、色あせた感熱紙レシート、文字が欠けたカーボンコピー、不規則な筆跡の手書きフィールド、ひどく傾いた写真です。計算列の重量チェックは抽出の不整合を検出します。ゼロ以外の結果は、3つの重量値のいずれかが誤読されたか、元の伝票に不整合があることを意味し、その行はレビュー用にフラグ付けされます。
自動抽出が調達文書タイプ全体の手動データ入力とどのように比較されるかについて詳しくは、計量伝票OCRと手動入力のエラー率とコストの比較をご覧ください。計量伝票を構造化されたスプレッドシートに一括変換するには、計量伝票からExcelへの変換ツールを使用してください。