AIは工事日報を
読めるのか?はい、ここでできることとできないことを解説
はい。最新の視覚AIは、手書きの工事日報から作業員数、職種別の作業時間、機器ID、材料の納品、安全インシデントを抽出できます。ただし、精度は手書きの読みやすさと写真の品質に大きく依存します。きれいに記入されたフォームを鮮明に撮影した場合、項目レベルの精度は、活字体の手書きで90〜95%、筆記体で75〜85%の範囲になります。しかし、工事日報には請求書やレシートにはない二重の課題があります。ほぼ100%が手書きであることに加え、埋め込まれた表構造と可変のフォームレイアウトに対応する必要があるのです。
重要なポイント
- 作業員名と機器の稼働時間を再入力する20分が、同じ工事日報の写真から、3分のスポットチェックに短縮されます。
- 平らで真正面から、明るい場所で撮影した写真は、斜めからの素早いスナップ写真よりも15〜25%高い抽出精度を実現します。この差は、どのツールをアップグレードするよりも大きなものです。
- ボトルネックが転記から検証に移ると、PMは本来の仕事、つまり人件費の異常値の検出に集中でき、作業員名簿の再入力に時間を取られることはありません。
AIは工事日報をどの程度正確に読み取れるのか?
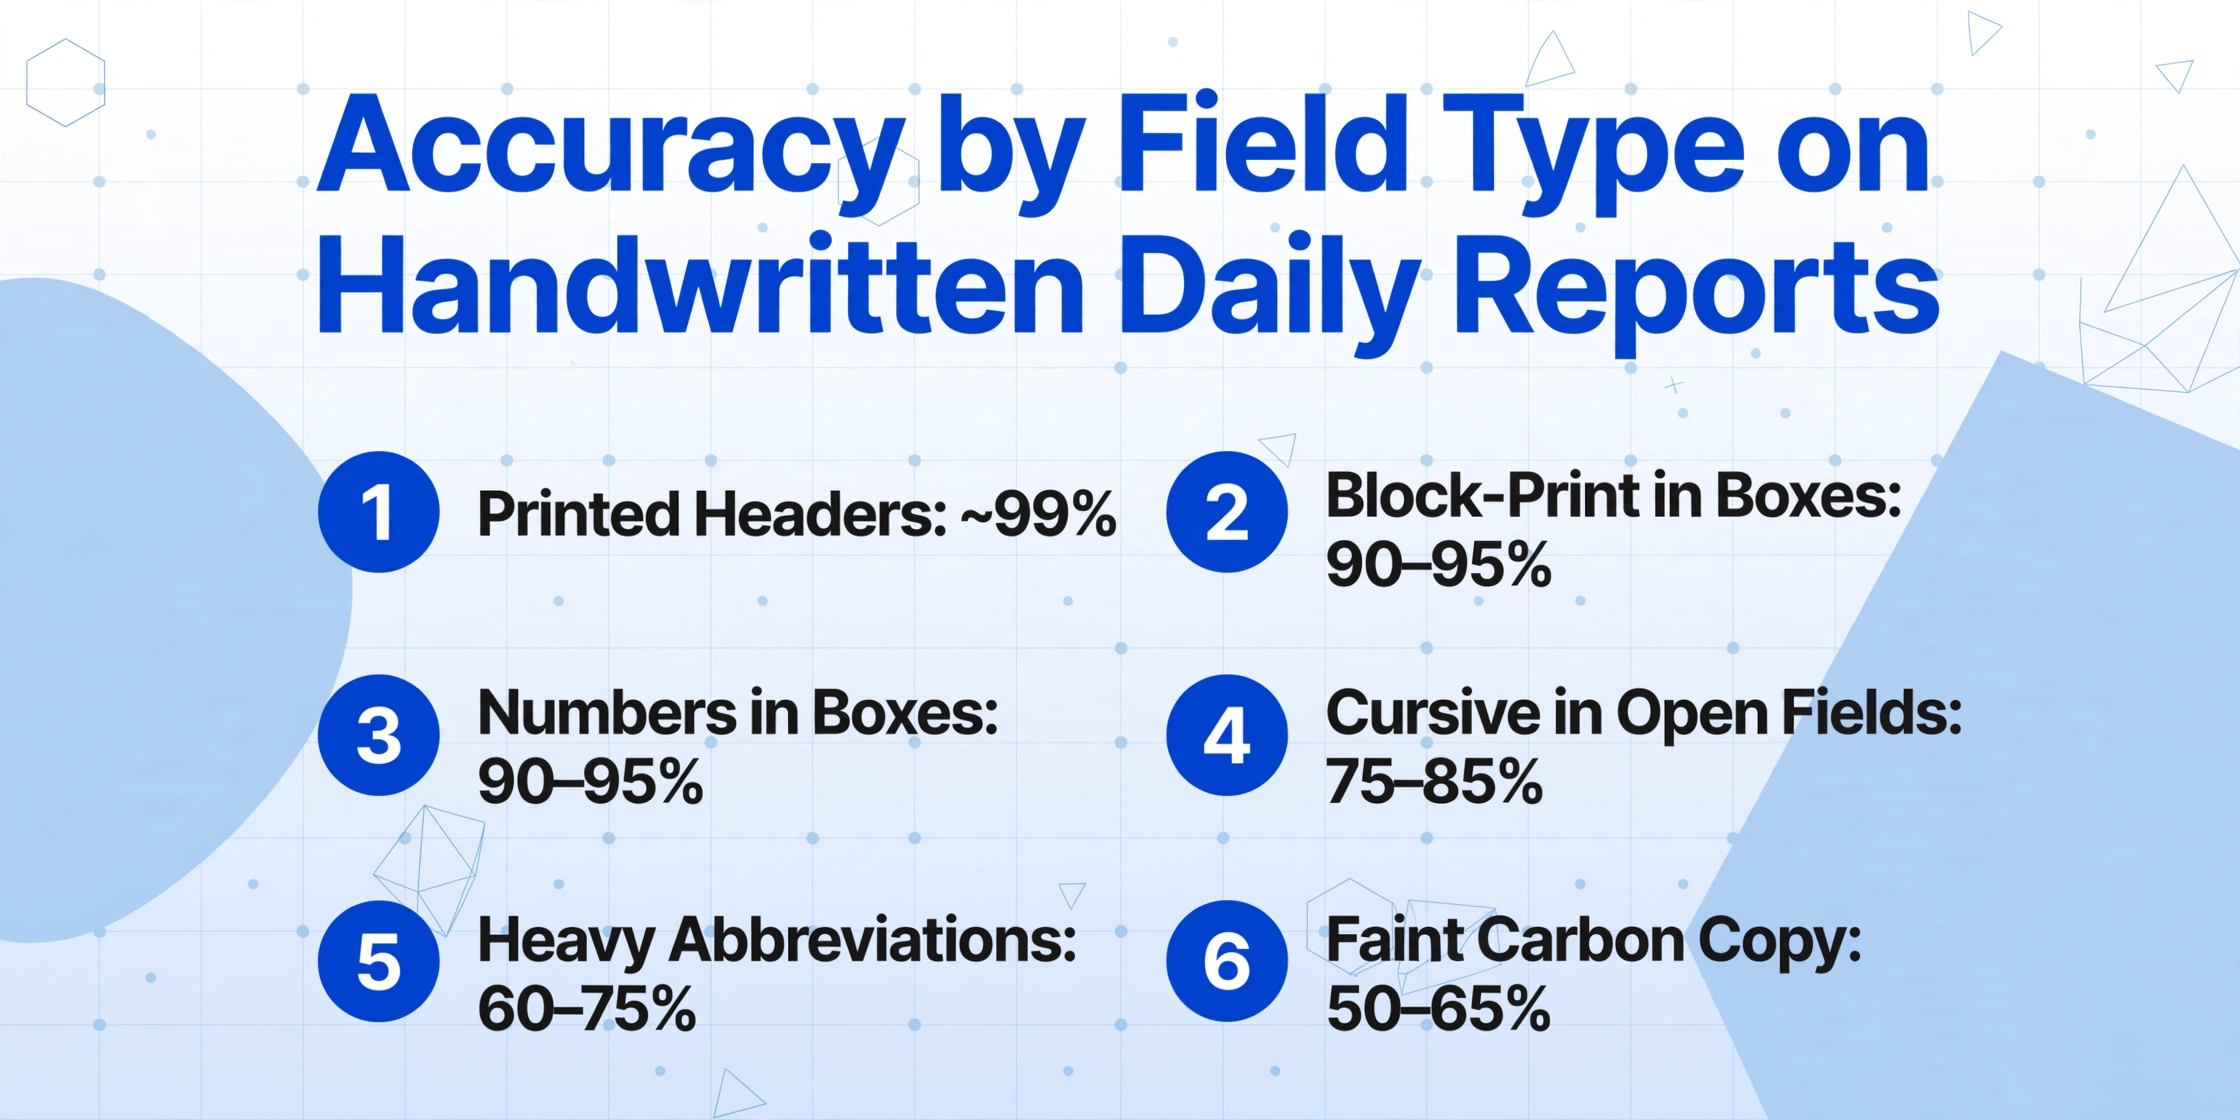
手書きの工事日報における精度は単一の数値では表せません。何を抽出するか、また報告書がどのように記入されたかによって異なります。以下は、一般的な現場監督の日報フォームに見られる一般的なフィールドタイプ別の内訳です:
手書きの工事日報におけるフィールドタイプ別の抽出精度:
タイプ印刷/印字ヘッダー+プリント済みラベル:約99%の精度
ラベル付きボックス内のブロック体手書き:90〜95%の精度
ボックス内の数字(時間、数量、気温):90〜95%の精度
自由欄の筆記体または速い手書き:75〜85%の精度
多用される略語や現場固有の短縮表記:60〜75%の精度
薄いカーボンコピー(3枚目、摩耗あり):50〜65%の精度同じツールにおける最良ケースと最悪ケースの精度差は、異なるツール間の差よりも大きいものです。つまり、どのプラットフォームを選ぶかよりも、入力品質の方が重要です。一般的な日報には15〜35個の抽出可能なフィールドがあります。85%の精度では、報告書あたり2〜5個のフィールドを修正する必要があります。手入力では5件の報告書に30〜45分かかります。AI抽出とその後のスポットチェックでは3〜5分です。手書き現場ログの詳細な精度ガイドでは、これらの数値の背後にあるテスト方法論を説明しています。
ボトルネックは転記から検証へと移行します。そして検証は桁違いに高速です。
日報が請求書や領収書より難しい理由
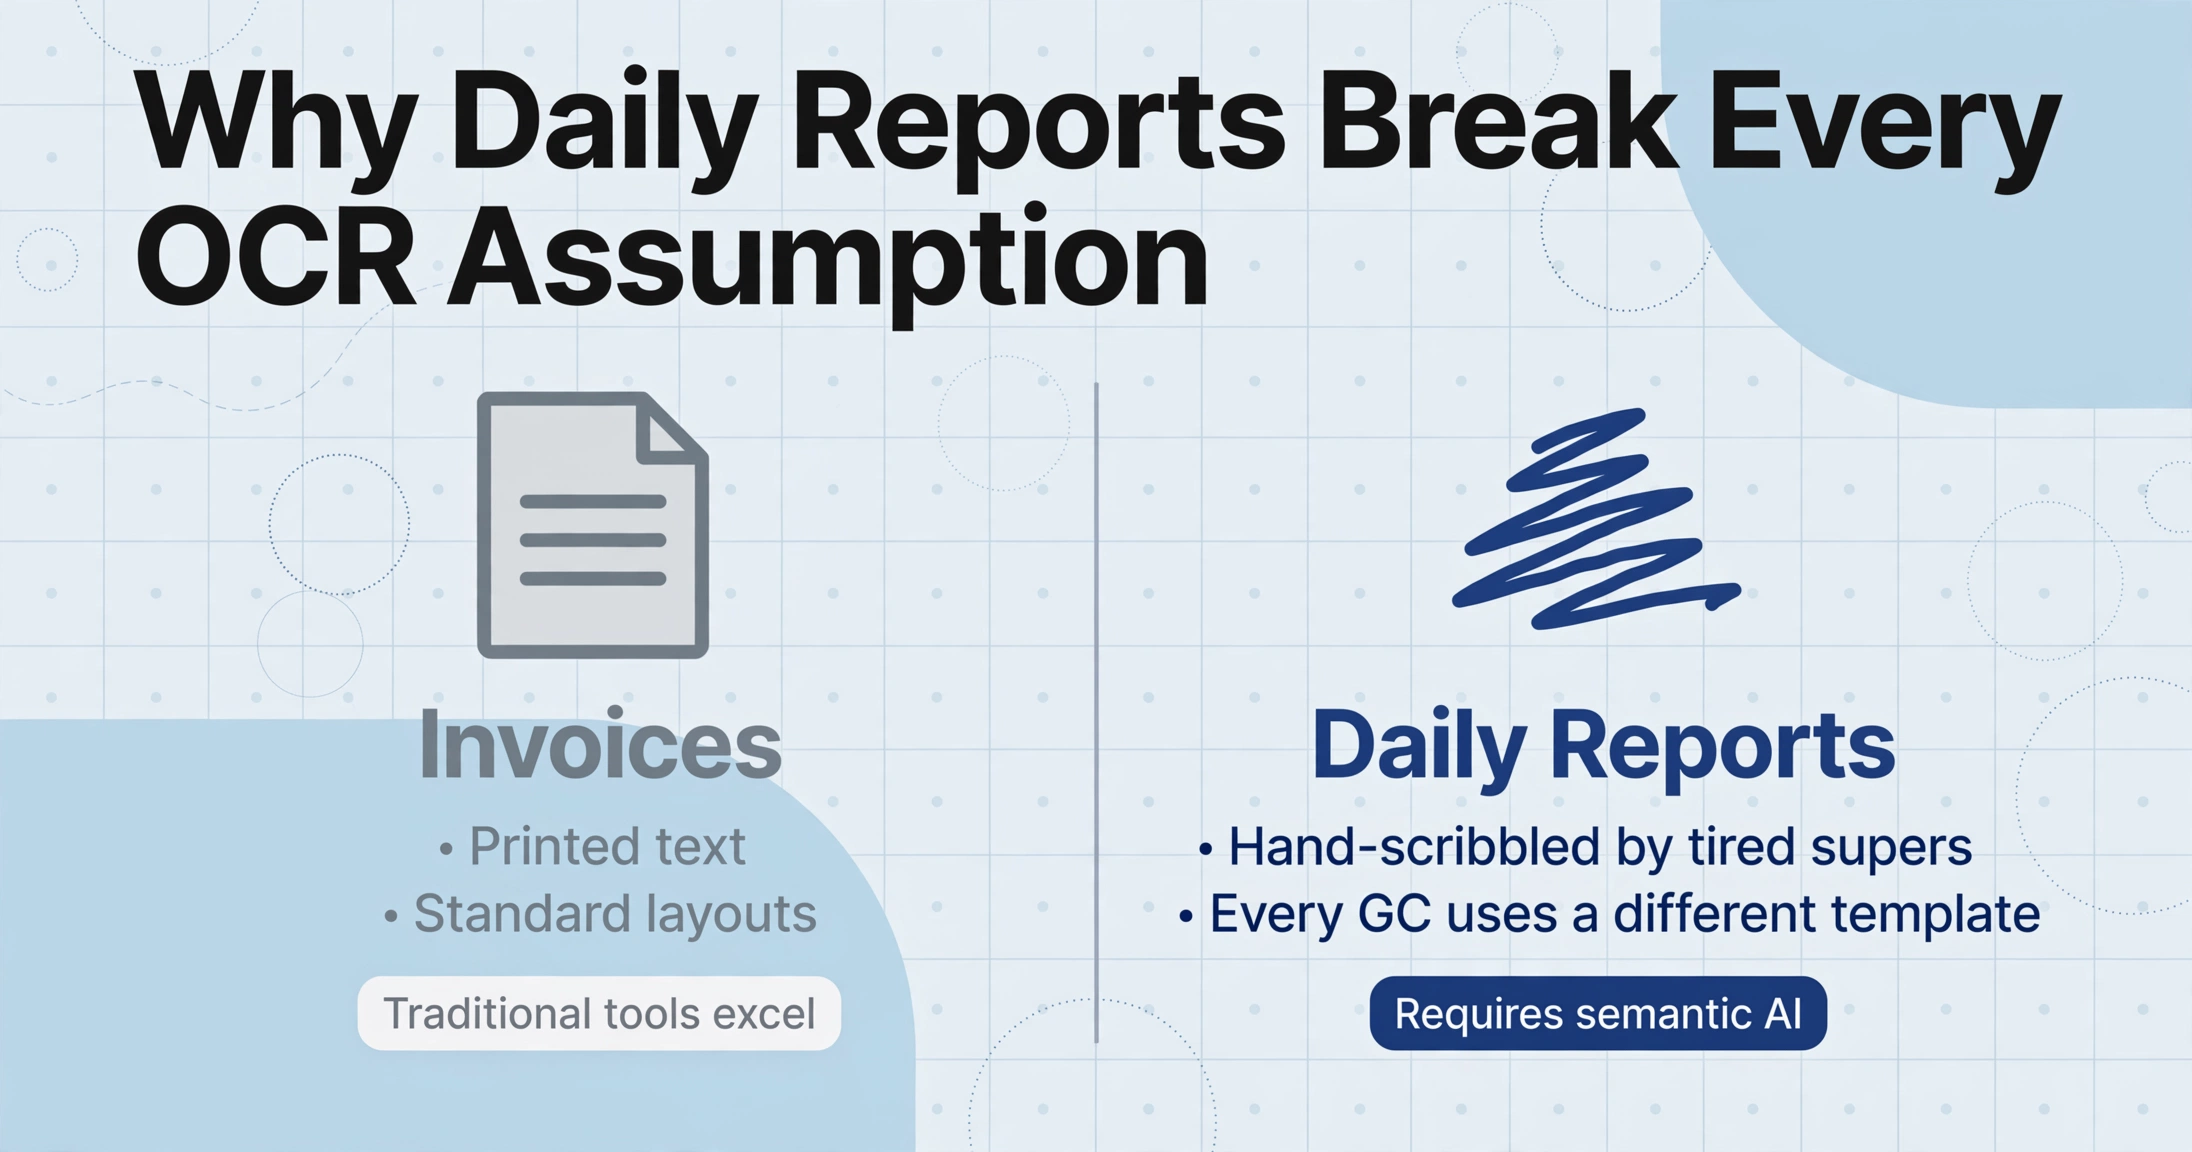
AI抽出のベンチマークは通常、請求書を基に作られています。印刷された文字、標準的なレイアウト、予測可能なフィールド位置。しかし建設日報は、そのすべての前提を覆します。
手書き率。日報は、10時間労働の最後の20分で現場監督がすべて手書きで記入するものです。文字の形をフォントモデルに照合する従来のOCRは、手書き文字では実用精度を下回ります。なぜなら手書き文字は、線の太さ、傾き、文字の形成に無限のばらつきがあるからです。
埋め込まれた表構造。1枚のページに、作業員表(氏名×時間)、機器表(ID×稼働時間)、材料表(品名×数量)、来訪者記録が含まれることがあり、それぞれが独自の列レイアウトを持ちます。AIは表の境界を特定し、手書きの各値を正しい列ヘッダーに関連付ける必要があります。
可変のフォームレイアウト。すべてのGCやプロジェクトマネージャーが少しずつ異なるテンプレートを使用します。印刷されたPDFフォーム、カーボンコピーのノート、または現場監督が独自の表を描く白紙のノートページなどです。フォームごとの設定が必要なテンプレートベースのツールは、複数現場の規模では実用的ではありません。日報がデジタル化を阻む理由の詳細な分析では、これらの障壁が15年間紙を標準としてきた理由を説明しています。現在のAIが従来と異なる点は意味的読み取りです。位置ではなく意味に基づいて抽出します。
AIが日報で正確に読み取れる項目
いくつかの現場カテゴリは、ビジョンモデルの強みを活かせるため、常に高い精度で抽出されます。
ラベル付きボックス内の構造化された数値フィールド。フォームに明確なラベル付きの列(「作業員数」「労働時間」「機器稼働時間」)がある場合、AIはラベルを使用して手書きの数値を文脈に沿って解釈します。数字は筆記体のテキストよりも文字の曖昧さが少ないため、ラベル付きの表セル内の数値は90〜95%の精度で確実に抽出されます。
チェックボックスと二値インジケーター。安全インシデントの有無、天候条件、チェック・×印・丸で記入されるY/Nフィールドは、手書きのスタイルに関係なく視覚パターンが一貫しているため、ほぼ100%の精度で抽出されます。
印刷と手書きが混在するフォーム。AIは事前印刷されたラベルと手書きの記入項目を自動的に区別します。「作業員氏名」がラベルで、その隣の「J. Martinez」が値であることを認識します。従来のOCRはすべてをテキストに変換し、どのテキストがメタデータでどのテキストがデータかを理解しないため、これを誤ることがよくあります。
天候と気温フィールド。これらは語彙が限定された専用ボックス(「晴れ」「雨」「曇り」)に表示されるため、乱雑な手書きでも高い信頼性で抽出できます。
AIが日報でまだ苦手とする領域
有用な能力評価では、人間による確認が依然として必要な具体的なシナリオが挙げられます。
かすかなカーボンコピーとNCR紙。3枚目や4枚目のカーボンレスコピーがオフィスに届く頃には、手書き文字がほとんど見えないことがあります。画像のコントラストが読み取り可能なしきい値を下回ると、抽出精度は急激に低下します。画像にない筆跡をどれだけ高度なモデルでも復元することはできません。実用的な対策は、一番上のコピーを撮影することです。
筆記体が多い説明欄。「作業完了」欄は通常、筆記体が続く場合、精度は75〜85%(はっきりした筆記)から50〜65%(略語を含む密集した筆記体)に低下します。対策としては、説明文は構造化抽出を必要としません。単一のメモ欄として取得し、元の形式のまま確認します。時間、数量、機器IDなどの構造化フィールドを抽出の優先対象にします。
手書きのスケッチや図面。フリーハンドのスケッチ(トレンチ断面図、鉄筋マークアップ)は構造化データに変換されません。スケッチ内のテキストラベルは個別に抽出される場合がありますが、空間的な関係は失われます。スケッチは画像添付ファイルとして扱ってください。
フィールド境界をまたぐ筆記と物理的な書類の損傷。筆記が隣接するフィールドや余白にはみ出すと、AIがテキストを誤った列に関連付ける可能性があります。水濡れによる損傷、激しい折り目、泥の汚れも、影響を受けた領域の抽出精度を低下させます。現場トレーラーを離れる前に報告書を事前スキャンすることで、これらの問題のほとんどを解消できます。
すべての限界に共通するパターンは一貫しています。抽出品質は入力品質に左右されます。実用的な対策は、報告書が折り曲げられたり損傷したりする前に、より良い写真を撮ることです。
AIによる日報抽出で最良の結果を得る方法
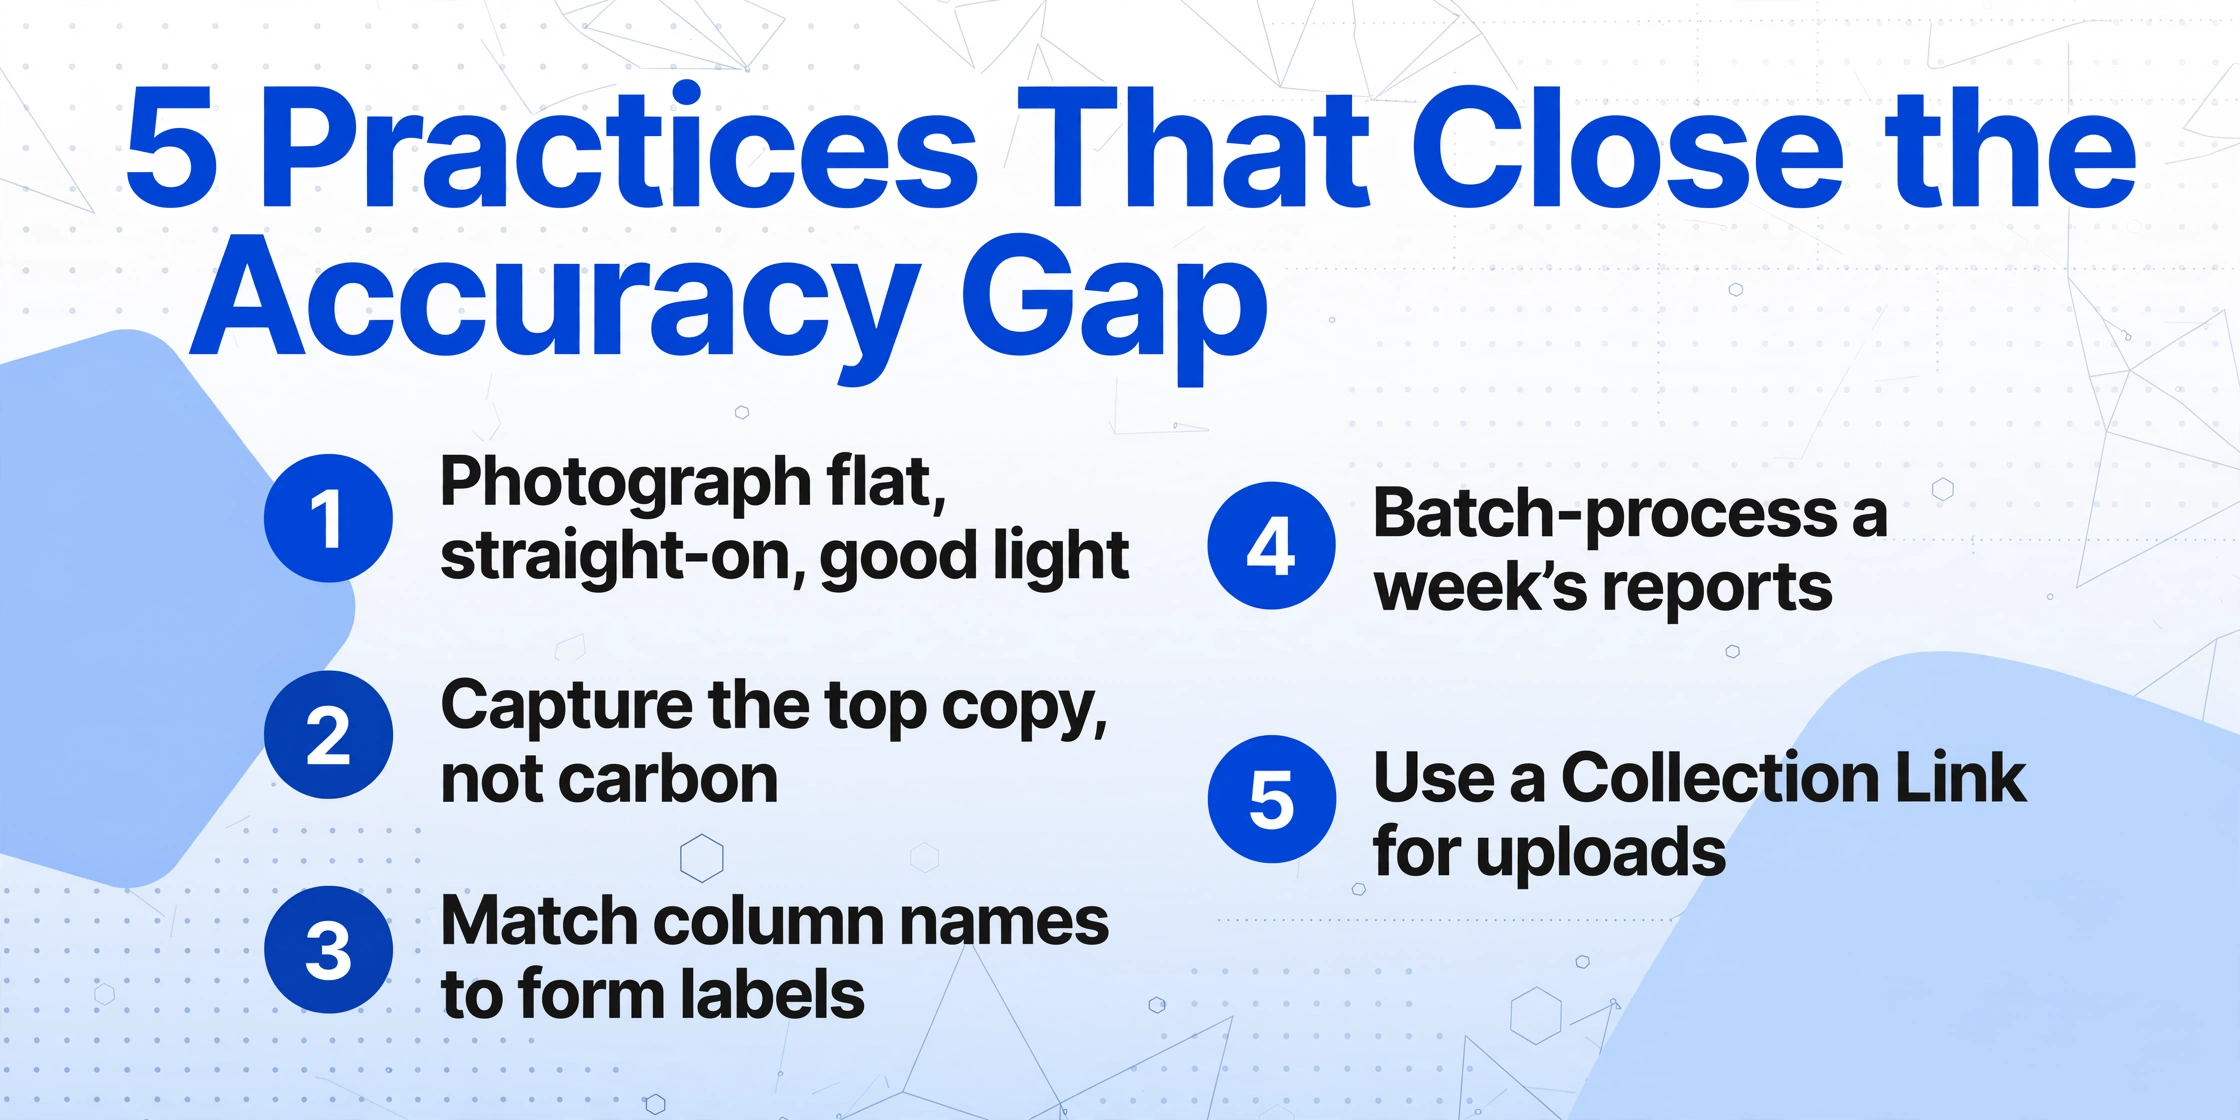
同じフォームでの65%から92%の精度の差は、ほぼすべて準備と現場設計に起因します。この差の大部分は、以下の5つの実践方法で説明できます。
用紙を平らに置き、正面から、明るい場所で撮影する。報告書を平らに置き、カメラをページに対して垂直に構え、十分な光を確保します。この方法で撮影した写真は、暗い場所で斜めから撮ったスナップ写真よりも15〜25%精度が高くなります。これは最も影響の大きい変数です。
原本を撮影し、カーボン複写は撮らない。一番上の用紙が取り外される前に、原本を撮影してください。カーボン複写は下の用紙になるほどコントラストが低くなります。コントラストは画質において最も重要な要素です。
フォームのフィールドラベルに合わせて列名を定義する。セマンティックマッチングは、列定義が用紙上の表記と一致している場合に最も効果的に機能します。フォームに「Equip #」と記載されている場合は、「Equipment ID」ではなく「Equip #」を列名に使用してください。
1週間分の報告書をまとめて処理する。処理量が増えるほど時間の節約効果は大きくなります。4つの現場から20件の報告書を処理すると、手入力と比較して2時間以上節約できます。週次サマリーのバッチ処理ワークフローをご覧ください。
現場代理人のアップロードにはコレクションリンクを使用する。各所長が自分のスマートフォンから開ける共有可能なコレクションリンクを生成します。所長は自分の報告書を撮影してアップロードするだけで、アプリのインストールもトレーニングも不要です。
実例で見る:各フィールドの実際の抽出結果
標準的な様式の日報を、ブロック体と筆記体が混在した手書き記入で、明るい場所で鮮明に撮影した場合、AIによるフィールド別の抽出結果は以下のようになります。
フィールドタイプ別の期待される抽出精度(鮮明な写真、良好な照明条件):
報告日(枠内に印字): 安定して抽出可能
天候 午前/午後(選択肢へのチェック): ほぼ100%
作業員名+職種別時間(表、ブロック体): 90~95%
機材ID+稼働時間(英数字、表内): 85~90%
材料+数量(手書き混在): 80~90%
安全インシデント記述(筆記体の文章): 70~80%
作業完了記述(段落形式の筆記体): 60~75%
トレードオフは明確です。コスト管理や労務レポートに使われるデータ(作業員時間、数量、機材ID)は、ラベル付きセル内の構造化された数値であるため、85~95%の精度で抽出されます。一方、文章部分の精度は低くなりますが、これらは原本で確認され、スプレッドシートに再入力されることはないため許容範囲です。複数のプロジェクトを管理するPMにとって、これは四半期あたり100時間以上の転記作業から、10~15時間の確認作業へのシフトを意味します。そして、確認作業こそPMの判断力が真価を発揮する場です。
よくある質問
AIは筆記体で書かれた日報を読めますか?
はい、筆跡の明瞭さにもよりますが、70~85%の精度で読み取れます。略語が混じった詰まった筆記体では50~65%に低下します。実用的なアプローチとしては、構造化されたフィールド(数値、名前、時間)を優先的に抽出し、文章部分は人間が確認するメモ欄として扱うことです。
日報のフォーマットごとにAIの設定を変える必要がありますか?
いいえ。カスタム列抽出は、位置ではなく意味に基づいてフィールドを読み取るため、同じ列定義が異なるフォームレイアウトでも機能します。作業員テーブルのラベルが「要員」でも「人員」でも、AIは正しいデータを見つけます。詳細は建設PMのための書類抽出ガイドをご参照ください。
人間でも読めない字はどうすれば?
人間が読めなければAIも読めません。抽出が有効なのは、読める報告書の80~90%です。本当に判読不能な場合は、記入者を誘導するラベル付きの定型用紙を使うのが解決策であり、AIの改良ではありません。
抽出データはProcoreやSageに取り込めますか?
はい — XLSX、CSV、JSONで出力し、データインポートに対応するプラットフォームに取り込めます。これはファイルベースの受け渡しであり、リアルタイムAPI連携ではありませんが、データは構造化・検証済みのため、インポートは再入力ではなくファイルアップロードで完了します。
RakenやFieldwireのような報告アプリとの違いは?
解決する課題が異なります。アプリは作成時点で紙を置き換えるもの — 現場監督がアプリに入力します。写真からのAI抽出は、既存の紙の出力をデジタル化し、誰の行動も変えません。両者は補完的です。あるチームはアプリ、別のチームは紙を使い、抽出レイヤーがどちらも処理します。
最も効果的な精度向上策は?
報告書を平らに、真上から、明るい場所で撮影すること。斜め・低照度のスナップと適切な写真では精度に15~25ポイントの差があり、これはどんなツールの改善よりも大きいです。手書き現場日報の精度向上ガイドには、現場事務所に掲示できる写真品質チェックリストが含まれています。