¿Puede la IA leer informes diarios
de obra? Sí, esto es lo que funciona y lo que no
Sí. La IA de visión moderna extrae recuentos de cuadrillas, horas por oficio, identificadores de equipos, entregas de materiales e incidentes de seguridad de informes diarios de obra escritos a mano, pero la precisión depende en gran medida de la legibilidad de la escritura y de la calidad de la foto. En una foto clara de un formulario bien cumplimentado, la precisión a nivel de campo oscila entre el 90–95 % para escritura tipo imprenta y el 75–85 % para cursiva. Pero los informes diarios presentan un doble desafío que las facturas y los recibos no tienen: una tasa de escritura a mano de casi el 100 % combinada con estructuras de tablas integradas y diseños de formularios variables.
Conclusiones clave
- 20 minutos de reescritura de nombres de cuadrillas y horas de equipos se reducen a 3 minutos de verificación puntual, a partir de la misma foto del informe diario.
- Una foto plana, tomada de frente y con buena luz produce una precisión de extracción entre un 15 y un 25 % mayor que una instantánea rápida en ángulo, y esa diferencia es mayor que cualquier mejora de herramienta.
- Cuando el cuello de botella pasa de la transcripción a la verificación, los PM hacen aquello para lo que fueron contratados: detectar anomalías en los costos de mano de obra, no reescribir las listas de cuadrillas.
¿Qué tan bien lee la IA un informe diario de obra?
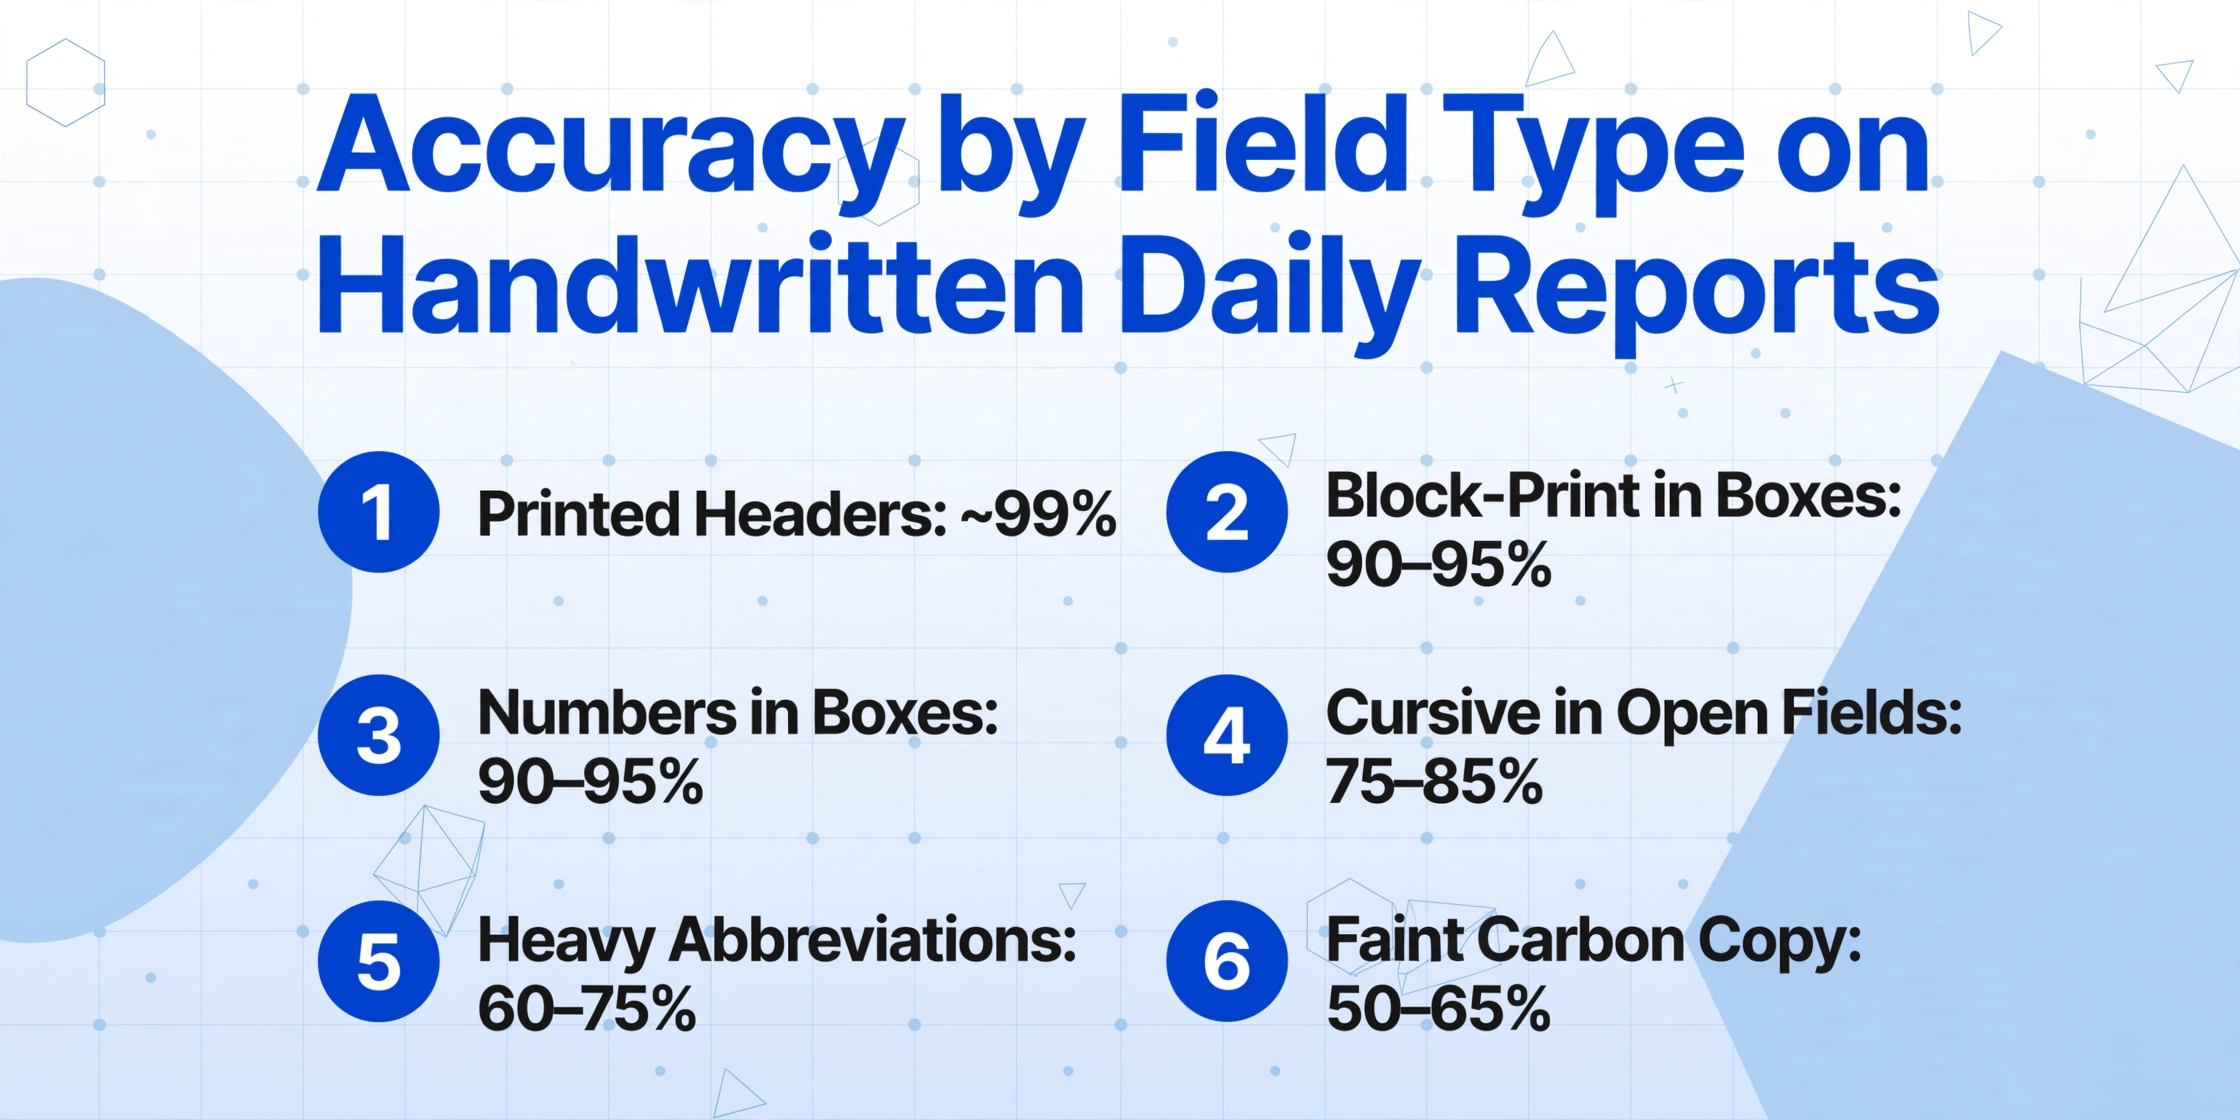
La precisión en informes diarios de obra manuscritos no es un número único. Varía según lo que se extrae y cómo se llenó el informe. Este es el desglose de los tipos de campo comunes que se encuentran en el formulario de informe diario de un supervisor de obra típico:
Precisión de extracción por tipo de campo en informes diarios de obra manuscritos:
Encabezados escritos/impresos + etiquetas preimpresas: ~99% de precisión
Escritura en letra de molde en casillas etiquetadas: 90–95% de precisión
Números en casillas (horas, conteos, temperaturas): 90–95% de precisión
Escritura cursiva o rápida en campos abiertos: 75–85% de precisión
Abreviaturas abundantes o jerga específica del sitio: 60–75% de precisión
Copia carbón desvaída (3.er ejemplar, gastado): 50–65% de precisión
La diferencia entre la precisión del mejor y el peor caso en la misma herramienta es mayor que la diferencia entre herramientas distintas — la calidad de la entrada importa más que la plataforma que usted elija. Un informe diario típico tiene de 15 a 35 campos extraíbles. Con un 85% de precisión, de 2 a 5 campos requieren corrección por informe. La entrada manual toma de 30 a 45 minutos para cinco informes. La extracción con IA seguida de una verificación rápida toma de 3 a 5 minutos. La guía detallada de precisión para registros de obra manuscritos cubre la metodología de prueba detrás de estos rangos.
El cuello de botella pasa de la transcripción a la verificación — y la verificación es un orden de magnitud más rápida.
Por qué los informes diarios de obra son más difíciles que las facturas o los recibos
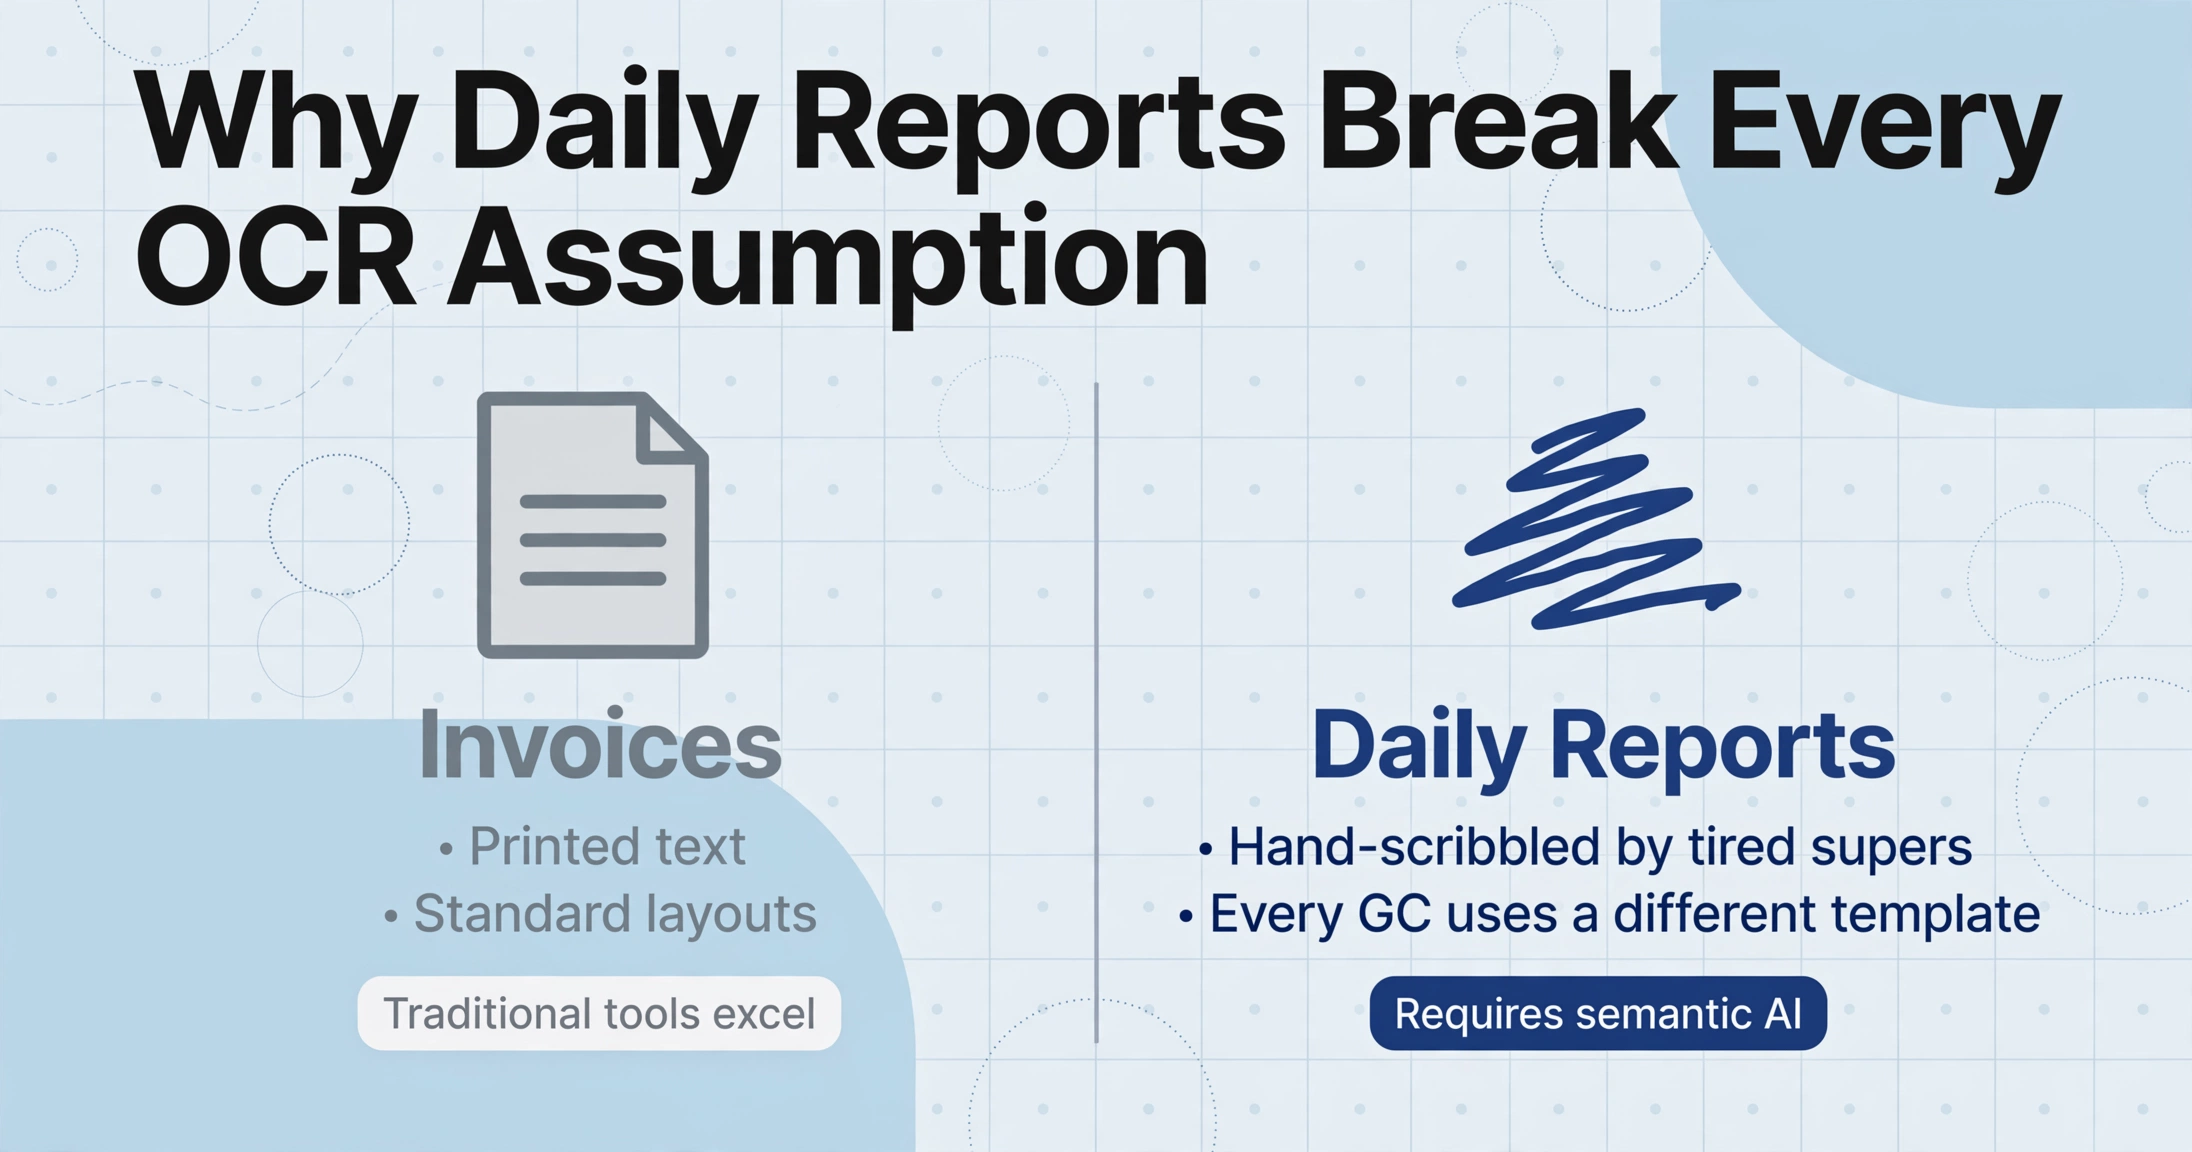
Los puntos de referencia de extracción con IA se construyen típicamente con facturas: texto impreso, diseños estándar, ubicaciones de campos predecibles. Los informes diarios de obra rompen todos esos supuestos.
Tasa de escritura a mano. Un informe diario está completamente garabateado a mano por un superintendente que lo llena en los últimos 20 minutos de un día de 10 horas. El OCR tradicional, que compara formas de caracteres con modelos de fuentes, cae por debajo de la precisión viable en escritura a mano porque esta tiene una variación infinita en grosor de trazo, inclinación y formación de letras.
Estructura de tabla integrada. Una sola página puede contener una tabla de cuadrilla (nombre × horas), una tabla de equipos (ID × horas de funcionamiento), una tabla de materiales (descripción × cantidad) y un registro de visitantes, cada una con su propio diseño de columnas. La IA debe identificar los límites de las tablas y asociar correctamente cada valor escrito a mano con su encabezado de columna.
Diseños de formularios variables. Cada GC y PM usa una plantilla ligeramente diferente: formularios PDF impresos, cuadernos de copia carbón o páginas de cuaderno en blanco donde el superintendente dibuja su propia tabla. Las herramientas basadas en plantillas que requieren configuración por formulario no son viables a escala de múltiples sitios. El análisis más profundo de por qué los informes diarios resisten la digitalización explica cómo estas barreras han mantenido el papel como opción predeterminada durante 15 años. Lo que hace diferente a la IA actual es la lectura semántica: extrae por significado, no por posición.
Lo que la IA lee bien en un informe diario
Varias categorías de campo se extraen consistentemente con alta precisión porque juegan con las fortalezas de los modelos de visión.
Campos numéricos estructurados en casillas etiquetadas. Cuando el formulario tiene una columna claramente etiquetada —"Tamaño de cuadrilla", "Horas trabajadas", "Horas de equipo"— la IA usa la etiqueta para contextualizar el número escrito a mano. Los numerales tienen menos ambigüedad de caracteres que el texto cursivo, por lo que los números en celdas de tabla etiquetadas se extraen de manera confiable al 90–95%.
Casillas de verificación e indicadores binarios. La presencia de incidentes de seguridad, condiciones climáticas y campos de sí/no marcados con marcas de verificación, X o círculos se extraen con una precisión cercana al 100% porque el patrón visual es consistente independientemente del estilo de escritura.
Formularios mixtos impresos y escritos a mano. La IA distingue automáticamente las etiquetas preimpresas de las entradas escritas a mano: sabe que "Nombre del miembro de cuadrilla" es la etiqueta y que "J. Martínez" junto a ella es el valor. El OCR tradicional frecuentemente se equivoca al convertir todo a texto sin entender qué texto es metadato y cuál es dato.
Campos de clima y temperatura. Estos aparecen en casillas dedicadas con vocabulario limitado ("Soleado", "Lluvia", "Nublado"), lo que los hace de alta confianza incluso con escritura descuidada.
Dónde la IA todavía falla con los informes diarios
Una evaluación de capacidades útil señala escenarios específicos donde todavía se requiere revisión humana.
Copias carbón tenues y papel NCR. Cuando la tercera o cuarta copia sin carbón llega a la oficina, la escritura puede ser apenas visible. La precisión de la extracción cae drásticamente cuando el contraste de la imagen baja de un umbral legible — ningún nivel de sofisticación del modelo puede recuperar trazos que no están en la imagen. La solución práctica: fotografiar la copia superior.
Secciones narrativas con mucha escritura cursiva. La sección «Trabajo Completado» suele estar en cursiva conectada con una precisión del 75–85% (escritura clara) que baja al 50–65% (cursiva apretada con abreviaturas). La mitigación: el texto narrativo no necesita extracción estructurada. Captúrelo como un único campo de memo y revíselo en su formato original. Priorice los campos estructurados — horas, conteos, IDs de equipo — para la extracción.
Bocetos y diagramas dibujados a mano. Los bocetos a mano alzada (secciones transversales de zanjas, anotaciones de refuerzo) no se convierten en datos estructurados. Las etiquetas de texto dentro de los bocetos pueden extraerse individualmente, pero las relaciones espaciales se pierden. Trate los bocetos como archivos adjuntos de imagen.
Escritura que cruza los límites de los campos y daño físico del documento. Cuando la escritura se extiende hacia campos adyacentes o márgenes, la IA puede asociar incorrectamente el texto con la columna equivocada. Los daños por agua, los pliegues marcados y las manchas de barro también degradan la extracción en las áreas afectadas. Escanear los informes antes de que salgan del tráiler de obra elimina la mayoría de estos problemas.
En todas las limitaciones el patrón es consistente: la calidad de la extracción sigue a la calidad de la entrada. La mitigación práctica es una mejor foto, tomada antes de que el informe se doble o se dañe.
Cómo obtener los mejores resultados de la extracción con IA en informes diarios
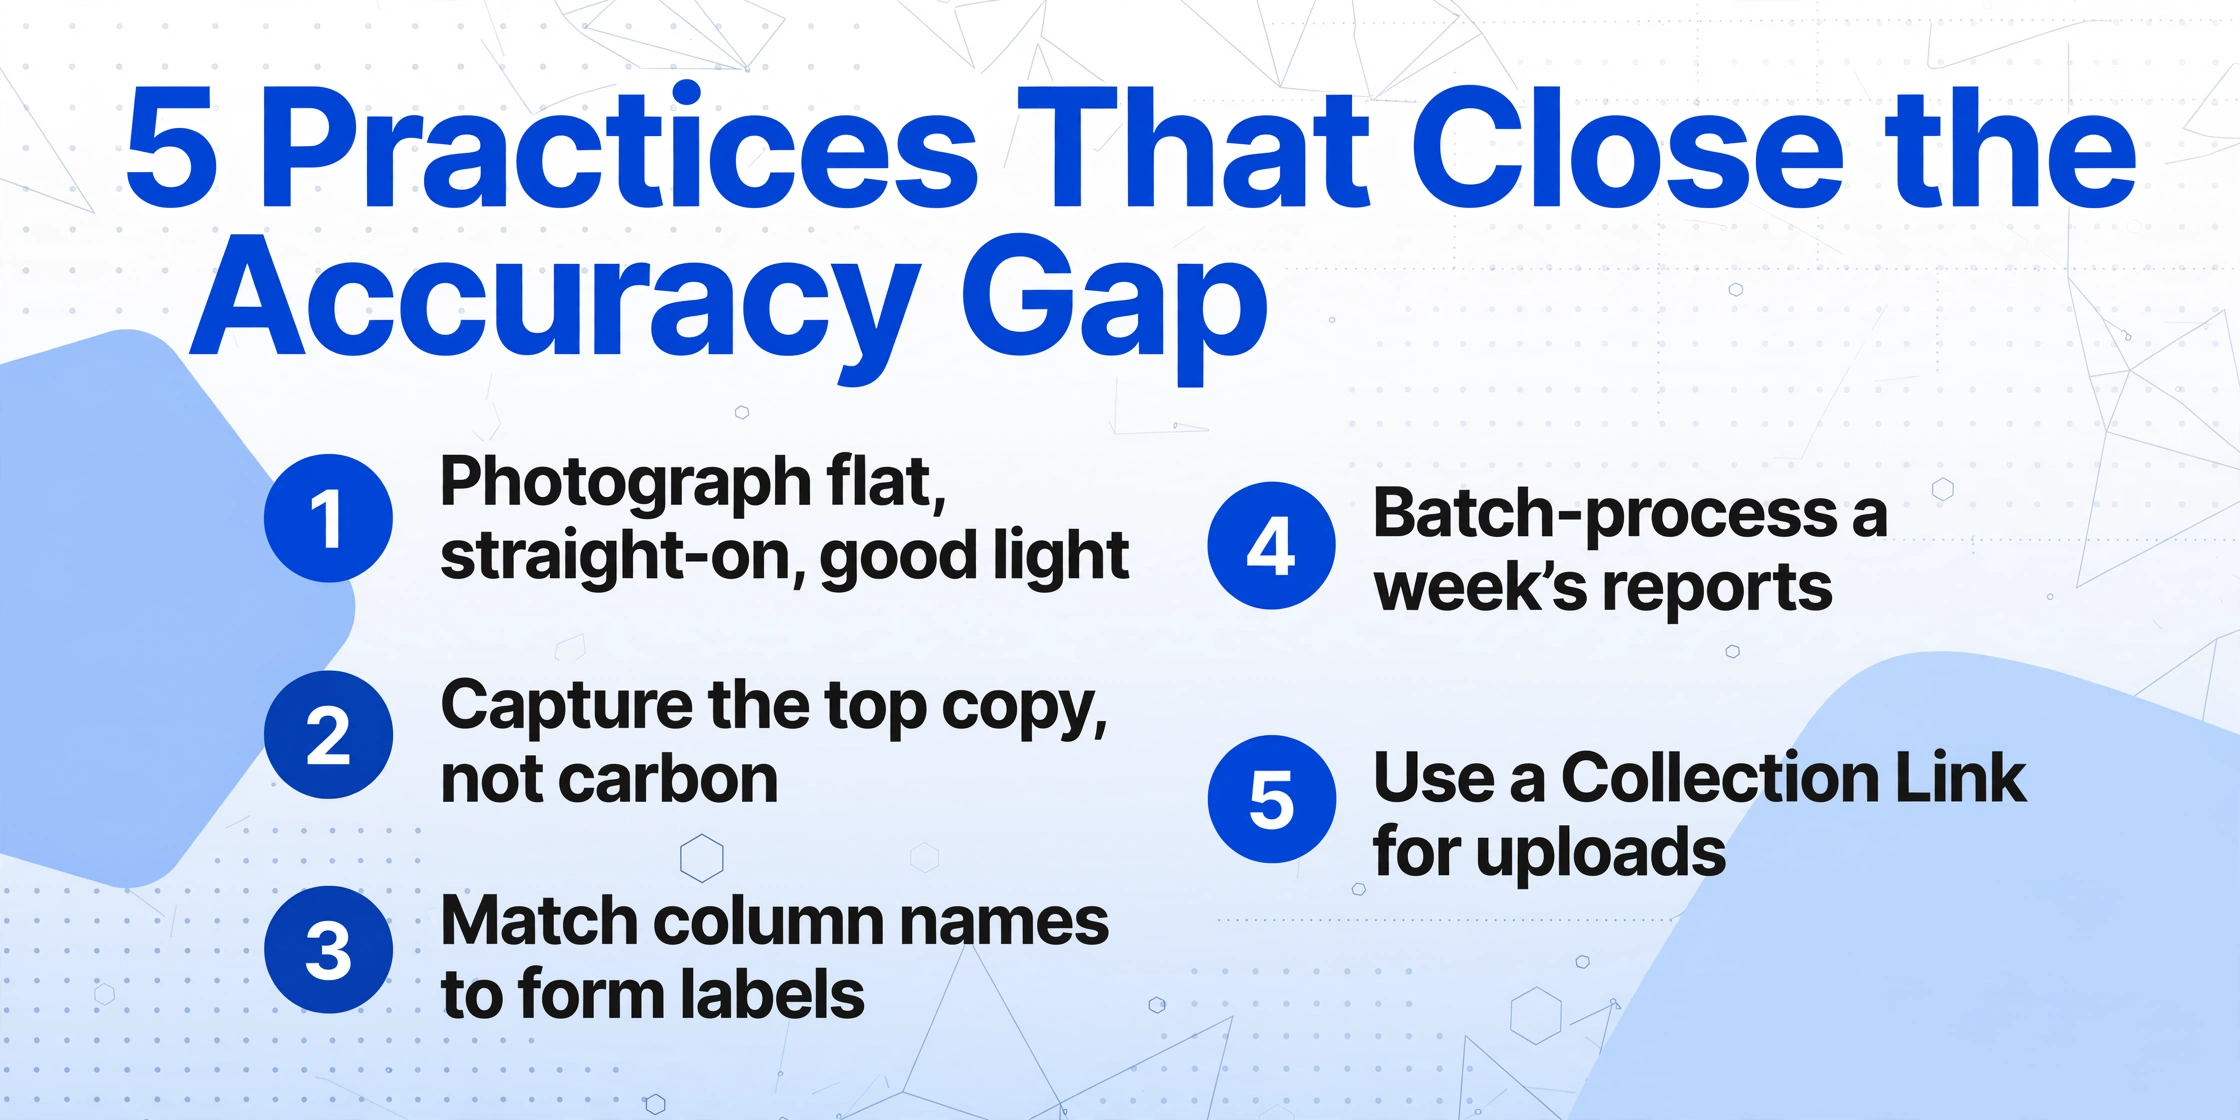
La brecha de precisión entre 65% y 92% en el mismo formulario se debe casi por completo a la preparación y el diseño de campo. Estas cinco prácticas explican la mayor parte de la brecha.
Fotografíe el formulario plano, de frente y con buena luz. Coloque el informe sobre una superficie plana, alinee la cámara en perpendicular a la página y use luz adecuada. Una foto tomada así produce una precisión 15–25 % mayor que una instantánea rápida en ángulo y con poca luz: es la variable de mayor impacto.
Capture la copia superior, no la copia carbón. Fotografíe el original antes de retirar la hoja superior. Cada copia sin carbón posterior tiene menor contraste, y el contraste es el factor de calidad de imagen más importante.
Defina nombres de columna que coincidan con las etiquetas de los campos del formulario. La coincidencia semántica funciona mejor cuando la definición de la columna refleja el texto de la página. Si el formulario dice «Equip #», use «Equip #» como nombre de columna, no «Equipment ID».
Procese por lotes los informes de una semana. El ahorro de tiempo se acumula con el volumen. Procesar 20 informes de cuatro obras ahorra más de dos horas en comparación con la entrada manual. Consulte el flujo de procesamiento por lotes para resúmenes semanales.
Use un Enlace de Recopilación para las cargas de los capataces. Genere un enlace de recopilación que cada superintendente abra desde su teléfono. Ellos fotografían y cargan su propio informe: sin instalación de aplicaciones ni capacitación requerida.
Ejemplo práctico: cómo se ven estos campos en la realidad
Así se comporta un informe diario típico bajo extracción por IA, campo por campo, suponiendo una foto clara de un formulario estándar con anotaciones manuscritas en mayúscula y cursiva:
Resultado esperado de extracción por tipo de campo (foto clara, buena luz):
Fecha del informe (impresa en recuadro): extracción fiable
Clima AM/PM (marca en opciones preimpresas): casi 100%
Nombres de cuadrilla + Horas por oficio (tabla, mayúscula): 90–95%
ID de equipo + Horas de operación (alfanumérico en tabla): 85–90%
Material + Cantidad (escritura mixta): 80–90%
Descripción de incidente de seguridad (relato en cursiva): 70–80%
Relato / Trabajo realizado (párrafo completo en cursiva): 60–75%
La compensación es clara: los datos que alimentan el control de costos y los informes de mano de obra —horas de cuadrilla, conteos, IDs de equipo— se extraen al 85–95% porque son números estructurados en celdas etiquetadas. Las secciones narrativas se extraen con menor precisión, pero eso es aceptable porque se revisan en los documentos originales, no se reescriben en hojas de cálculo. Para un gerente de proyectos que gestiona múltiples obras, el cambio es de más de 100 horas por trimestre de transcripción a 10–15 horas de verificación — y la verificación es donde el criterio del gerente realmente aporta valor.
Preguntas frecuentes
¿Puede la IA leer un informe diario escrito en cursiva?
Sí, con una precisión del 70–85% según la claridad de la escritura. La cursiva apretada con abreviaturas baja al 50–65%. El enfoque práctico: priorizar la extracción de campos estructurados (números, nombres, horas) y tratar las secciones narrativas como campos de memorándum para revisión humana.
¿La IA necesita una configuración diferente para cada formato de informe diario?
No. La extracción por columna personalizada lee los campos por significado semántico, no por posición — así que las mismas definiciones de columna funcionan en distintos diseños de formulario. Ya sea que la tabla de cuadrilla se llame "Personal" o "Mano de obra", la IA encuentra los datos correctos. La guía del gerente de proyectos de construcción para extracción de documentos cubre esto en detalle.
¿Qué pasa si la letra es ilegible incluso para otra persona?
Si un humano no puede leerlo, la IA tampoco. La extracción aporta valor en el 80–90% de los informes que sí pueden leerse. Para entradas realmente ilegibles, la solución son formularios preimpresos con campos etiquetados que guíen a quien escribe, no una mejor IA.
¿Los datos extraídos pueden integrarse en Procore o Sage?
Sí: la extracción genera archivos XLSX, CSV o JSON que pueden importarse en plataformas que admitan importación de datos. Es una transferencia mediante archivos, no una integración por API en vivo, pero los datos llegan estructurados y verificados, por lo que la importación es solo subir un archivo, no volver a tipear.
¿Cómo se compara esto con aplicaciones como Raken o Fieldwire?
Resuelven problemas distintos. Las apps reemplazan el papel en el punto de creación — el capataz escribe en una app. La extracción por IA a partir de fotos digitaliza informes en papel existentes sin pedirle a nadie que cambie su forma de trabajar. Son enfoques complementarios: algunos equipos usan app, otros papel, y la capa de extracción procesa lo que llegue.
¿Cuál es la mejora de precisión más impactante que puedo lograr?
Fotografiar el informe plano, de frente y con buena luz. La diferencia de precisión entre una foto inclinada con poca luz y una foto adecuada es de 15 a 25 puntos porcentuales — más que cualquier mejora de herramienta. La guía de precisión para registros de obra manuscritos incluye una lista de verificación de calidad fotográfica que los equipos pueden colocar en las casetas de obra.
Mira Tus Informes Diarios Convertidos en Datos
Sube un informe diario manuscrito — cualquier formato, cualquier letra — y ve lo que un modelo de IA de visión extrae en menos de 10 segundos. Sin registro.
Sube un Informe Manuscrito →