L'IA peut-elle lire les rapports quotidiens
de chantier ? Oui, voici ce qui fonctionne et ce qui ne fonctionne pas
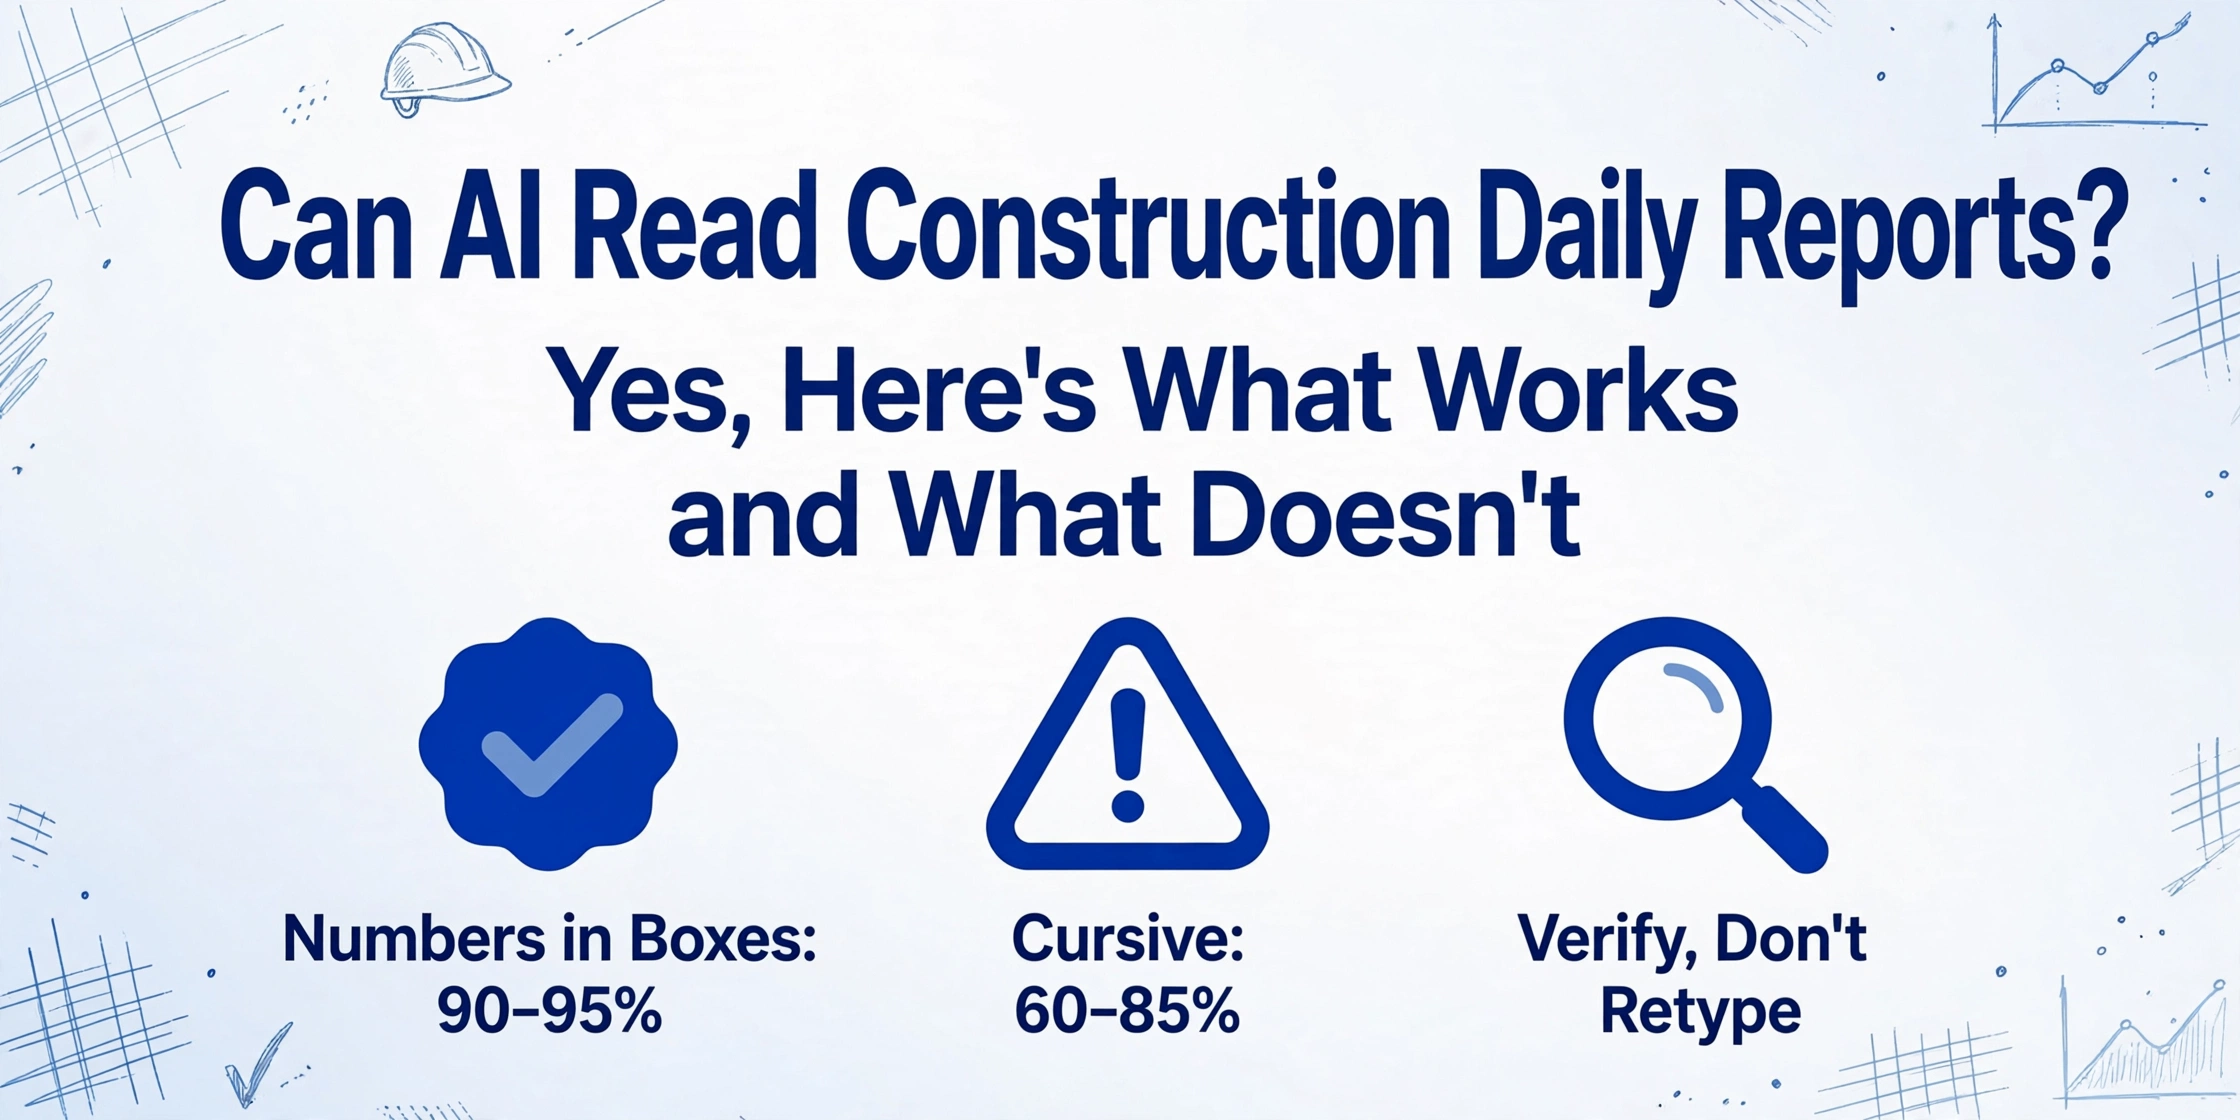
Oui. L'IA de vision moderne extrait les effectifs, les heures par corps de métier, les identifiants d'équipement, les livraisons de matériaux et les incidents de sécurité des rapports quotidiens de chantier manuscrits — mais la précision dépend fortement de la lisibilité de l'écriture et de la qualité de la photo. Sur une photo nette d'un formulaire bien rempli, la précision au niveau des champs varie de 90 à 95 % pour une écriture script à 75 à 85 % pour une écriture cursive. Mais les rapports quotidiens présentent un double défi que les factures et les reçus n'ont pas : un taux de manuscrit proche de 100 % combiné à des structures de tableaux intégrées et des formats de formulaires variables.
Points clés à retenir
- 20 minutes de ressaisie des noms d'équipe et des heures d'équipement se réduisent à 3 minutes de vérification ponctuelle — à partir de la même photo de rapport quotidien.
- Une photo plate, prise de face et bien éclairée produit une précision d'extraction supérieure de 15 à 25 % par rapport à une photo rapide en angle, et cet écart est plus important que toute mise à niveau d'outil.
- Lorsque le goulot d'étranglement passe de la transcription à la vérification, les PM font ce pour quoi ils ont été embauchés : repérer les anomalies dans les coûts de main-d'œuvre, plutôt que de ressaisir les listes d'équipe.
Dans quelle mesure l'IA lit-elle un rapport quotidien de chantier ?
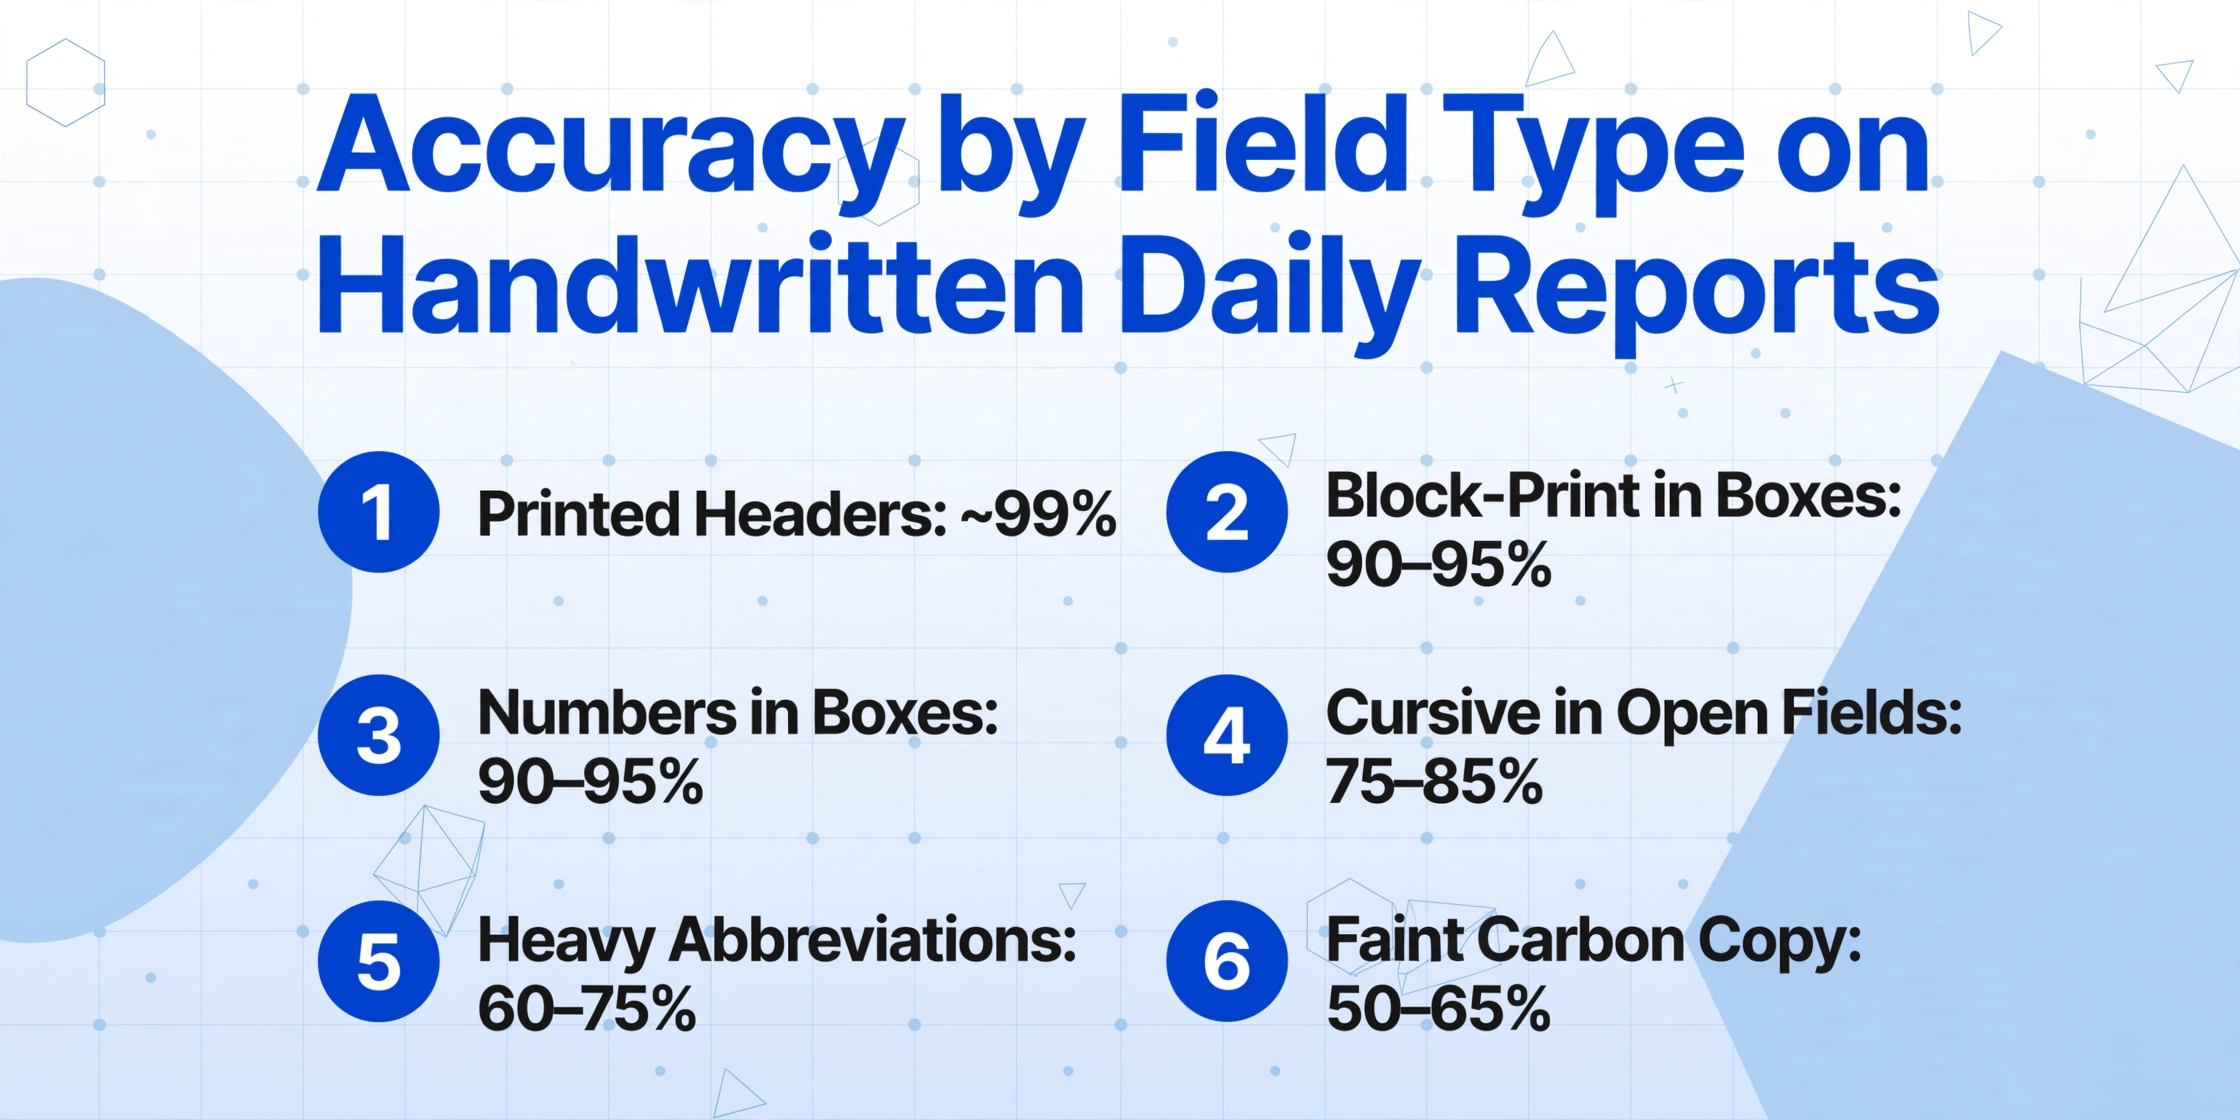
La précision sur les rapports quotidiens de chantier manuscrits n'est pas un chiffre unique. Elle varie selon ce que vous extrayez et la façon dont le rapport a été rempli. Voici la répartition par type de champ courant sur le formulaire de rapport quotidien d'un superviseur de site typique :
Précision d'extraction par type de champ sur les rapports quotidiens de chantier manuscrits :
En-têtes tapés/imprimés + étiquettes pré-imprimées : ~99 % de précision
Écriture en lettres capitales dans des cases étiquetées : 90–95 % de précision
Chiffres dans des cases (heures, compteurs, températures) : 90–95 % de précision
Écriture cursive ou rapide dans des champs ouverts : 75–85 % de précision
Abréviations fréquentes ou jargon spécifique au site : 60–75 % de précision
Copie carbone pâle (3e feuille, usée) : 50–65 % de précision
L'écart entre la précision optimale et la précision minimale sur le même outil est plus grand que l'écart entre différents outils — la qualité de la saisie importe plus que la plateforme choisie. Un rapport quotidien typique contient de 15 à 35 champs extractibles. À 85 % de précision, 2 à 5 champs nécessitent une correction par rapport. La saisie manuelle prend 30 à 45 minutes pour cinq rapports. L'extraction IA suivie d'une vérification ponctuelle prend 3 à 5 minutes. Le guide détaillé de précision pour les journaux de site manuscrits couvre la méthodologie de test derrière ces fourchettes.
Le goulot d'étranglement passe de la transcription à la vérification — et la vérification est d'un ordre de grandeur plus rapide.
Pourquoi les rapports quotidiens de chantier sont plus difficiles à traiter que les factures ou les reçus
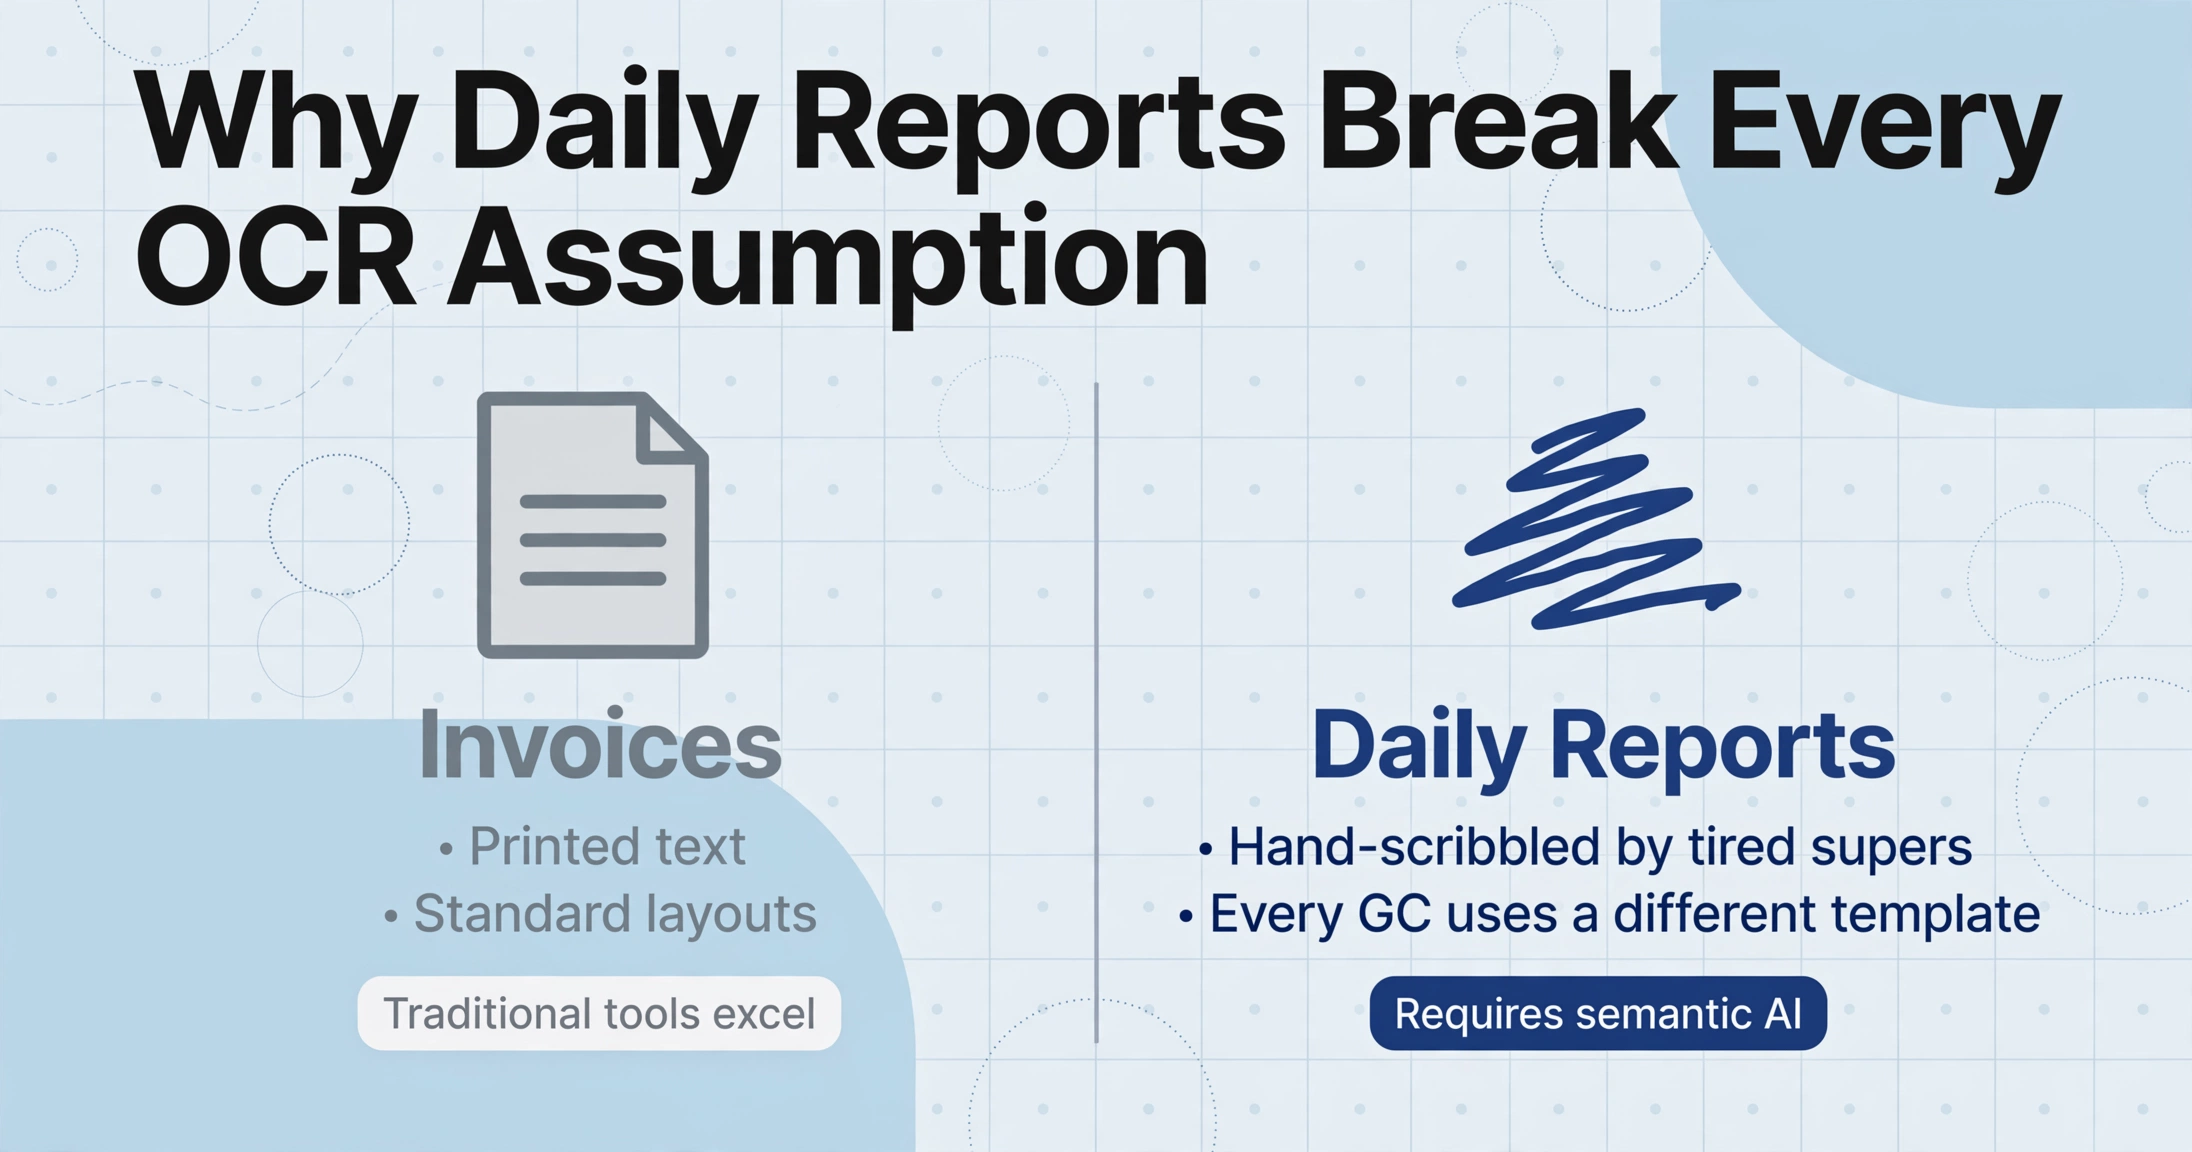
Les référentiels d'extraction par IA sont généralement basés sur des factures — texte imprimé, mises en page standard, emplacements de champs prévisibles. Les rapports quotidiens de chantier brisent toutes ces hypothèses.
Taux de manuscrit. Un rapport quotidien est entièrement rédigé à la main par un superviseur qui le remplit dans les 20 dernières minutes d'une journée de 10 heures. L'OCR traditionnel, qui compare les formes des caractères aux modèles de polices, tombe sous le seuil de précision viable sur l'écriture manuscrite, car celle-ci présente une variation infinie dans l'épaisseur des traits, l'inclinaison et la formation des lettres.
Structure de tableau intégrée. Une seule page peut contenir un tableau d'équipe (nom × heures), un tableau d'équipement (ID × heures de fonctionnement), un tableau de matériaux (description × quantité) et un registre des visiteurs — chacun avec sa propre disposition de colonnes. L'IA doit identifier les limites des tableaux et associer correctement chaque valeur manuscrite à son en-tête de colonne.
Mises en page de formulaires variables. Chaque GC et chaque chef de projet utilise un modèle légèrement différent — formulaires PDF imprimés, carnets à papier carbone ou pages de cahier vierges où le superviseur dessine son propre tableau. Les outils basés sur des modèles nécessitant une configuration par formulaire ne sont pas viables à l'échelle multi-sites. L'analyse approfondie des raisons pour lesquelles les rapports quotidiens résistent à la numérisation explique comment ces obstacles ont maintenu le papier comme option par défaut pendant 15 ans. Ce qui distingue l'IA actuelle, c'est la lecture sémantique — elle extrait par le sens, non par la position.
Ce que l'IA lit bien sur un rapport quotidien
Plusieurs catégories de terrain sont extraites de manière constante avec une grande précision, car elles exploitent les points forts des modèles de vision.
Champs numériques structurés dans des cases étiquetées. Lorsque le formulaire comporte une colonne clairement étiquetée — « Taille de l'équipe », « Heures travaillées », « Heures d'équipement » — l'IA utilise l'étiquette pour contextualiser le nombre manuscrit. Les chiffres présentent moins d'ambiguïté de caractères que le texte cursif, de sorte que les nombres dans les cellules de tableau étiquetées sont extraits de manière fiable à 90–95 %.
Cases à cocher et indicateurs binaires. La présence d'incidents de sécurité, les conditions météorologiques et les champs O/N marqués par des coches, des croix ou des cercles sont extraits avec une précision proche de 100 %, car le motif visuel est cohérent quel que soit le style d'écriture.
Formulaires mixtes imprimés et manuscrits. L'IA distingue automatiquement les étiquettes pré-imprimées des entrées manuscrites — elle sait que « Nom du membre de l'équipe » est l'étiquette et que « J. Martinez » à côté est la valeur. L'OCR traditionnel se trompe fréquemment en convertissant tout en texte sans comprendre quel texte est une métadonnée et lequel est une donnée.
Champs météo et température. Ceux-ci apparaissent dans des cases dédiées avec un vocabulaire restreint (« Ensoleillé », « Pluie », « Nuageux »), ce qui les rend très fiables même avec une écriture peu soignée.
Là où l'IA rencontre encore des difficultés avec les rapports quotidiens
Une évaluation utile des capacités identifie des scénarios précis où une vérification humaine reste nécessaire.
Copies carbone pâles et papier NCR. Lorsque la troisième ou quatrième copie sans carbone arrive au bureau, l'écriture manuscrite peut être à peine visible. La précision de l'extraction chute fortement lorsque le contraste de l'image tombe sous un seuil lisible — aucune sophistication du modèle ne peut récupérer des traits qui ne sont pas dans l'image. La solution pratique : photographier la copie originale.
Sections narratives très cursives. La section « Travaux terminés » est généralement une cursive liée avec une précision de 75 à 85 % (écriture claire), qui tombe à 50–65 % (cursive serrée avec abréviations). L'atténuation : le texte narratif n'a pas besoin d'une extraction structurée. Capturez-le comme un champ mémo unique et examinez-le sous sa forme brute. Priorisez les champs structurés — heures, quantités, identifiants d'équipement — pour l'extraction.
Croquis et schémas dessinés à la main. Les croquis à main levée (coupes de tranchées, annotations sur les armatures) ne sont pas convertis en données structurées. Les étiquettes de texte dans les croquis peuvent être extraites individuellement, mais les relations spatiales sont perdues. Traitez les croquis comme des pièces jointes image.
Écriture qui dépasse les limites des champs et dommages physiques du document. Lorsque l'écriture s'étend dans les champs adjacents ou les marges, l'IA peut associer le texte à la mauvaise colonne. Les dégâts d'eau, les pliures marquées et les taches de boue dégradent également l'extraction dans les zones concernées. Pré-numériser les rapports avant qu'ils ne quittent la remorque du chantier élimine la plupart de ces problèmes.
À travers toutes les limitations, le schéma est cohérent : la qualité de l'extraction suit la qualité de l'entrée. L'atténuation pratique est une meilleure photo, prise avant que le rapport ne soit plié ou endommagé.
Comment obtenir les meilleurs résultats de l'extraction IA sur les rapports quotidiens
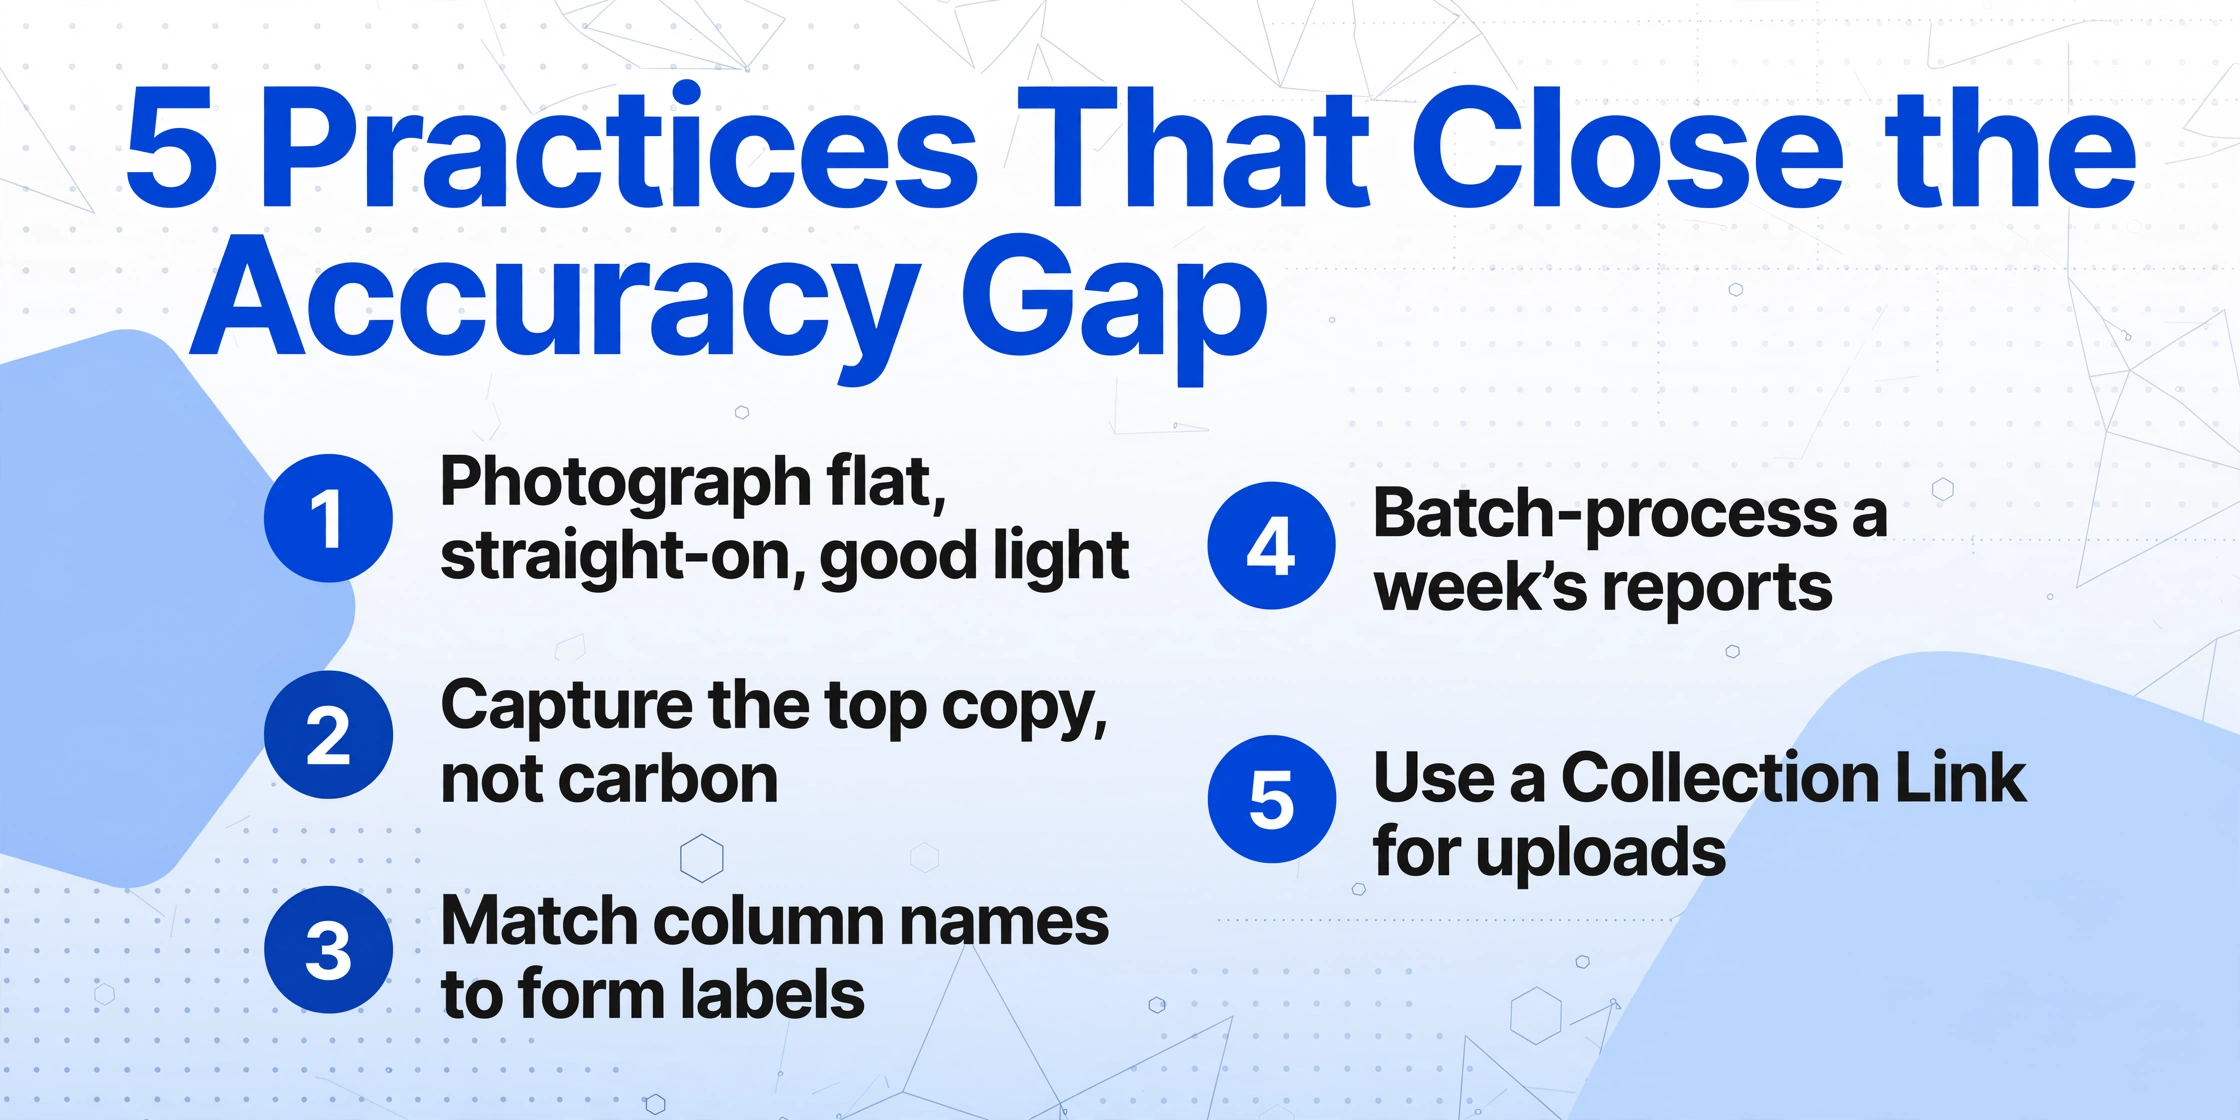
L'écart de précision entre 65 % et 92 % sur le même formulaire est presque entièrement lié à la préparation et à la conception du terrain. Ces cinq pratiques expliquent l'essentiel de cet écart.
Photographiez le formulaire à plat, de face, avec un bon éclairage. Posez le rapport à plat, alignez la caméra perpendiculairement à la page et utilisez un éclairage adéquat. Une photo prise ainsi produit une précision supérieure de 15 à 25 % par rapport à un instantané rapide pris en angle et en faible luminosité — c'est la variable la plus déterminante.
Photographiez l'original, pas la copie carbone. Photographiez l'original avant de retirer la première feuille. Chaque copie sans carbone successive présente un contraste plus faible — et le contraste est le facteur de qualité d'image le plus important.
Définissez des noms de colonnes qui correspondent aux libellés des champs du formulaire. La correspondance sémantique fonctionne mieux lorsque la définition de colonne reflète la formulation de la page. Si le formulaire indique « Équip. n° », utilisez « Équip. n° » comme nom de colonne — pas « Identifiant de l'équipement ».
TRAITEMENT PAR LOTS : traitez une semaine de rapports en une seule fois. Le gain de temps augmente avec le volume. Le traitement de 20 rapports provenant de quatre chantiers permet d'économiser plus de deux heures par rapport à la saisie manuelle. Voir le flux de traitement par lots pour les synthèses hebdomadaires.
Utilisez un lien de collecte pour les envois des chefs de chantier. Générez un lien de collecte partageable que chaque surintendant ouvre depuis son téléphone. Ils photographient et envoient leur propre rapport — aucune installation d'application, aucune formation requise.
Exemple concret : à quoi ressemblent ces champs en pratique
Voici comment un rapport journalier type se comporte sous extraction IA, champ par champ, en supposant une photo nette d'un formulaire standard avec des écritures manuscrites mêlant script et cursive :
Résultat d'extraction attendu par type de champ (photo nette, bonne luminosité) :
Date du rapport (imprimée dans un cadre) : extraite de manière fiable
Météo AM/PM (case à cocher sur options pré-imprimées) : quasi 100 %
Noms des équipes + Heures par corps de métier (tableau, écriture script) : 90–95 %
ID équipement + Heures de fonctionnement (alphanumérique dans tableau) : 85–90 %
Matériaux + Quantités (écriture manuscrite mixte) : 80–90 %
Description d'incident de sécurité (récit en cursive) : 70–80 %
Récit / Travaux effectués (paragraphe entier en cursive) : 60–75 %
Le compromis est clair : les données qui alimentent le suivi des coûts et les rapports de main-d'œuvre — heures d'équipe, quantités, ID d'équipement — sont extraites à 85–95 % car ce sont des nombres structurés dans des cellules étiquetées. Les sections narratives sont extraites avec une précision moindre, mais c'est acceptable car elles sont relues dans les documents originaux, pas ressaisies dans des tableurs. Pour un chef de projet gérant plusieurs chantiers, on passe de 100+ heures par trimestre de saisie à 10–15 heures de vérification — et la vérification est là où le jugement d'un chef de projet apporte une réelle valeur ajoutée.
FAQ
L'IA peut-elle lire un rapport journalier écrit en cursive ?
Oui, avec une précision de 70 à 85 % selon la clarté de l'écriture. Une cursive serrée avec des abréviations descend à 50–65 %. L'approche pratique : prioriser les champs structurés (nombres, noms, heures) pour l'extraction et traiter les sections narratives comme des champs de notes à relire humainement.
L'IA nécessite-t-elle une configuration différente pour chaque format de rapport journalier ?
Non. L'extraction par colonne personnalisée lit les champs par sens sémantique, pas par position — les mêmes définitions de colonne fonctionnent donc sur différentes mises en page de formulaires. Que le tableau d'équipe soit intitulé « Personnel » ou « Effectifs », l'IA trouve les bonnes données. Le guide du chef de projet BTP pour l'extraction de documents aborde ce sujet en détail.
Et si l'écriture est illisible même pour un humain ?
Si un humain ne peut pas la lire, l'IA non plus. L'extraction apporte de la valeur sur les 80 à 90 % des rapports qui sont lisibles. Pour les écritures vraiment illisibles, la solution réside dans des formulaires pré-imprimés avec des champs étiquetés qui guident le rédacteur — pas dans une meilleure IA.
Les données extraites peuvent-elles alimenter Procore ou Sage ?
Oui — l'extraction produit des fichiers XLSX, CSV ou JSON importables dans les plateformes qui acceptent les imports de données. Il s'agit d'un transfert par fichier, pas d'une intégration API en direct, mais les données arrivent structurées et vérifiées, donc l'import se résume à un téléchargement de fichier plutôt qu'à une resaisie.
En quoi cela se compare-t-il aux applications de reporting comme Raken ou Fieldwire ?
Elles résolvent des problèmes différents. Les applications remplacent le papier au moment de la création — le chef d'équipe saisit dans une app. L'extraction par IA à partir de photos numérise les documents papier existants sans demander à personne de changer ses habitudes. Les approches sont complémentaires : certaines équipes utilisent une app, d'autres le papier, et la couche d'extraction traite ce qui arrive.
Quelle est l'amélioration de précision la plus impactante que je puisse apporter ?
Photographiez le rapport à plat, de face, avec un bon éclairage. L'écart de précision entre une photo prise en contre-jour et une photo correcte est de 15 à 25 points de pourcentage — plus important que toute mise à niveau d'outil. Le guide de précision des journaux de chantier manuscrits inclut une checklist de qualité photo que les équipes peuvent afficher dans les baraquements de chantier.
Voyez vos rapports quotidiens transformés en données
Téléchargez un rapport quotidien manuscrit — n'importe quel format, n'importe quelle écriture — et voyez ce qu'un modèle d'IA de vision extrait en moins de 10 secondes. Sans inscription.
Télécharger un rapport manuscrit →