月末の領収書の山
簿記士が手入力データ入力を排除する方法
r/Bookkeepingの簿記士が、毎月合計5万ドル以上を支出する6人のマネージャーを担当しながら月末の現実をこう語っています:「毎月、経費をスプレッドシートに整理・スキャン・入力するのに文字通り何日も費やしています。」その数日間に平均的な簿記士の実効レートを掛けると、その一文は毎月4,500ドルの利益損失になります。ここでは、その計算、規制の背景、そして請求方法やクライアントの行動を変えずに手作業の山を排除するワークフローをご紹介します。
重要なポイント
- 月60時間の領収書データ入力は、30クライアントの事務所で時給75ドル換算すると年間54,000ドルを消費し、付加価値ゼロの作業です。
- 既存の領収書自動化ツールはクライアント数に応じて作業量が増加します:30クライアントなら30セットの仕入先ルールとカテゴリマッピングの設定・保守が必要で、このセットアップ負担は増え続けます。
- スプレッドシートの列を入力し、クライアントの1ヶ月分の領収書40枚を1つのバッチでアップロードすれば、ImageToTable.aiが列名に基づいてすべてのフィールドを自動入力します。クライアントごとの設定は不要で、すべての値はホバーするだけで領収書上の該当箇所を確認できます。
月末の領収書の山が実際にあなたの事務所に与えるコスト
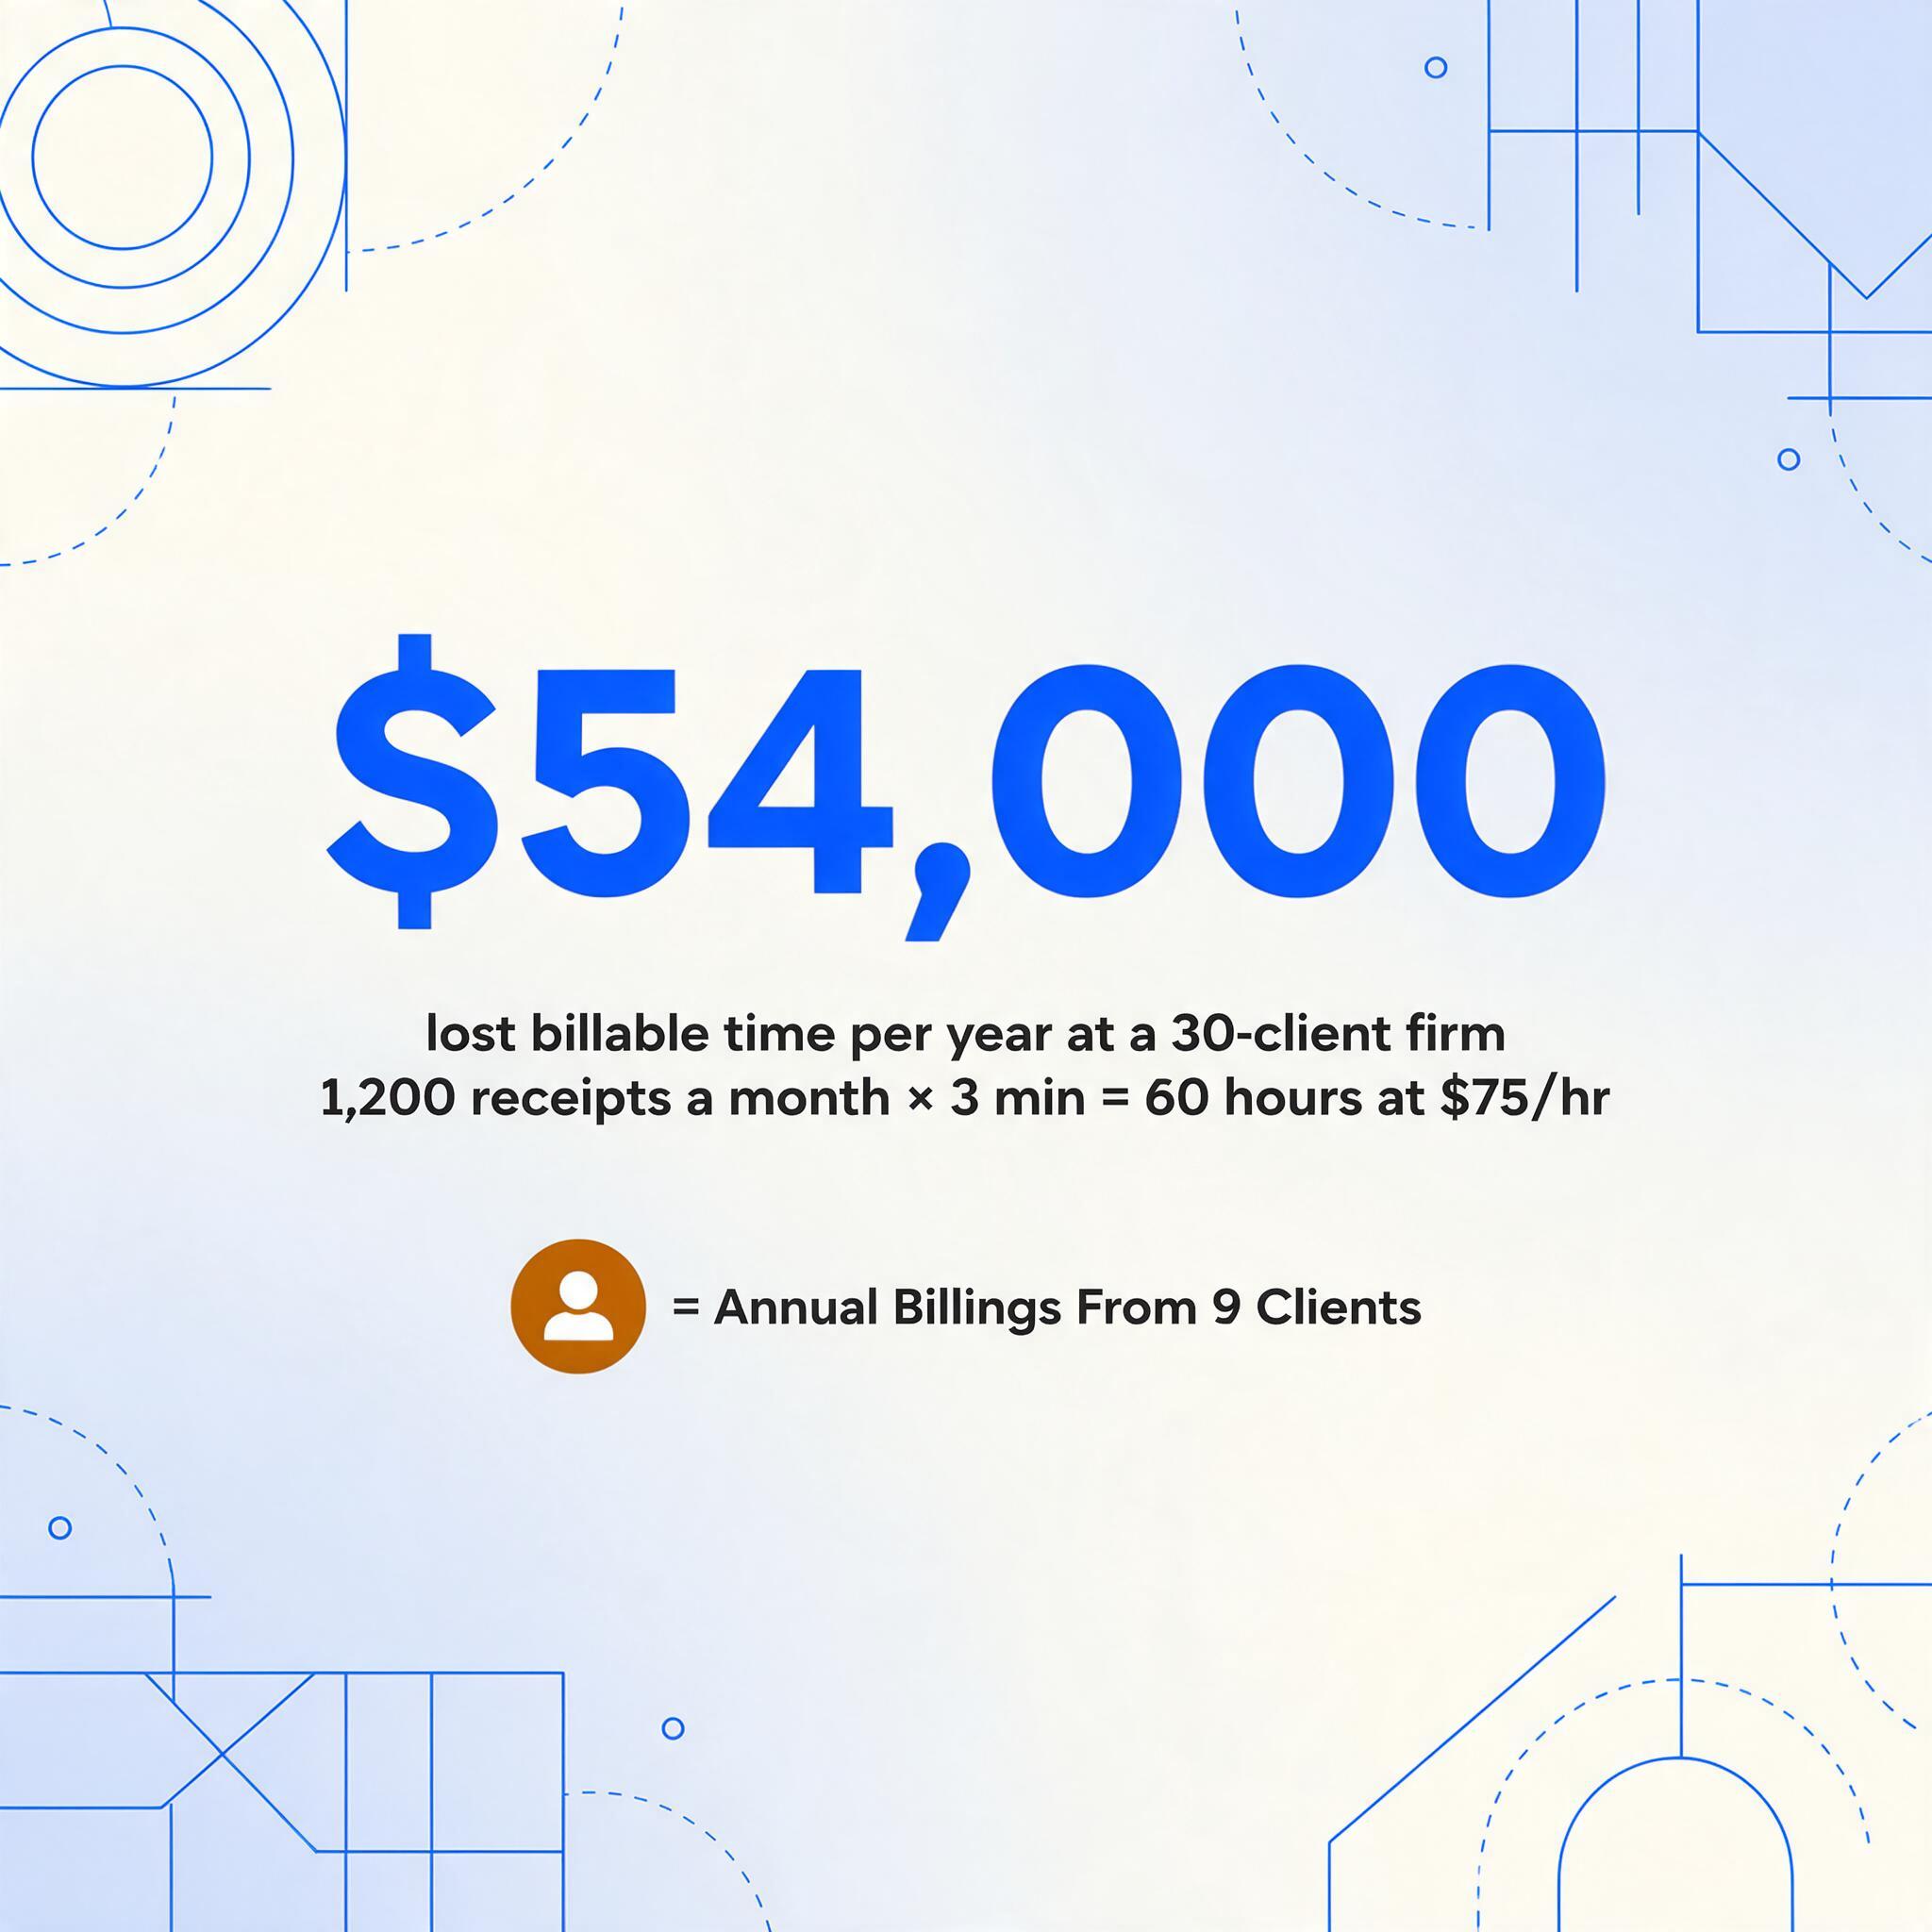
簿記士の領収書整理にかかる事務所の経済性は、ほとんどの人が認識している以上に深刻です。個々の作業自体は簡単です。問題は、それがクライアント全体に累積していくことであり、固定料金の請求では決して考慮されないという点です。中規模の標準的な実務で計算してみましょう。30の小規模ビジネスクライアントが、それぞれ月に約40枚の領収書を提出します。紙のもの、メール添付のもの、現場からテキスト送信された写真など様々です。各領収書から仕入先名、日付、小計、税額内訳、合計金額を特定するのに3分かかります。それが1,200枚。1枚3分で60時間。実効レート$75/時間で計算すると、月に$4,500の利益損失、年間では$54,000になります。
しかし、損失は入力に費やした時間だけではありません。それらの時間の機会費用も損失です。月60時間は、$500/月のクライアントをさらに4〜5社担当できる能力に相当し、データ入力に時間を取られるために獲得できない請求可能収益は約$24,000〜30,000になります。30クライアントに月$15,000を請求する固定料金の事務所は、戦略的価値がゼロの作業によって、潜在的な利益率の30%を失っている可能性があります。
30クライアントの事務所の計算: 月1,200枚の領収書×1枚3分=60時間=$75/時間で$4,500の請求可能時間の損失。年間では$54,000、これは$500/月のクライアント9社分の年間請求額に相当します。
これは仮定の話ではありません。6人のマネージャーを統括していたr/Bookkeepingの投稿者は、ソフトウェアの価格について不満を言っていたわけではありません。彼らが求めていたのは、仕入先名、日付、小計、税額内訳、合計金額を抽出できる、シンプルで安価なもの。不要な機能は一切ありませんでした。承認ワークフローやポリシー施行、クライアントが使わないモバイルアプリは必要なかったのです。彼らが必要だったのは、領収書を読み取ってスプレッドシートに入力してくれるツールでした。5つの指定フィールドだけで余計なものがないという、その具体的なリクエストは注目に値します。なぜなら、それはほぼすべての固定料金の簿記事務所に共通する中核的なニーズを表しているからです。
より深い洞察は、領収書のデータ入力が、あなたが構築できる事務所の種類を決定づけるということです。月60時間を領収書処理に費やしていると、キャパシティに制約が生じます。人を雇わずにクライアントを増やすことはできず、雇うとコスト構造が変わってしまいます。その前に根本的な非効率性を解決しなければなりません。これが固定料金の収益性の罠です。パッケージ価格は紙の上では健全に見えても、実際に消費する時間で割ると問題が見えてきます。(事務所規模別の手動データ入力の全コストについては、別途分析で詳しく解説しています。)
なぜ顧客の領収書処理は自社のものより難しいのか
これまで自分の領収書だけを処理してきたなら、規模の問題は単純に見えるでしょう。領収書が増えれば、時間も増える。しかし簿記士は構造的な倍率に直面しています。それが、顧客の領収書処理を自分のものより根本的に難しくしているのです。顧客ごとにドキュメントの世界が異なるからです。 ベンダーも、領収書の形式も、提出の習慣も、勘定科目体系も、分類ルールもすべて異なります。1人の顧客の領収書を40枚処理するのは、1つの認知的コンテキストです。30人の顧客それぞれの領収書を40枚ずつ処理するのは、30の認知的コンテキストであり、その切り替えコストこそが、精神的疲労の大部分が生まれる場所です。
3人の顧客が同じ日に月末の書類の山を提出した場合を考えてみましょう。顧客Aは造園業を営んでいます。領収書はHome Depot、SiteOne、地元のナーセリーからのもので、燃料費の領収書や手書きの下請け業者の請求書が混ざっています。顧客Bはコンサルタントで、ほとんどがデジタルです。Uberの領収書、顧客との夕食のレストラン領収書、事務用品のAmazon請求書、オンライン決済のスクリーンショット。顧客Cは小規模小売店です。明細項目のある仕入先請求書、配送領収書、公共料金の請求書、POSシステムの日次サマリー。それぞれの山を処理するには、その顧客の世界に精神的に切り替える必要があります。典型的なベンダーはどのようなものか、経費をどのように分類するか、どの勘定コードが適用されるか、どの領収書に税の按分がありそうか。
ほとんどの領収書整理AIツールは単一事業体での使用を想定して設計されています。従業員が自分の経費をスキャンする、または個人事業主が自分の控除を追跡する、といった用途です。簿記の領収書自動化で最もよく知られた2つの名前であるDextとHubdocは、フォーマットの問題を部分的に解決します。どちらも機械学習を使用して、領収書のレイアウトに関係なく、ベンダー、日付、合計などの一般的なフィールドを識別します。Dextの項目抽出とHubdocのフィールド抽出は、ヘッダーレベルのデータを合理的に処理し、ベンダー名、日付、請求書番号、合計金額をカバーします。しかし、複数の顧客を管理する簿記士にとって特に重要な2つのギャップを共有しています。
明細項目のギャップ。 Home Depotの領収書には合計金額だけでなく、SKU番号、数量、単価、および異なる経費勘定に割り当てる必要があるサブカテゴリを持つ5〜15の明細項目があります。Dextは99%以上のOCR精度を宣伝し、HubdocはXeroで無料の抽出を提供していますが、どちらも小売店の領収書から明細項目の詳細を確実に取得することはできません。つまり、「自動化された」抽出の後でも、誰か(依然としてあなた)が明細項目を仕訳に手入力していることになります。ツールはベンダー名と合計金額を入力する手間を省いてくれました。しかし、照合作業からは解放してくれません。
顧客設定の負担。 Dextの顧客接続には毎回設定が必要です。仕入先ルール、カテゴリマッピング、公開先。顧客が30人いれば、設定も30回です。顧客の勘定科目体系が変わると(中小企業は帳簿を再編成するため、これはよく起こります)、マッピングを更新します。Xeroで無料で利用でき、現在はXero内でSmart Document Captureとして表示されるHubdocは、よりシンプルですが、ヘッダーフィールドで止まります。Xeroの抽出ドキュメントには、仕入先、日付、請求書番号、合計が記載されており、明細項目テーブルはありません。顧客ごとの設定コストは現実のものであり、簿記士が自動化ツールは「機能する」が、規模が大きくなると「元が取れない」と言う理由の1つです。
3つ目の痛点はクライアントの提出行動です。Dextのモバイルアプリは、事業主がその場で領収書を撮影することを想定して設計されているため、理論上は簿記士が領収書に触れることはありません。しかし実際には、クライアントはアプリを使いません。忘れてしまうのです。インストールしないのです。代わりに写真をメールで送ってきたり、机の上に紙の封筒を置いていったりします。Dextは結果ではなくプランと文書数で価格設定されています。公表されているビジネスプランは250文書・5ユーザーで月額約$30から、ファームプランは約10クライアント口座で月額$200前後から始まり、クライアントを追加するごとに上がっていきます。このコストはクライアントが自動化に参加することを前提としており、多くのクライアントが参加しない場合、ツールにお金を払いながら手作業での入力も続けることになります。これが、ほとんどすべての簿記自動化の提案が見落としているクライアント導入の失敗です。クライアントへのトレーニングを必要としない提出問題の解決策については、この問題を完全に回避するコレクションリンクワークフローをご覧ください。
特に frustrating なのは、データ抽出自体がもはやボトルネックではないことです。AIは十分な能力を持っています。ボトルネックは、AIが抽出する内容とあなたの仕訳作成シートが期待する形式の間にあります。ベンダー、日付、合計額を抽出しても、使っていない税務報告ダッシュボードにエクスポートするだけでは、ステップを増やすだけで減らすことはできません。出力は、あなたのワークフローが引き継ぐ場所、つまりスプレッドシートの列見出しの下、あなたの順序に正確に収まる必要があります。(領収書の形式の多様性がテンプレートベースの抽出を特に困難にする理由の詳細については、領収書の形式の不整合がテンプレートOCRを弱体化させる仕組みをご覧ください)
IRS Publication 583がデジタル領収書について実際に述べていること
IRS Publication 583はペーパーレス問題に直接回答しています:「ハードコピーの帳簿記録に適用されるすべての要件は、電子保存システムにも適用されます。」 規制はさらに「電子保存システムがテストされていることを条件に、元のハードコピーの帳簿記録は廃棄してもよい」と述べています。つまりIRSは、デジタル複製が完全かつ判読可能である限り、簿記士や企業が完全にペーパーレス化し、デジタル化後に原本を廃棄し、監査目的で電子記録に依存することを明示的に許可しているのです。
これは新しいガイダンスではありません。IRS Revenue Procedure 97-22(1997年)は、約30年前に電子記録の有効性を確立しました。IRSの「どのような記録を保存すべきか」のページには、保持すべき証憑書類(売上伝票、支払済み請求書、納品書、領収書、入金伝票、取消済み小切手)が列挙され、「年次および収入・支出の種類別」に整理されなければならないと指定されています。フォーマット要件はありません。「原本の紙のみ」という規定もありません。整理されていて取り出せれば、デジタルで問題ないのです。
簿記士にとって、これは領収書自動化に対する最も一般的な反対意見「監査はどうするのか?」を排除します。監査人はデジタル記録を受け入れます。1997年から受け入れています。保存期間(ほとんどの記録は3年、雇用税記録は7年、特定の資産・損失記録は無期限)は紙とデジタルコピーの両方に同様に適用されます。スキャン品質が適切であれば、紙の原本がスキャン画像よりも優先されるというIRSの規定はありません。
簿記業務の実務的な意味合いとしては、現在30社分の紙の領収書を保管している場合——ファイルキャビネット、段ボール箱、外部倉庫——IRSが物理的な形で要求していないアーカイブを維持していることになります。入金時点で領収書をデジタル化することは、データ入力時間の節約だけでなく、物理的な保管負担と、クライアントが監査を受けた際にカテゴリ別に整理された3年分の領収書を提出するための検索コストを排除します。検索可能なPDFフォルダ1つと、抽出されたデータのExcelレジスタがあれば、Pub 583が列挙するすべての記録保持要件を満たします。
簿記士にとっての手動データ入力の実際のコストについては多くの記事が書かれていますが、ペーパーレス化を認める規制は、今日の自動化ツールのほとんどが存在する前から整っていました。障壁はIRSではありません。ワークフローなのです。
「バッチ→完了」ワークフロー:1回のアップロード、1回のエクスポート、1つの仕訳
何日もかけて領収書を整理・入力する代わりとなる方法は、より高額なDextプランや、使われないモバイルアプリを30社のクライアントにインストールしてもらうことではありません。それは根本的に異なるアプローチです:カスタム列抽出によるバッチ処理。ツールがどのフィールドを抽出し、どのようにラベル付けするかを決めるのではなく、あなたが列を定義します——するとAIが各領収書から一致するデータを見つけ出し、クライアントの月間領収書をすべて1つの出力ファイルに統合し、仕訳として転記できるスプレッドシートを提供します。クライアントごとの設定は不要。テンプレートのトレーニングも不要。クライアントの参加も不要です。
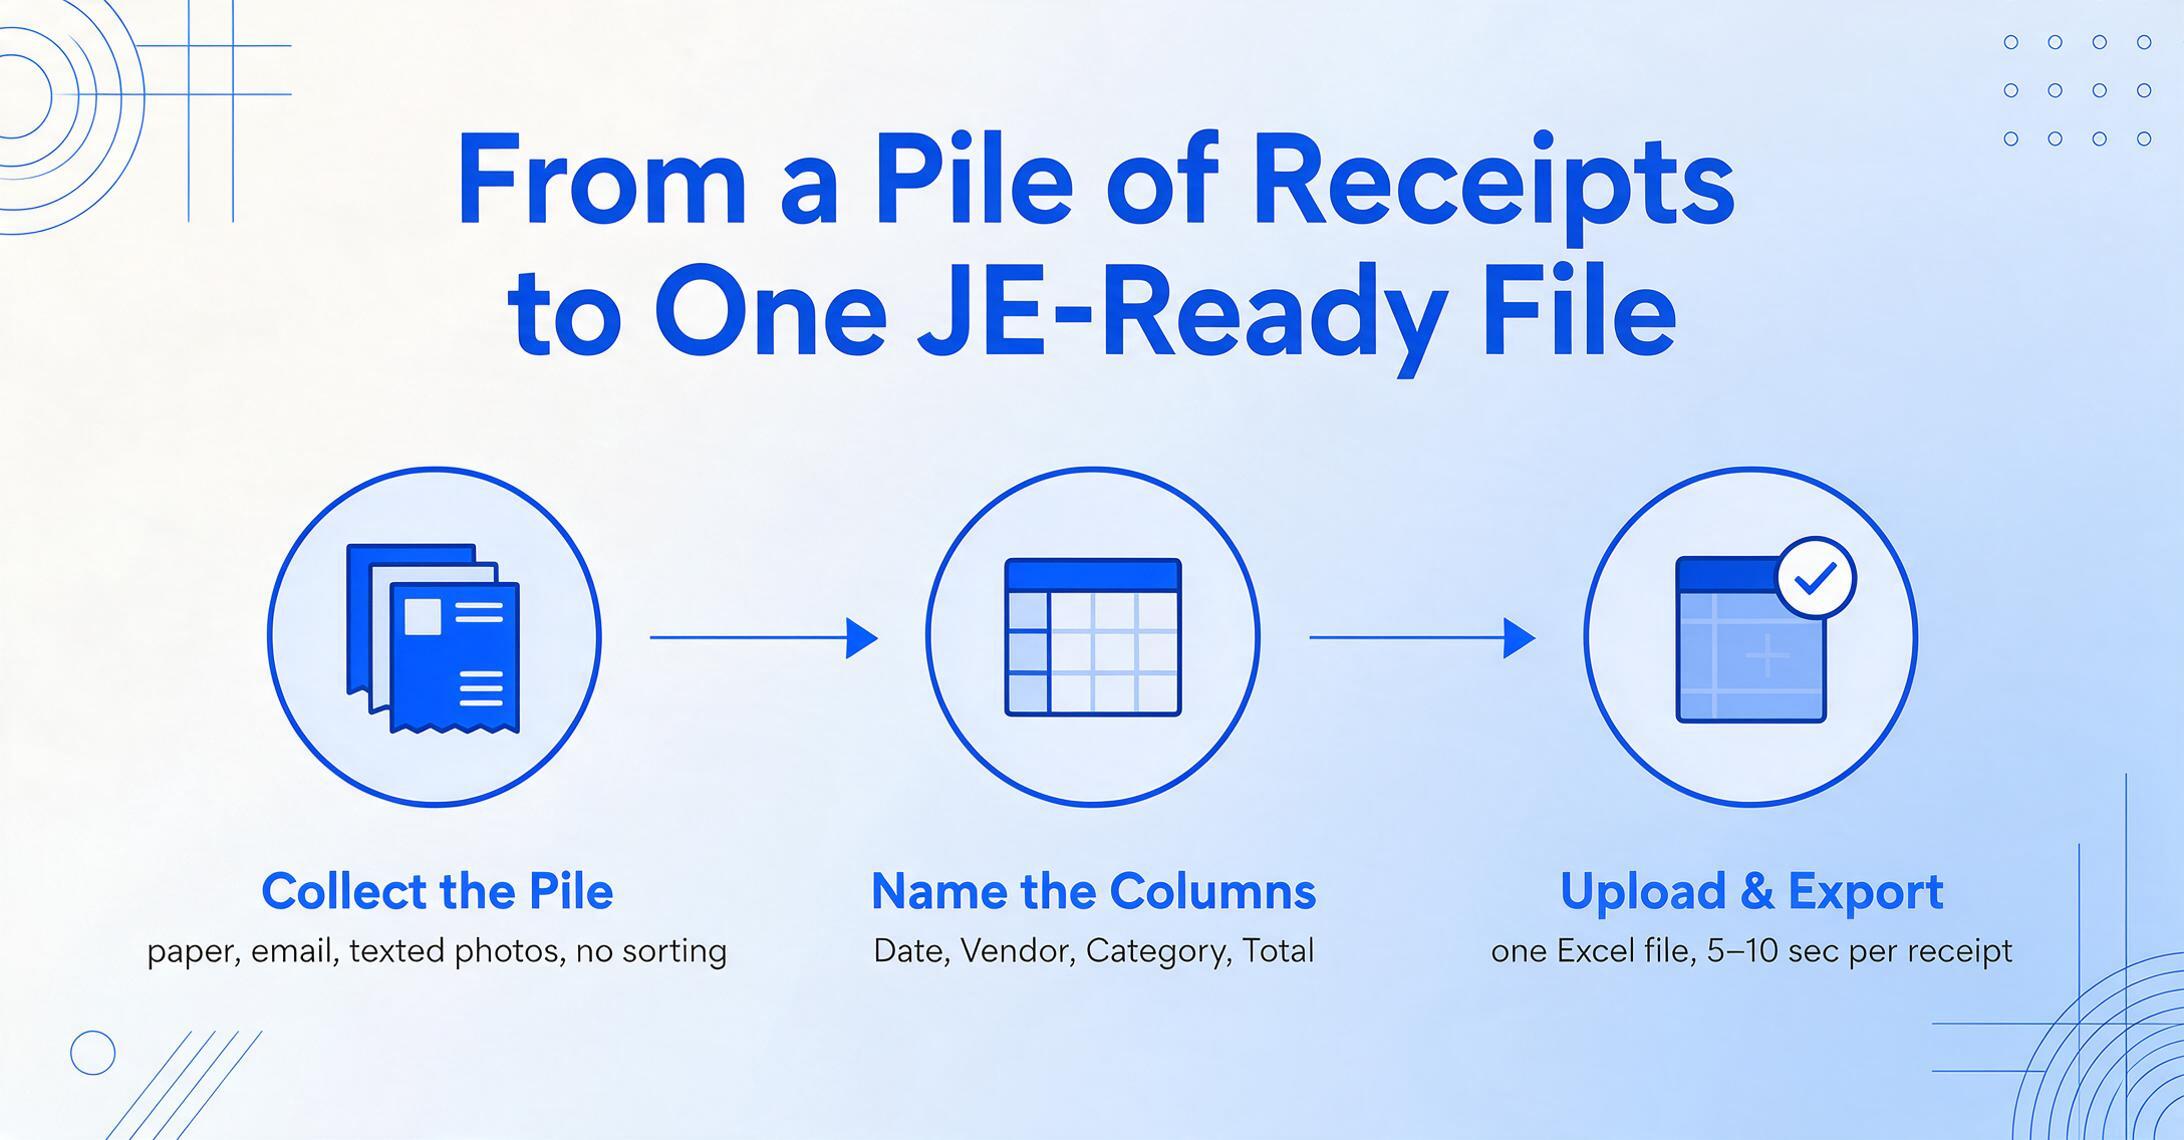
このワークフローは、各クライアントの月末に3つのステップで構成されます:
- 領収書を集める。クライアントの領収書がどのように届いても受け取ります——紙の封筒、メール添付、テキスト送信された写真、共有フォルダ。仕分けは不要。整理も不要。ただ集めるだけです。
- 列を定義する。このクライアントの仕訳準備に必要な列ヘッダーを入力します:
日付、取引先、説明、カテゴリ、小計、税額、合計。これらが出力ヘッダーになります。クライアントによって使用する列が異なる場合——あるクライアントは勘定コード、別のクライアントは経費勘定——ツールの設定ではなく、バッチごとに定義します。 - アップロードしてエクスポート。その月の領収書すべて——PDF、JPG、PNG、スクリーンショット——を1つのバッチでアップロードします。AIが各領収書を処理し、列名に一致する値を特定し、すべてを1つのExcelファイルに統合します。出力は並べ替え済みで、すぐに転記できます。総処理時間:領収書1枚あたり5〜10秒。3分ではありません。
実際の運用では次のようになります:
ファイルは安全に処理され、保存されません。
このワークフローは、簿記士・クライアント・ツールの関係を変えます。ツールはクライアントの勘定科目体系を知る必要はありません。仕入先ルールやカテゴリマッピング、勘定コードの割り当ても必要ありません。必要なのは、どの列を求めるかだけです。そして、列名そのものが唯一の指示になります。Subtotal、Tax、Total と入力すれば、各領収書からその値を探し出し、対応する出力列に配置します。ツールの役割は抽出で始まり抽出で終わります。後続のすべて — カテゴリ分類、照合、仕訳の転記 — は、クライアントをよく知る簿記士の側に残ります。
このアプローチは、以下の仕組みにより、規模が大きくなるほど効率が高まります。
コレクションリンクを使えば、領収書の収集という手間を完全に省けます。クライアントごとに共有可能なリンク(/c/xxxx のようなURL)を生成し、一度送るだけです。クライアントはリンクを開き、短い確認コードを入力して、領収書を直接アップロードします。アカウント作成も、アプリのインストールも、ログインも一切不要です。ファイルは自動的にあなたの処理キューに入ります。30人のクライアントを抱える簿記士であれば、毎月30通のフォローアップメールが不要になります。クライアントに経費領収書を提出する従業員がいる場合も、同じリンクが使えます。各自が自分の領収書をアップロードすれば、クライアントごとに1つの統合キューが得られます。
計算列は、そうでなければExcelに戻らざるを得なくなる計算を処理します。領収書に小計と税率は印字されているが税額が印字されていない場合、Tax (Subtotal × 8.75%) のような計算列が抽出中にそれを計算し、出力にはすでに税額の列が入っています。領収書に印字された合計が明細行の合計と一致しない場合(分割払いや一部返金の領収書でよくあります)、計算列で即座に不一致を検出できます。得られるのは生の抽出データではなく、計算がすでに済んだ、仕訳にそのまま使えるスプレッドシートです。これは、領収書に明示的に印字されていない値を列に導出する必要がある場合に特に有用です。たとえば、仕入先名に基づくカテゴリ分類(Account = "Office Supplies" if Vendor contains "Staples")などです。視覚AIがあらゆる形式の領収書を読み取れること(モバイル決済アプリの経費スクリーンショットを含む)と組み合わせることで、クライアントごとの設定なしに、出力は常にあなたの事務所の仕訳基準に一致します。
クライアントをまたぐバッチ処理は、時間の節約効果が最も顕著に現れる場面です。あるクライアントの場合:領収書40枚をアップロードし、1つの統合Excelを取得し、仕訳を転記して完了。次のクライアントでも同じ手順を繰り返します。このツールにはコンテキストスイッチによる負荷がありません。各クライアントのバッチは同じ手順、同じインターフェースで処理されます。唯一の変数は入力する列名で、それは各クライアント固有の勘定科目体系に直接対応しており、保存済み設定は不要です。30クライアントを抱える事務所では、月末の全領収書を約1〜2時間の監視付き作業(ファイルのアップロード、出力のスポットチェック、仕訳の転記)で処理でき、手動入力の60時間と比較して大幅な時間短縮となります。
これが事務所の収益計算に与える影響
月60時間の領収書データ入力から解放されることは、単に利益率を改善するだけでなく、価格設定と事業拡大の経済性を変えます。手動入力による月$4,500の損失に直面していた固定料金制の事務所は、その時間を請求可能なクライアント業務に振り向けることで、人員を増やしたりクライアント構成を変えたりすることなく、月間収益を増やすことができます。
典型的な事務所の数字を見てみましょう:
| 手動入力 | バッチAI抽出 | |
|---|---|---|
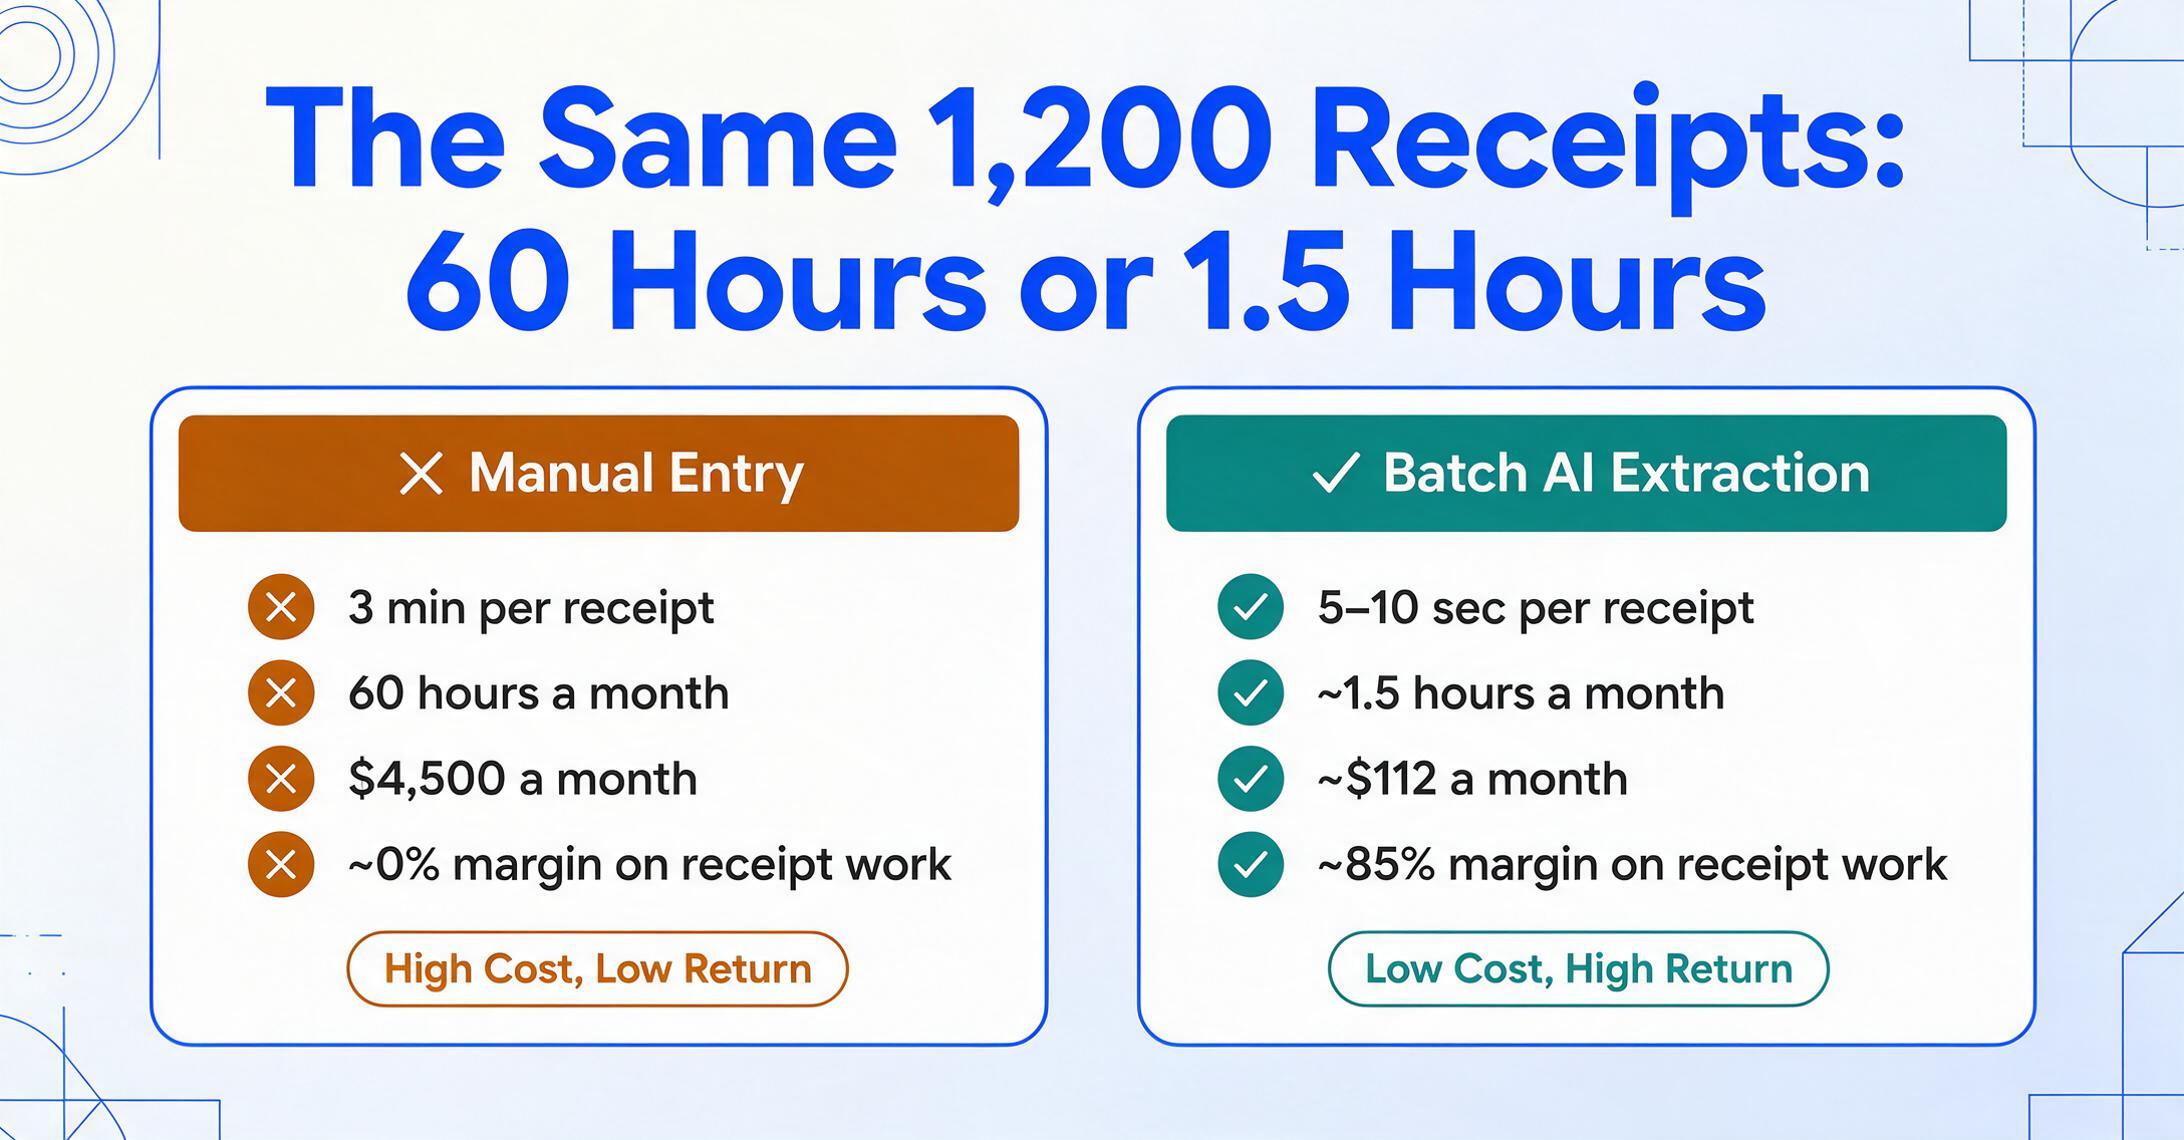
| 月間領収書数(30クライアント × 40枚) | 1,200 | 1,200 |
| 1枚あたりの処理時間 | 3分 | 5〜10秒 |
| 月間総作業時間 | 60時間 | 約1.5時間(アップロード+レビュー) |
| 実効レート$75/時間でのコスト | 月$4,500 | 月約$112 |
| 取り戻せる時間 | — | 月58.5時間 |
| 58.5時間で対応可能な追加クライアント数(フルサービス簿記でクライアントあたり月約12時間) | — | 新規4〜5クライアント |
| クライアントあたり月$500での追加年間収益 | — | 年間$24,000〜30,000 |
| 領収書処理の実効粗利益率 | 約0%(消費時間 ≈ 請求額) | 約85%(ツールコスト後) |
領収書処理コンポーネントだけでも利益率の改善は劇的ですが、戦略的なメリットはさらに大きいものです。月に60時間をデータ入力に費やしている場合、本質的に請求可能な時間を非請求業務と1対1の割合で交換していることになります。領収書処理に費やす1時間は、アドバイザリーサービス、クライアントとのコミュニケーション、税務計画、または事務所の成長に使えない1時間です。月に取り戻せる58時間—年間およそ700時間—は、月額500ドルの簿記関係と月額1,200ドルのクライアント会計サービス契約を区別する、四半期レビュー、キャッシュフロー分析、予算策定サポートといったアドバイザリーレイヤーを構築する能力を意味します。
文書あたりのコスト比較も、別の角度から同じことを示しています。1通あたり3分の手動入力と1時間あたり75ドルの実効レートでは、領収書1通あたり約3.75ドルの人件費になります—物理的な保管の間接費、エラーのコスト、簿記士の時間の機会費用は含まれていません。バッチAI抽出では、ツールコストを含めて1通あたり1ドル未満に抑えられます。30クライアントの事務所で年間14,400通を処理する場合、年間の節約額は40,000〜50,000ドルに及びます—これは追加のパートナー収入か、利益率を犠牲にすることなくより競争力のある価格設定を行う能力のいずれかを意味します。
高取引量産業—建設、小売、飲食、現場サービス—のクライアントにサービスを提供する事務所にとって、この計算はさらに有利になります。これらの業界では、クライアントあたり月40通の領収書は控えめな数字です。請負業者のクライアントは月に80〜120通(材料、下請け業者、機器レンタル、燃料、許可証)を生成する可能性があります。レストランのクライアントは毎日仕入先の請求書を生成します。これらの量では、手動入力のコストはクライアントあたり月1,000ドルを超え、固定料金モデルは完全に崩壊します。
30クライアント事務所の最終的なROI:月58時間以上を取り戻す→月500ドルで追加クライアントを4〜5社獲得→限界納品コストほぼゼロで年間24,000〜30,000ドルの追加収益。または、同じクライアント基盤を維持し、固定料金契約の実効時間利益率を約30%から50%以上に引き上げる。
よくある質問
手書きの領収書でも使えますか?
はい — 読みやすさの範囲内であれば可能です。AIは文字単位のOCRではなく視覚的な理解を使用するため、手書きの金額、仕入先名、日付を文脈から読み取ることができます — 人間の簿記士が各数字を個別に解析するのではなく、領収書上の位置から手書きの合計を認識するのと同じ方法です。標準的な領収書レイアウトにきれいな手書きであれば、通常は正確に抽出できます。薄い鉛筆書き、ひどく汚れた領収書、または窮屈な走り書きはエラーを生じる可能性があり、手動での確認が必要です。読みにくい領収書の重要な金額については、出力をスポットチェックしてください — 薄い領収書の確認に費やす30秒は、ゼロから入力する3分よりもはるかに短時間です。
クライアントごとにカスタム列名を使用できますか?
それが中核となる仕組みです。クライアントごとに帳簿の整理方法は異なります — あるクライアントは勘定コードを使用し、別のクライアントは費用勘定を使用し、3つ目のクライアントは正味金額とVATを別々の列に分けています。各クライアントのスプレッドシート構造に合った列名を入力すると、出力はそのヘッダーを保持します。30社のクライアントにわたって維持する保存済み設定はありません — バッチごとに列を定義するため、ツール設定を更新することなくクライアントの進化する勘定科目体系に適応できます。クライアントがカテゴリ名を変更したり、コストセンター列を追加したりした場合は、維持することを覚えておく必要のある保存済みテンプレートではなく、入力する内容を変更するだけです。
複数の領収書が含まれるPDF — 1つのファイルに15枚の領収書が入ったスキャナーダンプのような場合はどうですか?
AIは複数ページのPDFを処理し、単一ファイル内の個々の領収書を識別できます。クライアントが領収書の束を1つのPDFにスキャンした場合、ツールはそれらを分割して各領収書からデータを個別に抽出し、結果を結合した出力に統合します。これにより、抽出前にPDFを手動で分割する前処理ステップが不要になります。
出力はどのようにQuickBooks OnlineやXeroに反映されますか?
抽出結果は、指定した列見出しを含むクリーンなExcelまたはCSVファイルです。QBOとXeroの両方が、仕訳、請求書、経費のCSVインポートに対応しています。ワークフローは次のとおりです:抽出 → CSVエクスポート → プラットフォームの標準インポートツールを使用してQBO/Xeroにインポート。直接のAPI統合ではありません(このカテゴリのツールで、すべての会計プラットフォームのすべてのバージョンと確実にリアルタイム同期できるものはありません)が、エクスポートとインポートのステップはクライアントのバッチごとに60秒未満です。主にスプレッドシートで作業し、手動で仕訳を入力する簿記士にとっては、出力はインポートステップなしで仕訳準備シートに直接入ります。
ぼやけたスマホ写真の領収書はどう処理されますか?
クライアントが提出する領収書写真のほとんどは十分な品質です—適切な明るさと角度で撮影されています。AIは一般的なスマホ画質を問題なく処理します。極端なケース—暗いガレージで斜めから撮影された領収書、折り目で金額が隠れたくしゃくしゃの領収書、時間の経過で色あせた感熱紙の領収書—は、比例して精度が低下します。目を細めて推測しなければならないような領収書は、AIも同様に目を細めて推測します。ただし、抽出は数分ではなく数秒で完了するため、15%の再スキャン率(特に悪い写真1〜2枚をクライアントに再撮影してもらう)でも、クライアントが提出した40枚すべての領収書を手動で入力するよりはるかに手間がかかりません。このツールのコレクションリンク機能により、クライアント自身が悪い写真を再アップロードします—プロンプトが表示されるのはあなたではなくクライアントです。
DextやHubdocとはどう違うのですか?
DextとHubdocは「取り込み → 分類 → 会計ソフトに公開」というワークフロー向けに作られています。同じ仕入先ルールとカテゴリマッピングがすべての取引に適用される単一事業体での使用には適しています。複数クライアントの簿記業務では、違いは次の4点に集約されます:
- クライアントごとの設定が不要。Dextはクライアント接続ごとに仕入先ルール、カテゴリマッピング、公開先の設定が必要です。HubdocはXeroでクライアントごとの設定が必要です。列名抽出では、必要な列見出しを入力するだけが唯一の設定で、保存するルールも継続的なメンテナンスもありません。
- Excelファーストの出力。DextとHubdocは会計ソフトに公開します—出力先はQBOまたはXeroです。ワークフローが仕訳準備スプレッドシートにある場合(多くの簿記士がそうであるように)、列名抽出は中間の同期ステップなしでそのスプレッドシート構造に直接出力します。
- 計算列とカスタムフィールド定義。Dextは事前定義されたフィールド(仕入先、日付、合計、税、カテゴリ)を抽出します。計算に基づく列の導出やルールに基づくエントリの分類を指示することはできません。計算列を使用すると、
税額(小計×税率)や勘定コード(仕入先に「Home Depot」が含まれる場合→「5110」)のような派生フィールドを定義でき、抽出中に自動入力されます。 - クライアントごとの設定なしのコレクションリンク。Dextのクライアント提出には、クライアントがDextモバイルアプリをインストールして使用するか、領収書をDextのメールアドレスに転送する必要があります。コレクションリンクは共有可能なURLで、受信者はアカウントもアプリもトレーニングも不要です—アップロードしてページを閉じるだけです。
DextとHubdocは、設計された目的に対しては有能なツールです。問題は、その設計された目的が、スプレッドシートネイティブで複数クライアント対応の固定料金簿記ワークフローに合致するかどうか、あるいは「列を定義し、バッチを処理し、スプレッドシートを取得する」ために特別に作られたツールが、実際の作業方法に直接対応するかどうかです。
AIが重要な領収書で誤りを犯した場合はどうなりますか?
抽出ツールが100%正確であることはありません。Dextが宣伝する99%以上の精度でも、Hubdocでも、AIベースのシステムでも同様です。このワークフローでは、3つの方法でこれに対応しています。まず、バッチ出力は単一のスプレッドシートであるため、レビューが効率的です。Total列をスキャンして、元の領収書と照らし合わせて異常と思われる金額をスポットチェックします。次に、レビューモードは、抽出された各セルをソースドキュメントに結び付けます。出力内の値をホバーまたはクリックすると、元の領収書上の該当領域がハイライト表示されます。画像上の領域をクリックすると、対応するセルにジャンプするため、領収書全体を読み直すことなくフィールドを確認できます。これはファイルごとにトリガーすることも、自動注釈をオンにしてバッチを開いたときにマッピングがすでに生成されているようにすることもできます。第三に、抽出は領収書1枚あたり数秒しかかからないため、列名を調整したり、より鮮明な写真で領収書を再処理するコストはほぼゼロです。5分間のレビューパスでほとんどのエラーを検出でき、手動検証バッファを組み込んでも、全体的な時間短縮は維持されます。58時間の節約は、出力を確認するのに5分費やしたからといって50時間に減ることはありません。
クライアントごとの設定は不要です。バッチをアップロードし、列を入力して、Excelを取得します。