源泉徴収票300枚を、
1つのスプレッドシートに
日本の年末調整の計算は給与システム内で行われます。弥生給与も、freee人事労務も、SmartHRも計算します。問題が始まるのは計算が終わった瞬間です — 300枚の個別の源泉徴収票(Gensen Choshu-hyo)PDFを、グローバル本社、外部の会計士、または1月31日までに税務署に提出する法定調書合計表のために、1つのスプレッドシートにまとめる必要があるからです。
ボトルネックは計算ではなく、集計です
日本の年末調整は、計算上は決定的(デターミニスティック)です。従業員の課税所得は、総支給額から法定の給与所得控除、社会保険料、配偶者控除・扶養控除、生命保険料控除・地震保険料控除を差し引き、源泉徴収税額表を適用して、年間の源泉徴収額と比較し、12月の給与で差額を精算します。市場にあるどの給与計算プラットフォームでも、この計算は実行できます。
しかし、どのプラットフォームも答えられない質問があります。毎年1月に人事担当者の机に届く、この質問です:「全日本従業員の年間報酬サマリーを、英語で、Excelで、金曜日までに送ってください。」
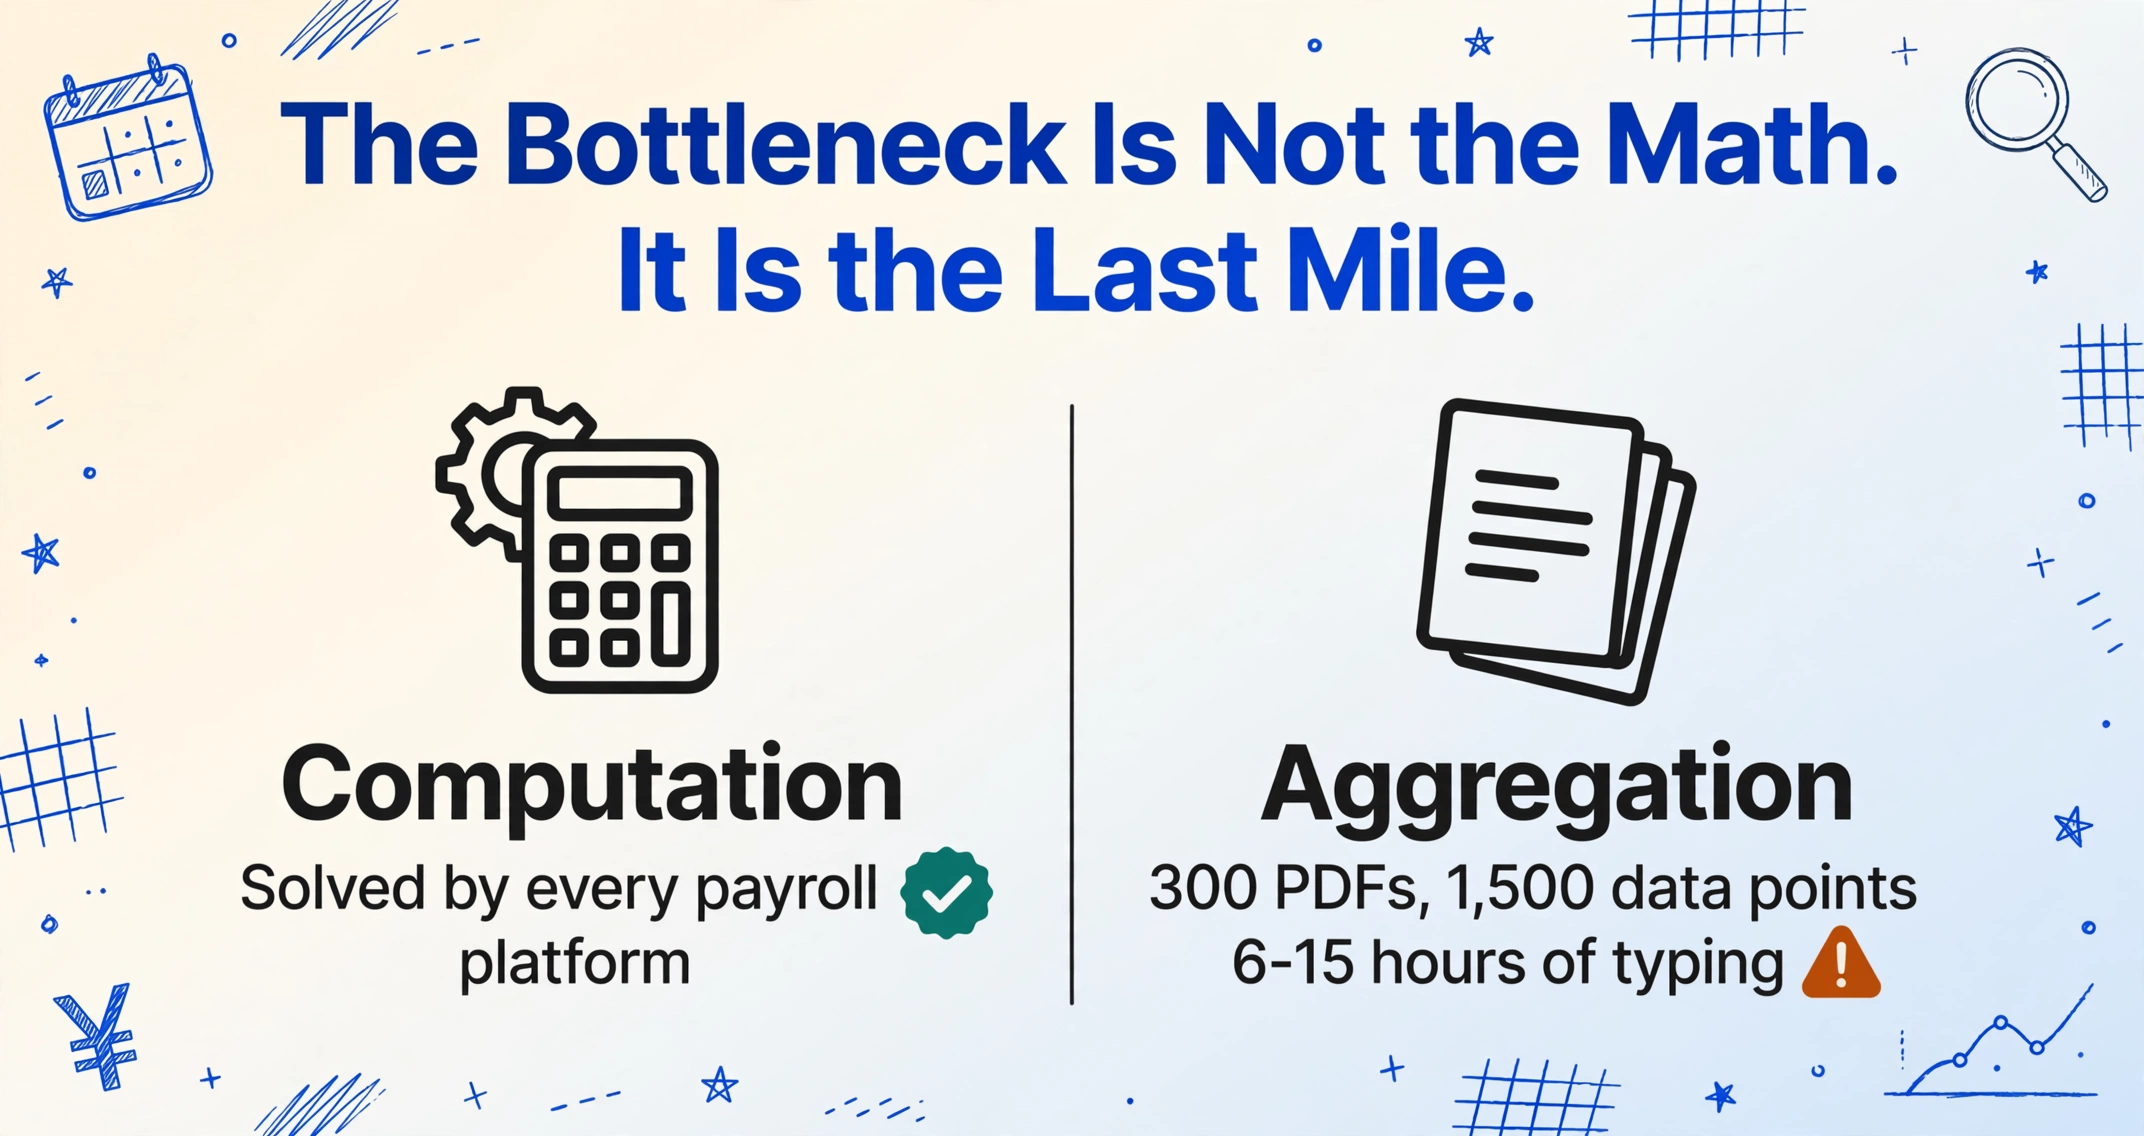
この質問に答えるには、各従業員の源泉徴収票を開く必要があります。これは、支払金額、給与所得控除後の金額、所得控除の額の合計額、源泉徴収税額、社会保険料等の金額など、26の定義済みフィールドを含む、情報量の多い1ページのPDFです。そして、関連する数値をスプレッドシートに手入力していくのです。従業員が300人の会社であれば、300枚のPDF、約1,500のデータ項目を転記することになり、タイピング速度や同時に開いておけるPDFビューアの数にもよりますが、6時間から15時間のデータ入力作業が必要になります。
計算は無料でした。転記作業こそが、1月の最初の1週間を費やさせるものなのです。
給与ソフトの限界:システム間連携の現実
日本の給与計算プラットフォームはデータをエクスポートできます。弥生給与は集計表からCSVを出力し、e-TaxのCSV形式にも対応しています。市場シェア首位で約38万事業者が利用するfreee人事労務は、源泉徴収票を生成し、年末調整データのエクスポートにも対応しています。SmartHRは源泉徴収票の取り込み形式として、CSV(SmartHR形式)、PDF、CSV(eLTAX形式)の3形式に対応しています。MoneyForward Cloud Payrollは勤怠から税務申告まで一貫して処理します。入社以来ずっと同じ給与システムを利用している従業員だけで、かつレポートの受け取り側がすべて日本語を読めるのであれば、エクスポートの道は存在します。
しかし、次の3つの現実が、その道をカタログ記載よりも困難にしています。
PDFのみというギャップは現実的で広く存在します。従業員数301〜1,000人の製造業のユーザーがSmartHRのアプリマーケットに投稿したレビューは、この問題を的確に説明しています。freee人事労務は源泉徴収票データをPDFでのみ出力します。提供されるCSVエクスポートは年末調整の確認用であり、構造化された源泉徴収票データ用ではありません。SmartHRに取り込むため、人事チームは約560人分のPDFを従業員IDと氏名で1ファイルずつ手動で命名・保存し、個別にアップロードする必要がありました。“導入初回の昨年度は源泉徴収票連携作業に時間を要したため、例年より公開が遅れた経緯がございます” — 移行初年度は、証明書連携作業に時間がかかり、従業員への公開が例年より遅れました。これが全国の給与ソフト移行サイクルで発生すると、手作業は人時ではなく人週単位になります。
年度途中の給与システム移行はデータを分断します。弥生給与を使う外部委託の給与計算会社から7月にSmartHRへ切り替えた企業では、従業員の源泉徴収票データが2つのシステムにまたがっています。CSVのレイアウトは異なり、列ヘッダーは日本語です。エンコーディングもShift-JIS(弥生)とUTF-8(現代のクラウドプラットフォーム)で異なります。2つのシステムのエクスポートを1つのグローバルレポートに統合するには、翻訳者、データクレンジングスクリプト、そして人事チームが想定していた以上のスプレッドシート作業が必要です。
グローバル本社は日本語を読みません。日本に子会社を持つ外資系企業では、シンガポール、ロンドン、ニューヨークの地域本社への月次・四半期レポートに、英語の日本従業員データが必要です。“Annual Gross Salary”、“Income Tax Withheld”、“Social Insurance Contributions”といった列が必要です。弥生給与のCSVエクスポートは、支払金額、源泉徴収税額、社会保険料等の金額というラベルで出力されるため、毎回手動での翻訳と整形が必要です。データは存在します。ただ、PDFの中に閉じ込められ、レポートの受け取り側が読めない言語でラベル付けされているだけなのです。
本当のギャップ:日本の給与ソフトは税額計算の問題を見事に解決しています。しかし、データの可搬性 — 構造化され、機械可読で、言語に依存しない出力を、給与システムを操作しないが必要とする人々の手に届けること — を解決するようには設計されていませんでした。
300枚の証明書、1回のアップロード:バッチ抽出がギャップを埋める方法
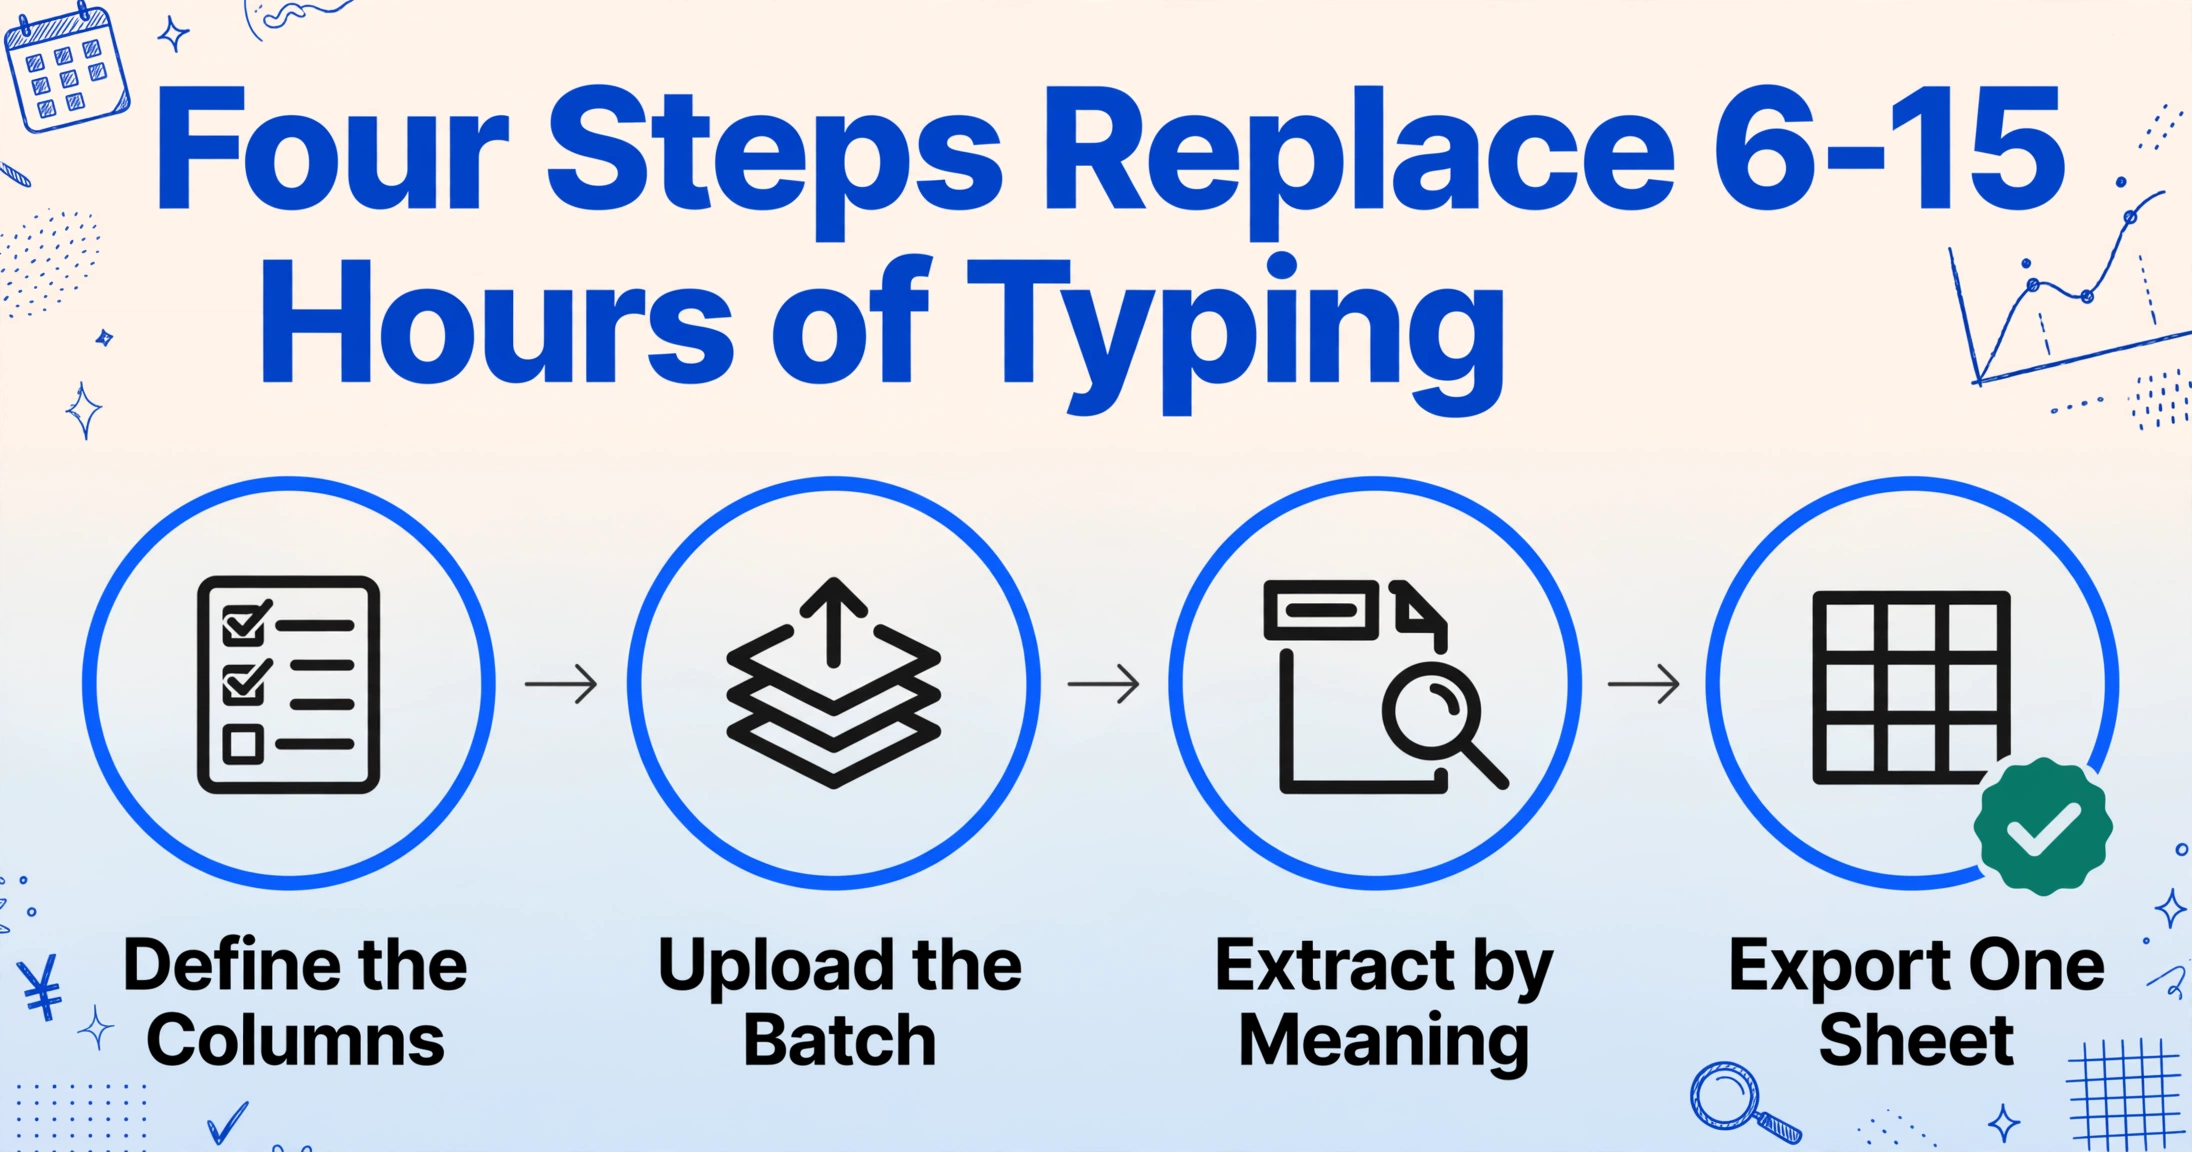
バッチ処理とは、複数の文書を一度にアップロードし、1つの結合された出力ファイルを受け取ることです。文書ごとに1行、定義したフィールドごとに1列が作成されます。これは、300枚のPDFを1枚ずつ処理する(開く、転記する、閉じる、繰り返す)のと、300枚すべてを1回の操作で処理するのとの違いです。
このワークフローは、転記を指示に置き換えます:
ステップ1:列を一度定義します。 各証明書からデータを打ち直す代わりに、抽出したい内容を定義します。ここでは列名抽出を使用します。フィールド名(「従業員名」「支払金額(JPY)」「源泉徴収税額(JPY)」「社会保険料合計(JPY)」)を入力すると、AIが各文書を読み取り、ページ上の位置ではなく意味を理解してそれらの値を特定・抽出します。これは、給与ソフトウェアによって源泉徴収票の形式が異なるため重要です。弥生給与は法人番号をある位置に配置し、SmartHRは別の位置に配置し、小規模な会計事務所の紙の証明書はさらに別のレイアウトに従います。列名抽出は座標ではなく意味ラベルを読み取ります。
源泉徴収票の標準的なバッチ抽出では、以下の8列で、グローバルな人事・財務チームが最も必要とするフィールドをカバーできます:
| 列名(英語) | 日本語フィールド | 値の例 |
|---|---|---|
| Employee Name | 氏名 | Tanaka Hiroshi |
| Gross Salary (JPY) | 支払金額 | 8,500,000 |
| Income After Deduction (JPY) | 給与所得控除後の金額 | 7,200,000 |
| Withholding Tax (JPY) | 源泉徴収税額 | 425,000 |
| Social Insurance Total (JPY) | 社会保険料等の金額 | 1,020,000 |
| Deductions Total (JPY) | 所得控除の額の合計額 | 2,500,000 |
| Date of Birth | 生年月日 | 1985-06-15 |
| Employer Name | 給与支払者の名称 | Tokyo Technology KK |
レポートのニーズが拡大するにつれて、生命保険料控除、地震保険料控除、住宅借入金等特別控除、扶養人数、配偶者控除の詳細などの列を追加できます。再トレーニングや給与プロバイダーごとのテンプレートは不要です。列名を追加するだけでAIが値を特定します。源泉徴収票の26フィールドすべてと単一証明書の抽出ワークフローの詳細な手順については、日本の源泉徴収票をExcelに抽出するガイドをご覧ください。
ステップ2:すべてを一括でアップロードします。 すべての源泉徴収票ファイル(給与ソフトからのPDF、以前の雇用主からのスキャンした紙の証明書、印刷されたコピーの写真)を1つのアップロードにドラッグします。このツールはそれらを1つのセッションでまとめて処理します。1ページあたり5〜10秒かかり、手動入力の平均3分と比較して約18倍高速ですが、本当の節約は300個の個別ファイルを開いて、転記して、閉じる必要がないことにあります。
ファイルは安全に処理され、保存されません。
ステップ3:サンプルを確認してからエクスポートします。 抽出が完了すると、プレビューテーブルが表示されます。従業員ごとに1行、合計300行で、定義した列が含まれます。元のPDFと照合して数行を確認し(15人の従業員をランダムに5%サンプルチェックすると、ほとんどの抽出問題を検出できます)、プレビューで直接修正を加え、Excel(XLSX)またはCSVとしてエクスポートします。ファイルは、グローバルHRISへのアップロード、外部の会計士への転送、法定調書合計表の作成にすぐに使用できます。
処理前に従業員から証明書を収集する必要がある企業(たとえば、前の雇用主から紙のみの源泉徴収票を受け取った従業員がいる場合)では、コレクションリンクを使用すると受け取りが簡単になります。共有可能なURLを生成し(受信者の登録は不要)、各従業員に送信すると、アップロードされたファイルが直接処理キューに追加され、一括抽出の準備が整います。
さまざまな源泉徴収票形式で機能する理由: AIはテンプレートの座標ではなく、意味理解によってフィールドを読み取ります。弥生給与、SmartHR、freee、または小規模な会計事務所で生成された証明書であっても、支払金額は常に総支給額を意味します。1つの列定義がすべてのソースで機能します。これが一括抽出を経済的に実行可能にする特性です。給与プロバイダーごとに個別のテンプレートが必要な場合、設定コストによって一括処理の節約が相殺されてしまいます。
個人の証明書から法定調書合計表へ:誰も予算化していない国税庁の締切
日本で給与を支払うすべての事業主は、年末調整の報告書を2種類提出しなければなりません:税務署への源泉徴収票と、各従業員の市区町村への給与支払報告書です。これらを結びつける集計書類が法定調書合計表(給与所得の源泉徴収票等の法定調書合計表)であり、すべての個人の証明書の合計を集計し、個人の報告書とともに1月31日までに提出する必要があります。
2016年以降、eLTAXの電子的提出の一元化により、事業主はPCdeskを通じて、市区町村への給与支払報告書と税務署への源泉徴収票の両方を、統一CSVレイアウトを使用して1回の操作で作成・提出できるようになりました。これにより、同じデータを2回準備して送信する必要がなくなりました — しかし、データはeLTAXパイプラインに入る前に、構造化された機械可読形式で存在している必要があります。
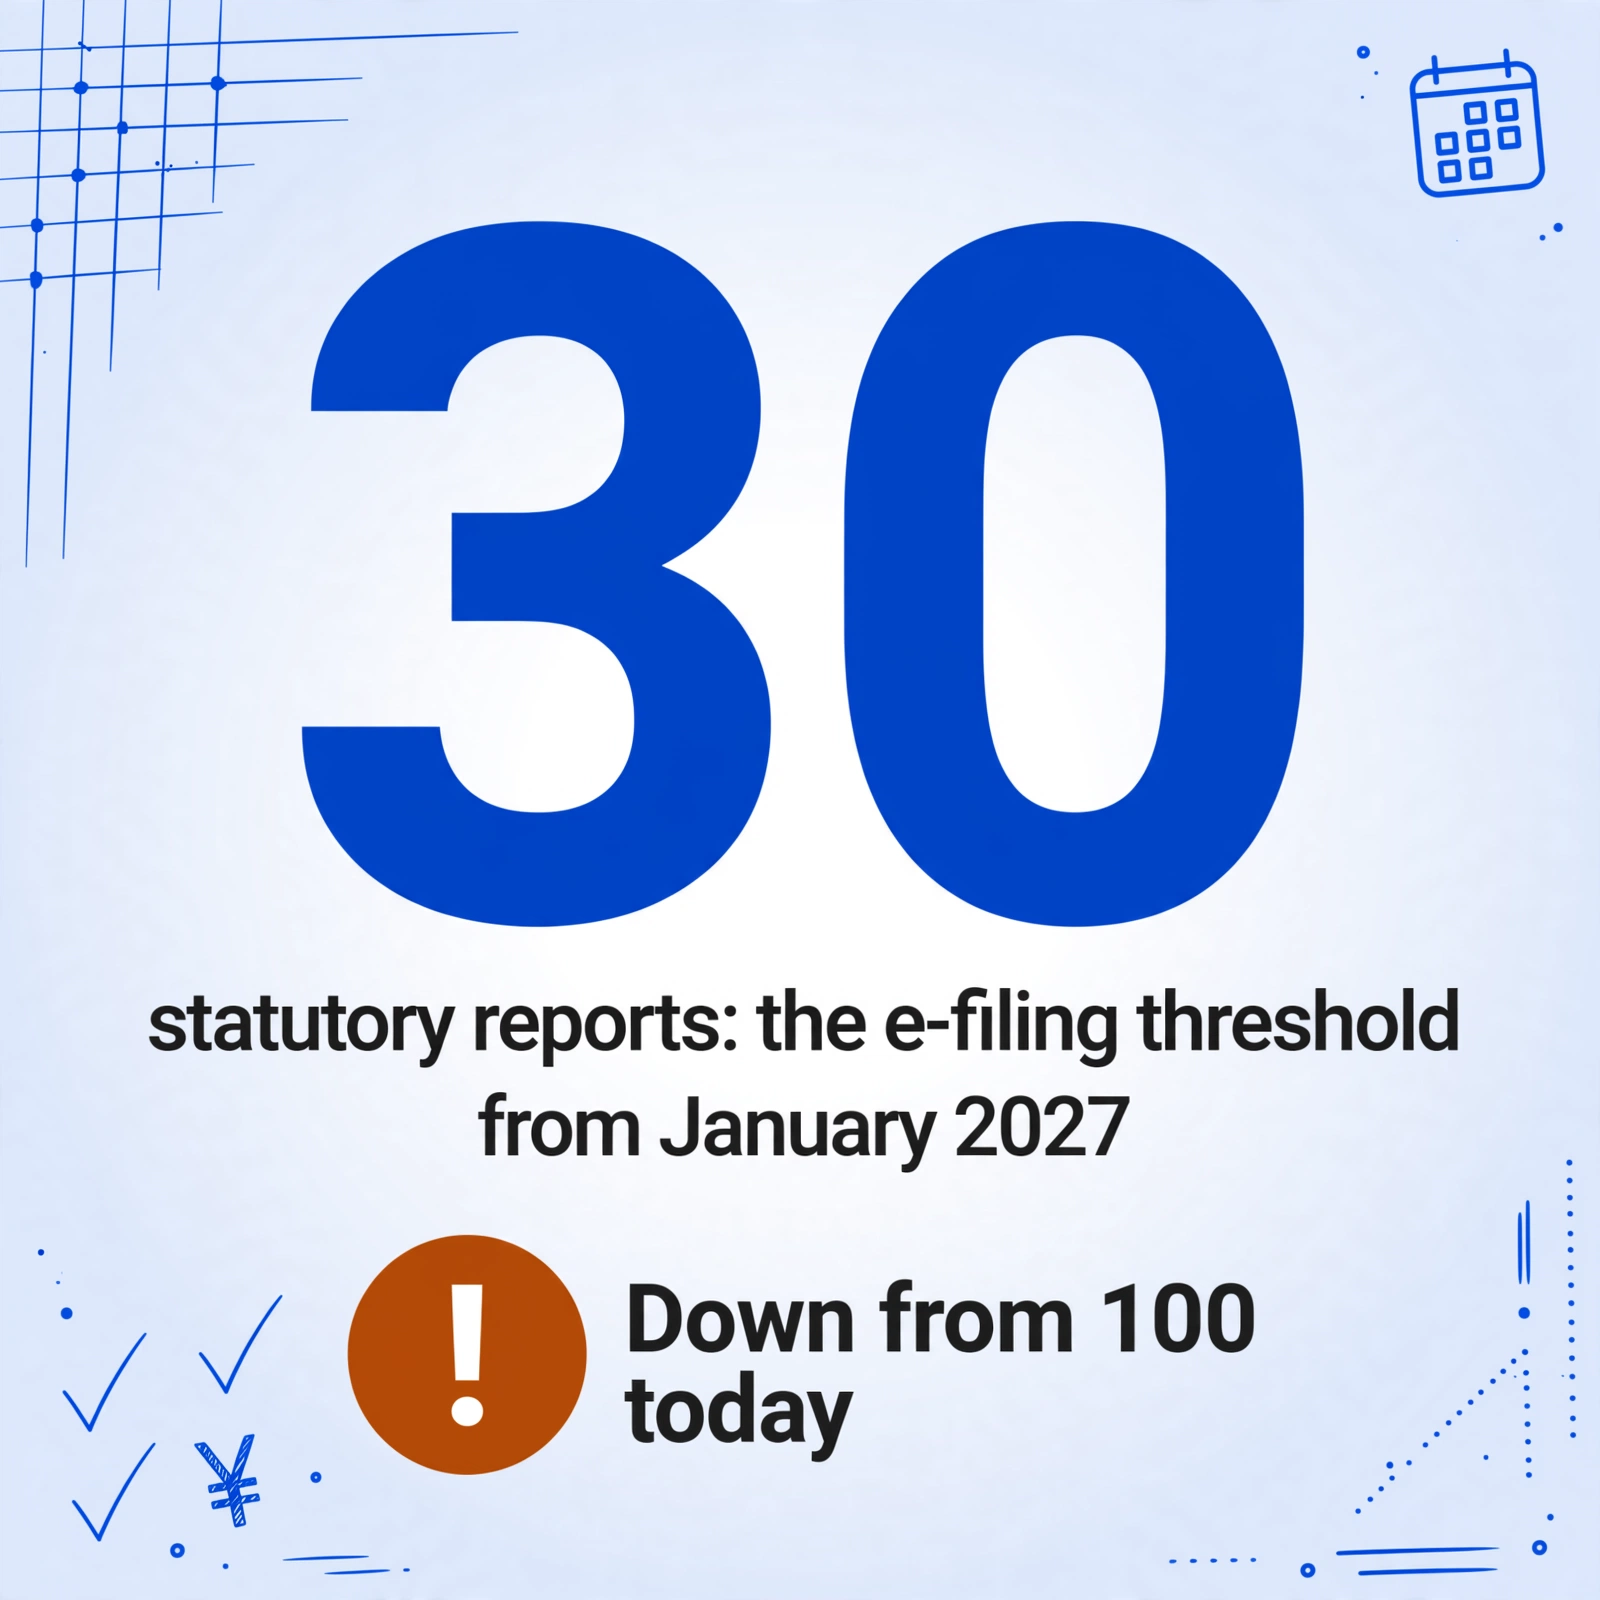
電子申告の義務化は厳しくなっています。現在の規則では、前年度に法定調書を100件以上提出した事業主は、e-Taxまたは光ディスクによる電子申告が義務付けられています。2027年1月から、その基準は30件に引き下げられます — つまり、従業員が30人だけの会社でも、電子申告義務のラインを超えることになります。実質的に、コンプライアンスの猶予期間は今です:今年準備する2025年のデータが、基準引き下げ時に電子申告が義務付けられるかどうかを決定します。
大企業向けには、TKCのe-TAX法定調書システムなどのソリューションが、電子申告ワークフロー全体を処理します — 給与システムからのCSVインポート、一括デジタル署名、eLTAXとe-Taxの両方への一括提出、コンプライアンス記録の保持。これらのツールは申告の問題を解決します。しかし、退職した従業員の紙の証明書、前の雇用主のPDF、またはレガシー給与システムのエクスポートから、これらの申告ツールが期待する構造化CSVにデータを取得するという上流の問題は解決しません。バッチ抽出がその上流のギャップを埋めます:すべての源泉徴収票が — 発生源に関係なく — 同じスプレッドシートに集まれば、法定調書合計表の準備は列の合計とカテゴリのカウントの問題になり、給与台帳と60枚のPDFを照合する必要はなくなります。
従業員が3つの異なる給与計算時代にまたがる場合
最も一般的なバッチ処理の課題は、処理量そのものではありません。その量を生み出すソースの多様性です。毎年1月に繰り返される3つのシナリオがあります:
年度途中の給与システム移行。8月に弥生給与からSmartHRへ移行した企業では、6か月分のデータが一方のシステムに、もう6か月分が別のシステムに存在します。弥生給与のシステムは1月から7月分の源泉徴収票を生成し、SmartHRは8月から12月分を発行しました。従業員の個人の税務記録にとって、2つの証明書を合わせることで年間全体を表します。グローバルな報酬レポートでは、1人の従業員が2つのソースシステムと2つの文書形式にまたがっています。バッチ抽出は同じアップロード内で両方のPDFを処理します — 「従業員名」が両方で一致し、出力行は結合された抽出データを反映します。
前職がある年度途中入社者。日本の所得税法では、年度途中に入社するすべての従業員が年末調整のために前職の源泉徴収票を提出することが義務付けられています。新しい雇用主は前職の所得を源泉徴収計算に組み込み、年間全体の単一の合算証明書を発行します。しかし、現雇用主と前雇用主のデータを分離する必要がある分析 — 報酬ベンチマーク、コストセンター別の予算配分、駐在員の税負担調整 — には、両方の証明書がスプレッドシートに必要です。抽出テーブルの「雇用主名」列で、どの行がどのソースに属するかを即座に識別できます。
合併後の統合。2つの企業が合併します。存続会社には、給与履歴が2つの異なるシステムに存在する従業員がいます。場合によっては2つの異なる給与プロバイダー、2つの異なる形式、福利厚生と手当に対する2つの異なる勘定科目マッピングがあります。合併後の最初の税年度は、これらすべての従業員が同じ法定調書合計表に初めて登場する年です。互換性のない2つの給与システムのエクスポートを調整しようとするのではなく、PDFからのバッチ抽出により、発生元に関係なく、1つのスキーマを持つ1つのテーブルが得られます。それはあなたが定義するものです。
よくある質問
証明書がデジタルPDFではなくスキャンした紙のコピーの場合はどうすればよいですか?
抽出エンジンは、スキャン画像、スマートフォンでの写真、ネイティブPDFを同様に処理します。200 DPI以上のクリーンなスキャンであれば、印刷されたテキストは最大99%の精度で抽出されます。手書きの証明書や、照明が不十分な低解像度のスマートフォン写真では精度が低下します。コレクションリンクを通じて従業員が提出する紙の証明書については、平らな面、十分な照明、全体がフレームに収まっていること、という簡単な品質ガイドラインで、アップロード前の問題のほとんどを解消できます。
バッチ抽出の代わりにfreeeのCSVエクスポートを使用できますか?
freee人事労務のCSVエクスポートは年末調整データの確認用に設計されており、構造化された源泉徴収票データのエクスポート用ではありません。別のシステムにインポートするのに適した形式で、源泉徴収票の全フィールドを出力することはありません。これはユーザー体験によって確認されています:freeeからSmartHRに移行した企業は、CSVエクスポートに源泉徴収票のデータ構造が含まれていないため、個々のPDFを手動で処理する必要があったと報告しています。freee内だけで完結し、freeeの標準レポートで提供される範囲の報告ニーズしかない場合は、CSVエクスポートで十分かもしれません。別のシステムでデータが必要な場合、別の言語が必要な場合、または他のソースからの証明書と集計する必要がある場合は、PDFからのバッチ抽出が実用的な方法です。
バッチ抽出の出力はe-TaxまたはeLTAXのCSVインポートで使用できますか?
バッチ抽出は、定義した列を持つクリーンなExcelまたはCSVファイルを出力します。これは、政府が定めた特定のフィールド順序とエンコーディング仕様を持つeLTAXの統一CSVレイアウト(統一CSVレイアウト)の直接の代替品ではありません。ただし、すべての従業員データが1つの構造化されたスプレッドシートにあれば、公式CSVテンプレートへの入力は簡単なマッピング作業になります — 英語の列見出しを統一CSVレイアウトで必要な日本語フィールドに一度マッピングし、そのマッピングをすべての行に適用するだけです。これは、各PDFから個別にデータを抽出して公式形式に手入力するよりもはるかに高速です。
退職所得の源泉徴収票についてはどうですか?
退職所得の源泉徴収票は、異なる項目を持つ別の様式を使用します。課税額の計算は(支払額 − 勤続年数1年あたり¥400,000(最長20年)、以降1年あたり¥700,000)× ½ です。これらは専用の列定義を持つ別のバッチとして処理する必要があります:「退職支払額」「勤続年数」「退職所得控除」「源泉徴収税」。抽出方法は同一で、列名のみが異なります。毎年退職者を多数処理する企業では、退職証明書バッチを主な給与所得バッチと並行して実行することで、両方のワークフローを明確に保てます。
バッチ抽出にはMy Number(個人番号)データが含まれますか?
いいえ。従業員控えの源泉徴収票(人事チームが通常扱う版)では、My Number欄は空白またはマスクされています。マスクされていないMy Numberは、法令遵守のために別途保管される事業主控えにのみ表示されます。従業員控えを対象としたバッチ抽出ワークフローでは、My Numberデータに遭遇することはありません。
300行にわたって正確性を確認するにはどうすればよいですか?
バッチ抽出の費用対効果の高い検証戦略:行の5%(300件中15件)をランダムにサンプリングし、各抽出フィールドを元のPDFと比較します。サンプル全体で正確性が高ければ、バッチは信頼できます。系統的なエラーが見つかった場合(例:SmartHR生成の証明書から社会保険料の合計が一貫して正しく抽出されない場合)、より正確な日本語のフィールドラベル(単なる「社会保険」ではなく社会保険料等の金額)を使用するように列名を調整し、再実行します。列定義は将来のバッチ実行でも再利用できるため、検証への投資はその後毎年1月に報われます。
給与システムが計算を担い、スプレッドシートが最後の仕上げを担います。
日本の給与ソフトウェアのエコシステムは、計算問題を解決してきました。弥生給与、freee人事労務、SmartHR、MoneyForwardはいずれも、源泉徴収税、社会保険、年末調整を国税庁の要件を満たす精度で計算します。ギャップは計算のギャップではなく、移行性のギャップです。毎年1月、日本中の人事チームは、最初の勤務週を報酬分析や予算計画、従業員相談ではなく、PDFからスプレッドシートへの数字の移行に費やしています。
数字は積み上がります。証明書300件、1件あたり3分:15時間。グローバル本社向けの英語版でも同様です。新しい給与システムへのデータ移行でも同様です。法定調書合計表の集計でも同様です。計算は無料でしたが、転記には毎年、累計で1か月分の人事労務の労力がかかります。
バッチ抽出は給与ソフトウェアを置き換えるものではなく、ソフトウェアが終わったところから引き継ぎます。アップロード1回、スプレッドシート1つ、1月にPDFを開いて数字を入力する週が1週間減ります。