De l'appareil photo au tableur en un geste
Le workflow complet
La photo que vous venez de prendre d'un reçu est bloquée. Elle vit dans la galerie de votre téléphone. Votre tableur vit sur un ordinateur. Entre les deux se trouvent six étapes dont vous ne vouliez pas — et la moitié introduisent des erreurs, pas de la commodité. Voici le workflow qui réduit ces six étapes à une seule.
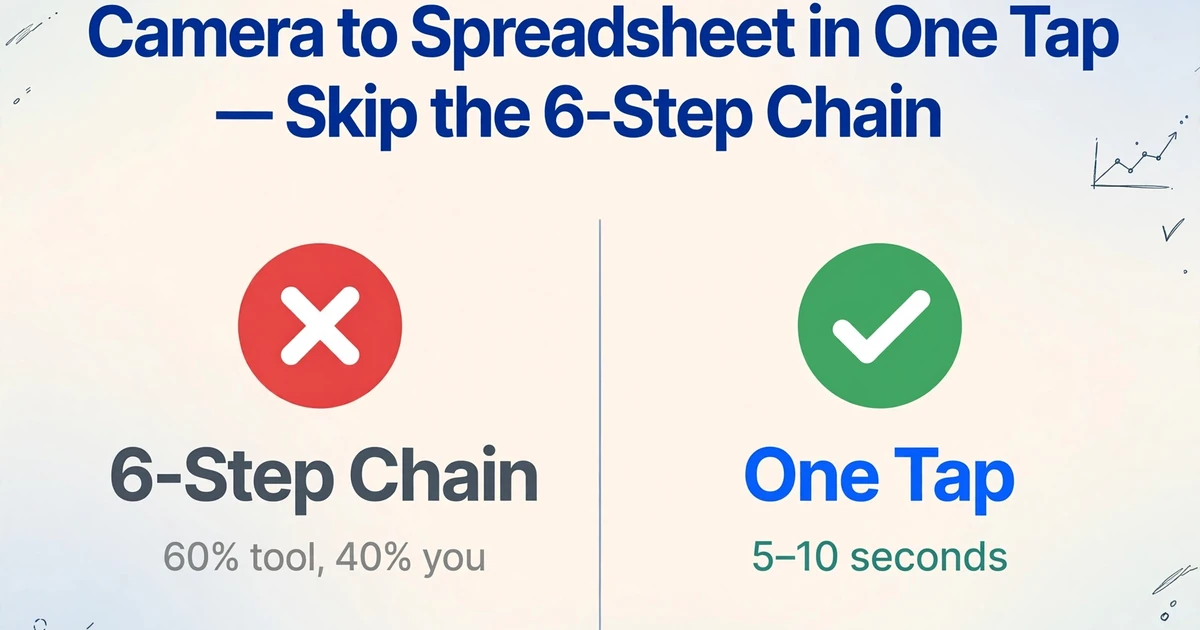
Points clés
- Convertir une photo en données de tableur prend actuellement six étapes — et pour dix documents, cela fait soixante points de transfert où les données se dégradent silencieusement.
- La chaîne existe non pas parce que la technologie l'exige, mais parce que chaque outil qu'elle contient — appareil photo, e-mail, OCR, Excel — a été conçu pour sa propre tâche, sans connaissance de ce dont l'outil suivant a besoin.
- Réduisez la chaîne : prenez une photo, nommez vos colonnes, téléchargez le tableur. Les cinq étapes intermédiaires disparaissent quand une IA lit le document et écrit le résultat.
La chaîne en six étapes qui ne devrait pas exister
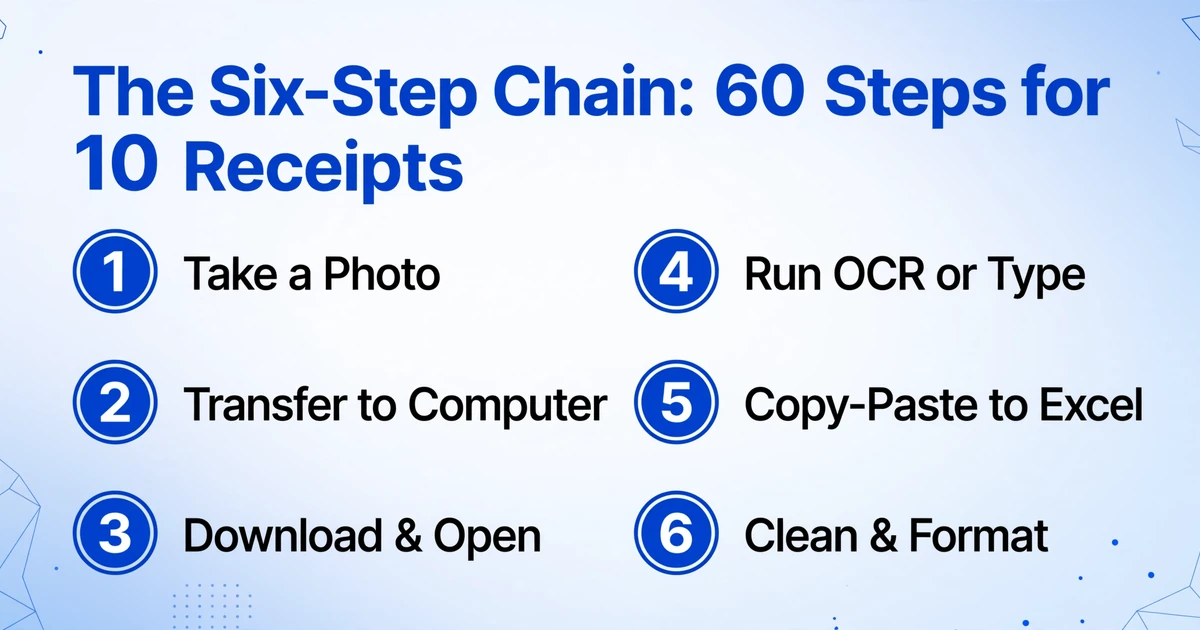
La plupart des gens transforment un document papier en données de tableur de la même manière qu'il y a dix ans. Voici la chaîne, étape par étape :
Multipliez maintenant cette chaîne par le nombre de documents que vous traitez en une semaine. Dix reçus ? Soixante étapes. Trente factures ? Cent quatre-vingts étapes. Chaque étape est petite. Collectivement, elles représentent une part substantielle de votre journée de travail qui n'a rien à voir avec votre métier.
Le coût ne réside dans aucune étape en particulier. Il réside dans le coût de passage entre elles — le changement de contexte mental du téléphone à l'e-mail, au bureau, à l'OCR, puis au tableur, chacun étant un point où votre attention se brise et où votre après-midi s'écoule.
Où chaque maillon échoue
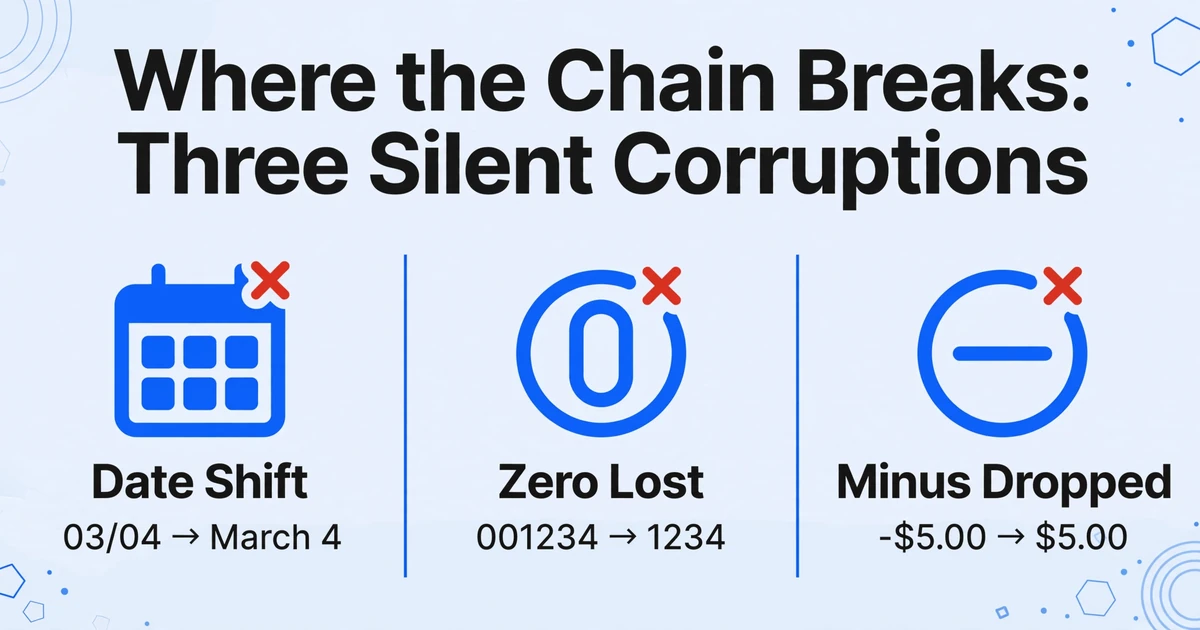
Prises isolément, aucune des six étapes ne semble défaillante. Mais chacune introduit un mode de défaillance précis qui s'accumule :
| Étape | Ce que vous faites | Ce qui ne va pas |
|---|---|---|
| Photo → Transfert | Envoyer la photo par e-mail | Certains clients de messagerie compressent les images. Ce qui arrive est de résolution inférieure à ce que vous avez pris — et des documents plus flous produisent de moins bons résultats OCR. |
| Transfert → Téléchargement | Ouvrir l'e-mail, télécharger la pièce jointe | Vous avez maintenant deux copies : une sur votre téléphone, une sur votre ordinateur. Si vous reprenez la photo plus tard, le cycle recommence. |
| Téléchargement → OCR | Ouvrir dans un outil d'extraction | L'OCR traditionnel produit tout le texte de la page en un bloc. Vous ne voulez pas « Nom du magasin : 7-Eleven, Adresse : 123 Main St, Caissier : #4521 » — vous voulez le total et la date. L'OCR ne fait pas la différence. |
| OCR → Copier-coller | Copier les résultats dans Excel | Excel applique un formatage automatique au collage. Une date comme « 03/04 » peut devenir le 4 mars. Un numéro de reçu comme « 001234 » devient « 1234 ». Un montant négatif perd son signe moins. Chacun est une corruption silencieuse — vous ne le saurez qu'en vérifiant. |
| Copier-coller → Nettoyage | Corriger et mettre en forme | Vous faites maintenant de la saisie de données avec des étapes supplémentaires. Le temps gagné grâce à l'OCR est consacré au nettoyage. |
Ces défaillances ont une racine commune : chaque outil de la chaîne a été conçu pour son propre travail, pas pour celui de transformer une photo en feuille de calcul. L'appareil photo prend des images. L'e-mail livre des messages. L'OCR lit du texte. Aucun ne sait ce dont l'outil suivant a besoin. Chaque transfert est une jointure où les données se dégradent.
C'est pourquoi les fils Reddit regorgent d'utilisateurs qui ont abandonné la fonctionnalité « Données à partir d'une image » d'Excel après l'avoir trouvée bloquée indéfiniment ou indisponible dans leur version d'Office. La fonctionnalité existe, mais en dépendre signifie qu'une panne des serveurs Microsoft suffit à vous priver de tout flux de travail — et même lorsqu'elle fonctionne, elle ne gère que des tableaux rigides, pas les documents à structure libre que la plupart des gens traitent réellement.
En un geste : le flux de travail de l'appareil photo au tableur
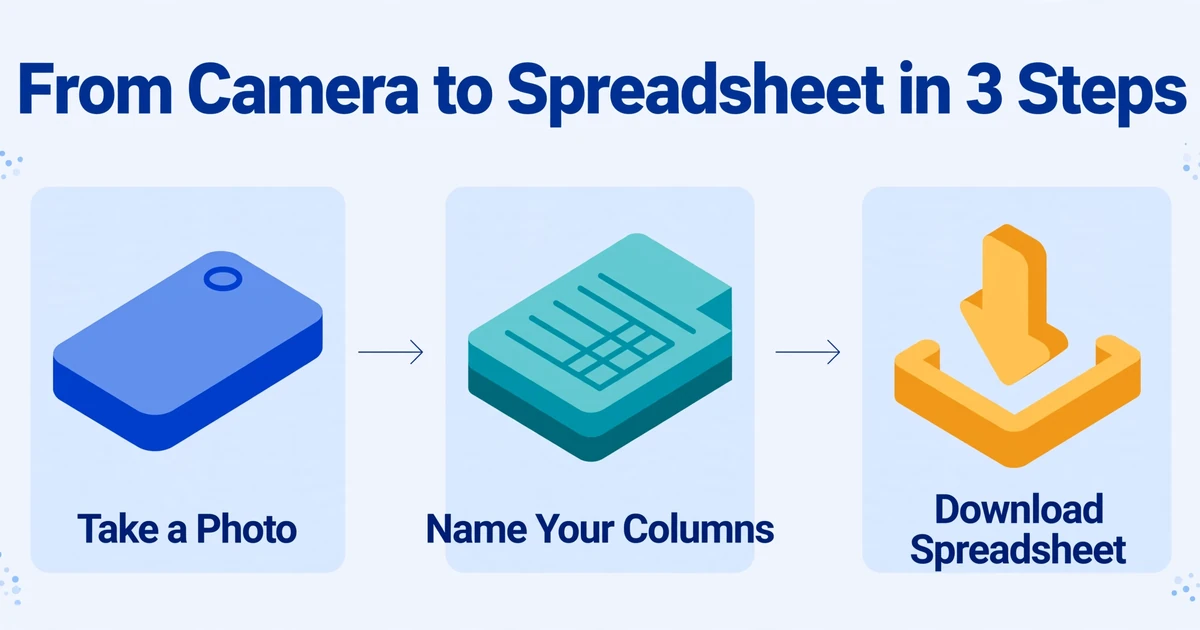
L'alternative est plus simple, non pas parce qu'elle constitue une meilleure version de la même chaîne, mais parce qu'elle supprime entièrement cette chaîne. Voici le nouveau flux de travail :
Prenez une photo
Utilisez l'appareil photo de votre téléphone. Aucune application spéciale, aucun angle particulier. Il suffit d'une photo nette du document.
Nommez vos colonnes
Ouvrez votre navigateur, importez la photo et saisissez les noms de colonnes souhaités : « Date », « Montant », « Fournisseur ».
Téléchargez le tableur
L'IA extrait les données correspondantes dans un fichier Excel ou CSV structuré. Un clic pour télécharger. Prêt à l'emploi.
Et voilà. La photo ne quitte jamais votre téléphone : pas d'e-mail, pas de câble, pas d'intermédiaire via un dossier cloud. L'import se fait directement depuis votre navigateur. Le résultat est déjà un tableur, et non un bloc de texte à analyser manuellement.
Le gain de temps est mesurable. La saisie manuelle d'un seul document — lire chaque champ, le taper dans la bonne cellule, vérifier les fautes de frappe — prend en moyenne environ 3 minutes pour un reçu ou un formulaire type. Le parcours en trois étapes, de l'appareil photo au tableur, ne mobilise que 5 à 10 secondes de votre attention, sans compter les quelques secondes que l'IA consacre au traitement en arrière-plan. Pour un lot de 10 reçus, cela représente 30 minutes contre moins d'une minute de votre temps.
Vous définissez la sortie. L'IA lit le document.
Ce qui rend ce nouveau flux de travail possible, c'est un changement dans la façon dont l'extraction fonctionne. L'OCR traditionnel lit tout ce qui se trouve sur la page et le déverse — un mur de texte que vous devez ensuite fouiller pour trouver les un ou deux champs qui vous intéressent vraiment. Le mécanisme central ici est différent : Extraction de colonnes personnalisées.
Voici comment cela fonctionne : au lieu que l'outil décide quoi extraire, c'est vous qui le lui dites. Vous saisissez les noms de colonnes souhaités — « Total du reçu », « Date de transaction », « Nom du fournisseur » — et l'IA localise les données correspondantes sur n'importe quel document en comprenant ce que chaque champ signifie, et non où il se trouve. Un « Total » sur un reçu peut être en bas à droite en gras ; sur un autre, il peut être au milieu de la page à côté d'une étiquette. La position n'a pas d'importance. Le sens, oui.
C'est la différence entre l'extraction basée sur la position (dessiner un cadre autour du champ, espérer que le document suivant le place dans le même cadre) et l'extraction basée sur l'intention (dire à l'IA ce que vous cherchez, et elle le trouve où qu'il se trouve). Aucun modèle à maintenir. Aucune configuration par fournisseur. Si un fournisseur redessine la mise en page de ses reçus demain, rien ne casse — car la mise en page n'a jamais fait partie de l'équation.
Cela signifie aussi que l'outil gère des documents que l'OCR traditionnel et les applications de capture de tableaux ne peuvent pas traiter. Une note manuscrite avec un montant en dollars griffonné dans le coin. Une capture d'écran d'une confirmation de commande en ligne. Un formulaire dont les champs sont dispersés sur la page plutôt que disposés en grille. L'IA lit le document comme le ferait une personne — en comprenant le contenu, pas en comptant les pixels.
Démonstration : de la photo à Excel en moins d'une minute
Voici à quoi ressemble l'interface réelle, du moment où vous ouvrez la page à celui où vous téléchargez votre feuille de calcul.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Vous arrivez sur la page. Aucune inscription n'est requise. La zone de téléversement est au centre — touchez-la pour sélectionner une photo dans votre galerie, ou prenez-en une avec votre appareil photo directement. Le fichier se téléverse en quelques secondes.
Sous la zone de téléversement se trouve la saisie des colonnes. C'est ici que vous tapez ce que vous voulez : « Date », « Montant », « Fournisseur ». Chaque nom de colonne devient un en-tête de colonne dans votre feuille de calcul finale. Vous pouvez ajouter autant de colonnes que nécessaire, ou très peu. Si vous ne savez pas quoi extraire, l'outil peut lire le document et suggérer automatiquement des noms de colonnes.
Une fois vos colonnes nommées, appuyez sur le bouton de traitement. L'IA lit votre document, trouve les valeurs correspondant à chaque nom de colonne et assemble le résultat. Quelques secondes plus tard, un tableau s'affiche à l'écran — chaque ligne correspond à un document, chaque colonne à l'un des champs demandés. Appuyez sur Télécharger et vous obtenez un fichier Excel, prêt à l'emploi.
Aucune étape de ce processus ne nécessite d'ordinateur de bureau. Aucune étape ne nécessite l'installation d'une application. Tout se passe dans le navigateur de votre téléphone, en une seule session, sans laisser de données derrière.
Tout document. Tout format. Toute situation.
Le flux de travail n'est lié à aucun type de document unique. Parce que l'IA lit les documents de manière sémantique — en comprenant le contenu plutôt qu'en faisant correspondre un modèle — elle fonctionne sur tous les formats qui exigeraient chacun un outil distinct dans l'approche traditionnelle :
Reçus
Notes de restaurant, reçus de station-service, confirmations de commandes en ligne. Un entrepreneur traitant 20 reçus provenant de différents magasins de bricolage et fournisseurs peut tous les traiter en un seul tableur — chaque reçu ayant sa propre mise en page, traitée de la même manière.
Formulaires manuscrits
Listes de contrôle d'inspection, feuilles de présence, rapports de terrain griffonnés sur papier carbone. L'écriture manuscrite avec laquelle l'OCR traditionnel a du mal devient extractible parce que l'IA lit le document de manière holistique — en utilisant le contexte visuel, pas seulement la reconnaissance de caractères.
Cartes d'identité et captures d'écran
Une photo d'un permis de conduire ou d'une carte d'identité. Une capture d'écran d'une page de confirmation de paiement. Un profil LinkedIn capturé en image. Toute image contenant des données dont vous avez besoin dans un format structuré.
Documents numérisés et PDF
PDF multipages, contrats numérisés, documents hérités numérisés à partir d'un scanner à plat. Le flux de travail les traite de la même manière que les photos — aucune différence de traitement.
Pour les scénarios où plusieurs personnes doivent soumettre des documents dans un seul tableur — notes de frais de membres d'équipe, feuilles de temps de travailleurs de terrain, factures de fournisseurs — il existe une couche supplémentaire : un Lien de collecte. Il génère une URL simple que vous pouvez partager. Les destinataires l'ouvrent, saisissent un court code de vérification et téléversent leurs documents directement. Les fichiers arrivent automatiquement dans votre file de traitement. Ils n'ont jamais besoin de créer un compte. Le flux de travail complet est détaillé dans notre guide sur la collecte de données sur le terrain avec photo vers Excel.
FAQ
Quelle est la précision de l'extraction à partir d'une photo prise avec un téléphone ?
Pour du texte imprimé sur une photo raisonnablement nette — prise de face avec un bon éclairage — la précision atteint 99 %. Celle de l'écriture manuscrite est plus faible, généralement entre 85 et 92 %, et dépend fortement de la lisibilité. Une photo prise de biais, en faible luminosité ou avec des ombres marquées réduit la précision. Les meilleurs résultats s'obtiennent en tenant le téléphone directement au-dessus du document avec un éclairage uniforme. Aucun équipement spécial requis — juste une main stable.
Dois-je installer une application spéciale ?
Non. Tout le processus s'exécute dans le navigateur de votre téléphone — Chrome, Safari, Firefox, tout navigateur moderne fonctionne. Pas d'application à télécharger ni de logiciel à installer sur votre ordinateur. C'est l'une des principales différences avec des outils comme « Données à partir d'une image » d'Excel, qui nécessitent l'application mobile Microsoft 365 et un abonnement payant.
Et si mon document n'a pas de mise en page en tableau ?
C'est justement l'intérêt. La plupart des outils d'extraction de documents, y compris la fonction intégrée d'Excel pour convertir une image en tableau, sont conçus pour des données déjà organisées en lignes et colonnes — tableaux imprimés, listes de prix, grilles structurées. L'extraction par colonnes personnalisées fonctionne sur des documents libres : un reçu dont le total est dans un coin et la date en haut, un formulaire dont les champs sont dispersés sur la page. L'IA lit le document de manière sémantique, pas géométrique.
Combien de documents puis-je traiter à la fois ?
Vous pouvez télécharger et traiter plusieurs fichiers en un seul lot — 10 reçus, 30 factures, 50 formulaires — et recevoir un fichier Excel fusionné avec une ligne par document. C'est le mode de traitement par lots. Les téléchargements gratuits pour les invités ont des limites quotidiennes et de nombre de fichiers ; les utilisateurs inscrits ont des limites plus élevées selon leur forfait.
Que deviennent mes documents après le traitement ?
Les fichiers téléchargés sont traités puis automatiquement supprimés du serveur. L'outil ne stocke ni ne conserve vos documents. Le fichier de sortie vous appartient et peut être téléchargé et conservé — rien ne reste sur le serveur après le traitement.
Cela fonctionne-t-il pour des documents dans d'autres langues que l'anglais ?
Oui. L'IA lit les documents dans plusieurs langues, dont le japonais, l'allemand, le français, l'espagnol, le portugais et le coréen. Les noms de colonnes doivent être rédigés dans la langue que vous souhaitez faire correspondre — si votre document est en allemand et que vous cherchez « Rechnungsbetrag », nommez cette colonne en allemand.
Puis-je utiliser cet outil pour extraire des données d'une capture d'écran plutôt que d'une photo ?
Oui. Les captures d'écran fonctionnent exactement comme les photos — une capture d'écran d'une page web, d'un PDF ouvert sur votre écran ou d'une page de confirmation d'application peut être téléchargée et traitée dans le même processus. L'outil ne fait pas de distinction entre une photo prise avec un appareil photo et une capture d'écran.
La chaîne en six étapes, de l'appareil photo au tableur, n'est pas une exigence de la technologie — c'est une exigence d'une chaîne d'outils où aucun outil ne communique avec un autre. Quand la même IA qui lit le document écrit aussi le tableur, ces cinq étapes intermédiaires disparaissent. Il ne reste plus que : viser, nommer, télécharger.
La photo qui traîne dans votre galerie en ce moment — le reçu, le formulaire, la capture d'écran que vous comptiez traiter plus tard — c'est là que commence la chaîne en six étapes. Essayez plutôt la version en trois étapes. Vous saurez en moins d'une minute si elle fonctionne pour vos documents.