カメラからスプレッドシートへワンタップ
完全ワークフロー
撮ったばかりのレシートの写真が、行き場を失っています。写真はスマホのギャラリーに、スプレッドシートはパソコンに。その間には、誰も望まなかった6つのステップがあり、その半分は便利さではなくエラーを生み出します。ここでは、その6ステップを1つにまとめるワークフローをご紹介します。
主なポイント
- 写真をスプレッドシートデータに変換するには現在6ステップかかり、10件の書類なら60回の受け渡しポイントでデータが静かに劣化していきます。
- この連鎖が存在するのは技術がそれを要求するからではなく、カメラ、メール、OCR、Excelといった各ツールが次のツールのニーズを知らずに、それぞれの役割のために作られているからです。
- 連鎖をまとめましょう。写真を撮り、列に名前を付け、スプレッドシートをダウンロードするだけ。1つのAIが書類を読み取って出力を書き出せば、中間の5ステップは消えます。
存在すべきでない6ステップの連鎖
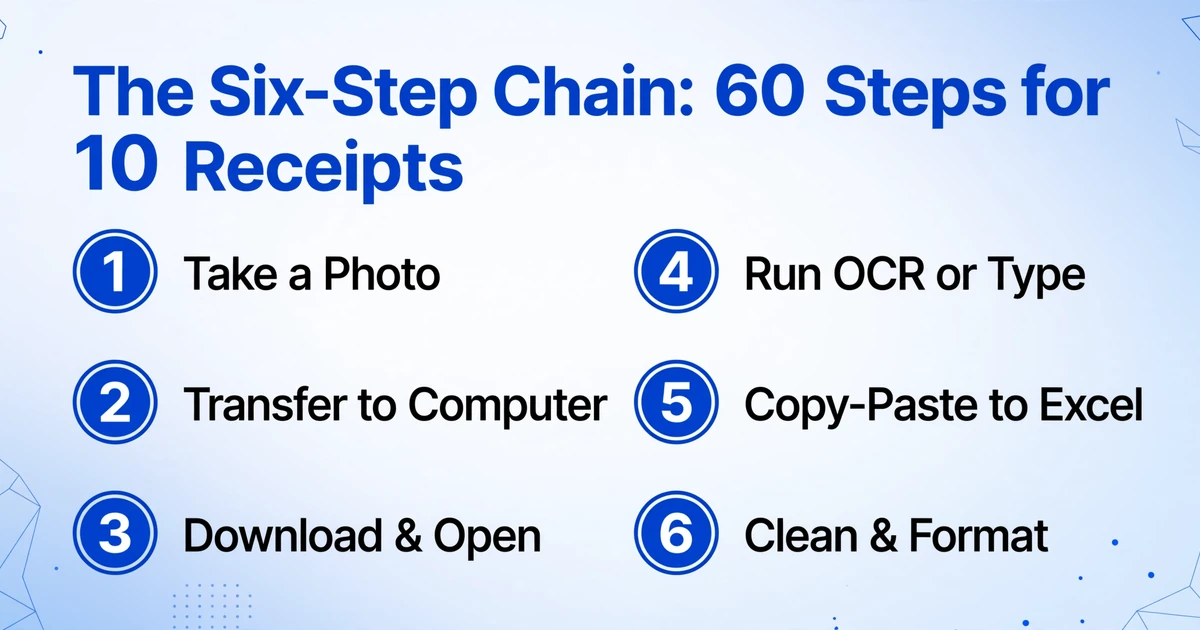
ほとんどの人は、10年前と同じ方法で紙の書類をスプレッドシートのデータに変換しています。その連鎖を順を追って見てみましょう。
では、この連鎖を1週間に処理する書類の数だけ掛け合わせてみましょう。レシート10枚なら60ステップ。請求書30枚なら180ステップ。一つひとつのステップは小さなものです。しかし積み重なると、本来の仕事とは無関係な作業に勤務時間の大部分が奪われていきます。
コストは個々のステップにあるのではありません。ステップ間の切り替えコストにあります — スマートフォンからメール、デスクトップ、OCR、スプレッドシートへと移るたびに頭のコンテキストが切り替わり、その一つひとつで集中が途切れ、午後の時間が消えていきます。
各リンクが失敗する場所
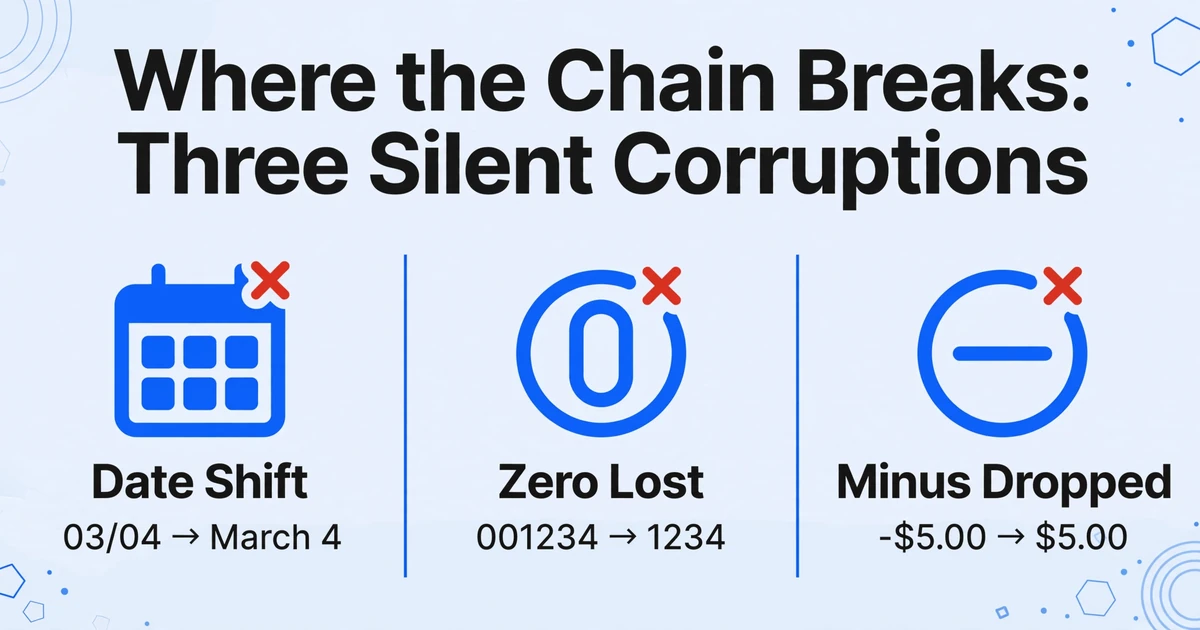
個別に見れば、6つのステップのどれも壊れてはいません。しかし、それぞれが固有の失敗モードを引き起こし、それが積み重なっていきます:
| ステップ | やること | うまくいかない点 |
|---|---|---|
| 写真 → 転送 | 自分宛に写真をメール送信 | 一部のメールクライアントは画像を圧縮します。届く画像は撮影時より低解像度になり、ぼやけたドキュメントほどOCRの結果が悪くなります。 |
| 転送 → ダウンロード | メールを開き、添付ファイルをダウンロード | これでコピーが2つになります。1つはスマートフォン、もう1つはデスクトップ。後で写真を撮り直すと、このサイクルがまた最初から始まります。 |
| ダウンロード → OCR | 抽出ツールで開く | 従来のOCRはページ上のすべてのテキストを一塊として出力します。必要なのは「店名:7-Eleven、住所:123 Main St、レジ担当:#4521」ではなく、合計金額と日付です。OCRはその違いがわかりません。 |
| OCR → コピー&ペースト | 結果をExcelにコピー | Excelは貼り付け時に自動書式設定します。「03/04」のような日付が3月4日になることがあります。「001234」のようなレシート番号が「1234」になります。マイナスの金額はマイナス記号を失います。いずれも静かな破損であり、確認するまで気づきません。 |
| コピー&ペースト → クリーンアップ | 修正と書式設定 | これは実質、余分な手間のかかるデータ入力です。OCRで節約した時間は、クリーンアップに費やされます。 |
これらの失敗には共通の根本原因があります:チェーン内のすべてのツールは、写真をスプレッドシートに変換するという仕事ではなく、それぞれ自身の仕事のために設計されているのです。カメラは写真を撮ります。メールはメッセージを届けます。OCRはテキストを読み取ります。どれも次のツールが何を必要としているかを知りません。各受け渡しは、データが劣化する継ぎ目です。
だからこそ、Redditのスレッドには、Excelの「画像からデータ」機能がいつまでも応答しない、あるいは自分のOfficeのバージョンでは利用できないと気づいて、この機能を諦めたユーザーであふれています。この機能は存在しますが、それに依存するということは、Microsoftのサーバー障害が一度起きるだけでワークフローが完全に失われることを意味します。そして、たとえ動作しても、扱えるのは硬直的な表だけであり、ほとんどの人が実際に対処している自由形式のドキュメントではありません。
ワンタップ:カメラからスプレッドシートへのワークフロー
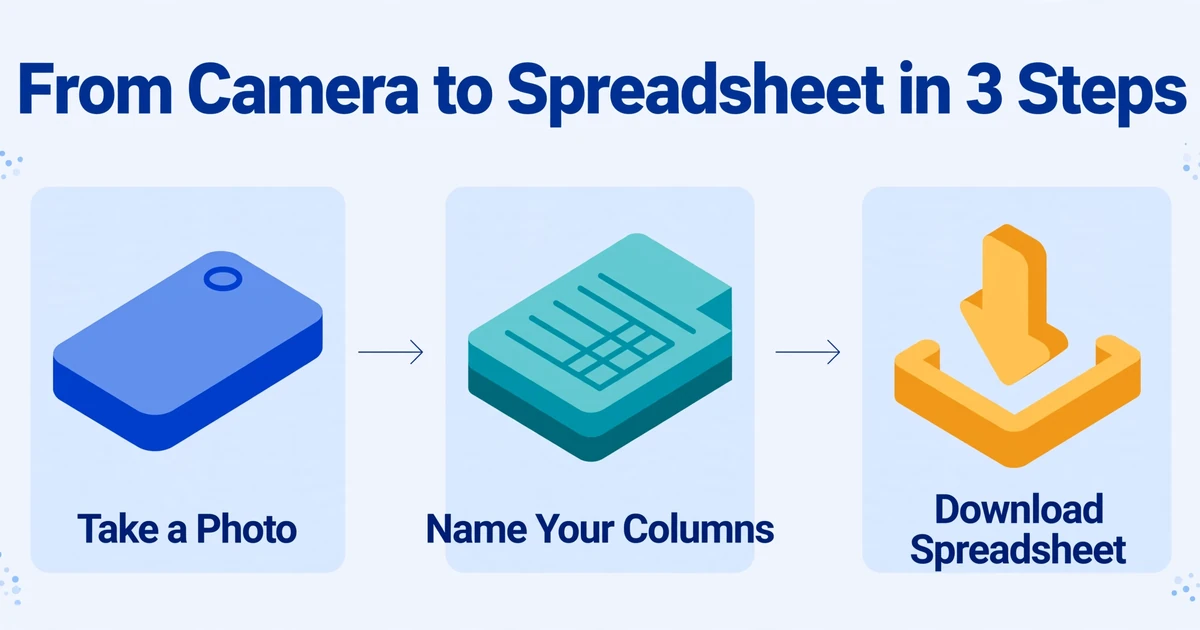
もう一方の方法がよりシンプルなのは、同じ流れを改良したものだからではなく、その流れ自体をなくすからです。新しいワークフローは次のとおりです。
写真を撮る
スマートフォンのカメラを使います。専用アプリも、特定の角度も不要。ドキュメントをはっきり撮影するだけです。
列に名前を付ける
ブラウザを開いて写真をアップロードし、必要な列名を入力します — 「日付」「金額」「取引先」など。
スプレッドシートをダウンロード
AIが該当するデータを抽出し、構造化されたExcelまたはCSVファイルに変換します。ワンクリックでダウンロード。すぐに使えます。
これだけです。写真がスマートフォンから出ることはありません — メールも、ケーブルも、クラウドフォルダという中間役も不要です。アップロードはブラウザから直接行われます。出力はすでにスプレッドシートであり、手作業で解析が必要なテキストの塊ではありません。
時間の節約効果は測定できます。1件のドキュメントを手作業で入力する場合 — 各フィールドを読み、正しいセルに入力し、タイプミスを確認する — 一般的なレシートやフォームで平均約3分かかります。カメラからスプレッドシートへの3ステップなら、AIがバックグラウンドで処理する数秒を除けば、あなたの注意力は5〜10秒で済みます。レシート10件のバッチなら、30分対1分未満の差になります。
出力はあなたが定義。AIが文書を読み取ります。
この新しいワークフローを可能にするのは、抽出の仕組みの変化です。従来のOCRはページ上のすべてを読み取り、そのまま出力します——後から必要な1つか2つのフィールドを探し出すためのテキストの壁です。ここでの核となる仕組みは異なります:カスタム列抽出です。
仕組みはこうです:ツールが何を抽出するかを決めるのではなく、あなたが指示します。必要な列名を入力します——「領収書合計」「取引日」「仕入先名」——するとAIは、各フィールドが意味する内容を理解することで、あらゆる文書から該当データを見つけ出します。位置ではなく意味です。ある領収書の「合計」は右下隅に太字であるかもしれません。別のものでは、ラベルの隣のページ中央にあるかもしれません。位置は関係ありません。意味が重要なのです。
これが位置ベース抽出(フィールドの周りにボックスを描き、次の文書が同じボックスに入ることを期待する)と意図ベース抽出(探しているものをAIに伝えれば、それがどこに現れても見つけてくれる)の違いです。維持するテンプレートはありません。ベンダーごとの設定もありません。サプライヤーが明日、領収書のレイアウトを再設計しても、何も壊れません——レイアウトはそもそも計算に入っていなかったからです。
これはまた、従来のOCRやテーブルスナップアプリが扱えない文書もこのツールが処理できることを意味します。隅に金額が走り書きされた手書きメモ。オンライン注文確認のスクリーンショット。フィールドがグリッド状ではなくページ全体に散らばっているフォーム。AIは、ピクセルを数えるのではなく、内容を理解することで、人間と同じように文書を読み取ります。
ウォークスルー:写真からExcelまで1分未満
ページを開いた瞬間からスプレッドシートをダウンロードする瞬間までの、実際のインターフェースは次のとおりです。
ファイルは安全に処理され、保存されません。
ページにアクセスします。サインアップは不要です。アップロードエリアは中央にあります——タップしてギャラリーから写真を選ぶか、その場でカメラで撮影します。ファイルは数秒でアップロードされます。
アップロードエリアの下が列入力です。ここで「日付」「金額」「仕入先」など、必要なものを入力します。各列名は最終的なスプレッドシートの列ヘッダーになります。必要な列はいくつでも追加できます。何を抽出すればよいかわからない場合は、ツールが文書を読み取って列名を自動的に提案します。
列名を設定したら、処理ボタンをタップします。AIがドキュメントを読み取り、各列名に一致する値を探し出して結果を組み立てます。数秒後、画面にテーブルが表示されます。各行がドキュメント、各列が指定したフィールドです。ダウンロードをタップすれば、すぐに使えるExcelファイルが手に入ります。
このプロセスのどのステップでもデスクトップコンピューターは不要です。アプリのインストールも不要です。すべてスマートフォンのブラウザ上で、単一セッション内で完結し、データは何も残りません。
あらゆるドキュメント。あらゆる形式。あらゆるシーン。
このワークフローは特定のドキュメントタイプに依存しません。AIがドキュメントを意味的に読み取るため(テンプレートに合わせるのではなく内容を理解するため)、従来の方法ではそれぞれ別のツールが必要だった形式にも対応できます。
レシート
飲食店の請求書、ガソリンスタンドのレシート、オンライン注文の確認書。異なるホームセンターや仕入先からのレシート20枚を処理する業者は、それぞれレイアウトが異なるレシートをすべて1つのスプレッドシートにまとめて、同じ方法で処理できます。
手書きフォーム
点検チェックリスト、受付簿、カーボン紙に走り書きされた現場報告書。従来のOCRでは処理が難しかった手書き文字も、AIがドキュメントを全体として読み取るため抽出可能になります。文字認識だけでなく、視覚的な文脈も活用するからです。
身分証明書とスクリーンショット
運転免許証や身分証明書の写真。支払い確認ページのスクリーンショット。画像として保存したLinkedInのプロフィールページ。構造化された形式で必要なデータを含む画像であれば、すべて対応します。
スキャン文書とPDF
複数ページのPDF、スキャンした契約書、フラットベッドスキャナーでデジタル化した旧式の書類。このワークフローは写真と同じ方法で処理するため、処理の違いはありません。
複数の人が1つのスプレッドシートにドキュメントを提出する必要があるシナリオ(チームメンバーからの経費報告書、現場作業員からのタイムシート、ベンダーからの請求書など)には、追加のレイヤーがあります:コレクションリンクです。共有可能なシンプルなURLが生成されます。受け取った人はそのURLを開き、短い確認コードを入力して、ドキュメントを直接アップロードします。ファイルは自動的に処理キューに追加されます。アカウントを作成する必要はありません。完全なワークフローは、写真からExcelへのフィールドデータ収集のガイドで詳しく説明しています。
よくある質問
スマホで撮った写真からの抽出精度は?
印刷された文字で、適切な明るさで真上から撮影した場合、精度は最大99%です。手書き文字の精度は低く、通常85~92%程度で、読みやすさに大きく依存します。斜めからの撮影、暗い場所、強い影があると精度が低下します。最良の結果を得るには、スマホを書類の真上に構え、均一な照明を当ててください。特別な機材は不要で、手ブレしないことだけがポイントです。
専用アプリのインストールは必要?
いいえ。すべての処理はスマホのブラウザ(Chrome、Safari、Firefoxなど最新のブラウザ)上で完結します。ダウンロードするアプリも、デスクトップにインストールするソフトも一切不要です。これは、Microsoft 365のモバイルアプリと有料サブスクリプションが必要なExcelの「画像からデータ」などのツールとの大きな違いです。
書類が表形式でない場合は?
そこがポイントです。Excelの画像→表機能を含む多くの抽出ツールは、印刷された表や価格表、構造化されたグリッドなど、行と列に整理されたデータを前提としています。一方、カスタム列抽出は自由形式の書類に対応します。例えば、合計金額が隅に、日付が上部にあるレシートや、フィールドがページ全体に散らばっているフォームなどです。AIは書類を幾何学的ではなく、意味的に読み取ります。
一度に処理できる書類の数は?
複数ファイルを一括でアップロード・処理できます(レシート10枚、請求書30枚、フォーム50枚など)。処理後は、1行が1書類に対応する1つの結合Excelファイルが出力されます。これがバッチ処理モードです。無料ゲストのアップロードには1日あたりの上限とファイル数の上限があります。登録ユーザーはプランに応じてより高い上限で利用できます。
処理後の書類はどうなりますか?
アップロードされたファイルは処理後、自動的にサーバーから削除されます。本ツールは書類を保存・保持しません。出力されたスプレッドシートはお客様がダウンロードしてご自身で保管するもので、サーバー上には何も残りません。
英語以外の言語の書類でも使えますか?
はい。AIは日本語、ドイツ語、フランス語、スペイン語、ポルトガル語、韓国語など、複数の言語の書類を読み取ります。列名は抽出したい項目の言語で指定してください。例えば、ドイツ語の書類から「Rechnungsbetrag」を探す場合は、その列名をドイツ語で指定します。
写真ではなくスクリーンショットからも抽出できますか?
はい。スクリーンショットも写真と全く同様に処理できます。Webページのスクリーンショット、画面上で開いたPDF、アプリの確認画面なども、同じ手順でアップロード・処理可能です。本ツールはカメラ写真とスクリーンキャプチャを区別しません。
カメラからスプレッドシートに至る6つのステップは、技術的な要件ではなく、ツール同士が連携していないツールチェーンにおける必要条件です。書類を読み取るAIがスプレッドシートも作成するなら、中間の5ステップは消えます。残るのは「撮る」「指定する」「ダウンロードする」だけです。
今、あなたのギャラリーにある写真——レシート、フォーム、後で処理しようと思っていたスクリーンショット——それが6ステップの連鎖の始まりです。代わりに3ステップ版を試してみてください。1分以内に、それがあなたのドキュメントに合うかどうかがわかります。