パッキングスリップデータ抽出とは?
仕組みを解説
パッキングスリップデータ抽出とは、PDFやスキャンしたパッキングスリップから注文番号、出荷日、運送会社、商品説明、出荷数量、追跡番号などの主要な出荷項目を自動で読み取り、構造化されたスプレッドシートの行に変換するプロセスです。受入担当者が各スリップを開いて各項目を目視確認し、WMSに入力する手作業(1枚あたり2〜5分、項目あたり1〜3%のエラー率)を行う代わりに、ソフトウェアが文書全体を読み取り、どの明細行がどのカートンに属するかを理解し、受入検証にすぐ使えるスプレッドシートを出力します。
重要なポイント
- 受入担当者1人あたり、1シフトで3時間以上を費やして、目の前のパッキングスリップにすでに印刷されているデータを入力しています。
- 項目あたり1〜3%のエラー率では、40項目のパッキングスリップが33〜70%の確率で誤った数字を含んだままWMSに入力されることになります。その誤りは数週間後の次の在庫差異まで表面化しません。
- 入力作業をなくし、スリップをアップロードするだけで構造化データを取得できれば、受入チームは例外を検出する検証者となり、データ入力オペレーターとしてエラーを生み出すことはなくなります。
パッキングスリップデータ抽出とは実際には何か
パッキングスリップは請求書ではありません。そして、その違いこそがデータ抽出においてすべてを左右します。請求書は何が請求されているかを示すもので、価格、支払条件、税額が記載され、買掛金部門に送られます。パッキングスリップは箱の中身を示すもので、注文番号、出荷日、運送会社、請求先住所と送付先住所、そして梱包された内容の明細項目が記載されています。その送付先は倉庫の受け入れドックであり、そこで到着したものが到着予定だったものと一致するかを誰かが確認する必要があります。
同じ文書が異なる名称で流通しています。「パッキングスリップ」は米国の業務では標準的です。「パッキングリスト」は国際配送やカートン単位の詳細を含む文書に登場します。「デリバリーノート」は一部の業界で使用されますが、厳密にはこれは配送後に何が納品されたかを確認するものであり、パッキングスリップは出荷前に何が梱包されたかを記録するものです。実際には、受け入れチームは同じサプライヤーからこれら3種類すべてを受け取るため、抽出ツールはそれらを同一に処理する必要があります。
パッキングスリップ抽出ツールが取得するフィールドは、出荷ヘッダーフィールド(注文番号/SO番号、出荷日、運送会社、送付先/請求先、追跡番号、総重量)と明細項目(品目コード/SKU、説明、注文数量、出荷数量、バックオーダー数量、単位)の2つのグループに分けられます。パッキングスリップ抽出を請求書抽出から区別する構造上の課題は、各行に注文済み、出荷済み、バックオーダー済みという3つの数量列が存在することです。サプライヤーが100ユニット中80ユニットを出荷する場合、パッキングスリップは部分出荷を識別できるよう受け入れチームが3つの数値すべてを保持する必要があります。この技術が文書処理にどのように適合するかの全体像については、AI文書抽出の基礎をご覧ください。
パッキングスリップ抽出と手動倉庫データ入力の比較
初めて検索する人が本当に尋ねている質問は、「パッキングスリップのデータをWMSに入力し続ければいいのではないか」ということです。答えは「できない」ということではなく、サプライヤーのフォーマットが変わるたびにコストが累積するということです。
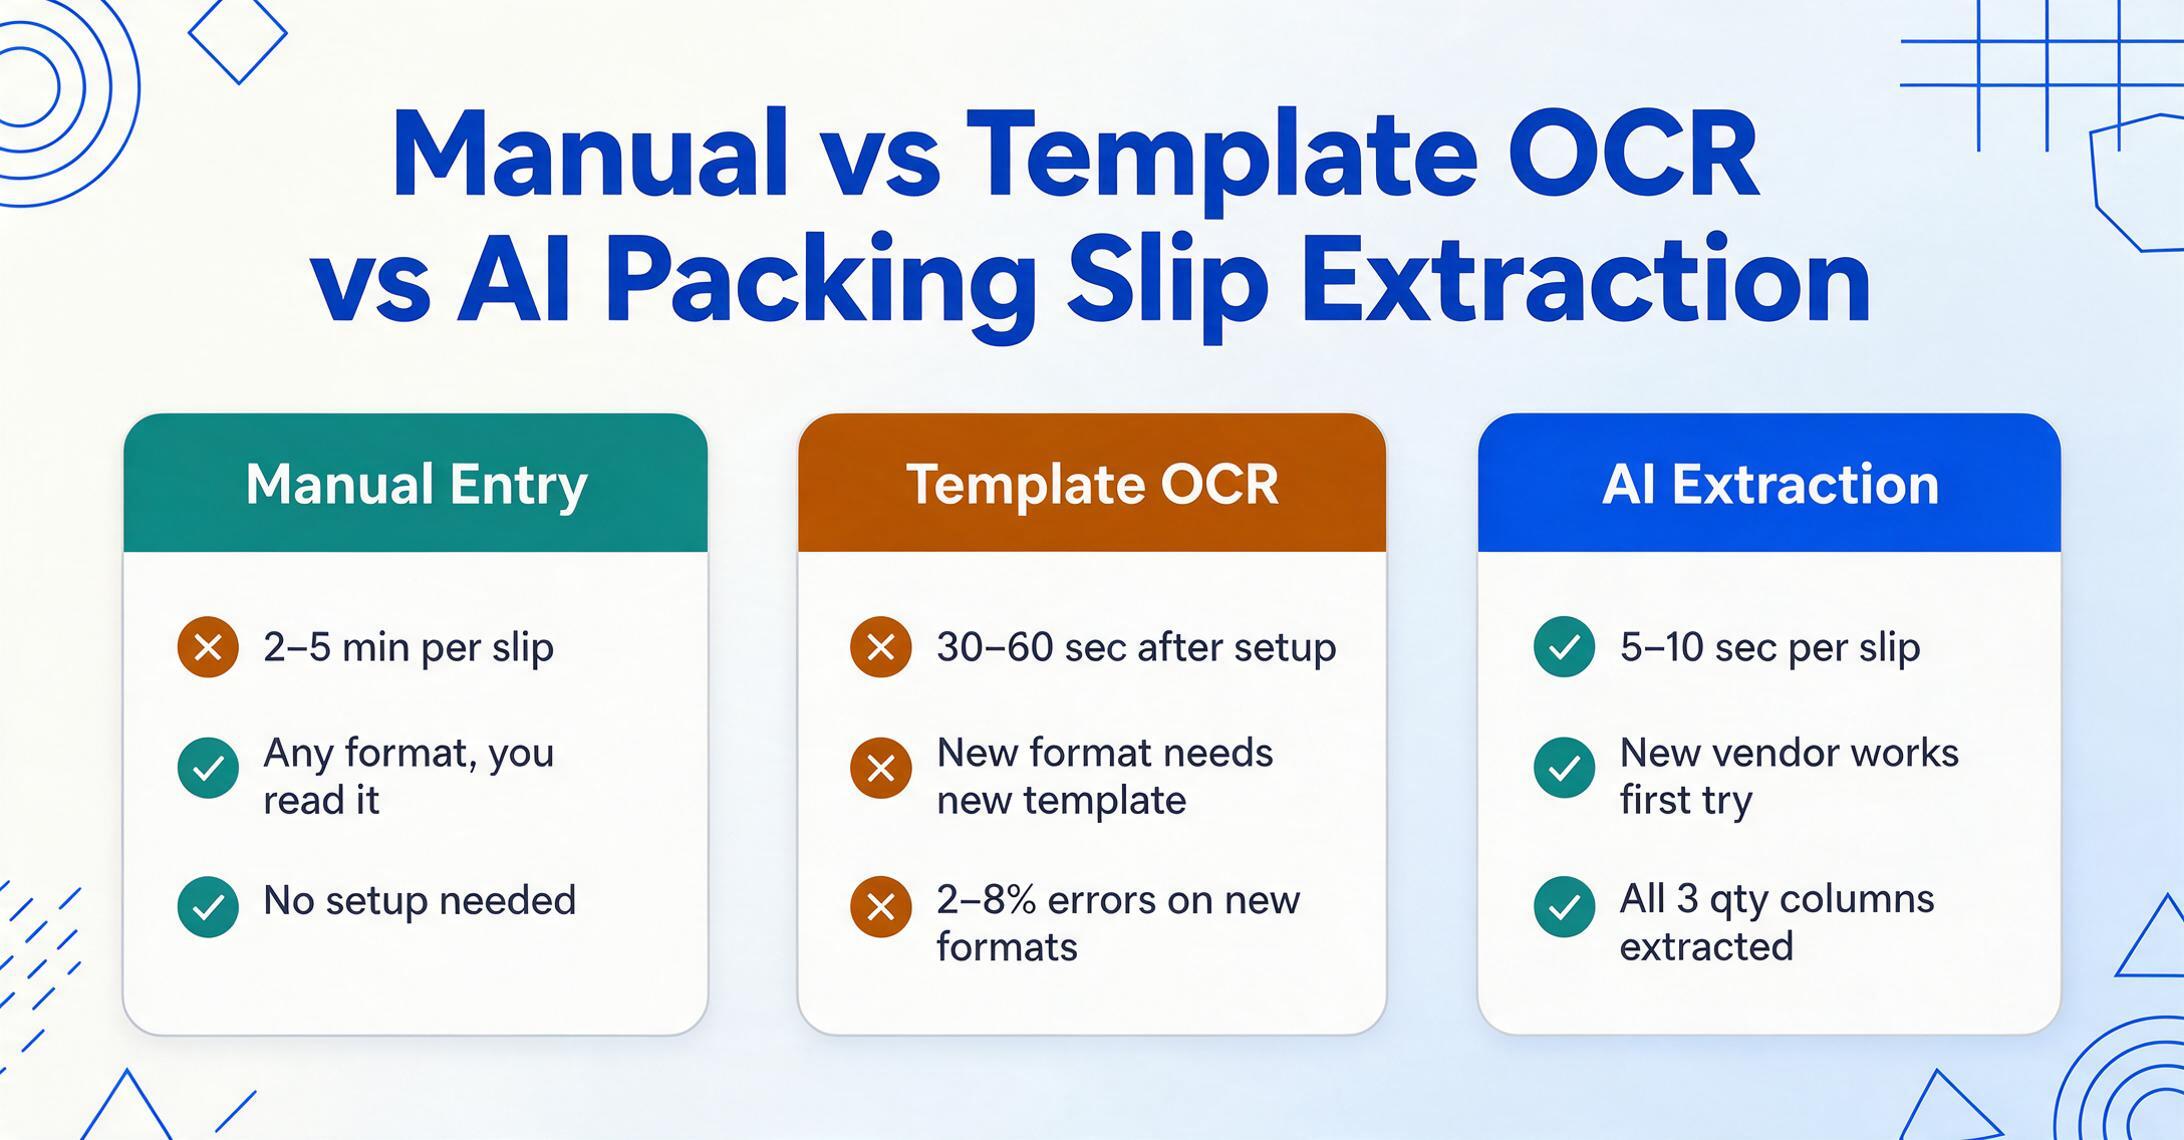
| 手動データ入力 | テンプレートベースOCR | AIパッキングスリップ抽出 | |
|---|---|---|---|
| スリップあたりの時間 | 2〜5分 | 30〜60秒(テンプレート作成後) | 5〜10秒 |
| 新しいサプライヤーフォーマット? | 対応可能(読み取るため) | 不可 — 新しいテンプレートが必要 | 対応可能 — 位置ではなく意味で読み取る |
| セットアップ | 不要 | フォーマットごとに1つのテンプレート | 不要 — 列タイプを一度設定するだけ |
| エラー率(フィールドあたり) | 1〜3% | 2〜8%(フォーマット依存) | 1〜5%(確認可能) |
| 部分出荷の処理 | POとの手動比較 | テンプレート依存 | 自動 — 3つの数量列すべてを抽出 |
WERCの2024年倉庫・フルフィルメントコスト調査によると、入庫コストは1時間あたり$40.79、SKUあたり$2.50です。APQCのベンチマークでは、ドックから在庫までのサイクルタイムに上位と下位の間で44.1時間の差があり、その主な要因はフォークリフトの速度ではなく、「商品到着」から「在庫更新」までの間にデータがどれだけ滞留するかです。手動でのパッキングスリップ処理にかかるコストの詳細な分析については、スリップあたり・シフトあたりの手動入力コストの内訳をご覧ください。
パッキングスリップデータ抽出の仕組み
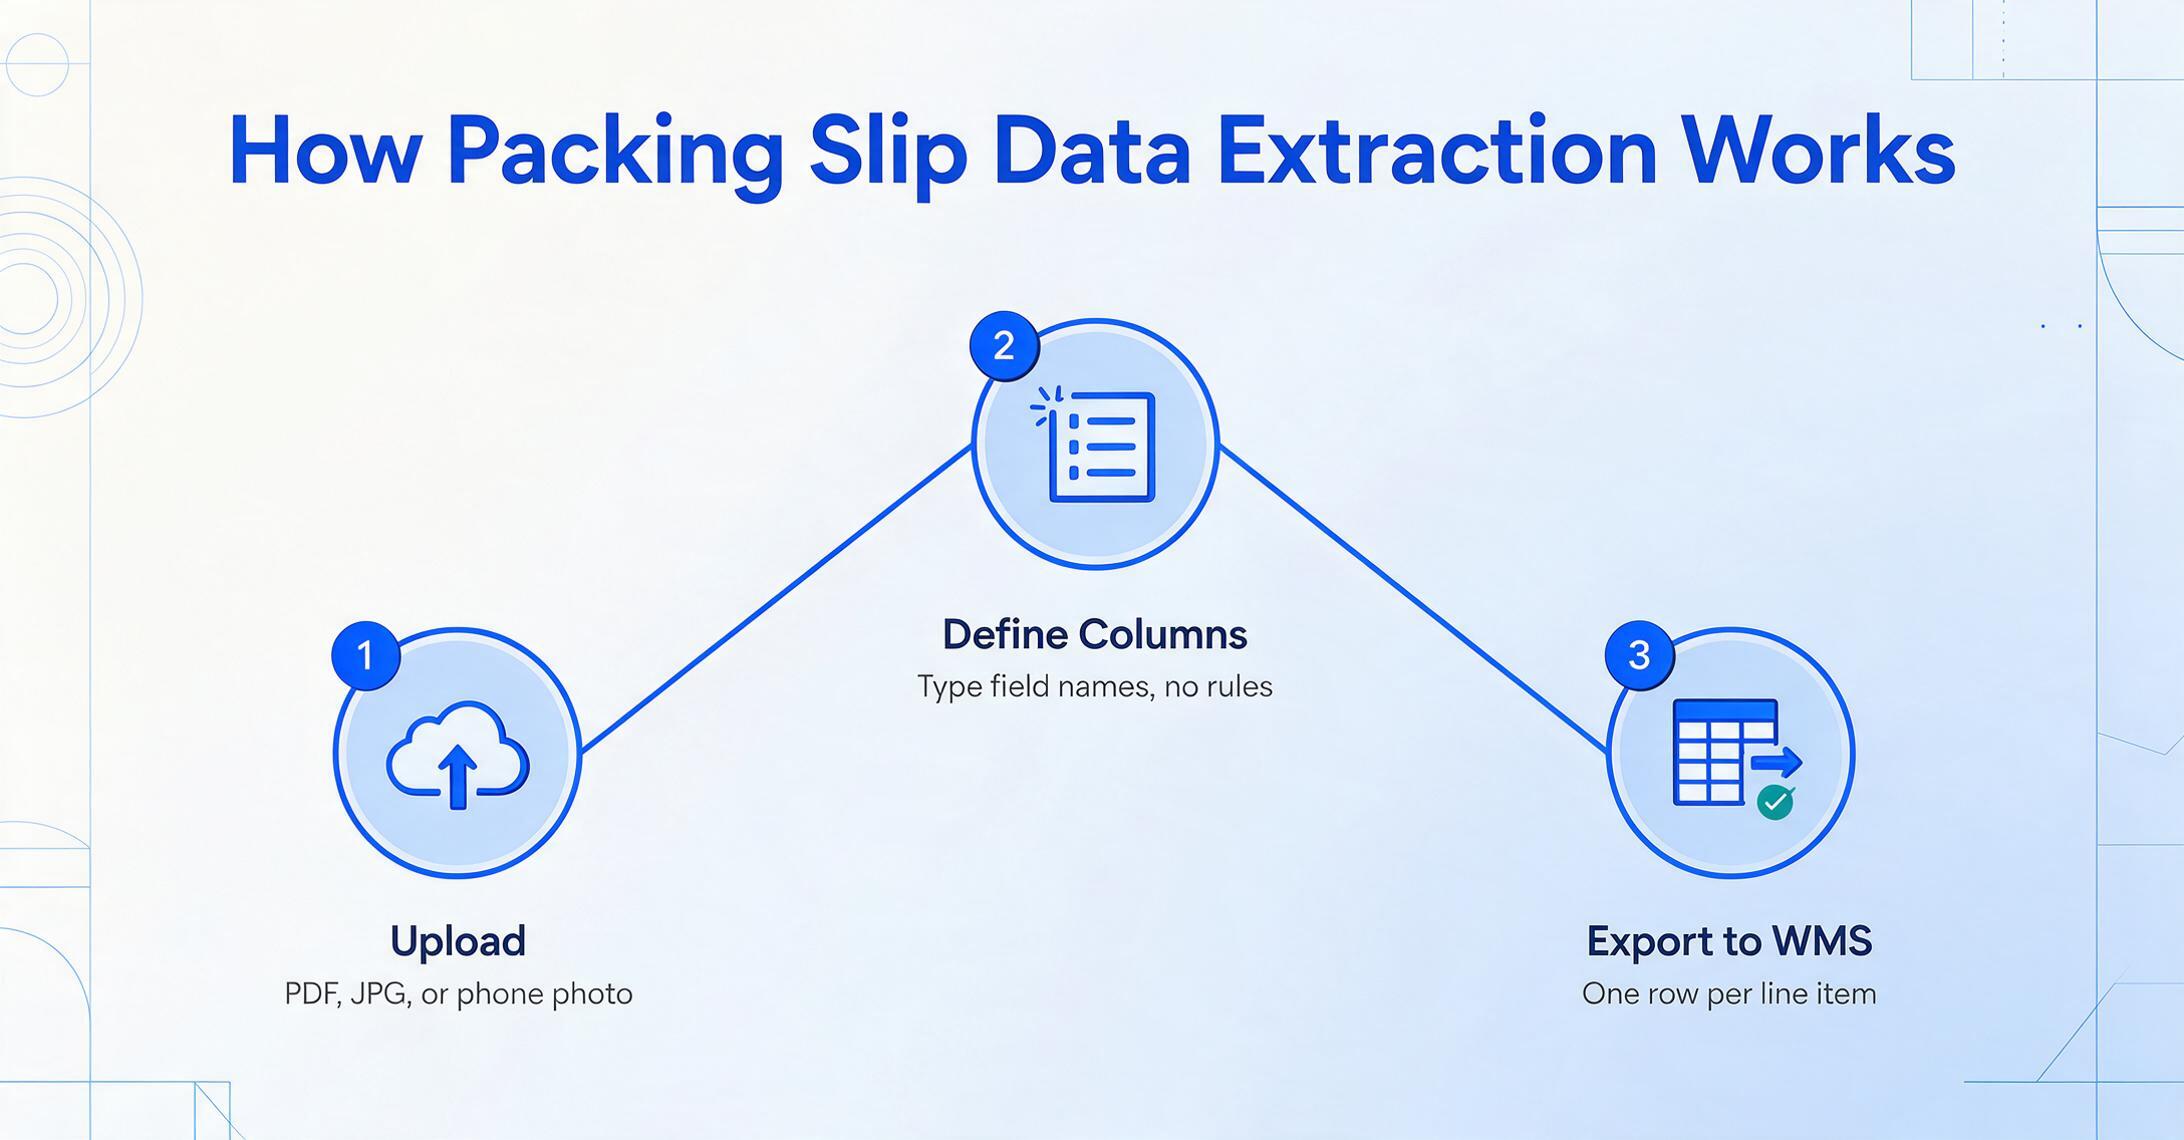
パッキングスリップ抽出は3段階のパイプラインで行われますが、その基盤となる技術はテンプレートベースのOCRとは根本的に異なります。
パッキングスリップをアップロード
どのサプライヤーからのPDF、スキャン画像、スマホの写真でも取り込めます。JPG、PNG、PDFに対応しており、フラットベッドスキャナーや前処理は不要です。異なるベンダーからのスリップを1枚でも20枚でも一度にアップロードできます。
必要な列を定義
フィールドの周りに矩形を描いたり、サプライヤーごとに解析ルールを書いたりする代わりに、出力用の列名を入力するだけです。「注文番号」「SKU」「注文数量」「出荷数量」「追跡番号」など。AIは文書全体(ヘッダーセクション、明細行テーブル、フッターノート)を読み取り、各値をページ上の位置ではなく意味に基づいて特定します。GraingerのパッキングスリップとFastenalのデリバリーノートは見た目がまったく異なりますが、「出荷数量」は両方で同じ意味を持ち、AIはどちらのテンプレートも使わずに両方でそれを見つけ出します。
入庫対応のスプレッドシートを取得
このツールは、パッキングスリップごとに明細行ごとに1行の構造化テーブルを出力し、定義したフィールド名に一致する列を持ちます。ExcelまたはCSVにエクスポートして、SAP、Oracle NetSuite、Manhattan Associates、Blue Yonder、または構造化データを受け入れるあらゆるWMS/ERPにインポートできます。バッチワークフローの場合は、朝の納品分をまとめてアップロードして、1つの統合スプレッドシートを取得できます。
ファイルは安全に処理され、保存されることはありません。
テンプレートベースのOCRと根本的に異なる点は、意味理解レイヤーにあります。従来のOCRはパッキングスリップを文字のグリッドとして読み取ります。表のセルに「80」とあれば正しく認識するかもしれませんが、それが注文数量なのか出荷数量なのかは判別できません。テンプレート不要の意味抽出モデルは全体を俯瞰して読み取ります。「Qty Shpd」という列には出荷数量が含まれていること、その行が特定のSKUに属していること、そして受領検証においてその関係性が重要であることを理解します。これこそが、メンテナンスなしでサプライヤーのフォーマット差異に対応できる理由です。「出荷数量」を、前回のレイアウト上の位置を記憶するのではなく、列が何を表しているかを理解することで見つけ出すからです。サプライヤーのフォーマットがなぜ異なるのか、そしてなぜ今後も異なり続けるのかについては、パッキングスリップのフォーマットが一致しない理由をご覧ください。
パッキングスリップ抽出が必要なケース
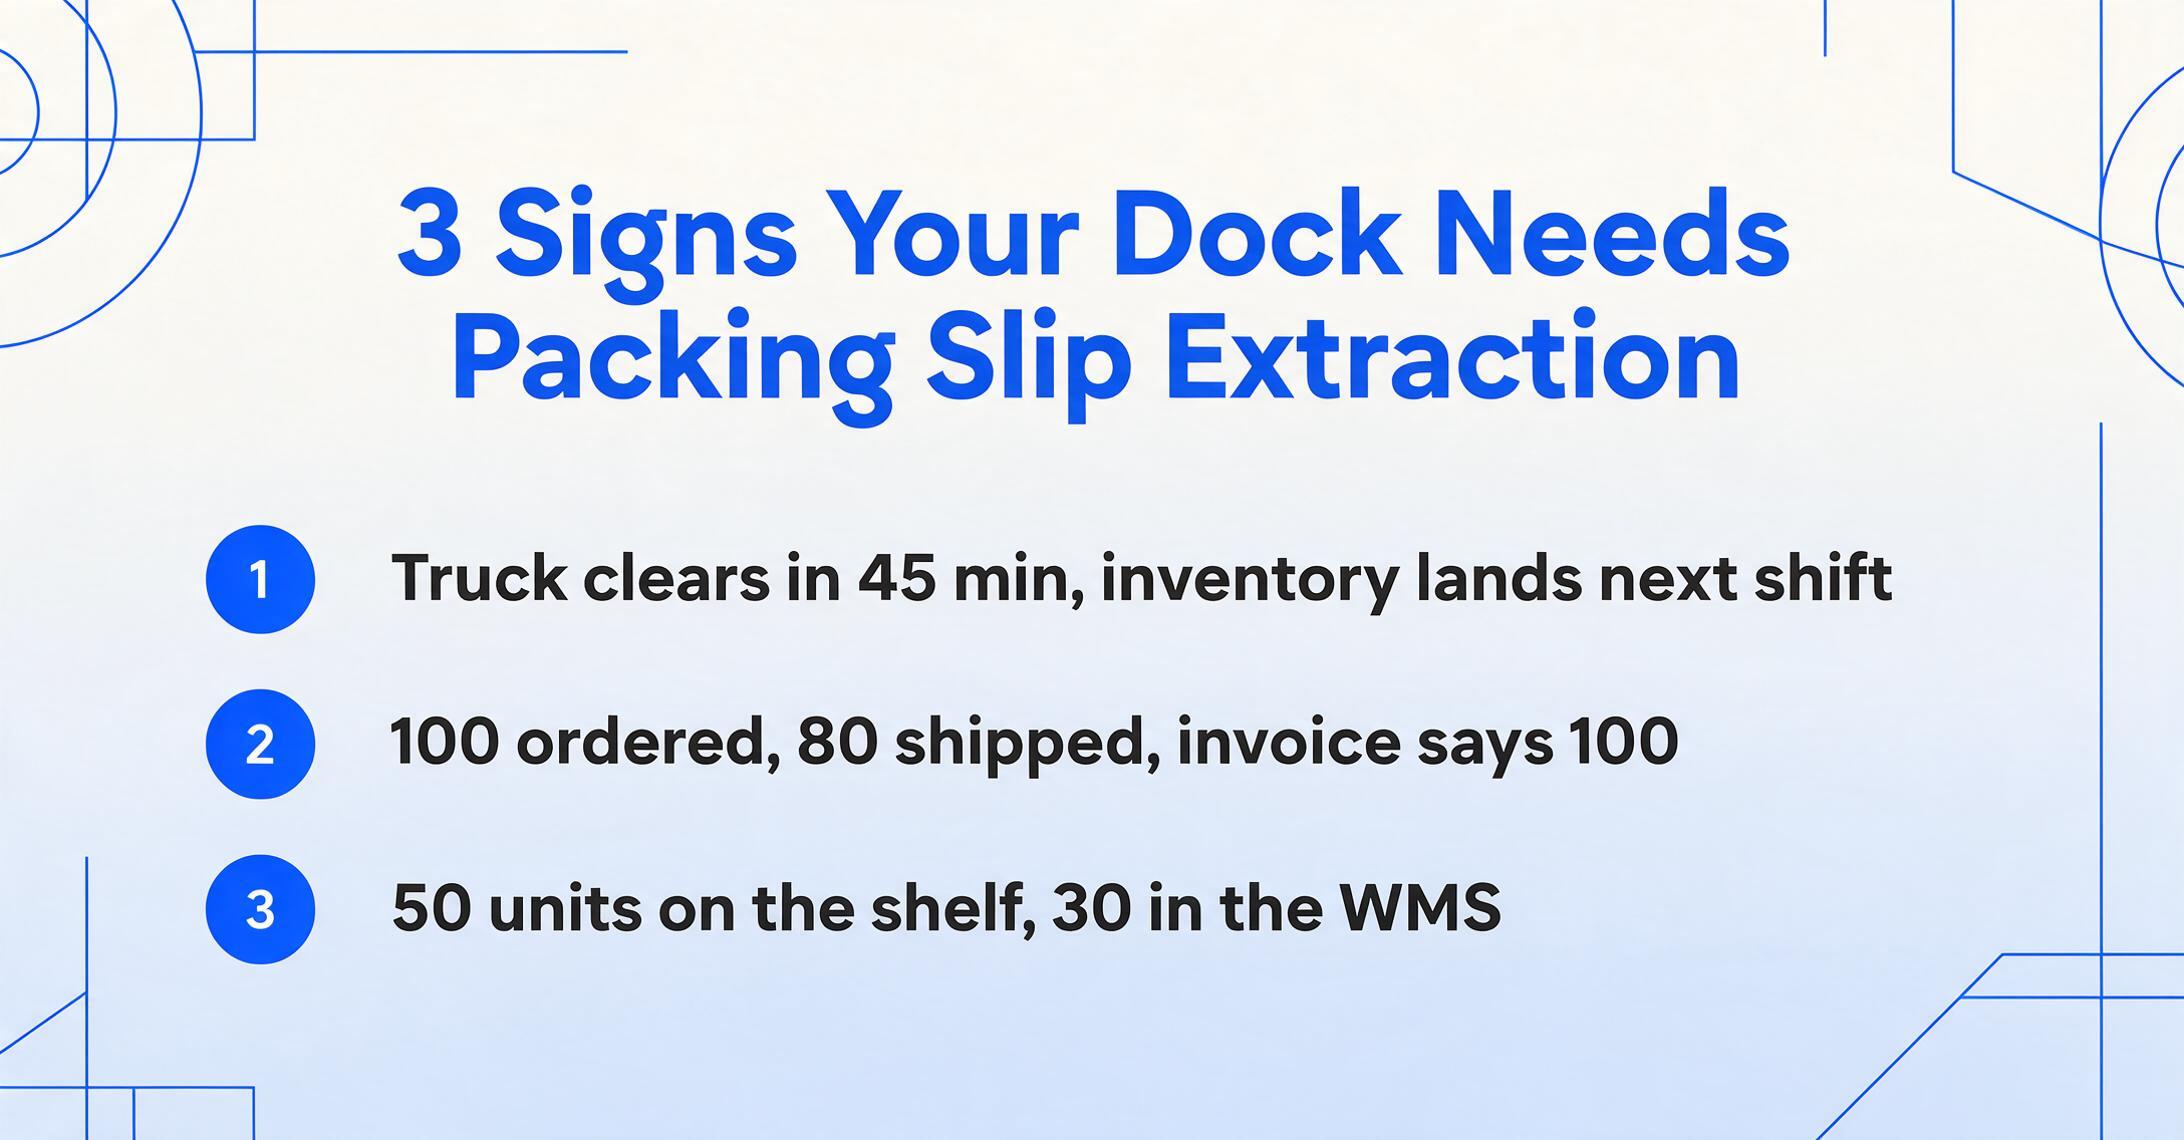
すべての受入業務で抽出が必要になるわけではありません。「興味深い」から「必要」へと変わるのは、以下の閾値に達したときです。
1. ドックから在庫化までの時間がボトルネックであり、ドックの処理能力が問題ではない場合。 WERCのベンチマークによると、最優秀クラスのドックから在庫化までの時間は3.5時間未満ですが、中規模の運用では12〜24時間かかります。トラックの荷降ろしに45分しかかからないのに、在庫が次のシフトまで利用可能にならない場合、ボトルネックはデータ入力です。抽出により、データ入力の時間をスリップ1枚あたり数分から数秒に短縮できます。
2. 三者照合が繰り返しAP保留を引き起こす場合。 三者照合(PO、パッキングスリップ、サプライヤー請求書の比較)は、AP業務の標準的な手法です。しかし、パッキングスリップのデータが紙に記載されている場合、照合プロセスでは誰かがスリップを読んで数量を手作業で比較する必要があります。1件の不一致(100個発注、80個出荷、100個で請求)があれば、AP保留が発生します。パッキングスリップのデータを構造化された形式に抽出することで、照合を自動化し、人間による確認が必要な例外のみをフラグ付けできます。エンドツーエンドのワークフローについては、受入と照合のためのパッキングスリップ項目の抽出方法をご覧ください。
3. 在庫差異が受入時の入力ミスに起因する場合。 サイクルカウントで棚に50個あるのにWMS上では30個となっている場合、その調査は数週間前のデータ入力ミスに遡ることがよくあります。パッキングスリップ上の数量の打ち間違いが、スリップがデジタル化されていなかったために誰にも気づかれなかったケースです。抽出により、受領時点でデジタル記録が作成され、物理的な到着とシステム上の記録とのギャップが解消されます。
パッキングスリップ抽出ツールに求めるべき点
パッキングスリップ抽出ツールには、テーブル構造を失う汎用PDF変換ツールから、構造化された受領データ向けに作られたAIプラットフォームまでさまざまなものがあります。作業負荷を減らすツールと、単に作業を移すだけのツールを分ける基準は4つあります。
フォーマット非依存。最も重要な差別化要因です。サプライヤーごとのフォーマットにテンプレートが必要なツールは、抽出ではなくテンプレート管理です。テンプレート不要の抽出は意味理解に基づいて行われます。過去に処理したことのないベンダーのパッキングスリップでも、AIが「出荷数量」の意味を理解しているため、サプライヤーがどこに配置しても初回アップロードで機能します。「明日、新しいベンダーからパッキングスリップを受け取ったら、そのまま使えますか?」と問いかけてください。答えに「まず解析ゾーンを定義して」が含まれるなら、それは自動化ではなくメンテナンスを買っていることになります。
明細行テーブルの保持。ツールはヘッダーフィールドと明細行テーブルのすべての行を抽出し、各品目と3つの数量列(注文済み、出荷済み、バックオーダー)の関係を保持する必要があります。フォーム用に設計されたツール(ラベル1つ、値1つ)は複数行テーブルで破綻します。さらに悪いことに、一部のツールは入れ子構造(カートン→カートン内の品目)をフラット化し、部分出荷の監査に必要なカートンレベルの詳細を失います。
バッチ処理。朝の納品には8社のサプライヤーから15枚のパッキングスリップが含まれるかもしれません。1枚ずつ処理する(アップロード、抽出、確認、次へ)のは、ツール操作のオーバーヘッドを考慮すると手入力とほとんど変わりません。バッチ処理(15枚を一度にアップロードし、1つの統合スプレッドシートを得る)こそ、時間の節約が積み重なる方法です。受領担当者の作業はデータ入力から検証へと移行します。2〜3枚を正確性のためスポットチェックし、不一致にフラグを立て、WMSにプッシュします。
スプレッドシートネイティブな出力。抽出されたデータは、WMSまたはERPが消費できる形式(ExcelまたはCSV)で届く必要があります。ほとんどのWMSプラットフォーム(Manhattan Associates、Blue Yonder、HighJump/Körber)とERP(SAP、Oracle NetSuite、Dynamics 365)は構造化CSVインポートに対応しています。ツールがJSONのみをエクスポートする場合やカスタムAPI統合が必要な場合は、手動データ入力をIT依存に置き換えたことになります。
上記の4つの基準が、求めるべき点をカバーしています。より深い運用上の詳細(ページをまたぐ複数ページの明細行テーブル、計算列を使った完全な3ウェイマッチングワークフロー、ヘッダーデータと明細行データのフィールド別内訳)については、パッキングスリップデータ抽出の完全ガイドをご覧ください。
よくある質問
納品書抽出と請求書抽出の違いは何ですか?
それぞれ異なる書類とシステムに対応します。請求書抽出は価格、税、支払条件などの財務項目を取得し、買掛金管理に連携します。納品書抽出は出荷数量、運送会社、追跡番号などの出荷項目を取得し、倉庫の入荷処理に連携します。明細行のテーブル構造も異なります。納品書には注文数量、出荷数量、バックオーダー数量の列があり、請求書には単価、金額、税の列があります。請求書向けのツールでは、出荷数量と注文数量の区別が設計されていないため、納品書では機能しないことがよくあります。
納品書抽出は分割出荷に対応できますか?
はい。ツールが複数の数量列を保持していれば可能です。分割出荷の納品書には、明細ごとに注文数量、出荷数量、バックオーダー数量の3つの数値が記載されています。抽出ツールはこれら3つを別々の項目として取得する必要があります。すべてを単一の「数量」列にまとめてしまうと、分割出荷の検証ができません。入荷担当者は100個注文したのに80個しか届いていないことを確認できなくなります。
手書きの納品書注釈にも対応できますか?
最新のビジョンAIは手書きの注釈(運送会社のメモ、受領者のイニシャル、丸で囲まれた数量など)を読み取りますが、精度は読みやすさに依存します。明確なブロック体の注釈は確実に取得できますが、走り書きの筆記体は困難です。従来のOCRより優れている点は、AIが周囲のコンテキスト(テーブル構造、近くの印刷テキスト、文書レイアウト)を利用して文字を判別することです。サプライヤーが納品書に手書きで注釈を付ける習慣がある場合は、実際の注釈サンプルでツールをテストしてから導入を決定してください。
EDI 856(出荷予定通知)とはどう違うのですか?
EDI 856は電子的な代替手段です。サプライヤーはトラックが到着する前にデジタルで出荷データを送信します。機能すれば、抽出は不要になります。しかし、導入状況は一貫していません。大規模サプライヤーは利用しますが、中堅・中小サプライヤーはほとんど利用せず、EDIは取引先ごとに設定が必要です。納品書抽出は別のアプローチで問題を解決します。EDI、PDF、パレットに貼られた感熱紙の伝票など、サプライヤーが実際に送ってくるものを処理します。多くの現場では両方を使用しています。EDI対応サプライヤーにはEDIを、それ以外には抽出を利用します。
どの程度の精度が期待できますか?
鮮明な印刷の納品書PDFでは、項目レベルの精度は95~99%に達します。スキャンした伝票や、影や傾きのあるスマホ写真では、85~95%程度に低下します。手動データ入力と比較してみましょう。APQCのベンチマークでは、入力項目あたり1~3%のエラー率です。つまり、40項目の納品書では、約33~70%の確率で少なくとも1つの打ち間違いが発生します。重要な違いは、抽出エラーはデータがWMSに入力される前に確認できることです。手動入力で「80」と誤入力しても、次のサイクルカウントまで発見されない可能性があります。
複数のサプライヤーのパッキングスリップを1つのバッチで処理できますか?
はい、可能です。ここで時間の節約効果がさらに大きくなります。8社のサプライヤーからの15枚のパッキングスリップを1つのバッチにアップロードし、列を一度定義するだけで、1つの統合スプレッドシートが得られます。抽出ツールはフォーマットの違いを内部的に処理します。GraingerのスリップもFastenalのデリバリーノートも、同じ列定義に基づいて処理されます。ステップバイステップのワークフローについては、複数のサプライヤーのパッキングスリップをバッチ処理する方法をご覧ください。
ドックからデータへ
パッキングスリップのデータ抽出は、WMS(倉庫管理システム)を置き換えるものではありません。Manhattan、Blue Yonder、SAPがその役割を担います。これは、出荷データが到着する場所(ドックの紙のスリップ)と、それが届くべき場所(受領システムの行)の間のギャップを埋めるものです。そのギャップは現在、フィールドごとに1〜3%のエラー確率を持つ人の手によるキー入力で埋められており、受領シフトごとに数百のフィールドに掛け算されます。在庫差異から買掛金保留、納品内容に関する顧客との紛争まで、さまざまな結果を招きます。
あらゆるパッキングスリップを読み取り、そのテーブル構造を理解し、出荷数量と注文数量を区別し、構造化データを出力する技術は、テンプレートなし、サプライヤーごとの設定なしで、あらゆる形式に対応して今日すでに存在しています。それを評価する最善の方法は、実際のパッキングスリップでテストすることです。当社のパッキングスリップデータ抽出ツールはこの正確な抽出を実行します。サンプルをアップロードして構造化出力を確認するか、パッキングスリップフィールド抽出のステップバイステップガイドから始めてください。