Was ist Lieferschein-Datenextraktion?
So funktioniert es
Lieferschein-Datenextraktion ist der automatisierte Prozess, bei dem wichtige Versandfelder – wie Bestellnummer, Versanddatum, Spediteur, Artikelbeschreibungen, versandte Mengen und Sendungsnummern – aus einem PDF oder einem gescannten Lieferschein gelesen und in strukturierte Tabellenzeilen umgewandelt werden. Statt dass ein Wareneingangsmitarbeiter jeden Lieferschein öffnet, jedes Feld visuell erfasst und die Werte manuell in ein WMS eingibt – ein Prozess, der 2–5 Minuten pro Lieferschein dauert und eine Fehlerquote von 1–3 % pro Feld aufweist – liest die Software das gesamte Dokument, erkennt, welche Positionen zu welchem Karton gehören, und liefert eine Tabelle, die für die Wareneingangsprüfung bereit ist.
Wichtigste Erkenntnisse
- Über 3 Stunden pro Schicht und Wareneingangsmitarbeiter werden damit verbracht, Daten einzutippen, die bereits auf dem Lieferschein vor ihnen gedruckt sind.
- Eine Fehlerquote von 1–3 % pro Feld bedeutet, dass ein Lieferschein mit 40 Feldern mit einer Wahrscheinlichkeit von 33–70 % eine falsche Zahl in Ihr WMS einbringt – eine Zahl, die erst bei der nächsten Inventurdifferenz Wochen später entdeckt wird.
- Entfernen Sie den Tipp-Schritt – Lieferschein hochladen, strukturierte Daten erhalten – und Ihr Wareneingangsteam wird zu Prüfern, die Ausnahmen erkennen, statt zu Datenerfassern, die sie verursachen.
Was Packing-Slip-Datenextraktion eigentlich ist
Ein Lieferschein ist keine Rechnung – und genau diese Unterscheidung ist bei der Datenextraktion entscheidend. Eine Rechnung zeigt, was Ihnen berechnet wird: Sie enthält Preise, Zahlungsbedingungen und Steuerbeträge und ist für die Kreditorenbuchhaltung bestimmt. Ein Lieferschein zeigt, was sich in der Sendung befindet: Bestellnummer, Versanddatum, Spediteur, Rechnungs- und Lieferadresse sowie eine positionsweise Aufschlüsselung des Gepackten. Sein Ziel ist die Warenannahme im Lager, wo jemand prüfen muss, ob das Angekommene dem Entsprechen entspricht, das hätte ankommen sollen.
Dasselbe Dokument läuft unter verschiedenen Namen. „Packing Slip" ist in US-amerikanischen Betrieben Standard. „Packing List" erscheint bei internationalen Sendungen oder Dokumenten mit Detailangaben auf Kartonebene. „Delivery Note" wird in manchen Branchen verwendet – obwohl sie technisch gesehen bestätigt, was geliefert wurde (nach Übergabe), während ein Lieferschein festhält, was gepackt wurde (vor Versand). In der Praxis begegnen Warenannahme-Teams allen drei Varianten vom selben Lieferanten, und das Extraktionstool muss sie identisch behandeln.
Die Felder, die ein Tool zur Lieferscheinextraktion erfasst, fallen in zwei Gruppen: Versandkopf-Felder (Bestell-/Auftragsnummer, Versanddatum, Spediteur, Liefer-/Rechnungsadresse, Sendungsverfolgungsnummer, Gesamtgewicht) und Positionen (Artikelnr./SKU, Beschreibung, bestellte Menge, gelieferte Menge, nachbestellte Menge, Maßeinheit). Die strukturelle Herausforderung, die die Lieferscheinextraktion von der Rechnungsextraktion unterscheidet, ist das Vorhandensein von drei Mengenspalten – bestellt, geliefert und nachbestellt – in jeder Zeile. Ein Lieferant könnte 80 von 100 Einheiten versenden, und der Lieferschein muss alle drei Zahlen bewahren, damit das Warenannahme-Team die Teillieferung erkennen kann. Für ein breiteres Bild darüber, wie diese Technologie in die Dokumentenverarbeitung passt, siehe unsere Grundlagen der KI-Dokumentenextraktion.
Lieferscheinextraktion vs. manuelle Lagereingabe
Die Frage, die sich Erstsuchende wirklich stellen: „Warum kann ich Lieferscheindaten nicht einfach weiter manuell in mein WMS eingeben?" Die Antwort ist nicht, dass es nicht geht – sondern dass die Kosten mit jeder zusätzlichen Lieferantenformat-Variation steigen.
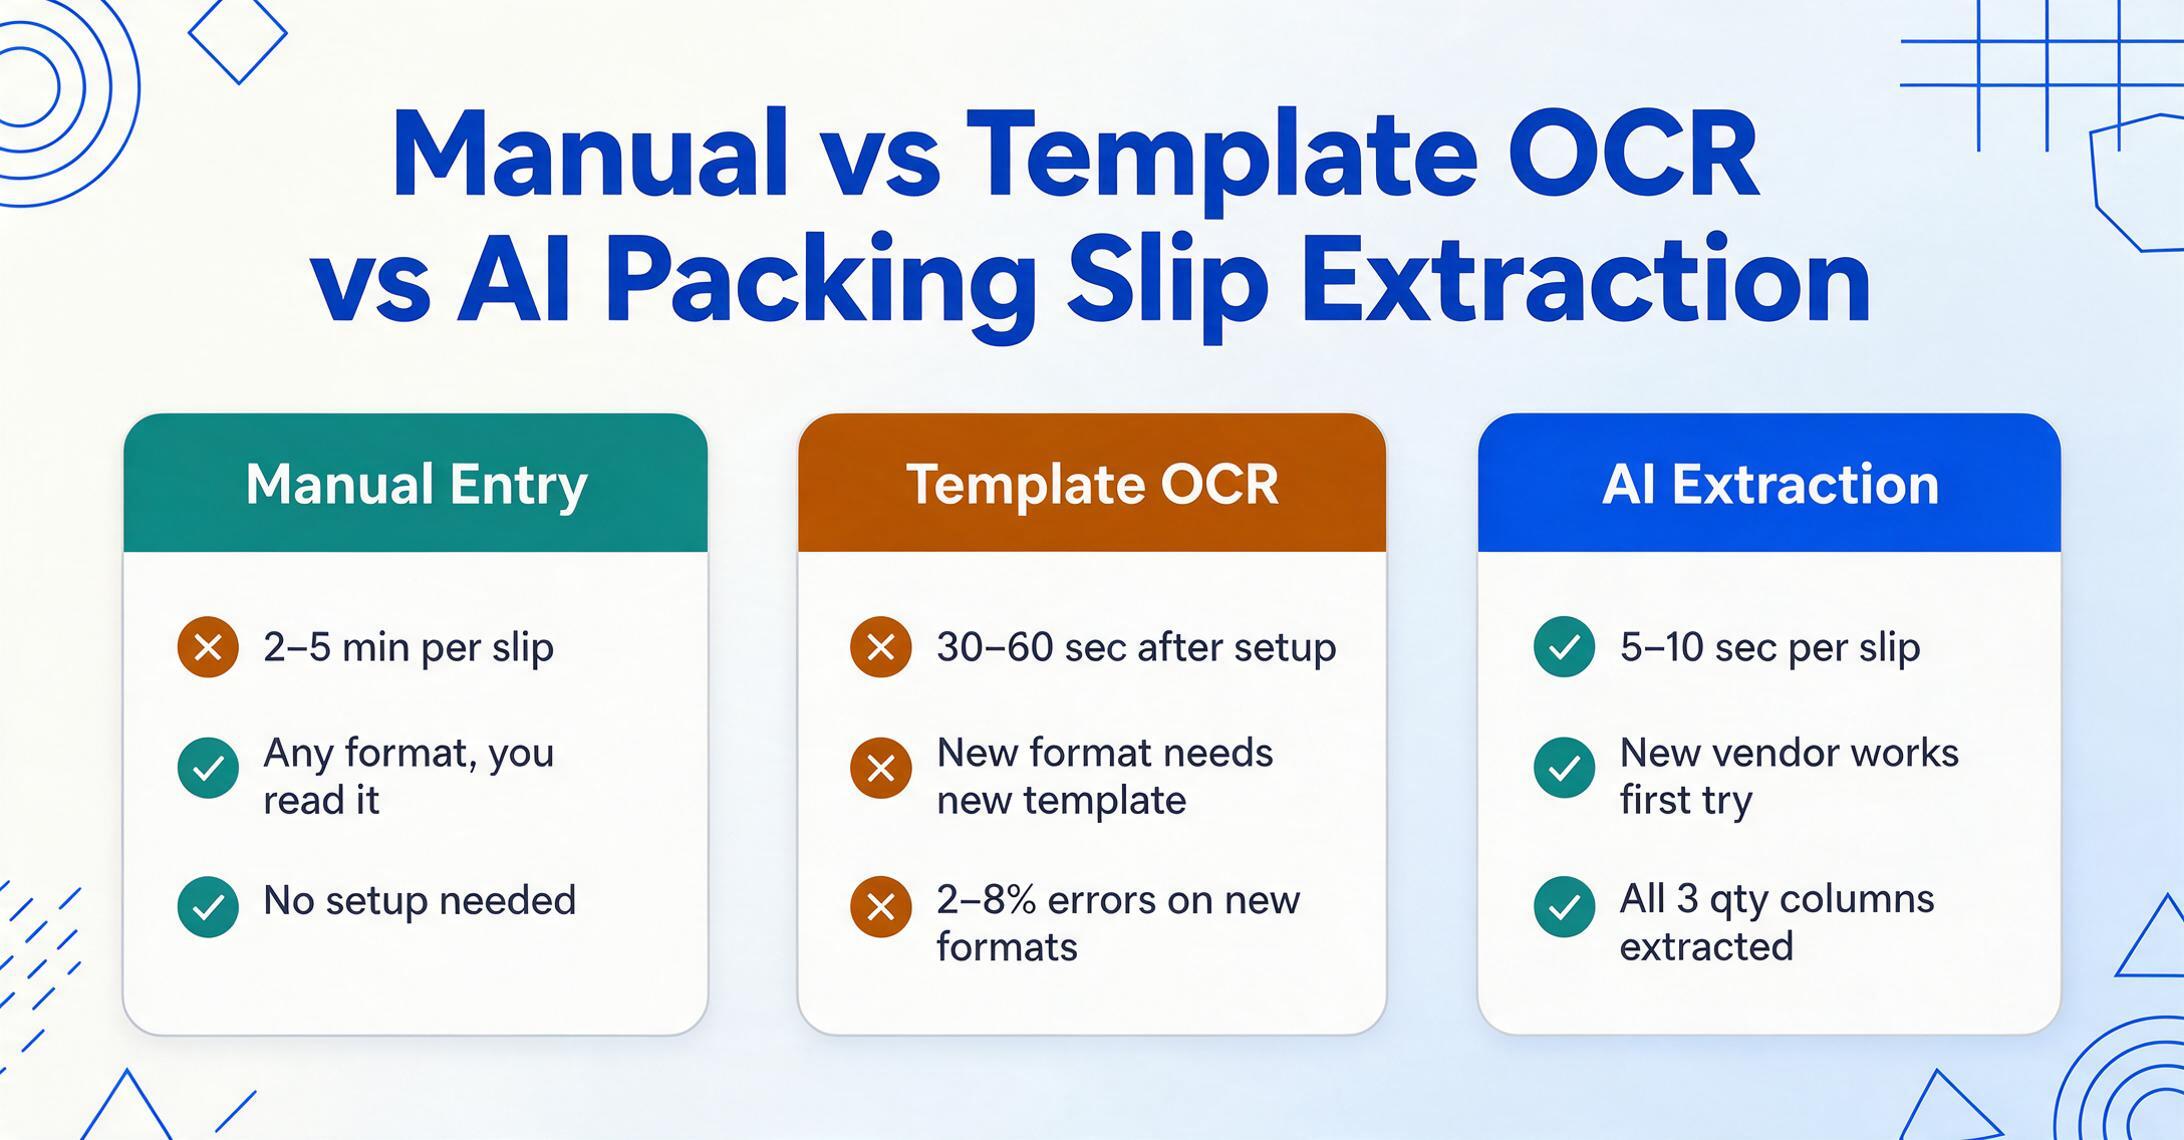
| Manuelle Dateneingabe | Template-basierte OCR | KI-Lieferscheinextraktion | |
|---|---|---|---|
| Zeit pro Lieferschein | 2–5 Minuten | 30–60 Sek. (nach Template-Erstellung) | 5–10 Sekunden |
| Neues Lieferantenformat? | Ja (Sie lesen es) | Nein – erfordert neues Template | Ja – liest nach Bedeutung, nicht nach Position |
| Einrichtung | Keine | Ein Template pro Format | Keine – Spalten einmal typisieren |
| Fehlerrate (pro Feld) | 1–3% | 2–8% (formatabhängig) | 1–5% (prüfbar) |
| Teillieferungsverarbeitung | Manueller Vergleich mit Bestellung | Template-abhängig | Automatisch – alle 3 Mengenspalten extrahiert |
Die WERC-Studie „2024 Warehousing & Fulfillment Costs Survey" beziffert die Kosten für den Wareneingang auf 40,79 $ pro Stunde bzw. 2,50 $ pro SKU. APQC-Benchmarks zeigen eine Spanne von 44,1 Stunden bei der Dock-to-Stock-Zykluszeit zwischen den besten und schlechtesten Performern – und der Haupttreiber ist nicht die Geschwindigkeit der Gabelstapler, sondern wie lange Daten zwischen „Ware angekommen" und „Bestand aktualisiert" brachliegen. Für eine detaillierte Analyse der Kosten manueller Lieferscheinverarbeitung im großen Maßstab, siehe unsere Aufschlüsselung der manuellen Erfassungskosten pro Lieferschein und Schicht.
So funktioniert die Lieferschein-Datenextraktion
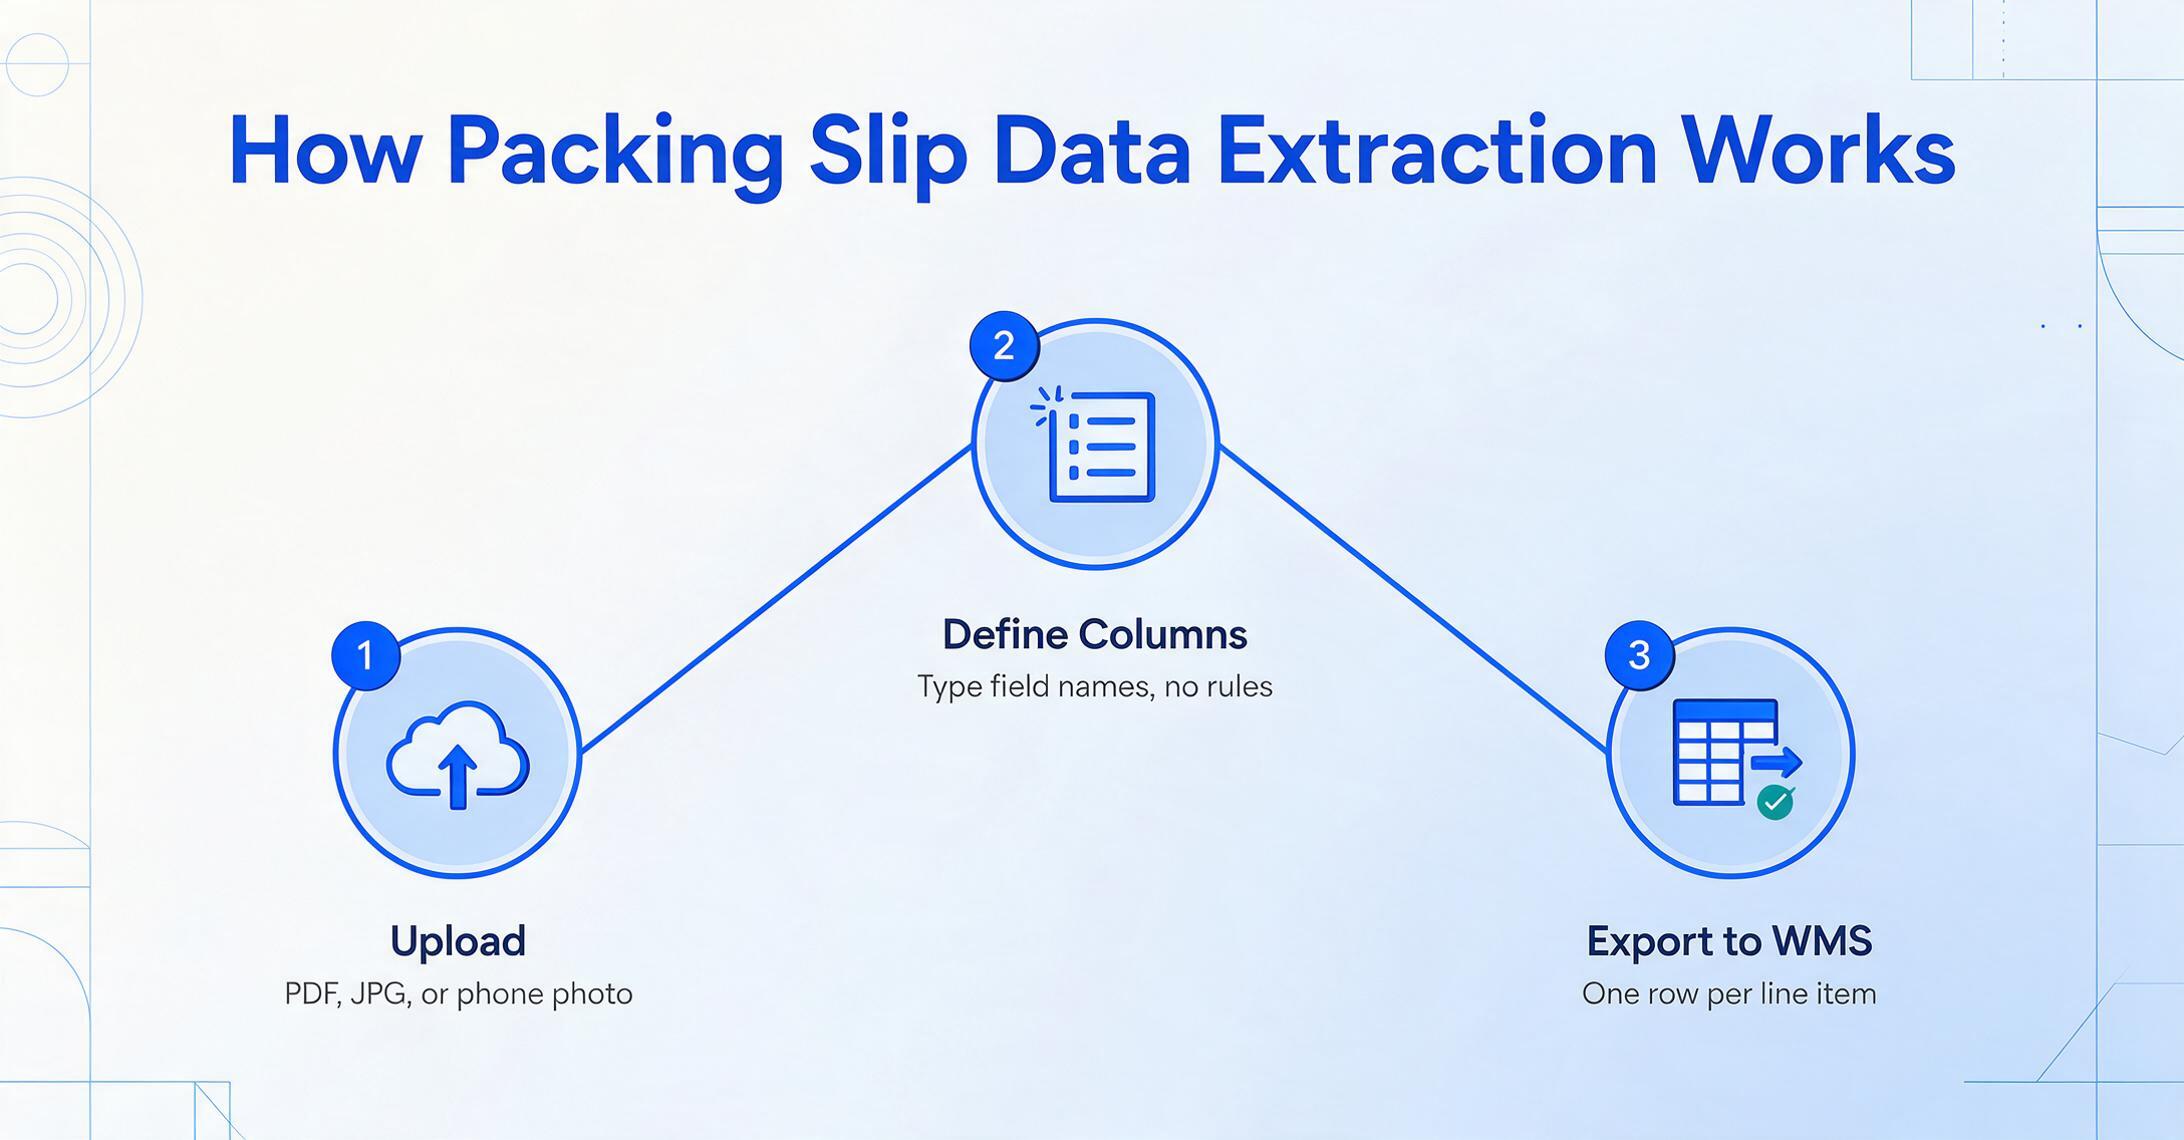
Die Lieferscheinextraktion folgt einer dreistufigen Pipeline, aber die zugrunde liegende Technologie unterscheidet sich grundlegend von templatebasierter OCR.
Lieferscheine hochladen
Laden Sie PDFs, gescannte Bilder oder Handyfotos von jedem Lieferanten hoch. Das System akzeptiert JPG, PNG und PDF – kein Flachbettscanner oder Vorverarbeitung erforderlich. Laden Sie einen Lieferschein oder zwanzig von verschiedenen Anbietern gleichzeitig hoch.
Definieren Sie die benötigten Spalten
Statt Rechtecke um Felder zu zeichnen oder Parsing-Regeln pro Lieferant zu schreiben, geben Sie die Spaltennamen für Ihre Ausgabe ein: „SO-Nummer", „SKU", „Bestellmenge", „Liefermenge", „Sendungsnummer". Die KI liest das gesamte Dokument – Kopfbereich, Positionstabelle, Fußnoten – und findet jeden Wert anhand seiner Bedeutung, nicht anhand seiner Position auf der Seite. Ein Grainger-Lieferschein und ein Fastenal-Lieferbegleitschein sehen völlig unterschiedlich aus, aber „Liefermenge" bedeutet auf beiden dasselbe – und die KI findet es auf beiden, ohne Vorlage für einen davon.
Erhalten Sie eine wareneingangsfertige Tabelle
Das Tool erzeugt eine strukturierte Tabelle – eine Zeile pro Position und Lieferschein – mit Spalten, die den von Ihnen definierten Feldnamen entsprechen. Exportieren Sie nach Excel oder CSV und importieren Sie in SAP, Oracle NetSuite, Manhattan Associates, Blue Yonder oder jedes WMS/ERP, das strukturierte Daten akzeptiert. Für Batch-Workflows laden Sie die Lieferungen eines ganzen Morgens auf einmal hoch und erhalten Sie eine einheitliche Tabelle.
Dateien werden sicher verarbeitet und nicht gespeichert.
Was dies grundlegend von template-basierter OCR unterscheidet, ist die semantische Verständnisebene. Traditionelle OCR liest einen Lieferschein als Zeichenraster – sie könnte „80" in einer Tabellenzelle korrekt erkennen, weiß aber nicht, ob es sich um die bestellte oder die versandte Menge handelt. Ein semantisches Extraktionsmodell ohne Vorlage liest ganzheitlich: Es versteht, dass eine Spalte mit der Bezeichnung „Qty Shpd" versandte Mengen enthält, dass die Zeile zu einer bestimmten SKU gehört und dass diese Beziehung für die Wareneingangsprüfung wichtig ist. Deshalb bewältigt es Lieferantenformatabweichungen ohne Wartung – es findet „versandte Menge", indem es versteht, was die Spalte darstellt, nicht indem es sich merkt, wo sie sich im letzten Layout befand. Warum Lieferantenformate voneinander abweichen und warum sie das immer tun werden, erfahren Sie unter warum Lieferscheinformate nie übereinstimmen.
Wann Sie eine Lieferschein-Erfassung benötigen
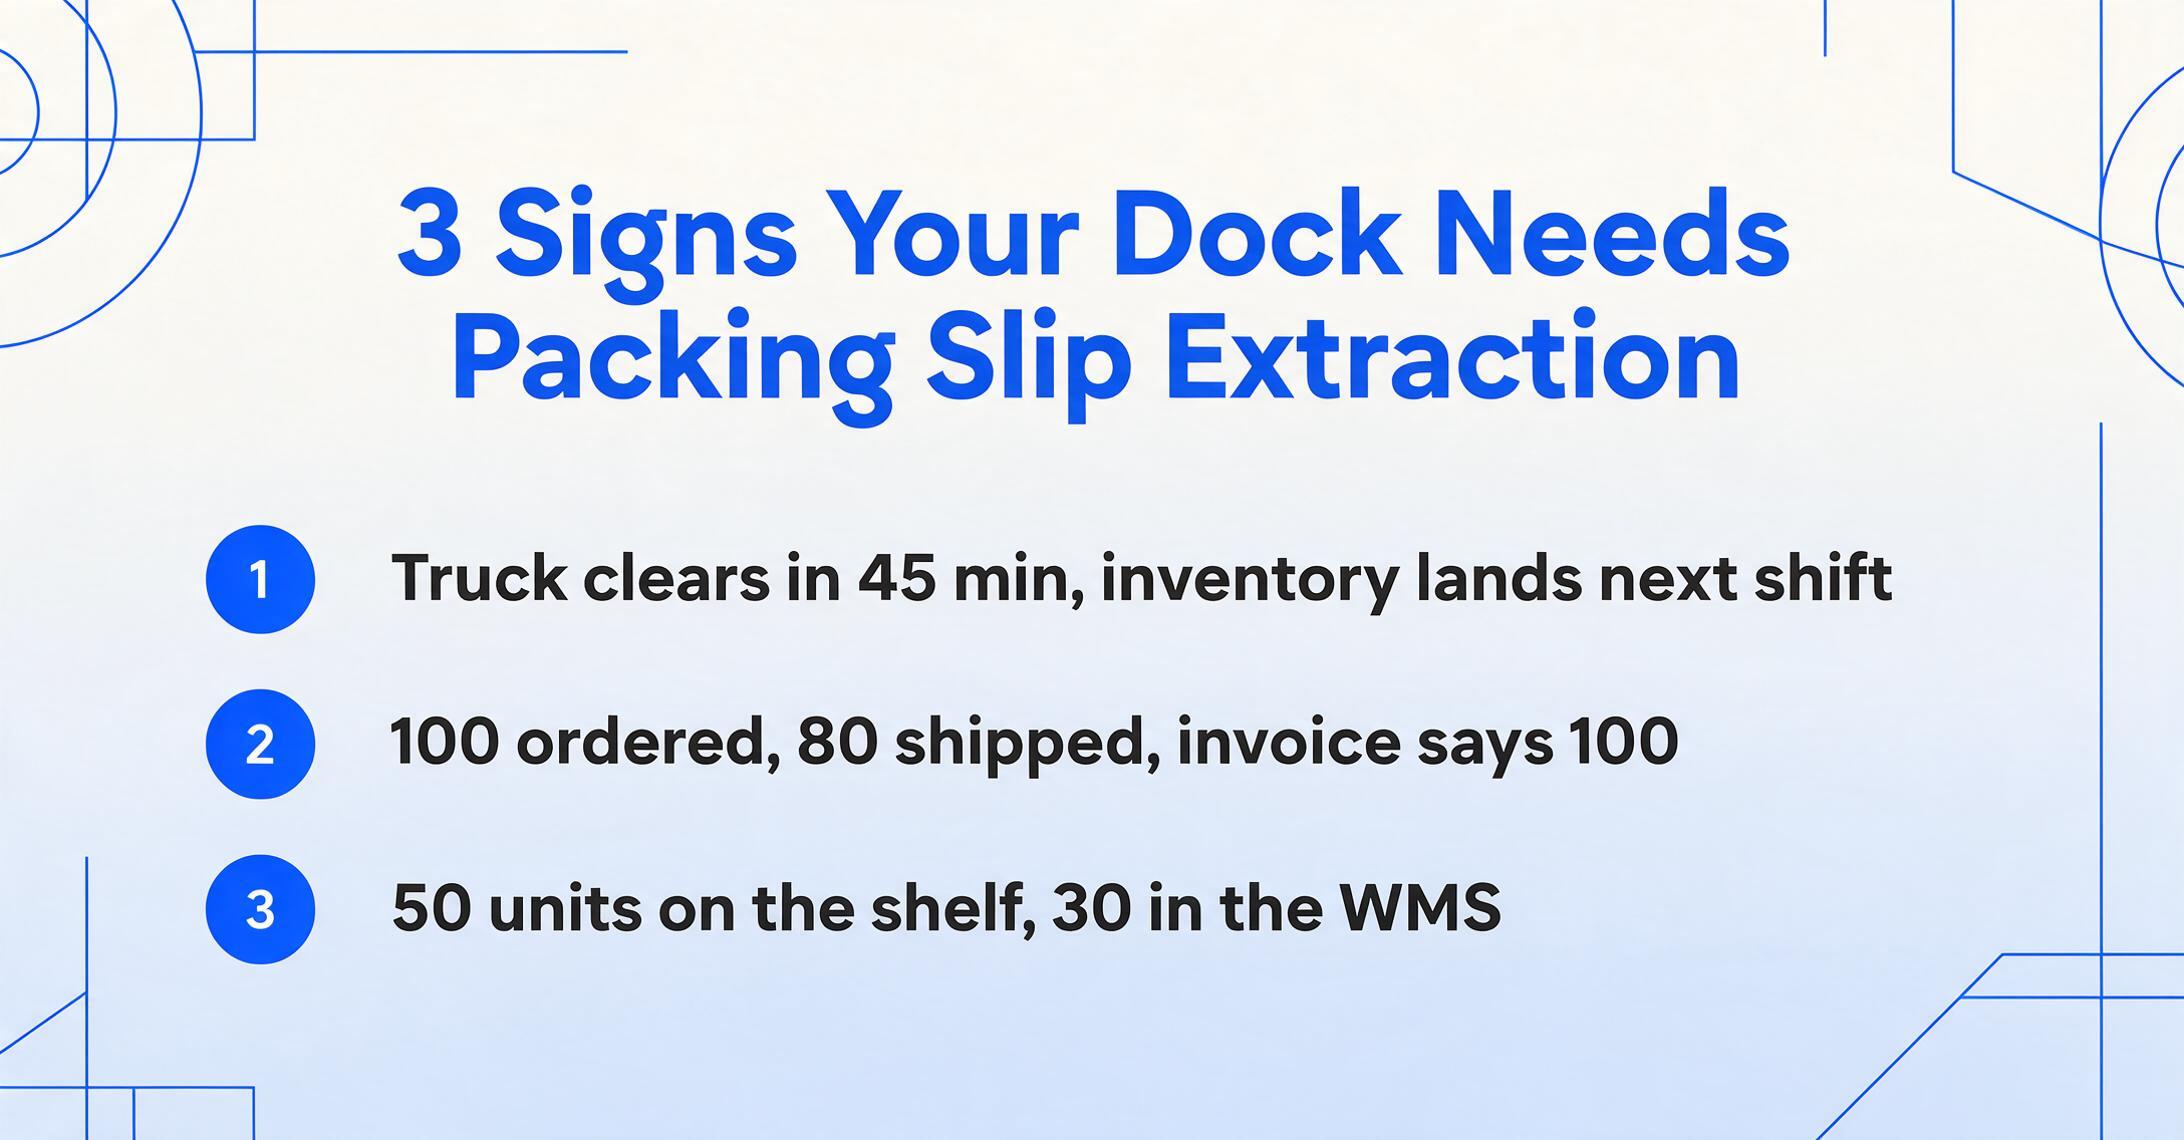
Nicht jeder Wareneingang benötigt eine Erfassung. Der Übergang von „interessant" zu „notwendig" erfolgt bei folgenden Schwellenwerten:
1. Die Dock-to-Stock-Zeit ist der Engpass, nicht die Dock-Kapazität. WERC-Benchmarks zeigen, dass Best-in-Class-Dock-to-Stock-Zeiten unter 3,5 Stunden liegen, während Mid-Market-Betriebe 12–24 Stunden benötigen. Wenn Ihre Mannschaft einen LKW in 45 Minuten entlädt, der Bestand aber erst in der nächsten Schicht als verfügbar angezeigt wird, ist die Dateneingabe der Engpass – und die Erfassung verkürzt das Dateneingabefenster von Minuten pro Lieferschein auf Sekunden.
2. Drei-Wege-Abgleich führt zu wiederkehrenden AP-Sperren. Der Drei-Wege-Abgleich – der Vergleich von Bestellung, Lieferschein und Lieferantenrechnung – ist gängige AP-Praxis. Wenn Lieferscheindaten jedoch auf Papier vorliegen, muss beim Abgleich jemand den Lieferschein lesen und die Mengen manuell vergleichen. Eine einzige Abweichung – 100 bestellt, 80 geliefert, 100 in Rechnung gestellt – löst eine AP-Sperre aus. Die Erfassung von Lieferscheindaten in ein strukturiertes Format ermöglicht einen automatischen Abgleich, bei dem nur Ausnahmen zur manuellen Prüfung markiert werden. Den vollständigen Workflow finden Sie unter Lieferscheinfelder für Wareneingang und Abstimmung erfassen.
3. Inventarabweichungen lassen sich auf Eingabefehler beim Wareneingang zurückführen. Wenn Zykluszählungen 50 Einheiten im Regal, aber 30 im WMS ergeben, führt die Untersuchung oft auf einen Dateneingabefehler von Wochen zuvor zurück – eine falsch eingegebene Menge auf einem Lieferschein, die niemand bemerkt hat, weil der Lieferschein nicht digitalisiert wurde. Die Erfassung erstellt einen digitalen Datensatz zum Zeitpunkt des Wareneingangs und schließt so die Lücke zwischen physischer Ankunft und Systemeintrag.
Worauf Sie bei einem Lieferschein-Extraktionstool achten sollten
Lieferschein-Extraktionstools reichen von generischen PDF-Konvertern, die die Tabellenstruktur verlieren, bis hin zu KI-Plattformen, die für strukturierte Wareneingangsdaten entwickelt wurden. Vier Kriterien unterscheiden Tools, die die Arbeitslast reduzieren, von solchen, die sie nur verlagern:
Formatunabhängigkeit. Das mit Abstand wichtigste Unterscheidungsmerkmal. Ein Tool, das eine Vorlage pro Lieferantenformat erfordert, ist keine Extraktion – es ist Vorlagenpflege. Ohne Vorlage arbeitende Extraktion liest durch semantisches Verständnis: Ein Lieferschein von einem Lieferanten, mit dem Sie noch nie gearbeitet haben, funktioniert beim ersten Upload, weil die KI versteht, was „gelieferte Menge" bedeutet, unabhängig davon, wo der Lieferant es platziert hat. Fragen Sie: „Wenn ich morgen einen Lieferschein von einem neuen Lieferanten erhalte, funktioniert das?" Wenn die Antwort „zuerst einen Parsing-Bereich definieren" beinhaltet, kaufen Sie Wartung, nicht Automatisierung.
Erhalt der Positionszeilentabelle. Das Tool muss Kopfzeilenfelder und jede Zeile in der Positionszeilentabelle extrahieren und dabei die Beziehung zwischen jedem Artikel und seinen drei Mengenspalten (bestellt, geliefert, rückständig) bewahren. Tools, die für Formulare entwickelt wurden – ein Label, ein Wert – scheitern bei mehrzeiligen Tabellen. Schlimmer noch: Einige Tools glätten verschachtelte Gruppierungen (Karton → Artikel im Karton) und verlieren dabei die Kartonebene-Details, die Wareneingangsteams für Teil-Lieferungsprüfungen benötigen.
Batch-Verarbeitung. Die Morgenlieferungen können 15 Lieferscheine von 8 Lieferanten umfassen. Diese einzeln zu verarbeiten – Upload, Extraktion, Prüfung, nächster – ist kaum schneller als manuelle Eingabe, wenn man den Interaktionsaufwand des Tools berücksichtigt. Batch-Verarbeitung – alle 15 auf einmal hochladen, eine einheitliche Tabelle erhalten – ist der Punkt, an dem sich Zeitersparnisse summieren. Die Aufgabe des Warenempfängers verschiebt sich von Dateneingabe zu Verifizierung: 2–3 Lieferscheine stichprobenartig auf Richtigkeit prüfen, Abweichungen kennzeichnen, an das WMS weiterleiten.
Tabellenkalkulationsnative Ausgabe. Die extrahierten Daten müssen dort ankommen, wo Ihr WMS oder ERP sie verarbeiten kann – als Excel oder CSV. Die meisten WMS-Plattformen (Manhattan Associates, Blue Yonder, HighJump/Körber) und ERPs (SAP, Oracle NetSuite, Dynamics 365) akzeptieren strukturierten CSV-Import. Wenn das Tool nur JSON exportiert oder eine individuelle API-Integration erfordert, haben Sie manuelle Dateneingabe gegen eine IT-Abhängigkeit eingetauscht.
Die vier oben genannten Kriterien decken ab, worauf Sie achten sollten. Für die tiefergehenden operativen Details – mehrseitige Positionszeilentabellen über einen Seitenumbruch hinweg, den vollständigen 3-Wege-Abgleich-Workflow mit berechneten Spalten und eine feldweise Aufschlüsselung von Kopf- vs. Positionsdaten – lesen Sie unseren vollständigen Leitfaden zur Lieferschein-Datenextraktion.
Häufig gestellte Fragen
Was ist der Unterschied zwischen Lieferschein- und Rechnungsextraktion?
Sie extrahieren aus unterschiedlichen Dokumenten für unterschiedliche Systeme. Die Rechnungsextraktion erfasst Finanzdaten – Preise, Steuern, Zahlungsbedingungen – und speist die Kreditorenbuchhaltung. Die Lieferscheinextraktion erfasst Versanddaten – gelieferte Mengen, Spediteur, Sendungsnummer – und speist den Wareneingang. Die Positionszeilen unterscheiden sich strukturell: Ein Lieferschein hat Spalten für bestellte, gelieferte und nachbestellte Menge; eine Rechnung hat Spalten für Einzelpreis, Gesamtpreis und Steuern. Ein für Rechnungen entwickeltes Tool scheitert oft an Lieferscheinen, weil es nicht darauf ausgelegt ist, gelieferte von bestellten Mengen zu unterscheiden.
Kann die Lieferscheinextraktion Teillieferungen verarbeiten?
Ja – sofern das Tool die Mehrfachmengenspalten beibehält. Ein Teillieferungslieferschein zeigt drei Zahlen pro Position: bestellte Menge, gelieferte Menge und nachbestellte Menge. Das Extraktionstool muss alle drei als separate Felder erfassen. Wenn es alles in eine einzige Spalte „Menge" zusammenfasst, können Teillieferungen nicht überprüft werden – der Wareneingang sieht nicht, dass 100 bestellt, aber nur 80 geliefert wurden.
Funktioniert es mit handschriftlichen Vermerken auf Lieferscheinen?
Moderne Bild-KI liest handschriftliche Vermerke – Spediteurnotizen, Empfängerkürzel, eingekreiste Mengen – mit einer Genauigkeit, die von der Leserlichkeit abhängt. Klare Druckschrift wird zuverlässig erfasst; flüchtige Schreibschrift ist schwieriger. Der Vorteil gegenüber herkömmlicher OCR ist, dass KI den umgebenden Kontext nutzt – Tabellenstruktur, nahen gedruckten Text, Dokumentenlayout – um Zeichen zu unterscheiden, die eine herkömmliche OCR-Engine nur erraten könnte. Wenn Ihre Lieferanten Lieferscheine regelmäßig handschriftlich ergänzen, testen Sie das Tool an echten annotierten Mustern, bevor Sie sich festlegen.
Wie unterscheidet sich das von EDI 856 (Vorab-Versandmitteilung)?
EDI 856 ist eine elektronische Alternative – der Lieferant sendet Versanddaten digital, bevor der Lkw eintrifft. Wenn es funktioniert, macht es die Extraktion überflüssig. Aber die Einführung ist uneinheitlich: Große Lieferanten nutzen es, mittelständische und kleine selten, und EDI erfordert Einrichtung pro Geschäftspartner. Die Lieferscheinextraktion löst das Problem vom anderen Ende: Sie verarbeitet, was der Lieferant tatsächlich sendet – ob EDI, PDF oder einen Thermoausdruck, der auf eine Palette geklebt ist. Die meisten Betriebe nutzen beides: EDI für Lieferanten, die es senden können, Extraktion für alle anderen.
Welche Genauigkeit kann ich erwarten?
Bei sauberen, gedruckten Lieferschein-PDFs erreicht die Feldgenauigkeit 95–99 %. Gescannte Lieferscheine oder Handyfotos mit Schatten oder Schräglage liegen niedriger – etwa 85–95 %. Vergleichen Sie das mit manueller Dateneingabe: APQC-Benchmarks zeigen 1–3 % Fehler pro eingegebenem Feld, d. h. ein Lieferschein mit 40 Feldern hat eine Wahrscheinlichkeit von etwa 33–70 % für mindestens einen Tippfehler. Der entscheidende Unterschied: Extraktionsfehler sind vor der Übernahme in Ihr WMS sichtbar; eine falsch eingegebene „80" bei manueller Eingabe wird möglicherweise erst bei der nächsten Inventur bemerkt.
Kann ich Lieferscheine von mehreren Lieferanten in einem Batch verarbeiten?
Ja – und genau hier summieren sich die Zeitersparnisse. Laden Sie 15 Lieferscheine von 8 verschiedenen Lieferanten in einem einzigen Batch hoch, definieren Sie Ihre Spalten einmal und erhalten Sie eine einheitliche Tabelle. Das Extraktionstool verarbeitet Formatunterschiede intern: Ein Grainger-Lieferschein und ein Fastenal-Lieferbegleitschein werden beide anhand derselben Spaltendefinitionen verarbeitet. Eine Schritt-für-Schritt-Anleitung finden Sie unter Batch-Verarbeitung von Lieferscheinen mehrerer Lieferanten.
Vom Dock zu Daten
Die Extraktion von Lieferscheindaten ersetzt nicht Ihr WMS (Warehouse Management System) – Manhattan, Blue Yonder und SAP übernehmen diese Aufgabe. Sie schließt die Lücke zwischen dem Ort, an dem Versanddaten ankommen (ein Papierbeleg am Dock), und dem Ort, an dem sie landen müssen (eine Zeile in Ihrem Wareneingangssystem). Diese Lücke wird derzeit durch manuelle Tastatureingaben überbrückt, die eine Fehlerwahrscheinlichkeit von 1–3 % pro Feld mit sich bringen – multipliziert über Hunderte von Feldern pro Wareneingangsschicht – mit Folgen von Inventarabweichungen über AP-Sperren bis hin zu Kundenstreitigkeiten über das, was geliefert wurde.
Die Technologie, um jeden Lieferschein zu lesen – seine Tabellenstruktur zu verstehen, die gelieferte Menge von der bestellten Menge zu unterscheiden und strukturierte Daten auszugeben – existiert heute ohne Vorlagen, ohne Einrichtung pro Lieferant und formatunabhängig. Der beste Weg, sie zu bewerten, ist ein Test mit Ihren tatsächlichen Lieferscheinen. Unser Lieferschein-Datenextraktor führt genau diese Extraktion durch – laden Sie eine Stichprobe hoch und sehen Sie die strukturierte Ausgabe – oder beginnen Sie mit unserer Schritt-für-Schritt-Anleitung zur Extraktion von Lieferscheinfeldern.