ベンダーリストに200件の名前がある
実際のサプライヤーは約120社
140人規模の企業で調達リードを務める方が、ベンダー統合プロジェクトと、財務部門からの出発点として「過去1年間に支払いを行った200社以上のベンダーリスト」を任されました。リストは存在しました。しかし、支出の実態を把握できる形にはなっていませんでした。同じサプライヤーが「4つの異なる表記」で登場し、経費精算の記録ではベンダー欄に会社名ではなく従業員名が入っていたのです。スレッドのコメント投稿者は、200件の行は実際には約120社のサプライヤーではないかと推測していました(r/procurement)。
200と120の差こそが問題の本質です。ベンダー名が信頼できるキーになるまでは、ベンダーリストの重複排除はできません。そして、中央管理のない個人カードでの購入が1年続いた後では、それはまだ実現していないのです。
重要ポイント
- 200件のベンダー名は通常、約120社の実在サプライヤーに集約されます。その差は単なる入力ミスではなく、個人カードでの購入が1年続いた場合の標準的な結果です。
- "AMZN MKTP US"と"Amazon.com"は同じサプライヤーですが、ファジーマッチングでは結びつきません。切り詰められたディスクリプタがブランド名の文字をほぼ共有していないためです。
- クレンジング対象のベンダーマスタは存在せず、1つのテーブルにまとめられたことのないレシートと明細があるだけです。名前のマッチングの前に、すべてのレコードを同じ列構成の1つのシートにまとめましょう(ImageToTable.aiはレイアウトではなく列名で読み取ります)。
統合期限が迫る中、誰も使えないリストが手元にある
財務部門のベンダーリストは、誰に支払われたかを教えてくれます。しかし、実際に誰から購入しているかを教えてくれることはほとんどありません。ベンダー支出の統合はこの2つ目の問いに依存しています。サプライヤーごとに支出を合計しようとしたとき、同じ会社の行なのに名前が一致しないことに気づくまでは、この2つは同じことのように思えるものです。
データ自体は十分に揃っています。問題はキーが信頼できないことであり、すべての統合の問いはそのキーの先にあります。
サプライヤーを総支出でランク付けするには、安定した名前が必要です。3つのチームが重複するプロジェクト管理ソフトウェアに支払っていることを見抜くにも、安定した名前が必要です。交渉したレートが実際に使われているかを確認するにも、安定した名前が必要です。キーが、購入のたびに別の人が別の日に打ち込んだ名前である場合、これらの問いにはどれも答えられず、生み出すはずだった交渉力は決して実現しません。
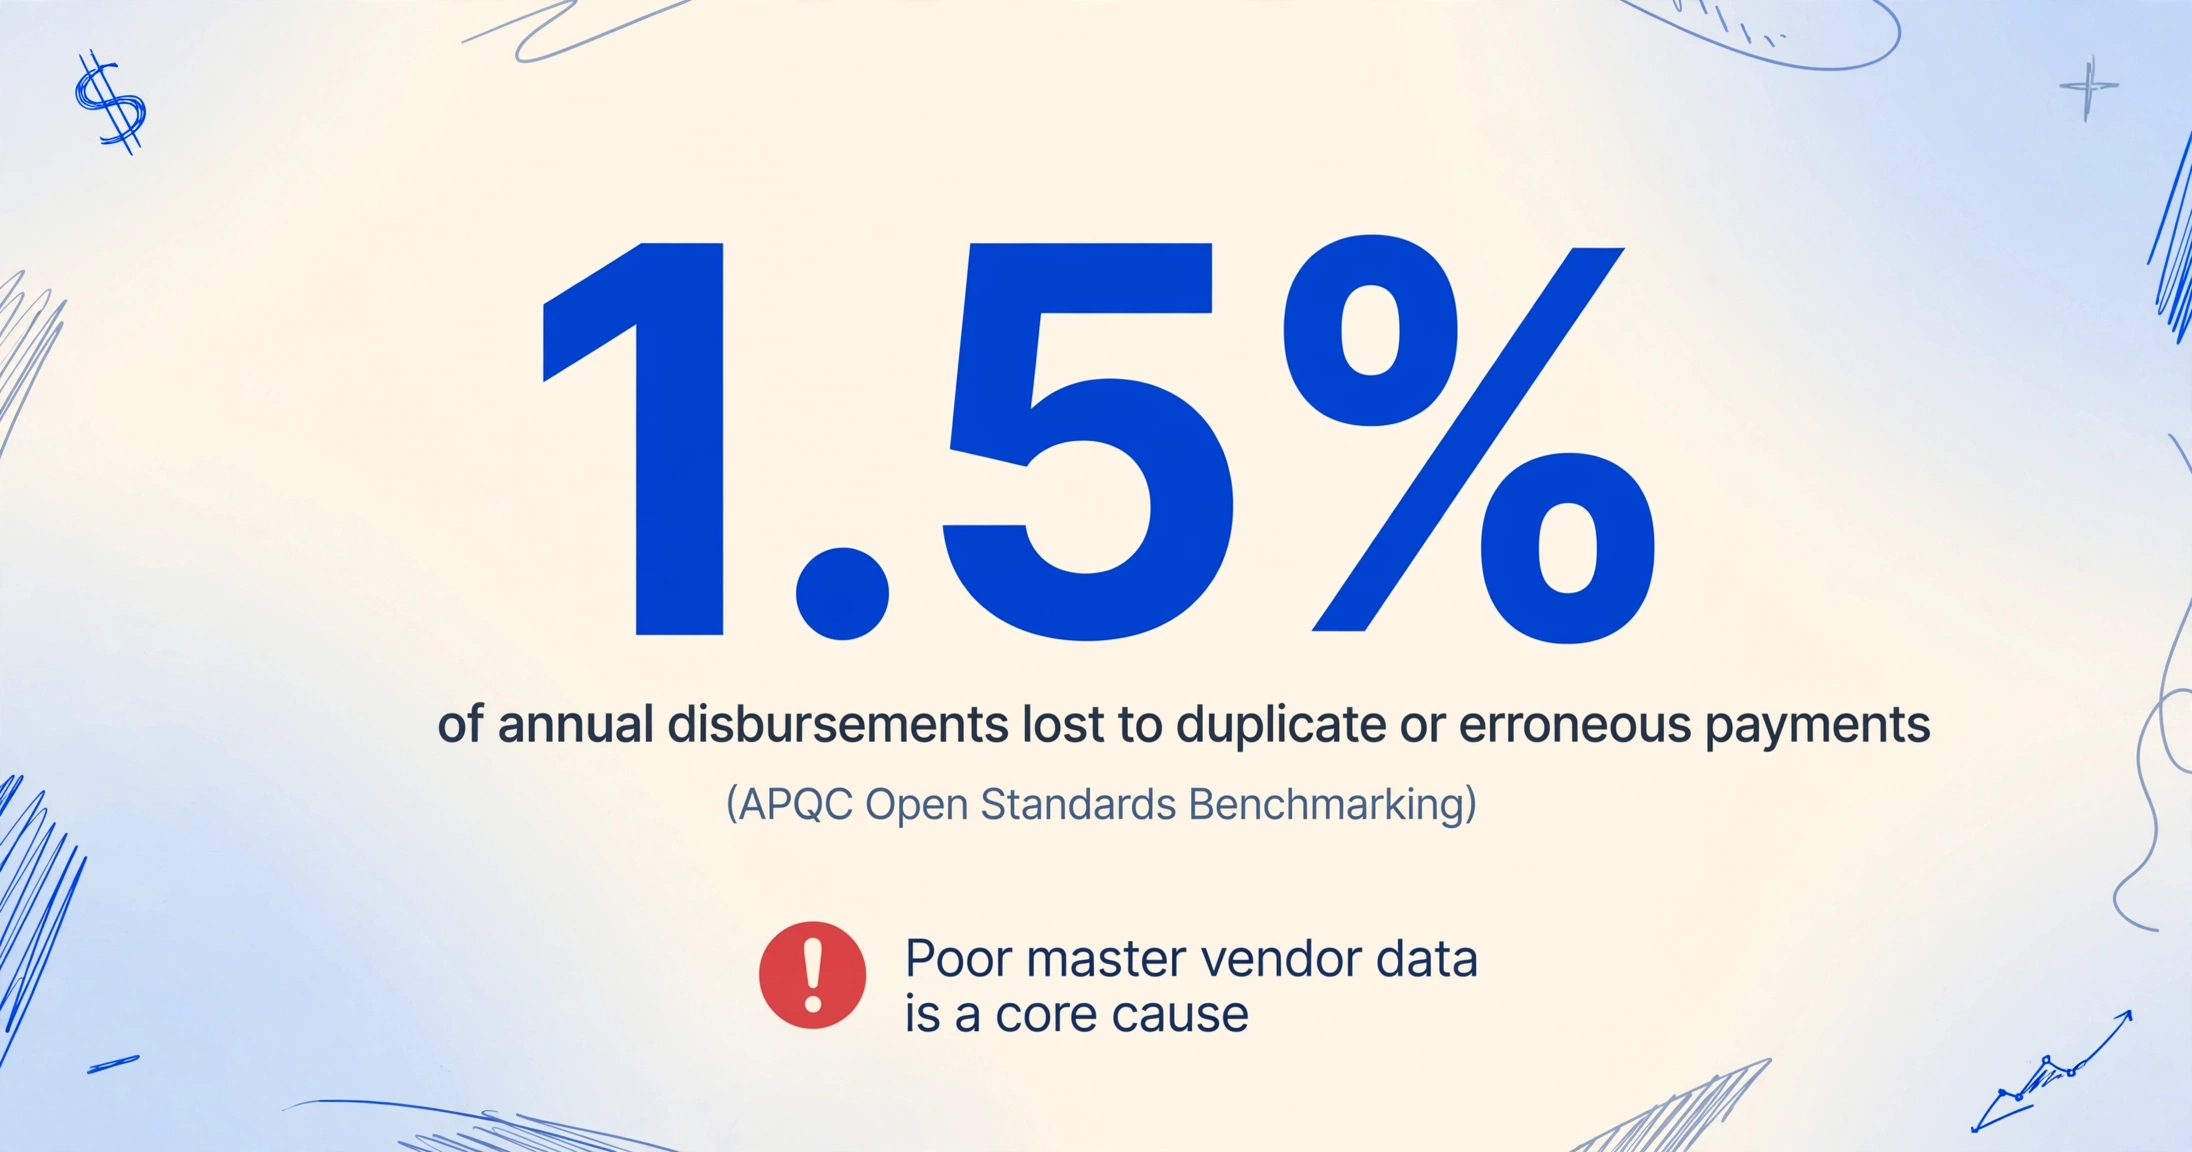
この失敗のコストは抽象的なものではありません。APQCのOpen Standards Benchmarkingによると、中央値の組織では重複または誤った支払いが年間支出の1.5%に達し、上位の組織でも0.8%に上ります(APQC)。APQCは、マスターベンダーファイル内のデータ品質の低さを主な原因の1つとして挙げています(これは、お客様がゼロから構築しようとしているリストと同じ種類のものです)。支出が$10Mの企業では、より良いサプライヤー可視性があれば防げたはずの漏れが6桁に達する可能性があります。
レコードが実際に存在する場所
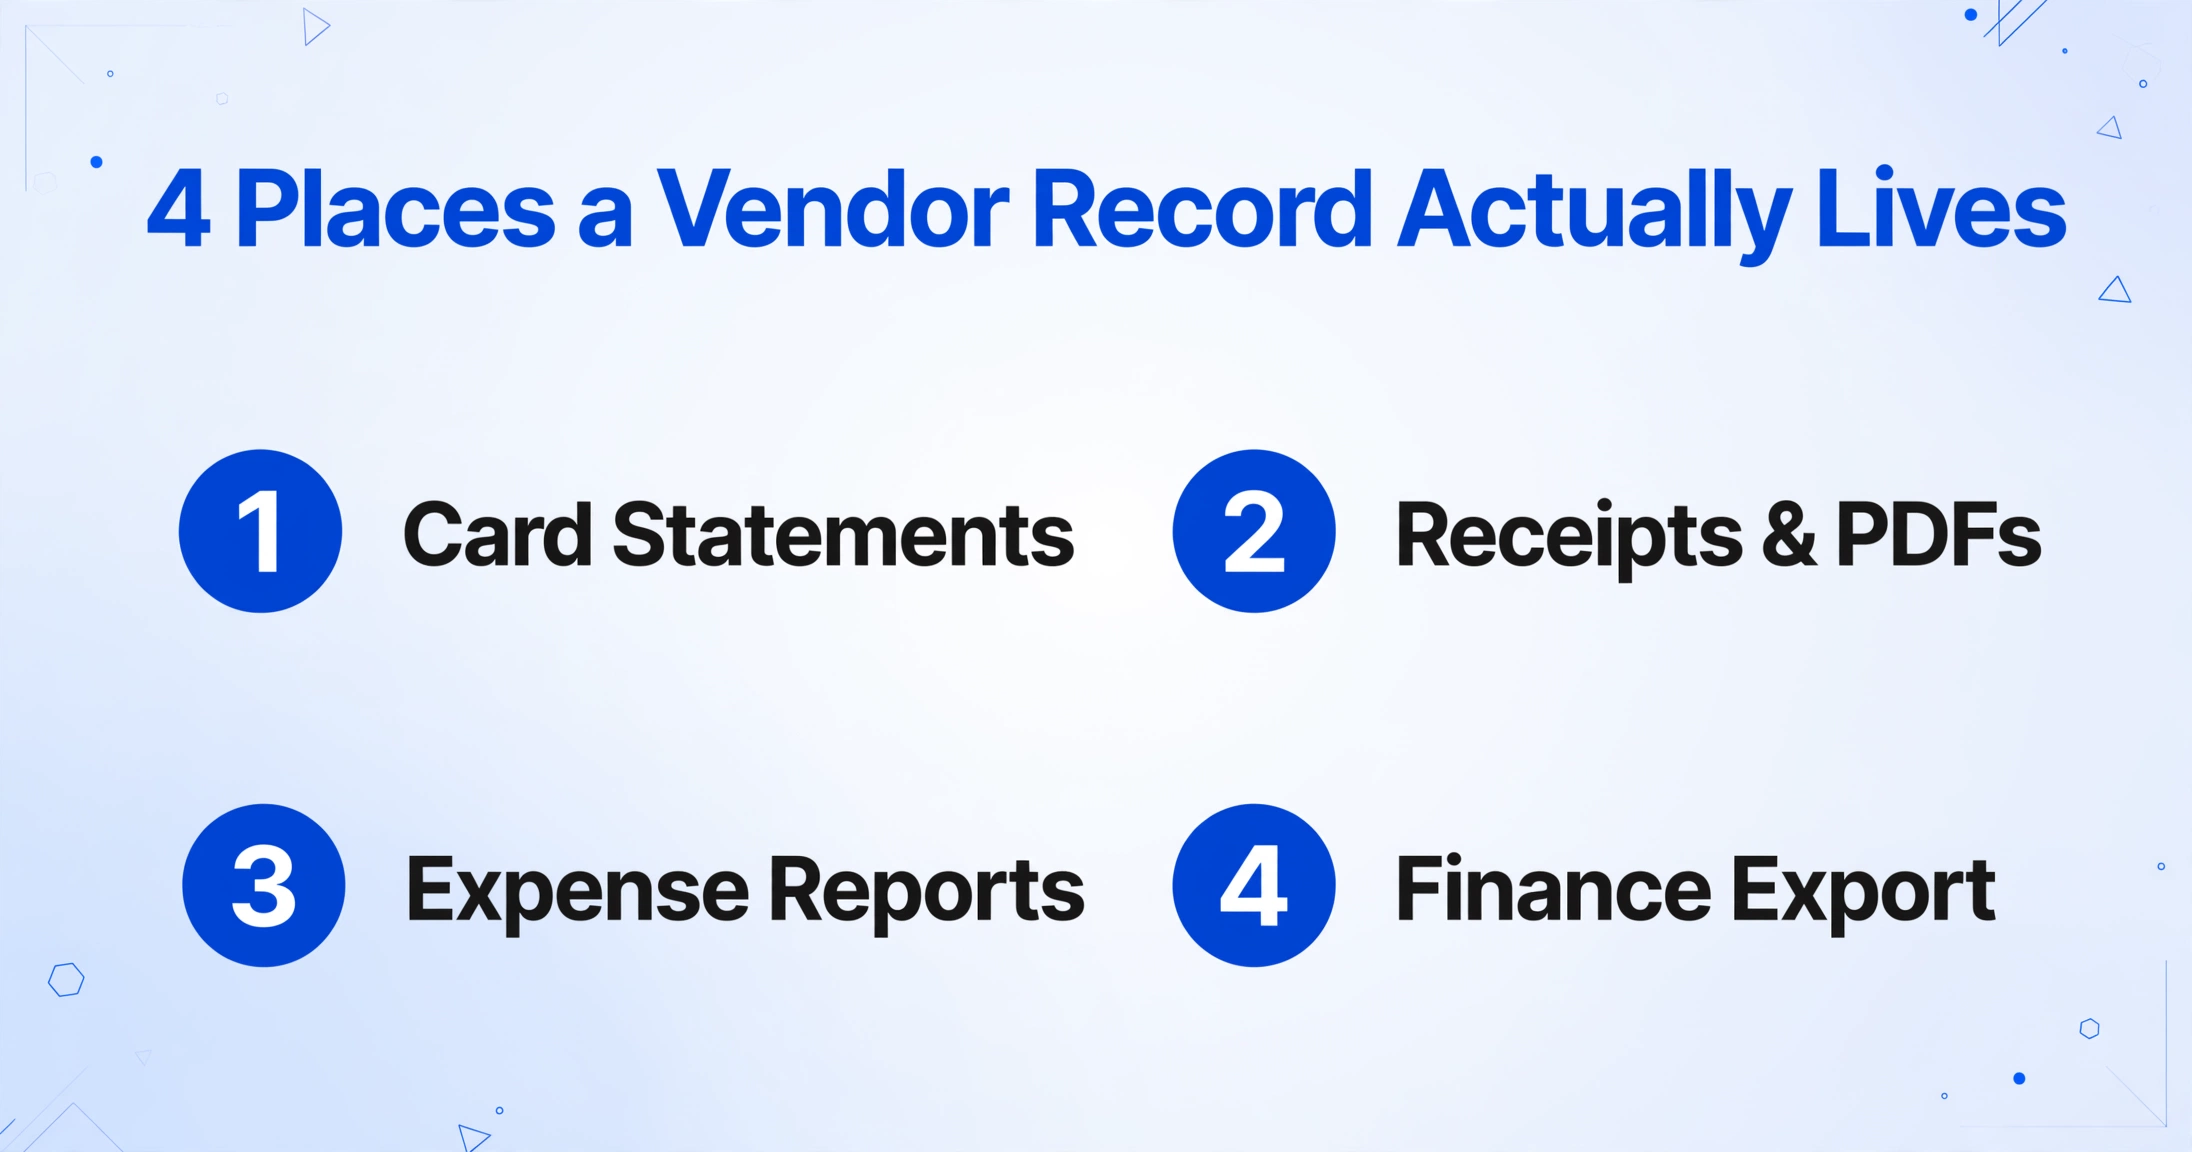
購買システムを持たない企業では、ベンダーレコードは一箇所に存在しません。サプライヤーをそれぞれ異なる名前で呼ぶ4つのソースに分散しています。
カード明細
マーチャントディスクリプタに記載されている内容です。これは機械生成された文字列であり、人間が選んだ名前ではありません。
領収書と請求書PDF
実際のドキュメントであり、多くの場合写真です。実際の取引名が表示される唯一の場所であることも少なくありません。
経費報告書
支払いを行った従業員によって提出されます。支払いは実際のものですが、報告書の「ベンダー」欄には従業員自身の名前が記載されることがよくあります。
財務エクスポート
上記の情報から作成されたスプレッドシートです。払い戻しまたは入力された内容をカバーしており、購入されたすべてのものを網羅しているわけではありません。
したがって、統合作業は「ベンダーマスターのクリーンアップ」ではありません。ベンダーマスターは存在しないからです。作業は、まず生のレコードからベンダーマスターを構築し、その後に皆さんが最初から始めていると思っていた名前マッチングの作業に取りかかることです。
1つの仕入先が4つの名前で表示される4つの理由
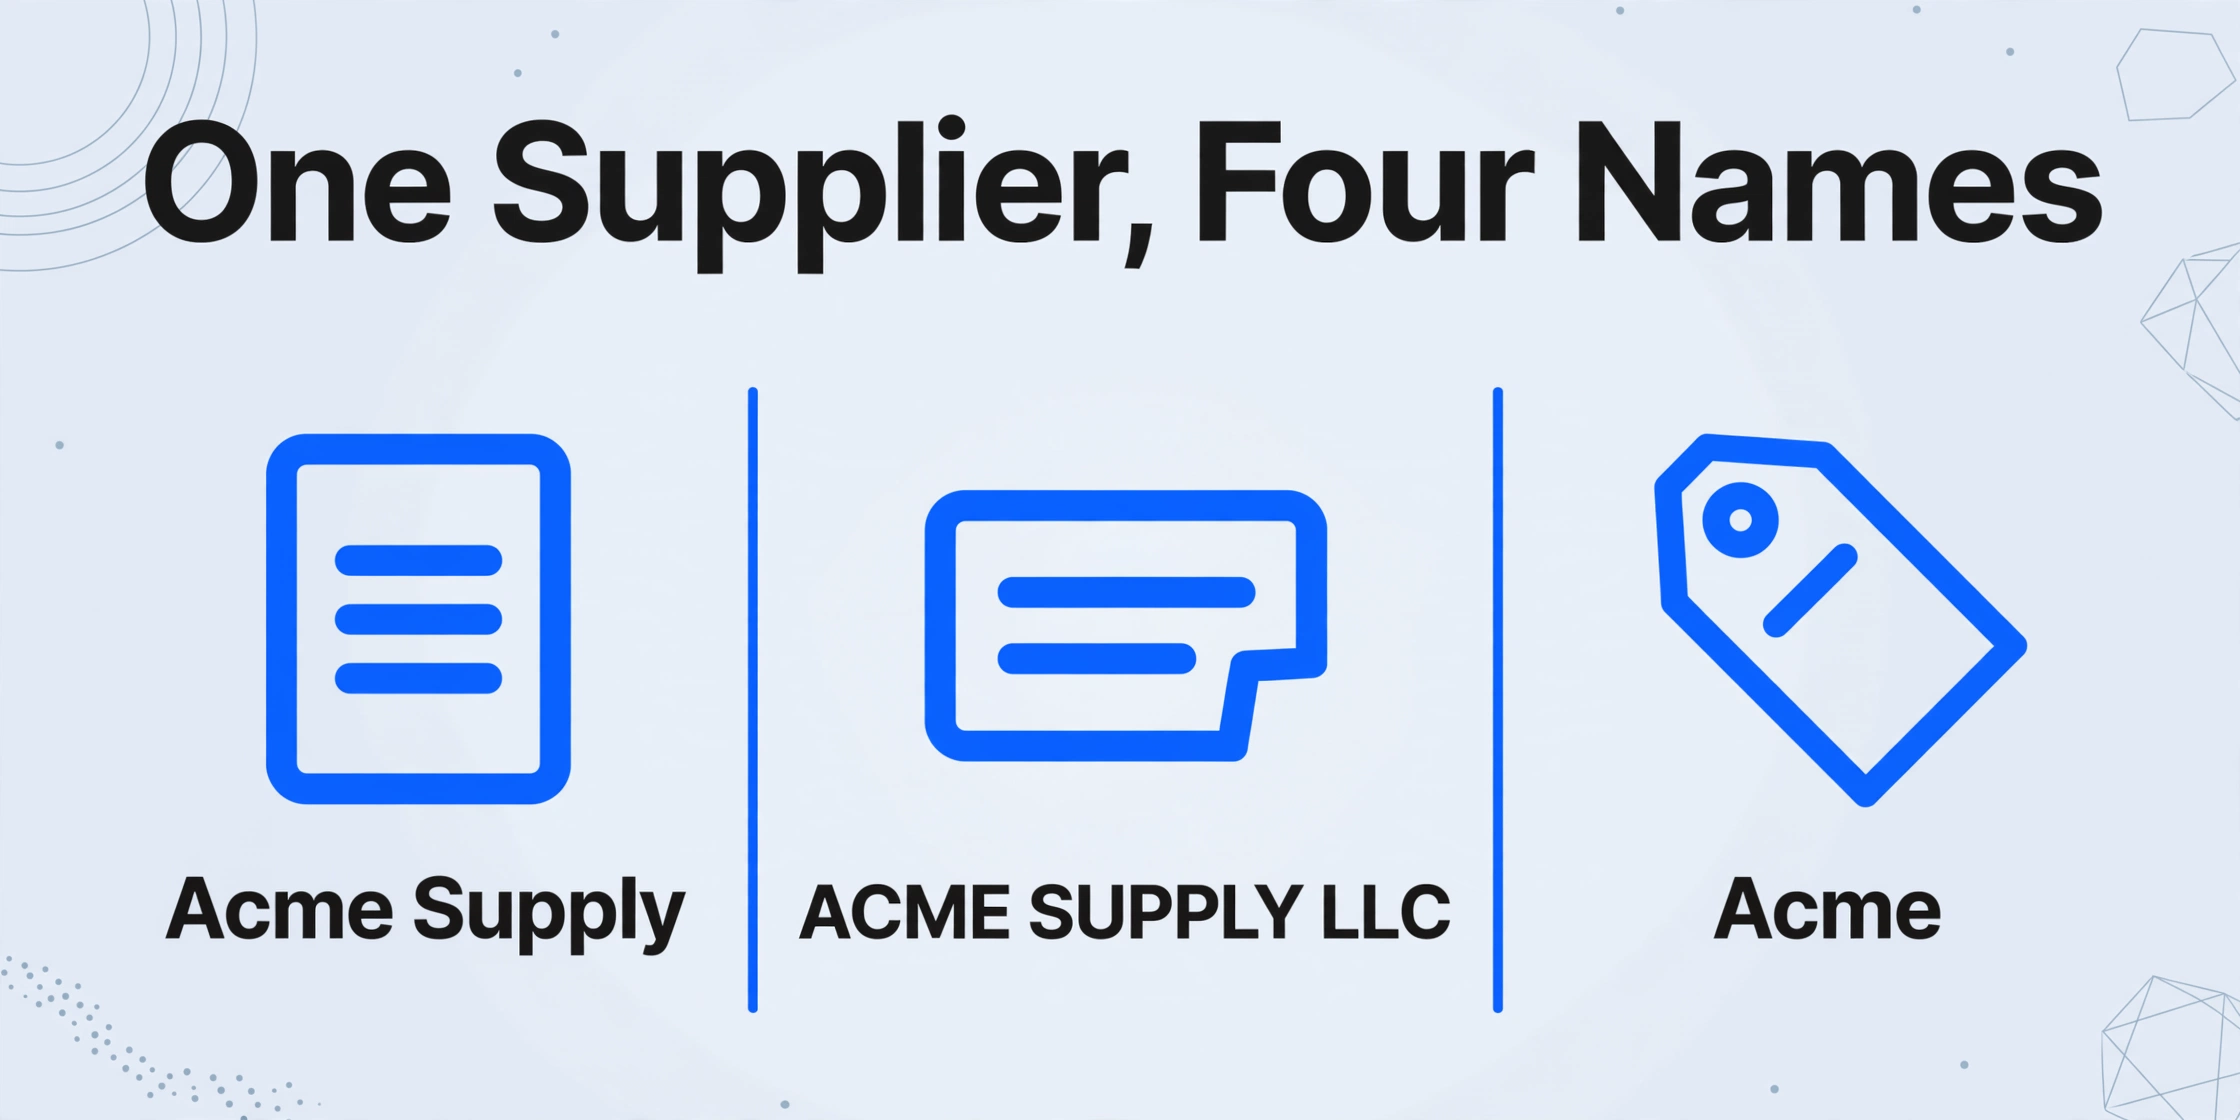
仕入先名のばらつきには機械的な原因があり、それを理解することで、どのバリエーションを安全に統合できるか、どのバリエーションに人の判断が必要かがわかります。
名前の所有者がいなかった。購買が分散していると、経費を申請する人が入力する内容を自由に決められます。ある従業員は「Acme Supply」と入力し、次の従業員は「ACME SUPPLY LLC」、3人目は「Acme」と入力します。Excelの条件付き書式やCOUNTIFで行うような完全一致の重複排除では、2つの文字列が同一になることはほとんどないため、ほぼ何も検出されません。
カードのディスクリプタは切り詰められ、エンコードされている。カードネットワークは加盟店ディスクリプタに上限(一般的に22文字)を設けており、処理業者は独自のタグをその前に付加します。Amazonでの購入は明細にAMZN MKTP USとして表示され、Squareでの支払いはSQ *MERCHANTとして表示されます。ブランド名は消え、コードに置き換わります。同じ購入の領収書には「Amazon.com」と記載されています。文字列類似度アルゴリズムでも、これら2つはほとんど文字を共有していないため、関連付けることはできません。
法的名称、DBA、送金先はそれぞれ異なる文字列である。仕入先の法的な事業体が「Northwind Logistics Holdings LLC」であっても、商号が「Northwind」であり、送金先住所がファクタリング会社や決済処理業者のものである場合があります。IOFMは、W-9のDBA欄が、法的名称と異なる請求書名を買い手が照合できるようにするために存在すると指摘しています(IOFM)。大規模な仕入先は部門ごとに請求書を発行することもあり、同じ親会社が同じ税IDで3つの別々の仕入先として表示されることがあります。
経費精算では、支払先ではなく支払者が記録される。従業員が支払いを行い、払い戻しを受ける場合、経費システムの取引は従業員に紐付けられます。仕入先は領収書の画像にのみ表示されるか、領収書がない場合はまったく表示されないこともあります。
4つのメカニズム、4つの名前。大文字小文字の違い、句読点、IncとIncorporatedのような接尾辞を加えると、200対120という比率はもはや外れ値ではなく、標準的な結果のように見えてきます。
ファジーマッチングで解決できることとできないこと
ファジーマッチングは標準的な次の手段であり、問題の一部を解決します。これは、2つの文字列が同一であることを要求するのではなく、類似度をスコアリングします。一般的な指標は、編集距離(Levenshtein。スコアは文字の変更回数)とトークンベースの類似度(Power QueryのファジーマージはJaccard類似度アルゴリズムを使用。詳細はMicrosoftのドキュメントを参照)です。類似度のしきい値を設定し、それを超えるものはすべて一致候補としてフラグが立てられます。
ファジーマッチングは候補を生成します。判断は行わず、選択したしきい値によって、見逃しと誤マージのどちらのエラーを優先するかが決まります。
しきい値が問題の核心です。しきい値を下げて「ABC Supply Inc.」と「ABC Supply LLC」を捕捉しようとすると、トークンを共有する無関係な名前もマージし始めます。Excel Universityの読者がこの失敗を正確に記録しています。しきい値0.9では「Titan」と「Twitch」、「SAVE」と「Pave」がマッチし、Inc./LLCのバリエーションを捕捉するために約0.5に下げると、レビューするにはあまりにも多くの誤検出が発生しました(Excel University)。名前だけではこのトレードオフを調整で回避できません。そのため、本番の重複排除では、名前を住所、税ID、銀行詳細、取引パターンなどの補助属性と照合して重み付けします。
ここでは、しきい値よりも重要な2つの制限があります。まず、ファジーマッチングはディスクリプタコードでは完全に機能しません。「AMZN MKTP US」と「Amazon.com」は類似した文字列ではないからです。次に、1つの親会社の3つの部門が1つのベンダーなのか3つのベンダーなのかを判断できません。これは、1つの関係として交渉するか3つとして交渉するかによって決まり、文字列比較ではなくビジネス上の判断です。
また、ここでの作業は重複支払いの検出とは異なります。同じ請求書が2回支払われたことを検出するのは履歴との比較であり、これらの障害モードについては重複請求書の検出で説明しています。散在した非中央集権的なレコードから1つのクリーンなベンダーリストを構築することは、母集団全体にわたるグループ化の問題であり、一貫性のない名前に依存する重複チェックは、検出対象のペア自体を見逃してしまうため、重複支払いチェックを信頼できるようにする前に解決する必要があります。
ファジーマッチングも他のすべてのクリーンアップ手法も、1つのことを前提としています。それは、すべてのレコードがすでに使用可能なベンダー列を持つ単一のテーブルにあることです。個人カードでの購入が1年続いた後では、そうはなっていません。そこが最初に修正すべきステップです。
ステップ1:すべてのレコードを同じ列構成の1枚のシートにまとめる
名前を正規化する前に、すべての領収書、請求書、明細書の行を、同じ列見出しの下で1か所にまとめる必要があります。これはデータ抽出の作業であり、写真、スキャン、PDFなど、さまざまな形式の書類を扱うため、ドキュメントのレイアウトに依存しない方法で行う価値があります。
ImageToTable.aiはカスタム列抽出を使用します。必要な列名を入力すると、AIがフィールドの意味を理解して、ページ上のどこからでも該当する値を探し出します。この作業では、列セットは小さく安定しています:
ベンダー名(ドキュメントまたはディスクリプタに印刷されている通り)取引日(YYYY-MM-DD)金額カード(購入に使用したカード)カテゴリ(オプション:ソフトウェア/オフィス/旅行/食事/その他)
これらの列のうち2つは、見た目以上に重要な役割を果たします。ツールがルール形式と呼ぶ日付形式の指示により、すべてのサプライヤーの日付が同じ文字列として出力されるため、並べ替えや期間フィルタリングが初回から機能します。カテゴリ列は推論列の例であり、AIが領収書の内容を読み取り、提供されたオプションから選択して、ドキュメントに印刷されていない値を補完します。これにより、分類が抽出と同時に行われ、別のパスになることはありません。
このツールはバッチファースト処理のため、フォルダ全体をアップロードすると、1ファイルずつではなく、1つの結合されたシートが得られます。複数ページにわたるカード明細書は、マルチページマージというテンプレート設定で処理されます。これは、同じ明細書に属するページを1つのレコードにグループ化し、アカウントレベルの情報が明細項目全体に引き継がれるようにします。年度末の大量データを処理する場合も、同じバッチとマージのフローがバッチクレジットカード明細書処理で詳しく説明されています。
開始場所は、ドキュメントの種類によって異なります。山の大部分が領収書の写真やメールの請求書である場合は、領収書からExcelへのワークフローが最速の入り口です。毎月の明細書の山である場合は、代わりにクレジットカード明細書抽出のページから始めてください。どちらの場合も、出力は同じ形状のテーブルであり、それがポイントです。
ファイルは安全に処理され、保存されません。
出力結果が「きれいなベンダーリスト」ではない点に注意してください。抽出では、ベンダー名がソースに記載されている通りにすべてのレコードが1つのテーブルにまとめられます。それが判断ステップのための生の材料です。これらの名前を信頼する前に検証するのは簡単です。抽出されたセルにホバーまたはクリックすると、元の画像上の正確な位置がハイライトされ、画像上の領域をクリックすると対応するセルにジャンプします。これがBbox検証機能付きのレビューモードであり、不審な文字列が実際にドキュメントに記載されている内容なのか、それとも読み間違いなのかを確認できます。
ステップ2:データを見ながら正規マッピングを手作業で構築する
ベンダー名の正規化は判断が必要なタスクであり、正直なところ、抽出されたテーブルを並べ替えて判断順序を明確にし、自分で行うのが正解です。合計金額の降順で並べ替え、上から順に処理してください。
各サプライヤーについて正規名を決定し、2番目の列にすべてのバリエーションをマッピングします。実用的な構造は3つの列です。抽出された元のVendor Name、入力するVendor (canonical)列、そして統合したバリエーションのエイリアスメモです。これにより、監査用の元の文字列が保持され、ピボットに使える安定したデータが得られます。
リストの上位はすぐに整理できます。8つのデザインエージェンシーは8つの正規名になります。重複する3つのプロジェクト管理ツールは3つになり、重複が確認できたので1つを削除する判断ができます。AMZN MKTP US、AMAZON.COM、AMZN Primeの明細行群はすべてAmazonに属しますが、AWSはインフラ費用であり通常は別の項目に属するため、グループ化の判断は単に「類似するものを統合する」だけではありません。この区別こそファジーマッチングでは行えないことであり、アルゴリズムの出力を受け入れるのではなくマッピングをレビューする理由です。
サポート列を使用して、推測ではなく確認を行ってください。2つのバリエーションでカード、日付範囲、定期的な金額が同じ場合、それらはほぼ間違いなく同じベンダーです。一方、「Supply」のようなトークンのみが共通している場合は、おそらく異なるベンダーです。機械可読な識別子が存在する場合は、それが最も信頼できる証拠となります。税IDや正確な住所は、名前の類似性スコアよりも優先されます。
空白の列ではなく出発点が必要な場合は、推論列が各行の正規グループ化または正規化された名前を提案できます。ドラフトとして扱ってください。信頼する前に支出合計と照合し、末尾の部分は手作業で修正する必要があると想定してください。誤った統合の結果(実際には2つのサプライヤーが1つにまとめられ、再交渉したい関係が隠れてしまうこと)は、候補をレビューするコストよりも悪いため、判断はお客様側に残ります。
これは、1つのベンダーの請求書内の形式を標準化するタスクよりも狭い範囲のタスクであり、ベンダー請求書データの標準化で個別に説明しています。ここでは形式は抽出時にすでに処理されており、構築しているのはその上に重ねるアイデンティティ層です。
このアプローチでまだできないこと
上記の手順でクリーンなリストが作成されます。ただし、判断作業がなくなるわけではなく、自動化がどこまで対応するのかを明確にしておく価値があります。
これは自動的なベンダーマスターの重複排除エンジンではありません。抽出処理によりすべてのレコードが生のベンダー名とともに1つのシートにまとめられますが、どの名前が同じ事業体かを判断するわけではありません。そのマッピングはお客様が定義するものであり、このツールの役割は、そのマッピングを迅速に構築し、簡単に検証できるようにすることです。
ファジーマッチングは、ディスクリプタコードのような無関係な文字列では依然として失敗するため、純粋にアルゴリズムによる処理ではAMZN MKTP USのような行はマージされないままになります。親会社とその部門が1つのベンダーなのか複数のベンダーなのかは、技術的な判断ではなくビジネス上の判断であり、どのツールでも代わりに判断することはできません。また、経費精算に領収書が添付されておらず従業員の名前だけが記載されている場合、レコードからベンダーを特定する方法がないこともあります。そのようなケースは、データではなく、カード明細書または従業員から確認して解決する必要があります。
カード明細書と帳簿の照合はまた別の作業であり、個人用カードと会社用カードを混在させると独自の問題が発生します。これについてはクレジットカードの照合で説明しています。まずベンダー層を正しく整えることで、毎月同じ仕入先を再判断する必要がなくなるため、その照合が容易になります。
ベンダーリストの重複排除:FAQ
ベンダーリストにExcel Power Queryのファジーマッチングを使うだけではだめですか?
使用することは可能で、一部のバリエーションは検出できますが、この特定の作業には2つの盲点があります。ディスクリプタコードとブランド名は類似した文字列ではないため、それらを関連付けることはできません。また、接尾辞のバリエーションを検出するしきい値では、無関係な名前もマージされてしまうため、結局すべての候補を確認することになります。Power Queryは、レコードがすでに1つのシートにまとめられ、候補リストを調整する段階で最も有用であり、最初の唯一のステップとしては適していません。
この規模の会社に、完全なベンダーマスターシステムは必要ですか?
100〜300人規模の会社であれば、支出管理プラットフォーム(Ramp、Brex、Expensify、Bill.com)が、今後の支出をカードにルーティングし、購入時点でベンダーを分類して重複をフラグ付けすることで、継続的な問題を解決します。CoupaやZipなどのツールは、より大規模な調達にまで対応します。しかし、これらのどれも、個人カードで既に購入されたものの記録を再構築することはありません。その過去のリストは、依然としてドキュメントから再構築する必要があり、このアプローチが対応するのはその部分です。
AIがベンダー名を抽出しましたが、まだ不整合です。どうすればよいですか?
それは想定内です。抽出はソースに表示されている名前をそのまま再現するため、ソース自体が不整合なのです。次のステップは正規マッピングです。支出順に並べ、バリアントをグループ化し、実際のサプライヤーごとに正規名を1つ割り当てます。抽出されたテーブルにVendor (canonical)列を加えたものが成果物であり、これによって合計額が信頼できるものになります。
従業員の名前しか表示されない経費精算はどう処理すればよいですか?
領収書またはカード明細書をベンダーの情報源として使用し、金額と日付で経費精算に結合します。領収書がない場合は、カードのディスクリプタがフォールバックになります。そのため、コードのように見えても、明細書から生のベンダー文字列を取得することが重要です。両方ともない場合、その経費はデータから復元できないため、手動で追跡する必要があります。
このリストはどのくらいの頻度で再構築すべきですか?
正規マッピングができれば、既存のサプライヤーからの新規購入は、すでに定義した名前にマッピングされるため、継続的なメンテナンスは軽くなります。新しい支出について抽出とマッピングを再実行し、未マッチの名前を定期的に確認してください。四半期ごとが、APチームがベンダーマスターのレビューで一般的に使用する頻度であり、リストがバリエーションの山に戻ってしまうのを防ぎます。
ベンダー統合のボトルネックはアイデンティティ層であり、各レコードがどのサプライヤーに属するかを判断することに時間がかかります。その層がスプレッドシートに存在すれば、支出のランキングと統合機会の発見は数週間ではなく数分で完了します。それが存在しなければ、リスト上に構築するすべてのレポートは、その下にある名前と同じだけの安定性しかありません。経費ドキュメントから構造化データを抽出する全体像については、経費レポートデータ抽出ガイドをご覧ください。記録が数ヶ月にわたる場合は、年末取引抽出とクレジットカード照合パイプラインが、同じ抽出テーブルがどのように照合と、その後のERPなしのスリーウェイマッチング作業に活用されるかを示しています。