Su lista de proveedores tiene 200 nombres
Unos 120 proveedores reales
Un responsable de compras en una empresa de 140 personas recibió un proyecto de consolidación de proveedores y un punto de partida de finanzas: una lista de más de 200 proveedores pagados en el último año. La lista existía. Una imagen útil del gasto, no. El mismo proveedor aparecía "de 4 maneras diferentes", como dijo el autor de la publicación, y en los registros de reembolso el campo de proveedor contenía nombres de empleados en lugar de nombres de empresas. Un comentarista del hilo calculó que las 200 filas probablemente correspondían a unos 120 proveedores reales (r/procurement).
Esa brecha entre 200 y 120 es todo el problema. No puede deduplicar una lista de proveedores hasta que el nombre del proveedor se convierta en una clave confiable, y después de un año de compras con tarjetas personales sin seguimiento centralizado, todavía no lo es.
Conclusiones Clave
- 200 nombres de proveedores generalmente se resuelven en unos 120 proveedores reales, y esa brecha no es un error de captura de datos sino el resultado predeterminado de un año de compras con tarjeta personal.
- "AMZN MKTP US" y "Amazon.com" son el mismo proveedor, pero ninguna coincidencia difusa los conecta, porque el descriptor truncado no comparte casi ninguno de los caracteres del nombre de la marca.
- No hay un maestro de proveedores que limpiar, solo recibos y estados de cuenta que nunca estuvieron en una sola tabla, así que antes de comparar nombres, ponga cada registro en una sola hoja con las mismas columnas (ImageToTable.ai lee por nombre de columna, no por diseño).
La fecha límite de consolidación se topa con una lista que nadie puede usar
Una lista de proveedores de finanzas le dice a quién se le pagó. Rara vez le dice a quién le está comprando realmente. La consolidación del gasto por proveedor depende de esa segunda pregunta, y ambas cosas suenan igual hasta que intenta sumar el gasto por proveedor y descubre que no hay dos filas de la misma empresa que coincidan en el nombre.
Los datos son lo suficientemente completos. El problema es que la clave no es confiable, y todas las preguntas de consolidación dependen de esa clave.
Clasificar a los proveedores por gasto total requiere un nombre estable. Detectar que tres equipos pagan por software de gestión de proyectos superpuesto requiere un nombre estable. Verificar si una tarifa negociada se está utilizando realmente requiere un nombre estable. Cuando la clave es un nombre que fue escrito por una persona diferente en un día diferente para cada compra, ninguna de esas preguntas puede responderse, y el poder de negociación que se suponía que debía crear nunca se materializa.
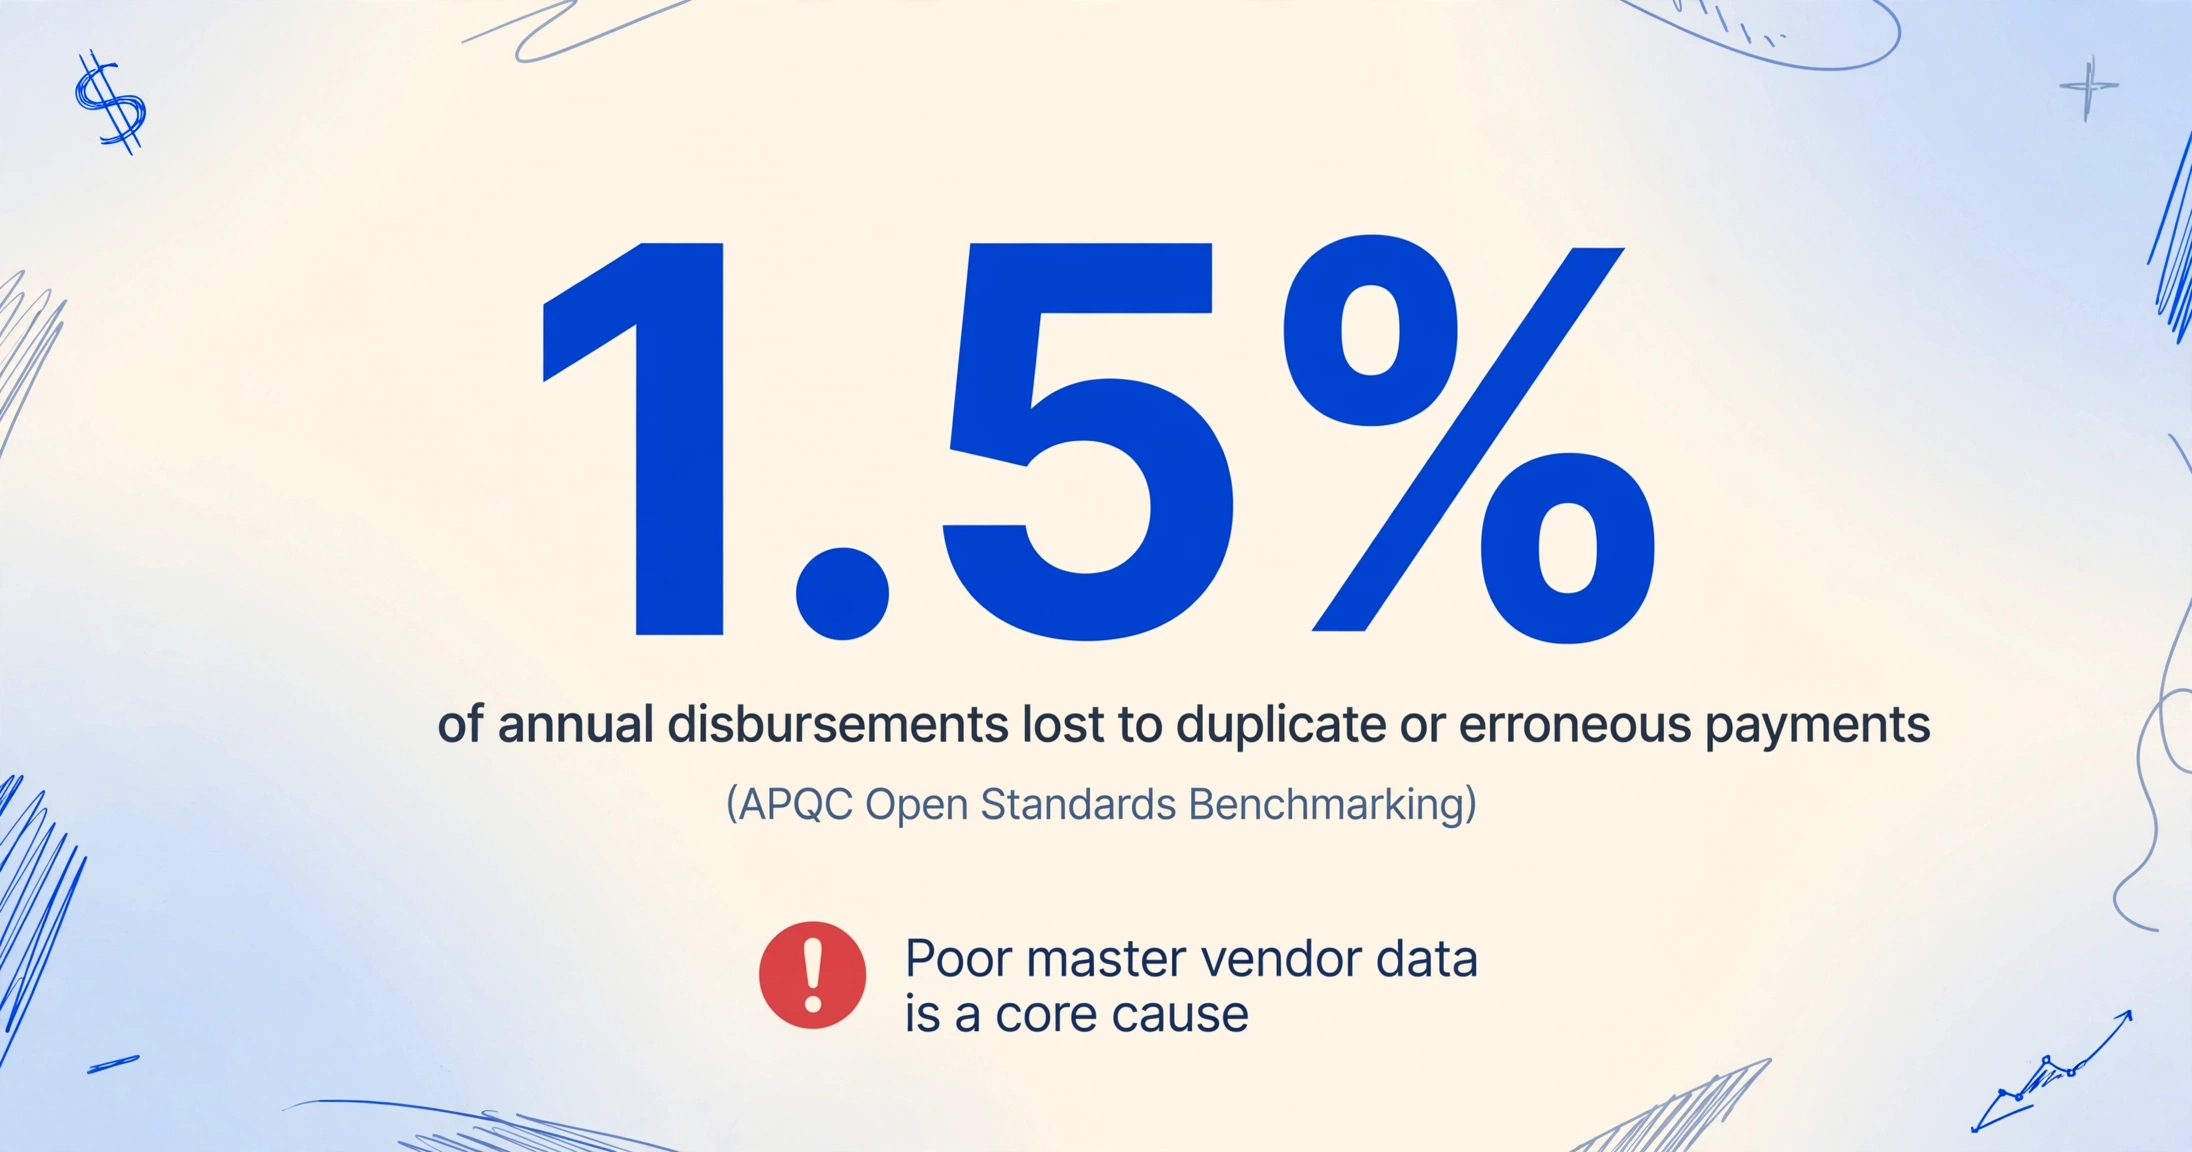
El costo de hacer esto mal no es abstracto. El Open Standards Benchmarking de APQC sitúa a la organización mediana con pagos duplicados o erróneos equivalentes al 1.5% de los desembolsos anuales, y los de mejor desempeño aún en el 0.8% (APQC). APQC señala los datos de mala calidad en el archivo maestro de proveedores como una de las causas principales (esta es la misma clase de lista que usted está tratando de construir desde cero). Una empresa con $10M en gasto está viendo seis cifras de fuga que una mejor visibilidad de proveedores habría detectado.
Dónde viven realmente los registros
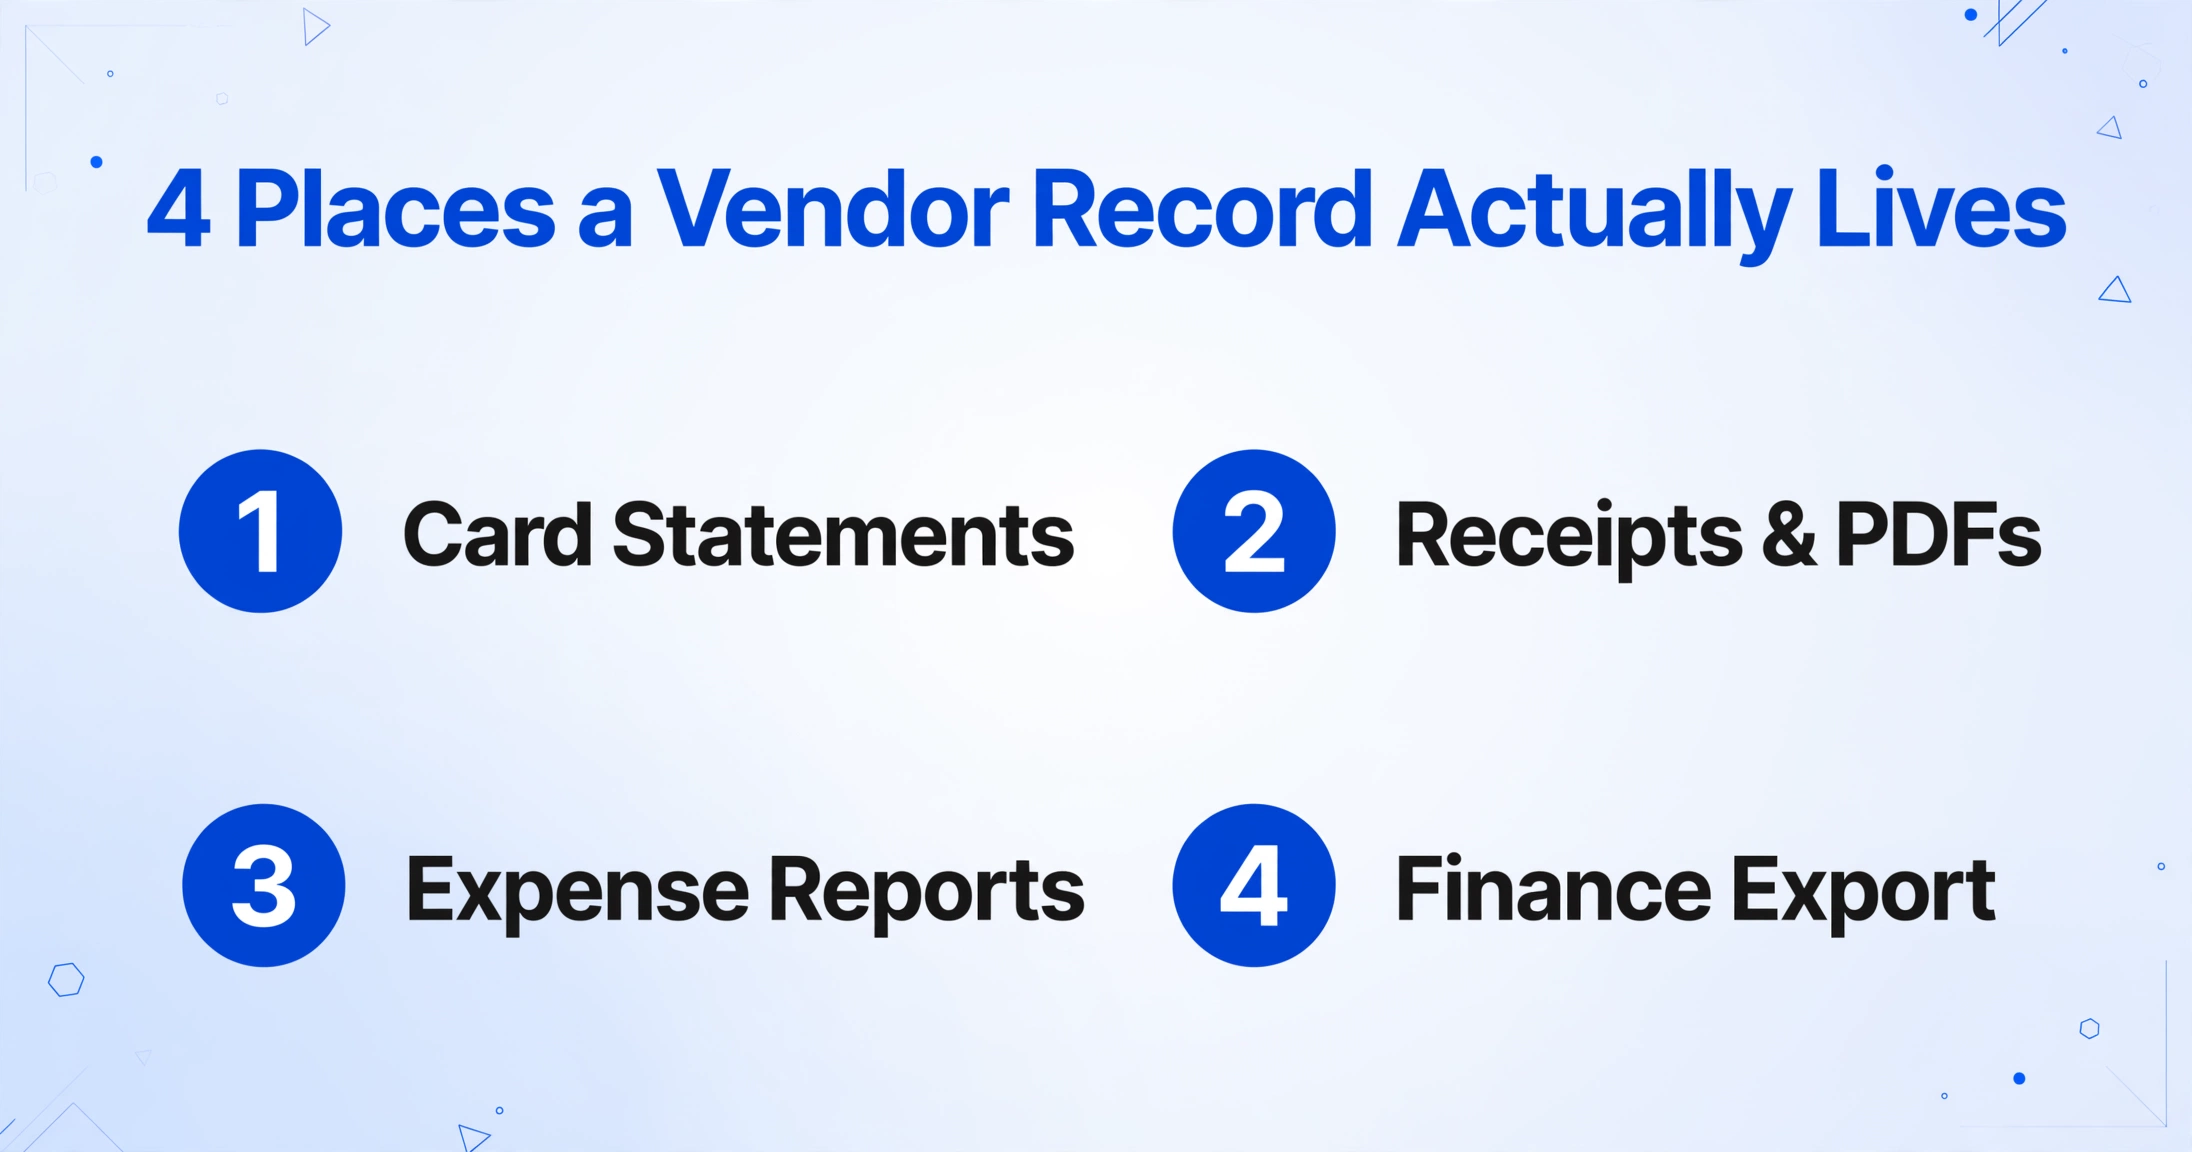
En una empresa sin sistema de compras, el registro del proveedor no está en un solo lugar. Está disperso en cuatro fuentes que nombran al proveedor de forma distinta.
Estados de tarjeta
Lo que diga el descriptor del comercio. Es una cadena generada por máquina, no un nombre elegido por una persona.
Recibos y PDF de facturas
El documento real, a menudo una foto. Con frecuencia es el único lugar donde aparece el nombre comercial real.
Informes de gastos
Presentados por el empleado que pagó. El pago es real, pero el campo «proveedor» del informe suele ser el nombre del propio empleado.
La exportación de finanzas
Una hoja de cálculo armada a partir de lo anterior. Cubre lo que se reembolsó o ingresó, no todo lo que se compró.
Por lo tanto, la tarea de consolidación no es «limpiar el maestro de proveedores». No existe un maestro de proveedores. La tarea es construirlo primero a partir de los registros en bruto, y solo entonces comenzar el trabajo de coincidencia de nombres que todos asumen que usted inició.
Cuatro razones por las que un proveedor aparece con cuatro nombres
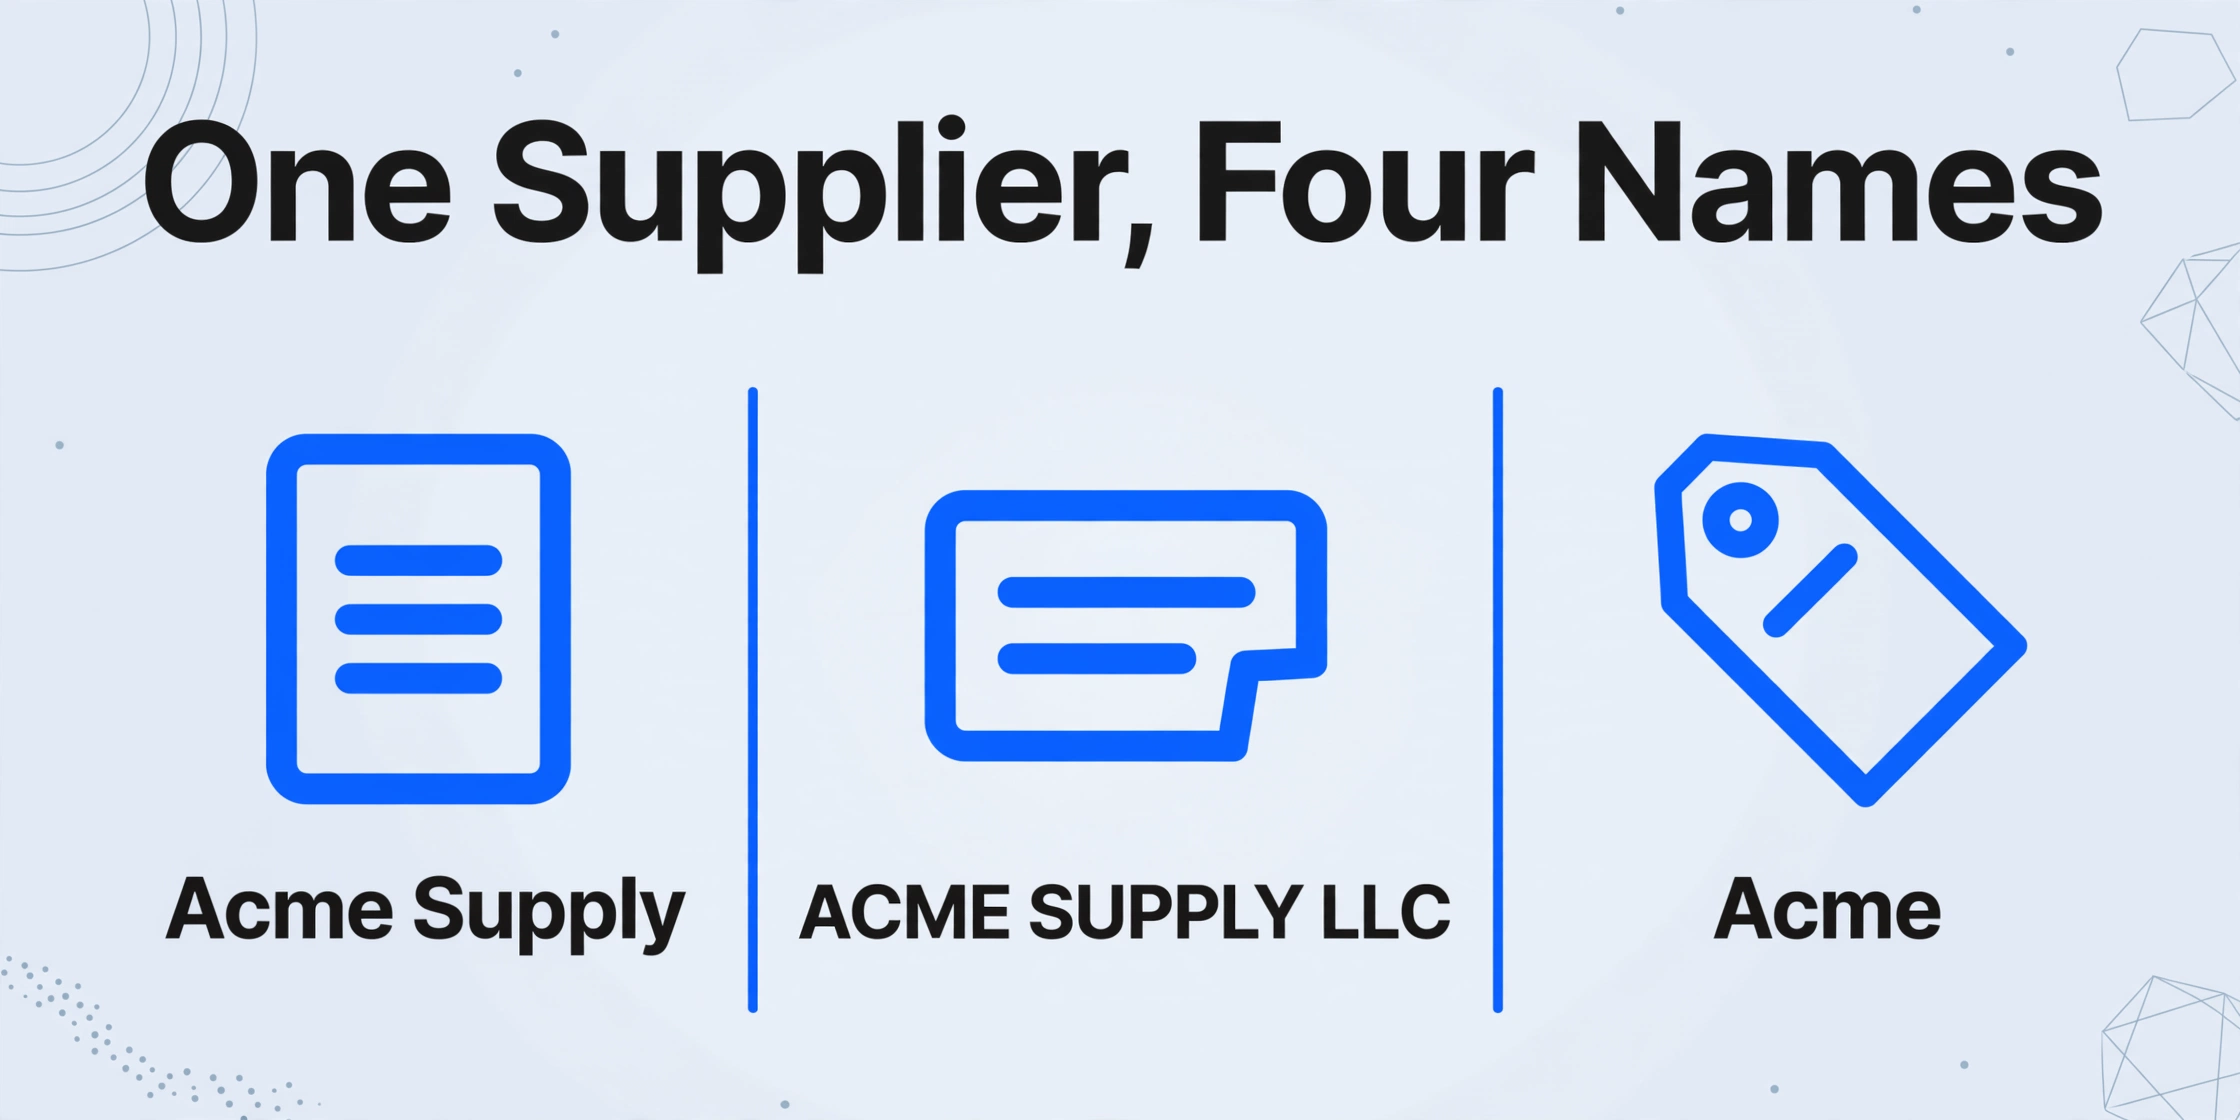
La variación en los nombres de proveedores tiene causas mecánicas, y conocerlas le indica qué variantes son seguras de fusionar y cuáles requieren una decisión humana.
Nadie era dueño del nombre. Con la compra descentralizada, la persona que presenta un gasto elige qué escribir. Un empleado escribe "Acme Supply", el siguiente escribe "ACME SUPPLY LLC", un tercero escribe "Acme". La deduplicación por coincidencia exacta, la que Excel hace con formato condicional o con COUNTIF, devuelve casi nada, porque no hay dos cadenas idénticas.
El descriptor de la tarjeta está truncado y codificado. Las redes de tarjetas limitan el descriptor del comercio (el límite suele ser de 22 caracteres), y los procesadores le añaden su propia etiqueta al inicio. Una compra en Amazon puede aparecer en el estado de cuenta como AMZN MKTP US, y un pago a través de Square como SQ *MERCHANT. El nombre de la marca desaparece y se reemplaza por un código. Un recibo de la misma compra dice "Amazon.com". Ningún algoritmo de similitud de cadenas conectará esos dos, porque no comparten casi ningún carácter.
El nombre legal, el DBA y el remitente son tres cadenas diferentes. La entidad legal de un proveedor puede ser "Northwind Logistics Holdings LLC", su nombre comercial puede ser "Northwind", y su dirección de remisión puede pertenecer a una empresa de factoraje o a un procesador de pagos. IOFM señala que el campo DBA en un W-9 existe precisamente para que un comprador pueda hacer coincidir un nombre de factura que difiere del nombre legal (IOFM). Los proveedores grandes también facturan desde divisiones, por lo que la misma empresa matriz puede aparecer como tres proveedores separados con el mismo ID fiscal.
Los reembolsos registran al pagador, no al beneficiario. Cuando un empleado paga y recibe un reembolso, la transacción en el sistema de gastos está vinculada al empleado. El proveedor puede aparecer solo en la imagen del recibo, o en ningún lugar si el recibo falta.
Cuatro mecanismos, cuatro nombres. Añada diferencias de mayúsculas, puntuación y sufijos como Inc frente a Incorporated, y la proporción de 200 a 120 deja de parecer un caso atípico y empieza a parecer el resultado predeterminado.
Lo que la coincidencia difusa puede y no puede resolver
La coincidencia difusa es el siguiente paso estándar y resuelve parte del problema. Evalúa qué tan similares son dos cadenas en lugar de exigir que sean idénticas. Las medidas habituales son la distancia de edición (Levenshtein, donde la puntuación es el número de cambios de caracteres) y la similitud basada en tokens (la fusión difusa de Power Query utiliza el algoritmo de similitud de Jaccard, según la documentación de Microsoft). Usted establece un umbral de similitud, y todo lo que esté por encima se marca como una posible coincidencia.
La coincidencia difusa genera candidatos. No toma decisiones, y el umbral que usted elija determina qué error prefiere: omisiones o fusiones falsas.
El umbral es donde falla. Si lo baja lo suficiente para capturar "ABC Supply Inc." y "ABC Supply LLC", comienza a fusionar nombres no relacionados que comparten tokens. Un lector de Excel University documentó el fallo con precisión: con un umbral de 0.9, la herramienta emparejó "Titan" con "Twitch" y "SAVE" con "Pave", y al bajarlo a aproximadamente 0.5 para capturar las variantes Inc./LLC se produjeron demasiados falsos positivos para revisar (Excel University). Usted no puede ajustar su salida de esa disyuntiva solo con nombres, por eso la deduplicación en producción pondera el nombre contra atributos de respaldo como dirección, ID fiscal, datos bancarios o patrón de transacciones.
Dos límites importan más aquí que el umbral. Primero, la coincidencia difusa falla por completo con los códigos descriptores, porque "AMZN MKTP US" y "Amazon.com" no son cadenas similares. Segundo, no puede decidir si tres divisiones de una misma matriz deben ser un proveedor o tres. Eso depende de si usted negocia con ellas como una relación o tres, y eso es una decisión comercial, no una comparación de cadenas.
Aquí es también donde el trabajo difiere de detectar un pago duplicado. Detectar que la misma factura se pagó dos veces es una comparación contra el historial, y cubrimos esos modos de fallo en detección de facturas duplicadas. Construir una lista limpia de proveedores a partir de registros desordenados y descentralizados es un problema de agrupación en toda una población, y debe resolverse antes de que cualquier verificación de pagos duplicados pueda ser confiable, porque una verificación de duplicados que se basa en un nombre inconsistente omite exactamente los pares que fue creada para encontrar.
Tanto la coincidencia difusa como cualquier otra técnica de limpieza asumen una cosa: que todos los registros ya están en una sola tabla con una columna de proveedor utilizable. Después de un año de compras con tarjeta personal, no lo están. Ese es el paso que debe corregirse primero.
Paso uno: consiga todos los registros en una sola hoja con las mismas columnas
Antes de que cualquier nombre pueda normalizarse, cada línea de recibo, factura y estado de cuenta debe existir en un solo lugar bajo los mismos encabezados de columna. Eso es una tarea de extracción de datos, y vale la pena hacerla de una manera que no dependa del diseño del documento, porque usted está tratando con fotos, escaneos y PDFs de docenas de comerciantes, todos con formatos diferentes.
ImageToTable.ai utiliza Extracción de Columnas Personalizadas: usted escribe los nombres de las columnas que desea, y la IA localiza el valor correspondiente en cualquier parte de la página al comprender qué significa el campo en lugar de dónde se encuentra. Para este trabajo, el conjunto de columnas es pequeño y estable:
Vendor Name(exactamente como aparece impreso en el documento o descriptor)Transaction Date (YYYY-MM-DD)AmountCard(en qué tarjeta se realizó la compra)Category (options: Software/Office/Travel/Meals/Other)
Dos de esas columnas hacen más trabajo de lo que parece. La instrucción de formato de fecha, que la herramienta llama Format Requirement, hace que la fecha de cada proveedor se convierta en la misma cadena, de modo que la clasificación y el filtrado por período funcionen desde el primer intento. La columna Category es un ejemplo de columna inferida, donde la IA completa un valor que no está impreso en el documento al leer el contenido del recibo y elegir entre las opciones que usted proporcionó. Así, la clasificación viaja junto con la extracción en lugar de convertirse en un proceso separado.
Debido a que la herramienta es de procesamiento por lotes prioritario, usted sube toda la carpeta y obtiene una sola hoja combinada en lugar de un archivo a la vez. Los estados de cuenta de tarjeta que abarcan varias páginas se gestionan con la fusión de varias páginas, una configuración de plantilla que agrupa las páginas pertenecientes al mismo estado de cuenta en un solo registro para que la información a nivel de cuenta se traslade a las líneas de detalle. Si también tiene volúmenes de fin de año para procesar, el mismo flujo de lote y fusión se cubre con más detalle en procesamiento por lotes de estados de cuenta de tarjeta de crédito.
Por dónde empezar depende de qué son los documentos. Si la mayor parte del montón son fotos de recibos y facturas por correo electrónico, el flujo de trabajo de recibo a Excel es el punto de entrada más rápido. Si es una pila de estados de cuenta mensuales, comience con la página de extracción de estados de cuenta de tarjeta de crédito. De cualquier manera, el resultado es la misma forma de tabla, que es el objetivo.
Los archivos se procesan de forma segura y no se almacenan.
Una de las cosas que la extracción no produce es una lista de proveedores limpia. La extracción te entrega cada registro en una sola tabla con el nombre del proveedor tal como aparece en la fuente. Ese es el material en bruto para el paso de juicio. Verificar esos nombres antes de confiar en ellos es fácil, ya que al pasar el cursor o hacer clic en cualquier celda extraída se resalta el punto exacto de la imagen original del que proviene, y al hacer clic en una región de la imagen se salta de vuelta a la celda correspondiente. Este es el Modo de Revisión con verificación de Bbox, y es lo que te permite confirmar que una cadena extraña es genuinamente lo que el documento decía y no una lectura errónea.
Paso Dos: Construir el Mapeo Canónico a Mano, Con los Datos Frente a Ti
La normalización de nombres de proveedores es una tarea de juicio, y la respuesta honesta es que la haces tú mismo, con la tabla extraída ordenada para que el orden de decisión sea evidente. Ordena por monto total descendente y trabaja desde arriba.
Para cada proveedor, decide cuál es el nombre canónico y luego mapea cada variante a ese nombre en una segunda columna. Una estructura práctica es de tres columnas: el Vendor Name sin procesar de la extracción, una columna Vendor (canonical) que tú llenas y una nota de alias para las variantes que incorporaste. Esto conserva la cadena original para la auditoría y te da algo estable para hacer pivote.
La parte superior de la lista se resuelve rápidamente. Ocho agencias de diseño se convierten en ocho nombres canónicos. Tres herramientas de gestión de proyectos superpuestas se convierten en tres, y ahora puedes ver la superposición y decidir eliminar una. Un grupo de líneas de estado que dicen AMZN MKTP US, AMAZON.COM y AMZN Prime pertenecen todas a Amazon, pero AWS es gasto de infraestructura y normalmente va en su propia línea, así que la decisión de agrupación no es solo "fusionar cualquier cosa similar". Esa distinción es exactamente lo que la coincidencia difusa no puede hacer, y es por eso que revisas el mapeo en lugar de aceptar la salida de un algoritmo.
Usa las columnas de apoyo para confirmar en lugar de adivinar. Si dos variantes comparten una tarjeta, un rango de fechas y un monto recurrente, es muy probable que sean el mismo proveedor. Si solo comparten un término como "Supply", probablemente no lo son. Los identificadores legibles por máquina son la evidencia más confiable cuando existen: un ID fiscal o una dirección exacta superan a un puntaje de similitud de nombres.
Si quieres un punto de partida en lugar de una columna vacía, una columna inferida puede proponer una agrupación canónica o un nombre normalizado para cada fila. Trátalo como un borrador. Verifícalo contra los totales de gasto antes de confiar en él, y espera corregir la cola larga a mano. El juicio se queda contigo porque la consecuencia de una fusión incorrecta (dos proveedores reales colapsados en uno, ocultando una relación que querías renegociar) es peor que el costo de revisar los candidatos.
Esta es una tarea más limitada que estandarizar los formatos dentro de las facturas de un solo proveedor, que tratamos por separado en estandarización de datos de facturas de proveedores. Aquí el formato ya se maneja en el momento de la extracción; lo que estás construyendo es la capa de identidad sobre eso.
Lo que este enfoque todavía no hace
Los pasos anteriores producen una lista limpia. No eliminan el criterio, y vale la pena ser claros sobre dónde se detiene la automatización.
No es un motor automático de deduplicación de maestro de proveedores. La extracción registra cada registro en una sola hoja con los nombres de proveedor en bruto; no decide qué nombres corresponden a la misma entidad. Ese mapeo es suyo para definirlo, y el trabajo de la herramienta es hacer que ese mapeo sea rápido de construir y fácil de verificar.
La coincidencia difusa todavía falla con cadenas no relacionadas, como códigos de descriptor, por lo que un pase puramente algorítmico dejará sin fusionar líneas del tipo AMZN MKTP US. Si una empresa matriz y sus divisiones son un solo proveedor o varios es una decisión comercial, no técnica, y ninguna herramienta puede tomarla por usted. Y si un reembolso solo lleva el nombre del empleado sin recibo adjunto, es posible que no haya forma de recuperar el proveedor a partir del registro. Esos casos deben resolverse con el estado de cuenta de la tarjeta o con el empleado, no con los datos.
Conciliar el estado de cuenta de la tarjeta con sus libros es otra tarea diferente, y una en la que mezclar tarjetas personales y de empresa crea sus propios problemas, que cubrimos en conciliación de tarjetas de crédito. Lograr primero la capa de proveedor correcta facilita esa conciliación, porque deja de volver a decidir sobre el mismo proveedor cada mes.
Deduplicación de una lista de proveedores: preguntas frecuentes
¿No puedo simplemente usar la coincidencia difusa de Power Query de Excel en la lista de proveedores?
Puede usarla, y captará algunas variantes, pero tiene dos puntos ciegos para este trabajo específico. No puede conectar un código de descriptor a un nombre de marca, porque no son cadenas similares. Y el umbral que capta variantes de sufijos también fusiona nombres no relacionados, así que termina revisando cada candidato de todos modos. Power Query es más útil una vez que los registros ya están en una sola hoja y está ajustando la lista de candidatos, no como el primer y único paso.
¿Necesito un sistema completo de maestro de proveedores para una empresa de este tamaño?
Para una empresa de 100 a 300 personas, una plataforma de gestión de gastos (Ramp, Brex, Expensify, Bill.com) resuelve el problema continuo al canalizar el gasto futuro a través de tarjetas que categorizan proveedores y marcan duplicados en el punto de compra, y herramientas como Coupa y Zip extienden eso a adquisiciones más grandes. Ninguna de ellas reconstruye el registro de lo que ya se compró con tarjetas personales. Esa lista histórica todavía tiene que reconstruirse a partir de documentos, que es la parte que este enfoque maneja.
La IA extrajo los nombres de los proveedores, pero siguen siendo inconsistentes. ¿Qué hago ahora?
Eso es esperado. La extracción reproduce el nombre tal como aparece en la fuente, y la fuente es inconsistente. El siguiente paso es el mapeo canónico: ordene por gasto, agrupe las variantes y asigne un nombre canónico por proveedor real. La tabla extraída con una columna Vendor (canonical) es el entregable, y es lo que hace que los totales sean confiables.
¿Cómo manejo los reembolsos que solo muestran el nombre del empleado?
Use el recibo o el estado de cuenta de la tarjeta como fuente de verdad para el proveedor, y vincúlelo al reembolso por monto y fecha. Si falta el recibo, el descriptor de la tarjeta es el respaldo, por eso capturar la cadena de proveedor sin procesar del estado de cuenta es importante incluso cuando parece un código. Cuando ambos faltan, el gasto no se puede recuperar de los datos y debe perseguirse manualmente.
¿Con qué frecuencia debe reconstruirse esta lista?
Una vez que tenga el mapeo canónico, el mantenimiento continuo es más ligero porque las compras nuevas de proveedores existentes se asignan a nombres que ya ha definido. Vuelva a ejecutar la extracción y el mapeo para el gasto nuevo, y revise los nombres no coincidentes según un cronograma. Trimestral es la cadencia que los equipos de AP suelen usar para la revisión del maestro de proveedores, y evita que la lista se degrade nuevamente en un montón de variaciones.
El cuello de botella en la consolidación de proveedores es la capa de identidad, y decidir a qué proveedor pertenece cada registro es lo que toma tiempo. Una vez que esa capa existe en una hoja de cálculo, clasificar el gasto y encontrar oportunidades de consolidación toma minutos en lugar de semanas. Cuando no existe, cada informe que construya sobre la lista es tan estable como los nombres que la sustentan. Para una visión más amplia de cómo extraer datos estructurados de documentos de gastos, consulte la guía de extracción de datos de informes de gastos. Si los registros abarcan muchos meses, la extracción de transacciones de fin de año y el proceso de conciliación de tarjetas de crédito muestran cómo la misma tabla extraída alimenta la conciliación y el trabajo de conciliación a tres vías sin un ERP que le sigue.