Ihre Lieferantenliste hat 200 Namen
Etwa 120 echte Lieferanten
Ein Beschaffungsleiter bei einem Unternehmen mit 140 Mitarbeitern erhielt ein Lieferantenkonsolidierungsprojekt und einen Ausgangspunkt von der Finanzabteilung: eine Liste mit mehr als 200 Lieferanten, die im vergangenen Jahr bezahlt wurden. Die Liste existierte. Ein brauchbares Bild der Ausgaben nicht. Derselbe Lieferant erschien „auf vier verschiedene Arten", wie der Verfasser es ausdrückte, und in den Erstattungsunterlagen enthielt das Lieferantenfeld Mitarbeiternamen statt Firmennamen. Ein Kommentator im Thread vermutete, dass die 200 Zeilen wahrscheinlich etwa 120 echte Lieferanten umfassten (r/procurement).
Diese Lücke zwischen 200 und 120 ist das eigentliche Problem. Sie können eine Lieferantenliste nicht deduplizieren, bis der Lieferantenname zu einem zuverlässigen Schlüssel wird – und nach einem Jahr Einkäufen mit privaten Karten ohne zentrale Erfassung ist er das noch nicht.
Wichtigste Erkenntnisse
- 200 Lieferantennamen lassen sich in der Regel auf etwa 120 echte Lieferanten zurückführen, und diese Lücke ist kein Tippfehler, sondern das Standardergebnis eines Jahres privater Karteneinkäufe.
- „AMZN MKTP US" und „Amazon.com" sind derselbe Lieferant, aber kein Fuzzy-Matching verbindet sie, weil der abgeschnittene Deskriptor fast keine Zeichen des Markennamens enthält.
- Es gibt keinen Lieferantenstamm zu bereinigen, nur Belege und Kontoauszüge, die nie in einer Tabelle standen. Bevor Sie Namen abgleichen, bringen Sie also jeden Datensatz in ein einziges Blatt mit denselben Spalten (ImageToTable.ai liest nach Spaltenname, nicht nach Layout).
Die Konsolidierungsfrist trifft auf eine Liste, die niemand nutzen kann
Eine Lieferantenliste aus der Finanzabteilung sagt Ihnen, wer bezahlt wurde. Sie sagt Ihnen selten, von wem Sie tatsächlich kaufen. Die Konsolidierung der Lieferantenausgaben hängt von dieser zweiten Frage ab, und das klingt nach derselben Sache, bis Sie versuchen, die Ausgaben nach Lieferant zu summieren und feststellen, dass keine zwei Zeilen für dasselbe Unternehmen im Namen übereinstimmen.
Die Daten sind vollständig genug. Das Problem ist, dass der Schlüssel unzuverlässig ist, und jede Konsolidierungsfrage hängt von diesem Schlüssel ab.
Die Rangfolge der Lieferanten nach Gesamtausgaben erfordert einen stabilen Namen. Zu erkennen, dass drei Teams für überlappende Projektmanagement-Software zahlen, erfordert einen stabilen Namen. Zu prüfen, ob ein ausgehandelter Satz tatsächlich verwendet wird, erfordert einen stabilen Namen. Wenn der Schlüssel ein Name ist, der von einer anderen Person an einem anderen Tag für jeden Einkauf eingegeben wurde, kann keine dieser Fragen beantwortet werden, und die Verhandlungsmacht, die Sie schaffen sollten, materialisiert sich nie.
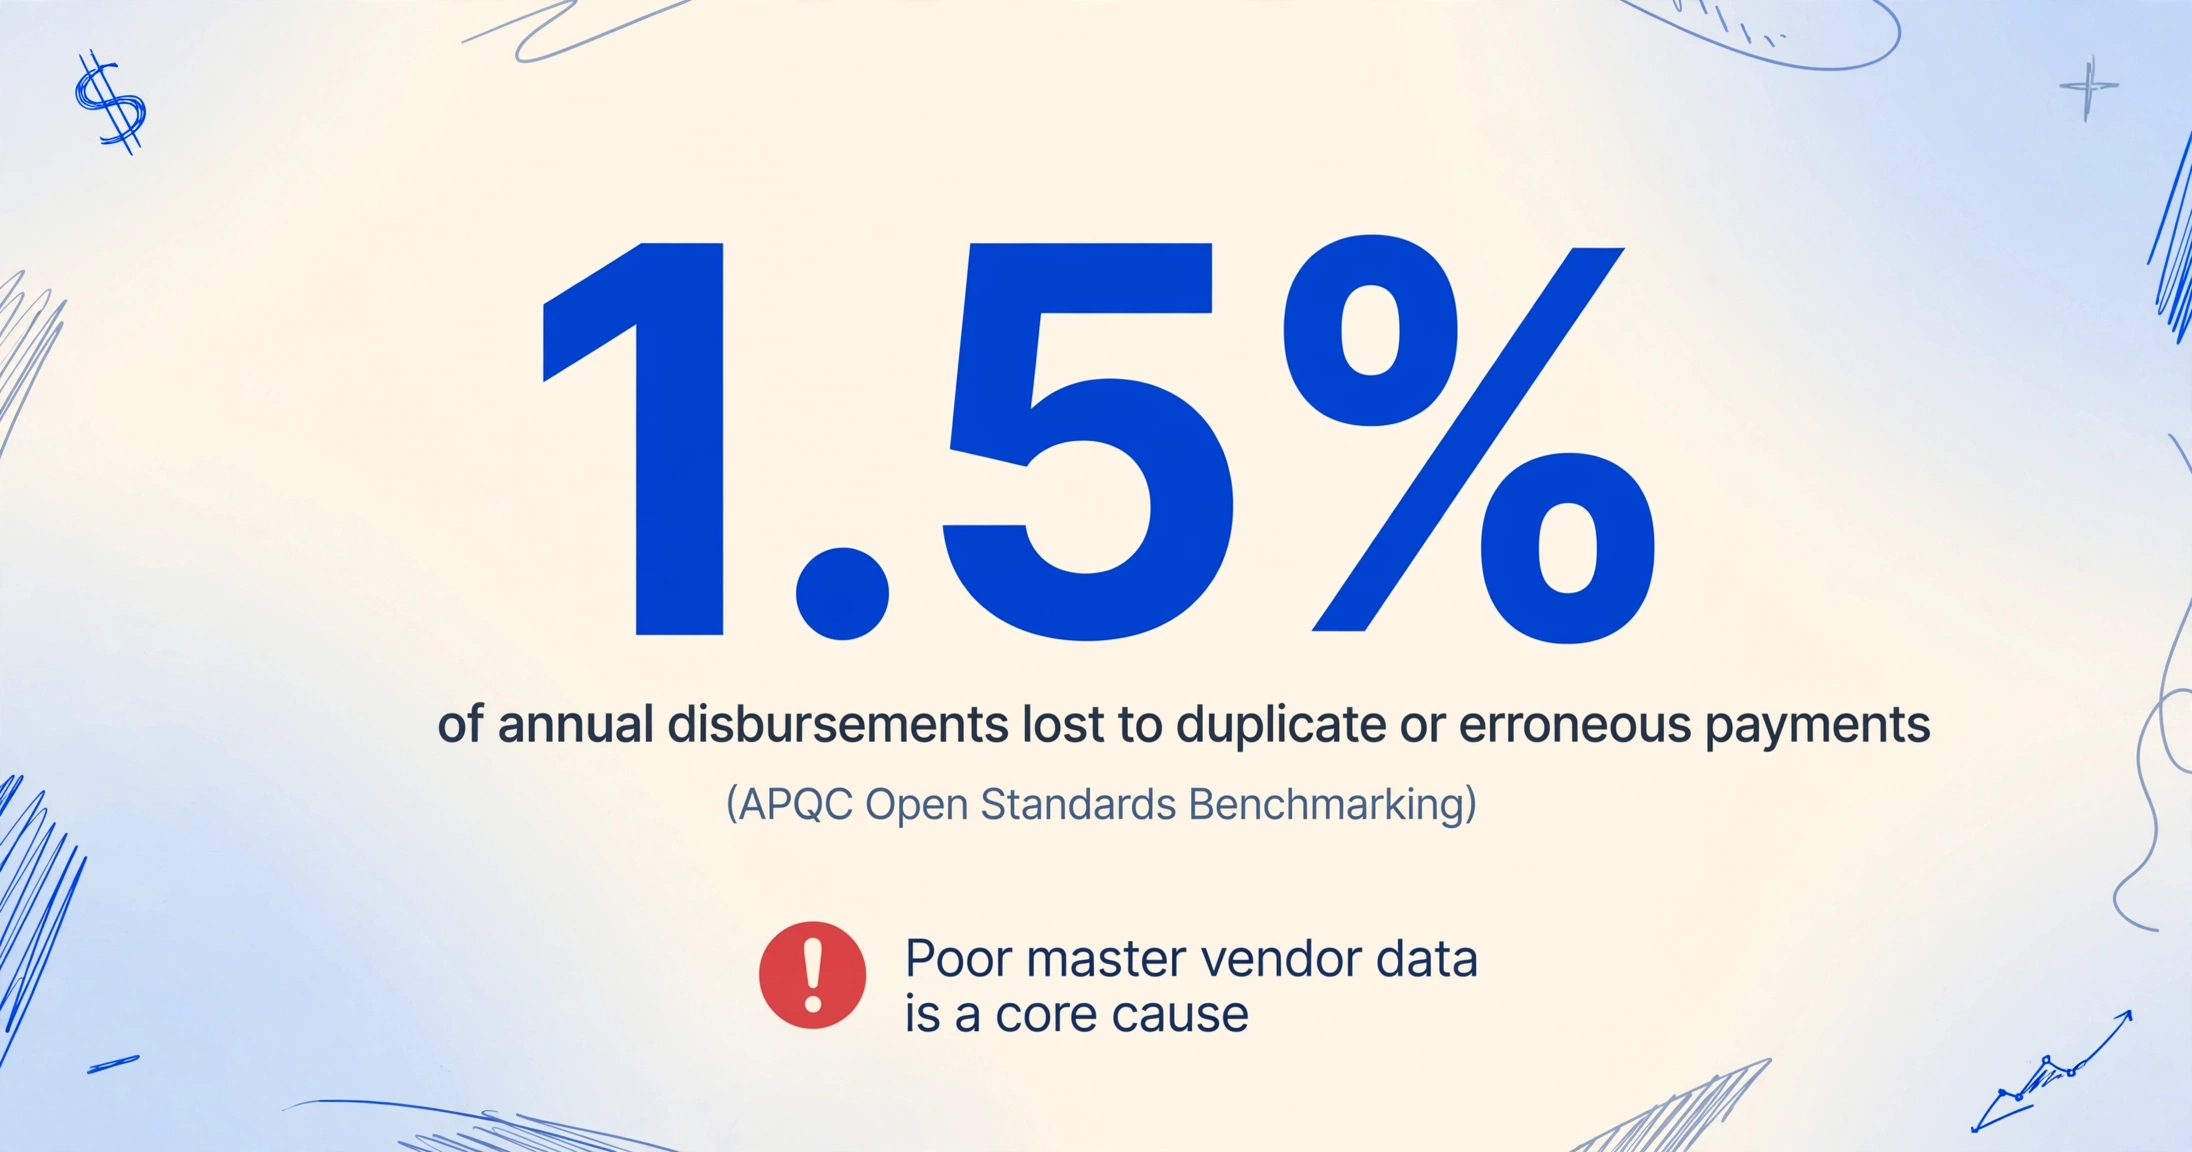
Die Kosten, dies falsch zu machen, sind nicht abstrakt. Das Open Standards Benchmarking von APQC beziffert die mediane Organisation auf doppelte oder fehlerhafte Zahlungen in Höhe von 1,5 % der jährlichen Auszahlungen, wobei die besten Leistungen immer noch bei 0,8 % liegen (APQC). APQC nennt schlechte Datenqualität in der Master-Lieferantendatei als eine der Hauptursachen (dies ist dieselbe Klasse von Liste, die Sie von Grund auf aufbauen möchten). Ein Unternehmen mit 10 Mio. $ Ausgaben blickt auf sechsstellige Verluste, die eine bessere Lieferantentransparenz aufgedeckt hätte.
Wo die Datensätze tatsächlich liegen
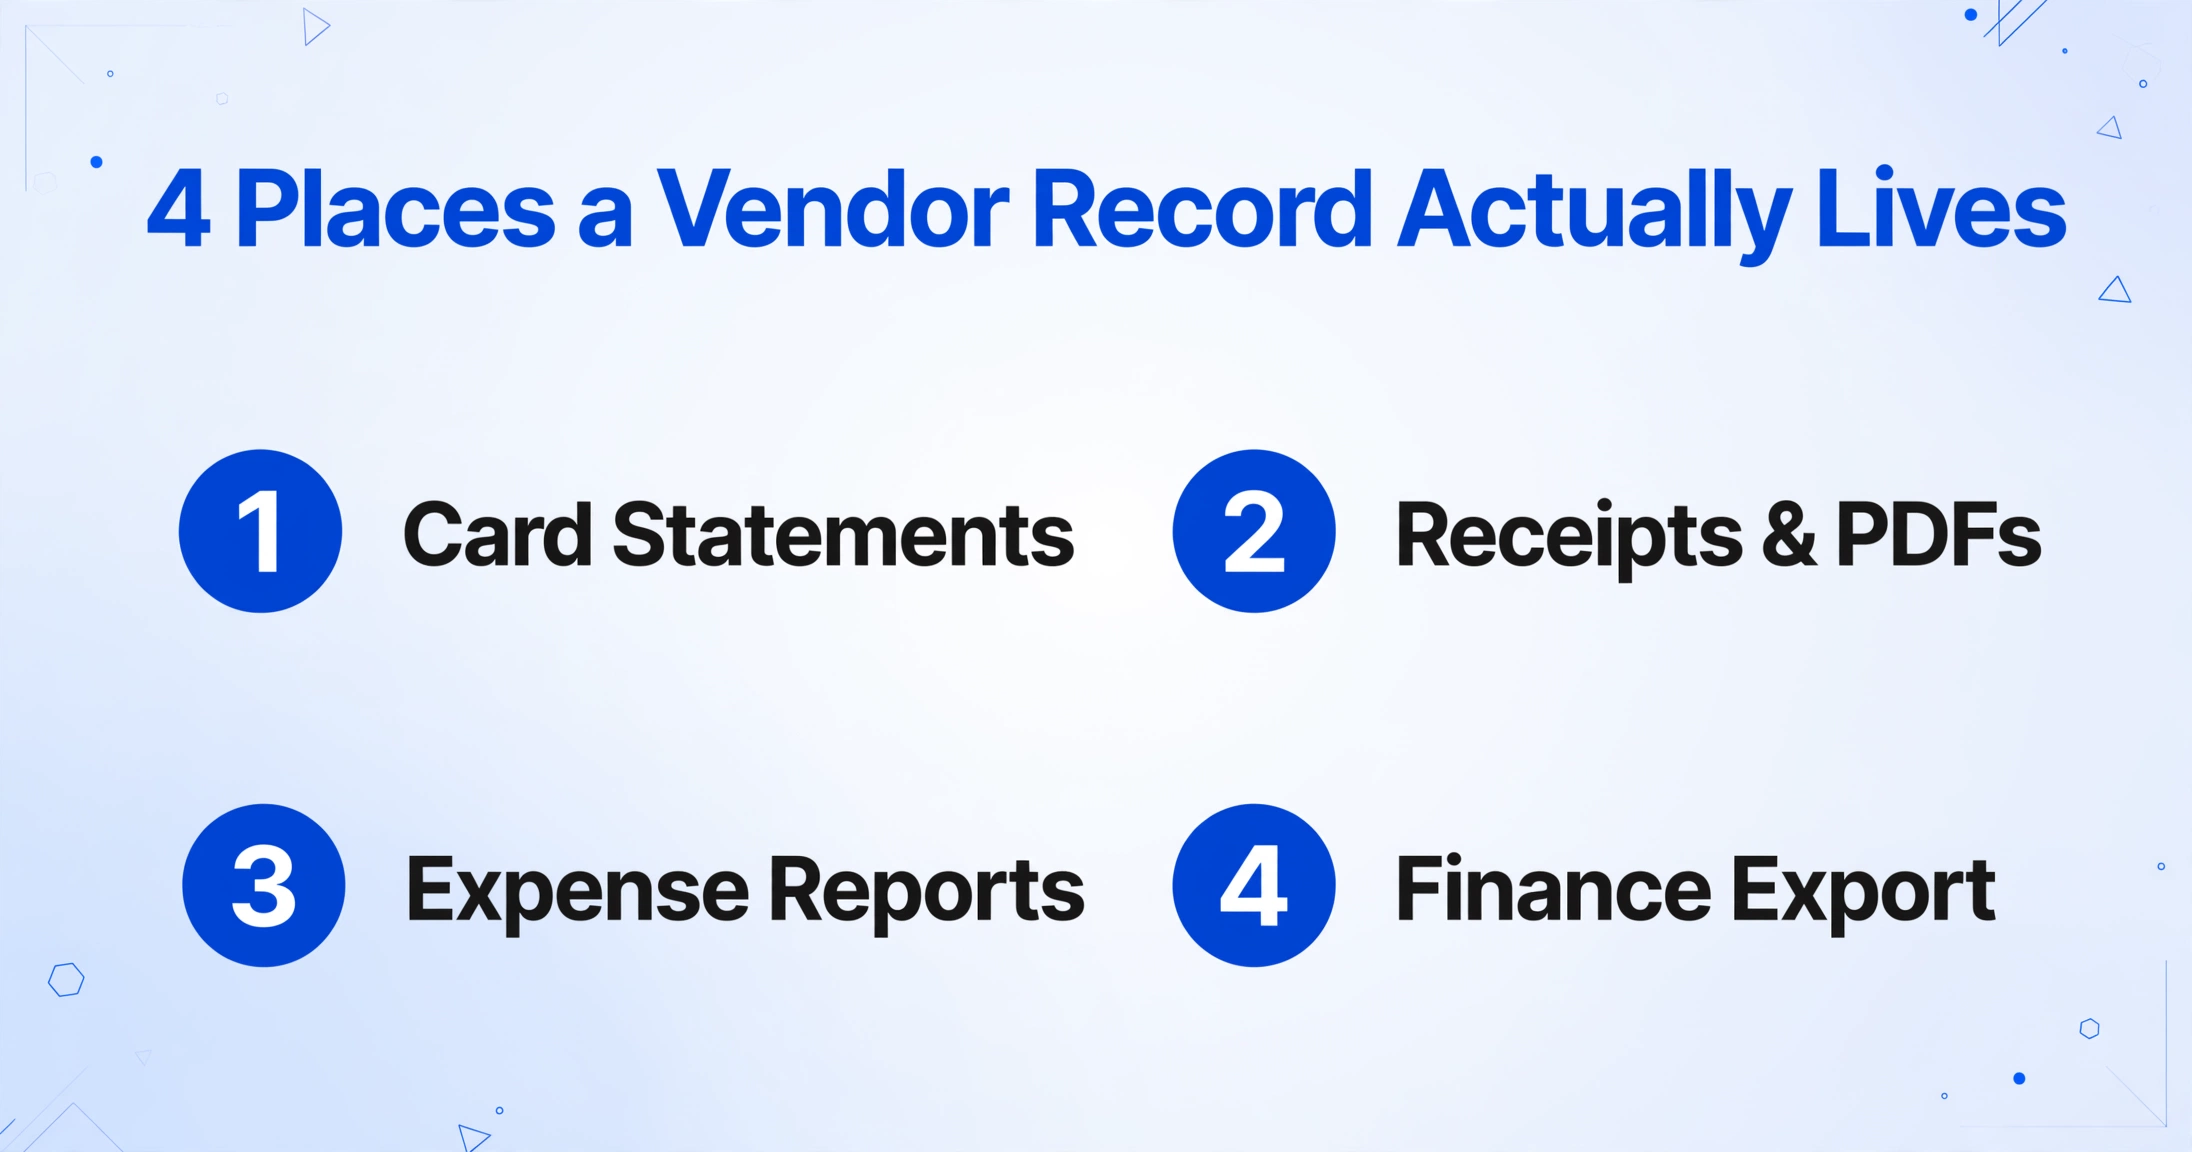
In einem Unternehmen ohne Beschaffungssystem liegt der Lieferantendatensatz nicht an einem Ort. Er ist über vier Quellen verstreut, die den Lieferanten jeweils unterschiedlich benennen.
Kontoauszüge
Was auch immer der Händler-Deskriptor angibt. Dies ist eine maschinell erzeugte Zeichenfolge, kein Name, den ein Mensch gewählt hat.
Belege und Rechnungs-PDFs
Das eigentliche Dokument, oft ein Foto. Oft der einzige Ort, an dem der tatsächliche Firmenname erscheint.
Spesenabrechnungen
Eingereicht von der Mitarbeiterin oder dem Mitarbeiter, der bzw. die bezahlt hat. Die Zahlung ist echt, aber das Feld „Lieferant" auf der Abrechnung ist häufig der eigene Name der Person.
Der Finanz-Export
Eine Tabellenkalkulation, die aus den oben genannten Quellen zusammengestellt wurde. Sie umfasst, was erstattet oder erfasst wurde, nicht alles, was gekauft wurde.
Die Konsolidierungsaufgabe besteht also nicht darin, den Lieferantenstamm zu bereinigen. Es gibt keinen Lieferantenstamm. Die Aufgabe besteht darin, zunächst einen aus den Rohdaten aufzubauen – und erst dann mit der Namensabgleichs-Arbeit zu beginnen, von der alle annehmen, dass man damit angefangen hat.
Vier Gründe, warum ein Lieferant unter vier Namen erscheint
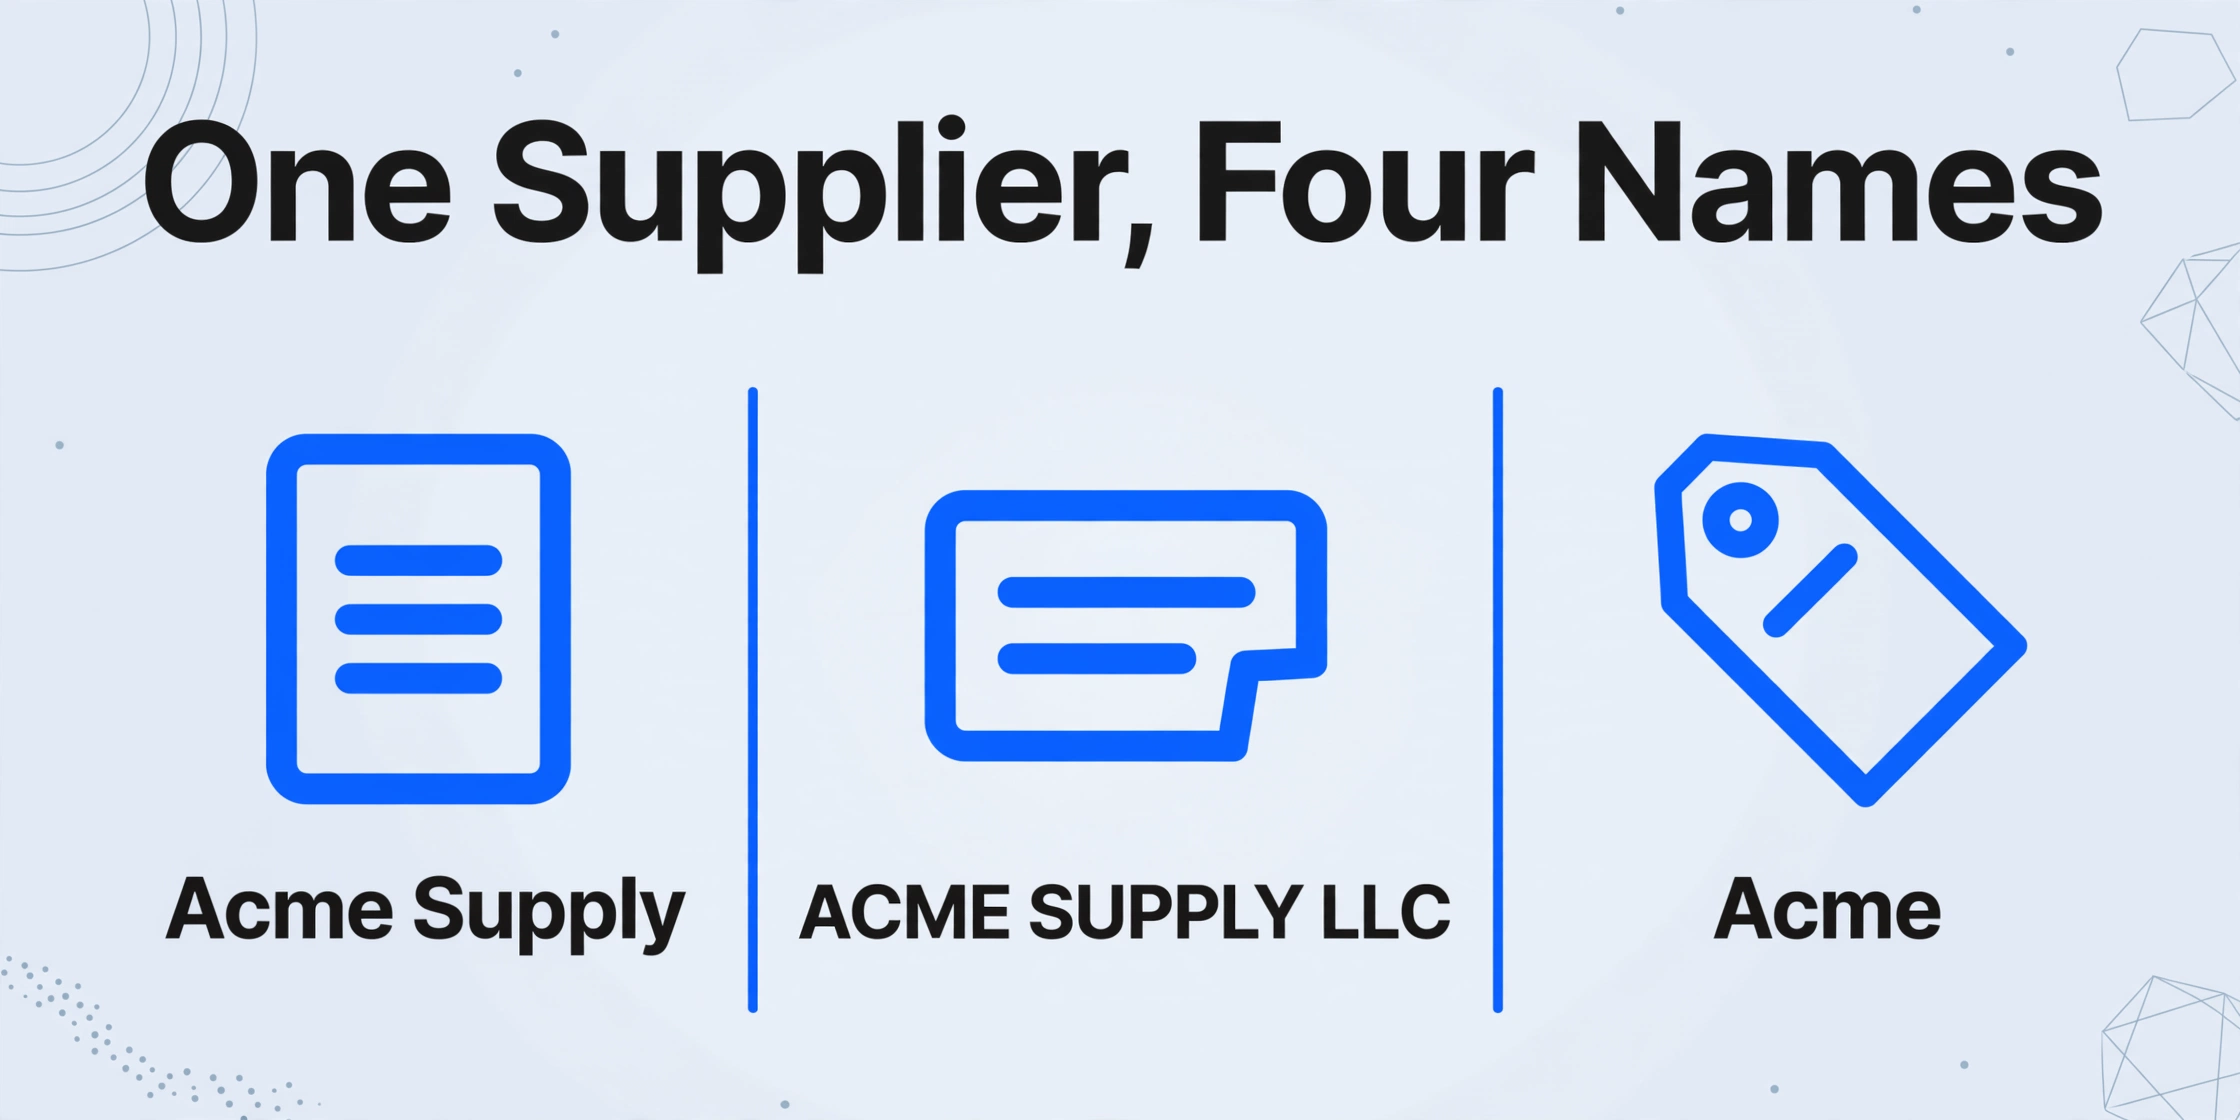
Die Variantenvielfalt bei Lieferantennamen hat mechanische Ursachen. Wenn Sie diese kennen, wissen Sie, welche Varianten Sie bedenkenlos zusammenführen können und welche eine menschliche Entscheidung erfordern.
Niemand hat den Namen verwaltet. Bei dezentralem Einkauf entscheidet die Person, die eine Ausgabe einreicht, was sie eintippt. Ein Mitarbeiter schreibt „Acme Supply", der nächste „ACME SUPPLY LLC", ein dritter „Acme". Exakte Übereinstimmungs-Deduplizierung, wie Excel sie mit bedingter Formatierung oder einer COUNTIF-Formel durchführt, liefert fast keine Treffer, weil keine zwei Zeichenfolgen identisch sind.
Der Karten-Deskriptor ist gekürzt und kodiert. Kartennetzwerke begrenzen den Händler-Deskriptor (das Limit liegt üblicherweise bei 22 Zeichen), und Prozessoren stellen ihm ein eigenes Kürzel voran. Ein Kauf bei Amazon kann auf dem Kontoauszug als AMZN MKTP US erscheinen, eine Zahlung über Square als SQ *MERCHANT. Der Markenname ist verschwunden, ersetzt durch einen Code. Eine Quittung für denselben Kauf sagt „Amazon.com". Kein Algorithmus zur Zeichenfolgenähnlichkeit wird diese beiden verbinden, weil sie fast keine Zeichen gemeinsam haben.
Rechtsname, DBA und Zahlungsempfänger sind drei verschiedene Zeichenfolgen. Die juristische Person eines Lieferanten kann „Northwind Logistics Holdings LLC" sein, sein Handelsname „Northwind", und seine Zahlungsadresse kann einem Factoring-Unternehmen oder einem Zahlungsdienstleister gehören. IOFM weist darauf hin, dass das DBA-Feld auf einem W-9 genau dafür existiert, damit ein Käufer einen Rechnungsnamen abgleichen kann, der vom Rechtsnamen abweicht (IOFM). Große Lieferanten stellen außerdem von Abteilungen aus Rechnungen aus, sodass dasselbe Mutterunternehmen als drei separate Lieferanten mit derselben Steuernummer erscheinen kann.
Erstattungen erfassen den Zahlenden, nicht den Zahlungsempfänger. Wenn ein Mitarbeiter zahlt und eine Erstattung erhält, ist die Transaktion im Ausgabensystem an den Mitarbeiter gebunden. Der Lieferant erscheint möglicherweise nur auf dem Quittungsbild oder gar nicht, wenn die Quittung fehlt.
Vier Mechanismen, vier Namen. Addieren Sie Groß-/Kleinschreibung, Satzzeichen und Suffixe wie Inc gegenüber Incorporated, und das Verhältnis von 200 zu 120 wirkt nicht mehr wie ein Ausreißer, sondern wie das Standardergebnis.
Was Fuzzy-Matching leisten kann und was nicht
Fuzzy-Matching ist der übliche nächste Schritt und löst einen Teil des Problems. Es bewertet, wie ähnlich zwei Zeichenfolgen sind, anstatt zu verlangen, dass sie identisch sind. Die üblichen Maße sind die Editierdistanz (Levenshtein, wobei die Punktzahl die Anzahl der Zeichenänderungen ist) und tokenbasierte Ähnlichkeit (Power Querys Fuzzy-Merge verwendet den Jaccard-Ähnlichkeitsalgorithmus, laut Microsofts Dokumentation). Sie legen einen Ähnlichkeitsschwellenwert fest, und alles darüber wird als mögliche Übereinstimmung markiert.
Fuzzy-Matching erzeugt Kandidaten. Es trifft keine Entscheidungen, und der von Ihnen gewählte Schwellenwert bestimmt, welchen Fehler Sie bevorzugen: Übersehene oder falsche Zusammenführungen.
Der Schwellenwert ist der Punkt, an dem es scheitert. Senken Sie ihn genug, um „ABC Supply Inc." und „ABC Supply LLC" zu erfassen, und er beginnt, unzusammenhängende Namen zusammenzuführen, die zufällig Token teilen. Ein Leser von Excel University dokumentierte das Versagen präzise: Bei einem Schwellenwert von 0,9 ordnete das Tool „Titan" „Twitch" und „SAVE" „Pave" zu, und das Absenken auf etwa 0,5, um die Inc./LLC-Varianten zu erfassen, erzeugte viel zu viele falsch-positive Treffer, um sie zu prüfen (Excel University). Sie können sich mit Namen allein nicht aus diesem Kompromiss heraustunen, weshalb die Produktions-Deduplizierung Namen gegen unterstützende Attribute wie Adresse, Steuer-ID, Bankdaten oder Transaktionsmuster abwägt.
Zwei Grenzen sind hier wichtiger als der Schwellenwert. Erstens scheitert Fuzzy-Matching bei Deskriptor-Codes völlig, weil „AMZN MKTP US" und „Amazon.com" keine ähnlichen Zeichenfolgen sind. Zweitens kann es nicht entscheiden, ob drei Abteilungen eines Mutterkonzerns ein Lieferant oder drei sein sollten. Das hängt davon ab, ob Sie mit ihnen als eine Beziehung oder als drei verhandeln, und das ist eine Geschäftsentscheidung, kein Zeichenfolgenvergleich.
Hier unterscheidet sich die Arbeit auch vom Erkennen einer doppelten Zahlung. Das Erkennen, dass dieselbe Rechnung zweimal bezahlt wurde, ist ein Vergleich mit der Historie, und wir behandeln diese Fehlerarten in Erkennung doppelter Rechnungen. Das Erstellen einer einzigen sauberen Lieferantenliste aus unübersichtlichen, dezentralen Datensätzen ist ein Gruppierungsproblem über eine gesamte Grundgesamtheit, und es muss gelöst werden, bevor eine Prüfung auf doppelte Zahlungen vertrauenswürdig sein kann, denn eine Duplikatprüfung, die auf einem inkonsistenten Namen basiert, übersieht genau die Paare, die sie finden soll.
Sowohl Fuzzy-Matching als auch jede andere Bereinigungstechnik setzen eines voraus: dass sich alle Datensätze bereits in einer einzigen Tabelle mit einer brauchbaren Lieferantenspalte befinden. Nach einem Jahr Einkäufen mit der Privatkarte sind sie das nicht. Das ist der Schritt, der zuerst behoben werden muss.
Schritt eins: Alle Datensätze in einem Blatt mit denselben Spalten erfassen
Bevor ein Name normalisiert werden kann, müssen alle Belege, Rechnungen und Kontoauszugszeilen an einem Ort unter denselben Spaltenüberschriften vorliegen. Das ist eine Datenextraktionsaufgabe, die sich so umsetzen lässt, dass sie nicht vom Layout des Dokuments abhängt – schließlich hat man es mit Fotos, Scans und PDFs von Dutzenden Händlern zu tun, die alle unterschiedlich formatiert sind.
ImageToTable.ai nutzt die Benutzerdefinierte Spaltenextraktion: Sie geben die gewünschten Spaltennamen ein, und die KI findet den passenden Wert überall auf der Seite, indem sie versteht, was das Feld bedeutet, statt wo es steht. Für diese Aufgabe ist der Spaltensatz klein und stabil:
Lieferantenname(genau wie auf dem Dokument oder Deskriptor gedruckt)Transaktionsdatum (JJJJ-MM-TT)BetragKarte(mit welcher Karte der Kauf getätigt wurde)Kategorie (Optionen: Software/Büro/Reisen/Mahlzeiten/Sonstiges)
Zwei dieser Spalten leisten mehr, als man ihnen ansieht. Die Datumsformat-Anweisung, die das Tool als Format Requirement bezeichnet, sorgt dafür, dass jedes Lieferantendatum als derselbe String landet, sodass Sortierung und Zeitraumfilter tatsächlich auf Anhieb funktionieren. Die Kategoriespalte ist ein Beispiel für eine abgeleitete Spalte, bei der die KI einen Wert ergänzt, der nicht auf dem Dokument steht, indem sie den Beleginhalt liest und aus den von Ihnen angegebenen Optionen wählt. So läuft die Klassifizierung parallel zur Extraktion, statt ein separater Durchgang zu sein.
Da das Tool batch-first arbeitet, laden Sie den gesamten Ordner hoch und erhalten ein zusammengeführtes Blatt statt einer Datei nach der anderen. Kontoauszüge über mehrere Seiten werden per Mehrseiten-Zusammenführung verarbeitet, einer Vorlageneinstellung, die Seiten desselben Auszugs zu einem einzigen Datensatz gruppiert, sodass Kontoinformationen über die Positionszeilen hinweg übertragen werden. Wenn Sie auch Jahresendmengen durcharbeiten müssen, wird derselbe Batch- und Merge-Ablauf unter Batch-Verarbeitung von Kreditkartenabrechnungen ausführlicher behandelt.
Wo Sie beginnen, hängt von den Dokumenten ab. Wenn der Großteil aus Belegfotos und E-Mail-Rechnungen besteht, ist der Beleg-zu-Excel-Workflow der schnellste Einstieg. Wenn es ein Stapel monatlicher Abrechnungen ist, beginnen Sie stattdessen mit der Seite Kreditkartenabrechnungsextraktion. In beiden Fällen ist die Ausgabe dieselbe Tabellenform – genau das ist der Punkt.
Dateien werden sicher verarbeitet und nicht gespeichert.
Eines ist das Ergebnis nicht: eine saubere Lieferantenliste. Die Extraktion liefert Ihnen jeden Datensatz in einer Tabelle mit dem Lieferantennamen, wie er in der Quelle erscheint. Das ist das Rohmaterial für den Bewertungsschritt. Diese Namen zu überprüfen, bevor Sie ihnen vertrauen, ist einfach, da das Überfahren oder Anklicken einer extrahierten Zelle die genaue Stelle im Originalbild hervorhebt, aus der sie stammt, und das Klicken auf einen Bildbereich springt zur passenden Zelle zurück. Dies ist der Review-Modus mit Bbox-Verifizierung, und er ermöglicht es Ihnen zu bestätigen, dass eine ungewöhnliche Zeichenfolge tatsächlich das ist, was das Dokument sagte, und nicht ein Lesefehler.
Schritt zwei: Die kanonische Zuordnung von Hand erstellen, mit den Daten vor Augen
Die Normalisierung von Lieferantennamen ist eine Bewertungsaufgabe, und die ehrliche Antwort ist, dass Sie sie selbst durchführen, wobei die extrahierte Tabelle so sortiert ist, dass die Entscheidungsreihenfolge offensichtlich ist. Sortieren Sie absteigend nach Gesamtbetrag und arbeiten Sie sich von oben nach unten vor.
Entscheiden Sie für jeden Lieferanten, was der kanonische Name ist, und ordnen Sie dann jede Variante in einer zweiten Spalte zu. Eine praktikable Struktur sind drei Spalten: der rohe Vendor Name aus der Extraktion, eine Vendor (canonical)-Spalte, die Sie ausfüllen, und eine Alias-Notiz für die Varianten, die Sie zusammengeführt haben. Das bewahrt die ursprüngliche Zeichenfolge für die Prüfung und gibt Ihnen etwas Stabiles, auf das Sie sich stützen können.
Die Spitze der Liste lässt sich schnell auflösen. Acht Designagenturen werden zu acht kanonischen Namen. Drei sich überschneidende Projektmanagement-Tools werden zu drei, und jetzt sehen Sie die Überschneidung und können entscheiden, eines zu streichen. Eine Gruppe von Kontoauszugszeilen mit AMZN MKTP US, AMAZON.COM und AMZN Prime gehört alle zu Amazon, aber AWS ist Infrastrukturausgabe und gehört normalerweise auf eine eigene Zeile, daher ist die Gruppierungsentscheidung nicht nur „alles Ähnliche zusammenführen“. Diese Unterscheidung ist genau die, die Fuzzy-Matching nicht treffen kann, und sie ist der Grund, warum Sie die Zuordnung überprüfen, anstatt die Ausgabe eines Algorithmus zu akzeptieren.
Nutzen Sie die unterstützenden Spalten, um zu bestätigen statt zu raten. Wenn zwei Varianten eine Karte, einen Datumsbereich und einen wiederkehrenden Betrag teilen, sind sie sehr wahrscheinlich derselbe Lieferant. Wenn sie nur ein Token wie „Supply“ teilen, sind sie es wahrscheinlich nicht. Maschinenlesbare Kennungen sind die zuverlässigsten Beweise, wenn sie existieren: eine Steuer-ID oder eine exakte Adresse übertrifft einen Namensähnlichkeitswert.
Wenn Sie einen Ausgangspunkt statt einer leeren Spalte möchten, kann eine abgeleitete Spalte eine kanonische Gruppierung oder einen normalisierten Namen für jede Zeile vorschlagen. Behandeln Sie sie als Entwurf. Prüfen Sie sie gegen die Ausgabensummen, bevor Sie sich darauf verlassen, und rechnen Sie damit, den langen Schwanz von Hand zu korrigieren. Das Urteilsvermögen bleibt bei Ihnen, weil die Folge einer falschen Zusammenführung (zwei echte Lieferanten zu einem zusammengefasst, was eine Beziehung verdeckt, die Sie neu verhandeln wollten) schlimmer ist als die Kosten der Überprüfung der Kandidaten.
Dies ist eine engere Aufgabe als die Standardisierung der Formate innerhalb der Rechnungen eines Lieferanten, die wir separat unter Standardisierung von Lieferantenrechnungsdaten behandeln. Hier wird das Format bereits bei der Extraktion gehandhabt; was Sie aufbauen, ist die Identitätsebene darüber.
Was dieser Ansatz weiterhin nicht leistet
Die obigen Schritte erzeugen eine saubere Liste. Sie nehmen Ihnen die Beurteilung nicht ab, und es lohnt sich, klar zu sagen, wo die Automatisierung endet.
Es ist keine automatische Deduplizierungs-Engine für den Lieferantenstamm. Die Extraktion bringt jeden Datensatz mit den rohen Lieferantennamen in ein einziges Blatt; sie entscheidet nicht, welche Namen dieselbe Entität sind. Diese Zuordnung müssen Sie selbst definieren, und die Aufgabe des Tools besteht darin, diese Zuordnung schnell aufzubauen und leicht zu überprüfen.
Fuzzy-Matching scheitert weiterhin an unzusammenhängenden Zeichenfolgen wie Deskriptorcodes, sodass ein rein algorithmischer Durchlauf Zeilen vom Typ AMZN MKTP US unzusammengeführt lässt. Ob ein Mutterunternehmen und seine Abteilungen ein Lieferant oder mehrere sind, ist eine Geschäftsentscheidung, keine technische, und kein Tool kann sie für Sie treffen. Und wenn eine Erstattung nur den Namen des Mitarbeiters ohne beigefügte Quittung trägt, gibt es möglicherweise keine Möglichkeit, den Lieferanten aus dem Datensatz zurückzugewinnen. Diese Fälle müssen über den Kontoauszug oder den Mitarbeiter gelöst werden, nicht über die Daten.
Der Abgleich des Kontoauszugs mit Ihren Büchern ist wiederum eine andere Aufgabe, und die Vermischung privater und Firmenkarten schafft dabei eigene Probleme, die wir unter Kreditkartenabgleich behandeln. Wenn Sie die Lieferantenebene zuerst richtig hinbekommen, wird dieser Abgleich einfacher, weil Sie nicht jeden Monat denselben Lieferanten neu entscheiden müssen.
Deduplizieren einer Lieferantenliste: FAQ
Kann ich nicht einfach das Fuzzy-Matching von Excel Power Query auf der Lieferantenliste verwenden?
Sie können es verwenden, und es wird einige Varianten erkennen, aber es hat zwei blinde Flecken für diese spezielle Aufgabe. Es kann einen Deskriptorcode nicht mit einem Markennamen verbinden, weil das keine ähnlichen Zeichenfolgen sind. Und der Schwellenwert, der Suffixvarianten erfasst, führt auch unzusammenhängende Namen zusammen, sodass Sie am Ende ohnehin jeden Kandidaten prüfen. Power Query ist am nützlichsten, wenn die Datensätze bereits in einem Blatt sind und Sie die Kandidatenliste optimieren, nicht als erster und einziger Schritt.
Brauche ich für ein Unternehmen dieser Größe ein vollständiges Lieferantenstammsystem?
Für ein Unternehmen mit 100 bis 300 Mitarbeitern löst eine Spend-Management-Plattform (Ramp, Brex, Expensify, Bill.com) das laufende Problem, indem zukünftige Ausgaben über Karten laufen, die Lieferanten kategorisieren und Duplikate beim Kauf kennzeichnen. Tools wie Coupa und Zip erweitern das auf größere Beschaffungsprozesse. Keines davon rekonstruiert jedoch den Verlauf dessen, was bereits mit privaten Karten gekauft wurde. Diese historische Liste muss weiterhin aus Dokumenten rekonstruiert werden – genau das übernimmt dieser Ansatz.
Die KI hat die Lieferantennamen extrahiert, aber sie sind immer noch inkonsistent. Was nun?
Das ist zu erwarten. Die Extraktion reproduziert den Namen, wie er in der Quelle erscheint, und die Quelle ist inkonsistent. Der nächste Schritt ist die kanonische Zuordnung: nach Ausgaben sortieren, die Varianten gruppieren und einen kanonischen Namen pro tatsächlichem Lieferanten zuweisen. Die extrahierte Tabelle mit einer Spalte Lieferant (kanonisch) ist das Ergebnis und macht die Summen vertrauenswürdig.
Wie gehe ich mit Erstattungen um, die nur den Namen des Mitarbeiters zeigen?
Verwenden Sie die Quittung oder den Kartenauszug als Quelle der Wahrheit für den Lieferanten und verknüpfen Sie sie mit der Erstattung über Betrag und Datum. Fehlt die Quittung, ist der Karten-Deskriptor der Fallback – deshalb ist es wichtig, den rohen Lieferantenstring aus dem Auszug zu erfassen, auch wenn er wie ein Code aussieht. Fehlen beide, ist die Ausgabe aus den Daten nicht rekonstruierbar und muss manuell nachverfolgt werden.
Wie oft sollte diese Liste neu aufgebaut werden?
Sobald die kanonische Zuordnung existiert, ist die laufende Pflege einfacher, weil neue Käufe bei bestehenden Lieferanten Namen zugeordnet werden, die Sie bereits definiert haben. Führen Sie die Extraktion und Zuordnung für neue Ausgaben erneut durch und prüfen Sie die nicht zugeordneten Namen regelmäßig. Vierteljährlich ist der Rhythmus, den AP-Teams üblicherweise für die Lieferantenstammprüfung nutzen – das verhindert, dass die Liste wieder zu einem Haufen Variationen verfällt.
Der Engpass bei der Lieferantenkonsolidierung ist die Identitätsebene – und zu entscheiden, zu welchem Lieferanten jeder Datensatz gehört, kostet Zeit. Sobald diese Ebene in einer Tabelle existiert, dauert das Ranking der Ausgaben und das Finden von Konsolidierungsmöglichkeiten Minuten statt Wochen. Ohne sie ist jeder Bericht, den Sie auf Basis der Liste erstellen, nur so stabil wie die Namen darunter. Für das Gesamtbild der strukturierten Datenextraktion aus Ausgabenbelegen siehe den Leitfaden zur Extraktion von Spesendaten. Wenn die Datensätze viele Monate umfassen, zeigen die Jahresend-Transaktionsextraktion und die Kreditkarten-Abstimmungspipeline, wie dieselbe extrahierte Tabelle die Abstimmung und die anschließende Drei-Wege-Abstimmung ohne ERP speist.