Votre liste de fournisseurs compte 200 noms
Environ 120 vrais fournisseurs
Un responsable achats d'une entreprise de 140 personnes a reçu un projet de consolidation des fournisseurs et un point de départ de la finance : une liste de plus de 200 fournisseurs payés au cours de l'année écoulée. La liste existait. Une image exploitable des dépenses, non. Le même fournisseur apparaissait « de 4 manières différentes », comme l'a dit l'auteur du post, et dans les relevés de remboursement, le champ fournisseur contenait des noms d'employés au lieu de noms d'entreprises. Un commentateur du fil a estimé que les 200 lignes correspondaient probablement à environ 120 vrais fournisseurs (r/procurement).
Cet écart entre 200 et 120 est tout le problème. Vous ne pouvez pas dédupliquer une liste de fournisseurs tant que le nom du fournisseur ne devient pas une clé fiable, et après une année d'achats par cartes personnelles sans suivi centralisé, ce n'est pas encore le cas.
Points clés à retenir
- 200 noms de fournisseurs correspondent généralement à environ 120 vrais fournisseurs, et cet écart n'est pas une erreur de saisie mais le résultat par défaut d'une année d'achats par carte personnelle.
- « AMZN MKTP US » et « Amazon.com » sont le même fournisseur, mais aucune correspondance floue ne les relie, car le descripteur tronqué ne partage presque aucun des caractères du nom de la marque.
- Il n'existe pas de référentiel fournisseurs à nettoyer, seulement des reçus et des relevés qui n'ont jamais été réunis dans un même tableau ; avant de faire correspondre les noms, placez donc chaque enregistrement dans une seule feuille avec les mêmes colonnes (ImageToTable.ai lit par nom de colonne, pas par mise en page).
La date limite de consolidation face à une liste inutilisable
Une liste de fournisseurs issue de la finance vous indique qui a été payé. Elle vous indique rarement qui est réellement votre fournisseur. La consolidation des dépenses fournisseurs repose sur cette seconde question, et ces deux questions semblent identiques jusqu'à ce que vous tentiez de totaliser les dépenses par fournisseur et constatiez qu'aucune des lignes du même nom d'entreprise ne concordent.
Les données sont suffisamment complètes. Le problème est que la clé n'est pas fiable, et chaque question de consolidation dépend de cette clé.
Classer les fournisseurs par dépense totale exige un nom stable. Repérer que trois équipes paient pour des logiciels de gestion de projet qui se chevauchent exige un nom stable. Vérifier qu'un tarif négocié est réellement appliqué exige un nom stable. Lorsque la clé est un nom saisi par une personne différente, un jour différent, pour chaque achat, aucune de ces questions ne peut trouver de réponse, et le levier de négociation que vous deviez créer ne se matérialise jamais.
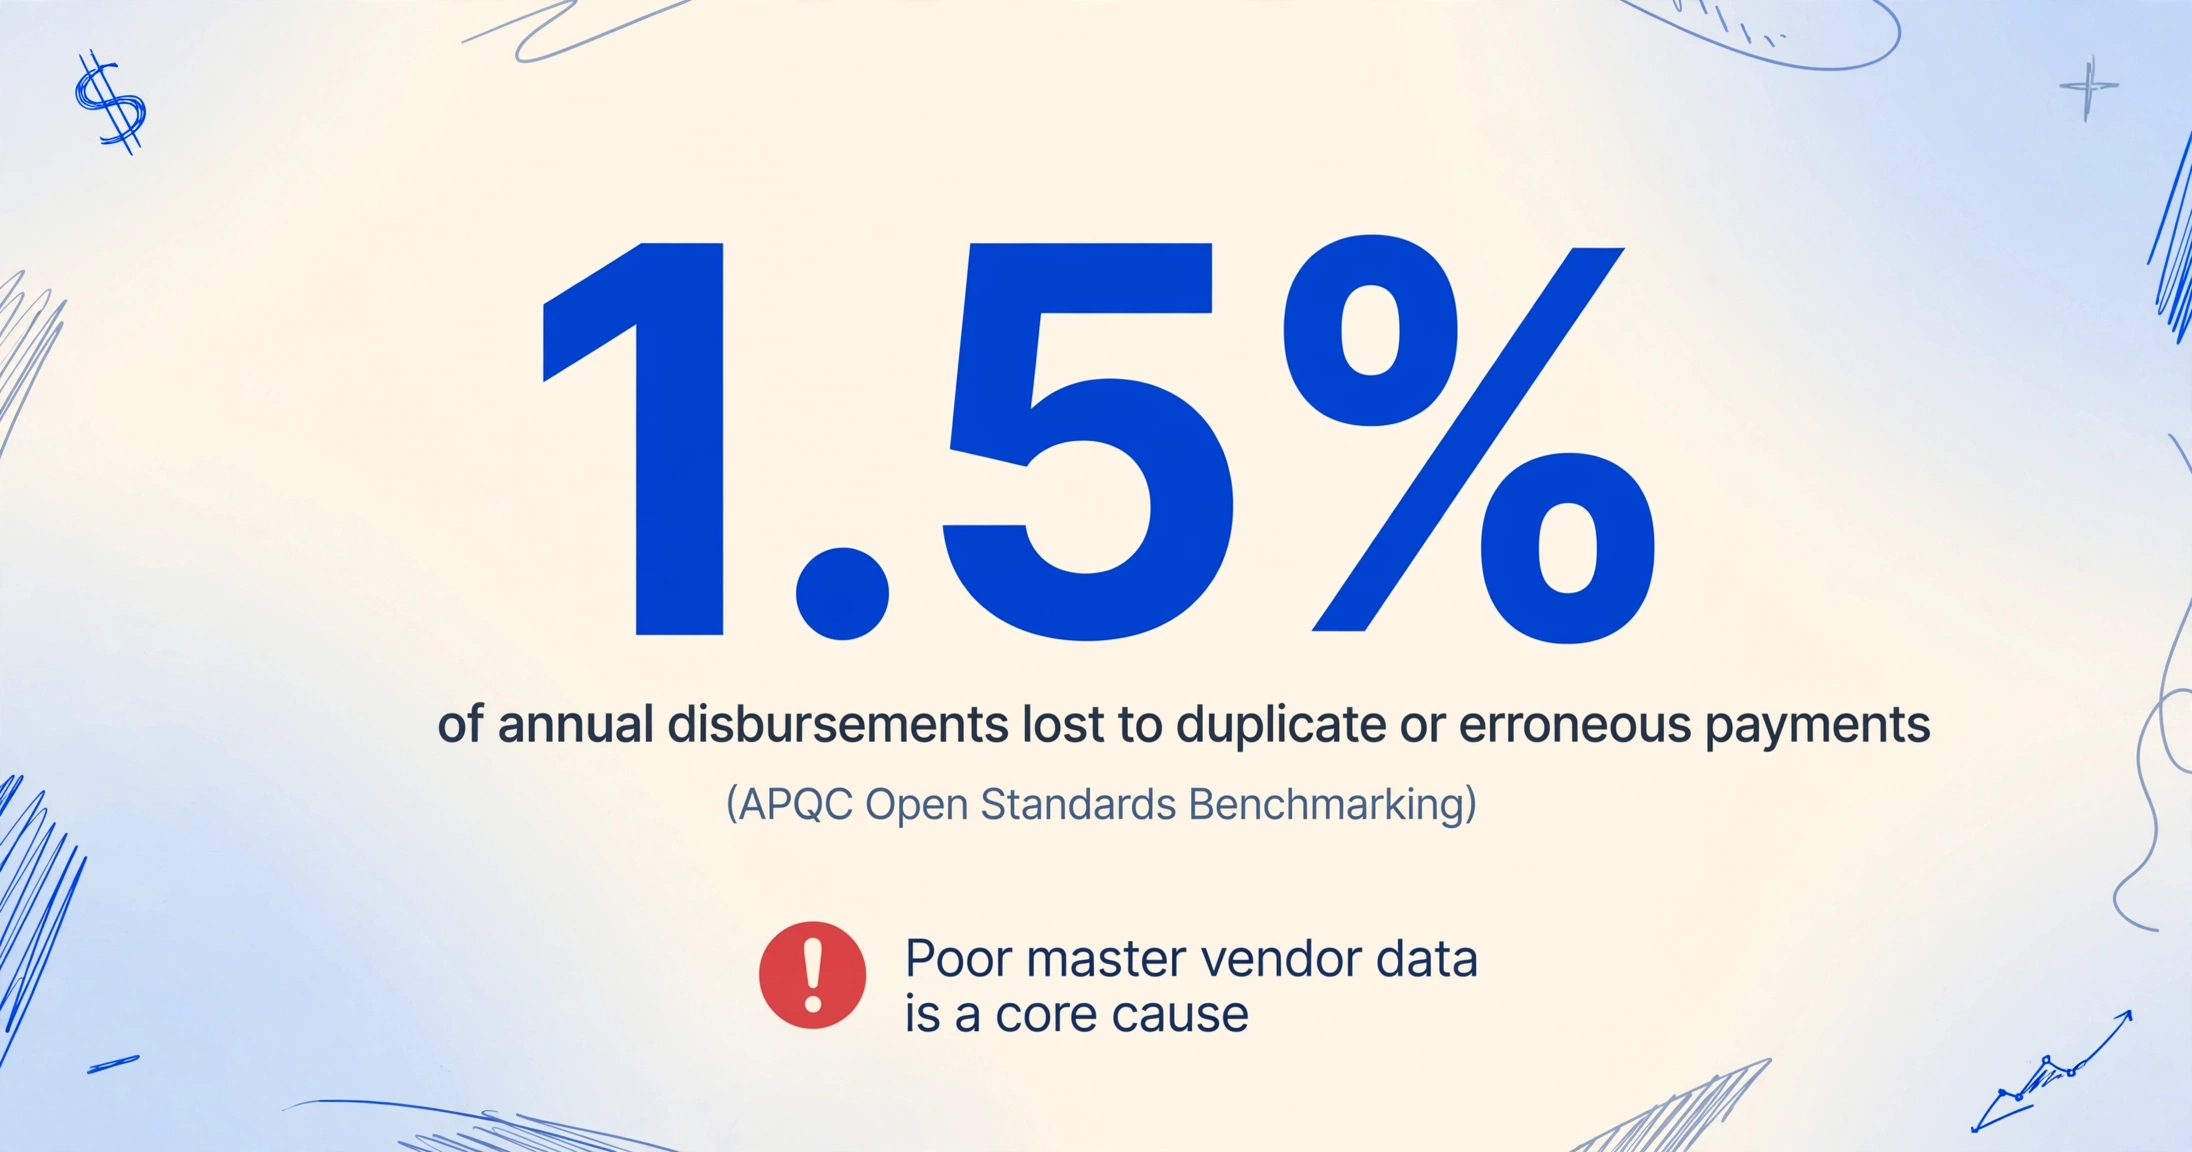
Le coût de cette erreur n'est pas abstrait. Les références Open Standards Benchmarking d'APQC situent l'organisation médiane à des paiements en double ou erronés équivalant à 1,5 % des décaissements annuels, les meilleurs performeurs se situant encore à 0,8 % (APQC). APQC cite la mauvaise qualité des données du fichier fournisseurs principal comme l'une des causes fondamentales (il s'agit de la même catégorie de liste que vous tentez de constituer de zéro). Une entreprise avec 10 M$ de dépenses fait face à des fuites à six chiffres qu'une meilleure visibilité sur les fournisseurs aurait permis d'éviter.
Où vivent réellement les enregistrements
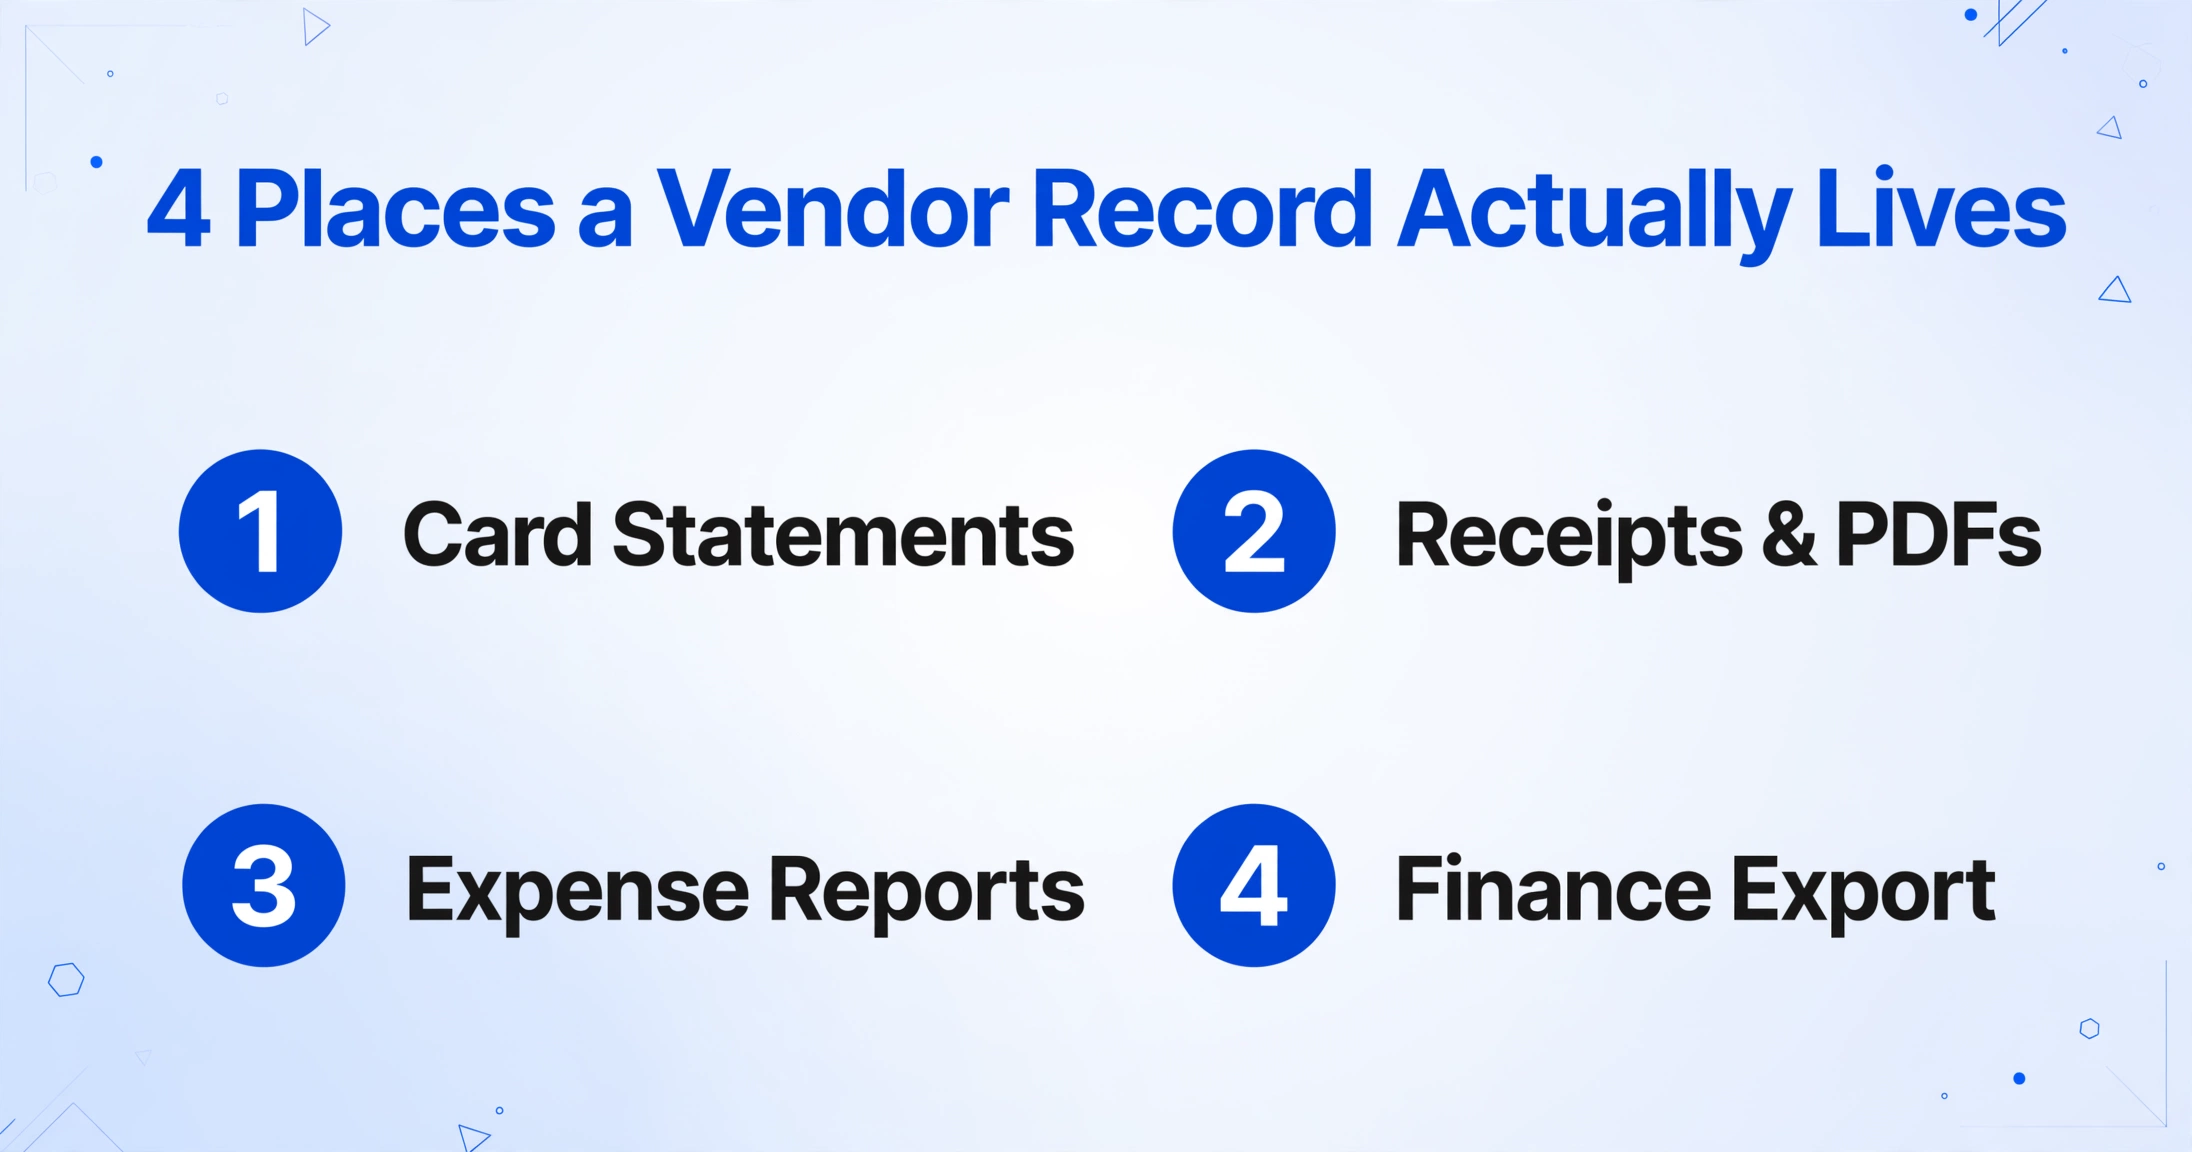
Dans une entreprise sans système d'achat, l'enregistrement du fournisseur n'est pas à un seul endroit. Il est réparti entre quatre sources qui nomment chacune le fournisseur différemment.
Relevés de carte
Ce que dit le descripteur du marchand. Il s'agit d'une chaîne générée par machine, pas d'un nom choisi par un humain.
Reçus et PDF de factures
Le document réel, souvent une photo. C'est souvent le seul endroit où apparaît le véritable nom commercial.
Notes de frais
Soumises par l'employé qui a payé. Le paiement est réel, mais le champ « fournisseur » du rapport est fréquemment le nom de l'employé lui-même.
L'exportation financière
Une feuille de calcul assemblée à partir des éléments ci-dessus. Elle couvre ce qui a été remboursé ou saisi, pas tout ce qui a été acheté.
La tâche de consolidation n'est donc pas de « nettoyer le référentiel fournisseurs ». Il n'y a pas de référentiel fournisseurs. La tâche consiste d'abord à en construire un à partir des enregistrements bruts, puis seulement à commencer le travail de correspondance des noms que tout le monde suppose que vous avez commencé.
Quatre raisons pour lesquelles un fournisseur apparaît sous quatre noms
La variance des noms de fournisseurs a des causes mécaniques, et les connaître vous indique quelles variantes peuvent être fusionnées en toute sécurité et lesquelles nécessitent une décision humaine.
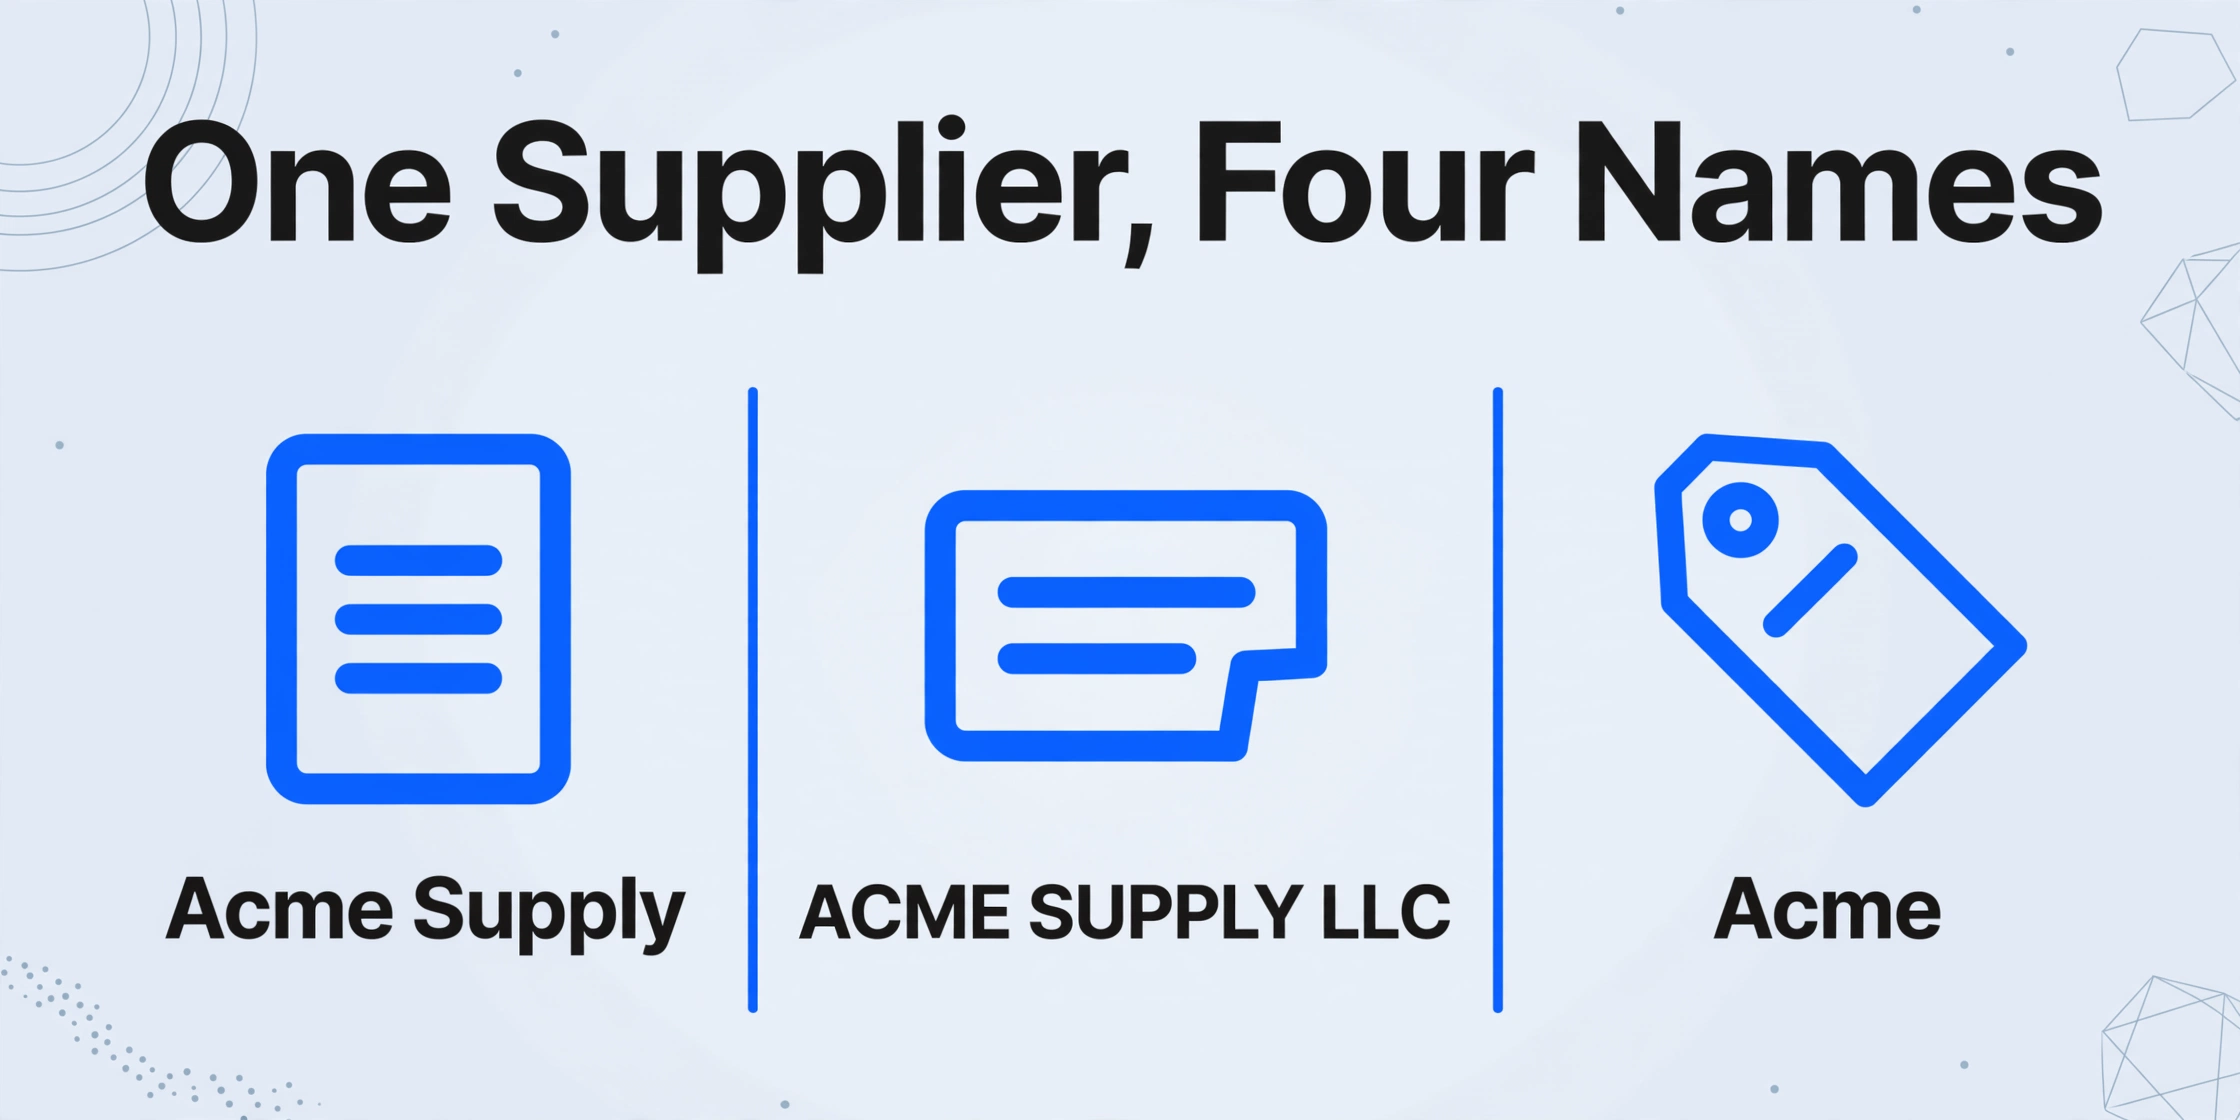
Personne ne possédait le nom. Avec un achat décentralisé, la personne qui soumet une dépense choisit quoi saisir. Un employé écrit « Acme Supply », le suivant écrit « ACME SUPPLY LLC », un troisième écrit « Acme ». La déduplication par correspondance exacte, celle qu'Excel effectue avec la mise en forme conditionnelle ou un COUNTIF, ne renvoie presque rien, car aucune chaîne de caractères n'est identique.
Le descripteur de carte est tronqué et encodé. Les réseaux de cartes plafonnent le descripteur marchand (la limite est généralement de 22 caractères), et les processeurs le préfixent avec leur propre balise. Un achat sur Amazon peut apparaître sur un relevé comme AMZN MKTP US, un paiement via Square comme SQ *MERCHANT. Le nom de la marque a disparu, remplacé par un code. Un reçu pour le même achat indique « Amazon.com ». Aucun algorithme de similarité de chaînes ne reliera ces deux éléments, car ils ne partagent presque aucun caractère.
Le nom légal, le DBA et l'adresse de paiement sont trois chaînes différentes. L'entité légale d'un fournisseur peut être « Northwind Logistics Holdings LLC », son nom commercial peut être « Northwind », et son adresse de paiement peut appartenir à une société d'affacturage ou à un processeur de paiement. IOFM note que le champ DBA sur un W-9 existe précisément pour qu'un acheteur puisse faire correspondre un nom de facture différent du nom légal (IOFM). Les grands fournisseurs facturent également depuis des divisions, de sorte que la même société mère peut apparaître comme trois fournisseurs distincts avec le même numéro d'identification fiscale.
Les remboursements enregistrent le payeur, pas le bénéficiaire. Lorsqu'un employé paie puis se fait rembourser, la transaction dans le système de dépenses est liée à l'employé. Le fournisseur peut n'apparaître que sur l'image du reçu, ou pas du tout si le reçu est manquant.
Quatre mécanismes, quatre noms. Ajoutez les différences de casse, la ponctuation et les suffixes comme Inc par rapport à Incorporated, et le ratio de 200 à 120 cesse de ressembler à une anomalie et commence à ressembler au résultat par défaut.
Ce que la correspondance floue peut et ne peut pas résoudre
La correspondance floue est la prochaine étape standard, et elle résout une partie du problème. Elle évalue la similarité entre deux chaînes de caractères plutôt que d'exiger qu'elles soient identiques. Les mesures habituelles sont la distance d'édition (Levenshtein, où le score correspond au nombre de changements de caractères) et la similarité basée sur les jetons (la fusion floue de Power Query utilise l'algorithme de similarité Jaccard, selon la documentation de Microsoft). Vous définissez un seuil de similarité, et tout ce qui se situe au-dessus est signalé comme une correspondance possible.
La correspondance floue génère des candidats. Elle ne prend pas de décisions, et le seuil que vous choisissez détermine l'erreur que vous préférez : les omissions ou les fusions erronées.
C'est là que le seuil pose problème. Si vous le baissez suffisamment pour détecter « ABC Supply Inc. » et « ABC Supply LLC », il commence à fusionner des noms sans rapport qui partagent des jetons. Un lecteur d'Excel University a documenté l'échec précisément : à un seuil de 0,9, l'outil a associé « Titan » à « Twitch » et « SAVE » à « Pave », et en baissant à environ 0,5 pour détecter les variantes Inc./LLC, il a produit beaucoup trop de faux positifs à examiner (Excel University). Vous ne pouvez pas ajuster votre façon de sortir de ce compromis avec les seuls noms, c'est pourquoi la déduplication en production pondère le nom par rapport à des attributs de soutien tels que l'adresse, le numéro d'identification fiscale, les coordonnées bancaires ou le schéma de transactions.
Deux limites importent plus ici que le seuil. Premièrement, la correspondance floue échoue complètement sur les codes descripteurs, car « AMZN MKTP US » et « Amazon.com » ne sont pas des chaînes similaires. Deuxièmement, elle ne peut pas décider si trois divisions d'une même société mère doivent être considérées comme un seul fournisseur ou trois. Cela dépend de la manière dont vous négociez avec elles, comme une seule relation ou trois, et c'est une décision commerciale, pas une comparaison de chaînes.
C'est également là que le travail diffère de la détection d'un paiement en double. Détecter que la même facture a été payée deux fois est une comparaison avec l'historique, et nous couvrons ces modes de défaillance dans la détection des factures en double. Construire une liste de fournisseurs propre à partir d'enregistrements dispersés et désordonnés est un problème de regroupement sur l'ensemble d'une population, et il doit être résolu avant qu'un contrôle de paiement en double puisse être fiable, car un contrôle qui repose sur un nom incohérent manque exactement les paires qu'il a été conçu pour trouver.
La correspondance floue et toutes les autres techniques de nettoyage supposent une chose : que tous les enregistrements se trouvent déjà dans un seul tableau avec une colonne fournisseur utilisable. Après une année d'achats par carte personnelle, ce n'est pas le cas. C'est l'étape à corriger en premier.
Étape une : regrouper tous les enregistrements dans une seule feuille avec les mêmes colonnes
Avant de pouvoir normaliser un nom, chaque ligne de reçu, de facture et de relevé doit exister au même endroit, sous les mêmes en-têtes de colonnes. C'est une tâche d'extraction de données, et il vaut la peine de la réaliser d'une manière qui ne dépende pas de la mise en page du document, car vous avez affaire à des photos, des scans et des PDF provenant de dizaines de commerçants, tous formatés différemment.
ImageToTable.ai utilise l'Extraction de colonnes personnalisées : vous saisissez les noms de colonnes souhaités, et l'IA localise la valeur correspondante n'importe où sur la page en comprenant ce que signifie le champ plutôt que l'endroit où il se trouve. Pour cette tâche, l'ensemble de colonnes est restreint et stable :
Vendor Name(exactement tel qu'imprimé sur le document ou le descripteur)Transaction Date (YYYY-MM-DD)AmountCard(la carte utilisée pour l'achat)Category (options: Software/Office/Travel/Meals/Other)
Deux de ces colonnes font plus de travail qu'il n'y paraît. L'instruction de format de date, que l'outil appelle Format Requirement, fait en sorte que la date de chaque fournisseur aboutisse à la même chaîne de caractères, de sorte que le tri et le filtrage par période fonctionnent réellement du premier coup. La colonne Category est un exemple de colonne inférée, où l'IA remplit une valeur qui n'est pas imprimée sur le document en lisant le contenu du reçu et en choisissant parmi les options que vous avez fournies. C'est ainsi que la classification accompagne l'extraction au lieu de devenir une étape distincte.
Comme l'outil est conçu pour le traitement par lots en priorité, vous téléchargez tout le dossier et obtenez une seule feuille fusionnée plutôt qu'un fichier à la fois. Les relevés de carte s'étendant sur plusieurs pages sont gérés par la fusion multipage, un paramètre de modèle qui regroupe les pages appartenant au même relevé en un seul enregistrement, afin que les informations au niveau du compte soient reportées sur les lignes. Si vous avez également des volumes de fin d'année à traiter, le même flux de traitement par lots et de fusion est détaillé dans le traitement par lots des relevés de carte de crédit.
Le point de départ dépend de la nature des documents. Si la majorité de la pile est composée de photos de reçus et de factures par e-mail, le flux de travail reçu vers Excel est le point d'entrée le plus rapide. S'il s'agit d'une pile de relevés mensuels, commencez plutôt par la page d'extraction des relevés de carte de crédit. Dans les deux cas, la sortie est une table de même forme, ce qui est l'essentiel.
Les fichiers sont traités de manière sécurisée et ne sont pas stockés.
Une chose que le résultat n'est pas : une liste de fournisseurs propre. L'extraction vous donne chaque enregistrement dans un tableau unique avec le nom du fournisseur tel qu'il apparaît dans la source. C'est la matière première pour l'étape de jugement. Vérifier ces noms avant de leur faire confiance est facile, car survoler ou cliquer sur n'importe quelle cellule extraite met en évidence l'endroit exact sur l'image d'origine d'où elle provient, et cliquer sur une région de l'image ramène à la cellule correspondante. C'est le mode de révision avec vérification Bbox, et c'est ce qui vous permet de confirmer qu'une chaîne étrange est réellement ce que le document disait plutôt qu'une erreur de lecture.
Étape deux : construire le mappage canonique à la main, avec les données sous les yeux
La normalisation des noms de fournisseurs est une tâche de jugement, et la réponse honnête est que vous le faites vous-même, avec le tableau extrait trié pour que l'ordre de décision soit évident. Triez par montant total décroissant et travaillez depuis le haut.
Pour chaque fournisseur, décidez quel est le nom canonique, puis mappez chaque variante vers celui-ci dans une deuxième colonne. Une structure viable est de trois colonnes : le Vendor Name brut de l'extraction, une colonne Vendor (canonical) que vous remplissez, et une note d'alias pour les variantes que vous avez regroupées. Cela préserve la chaîne d'origine pour l'audit tout en vous donnant quelque chose de stable sur lequel pivoter.
Le haut de la liste se résout rapidement. Huit agences de design deviennent huit noms canoniques. Trois outils de gestion de projet qui se chevauchent deviennent trois, et vous pouvez maintenant voir le chevauchement et décider d'en supprimer un. Un groupe de lignes de relevé indiquant AMZN MKTP US, AMAZON.COM et AMZN Prime appartient tout à Amazon, mais AWS est une dépense d'infrastructure et appartient généralement à sa propre ligne, donc la décision de regroupement n'est pas simplement « fusionner tout ce qui est similaire ». Cette distinction est exactement ce que la correspondance floue ne peut pas faire, et c'est pourquoi vous révisez le mappage au lieu d'accepter la sortie d'un algorithme.
Utilisez les colonnes de support pour confirmer plutôt que deviner. Si deux variantes partagent une carte, une plage de dates et un montant récurrent, il est très probable qu'il s'agisse du même fournisseur. Si elles ne partagent qu'un jeton comme « Supply », ce n'est probablement pas le cas. Les identifiants lisibles par machine sont la preuve la plus fiable lorsqu'ils existent : un numéro d'identification fiscale ou une adresse exacte l'emporte sur un score de similarité de nom.
Si vous voulez un point de départ plutôt qu'une colonne vide, une colonne inférée peut proposer un regroupement canonique ou un nom normalisé pour chaque ligne. Traitez-la comme un brouillon. Vérifiez-la par rapport aux totaux de dépenses avant de vous y fier, et attendez-vous à corriger la longue traîne à la main. Le jugement reste avec vous car la conséquence d'une mauvaise fusion (deux vrais fournisseurs regroupés en un seul, masquant une relation que vous vouliez renégocier) est pire que le coût de la révision des candidats.
C'est une tâche plus étroite que la normalisation des formats à l'intérieur des factures d'un même fournisseur, que nous traitons séparément dans standardizing vendor invoice data. Ici, le format est déjà géré au moment de l'extraction ; ce que vous construisez, c'est la couche d'identité par-dessus.
Ce que cette approche ne fait toujours pas
Les étapes ci-dessus produisent une liste propre. Elles ne suppriment pas le jugement, et il vaut la peine d'être clair sur le point où l'automatisation s'arrête.
Ce n'est pas un moteur automatique de déduplication du référentiel fournisseurs. L'extraction regroupe chaque enregistrement dans une seule feuille avec les noms de fournisseurs bruts ; elle ne décide pas quels noms correspondent à la même entité. Ce mappage est à vous de définir, et le rôle de l'outil est de rendre ce mappage rapide à construire et facile à vérifier.
La correspondance floue échoue toujours sur des chaînes sans rapport telles que les codes descripteurs, donc un passage purement algorithmique laissera le type de ligne AMZN MKTP US non fusionné. Qu'une société mère et ses divisions soient un seul fournisseur ou plusieurs est une décision commerciale, pas technique, et aucun outil ne peut la prendre à votre place. Et si un remboursement ne porte que le nom de l'employé sans reçu joint, il peut être impossible de retrouver le fournisseur à partir de l'enregistrement. Ces cas doivent être résolus à partir du relevé de carte ou auprès de l'employé, pas à partir des données.
Rapprocher le relevé de carte avec vos livres comptables est un autre travail, et mélanger les cartes personnelles et professionnelles crée ses propres problèmes, que nous abordons dans le rapprochement de relevés de carte de crédit. Bien établir la couche fournisseurs d'abord facilite ce rapprochement, car vous cessez de re-décider du même fournisseur chaque mois.
Dédupliquer une liste de fournisseurs : FAQ
Ne puis-je pas simplement utiliser la correspondance floue Power Query d'Excel sur la liste des fournisseurs ?
Vous pouvez l'utiliser, et elle attrapera certaines variantes, mais elle présente deux angles morts pour ce travail précis. Elle ne peut pas relier un code descripteur à un nom de marque, car ce ne sont pas des chaînes similaires. Et le seuil qui attrape les variantes de suffixes fusionne aussi des noms sans rapport, donc vous finissez par examiner chaque candidat de toute façon. Power Query est plus utile une fois que les enregistrements sont déjà dans une seule feuille et que vous ajustez la liste des candidats, pas comme première et unique étape.
Ai-je besoin d'un système complet de référentiel fournisseurs pour une entreprise de cette taille ?
Pour une entreprise de 100 à 300 personnes, une plateforme de gestion des dépenses (Ramp, Brex, Expensify, Bill.com) résout le problème au quotidien en acheminant les dépenses futures via des cartes qui catégorisent les fournisseurs et signalent les doublons au moment de l'achat, et des outils comme Coupa et Zip étendent cela à des achats plus importants. Aucun d'entre eux ne reconstruit l'historique de ce qui a déjà été acheté avec des cartes personnelles. Cette liste historique doit encore être reconstituée à partir des documents, ce que cette approche prend en charge.
L'IA a extrait les noms des fournisseurs, mais ils restent incohérents. Que faire ?
C'est normal. L'extraction reproduit le nom tel qu'il apparaît dans la source, et la source est incohérente. L'étape suivante est le mappage canonique : trier par montant, regrouper les variantes et attribuer un nom canonique par véritable fournisseur. Le tableau extrait avec une colonne Vendor (canonical) est le livrable, et c'est ce qui rend les totaux fiables.
Comment gérer les remboursements qui ne mentionnent que le nom de l'employé ?
Utilisez le reçu ou le relevé de carte comme source de vérité pour le fournisseur, et rapprochez-le du remboursement par montant et par date. Si le reçu manque, le descripteur de carte est le recours, c'est pourquoi il est important de capturer la chaîne brute du fournisseur à partir du relevé, même lorsqu'elle ressemble à un code. Si les deux manquent, la dépense n'est pas récupérable à partir des données et doit être traitée manuellement.
À quelle fréquence cette liste doit-elle être reconstruite ?
Une fois le mappage canonique en place, la maintenance courante est plus légère, car les nouveaux achats auprès de fournisseurs existants correspondent à des noms déjà définis. Relancez l'extraction et le mappage pour les nouvelles dépenses, et examinez les noms non appariés selon un calendrier régulier. Le rythme trimestriel est celui que les équipes AP utilisent couramment pour la revue du référentiel fournisseurs, et il évite que la liste ne retombe dans un amas de variantes.
Le goulot d'étranglement dans la consolidation des fournisseurs est la couche d'identité, et c'est décider à quel fournisseur appartient chaque enregistrement qui prend du temps. Une fois cette couche en place dans un tableur, classer les dépenses et trouver des opportunités de consolidation prend des minutes au lieu de semaines. Sans elle, chaque rapport construit sur la liste n'est aussi stable que les noms qui la sous-tendent. Pour une vue d'ensemble de l'extraction de données structurées à partir de documents de dépenses, voir le guide d'extraction de données des notes de frais. Si les enregistrements couvrent plusieurs mois, l'extraction des transactions de fin d'année et le pipeline de rapprochement des relevés de carte de crédit montrent comment le même tableau extrait alimente le rapprochement et le travail de rapprochement à trois sources sans ERP qui suit.