印刷ジョブ注文の問題は、受付で始まる。
印刷機ではない
再印刷は通常、ジョブチケットに記載されなかった1行にまで遡ります。その後のすべて、段取り、版、印刷、仕上げは、渡された指示を工場が正しく実行しているにすぎません。だからこそ、注文入力は印刷ジョブの中で最も効果の高いステップなのです。ジョブ全体をまだ安価に変更できる最後のポイントだからです。
重要ポイント
- 再印刷は印刷機ではなく注文入力時に決定される。ジョブ全体をまだ安価に変更できる最後のポイントである。
- 1日に40回、フロントデスクは注文の読み取りが苦手なのではなく、電話の合間にすべての仕様を頭の中で保持することを求められている。
- 役割は空白のチケットを入力することから、構造化された行をチェックすることへと変わる。各名前付き列は、その出典となったページにリンクされている。
印刷注文が再印刷になるケース
印刷会社の内部では、お客様の注文はジョブチケット(ジョブバッグまたはドケットとも呼ばれます)と呼ばれる社内記録になります。このチケットには、作業を生産するために必要な仕様(仕上がりサイズ、用紙、数量、インク、仕上げ、納期)が記載されます。印刷MISがこれを生成しますが、誰も入力しなかった情報を生成することはできません。
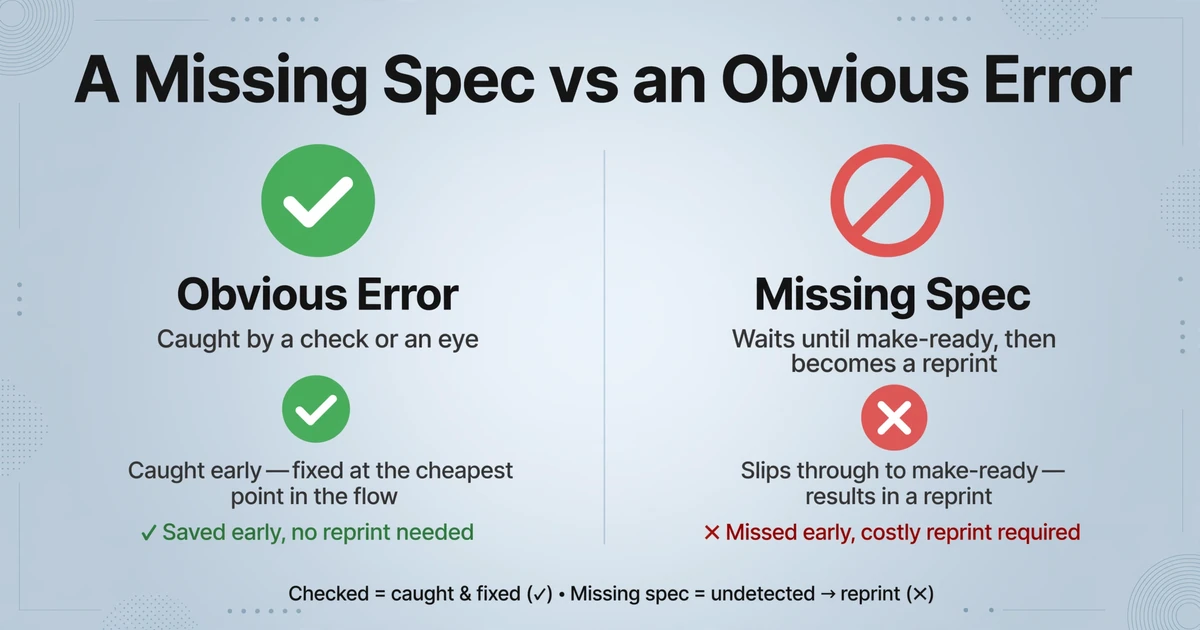
最もコストがかかる失敗は、明らかに間違っている数字ではありません。間違った合計は、通常、チェックや目視で引っかかるため発見されます。高くつくのは、単に存在しないフィールドです。お客様が返信で言及した折り目が引き継がれない。注文が5,000部と言っているのに数量が500部と読み取られる。お客様がコート紙を希望したのに、社内標準の用紙が入力される。チケットには何も問題がないように見えるため、ジョブを止めるものは何もありません。
欠落した仕様は検証ルールに失敗しません。段取りの時点、つまり版が作られプレス機に用紙がセットされるまで待ち、その後、再印刷として姿を現します。これは、ワークフローの中で最も安価な場所で犯されたミスを学ぶには、最も高価な場所なのです。
コストは、無駄になる用紙とプレス時間だけではありません。それはスケジュール、お客様に約束した納期、そしてそのお客様が次の注文を送るかどうかを左右する信頼にも影響を及ぼします。それらのどれもチケットには表示されません。それは数週間後、連絡を絶ったお客様として表面化します。
印刷工程に入る前のジョブオーダーの経路
印刷ジョブがプレス機に届くまでに、少なくとも4つの担当者の手を経由し、それぞれが受注ステップで作成された同じ記録を基に作業します。
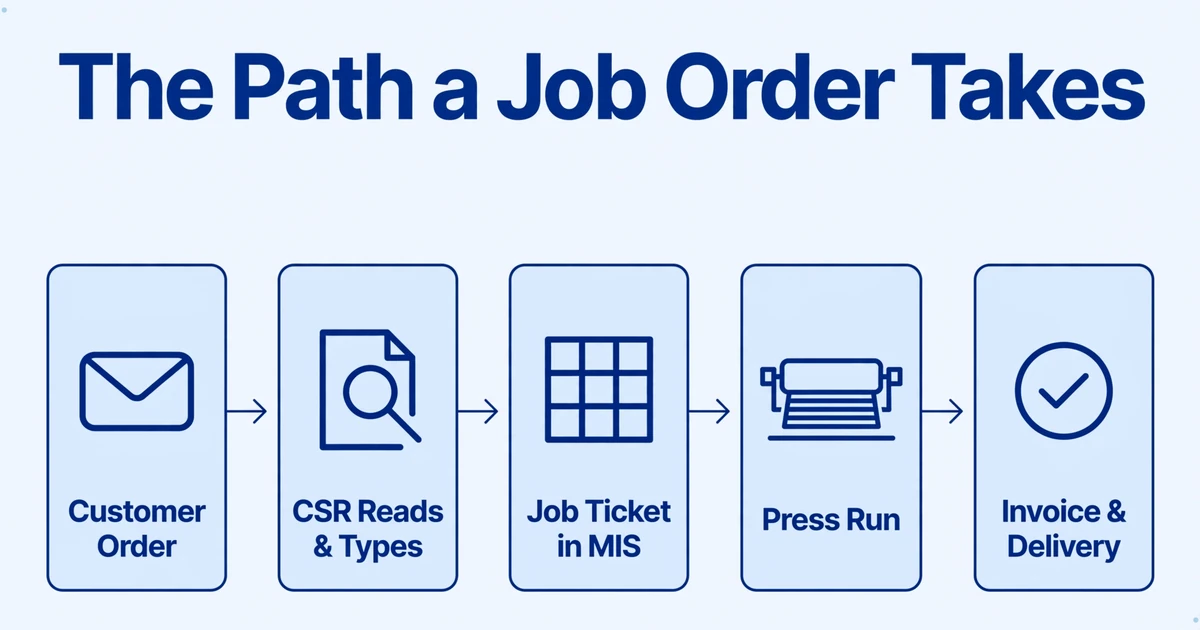
注文は、お客様が送りたい方法で届きます。3通目の返信に実際の仕様が記載されたメールスレッド、PDFの注文書、ファックス、手書きのジョブ依頼書のスキャン、カスタマーポータル経由でアップロードされたファイルなどです。CSRまたは見積担当者がそれを読み取り、業務を支える印刷MIS内で再構築します。商業印刷所で一般的なシステムには、EFI Pace、Avanti Slingshot、eProductivity Software (ePS)、Tharstern、PrintSmithなどがあります。MISは注文を読み取るわけではありません。CSRが入力した版を保存するのです。
そこからジョブは、現場用の印刷ジョブチケット、提供ファイルのプリプレスチェック、生産スケジュール上の枠、プレス稼働、仕上げ工程、そして最終的な請求書になります。プランナーはチケットからスケジュールを組み、オペレーターはチケットからセットアップを行い、請求部門も同じ記録から情報を取得します。最初の段階で1つのフィールドが間違っていたり欠落していたりすると、その後のすべてのステップに影響が及びます。
これがすでに自動化されているはずだと思われるかもしれません。FESPAの2025年印刷センサスは、89か国の774社の企業を対象に調査し、印刷企業が自動化を導入している場合、その重点はワークフローツール、Web-to-printプラットフォーム、プリプレスに集中しており、ほぼ半数が自動化をまったく導入していないと報告しています。生産とプリプレスに投資が集中し、受注業務は、依然として担当者が目視で書類を読む作業がほとんどで、自動化は進んでいません。
印刷所がこの状況に無関心なわけではありません。PRINTING United Allianceの報告によると、米国の印刷会社の4分の3が、資格のある印刷・製本オペレーターの採用に苦労しています。労働市場の逼迫により、受注量が増加しているまさにその時に、フロントオフィスは厚みを増すどころか薄くなっています。
注文入力が自動化に抵抗する理由
注文入力の自動化が難しいのは、顧客ごとに異なるジョブ注文を考案するためです。従来のアプローチであるテンプレートベースの解析は、既知のレイアウト上の固定座標で値を取得します。同じ文書が同じソースから同じ形式で届く場合には機能します。印刷会社はその逆の状況です。同じジョブが、ある顧客のPDF注文書、別の顧客のプレーンテキストメール、3番目の顧客のスキャン済み紙フォーム、そして「前回と同じ」とだけ書かれた再注文リクエストとして届くことがあります。
顧客ごと、フォームごとにテンプレートを維持すること自体が仕事であり、顧客がフォームを再設計したり、仕様を添付ファイルからメール本文に移したりすると、すぐに機能しなくなります。その回避策は、担当者が注文を読んで入力することになり、問題は中断の中での人手による転記に戻ってしまいます。
ジョブ注文を読むことは難しい部分ではありません。フロントデスクの誰でも数量と納期を見つけられます。難しいのは、電話の合間に1日40回それを実行し、3ページ目に埋もれた1つの詳細を見落とさないことです。ある印刷専門家はr/CommercialPrintingで日常の現状を説明し、フロントオフィスが「非構造化データを構造化されたジョブチケットに手動で変換する」ことにまだどれだけの時間を費やしているかを尋ね、通常の原因を挙げています。「3ページのメールスレッドに埋もれた仕様、レガシーPDFに閉じ込められた『前回のジョブ』の詳細、または顧客の奇妙な形式のExcelスプレッドシート」。続く質問こそ、この記事のテーマです。「ファイルに埋もれた詳細が初期入力時に見落とされた」ために生産エラーがどのくらいの頻度で発生するのか、ということです。
痛みを伴う注文入力エラーは静かに発生します。折りの見落としや用紙の取り違えはチェックに引っかからないため、ジョブは進行し続け、ミスが発見されるのは印刷機がすでに稼働しているときです。
これこそが埋める価値のあるギャップです。目標は再入力を完全に排除し、仕様が文書に表示された時点で取得され、ジョブになる前に確認できるようにすることです。印刷ジョブ注文データ抽出において、この区別こそが核心です。速いタイピストでもフィールドを見落としますが、構造化された行は検証できます。
ジョブの進め方を左右するフィールド
印刷ジョブチケットは、1フィールドあたりのコストが異常に高い短いドキュメントです。実際の注文で使われる語彙で、抽出列として名前を付ける価値があるフィールドは次のとおりです。
| フィールド | 注文での一般的な表現 | 見逃した場合のコスト |
|---|---|---|
| ジョブ/注文番号 | 注文番号、ジョブ名、参照 | チケットを注文に紐付けられず、再印刷や再注文の履歴が失われます。 |
| 顧客名とPO番号 | 請求先、PO番号、アカウント | 請求時に、請求書を購入者の書類と照合できません。 |
| 数量(および増刷分) | 500、1M、「5%増しで印刷」 | 不足印刷では2回目の段取りが必要になり、過剰印刷では在庫と時間を浪費します。 |
| 仕上がりサイズ(および平判サイズ) | 仕上がり8.5x11、A4、断ち寸 | 面付けと断裁が誤り、仕上げ工程を出た時点でサイズが違います。 |
| 用紙/素材 | 100lbグロス、350gsm、銘柄名、「前回と同じ」 | 用紙が違うと色味と風合いが変わり、社内在庫にない場合もあります。 |
| インキ/色 | CMYK、4/4、PMS 186 | 色合わせが不合格となり、印刷が無駄になるか作り直しになります。 |
| 面数 | 片面、両面、4/4 | ジョブの半分が片面印刷になるか、裏面の向きが逆になります。 |
| 仕上げ | 中綴じ、無線綴じ、折り、穴あけ、パッド、シュリンク包装 | 仕上げの手配が誤り、ジョブが振り替えられるか再印刷になります。 |
| 納期/配送 | 金曜日まで、10/20発送、至急 | 納期遅れと、それを取り戻すための急送料金が発生します。 |
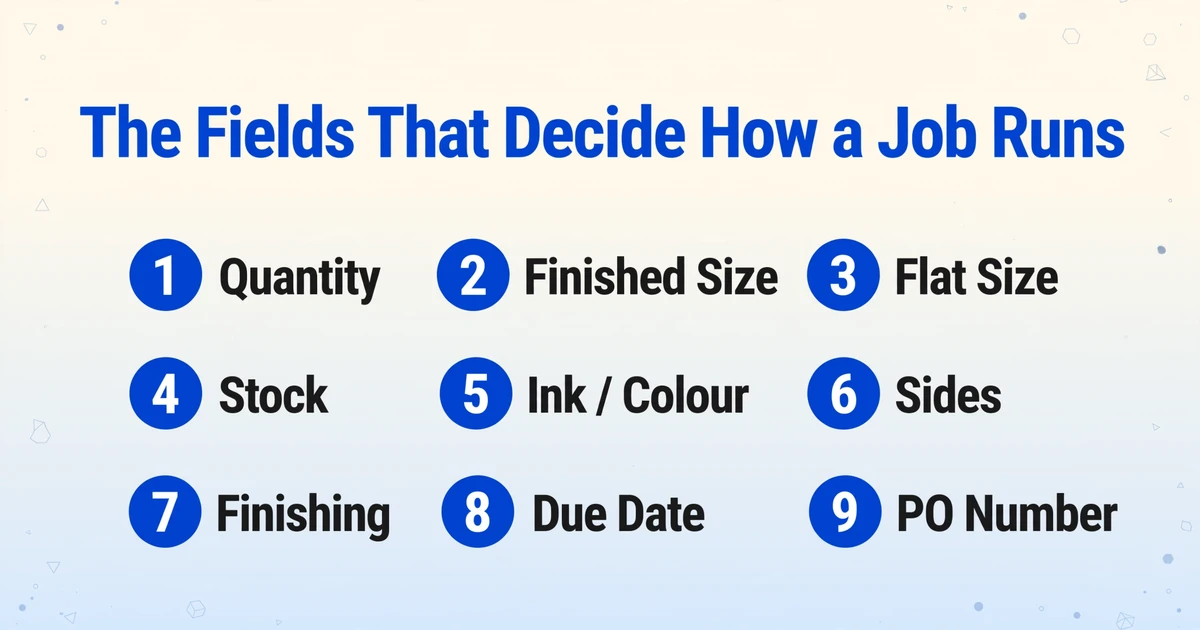
特に注目すべきフィールドが1つあります:平判サイズと仕上がりサイズです。仕上がり8.5 x 11の中綴じ冊子の平判サイズは11 x 17です。注文に数字が1つしかなく、チケットに誤ったサイズが記録された場合、印刷開始前に面付けが誤ります。両方の列に名前を付け、AIに両方が登場する箇所を見つけさせることで、それを事前に把握できるか、印刷機の上で気づくかの違いが生まれます。
印刷ジョブ注文は、社内で生産される受注伝票のようなもので、購入者自身のフォームとして届く場合は実質的に発注書となります。抽出パターンは、受注伝票のフィールドをスプレッドシートに取り込むや発注書データの抽出で説明したものと同じです。ここで変わるのはドキュメントです。印刷チケットには、通常の注文フォームにはないフィールドがあり、欠落すると実際のコストが発生します。
注文票を確認できる構造化された行に変換する
取り込みステップは、ツールが位置ではなく意味を読み取ることで自動化が可能になります。ImageToTable.aiではこれをカスタム列抽出と呼びます。「数量」「仕上がりサイズ」「用紙」「納期」など、必要な列名を入力すると、AIが固定レイアウトに合わせるのではなく、意味を理解してページ上のどこからでも各値を特定します。入力した列名が出力のヘッダー行になるため、最初のパスからテーブルがお客様のチケットに合わせて形作られます。これは、印刷業界の注文票自動化を実用的にする仕組みです。1つの列セットで全顧客のフォーマットに対応できるからです。
読み取りが意味ベースであるため、1つの列セットがすべての顧客のフォーマットで機能します。ある購入者からのPDF注文書も、別の購入者からのFAXスキャンも、3人目からの手書きの注文依頼も、いずれもテンプレートを用意することなく同じ行に変換されます。これこそが、注文入力の自動化を難しくしていたフォーマット問題への実用的な答えです。
ワークフロー自体は4つのステップで構成されています。
当日の注文を収集する
注文票をアップロードするか、自動で届くようにします。ドキュメントは、添付ファイルを自動処理する専用のメール受信ボックスに転送するか、アカウントなしで仕様書をアップロードできるコレクションリンクを通じて収集できます。バッチ処理とは、当日の注文をまとめてアップロードし、ファイルごとに作業するのではなく1つのテーブルに結合することです。フォルダ全体を一度にドロップして、すべてのジョブを行として取得できます。
チケットに合わせて列名を付ける
上記のテーブルのフィールド名を使用します。数量、仕上がりサイズ、平判サイズ、用紙、インク、面数、仕上げ、納期、PO番号などです。必要に応じて計算列を追加すると、読み取り時に計算も行われます。たとえば、数量と面付けから算出する枚数や、数量と単価から算出する行合計などです。
値をページと照合する
レビューモードで、抽出された任意のセルをクリックすると、元の注文票でその値の取得元の箇所がハイライト表示されます。危険なエラーはジョブが完全に失敗することではなく、フィールドが誤っているか欠落していることなので、注文書全体を読み直さずに仕様をソースと照合できることは、2回目の手動チェックではなくスポットチェックを実用的にします。
ジョブごとに1行をエクスポートする
出力は標準のXLSXまたはCSVファイルで、各注文票が1行、列名がヘッダーになります。レビュー用にスプレッドシートにステージングしたり、MISが受け付けるインポート形式にマッピングしたりできます。1つの注文が複数ページにわたる場合や、仕様書と注文書が別々に届く場合は、マルチページ結合によってページをその1行にまとめます。
ファイルは安全に処理され、保存されることはありません。
抽出した行を、お客様が既に運用中のMISにどう合わせるか
抽出された行は、お客様が既に運用しているシステムに合わせて構築されており、それを置き換えるものではありません。この経路を誠実に選ぶためには、引き継ぎがどこで発生するかを正確に把握することが重要です。
ImageToTable.aiは、EFI Pace、Avanti Slingshot、ePS、Tharstern、その他の印刷MISに直接書き込むことはありません。その出力は、XLSX、CSV、JSONなどの構造化ファイルです。そこから、行はスプレッドシートでレビューされ、MIS自身の注文入力またはインポート経路を通じてインポートされるか、開発者に引き渡されます。v1 APIは構造化JSONを返し、処理完了時にWebhookを通じてお客様のシステムに通知できます。これは、担当者を介さずに、カスタムジョブ管理ワークフローに取り込みステップを組み込むための経路です。オフィスが既にスプレッドシートで運用している場合は、Google Sheetsアドオンが結果をアクティブなシートに直接書き込みます。
これは、注文を受け付けるソフトウェアと生産を実行するソフトウェアの間でデータを移動するという、より広範な問題と同じ形です。ショップ外で生成されたジョブ注文と、製造タイムシートのような生産ドキュメントは、どちらも同じものを必要とします。それは、ドキュメントを、相手側のシステムが受け入れられるフィールドに変換する信頼できる方法です。業務全体にわたるドキュメント自動化の概要では、その広範な全体像を説明しています。ここでは、すべての価値が1つのステップに集中しているため、あちこちで行うよりも、このステップをしっかりと行う価値があります。
できないこと
このアプローチでできないことを理解することは、できることと同じくらい重要です。受付時に過大な約束をすることは、仕様書の欠落と同じことだからです。
ページに記載のない仕様を生み出すことはできません
注文書に用紙の指定がなければ、抽出でもそれを生成することはできません。AIはお客様が送信した内容を読み取ります。注文書に明記されていない限り、御社が常に100lbの社内用紙を使用していることをAIが知ることはありません。
暗黙の指定や簡略化された注文には、人の確認が必要です
「前回と同じ」は文章であって、仕様書ではありません。抽出ではその文言を正確に取得し、お客様にお渡しします。それを過去の注文履歴と照合して解決する作業は、御社のチームの役割です。
見積、スケジュール、登録は行いません
見積もり、生産スケジュール、面付け、MISへの書き込みは一切行いません。出力は構造化された行で終了します。MISや見積担当者がその行に対して行う処理は、それぞれの担当範囲に留まります。
品質の低いスキャンや読みにくい手書き文字には、確認が必要です
ビジョンモデルは印刷文字と手書き文字の両方を読み取りますが、かすれたFAXや読みにくい走り書きこそ、スポットチェックが真価を発揮する場面です。レビューモードは、その確認を迅速にするために存在しており、任意にするためではありません。
FAQ
FAXやスキャンされた注文書を読み取れますか?
はい。スキャン、FAX、スマートフォンでの撮影、PDFはすべて同じ方法で読み取られ、抽出はそれらのレイアウトに依存しません。ソースの品質が重要です。きれいなスキャンや明るい場所での撮影は、3世代目のFAXよりも良い結果が得られ、値は行が使用される前にレビューモードでページと照合できます。
顧客ごとに異なる注文書フォームでも機能しますか?
それがこの製品が作られた目的です。列は位置ではなく意味で照合されるため、1つの列設定で、仕様が文章で書かれたメール本文を含む、すべての顧客のフォーマットに対応できます。顧客ごとにテンプレートを作成する必要はなく、フォームが変更されても再構築する必要はありません。
印刷MISに直接書き込めますか?
いいえ。出力は構造化されたXLSX、CSV、またはJSONファイルです。お客様のMISの注文入力またはインポート機能を通じてインポートするか、開発者がv1 APIをカスタムワークフローに組み込みます。Pace、Avanti、ePSなどのシステムへの直接コネクタは製品の一部ではないため、正直な期待は、MISへの自動投稿ではなく、クリーンで確認可能な行です。
どの注文書フィールドを列として指定すべきですか?
間違えるとコストが最も高くなるものから始めてください。数量、仕上がりサイズ、平判サイズ、用紙、インク、面数、仕上げ、納期、PO番号です。ジョブ名、顧客名、ジョブ番号は、行を注文に遡って追跡するのに役立ちます。お客様のチームが現在手作業で行っている計算(枚数やライン合計など)には、計算列を追加してください。
複数ページにまたがる注文書を処理できますか?
はい。注文書と別の仕様書が同じ提出物の異なるページとして届いた場合、マルチページ結合でそれらを1つの行にグループ化し、すべてのページのフィールドが一緒に配置されます。ジョブ番号などの追跡値でグループ化することも、固定ページ数でグループ化することもできます。
添付ファイルなしでメール本文として注文が届いた場合はどうなりますか?
これはサポートされている受信チャネルです。メール受信ボックスは、添付ファイルの代わりに、または添付ファイルに加えてメッセージ本文を読み取るように設定でき、フォームを添付する代わりに仕様をメールに直接書く顧客に対応します。
この方法で注文書を読み取ると、担当者が受信ステップに留まり、ゼロから記入する空白のチケットではなく、確認するための構造化された行が提供されます。これにより、3ページ目に埋もれた仕様が、まだ行であり、再印刷になる前に検出されるのです。
1日分の注文書を1つのテーブルに入れ、チケットに実際に必要なフィールドを指定し、ジョブになる前に各値をソースと照合してください。お客様ご自身の注文でどのように機能するかご確認ください。