A maioria dos problemas de pedidos de impressão começa na entrada de dados,
não na impressora
Uma reimpressão geralmente remonta a uma linha que nunca entrou na ficha de trabalho. Tudo depois disso — a preparação, a chapa, a tiragem, o acabamento — é a gráfica executando corretamente as instruções que recebeu. É isso que torna a entrada de pedidos a etapa de maior alavancagem em um trabalho de impressão: é o último ponto em que todo o trabalho ainda é barato de alterar.
Principais conclusões
- Uma reimpressão é decidida na entrada do pedido, não na impressora, no último ponto em que todo o trabalho ainda é barato de alterar.
- Quarenta vezes por dia, a recepção não é ruim em ler um pedido — ela é solicitada a manter todas as especificações em mente entre chamadas telefônicas.
- O papel muda de digitar uma ficha em branco para verificar uma linha estruturada, em que cada coluna nomeada se conecta à página de onde veio.
Quando um Pedido de Impressão Vira uma Reimpressão
Dentro de uma gráfica, o pedido do cliente se torna um registro interno chamado ficha de trabalho (também conhecida como job bag ou docket). Essa ficha carrega as especificações que a gráfica precisa para produzir o trabalho: tamanho final, papel, quantidade, tinta, acabamento, data de entrega. O MIS da gráfica a gera, mas não pode gerar o que ninguém digitou nela.
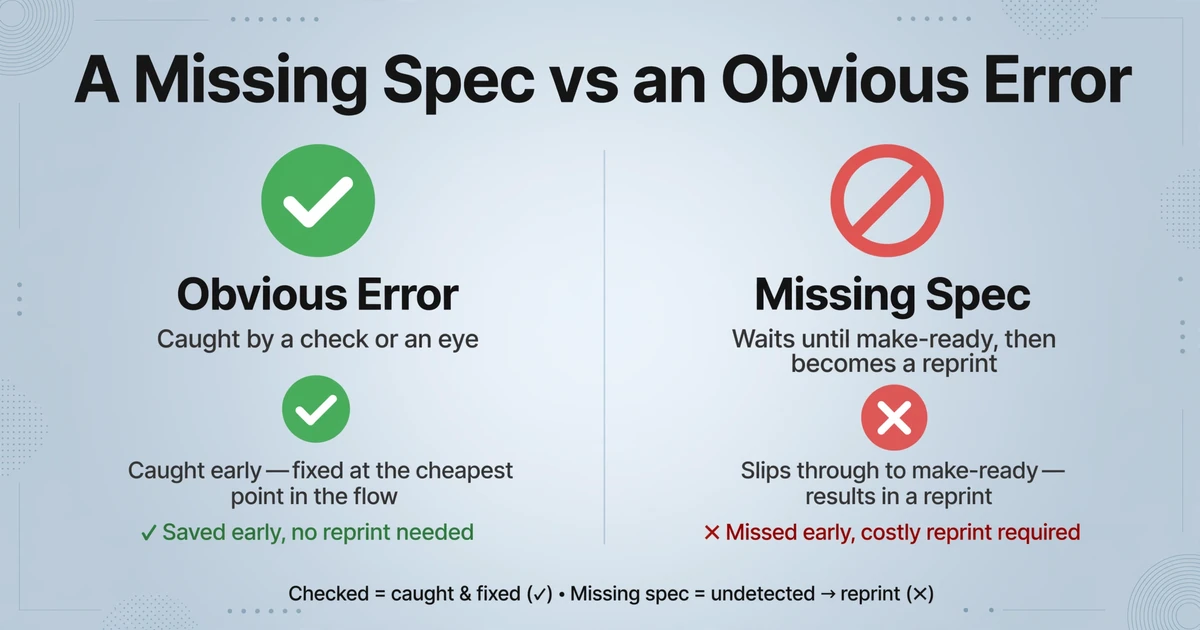
A falha que custa mais caro não é um número que está obviamente errado. Um total errado geralmente é pego porque esbarra em uma verificação ou em um olhar. A cara é um campo simplesmente ausente. A dobra que o cliente mencionou em uma resposta nunca é transferida. A quantidade é lida como 500 quando o pedido dizia 5.000. O papel é inserido como o padrão da casa quando o cliente pediu um revestido. Nada na ficha parece quebrado, então nada impede o trabalho.
Uma especificação ausente não falha em uma regra de validação. Ela espera até a preparação da máquina, quando as chapas são feitas e a prensa é carregada, e então se anuncia como uma reimpressão. Esse é o lugar mais caro do fluxo de trabalho para descobrir um erro que foi cometido no mais barato.
O custo não é apenas o papel e o tempo de prensa desperdiçados. Ele também recai sobre o cronograma, sobre a data de entrega prometida ao cliente e sobre a confiança que decide se esse cliente envia o próximo pedido. Nada disso aparece na ficha. Aparece semanas depois como um cliente que parou de ligar.
O Caminho de uma Ficha de Trabalho Antes da Impressão
Antes de um trabalho de impressão chegar à máquina, ele passa por pelo menos quatro pares de mãos, e cada uma trabalha com o mesmo registro criado na etapa de entrada de pedidos.
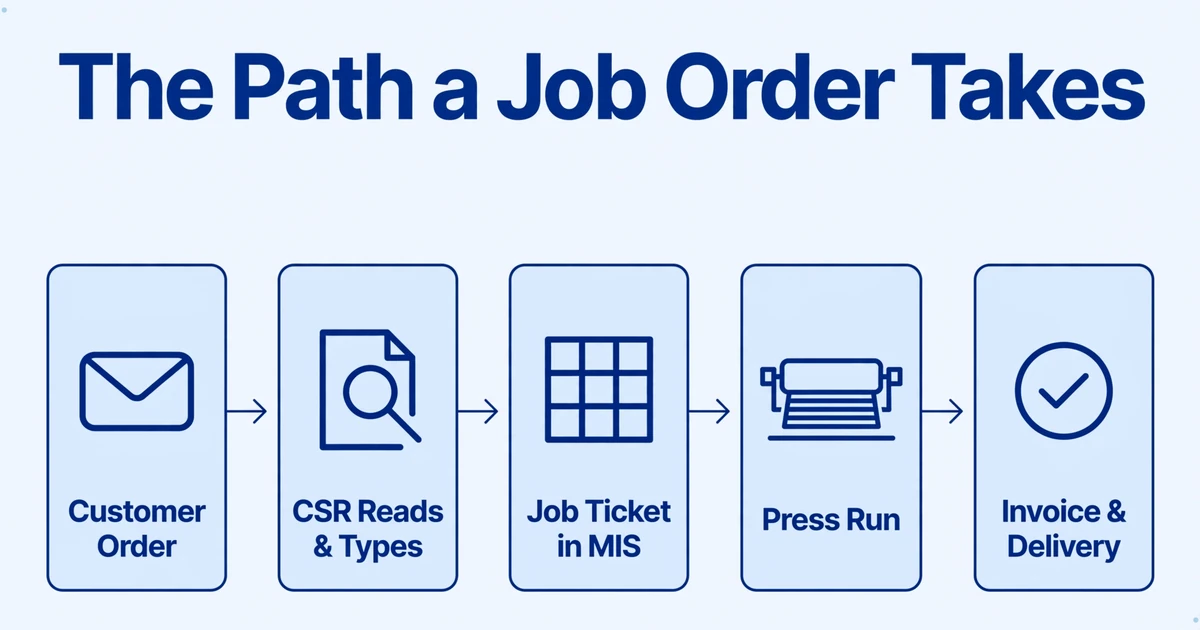
O pedido chega da forma que o cliente preferir enviar: um tópico de e-mail com a especificação real na terceira resposta, um pedido de compra em PDF, um fax, uma digitalização de uma solicitação manuscrita, um arquivo enviado por um portal do cliente. Um CSR ou orçamentista lê e o reconstrói dentro do MIS de impressão, o software no qual a empresa opera. Sistemas comuns em gráficas comerciais incluem EFI Pace, Avanti Slingshot, eProductivity Software (ePS), Tharstern e PrintSmith. O MIS não lê o pedido. Ele armazena a versão digitada pelo CSR.
A partir daí, o trabalho se torna uma ficha de trabalho impressa para o chão de fábrica, uma verificação de pré-impressão dos arquivos fornecidos, um espaço na programação da produção, uma execução na máquina, uma etapa de acabamento e, finalmente, uma fatura. O planejador agenda com base na ficha. O operador configura a máquina com base na ficha. O faturamento usa o mesmo registro. Um campo errado ou ausente no início se propaga por cada uma dessas etapas.
Você esperaria que isso já tivesse sido automatizado. O Print Census 2025 da FESPA, com base em 774 empresas em 89 países, descobriu que, onde as gráficas automatizam, a automação se concentra em ferramentas de fluxo de trabalho, plataformas web-to-print e pré-impressão, e que quase metade relata nenhuma automação. Produção e pré-impressão absorveram o investimento. A entrada de pedidos, ainda uma pessoa lendo um documento manualmente, em sua maioria não recebeu.
As gráficas não são indiferentes a isso. A PRINTING United Alliance relata que três quartos das gráficas dos EUA têm dificuldade em contratar operadores de máquina e acabamento qualificados. Um mercado de trabalho apertado deixa o escritório administrativo mais enxuto, não mais robusto, exatamente no momento em que o volume de pedidos está crescendo.
Por que a entrada de pedidos resiste à automação
A entrada de pedidos é difícil de automatizar porque cada cliente inventa um pedido de trabalho diferente. A análise baseada em modelos, a abordagem mais antiga, captura valores em coordenadas fixas em um layout conhecido. Ela funciona quando o mesmo documento chega da mesma fonte no mesmo formato. Uma gráfica é a situação oposta. O mesmo trabalho pode chegar como PDF de pedido de compra de um cliente, e-mail em texto puro de outro, formulário em papel escaneado de um terceiro, e um pedido de reimpressão que diz apenas "igual ao da última vez".
Manter um modelo por cliente e por formulário é um trabalho em si, e ele quebra na primeira vez que um cliente redesenha o formulário ou move a especificação do anexo para o corpo do e-mail. A solução alternativa vira uma pessoa lendo o pedido e digitando-o, o que traz o problema de volta para a transcrição humana sob interrupções.
Ler um pedido de trabalho não é a parte difícil. Qualquer pessoa na recepção consegue encontrar a quantidade e a data de entrega. A parte difícil é fazer isso quarenta vezes por dia, entre chamadas telefônicas, sem perder o único detalhe enterrado na página três. Um profissional de impressão descreveu a realidade diária no r/CommercialPrinting, perguntando quanto tempo o escritório ainda gasta "traduzindo manualmente dados não estruturados em fichas de trabalho estruturadas", e nomeando o culpado habitual: "as especificações enterradas em um e-mail de três páginas, os detalhes do 'trabalho anterior' presos em um PDF legado, ou uma planilha Excel formatada de forma estranha de um cliente." A pergunta que se segue é o tema deste artigo: com que frequência um erro de produção acontece porque "um detalhe estava enterrado em um arquivo e foi perdido durante a entrada inicial?"
O erro de entrada de pedidos que dói é silencioso. Uma dobra perdida ou um papel trocado não aciona nenhuma verificação, então o trabalho continua e o erro é descoberto quando a impressora já está rodando.
Essa é a lacuna que vale a pena fechar. O objetivo é eliminar a redigitação por completo, para que as especificações sejam capturadas conforme aparecem no documento e possam ser verificadas antes de virarem um trabalho. Na extração de dados de pedidos de impressão, essa distinção é o ponto central: um digitador mais rápido ainda perde um campo, enquanto uma linha estruturada pode ser verificada.
Os campos que decidem como um trabalho é executado
Uma ficha de trabalho de impressão é um documento curto com um custo por campo excepcionalmente alto. Estes são os campos que valem a pena nomear como colunas de extração, no vocabulário que um pedido real usa.
| Campo | Como os pedidos costumam descrever | O que custa errar |
|---|---|---|
| Número do trabalho / pedido | Nº do pedido, nome do trabalho, referência | A ficha não pode ser vinculada ao pedido; reimpressões e novos pedidos perdem seu histórico. |
| Cliente e número do pedido de compra | Cobrança, PO nº, conta | O faturamento não consegue conciliar a nota fiscal com a documentação do comprador. |
| Quantidade (e excedente) | 500, 1M, "rodar 5% a mais" | Produção abaixo do pedido exige uma segunda configuração; produção acima queima estoque e tempo. |
| Tamanho final (e tamanho aberto) | 8,5x11 final, A4, cortar para | A imposição e o corte ficam errados; o trabalho sai do acabamento com o tamanho errado. |
| Substrato / papel | couchê 100lb, 350gsm, nome da marca, "igual ao da última vez" | O papel errado altera cor e toque, e pode não estar no estoque da casa. |
| Tinta / cor | CMYK, 4/4, PMS 186 | A correspondência de cor é rejeitada e a tiragem é perdida ou refeita. |
| Lados | 1 lado, frente e verso, 4/4 | Metade do trabalho é impressa de um lado só ou o verso fica errado. |
| Acabamento | grampo canoa, lombada colada, dobra, furação, encadernação, embalagem plástica | O acabamento é agendado errado e o trabalho é redirecionado ou refeito. |
| Data de entrega / envio | até sexta, enviar 20/10, o quanto antes | Um prazo perdido e frete expresso para recuperar o atraso. |
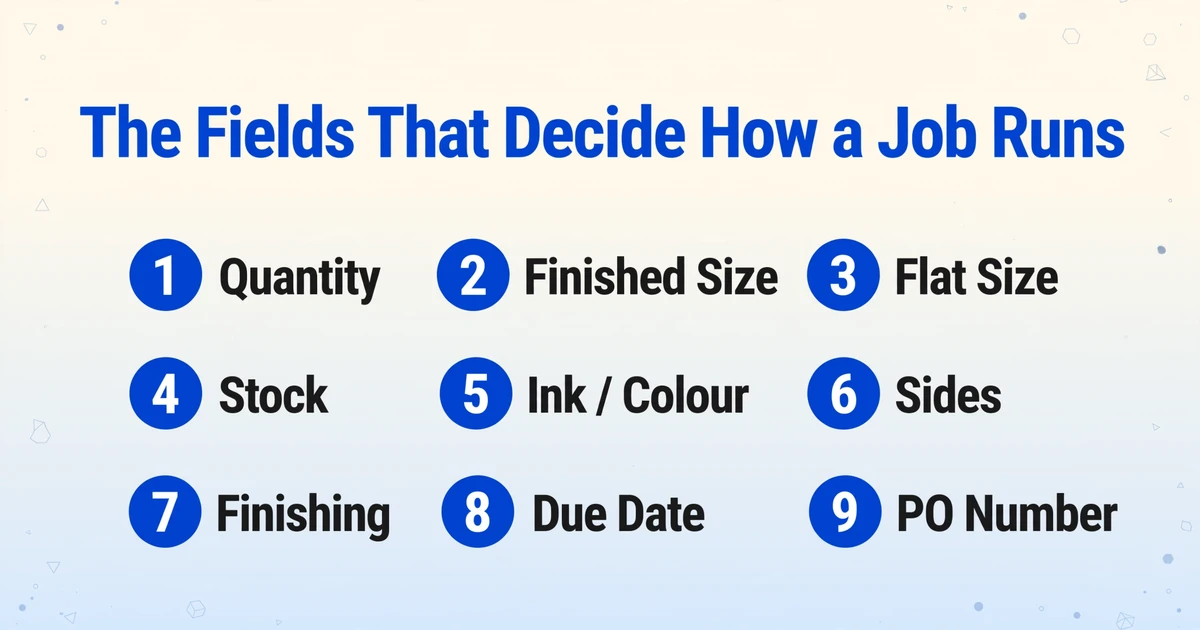
Um campo merece uma observação própria: tamanho aberto versus tamanho final. Um livreto grampeado canoa com 8,5 x 11 final tem tamanho aberto de 11 x 17. Se o pedido informa apenas um número e a ficha registra o errado, a imposição já sai errada antes de a impressora começar. Nomear as duas colunas e deixar a IA encontrar ambas onde aparecem é a diferença entre detectar isso e descobrir na impressão.
Um pedido de trabalho de impressão se comporta como um pedido de venda que acontece de ser produzido internamente, e quando chega no formulário do próprio comprador, é efetivamente um pedido de compra. O padrão de extração é o mesmo abordado em puxando campos de pedidos de venda para uma planilha e em extraindo dados de pedidos de compra. O que muda aqui é o documento: uma ficha de impressão tem campos que a maioria dos formulários de pedido nunca carrega, e um campo ausente tem um custo físico.
Transformando um Pedido em Linhas Estruturadas que Você Pode Verificar
A etapa de captura se torna automatizável quando a ferramenta lê pelo significado em vez da posição. É isso que a ImageToTable.ai chama de Extração de Colunas Personalizadas: você digita os nomes das colunas que deseja, como "Quantidade", "Formato Final", "Papel" ou "Data de Entrega", e a IA localiza cada valor em qualquer lugar da página entendendo o que ele significa, sem depender de um layout fixo. Os nomes que você digita se tornam a linha de cabeçalho da saída, então a tabela já nasce com o formato do seu pedido. É o mecanismo que torna prática a automação de pedidos para impressão, porque um único conjunto de colunas cobre o formato de todos os clientes.
Como a leitura é semântica, um único conjunto de colunas funciona com o formato de todos os clientes. Um pedido de compra em PDF de um comprador, um scan enviado por fax de outro e um pedido manuscrito de um terceiro se resolvem na mesma linha, sem modelo criado para nenhum deles. Essa é a resposta prática para o problema de formato que dificulta a automação da entrada de pedidos.
O fluxo de trabalho tem quatro etapas.
Colete os pedidos do dia
Envie os pedidos ou deixe que cheguem sozinhos. Os documentos podem ser encaminhados para uma caixa de entrada de e-mail dedicada que processa os anexos automaticamente, ou coletados por meio de um Link de Coleta que o cliente pode abrir para enviar uma ficha técnica sem precisar de conta. O processamento em lote significa enviar os pedidos do dia juntos e mesclá-los em uma única tabela, em vez de trabalhar arquivo por arquivo: solte a pasta inteira de uma vez e receba cada pedido como uma linha.
Nomeie as colunas como na ficha de trabalho
Use os nomes dos campos da tabela acima: Quantidade, Formato Final, Formato Aberto, Papel, Tinta, Lados, Acabamento, Data de Entrega, Número do Pedido de Compra. Adicione colunas calculadas quando for útil, para que a extração faça a aritmética enquanto lê, como uma contagem de folhas derivada da quantidade e do formato, ou um total por linha derivado da quantidade e do preço unitário.
Verifique um valor na página
No modo de revisão, clique em qualquer célula extraída e o pedido original destacará o local de onde aquele valor veio. Como o erro perigoso é um campo errado ou ausente, e não um pedido que falha por completo, poder verificar uma especificação na fonte sem reler o pedido inteiro é o que torna a verificação por amostragem prática, em vez de uma segunda passagem manual.
Exporte uma linha por pedido
A saída é um arquivo XLSX ou CSV padrão, com cada pedido como uma linha e seus nomes de coluna como cabeçalhos. Ele pode ser organizado em uma planilha para revisão ou mapeado para o formato de importação aceito pelo seu MIS. Quando um único pedido abrange várias páginas ou chega como uma ficha técnica separada do formulário de pedido, a mesclagem de várias páginas reúne as páginas de volta naquela única linha.
Os arquivos são processados com segurança e não são armazenados.
Como as Linhas Encontram o MIS que Você Já Usa
As linhas extraídas são criadas para se alinhar ao sistema que você já usa, não para substituí-lo. Ser preciso sobre onde ocorre a transferência faz parte de escolher esse caminho com honestidade.
O ImageToTable.ai não grava diretamente no EFI Pace, Avanti Slingshot, ePS, Tharstern ou em qualquer outro MIS de impressão. Sua saída é um arquivo estruturado: XLSX, CSV ou JSON. A partir daí, a linha é revisada em uma planilha e importada pelo caminho de entrada de pedidos ou importação do próprio MIS, ou entregue a um desenvolvedor. A API v1 retorna JSON estruturado e pode notificar seu sistema por meio de um webhook quando o processamento terminar, que é o caminho para integrar a etapa de entrada em um fluxo de trabalho personalizado de gerenciamento de pedidos sem uma pessoa no meio. Se o escritório já vive em planilhas, o complemento do Google Sheets grava os resultados diretamente na planilha ativa.
Essa é a mesma forma do problema mais amplo de mover dados entre o software que recebe pedidos e o software que executa a produção. Um pedido de trabalho gerado fora da gráfica e um documento de produção como uma folha de ponto de fabricação precisam da mesma coisa: uma maneira confiável de transformar um documento em campos que o sistema do outro lado possa aceitar. A visão geral da automação de documentos em uma operação cobre esse panorama mais amplo. Aqui, todo o valor está concentrado em uma única etapa, por isso vale a pena fazê-la bem em vez de fazê-la em todos os lugares.
O Que Isto Não Faz
O que a abordagem não pode fazer importa tanto quanto o que ela pode, porque uma promessa inflada no recebimento é apenas outro tipo de especificação ausente.
Não pode inventar uma especificação que não está na página
Se a ficha de trabalho não informa o papel, a extração não pode produzi-lo. A IA lê o que o cliente enviou. Ela não sabe que sua gráfica sempre usa a folha padrão de 100lb, a menos que o pedido diga isso.
Pedidos implícitos e abreviados ainda precisam de um humano
"Igual ao da última vez" é uma frase, não uma especificação. A extração captura a frase com precisão e a entrega a você. Resolver isso com base no histórico de trabalhos permanece com sua equipe.
Não faz orçamento, agendamento ou lançamento
Sem orçamentação, sem programação de produção, sem imposição, sem gravação no MIS. A saída termina na linha estruturada. Tudo o que o MIS ou o orçamentista faz com essa linha permanece onde deve ser.
Escaneamentos ruins e caligrafia incomum merecem uma verificação
Os modelos de visão leem texto impresso e manuscrito, mas um fax muito desbotado ou uma caligrafia incomum é exatamente onde uma verificação pontual se justifica. O modo de revisão existe para tornar essa verificação rápida, não para torná-la opcional.
FAQ
Ele consegue ler uma ordem de serviço enviada por fax ou digitalizada?
Sim. Digitalizações, faxes, fotos de celular e PDFs são lidos da mesma forma, e a extração não está vinculada ao layout de nenhum deles. A qualidade da fonte importa: uma digitalização limpa ou uma foto bem iluminada dá melhores resultados do que um fax de terceira geração, e os valores podem ser conferidos na página no modo de revisão antes de a linha ser usada.
Funciona se cada cliente enviar um formulário de ordem de serviço diferente?
É exatamente para esse caso que ele foi criado. Como as colunas são combinadas pelo significado e não pela posição, uma única configuração de colunas cobre o formato de todos os clientes, inclusive corpos de e-mail com a especificação escrita em prosa. Não há modelo para criar por cliente e nada para reconstruir quando um formulário muda.
Ele consegue gravar diretamente no nosso MIS de impressão?
Não. A saída é um arquivo estruturado em XLSX, CSV ou JSON. Você o importa pelo próprio caminho de entrada de pedidos ou importação do seu MIS, ou um desenvolvedor conecta a API v1 a um fluxo de trabalho personalizado. Conectores diretos em sistemas como Pace, Avanti ou ePS não fazem parte do produto, então a expectativa honesta é uma linha limpa e revisável, e não um lançamento automático no MIS.
Quais campos da ordem de serviço devo nomear como colunas?
Comece pelos que geram mais custo se estiverem errados: Quantidade, Tamanho Acabado, Tamanho Plano, Papel, Tinta, Lados, Acabamento, Data de Entrega e Número do Pedido de Compra. Nome do trabalho, cliente e número do trabalho são úteis para rastrear a linha até o pedido. Adicione colunas calculadas para a aritmética que sua equipe faz manualmente hoje, como contagem de folhas ou total da linha.
Ele consegue lidar com uma ordem de serviço distribuída em várias páginas?
Sim. Se o pedido e uma folha de especificações separada chegarem como páginas diferentes da mesma submissão, a mesclagem de várias páginas os agrupa de volta em uma única linha para que os campos de todas as páginas fiquem juntos. Ele pode agrupar por um valor rastreado, como o número do trabalho, ou por um número fixo de páginas.
E se o pedido chegar como corpo de e-mail sem anexo?
Esse é um canal de recebimento suportado. A caixa de entrada de e-mail pode ser configurada para ler o corpo da mensagem em vez de, ou junto com, seus anexos, o que cobre o cliente que escreve a especificação diretamente no e-mail em vez de anexar um formulário.
Ler uma ordem de serviço dessa forma mantém a pessoa na etapa de recebimento e dá a ela uma linha estruturada para conferir, em vez de uma ficha em branco para preencher do zero. É assim que a especificação enterrada na página três é capturada enquanto ainda é uma linha e ainda não virou uma reimpressão.
Coloque as ordens de serviço de um dia em uma única tabela, nomeie os campos que sua ficha realmente precisa e confira cada valor na fonte antes de virar um trabalho. Veja como ele lida com seus próprios pedidos.