手書き請求書から
請負業者向けデータを抽出する方法
ほとんどの請求書抽出ツールは、企業ベンダーが発行する入力済みPDF向けに作られています。地元の木材店から届いた走り書きの仕入先請求書を従来のOCRシステムに読み込ませると、フィールド名が文字化けしたり、まったく何も出力されなかったりします。請求書の大半を紙で受け取る請負業者 — しかも手書きが多い — にとって、「OCRツールを使えばいい」という一般的なアドバイスは通用しません。
主なポイント
- 手書き請求書が従来のOCRを破綻させるのは、ツールがページ上の想定された位置で文字の形を読み取るためです — 走り書きされた木材店の請求書はどちらのパターンにも当てはまりません。
- 失敗の原因は手書きの丁寧さではありません。テンプレートベースの抽出では各フィールドに固定の座標が必要ですが、20社の仕入先はそれぞれ請求書の日付をページの違う隅に書いています。
- ImageToTable.aiはフィールドの意味を理解して位置を特定します — 「請求書日付」はグリッド位置をスキャンするのではなく、文脈の中で日付を認識して見つけます。この一つの違いが、手書き請求書の抽出を実際に機能させます。
手書き請求書が従来のOCRでは対応できない理由
印刷された請求書には予測可能な構造があります。ベンダー名はヘッダーブロックにあり、請求書番号は右上付近に表示され、明細行はラベル付きの列を持つグリッドに配置されています。従来のOCRツールはまさにこの前提に基づいて構築されており、想定された位置のテキストを探し、テンプレートと照合します。
地元のサプライヤーからの手書き請求書は、こうした前提をすべて覆します。ベンダーが会社名を左上の余白に走り書きすることもあります。明細行が表ではなくダッシュで縦に並ぶこともあります。合計金額がラベルなしで右下隅に丸で囲まれていることもあります。テンプレートベースのOCRシステム——参照ドキュメント上で各フィールドの周囲にボックスを定義する必要があるタイプ——では、このような変動に対応できません。新しいサプライヤーの手書き文字ごとに新しいテンプレートが必要になり、あまりに自由な形式の請求書ではどのテンプレートも機能しません。
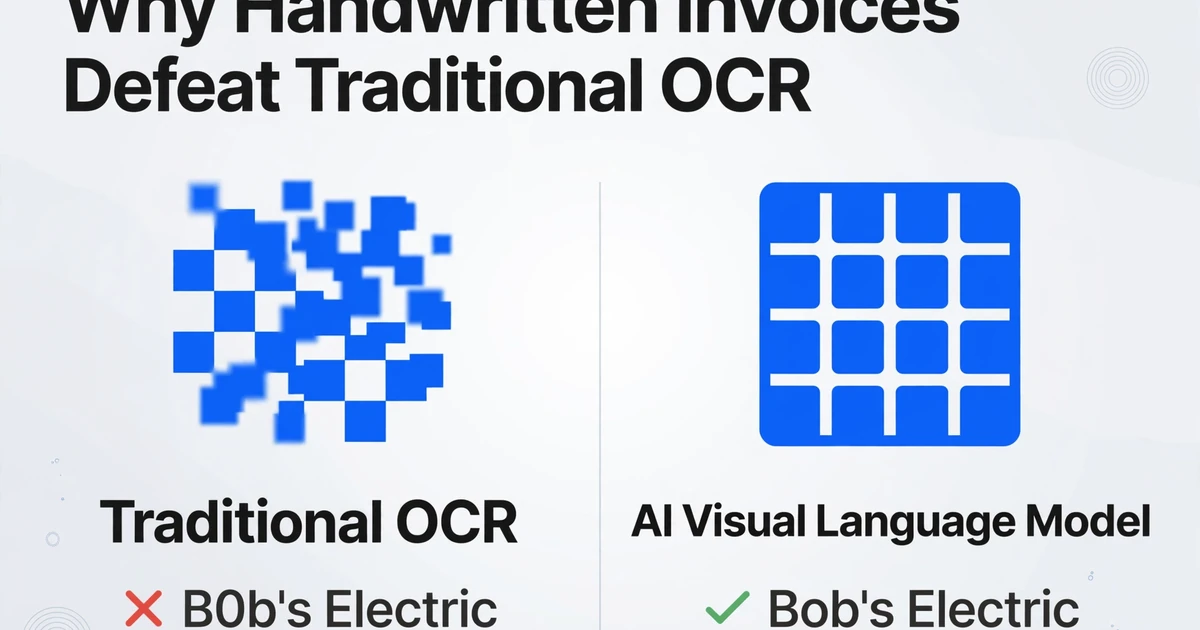
ここで重要なのは、基盤となるエンジンです。従来のOCRは文字の形状とパターンを検出します——ピクセルレベルのマッチングです。小文字の「g」のループや「t」の横棒を見て、統計的に推測します。手書きが急いでいたり、傾いていたり、サプライヤーごとに異なったりすると、そうしたピクセルレベルのパターンは急速に劣化します。その結果、「Bob's Electric」ではなく「B0b's Electric」、「$2,350.00」ではなく「$23,$0.00」、あるいはOCRが信頼度のしきい値に達せずフィールドが空として認識されることがあります。
視覚言語モデル——現代のAI手書き抽出を支える技術——は異なる仕組みで動作します。文字の形状を照合する代わりに、人間と同じようにドキュメントを理解します。つまり文脈を読み取り、個々の文字が曖昧であっても「Bob's」が名前であり「$2,350.00」が通貨金額であることを認識します。この意味論的アプローチにより、従来のOCRでは決して実現できなかった形で手書き請求書抽出が可能になります。これら2つのアプローチの違いについてより詳しく知りたい方は、AI手書き認識と従来のOCRの比較をご覧ください。
手書き請求書に抽出ツールが果たすべき3つの条件
手書き請求書の滞留分を処理するツール、あるいはこれ以上増やさないためのツールを検討しているなら、譲れない3つの要件を紹介します。どれか1つでも欠けると、1週間以内に手入力に戻ることになります。
1. テンプレート不要。これが決定的な条件です。「サンプル請求書」をアップロードしてフィールドを四角で囲むよう求めるツールは、同じ取引先の同じフォーマットの定期的な請求書を想定して設計されています。工事業者は、木材販売店、配管卸売業者、機器レンタル会社、独立下請け業者など、10〜30社の異なる取引先と取引します。それぞれ手書きの癖もレイアウトも異なります。取引先ごとに個別のテンプレートが必要なら、その設定時間だけで節約できる時間が消えてしまいます。ツールは事前設定なしに、各請求書をそのまま読み取るべきです。
2. 位置ベースの照合ではなく、セマンティックなフィールド検出。印刷された請求書では、「請求日」は常に上部付近にあります。手書き請求書では、日付が余白に走り書きされていたり、最初の明細の上に書かれていたり、隅に斜めに書きなぐられていたりします。位置ベースのツールでは見つけられません。セマンティックなツール——文脈の中で日付がどのように見えるかを理解するツール——なら、ページ上のどこに現れても特定できます。これがカスタム列抽出の実現するものです。「請求日」「取引先名」「明細合計」など、欲しいフィールドをAIに伝えれば、固定座標をスキャンするのではなく、その意味を理解して値を特定します。
3. 手書き認識だけでなく、手書きへの許容性。認識とは、AIが整った筆記体で書かれた「Smith & Sons」を読めるかどうかの確認です。許容性とは、請求書を書いた人のペンがインク切れでかすれ、紙がトラックのグローブボックスで折りたたまれてしわになり、「&」がプラス記号のように見える場合でも、同じ名前を読めるかどうかです。管理されたデモ環境では機能するが、実際の工事業者の書類では失敗するツールは役に立ちません。抽出システムは、職人が受け取る実際の手書き請求書の品質——理想化されたサンプルではなく——に対応できる必要があります。
ステップバイステップ:手書きの仕入先請求書から構造化されたExcelへ
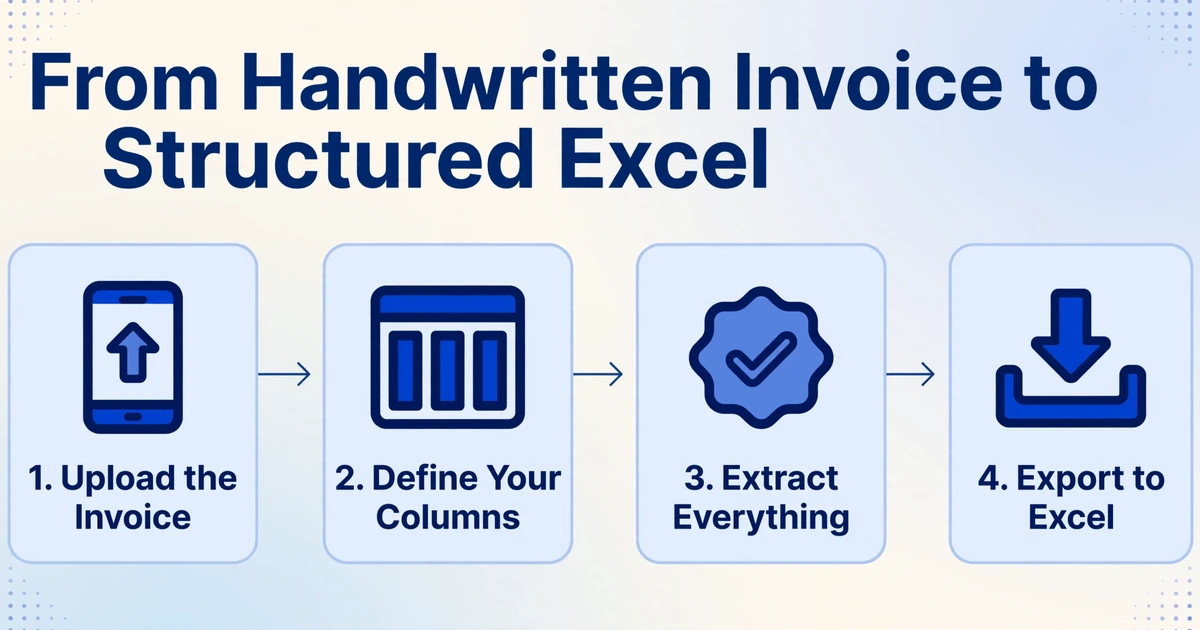
実際のシナリオを見ていきましょう。あなたは住宅向け電気工事士です。FergusonがMaple Streetのキッチンリフォーム用に12/2 Romex、ジャンクションボックス、ブレーカーをちょうど納品しました。納品書は手書きです。Fergusonのドライバーが倉庫で記入し、明細はボールペンで走り書きされ、型番は省略されています。金曜日までにジョブコスト計算のためにQuickBooksへ入力する必要がありますが、このような請求書7枚分の明細10行を打ち直すと、週末がつぶれてしまいます。
以下が抽出ワークフローです。順を追って説明します。
ファイルは安全に処理され、保存されません。
なぜ請負業者は請求書が「デジタル化」されるのを待つべきでないのか
抽出ツールを評価する請負業者からよく聞かれる反応は、「サプライヤーに紙の代わりにPDFを送ってもらえばいいだけだ」というものです。理にかなっているように聞こえますが、手書き請求書が建設業界に残り続ける理由を誤解しています。
地元の材木店の配達ドライバーが、トラックの中でiPadから請求書をメールで送り始めることはありません。1987年から同じやり方で商売をしてきた電気卸売業者が、一人の顧客の要望で電子請求書に切り替えることはありません。独立系の下請け業者 — バスルームのリフォームに連れてきた左官職人や、下地工事を手伝った空調業者 — 彼らはトラックにある紙に請求書を書きます。これらは経理部門を持つ企業ではなく、請求システムがメモ帳とペンである熟練した職人です。
建設業界における手書き請求書への依存は、いずれ自然に解消される一時的な段階ではありません。これは構造的な現実です。この業界は、書類の形式よりもスピードと柔軟性を重視する小規模な独立事業者同士の関係性で成り立っています。請求書を手書きして配達物と一緒に投げ渡すサプライヤーは、困ったときに朝6時に駆けつけてくれるサプライヤーでもあります。請求書の形式ごときで彼らを切ることはありませんし、良いサプライヤー関係と管理しやすいバックオフィスのどちらかを選ばなければならないという状況に追い込まれるべきでもありません。
解決策は、業界のデジタル化を待つことではありません。実際に受け取る請求書に対応した抽出ツールを使うことです — 手書きでも、タイプ印刷でも、その両方でも — サプライヤーの業務方法を変える必要はありません。テクノロジーは、建設業界の実際の働き方に追いついてきています。
よくある質問
手書きの品質は抽出精度に影響しますか?
影響はありますが、想像するほどではありません。最新のAI手書き抽出は意味理解を使用します。読みにくい単語の周囲の文脈を読み取り、人が乱雑な手書きを目を細めて見て周囲の情報から解釈するのと同じように、その単語が何を意味するかを解釈します。ブロック体の大文字が最も簡単で、急いで書かれた筆記体は難しいものの抽出は可能です。失敗の原因となるのは、必ずしも悪い手書きそのものではなく、極端な条件です。急な角度で書かれた文字、重なり合う文字、紙に対してコントラストがほぼ見えないほど薄いインクなどです。配送伝票や仕入先請求書に見られるような、一般的な請負業者レベルの手書きの場合、精度は十分に高く、修正はフィールド全体ではなく個々の文字単位で行われます。
印刷部分と手書き部分の両方がある請求書を処理できますか?
はい。多くの仕入先請求書には、印刷されたヘッダー(会社ロゴ、住所欄)と手書きの記入欄(明細項目、数量、署名)があります。AIは両方を読み取ります。印刷テキストはほぼ完璧な精度で、手書きテキストは上記の意味理解を使用します。2つを前処理したり分離したりする必要はありません。同じ抽出実行でページ全体を処理します。
2つの仕入先がまったく異なる請求書レイアウトを使用している場合はどうなりますか?
問題ありません。レイアウトごとに個別の設定が必要なテンプレートベースのツールとは異なり、意味的フィールド検出を使用するAI抽出は、ページ上のどこに何が表示されるかを気にしません。「請求日」は、ある仕入先の請求書では右上にあり、別の仕入先では左下にある場合でも見つかります。これは、請負業者にとってテンプレートベースの抽出よりも意味的抽出の最大の利点です。列を一度定義すれば、すべての仕入先の形式で機能します。
初回セットアップにはどのくらい時間がかかりますか?
実質的にセットアップは不要です。抽出したい列名を入力するだけです。サンプル文書のアップロード、テンプレートの作成、トレーニングデータの提供は一切不要です。必要なフィールド(仕入先名、請求日、明細項目、合計)がすでにわかっている場合は、1分以内で完了します。列設定をプリセットとして保存して再利用することもできるため、将来の請求書バッチはすべて再入力せずに同じフィールド定義を使用できます。
これはサプライヤー請求書だけでなく、下請け業者の請求書にも対応していますか?
はい。下請け業者の請求書 — 左官屋やHVAC技術者が紙に「40時間 @ $65/時 — $2,600」と書くようなもの — は、複数の明細行があるサプライヤー請求書よりも構造的にシンプルです。同じ抽出プロセスで処理できます。「下請け業者名」「日付」「時間」「単価」「合計」として列を定義すれば、AIがレイアウトに関係なく手書きのシートからそれらの値を抽出します。複数の下請け業者の請求書を一度に処理する場合は、バッチ抽出がより高速な方法です。