Comment extraire les données de factures manuscrites
pour les entrepreneurs
La plupart des outils d'extraction de factures sont conçus pour des PDF saisis provenant de fournisseurs d'entreprise. Déposez une facture fournisseur griffonnée d'une scierie locale dans un système OCR traditionnel, et les résultats vont de noms de champs incompréhensibles à un silence total. Pour les entrepreneurs qui reçoivent la majorité de leurs factures sur papier — souvent manuscrites — le conseil standard « utilisez simplement un outil OCR » ne tient pas.
Points clés
- Les factures manuscrites mettent en échec l'OCR traditionnel car l'outil lit les formes des caractères aux positions attendues sur une page — et une facture griffonnée d'une scierie ne suit ni l'un ni l'autre de ces schémas.
- L'échec ne tient pas à la propreté de l'écriture. L'extraction basée sur un modèle nécessite une coordonnée fixe pour chaque champ, et vos 20 fournisseurs différents écrivent tous la date de facture dans un coin différent de la page.
- ImageToTable.ai localise les champs en comprenant ce qu'ils signifient — « Date de facture » est trouvée en reconnaissant une date en contexte, et non en scannant une position de grille. Cette seule différence est ce qui fait réellement fonctionner l'extraction de factures manuscrites.
Pourquoi les factures manuscrites déjouent l'OCR traditionnel
Une facture imprimée a une structure prévisible : le nom du fournisseur se trouve dans un bloc d'en-tête, le numéro de facture apparaît en haut à droite, et les lignes d'articles sont disposées dans une grille avec des colonnes étiquetées. Les outils OCR traditionnels reposent exactement sur cette hypothèse — ils cherchent le texte aux positions attendues et le comparent à un modèle.
Une facture manuscrite d'un fournisseur local brise chacune de ces hypothèses. Le fournisseur peut griffonner son nom commercial dans la marge en haut à gauche. Les lignes d'articles peuvent être empilées verticalement avec des tirets au lieu d'un tableau. Le total peut être entouré dans le coin inférieur droit sans aucune étiquette. Un système OCR basé sur des modèles — celui qui vous oblige à définir des zones autour de chaque champ sur un document de référence — ne peut pas gérer cette variabilité. Chaque nouvelle écriture de fournisseur implique un nouveau modèle, et certaines factures sont si libres qu'aucun modèle ne fonctionne.
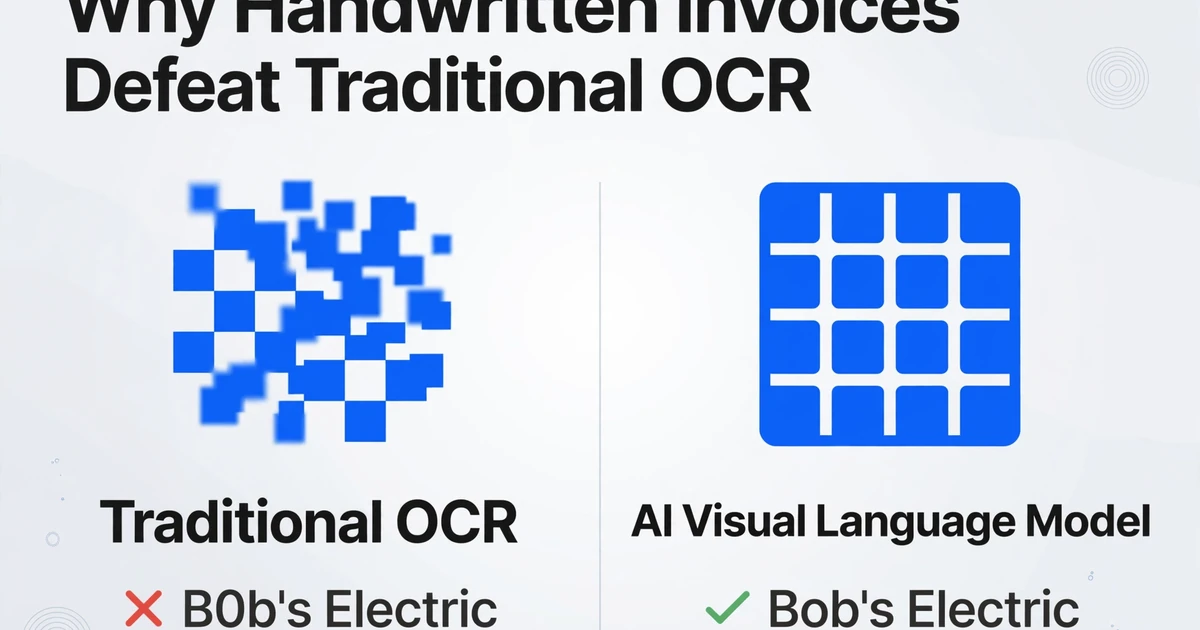
C'est là que le moteur sous-jacent compte. L'OCR traditionnel détecte les formes et motifs des caractères — une correspondance au niveau du pixel. Il repère les boucles d'un « g » minuscule et la barre d'un « t » et fait une estimation statistique. Quand l'écriture est précipitée, inclinée ou varie d'un fournisseur à l'autre, ces motifs au niveau du pixel se dégradent vite. Résultat : « B0b's Electric » au lieu de « Bob's Electric », « $23,$0.00 » au lieu de « $2,350.00 », ou des champs vides parce que l'OCR n'a pas atteint un seuil de confiance.
Les modèles de langage visuel — la technologie derrière l'extraction d'écriture manuscrite par IA moderne — fonctionnent différemment. Au lieu de faire correspondre des formes de caractères, ils comprennent le document comme une personne : en lisant le contexte, en reconnaissant que « Bob's » est un nom et que « $2,350.00 » est un montant en devise, même quand les caractères individuels sont ambigus. Cette approche sémantique rend l'extraction de factures manuscrites viable comme l'OCR traditionnel ne l'a jamais été. Pour une comparaison plus approfondie de ces deux approches, consultez notre analyse de la reconnaissance d'écriture manuscrite par IA face à l'OCR traditionnel.
Les trois choses qu'un outil d'extraction doit faire pour les factures manuscrites
Si vous évaluez des outils pour traiter votre arriéré de factures manuscrites — ou pour l'empêcher de grossir — voici les trois exigences non négociables. Omettez-en une seule, et vous reviendrez à la saisie manuelle en une semaine.
1. Aucun modèle requis. C'est le critère décisif. Un outil qui vous demande de téléverser une « facture exemple » et de dessiner des zones autour des champs est conçu pour des factures récurrentes d'un même fournisseur, dans un même format. Les entrepreneurs travaillent avec 10 à 30 fournisseurs différents — scieries, grossistes en plomberie, loueurs de matériel, sous-traitants indépendants — chacun avec son écriture et sa mise en page. Si vous avez besoin d'un modèle distinct pour chaque fournisseur, le temps de configuration à lui seul annule le gain de temps. L'outil doit lire chaque facture selon ses propres termes, sans préconfiguration.
2. Détection sémantique des champs, et non correspondance par position. Sur une facture imprimée, la « date de facture » se trouve toujours près du haut. Sur une facture manuscrite, la date peut être griffonnée dans la marge, écrite au-dessus du premier article ou tracée en diagonale dans le coin. Un outil basé sur la position ne la trouvera pas. Un outil sémantique — qui comprend à quoi ressemble une date en contexte — la localise quel que soit l'endroit de la page où elle apparaît. C'est ce que permet l'extraction de colonnes personnalisées : vous indiquez à l'IA le champ souhaité (« date de facture », « nom du fournisseur », « total de ligne »), et elle localise la valeur en comprenant son sens, sans balayer une coordonnée fixe.
3. Tolérance à l'écriture manuscrite, pas seulement reconnaissance d'écriture. La reconnaissance, c'est vérifier si l'IA peut lire « Smith & Sons » dans une cursive soignée. La tolérance, c'est vérifier si elle peut lire le même nom quand le stylo du rédacteur n'avait plus d'encre, que le papier est froissé d'avoir été plié dans la boîte à gants d'un camion et que le « & » ressemble davantage à un signe plus. Un outil qui fonctionne dans des conditions de démonstration contrôlées mais échoue sur les documents réels des entrepreneurs n'est pas utile. Le système d'extraction doit gérer la qualité réelle des factures manuscrites que reçoivent les artisans — pas des échantillons idéalisés.
Étape par étape : d'une facture fournisseur manuscrite à un Excel structuré
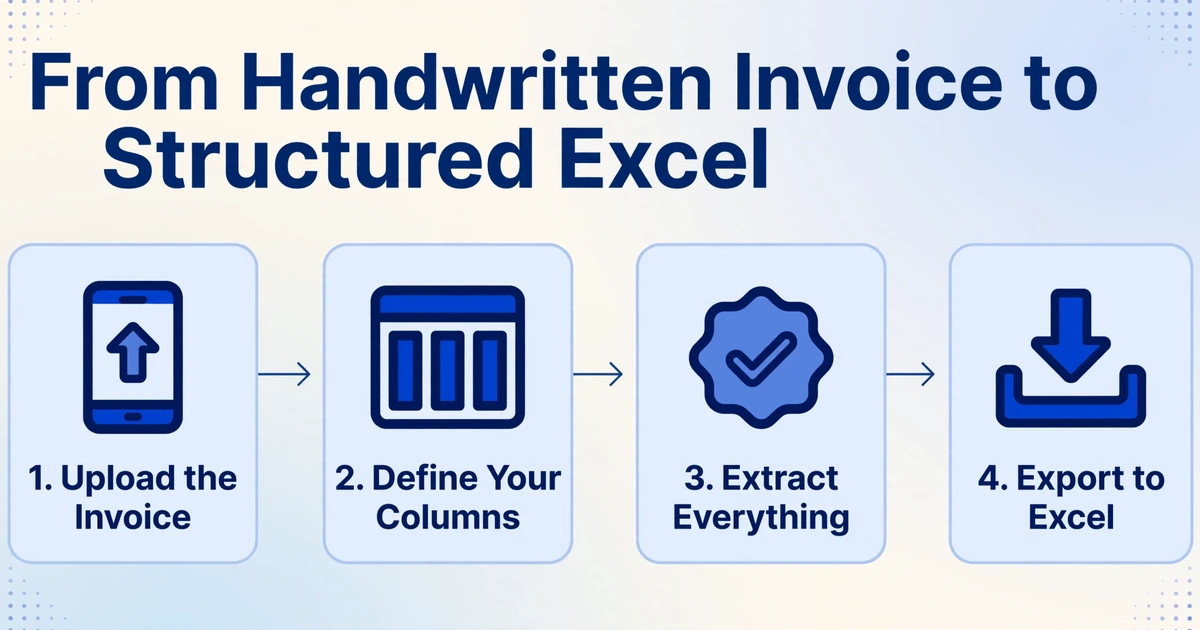
Prenons un scénario réel. Vous êtes électricien en résidentiel. Ferguson vient de livrer un lot de Romex 12/2, de boîtes de jonction et de disjoncteurs pour la rénovation de la cuisine sur Maple Street. Le bon de livraison est manuscrit — le chauffeur de Ferguson l'a rempli à l'entrepôt, et les lignes d'articles sont griffonnées au stylo à bille avec des références abrégées. Il vous faut cela dans votre QuickBooks avant vendredi pour le calcul du coût du chantier, mais retaper 10 lignes d'articles sur 7 factures comme celle-ci vous prend la fin de votre semaine.
Voici le flux d'extraction, étape par étape.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Pourquoi les entrepreneurs ne devraient pas attendre que les factures deviennent « numériques »
Une réaction courante des entrepreneurs qui évaluent les outils d'extraction est : « Je vais simplement demander à mes fournisseurs d'envoyer des PDF au lieu du papier. » Cela semble raisonnable, mais cela méconnaît pourquoi les factures manuscrites persistent dans les métiers.
Le livreur de votre scierie locale ne va pas commencer à envoyer des factures par e-mail depuis un iPad dans le camion. Le grossiste en électricité qui fait des affaires de la même manière depuis 1987 ne va pas passer à la facturation électronique parce qu'un client l'a demandé. Les sous-traitants indépendants — le plâtrier que vous avez fait venir pour la rénovation de la salle de bain, le gars du CVC qui a aidé pour la pré-installation — ils écrivent leurs factures sur le papier qui traîne dans le camion. Ce ne sont pas des entreprises avec des services de comptabilité fournisseurs ; ce sont des artisans qualifiés dont le système de facturation est un bloc-notes et un stylo.
La dépendance de l'industrie de la construction aux factures manuscrites n'est pas une phase temporaire qui est sur le point de se résoudre. C'est une réalité structurelle : l'industrie repose sur des relations entre de petits opérateurs indépendants qui valorisent la rapidité et la flexibilité plutôt que la formalité documentaire. Le fournisseur qui écrit votre facture à la main et la dépose sur la livraison est aussi celui qui se présente à 6 h du matin quand vous êtes dans le pétrin. Vous n'allez pas le renvoyer pour le format de facture, et vous ne devriez pas avoir à choisir entre une bonne relation fournisseur et un back-office gérable.
La solution n'est pas d'attendre que l'industrie se numérise. C'est d'utiliser des outils d'extraction qui fonctionnent avec les factures que vous recevez réellement — manuscrites, tapées, ou un mélange des deux — sans vous obliger à changer la façon dont vos fournisseurs opèrent. La technologie a rattrapé la réalité du fonctionnement réel des entreprises de métier.
FAQ
La qualité de l'écriture manuscrite affecte-t-elle la précision de l'extraction ?
Elle compte, mais moins qu'on ne le pense. L'extraction moderne de l'écriture manuscrite par IA repose sur la compréhension sémantique — elle lit le contexte autour d'un mot griffonné pour interpréter ce qu'il signifie probablement, comme une personne qui plisse les yeux devant une écriture illisible et la déchiffre grâce aux informations environnantes. Les majuscules d'imprimerie sont les plus faciles ; la cursive rapide est plus difficile mais reste extractible. Ce qui cause généralement des échecs, ce n'est pas une mauvaise écriture en soi mais des conditions extrêmes — un texte écrit avec un angle prononcé, des caractères qui se chevauchent, ou une encre si délavée que le contraste est presque invisible sur le papier. Pour une écriture manuscrite typique de chantier — celle que l'on trouve sur les bons de livraison et les factures fournisseurs — la précision est suffisamment élevée pour que la correction se mesure en caractères individuels, et non en champs entiers.
Peut-elle traiter des factures comportant à la fois des sections imprimées et manuscrites ?
Oui. De nombreuses factures fournisseurs ont un en-tête imprimé (logo de l'entreprise, bloc d'adresse) et des sections manuscrites à remplir (lignes d'articles, quantités, signatures). L'IA lit les deux — le texte imprimé avec une précision quasi parfaite et le texte manuscrit avec la compréhension sémantique décrite ci-dessus. Aucun prétraitement ni séparation n'est nécessaire ; la même passe d'extraction traite l'intégralité de la page.
Et si deux fournisseurs utilisent des mises en page de factures complètement différentes ?
Aucun problème. Contrairement aux outils basés sur des modèles qui nécessitent une configuration distincte pour chaque mise en page, l'extraction par IA utilisant la détection sémantique des champs ne se soucie pas de l'emplacement d'un élément sur la page. La « date de facture » est trouvée qu'elle se trouve en haut à droite sur la facture d'un fournisseur ou en bas à gauche sur celle d'un autre. C'est le plus grand avantage de l'extraction sémantique par rapport à l'extraction basée sur des modèles pour les entrepreneurs — vous définissez vos colonnes une seule fois et elles fonctionnent avec le format de chaque fournisseur.
Combien de temps faut-il pour la configuration initiale ?
Il n'y a pratiquement aucune configuration. Vous saisissez les noms des colonnes que vous souhaitez extraire — c'est tout. Aucun document d'exemple à télécharger, aucun modèle à créer, aucune donnée d'entraînement à fournir. Si vous savez déjà quels champs vous avez besoin (nom du fournisseur, date de facture, lignes d'articles, total), vous avez terminé en moins d'une minute. Vous pouvez également enregistrer votre configuration de colonnes comme préréglage pour une réutilisation, afin que tous les futurs lots de factures utilisent les mêmes définitions de champs sans avoir à les ressaisir.
Est-ce que cela fonctionne pour les factures de sous-traitants, pas seulement pour les factures de fournisseurs ?
Oui. Une facture de sous-traitant — où un plâtrier ou un technicien CVC écrit « 40 heures @ 65 $/heure — 2 600 $ » sur un morceau de papier — est structurellement plus simple qu'une facture de fournisseur à plusieurs lignes. Le même processus d'extraction la gère. Définissez vos colonnes comme « Nom du sous-traitant », « Date », « Heures », « Taux », « Total », et l'IA extrait ces valeurs de la feuille manuscrite, quel que soit le format. Pour traiter plusieurs factures de sous-traitants à la fois, l'extraction par lots est la voie la plus rapide.